Program
Pembelajaran Mendalam dalam Python
18 jam
TRIBE v2 (TRImodal Brain Encoder) adalah model deep learning yang memetakan rangsangan naturalistik ke respons fMRI otak yang diprediksi. Diberi klip video, berkas audio, atau blok teks, model ini menghasilkan sinyal BOLD yang diprediksi untuk masing-masing dari 20.484 verteks pada permukaan kortikal fsaverage5 pada 1 Hz, yaitu satu prediksi per detik.
Prediksi ditujukan untuk subjek rata-rata (bukan otak seseorang secara spesifik), melainkan respons rata-rata kelompok kanonik yang dipelajari TRIBE v2 dari 720 partisipan di empat dataset naturalistik. Prediksi zero-shot model ini melampaui rekaman fMRI subjek tunggal pada dataset Human Connectome Project 7T, yang memiliki kualitas sinyal tertinggi dalam set pelatihan.
|
Properti |
Detail |
|
Ruang keluaran |
20.484 verteks kortikal pada permukaan fsaverage5 dan prediksi seluruh otak di sekitar 70.000 voxel (korteks + subkorteks) |
|
Resolusi temporal |
1 Hz (sesuai frekuensi TR fMRI) |
|
Modalitas masukan |
Video (V-JEPA2-Giant), Audio (Wav2Vec-BERT 2.0), Teks (LLaMA 3.2-3B) |
|
Parameter encoder |
~1B parameter terpelajari pada lapisan integrasi transformer |
|
Data pelatihan |
1.115 jam fMRI dari 720 subjek pada 4 dataset |
|
Generalisasi |
Zero-shot ke subjek, tugas, dan bahasa baru |
|
Lisensi |
CC-BY-NC 4.0 (penggunaan riset, non-komersial) |
Model ini diadaptasi dari makalah berjudul A foundation model of vision, audition, and language for in-silico neuroscience, yang menunjukkan bahwa TRIBE v2 memulihkan fusiform face area untuk wajah, parahippocampal place area untuk pemandangan, area Broca untuk sintaksis kompleks, dan jaringan bahasa lateral kiri untuk ujaran tanpa data fMRI apa pun pada saat inferensi.
TRIBE v2 memiliki tiga tahap yang dijalankan berurutan untuk setiap pemanggilan inferensi:
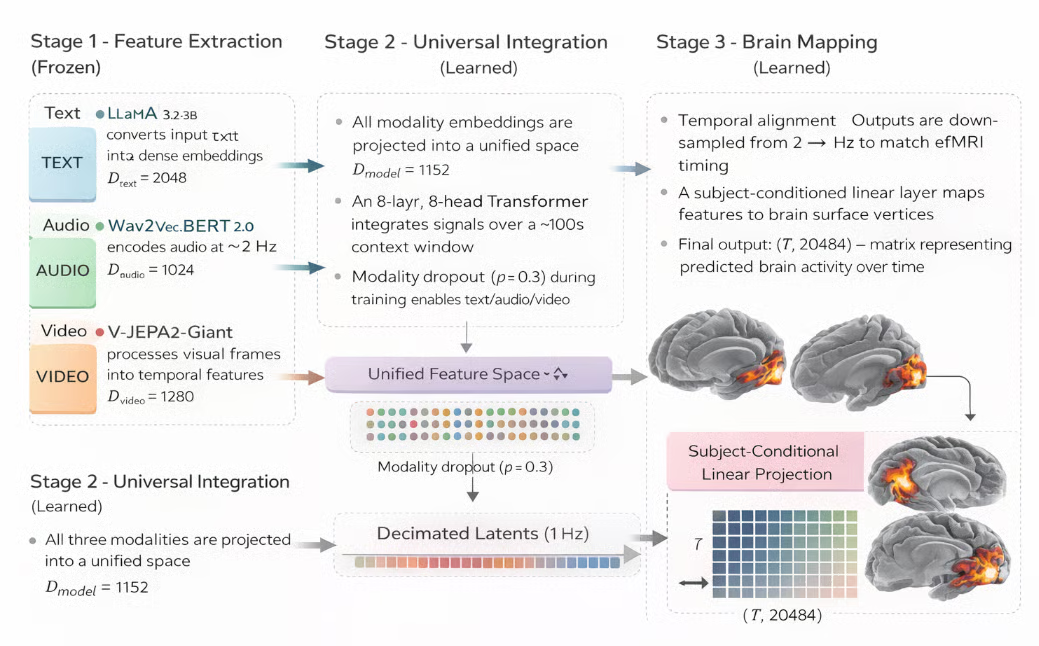
Gambar: Model prediksi aktivitas otak TRIBE v2 (Dihasilkan dengan AI)
Pertama, tiga encoder pralatih yang terpisah secara independen memproses setiap modalitas masukan menjadi embedding padat yang selaras waktu. Tidak ada encoder ini yang diperbarui selama pelatihan (beku), sehingga TRIBE v2 mewarisi representasi mereka apa adanya. Berikut beberapa metrik ekstraksi fitur untuk tiap modalitas:
Teks: LLaMA 3.2-3B mengonversi teks masukan menjadi embedding padat (D = 2048)
Audio: Wav2Vec-BERT 2.0 mengenkode sinyal audio pada ~2 Hz (D = 1024)
Video: V-JEPA2-Giant memproses frame visual menjadi fitur temporal (D = 1280)
Tiga aliran embedding digabungkan ke dalam satu representasi bersama dan diproses oleh Transformer yang memperhatikan lintas waktu. Di sinilah bobot terpelajari TRIBE v2 berada dan tempat interaksi lintas modal ditangkap sebagai berikut:
Representasi bersama: Semua embedding modalitas diproyeksikan ke ruang terpadu (D_model = 1152)
Fusi Transformer: Transformer 8-lapis, 8-kepala mengintegrasikan sinyal pada jendela konteks panjang (~100 dtk)
Fleksibilitas modalitas: Modality dropout (p = 0.3) memungkinkan inferensi dengan subset mana pun (teks/audio/video)
Representasi laten yang telah digabungkan diproyeksikan ke permukaan kortikal untuk menghasilkan prediksi fMRI akhir. Tahap ini mengubah fitur model abstrak menjadi estimasi aktivitas otak yang terselesaikan secara spasial dan temporal.
Karena tiga ekstraktor fitur dibekukan selama pelatihan, TRIBE v2 hanya mempelajari lapisan proyeksi dan bobot transformer yang mengintegrasikan keluarannya. Pilihan desain ini penting karena membuat model tangguh terhadap rangsangan di luar distribusi, sebab ia mewarisi kemampuan generalisasi dari tiga model pralatih skala besar alih-alih dilatih end-to-end hanya pada data fMRI.
Catatan: Trik pelatihan kunci adalah dropout modalitas. Selama pelatihan, setiap modalitas secara independen diset nol dengan probabilitas 0,3. Ini memaksa model membuat prediksi bermakna dari subset modalitas apa pun. Jadi, saat inferensi, Anda dapat hanya memasukkan audio atau hanya teks dan tetap memperoleh prediksi kortikal yang berguna.
Pada bagian ini, kita akan membangun alur kerja langkah demi langkah yang menjalankan inferensi TRIBE v2 pada masukan teks, audio, atau video dan memvisualisasikan aktivitas kortikal yang diprediksi sebagai peta panas otak 3D interaktif. Kita juga akan menjalankan eksperimen perbandingan yang mereplikasi paradigma in-silico dari makalah aslinya. Terakhir, kita akan mengembangkan aplikasi Gradio yang dapat digunakan siapa pun untuk menjelajahi demo secara langsung.
Sebelum mulai, konfigurasikan runtime Colab Anda. Perlu dicatat bahwa Anda juga dapat menggunakan layanan lain dengan GPU A100 yang stabil dan RAM tinggi.
TRIBE v2 memuat tiga encoder beku secara bersamaan, termasuk LLaMA 3.2-3B (~7 GB), V-JEPA2-Giant (~14 GB), dan Wav2Vec-BERT 2.0 (~1 GB), bersama dengan bobot transformer TRIBE. Total jejak VRAM adalah 28–32 GB.
Catatan: T4 (16 GB) akan kehabisan memori ketika model.predict() memuat LLaMA. Gunakan A100 (40 GB) atau A100 dengan High RAM (80 GB) untuk kinerja lebih baik.
Verifikasi GPU Anda sebelum memasang apa pun dengan menjalankan berikut ini:
import subprocess, sys
result = subprocess.run(
    ['nvidia-smi', '--query-gpu=name,memory.total',
     '--format=csv,noheader,nounits'],
    capture_output=True, text=True)
print(result.stdout.strip())
import torch
assert torch.cuda.is_available(), "No GPU detected"
props = torch.cuda.get_device_properties(0)
assert props.total_memory > 30e9, (
    f"Need ≥40 GB VRAM. Got {props.total_memory/1e9:.0f} GB. Switch to A100.")
print(f"GPU: {props.name} — {props.total_memory/1e9:.0f} GB")
Panggilan subprocess.run() memanggil nvidia-smi dengan flag --query-gpu untuk mengambil nama GPU dan total VRAM. Dua pernyataan assert bertindak sebagai penghentian dini; yang pertama memastikan CUDA tersedia, dan yang kedua memverifikasi total VRAM melebihi 30 GB. Gagal dengan jelas di sini lebih baik daripada gagal diam-diam di dalam model.predict() 10 menit kemudian dengan galat CUDA out-of-memory yang membingungkan.
Lewati langkah ini jika Anda tidak menjalankannya di Google Colab. Ini adalah bug pertama yang akan Anda temui karena Colab menyertakan NumPy 2.x secara default. Beberapa dependensi internal TRIBE v2, khususnya neuralset, dikompilasi terhadap NumPy <2.1, yang menghapus simbol _center dari numpy._core.umath. Akibatnya muncul galat ini saat Anda mencoba import tribev2:
ImportError
cannot import name '_center' from 'numpy._core.umath'
(/usr/local/lib/python3.12/dist-packages/numpy/_core/umath.py)
Solusinya adalah mengunci NumPy ke <2.1 sebelum tribev2 atau dependensinya dipasang, lalu mulai ulang runtime. Cukup jalankan sel berikut, yang mencopot pemasangan NumPy saat ini dan menggantinya dengan versi di bawah 2.1.
import subprocess, sys
print("Pinning NumPy to <2.1 (required for neuralset compatibility)...")
subprocess.run([sys.executable, '-m', 'pip', 'uninstall', '-y', 'numpy'])
subprocess.run([sys.executable, '-m', 'pip', 'install', '-q',
                'numpy>=1.26.4,<2.1.0'])
Setelah lingkungan dan dependensi final, kita dapat melanjutkan memasang TRIBE v2.
Dengan kernel baru saja dimulai ulang dan NumPy yang dikunci telah dimuat, kini kita dapat memasang paket tribev2 dari GitHub dengan aman beserta pustaka visualisasi dan UI-nya.
import numpy as np
from packaging.version import Version
assert Version(np.__version__) < Version('2.1.0'), (
    f"NumPy is {np.__version__}. Run Step 2a and restart first.")
print(f"NumPy {np.__version__} Checked")
# Install tribev2 from GitHub
!pip install -q 'tribev2[plotting] @ git+https://github.com/facebookresearch/tribev2.git'
!pip install -q 'gradio>=4.19.0' 'nilearn>=0.10.3' 'plotly>=5.18.0'
Ekstra tribev2[plotting] memasang pyvista, pustaka Python untuk visualisasi 3D, dan nilearn, pustaka Python untuk neuroimaging, bersamaan dengan paket inti. Memasang langsung dari URL GitHub memastikan Anda mendapatkan commit terbaru tanpa perlu mengkloning repositori secara lokal.
Paket nilearn dan gradio dipasang secara terpisah karena batasan versinya lebih fleksibel dan diuntungkan jika diselesaikan secara independen dari grafik dependensi tribev2.
Encoder teks menggunakan LLaMA 3.2-3B, yang merupakan model berpagar di HuggingFace. Anda perlu secara eksplisit menerima lisensi Meta sebelum bobot dapat diunduh. Lakukan ini sekali:
Setelah token HF Anda disetel, jalankan kode berikut untuk login ke akun Anda:
import os
# Load token from Colab Secrets
try:
    from google.colab import userdata
    os.environ['HF_TOKEN'] = userdata.get('HF_TOKEN')
    print("HF_TOKEN loaded from Colab Secrets")
except Exception:
    from huggingface_hub import login
    login()
Jalur yang disarankan menggunakan google.colab.userdata.get(), yang membaca dari penyimpanan Rahasia terenkripsi milik Colab, sehingga tidak dapat terekspos secara tidak sengaja dalam tautan notebook yang dibagikan.
Fallback memanggil huggingface_hub.login(), yang meminta secara interaktif dan menyamarkan token saat Anda mengetik. Keduanya menulis token ke os.environ['HF_TOKEN'], tempat pustaka HuggingFace Hub akan otomatis mengambilnya saat mengunduh bobot model berpagar.
Dengan NumPy telah dikunci, autentikasi dikonfigurasikan, dan LLaMA telah di-cache, kini kita dapat memuat checkpoint encoder TRIBE v2 dari HuggingFace. Ini mengunduh sekitar 1 GB pada jalan pertama dan memerlukan beberapa detik dari cache pada jalan berikutnya.
from pathlib import Path
from tribev2.demo_utils import TribeModel
import torch
CACHE_DIR = Path('/content/tribe_cache')
CACHE_DIR.mkdir(exist_ok=True)
print('Loading TRIBE v2 (first run downloads ~1 GB)...')
model = TribeModel.from_pretrained(
    'facebook/tribev2',
    cache_folder=str(CACHE_DIR)
)
print('Model loaded')
if torch.cuda.is_available():
    used  = torch.cuda.memory_allocated() / 1e9
    total = torch.cuda.get_device_properties(0).total_memory / 1e9
    print(f'VRAM after load: {used:.1f} / {total:.1f} GB')
TribeModel.from_pretrained() mengunduh checkpoint encoder TRIBE dari facebook/tribev2 di HuggingFace dan menyimpannya ke cache_folder. Checkpoint ini berisi bobot integrasi transformer dan blok subjek, tetapi tidak termasuk tiga ekstraktor fitur. Ketiganya akan diunduh terpisah saat model.predict() pertama kali menggunakan setiap modalitas.
Setelah hanya memuat encoder TRIBE, sekitar 2–4 GB VRAM teralokasi, sementara 24–28 GB sisanya akan terpakai saat model.predict() memuat V-JEPA2-Giant dan LLaMA 3.2-3B pada penggunaan pertama.
Setelah model TRIBE dimuat, pemanggilan model.predict() pada masukan teks untuk pertama kali memicu unduhan malas bobot LLaMA 3.2-3B (~6 GB). Batas waktu default HuggingFace Hub adalah 10 detik, menghasilkan galat ini di tengah inferensi:
ReadTimeout
The read operation timed out
Computing word embeddings:  0%|  | 0/9 [00:10<?, ?it/s]
Untuk memperbaikinya, naikkan variabel lingkungan timeout, lalu unduh pra-LLaMA secara eksplisit menggunakan snapshot_download sehingga Anda mendapatkan progres yang terlihat dan melanjutkan otomatis saat terputus, bukan kegagalan senyap yang tersembunyi di dalam predict().
import os
os.environ['HF_HUB_DOWNLOAD_TIMEOUT'] = '300'
os.environ['HF_HUB_HTTP_TIMEOUT']     = '300'
from huggingface_hub import snapshot_download
print("Pre-downloading LLaMA 3.2-3B (~6 GB)...")
print("Runs once — subsequent calls load from cache.\n")
snapshot_download(
    repo_id        = "meta-llama/Llama-3.2-3B",
    cache_dir      = "/content/tribe_cache/llama",
    ignore_patterns= ["*.bin"],
)
print("\n LLaMA 3.2-3B cached")
snapshot_download() mengunduh seluruh repositori ke cache lokal menggunakan protokol permintaan rentang milik HuggingFace, yang berarti proses akan otomatis dilanjutkan jika koneksi terputus di tengah berkas. Argumen ignore_patterns=["*.bin"] melewati format biner PyTorch yang lebih lama dan hanya mengunduh berkas safetensors, mengurangi ukuran unduhan total sekitar 40%.
Sebelum menjalankan inferensi nyata, kita menyiapkan lapisan visualisasi. Fungsi pembantu ini mengonversi array prediksi mentah (T, 20484) menjadi peta panas otak 3D interaktif menggunakan nilearn.
TRIBE v2 mengembalikan prediksi sebagai array NumPy berukuran (T, 20484), di mana T adalah jumlah detik masukan. 10.242 verteks pertama berada di belahan kiri, dan 10.242 sisanya berada di belahan kanan.
Kita menggunakan nilearn.plotting.view_surf untuk merender setiap belahan sebagai permukaan WebGL interaktif. Mesh yang diinflasi memperlihatkan geometri sulkus yang sebaliknya tersembunyi di lipatan, dan peta kedalaman sulkus memberikan referensi anatomi di bawah peta panas.
Mesh fsaverage5 adalah templat kortikal FreeSurfer standar yang digunakan TRIBE v2 sebagai ruang keluarannya. Kita mengunduhnya sekali di sini agar semua pemanggilan visualisasi berikutnya dapat merujuknya tanpa mengambil ulang dari jaringan.
import numpy as np
from nilearn import datasets as nl_datasets
from nilearn.plotting import view_surf
from IPython.display import display, HTML
N_PER_HEMI = 10242   # fsaverage5: 10242 vertices per hemisphere
print('Fetching fsaverage5 mesh...')
fsavg = nl_datasets.fetch_surf_fsaverage(mesh='fsaverage5')
print('Mesh ready')
print('Keys:', [k for k in fsavg.keys() if k != 'description'])
Fungsi fetch_surf_fsaverage(mesh='fsaverage5') mengunduh templat fsaverage5 FreeSurfer dari CDN nilearn dan menyimpannya ke cache. Fungsi ini juga mengembalikan objek Bunch (kamus) dengan kunci seperti infl_left, infl_right, sulc_left, dan sulc_right.
Sub-langkah ini mendefinisikan tiga fungsi inti yang menjadi dasar semua visualisasi dalam tutorial ini. Fungsi split_hemis() membagi array verteks, fungsi render_hemi() membangun permukaan WebGL interaktif untuk satu belahan, dan fungsi show_brain() menyusun keduanya dalam tata letak berdampingan.
def split_hemis(v):
    n = v.shape[0]
    if n == 2 * N_PER_HEMI:
        return v[:N_PER_HEMI], v[N_PER_HEMI:]
    return v[:n//2], v[n//2:]
def render_hemi(pred_vec, hemi='left', title=''):
    lh, rh = split_hemis(pred_vec)
    data = lh if hemi == 'left' else rh
    vmax = max(float(np.percentile(np.abs(data), 99)), 1e-6)
    return view_surf(
        surf_mesh = fsavg[f'infl_{hemi}'],
        surf_map  = data,
        bg_map    = fsavg[f'sulc_{hemi}'],
        hemi      = hemi,
        threshold = '20%',
        cmap      = 'hot',
        black_bg  = True,
        vmax      = vmax,
        bg_on_data= True,
        colorbar  = True,
        title     = title,
    )
def show_brain(pred_vec, title='', t=None):
    sfx = f' — t={t}s' if t is not None else ''
    lv  = render_hemi(pred_vec, 'left',  f'{title} [Left]{sfx}')
    rv  = render_hemi(pred_vec, 'right', f'{title} [Right]{sfx}')
    html = (
        '<div style="display:flex;gap:10px;background:#000;'
        'border-radius:10px;">'
        f'<div style="flex:1">{lv.get_iframe(width="100%",height="460px")}</div>'
        f'<div style="flex:1">{rv.get_iframe(width="100%",height="460px")}</div>'
        '</div>'
    )
    display(HTML(html))
Mari pahami fungsi masing-masing pembantu secara rinci:
Fungsi split_hemis() membagi vektor prediksi pada indeks 10.242, yang merupakan titik pisah standar untuk mesh fsaverage5 dalam konvensi FreeSurfer. Belahan kiri menempati indeks 0–10241 dan belahan kanan 10242–20483. Cabang fallback di bagian bawah menangani kasus tepi saat model mengembalikan jumlah verteks non-standar.
Di dalam fungsi render_hemi(), vmax dihitung sebagai persentil ke-99 dari nilai aktivasi absolut, bukan nilai maksimum sebenarnya. Ini mencegah satu verteks ekstrem meruntuhkan seluruh peta warna ke rentang sempit, sehingga pola spasial tetap terlihat.
Fungsi view_surf() mengembalikan objek SurfaceView yang berisi 2,4 MB HTML WebGL mandiri. Panggilan get_iframe() membungkus ini dalam tag <iframe> berukuran sesuai dimensi yang diberikan. Jadi, saat kita memanggil display(HTML(...)) dengan dua iframe berdampingan, hasilnya adalah tata letak belahan kiri/kanan terpisah.
Dengan model dimuat dan pembantu visualisasi siap, kita dapat menjalankan inferensi nyata pertama kita.
Inferensi TRIBE v2 adalah proses dua langkah. Pertama, model.get_events_dataframe() mengekstrak peristiwa yang selaras waktu dari masukan, bersama dengan penentuan waktu kata dari teks, embedding Wav2Vec pada 2 Hz dari audio, atau embedding V-JEPA2 pada 2 Hz dari frame video.
DataFrame peristiwa yang dihasilkan kemudian diteruskan ke model.predict(), yang menjalankan transformer dan blok subjek untuk menghasilkan prediksi kortikal akhir.
import tempfile, os
SAMPLE_TEXT = '''
The brain processes language through a distributed network in the left hemisphere.
Broca's area coordinates syntactic structure, while Wernicke's area handles semantics.
Together they form the language circuit activated when reading or hearing speech.
'''
tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
try:
    tmp.write(SAMPLE_TEXT.strip())
    tmp.flush()
    os.fsync(tmp.fileno())
    tmp.close()
    events = model.get_events_dataframe(text_path=tmp.name)
finally:
    if os.path.exists(tmp.name):
        os.unlink(tmp.name)
print(f'Events: {events.shape}')
print(events[['type', 'start', 'duration']].head(8))
print('\nRunning model.predict()...')
preds, segments = model.predict(events=events)
preds = np.asarray(preds)
print(f'Prediction shape: {preds.shape}')
print(f'  T = {preds.shape[0]}s   (1 Hz fMRI frequency)')
print(f'  V = {preds.shape[1]} vertices  (fsaverage5 cortical surface)')
Urutan tulis tmp.write(), tmp.flush(), os.fsync(tmp.fileno()), tmp.close() adalah perbaikan kritis untuk bug subtil. Jika Anda memanggil get_events_dataframe() di dalam blok with sebelum berkas ditutup, buffer tulis internal Python mungkin belum tersinkron ke OS, dan tribev2 akan membaca berkas kosong serta memunculkan ValueError. Panggilan os.fsync() menjamin page cache OS disiram ke disk sebelum tribev2 membuka path.
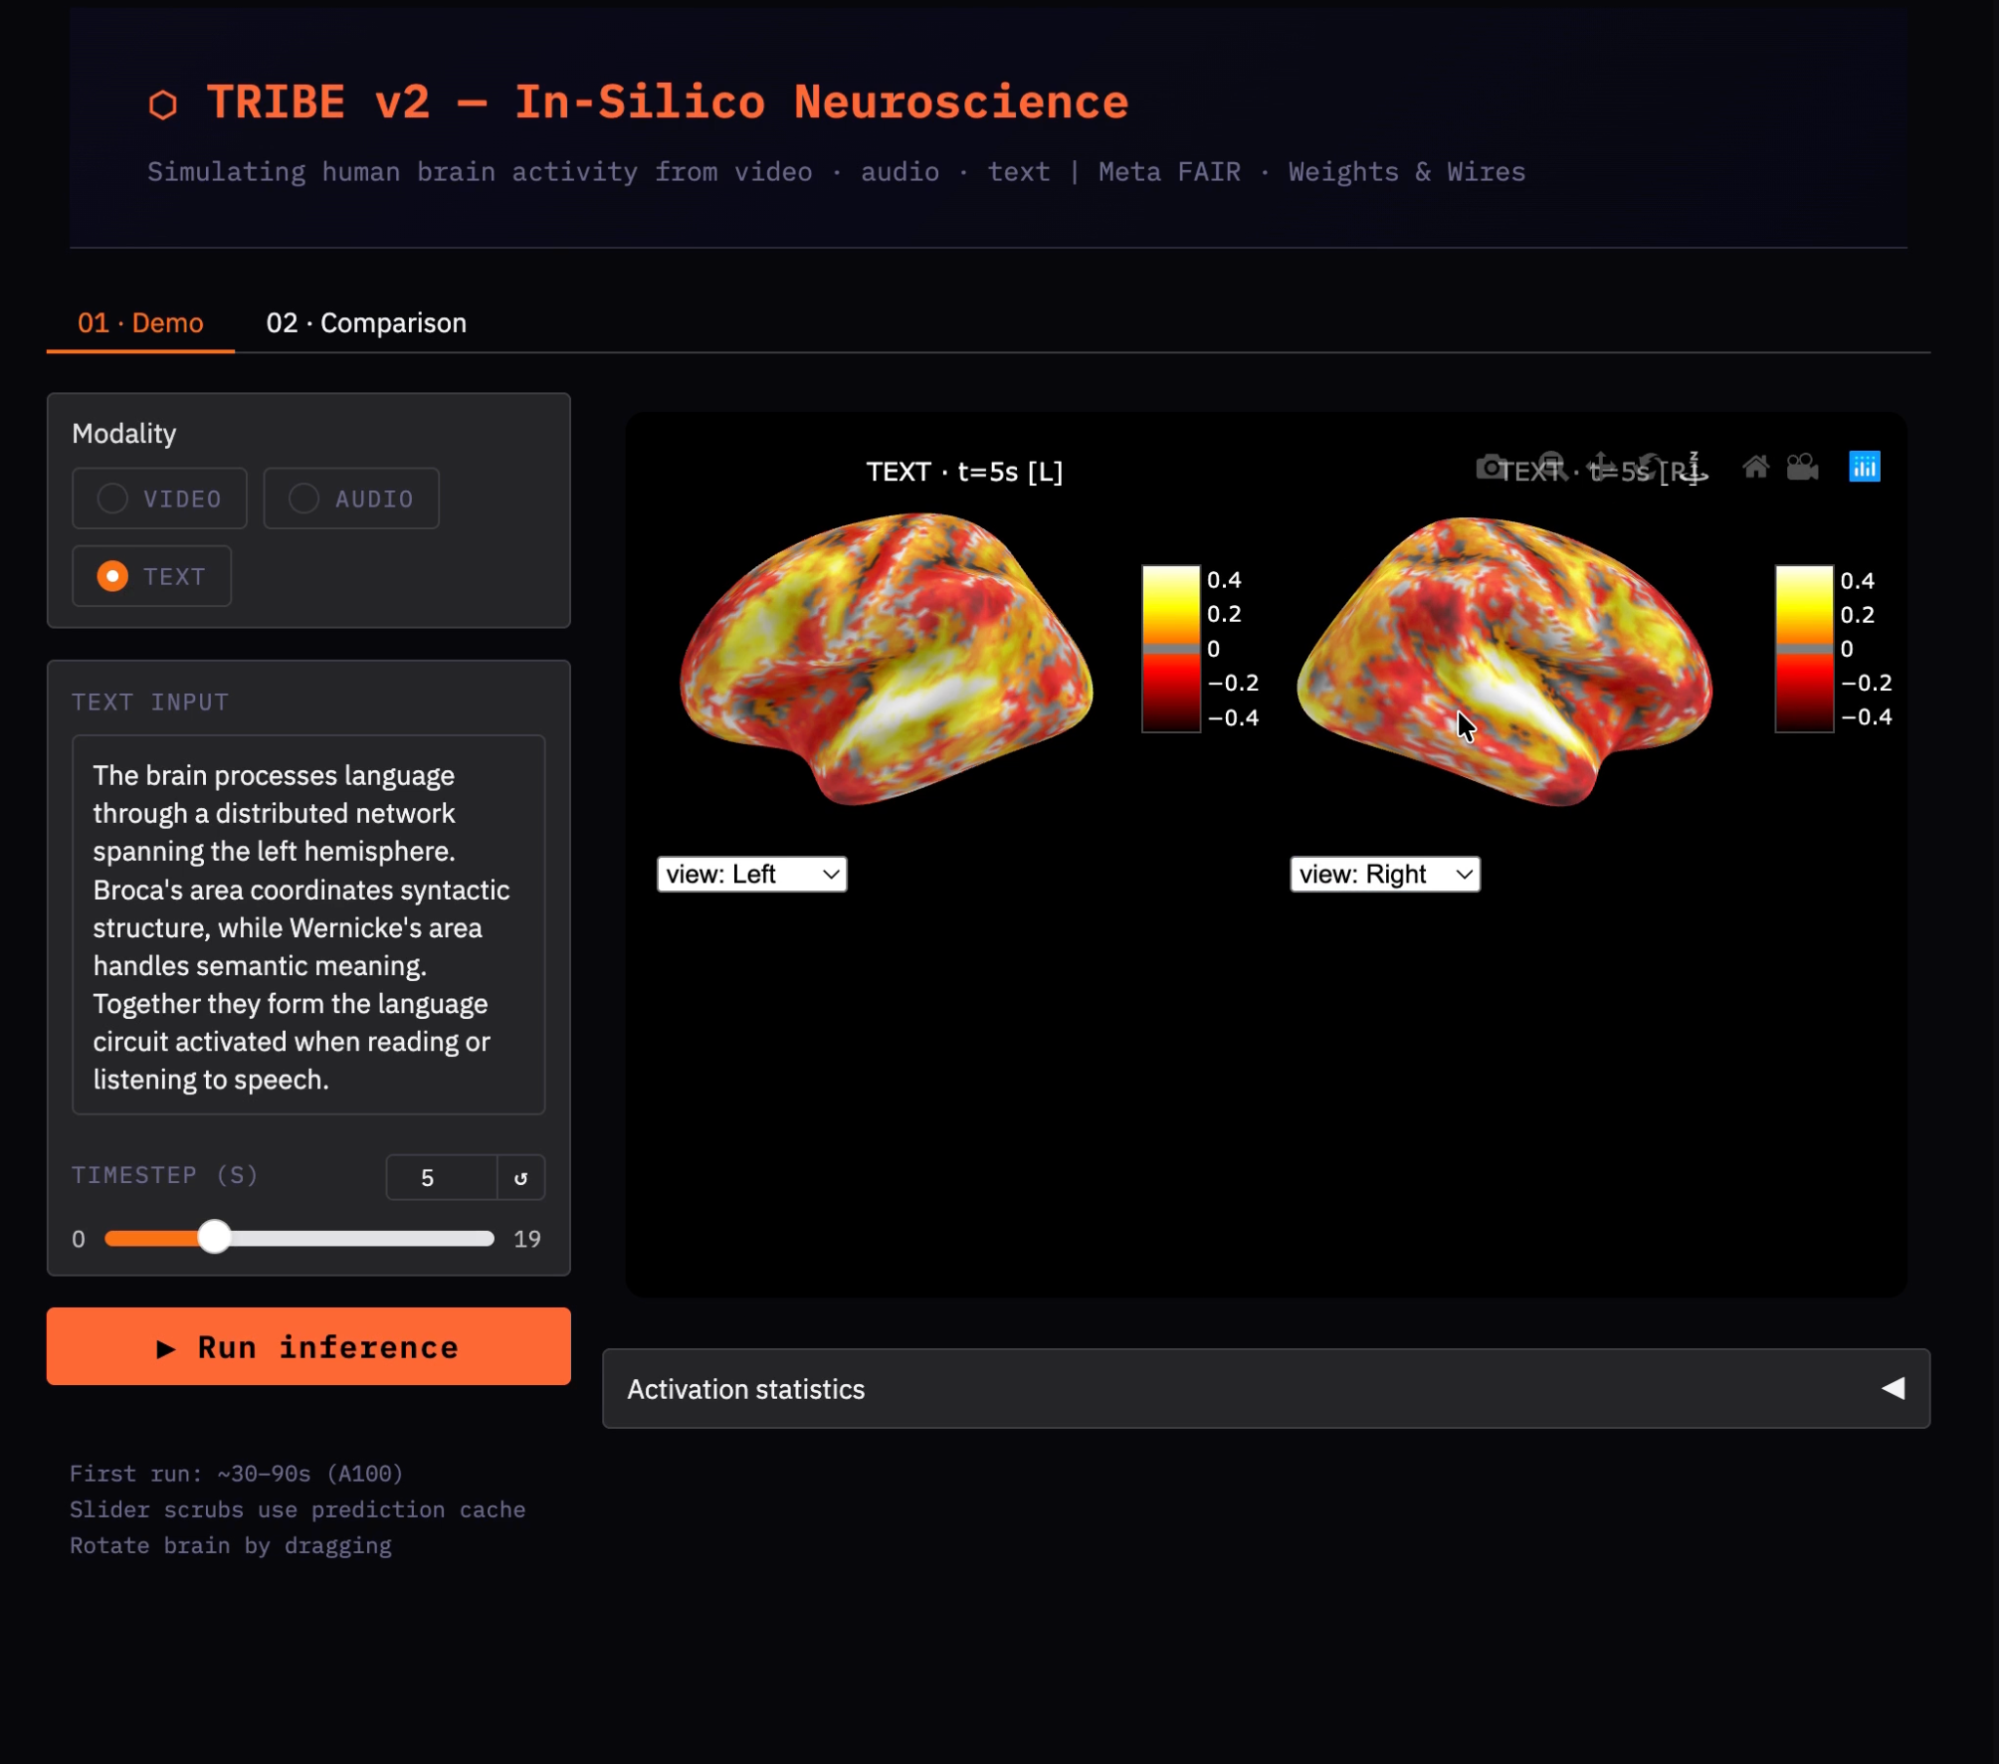
Fungsi model.predict() mengembalikan tuple (preds, segments). Array preds berukuran (T, 20484), satu prediksi kortikal per detik masukan di seluruh 20.484 verteks fsaverage5. Membungkusnya dalam np.asarray() memastikan bahwa itu adalah array NumPy murni terlepas dari tipe internal apa yang dikembalikan model. Setelah Anda memiliki preds, Anda dapat memvisualisasikan respons kortikal pada timestep mana pun:
T = preds.shape[0]
print(f'Timesteps: 0 to {T-1}')
T_SHOW = min(5, T - 1)
show_brain(preds[T_SHOW], title='Language stimulus', t=T_SHOW)
Kita default ke t=5 karena sinyal BOLD (Blood-Oxygen-Level-Dependent) memiliki keterlambatan hemodinamik, dan respons vaskular terhadap aktivitas saraf mencapai puncak sekitar 5–6 detik setelah onset rangsangan. Memvisualisasikan pada t=0 menunjukkan aktivasi mendekati nol terlepas dari konten rangsangan, karena respons vaskular otak belum terbentuk. Penjaga min(5, T-1) mencegah galat indeks ketika masukan menghasilkan kurang dari 6 timestep.
Peta aktivasi tunggal memberi tahu Anda area mana yang aktif, tetapi tidak memberi tahu apa yang membuat satu rangsangan berbeda dari yang lain. Langkah ini menjalankan dua masukan melalui model dan menghitung peta kontras (A − B) untuk mengisolasi perbedaan spesifik wilayah antara konten bahasa dan konten visual/spasial.
Alih-alih mengulang pola tulis -> flush -> close -> infer untuk setiap kondisi, kita membungkusnya dalam satu fungsi text_to_preds(). Ini memastikan langkah penyiraman berkas penting tidak pernah terlewat secara tidak sengaja untuk salah satu kondisi.
TEXT_A = '''
She spoke slowly and clearly, her voice filling the quiet room.
Every sentence carried meaning, and each word was chosen with care.
Language connects us, the professor said, bridging minds across time.
'''
TEXT_B = '''
The canyon walls rose steeply, layers of red and orange sandstone.
A hawk circled overhead, its wings barely moving in the thermal current.
Shadows shifted as the sun tracked its arc across the open desert sky.
'''
def text_to_preds(text):
    tmp = tempfile.NamedTemporaryFile(
        delete=False, suffix='.txt', mode='w', encoding='utf-8')
    try:
        tmp.write(text.strip())
        tmp.flush()
        os.fsync(tmp.fileno())
        tmp.close()
        evts = model.get_events_dataframe(text_path=tmp.name)
        p, _ = model.predict(events=evts)
        return np.asarray(p)
    finally:
        if os.path.exists(tmp.name):
            os.unlink(tmp.name)
print('Condition A: language content...')
preds_a = text_to_preds(TEXT_A)
print('Condition B: visual/spatial content...')
preds_b = text_to_preds(TEXT_B)
Kita menggunakan dua potongan teks dengan konten semantik yang berbeda, dengan temuan yang diharapkan bahwa konten bahasa lebih menggerakkan korteks temporal belahan kiri, sementara konten visual/spasial lebih merekrut korteks oksipital dan parietal posterior.
Fungsi text_to_preds() mengenkapsulasi seluruh pipeline ke dalam satu fungsi yang dapat digunakan ulang, menerapkan pola aman yang sama dari Langkah 8 sehingga berkas sementara selalu benar-benar disiram sebelum tribev2 membacanya. Argumen encoding='utf-8' dibuat eksplisit untuk menghindari masalah pengodean yang bergantung pada platform.
Sekarang kedua kondisi telah diprediksi, kita memvisualisasikan masing-masing secara individual lalu mengurangkannya verteks demi verteks untuk menghasilkan peta kontras.
T_shared = min(preds_a.shape[0], preds_b.shape[0])
t_show   = min(5, T_shared - 1)
print('\n[A] Language content:')
show_brain(preds_a[t_show], title='Condition A: Language', t=t_show)
print('\n[B] Visual/spatial content:')
show_brain(preds_b[t_show], title='Condition B: Visual', t=t_show)
print('\n[A − B] Contrast: Language > Visual')
show_brain(preds_a[t_show] - preds_b[t_show], title='Contrast A − B', t=t_show)
Peta kontras preds_a[t_show] - preds_b[t_show] adalah pengurangan langsung per verteks di mana nilai positif menunjukkan wilayah tempat kondisi A lebih aktif, dan nilai negatif menunjukkan wilayah tempat kondisi B lebih aktif.
Karena kedua kondisi berbagi jalur pemrosesan teks yang sama, peta mentah akan terlihat secara umum serupa. Peta kontras ini menyoroti perbedaan spesifik ranah antara konten bahasa dan visual.
Peta panas otak menunjukkan pola spasial pada satu momen waktu. Langkah ini menambahkan perspektif temporal, seperti bagaimana perbandingan aktivasi keseluruhan antara kondisi di seluruh semua timestep, dan kapan kedua kondisi paling kuat menyimpang?
import matplotlib.pyplot as plt
diff_norms = [
    np.linalg.norm(preds_a[i] - preds_b[i])
    for i in range(T_shared)
]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 3.5))
ax1.plot(np.abs(preds_a).mean(axis=1)[:T_shared],
         color='#e74c3c', linewidth=2, label='A: Language')
ax1.plot(np.abs(preds_b).mean(axis=1)[:T_shared],
         color='#3498db', linewidth=2, label='B: Visual')
ax1.set_title('Mean cortical activation over time')
ax1.set_xlabel('Time (s)'); ax1.legend(); ax1.grid(True, alpha=0.3)
ax2.plot(diff_norms, color='#f39c12', linewidth=2)
ax2.fill_between(range(T_shared), diff_norms, alpha=0.2, color='#f39c12')
ax2.set_title('||A − B|| difference over time')
ax2.set_xlabel('Time (s)'); ax2.grid(True, alpha=0.3)
plt.tight_layout(); plt.show()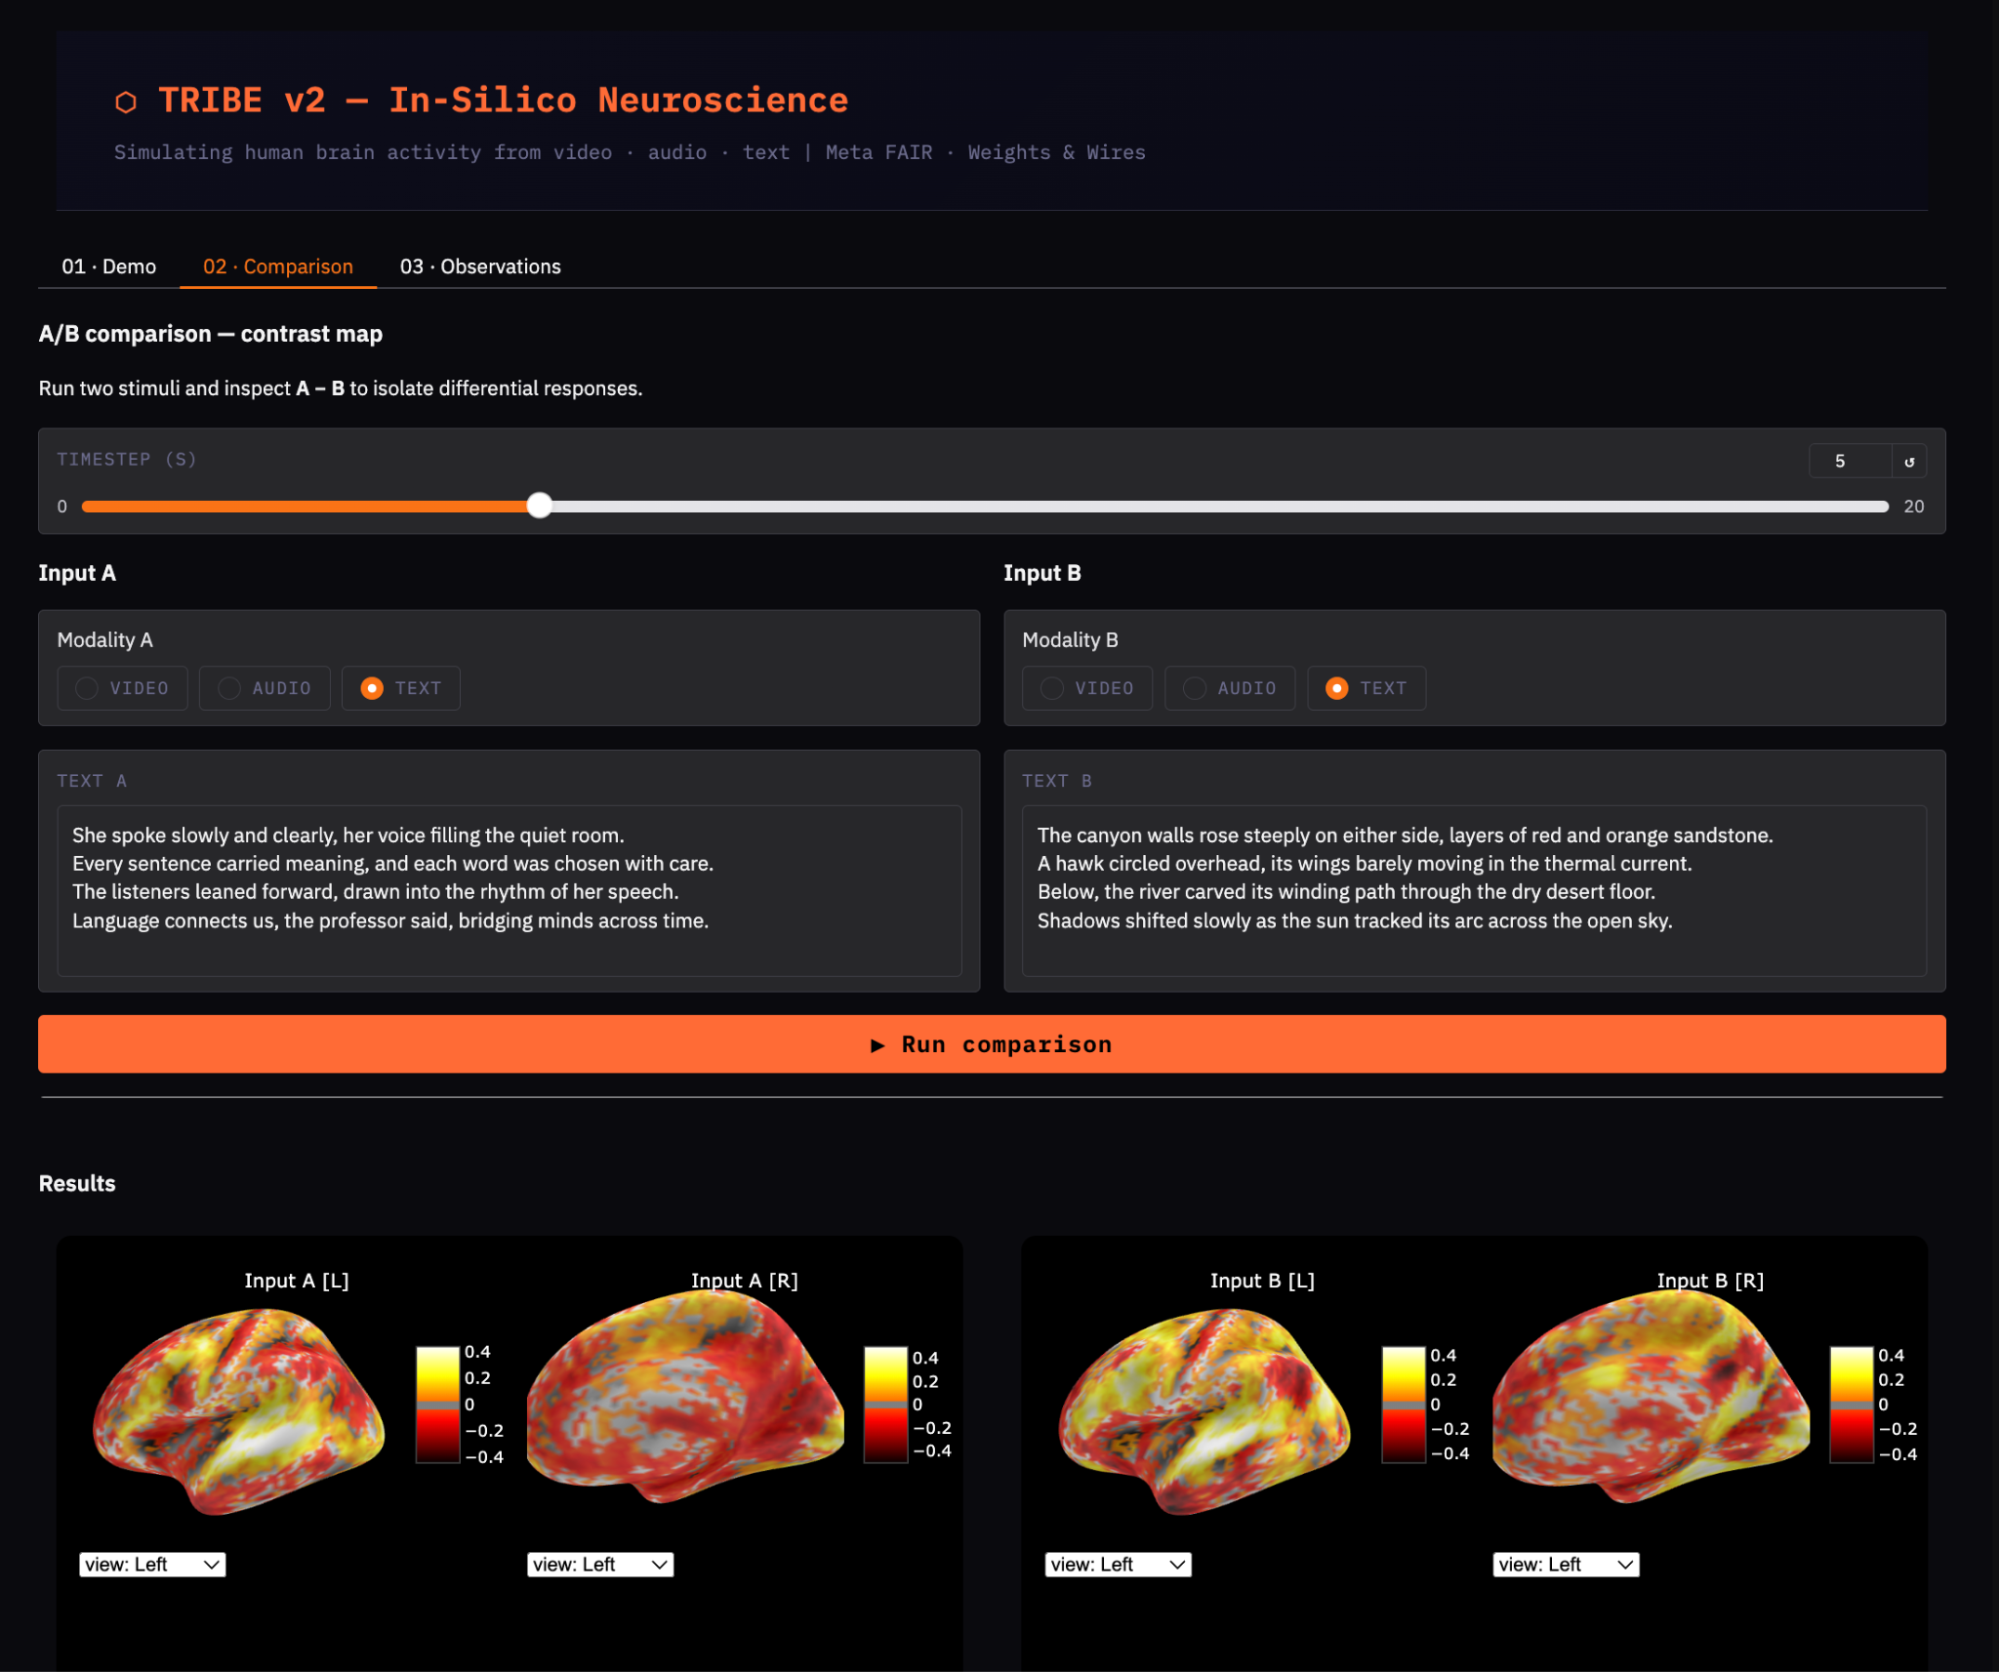
Plot kiri melacak np.abs(preds).mean(axis=1), yaitu rata-rata aktivasi absolut yang diruntuhkan di seluruh 20.484 verteks pada setiap detik. Ini menunjukkan seberapa kuat tiap kondisi melibatkan korteks dan kapan respons memuncak. Mengambil nilai absolut penting karena nilai BOLD yang diprediksi dapat negatif (deaktivasi), dan kita menginginkan magnitudo alih-alih rata-rata bertanda.
Plot kanan melacak norma L2 dari vektor perbedaan pada setiap timestep, np.linalg.norm(preds_a[i] - preds_b[i]). Puncak kurva ini sekitar t=5–7 dtk konsisten dengan keterlambatan hemodinamik, jadi kedua kondisi memerlukan waktu agar respons BOLD terbentuk sebelum mereka menyimpang. Arsiran fill_between() membuat onset dan puncak penyimpangan terlihat jelas.
Langkah terakhir ini membungkus logika inferensi dan visualisasi dalam aplikasi Gradio dengan UI yang bersih, penggeser timestep, dan tab perbandingan A/B.
import gradio as gr
_pred_cache = {}
def _infer(mod, vid, aud, txt):
    """Run inference and cache the result. Subsequent calls return cached array."""
    key = (mod, vid, aud, hash(txt or ''))
    if key not in _pred_cache:
        if mod == 'video':
            evts = model.get_events_dataframe(video_path=vid)
        elif mod == 'audio':
            evts = model.get_events_dataframe(audio_path=aud)
        else:
            tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
            tmp.write((txt or '').strip()); tmp.flush()
            os.fsync(tmp.fileno()); tmp.close()
            evts = model.get_events_dataframe(text_path=tmp.name)
            os.unlink(tmp.name)
        p, _ = model.predict(events=evts)
        _pred_cache[key] = np.asarray(p)
    return _pred_cache[key]
demo.launch(
    share      = True,
    debug      = False,
    server_name= "0.0.0.0",
)
Berikut cara UI Gradio dan pipeline inferensi berpadu:
Fungsi _infer() bertindak sebagai lapisan inferensi pusat, menangani ketiga modalitas (video, audio, dan teks) dengan menyiapkan masukan, memanggil model.predict(), dan mengembalikan aktivitas otak yang diprediksi.
Cache prediksi digunakan untuk menyimpan hasil berdasarkan kunci yang terdiri dari modalitas, path masukan, dan hash teks. Ini memastikan masukan yang identik tidak memicu inferensi model berulang.
Mekanisme caching krusial karena komponen UI seperti penggeser sering memicu callback. Tanpa caching, setiap interaksi akan menjalankan inferensi ulang (memakan waktu hingga ~60 detik), sedangkan dengan caching, hasil dikembalikan seketika setelah jalan pertama.
Antarmuka menyediakan dua tab, satu dengan mode masukan tunggal dengan penggeser timestep untuk menjelajahi aktivitas otak dari waktu ke waktu, dan mode perbandingan yang menjalankan dua masukan dan memvisualisasikan perbedaannya sebagai peta panas kontras.
Terakhir, demo.launch() dikonfigurasi dengan share=True untuk menghasilkan URL publik dan server_name="0.0.0.0" untuk memungkinkan akses eksternal, sehingga aplikasi mudah dipasang.
Setelah menjalankan demo pada berbagai masukan (video, audio, dan teks), beberapa pola konsisten muncul yang membantu menafsirkan keluaran TRIBE v2. Beberapa wawasan dari demo adalah:
Model ini tidak mengklaim 100% akurat, dan memiliki kekurangan tersendiri:
TRIBE v2 adalah alat riset yang kuat, tetapi memiliki batasan penting yang memengaruhi cara keluarannya harus ditafsirkan. Memahami batasan ini penting sebelum menarik kesimpulan ilmiah atau klinis dari prediksi.
Dalam tutorial ini, kita membangun pipeline TRIBE v2 yang berfungsi di Google Colab A100: mulai dari menyelesaikan dua bug konkret (konflik versi NumPy 2.x dan batas waktu unduhan HuggingFace), menjalankan prediksi kortikal nyata, hingga memvisualisasikannya sebagai peta panas otak 3D interaktif dan menjalankan eksperimen perbandingan yang mereplikasi paradigma in-silico dari makalah.
Empat pelajaran rekayasa terpenting dari tutorial ini adalah:
Kunci NumPy ke <2.1 dan mulai ulang runtime sebelum memasang tribev2
Setel HF_HUB_DOWNLOAD_TIMEOUT=300 dan unduh pra-LLaMA dengan snapshot_download sebelum memanggil model.predict()
Selalu tulis → flush() → fsync() → close() berkas sementara sebelum meneruskan path-nya ke model
Cache prediksi dalam kamus, agar interaksi slider UI tidak pernah menjalankan ulang inferensi.
Dari sini, dua perluasan yang alami menonjol. Pertama adalah rangsangan yang lebih kaya: klip film nyata atau segmen podcast berdurasi 30–60 detik menghasilkan dinamika temporal dan pola spasial yang jauh lebih jelas daripada potongan teks pendek.
Kedua adalah fine-tuning individual: dengan ~1 jam data fMRI dari subjek tertentu, blok subjek TRIBE v2 dapat di-fine-tune dalam satu epoch untuk menghasilkan prediksi personal yang melampaui model rata-rata kelompok sebesar 2–4x menurut hasil makalah.
Notebook lengkap tersedia di repositori GitHub TRIBE v2. Makalahnya layak dibaca sepenuhnya, khususnya Bagian 2.5 (eksperimen visi in-silico) dan Bagian 2.8 (wawasan integrasi multimodal), yang menunjukkan kemungkinan yang dihadirkan perangkat semacam ini bagi riset ilmu saraf.
Kursus Deep Learning
Program
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt