Program
Derin Öğrenme Python'da
18 sa
TRIBE v2 (TRImodal Brain Encoder), doğal uyaranları tahmin edilen fMRI beyin tepkilerine eşleyen bir derin öğrenme modelidir. Bir video klip, bir ses dosyası veya bir metin bloğu verildiğinde, model fsaverage5 kortikal yüzeyindeki 20.484 tepe noktası için 1 Hz’de, yani saniyede bir tahmin olmak üzere, BOLD sinyali çıktısı üretir.
Tahminler ortalama denek içindir (belirli bir kişinin beyni için değil), fakat TRIBE v2’nin dört doğal veri kümesinde 720 katılımcıdan öğrendiği kanonik grup ortalaması yanıtıdır. Modelin sıfır atış (zero-shot) tahminleri, eğitim setindeki en yüksek sinyal kalitesine sahip Human Connectome Project 7T veri kümesinde tek-denek fMRI kayıtlarından daha iyi performans gösterir.
|
Özellik |
Ayrıntı |
|
Çıktı uzayı |
fsaverage5 yüzeyindeki 20.484 kortikal tepe noktası ve tüm beyinde yaklaşık 70.000 voksel (korteks + subkorteks) boyunca tahminler |
|
Zamansal çözünürlük |
1 Hz (fMRI TR frekansıyla eşleşir) |
|
Girdi kipleri |
Video (V-JEPA2-Giant), Ses (Wav2Vec-BERT 2.0), Metin (LLaMA 3.2-3B) |
|
Kodlayıcı parametreleri |
~1B öğrenilebilir parametre, dönüştürücü (transformer) entegrasyon katmanında |
|
Eğitim verisi |
4 veri kümesinde 720 denek üzerinden 1.115 saat fMRI |
|
Genelleme |
Yeni deneklere, görevlere ve dillere sıfır atış |
|
Lisans |
CC-BY-NC 4.0 (araştırma kullanımı, ticari olmayan) |
Model, A foundation model of vision, audition, and language for in-silico neuroscience adlı makaleden uyarlanmıştır; bu çalışma, TRIBE v2’nin, yüzler için fusiform yüz alanını, sahneler için parahipokampal yer alanını, karmaşık sözdizimi için Broca alanını ve konuşma için sol lateralize dil ağını, çıkarım zamanında herhangi bir fMRI verisi olmadan geri kazandığını göstermektedir.
TRIBE v2, her çıkarım çağrısında sıralı olarak çalışan üç aşamaya sahiptir:
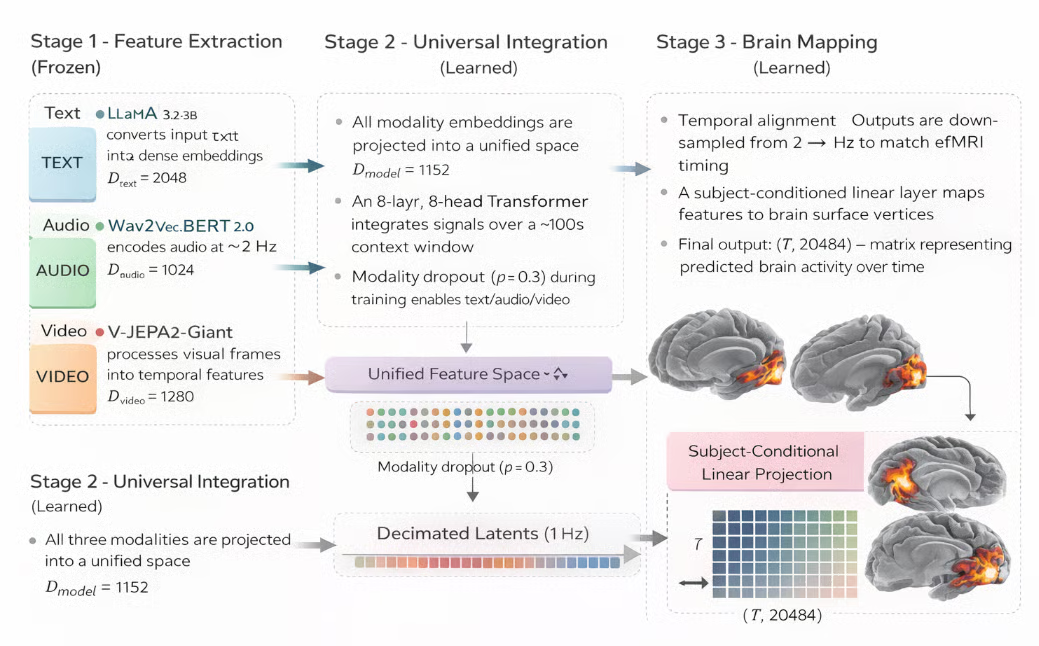
Şekil: TRIBE v2 beyin aktivitesi tahmin modeli (Yapay zekâ ile oluşturulmuştur)
Öncelikle üç ayrı, önceden eğitilmiş kodlayıcı, her bir girdi kipini bağımsız olarak yoğun ve zamana hizalı gömlemelere dönüştürür. Bu kodlayıcıların hiçbiri eğitim sırasında güncellenmez (dondurulmuştur), dolayısıyla TRIBE v2 bunların temsillerini olduğu gibi devralır. Her kip için öznitelik çıkarıma ilişkin bazı ölçütler:
Metin: LLaMA 3.2-3B, girdi metnini yoğun gömlemelere dönüştürür (D = 2048)
Ses: Wav2Vec-BERT 2.0, ses sinyallerini ~2 Hz’de kodlar (D = 1024)
Video: V-JEPA2-Giant, görsel kareleri zamansal özniteliklere dönüştürür (D = 1280)
Üç gömme akışı tek bir ortak temsilde birleştirilir ve zaman boyunca dikkat (attention) uygulayan bir Transformer tarafından işlenir. TRIBE v2’nin öğrenilmiş ağırlıkları burada bulunur ve kipler arası etkileşimler şu şekilde yakalanır:
Ortak temsil: Tüm kip gömmeleri birleşik bir uzaya yansıtılır (D_model = 1152)
Transformer füzyon: 8 katmanlı, 8 başlı bir Transformer, sinyalleri uzun (~100 sn) bir bağlam penceresinde entegre eder
Kip esnekliği: Kip düşürme (p = 0.3), herhangi bir alt kümeyle (metin/ses/video) çıkarıma olanak tanır
Birleştirilmiş gizil temsil, nihai fMRI tahminini üretmek için kortikal yüzeye yansıtılır. Bu aşama, soyut model özniteliklerini, mekânsal ve zamansal olarak çözülmüş beyin aktivitesi tahminlerine dönüştürür.
Üç öznitelik çıkarıcı eğitim sırasında dondurulduğundan, TRIBE v2 yalnızca bunların çıktılarını entegre eden projeksiyon katmanlarını ve dönüştürücü ağırlıklarını öğrenir. Bu tasarım seçimi önemlidir; çünkü modelin dağılım dışı uyaranlara karşı dayanıklı olduğu anlamına gelir; yalnızca fMRI verileriyle uçtan uca eğitilmek yerine, üç büyük ölçekli önceden eğitilmiş modelin genellemesini devralır.
Not: Önemli bir eğitim hilesi kip düşürmedir. Eğitim sırasında her kip, 0.3 olasılıkla bağımsız olarak sıfırlanır. Bu, modelin herhangi bir kip alt kümesinden anlamlı tahminler yapmaya zorlar. Dolayısıyla, çıkarım zamanında yalnızca ses veya yalnızca metin verebilir ve yine de faydalı bir kortikal tahmin alabilirsiniz.
Bu bölümde, TRIBE v2 çıkarımını metin, ses veya video girdileri üzerinde çalıştıran ve tahmin edilen kortikal aktiviteyi etkileşimli 3B beyin ısı haritası olarak görselleştiren adım adım bir iş akışı oluşturacağız. Ayrıca özgün makaledeki in-silico paradigmayı yineleyen bir karşılaştırma deneyi yürüteceğiz. Son olarak, herkesin canlı olarak demoyu keşfetmesi için bir Gradio uygulaması geliştireceğiz.
Başlamadan önce Colab çalışma zamanınızı yapılandırın. Yüksek RAM’li, kararlı bir A100 GPU’ya sahip herhangi bir hizmeti de kullanabileceğinizi unutmayın.
TRIBE v2, TRIBE dönüştürücü ağırlıklarının yanı sıra eşzamanlı olarak üç dondurulmuş kodlayıcıyı yükler: LLaMA 3.2-3B (~7 GB), V-JEPA2-Giant (~14 GB) ve Wav2Vec-BERT 2.0 (~1 GB). Toplam VRAM ayak izi 28–32 GB’dır.
Not: Bir T4 (16 GB), model.predict() LLaMA’yı yüklediğinde belleğin tükenecektir. Daha iyi performans için A100 (40 GB) veya Yüksek RAM’li A100 (80 GB) kullanın.
Herhangi bir şey yüklemeden önce aşağıdakileri çalıştırarak GPU’nuzu doğrulayın:
import subprocess, sys
result = subprocess.run(
    ['nvidia-smi', '--query-gpu=name,memory.total',
     '--format=csv,noheader,nounits'],
    capture_output=True, text=True)
print(result.stdout.strip())
import torch
assert torch.cuda.is_available(), "No GPU detected"
props = torch.cuda.get_device_properties(0)
assert props.total_memory > 30e9, (
    f"Need ≥40 GB VRAM. Got {props.total_memory/1e9:.0f} GB. Switch to A100.")
print(f"GPU: {props.name} — {props.total_memory/1e9:.0f} GB")
subprocess.run() çağrısı, GPU adını ve toplam VRAM’i çıkarmak için --query-gpu bayrağıyla nvidia-smi’yi çağırır. İki assert ifadesi erken çıkış görevi görür; ilki CUDA’nın kullanılabilir olduğunu doğrular, ikincisi ise toplam VRAM’in 30 GB’ı aştığını teyit eder. Burada net bir şekilde başarısız olmak, 10 dakika sonra model.predict() içinde anlaşılmaz bir CUDA bellek yetersizliği hatasıyla sessizce başarısız olmaktan daha iyidir.
Eğer bunu bir Google Colab’de çalıştırmıyorsanız bu adımı atlayın. Bu, karşılaşacağınız ilk hatadır; çünkü Colab varsayılan olarak NumPy 2.x ile gelir. TRIBE v2’nin dahili bağımlılıklarından bazıları, özellikle neuralset, NumPy <2.1 baz alınarak derlenmiştir ve bu sürümde numpy._core.umath içinden _center sembolü kaldırılmıştır. Sonuç olarak tribev2’yi import etmeye çalıştığınızda şu hatayı alırsınız:
ImportError
cannot import name '_center' from 'numpy._core.umath'
(/usr/local/lib/python3.12/dist-packages/numpy/_core/umath.py)
Düzeltme, tribev2 veya bağımlılıkları yüklenmeden önce NumPy’yi <2.1’e sabitlemek ve ardından çalışma zamanını yeniden başlatmaktır. Aşağıdaki hücreyi çalıştırmanız yeterlidir; bu, mevcut NumPy’yi kaldırır ve 2.1’in altındaki bir sürümle değiştirir.
import subprocess, sys
print("Pinning NumPy to <2.1 (required for neuralset compatibility)...")
subprocess.run([sys.executable, '-m', 'pip', 'uninstall', '-y', 'numpy'])
subprocess.run([sys.executable, '-m', 'pip', 'install', '-q',
                'numpy>=1.26.4,<2.1.0'])
Ortam ve bağımlılıklar kesinleştirildikten sonra TRIBE v2’yi yüklemeye devam edebiliriz.
Çekirdek taze bir şekilde yeniden başlatılıp sabitlenmiş NumPy yüklendikten sonra, GitHub’dan tribev2 paketini görselleştirme ve UI kitaplıklarıyla birlikte güvenle kurabiliriz.
import numpy as np
from packaging.version import Version
assert Version(np.__version__) < Version('2.1.0'), (
    f"NumPy is {np.__version__}. Run Step 2a and restart first.")
print(f"NumPy {np.__version__} Checked")
# Install tribev2 from GitHub
!pip install -q 'tribev2[plotting] @ git+https://github.com/facebookresearch/tribev2.git'
!pip install -q 'gradio>=4.19.0' 'nilearn>=0.10.3' 'plotly>=5.18.0'
tribev2[plotting] eki, çekirdek paketle birlikte 3B görselleştirme için Python kütüphanesi olan pyvista’yı ve nörogörüntüleme için Python kütüphanesi olan nilearn’ı kurar. Doğrudan GitHub URL’sinden kurmak, depoyu yerel olarak klonlamaya gerek kalmadan en son commit’i almanızı sağlar.
nilearn ve gradio paketleri ayrı kurulmuştur; çünkü sürüm kısıtları daha esnektir ve tribev2 bağımlılık grafiğinden bağımsız çözülmesi faydalıdır.
Metin kodlayıcı LLaMA 3.2-3B’yi kullanır; bu model HuggingFace üzerinde kısıtlıdır. Ağırlıklar indirilemeden önce Meta’nın lisansını açıkça kabul etmeniz gerekir. Bunu bir kez yapın:
HF belirteciniz ayarlandıktan sonra hesabınıza giriş yapmak için aşağıdaki kodu çalıştırın:
import os
# Load token from Colab Secrets
try:
    from google.colab import userdata
    os.environ['HF_TOKEN'] = userdata.get('HF_TOKEN')
    print("HF_TOKEN loaded from Colab Secrets")
except Exception:
    from huggingface_hub import login
    login()
Tercih edilen yol, Colab’in şifreli Secrets deposundan okuyan google.colab.userdata.get() kullanmaktır; bu depo, paylaşılan bir not defteri bağlantısında yanlışlıkla ifşa edilemez.
Geri dönüş yolu huggingface_hub.login() çağırır; bu, etkileşimli istemde belirteci girmenizi ister ve yazarken maskeler. Her iki yol da belirteci os.environ['HF_TOKEN']’a yazar; HuggingFace Hub kitaplığı, kısıtlı model ağırlıklarını indirirken bunu otomatik olarak alır.
NumPy sabitlendiğinde, kimlik doğrulaması yapılandırıldığında ve LLaMA önbelleğe alındığında, artık HuggingFace’den TRIBE v2 kodlayıcı kontrol noktasını yükleyebiliriz. Bu işlem ilk çalıştırmada yaklaşık 1 GB indirir ve sonraki çalıştırmalarda önbellekten birkaç saniye sürer.
from pathlib import Path
from tribev2.demo_utils import TribeModel
import torch
CACHE_DIR = Path('/content/tribe_cache')
CACHE_DIR.mkdir(exist_ok=True)
print('Loading TRIBE v2 (first run downloads ~1 GB)...')
model = TribeModel.from_pretrained(
    'facebook/tribev2',
    cache_folder=str(CACHE_DIR)
)
print('Model loaded')
if torch.cuda.is_available():
    used  = torch.cuda.memory_allocated() / 1e9
    total = torch.cuda.get_device_properties(0).total_memory / 1e9
print(f'VRAM after load: {used:.1f} / {total:.1f} GB')TribeModel.from_pretrained(), HuggingFace üzerindeki facebook/tribev2’den TRIBE kodlayıcı kontrol noktasını indirir ve cache_folder’a kaydeder. Bu kontrol noktası, dönüştürücü entegrasyon ağırlıklarını ve denek bloğunu içerir; ancak üç öznitelik çıkarıcıyı içermez. Bunlar, her kip ilk kez kullanıldığında model.predict() tarafından ayrı ayrı çekilir.
Sadece TRIBE kodlayıcı yüklendikten sonra yaklaşık 2–4 GB VRAM ayrılır; kalan 24–28 GB ise model.predict() V-JEPA2-Giant ve LLaMA 3.2-3B’yi ilk kullanımda yüklediğinde tüketilecektir.
TRIBE modeli yüklendikten sonra, metin girdisi üzerinde ilk kez model.predict() çağrısı yapmak, LLaMA 3.2-3B ağırlıklarının (~6 GB) tembel indirmesini tetikler. HuggingFace Hub’ın varsayılan zaman aşımı 10 saniyedir ve çıkarım ortasında şu hataya yol açar:
ReadTimeout
The read operation timed out
Computing word embeddings:  0%|  | 0/9 [00:10<?, ?it/s]
Bunu düzeltmek için zaman aşımı ortam değişkenlerini yükseltin ve ardından snapshot_download kullanarak LLaMA’yı önceden indirin; böylece görünür ilerleme ve kesinti durumunda otomatik devam elde edersiniz; predict() içinde gizli bir başarısızlık yerine.
import os
os.environ['HF_HUB_DOWNLOAD_TIMEOUT'] = '300'
os.environ['HF_HUB_HTTP_TIMEOUT']     = '300'
from huggingface_hub import snapshot_download
print("Pre-downloading LLaMA 3.2-3B (~6 GB)...")
print("Runs once — subsequent calls load from cache.\n")
snapshot_download(
    repo_id        = "meta-llama/Llama-3.2-3B",
    cache_dir      = "/content/tribe_cache/llama",
    ignore_patterns= ["*.bin"],
)
print("\n LLaMA 3.2-3B cached")snapshot_download(), HuggingFace’in aralık isteği protokolünü kullanarak tüm bir depoyu yerel önbelleğe indirir; bu, bağlantı dosyanın ortasında koparsa otomatik olarak devam edeceği anlamına gelir. ignore_patterns=["*.bin"] argümanı, daha eski PyTorch ikili biçimini atlar ve yalnızca safetensors dosyalarını indirir; bu da toplam indirme boyutunu yaklaşık %40 azaltır.
Gerçek çıkarımı çalıştırmadan önce görselleştirme katmanını kuruyoruz. Bu yardımcı işlevler, ham (T, 20484) tahmin dizisini nilearn kullanarak etkileşimli 3B beyin ısı haritalarına dönüştürür.
TRIBE v2, tahminleri (T, 20484) şeklinde bir NumPy dizisi olarak döndürür; burada T, girdi saniye sayısıdır. İlk 10.242 tepe noktası sol hemisferde, kalan 10.242 ise sağ hemisferdedir.
Her hemisferi etkileşimli bir WebGL yüzeyi olarak oluşturmak için nilearn.plotting.view_surf kullanırız. Şişirilmiş ağ, kıvrımlar içinde gizli kalacak sulkal geometrisini ortaya çıkarır ve sulkus derinlik haritası, ısı haritası altında anatomik referans sağlar.
fsaverage5 ağı, TRIBE v2’nin çıktı alanı olarak kullandığı standart FreeSurfer kortikal şablonudur. Bunu burada bir kez indiriyoruz; böylece sonraki tüm görselleştirme çağrıları, ağdan yeniden almak zorunda kalmadan buna başvurabilir.
import numpy as np
from nilearn import datasets as nl_datasets
from nilearn.plotting import view_surf
from IPython.display import display, HTML
N_PER_HEMI = 10242   # fsaverage5: 10242 vertices per hemisphere
print('Fetching fsaverage5 mesh...')
fsavg = nl_datasets.fetch_surf_fsaverage(mesh='fsaverage5')
print('Mesh ready')
print('Keys:', [k for k in fsavg.keys() if k != 'description']) fetch_surf_fsaverage(mesh='fsaverage5'), nilearn’ın CDN’inden FreeSurfer fsaverage5 şablonunu indirir ve önbelleğe alır. Ayrıca infl_left, infl_right, sulc_left ve sulc_right gibi anahtarları olan bir Bunch nesnesi (sözlük) döndürür.
Bu alt adım, bu eğitimdeki tüm görselleştirmelerin bağlı olduğu üç çekirdek işlevi tanımlar. split_hemis() işlevi tepe noktasını böler, render_hemi() bir hemisfer için etkileşimli WebGL yüzeyini oluşturur ve show_brain() ikisini yan yana düzende birleştirir.
def split_hemis(v):
    n = v.shape[0]
    if n == 2 * N_PER_HEMI:
        return v[:N_PER_HEMI], v[N_PER_HEMI:]
    return v[:n//2], v[n//2:]
def render_hemi(pred_vec, hemi='left', title=''):
    lh, rh = split_hemis(pred_vec)
    data = lh if hemi == 'left' else rh
    vmax = max(float(np.percentile(np.abs(data), 99)), 1e-6)
    return view_surf(
        surf_mesh = fsavg[f'infl_{hemi}'],
        surf_map  = data,
        bg_map    = fsavg[f'sulc_{hemi}'],
        hemi      = hemi,
        threshold = '20%',
        cmap      = 'hot',
        black_bg  = True,
        vmax      = vmax,
        bg_on_data= True,
        colorbar  = True,
        title     = title,
    )
def show_brain(pred_vec, title='', t=None):
    sfx = f' — t={t}s' if t is not None else ''
    lv  = render_hemi(pred_vec, 'left',  f'{title} [Left]{sfx}')
    rv  = render_hemi(pred_vec, 'right', f'{title} [Right]{sfx}')
    html = (
        '<div style="display:flex;gap:10px;background:#000;'
        'border-radius:10px;">'
        f'<div style="flex:1">{lv.get_iframe(width="100%",height="460px")}</div>'
        f'<div style="flex:1">{rv.get_iframe(width="100%",height="460px")}</div>'
        '</div>'
    )
    display(HTML(html))
Her yardımcı işlevin işlevini ayrıntılı olarak anlayalım:
split_hemis() işlevi, FreeSurfer kuralında fsaverage5 ağı için standart bölme noktası olan 10.242 indeksinde tahmin vektörünü dilimler. Sol hemisfer 0–10241 indekslerini, sağ hemisfer 10242–20483 indekslerini kaplar. Alttaki geri dönüş dalı, modelin standart olmayan tepe noktası sayısı döndürdüğü uç durumları ele alır.
render_hemi() işlevinin içinde, vmax gerçek maksimum yerine mutlak aktivasyon değerlerinin %99’luk yüzdelik dilimi olarak hesaplanır. Bu, tek bir aşırı tepe noktasının tüm renk haritasını dar bir aralığa sıkıştırmasını engeller ve mekânsal deseni görünür kılar.
view_surf() işlevi, 2,4 MB’lık bağımsız WebGL HTML içeren bir SurfaceView nesnesi döndürür. get_iframe() çağrısı bunu verilen boyutlarda bir <iframe> etiketi içinde sarmalar. Dolayısıyla iki iframe’i yan yana display(HTML(...)) ile çağırdığımızda, bölünmüş sol/sağ hemisfer düzeni üretilir.
Model yüklendi ve görselleştirme yardımcıları hazır olduğuna göre, ilk gerçek çıkarımı çalıştırabiliriz.
TRIBE v2’nin çıkarımı iki aşamalı bir süreçtir. Önce, model.get_events_dataframe() girdiden zamana hizalı olayları çıkarır; metinden sözcük zamanlamaları, sesten Wav2Vec gömmeleri 2 Hz’de, veya video karelerinden V-JEPA2 gömmeleri 2 Hz’de.
Ortaya çıkan olaylar DataFrame’i daha sonra model.predict()’e iletilir; bu, dönüştürücüyü ve denek bloğunu çalıştırarak nihai kortikal tahminleri üretir.
import tempfile, os
SAMPLE_TEXT = '''
The brain processes language through a distributed network in the left hemisphere.
Broca's area coordinates syntactic structure, while Wernicke's area handles semantics.
Together they form the language circuit activated when reading or hearing speech.
'''
tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
try:
    tmp.write(SAMPLE_TEXT.strip())
    tmp.flush()
    os.fsync(tmp.fileno())
    tmp.close()
    events = model.get_events_dataframe(text_path=tmp.name)
finally:
    if os.path.exists(tmp.name):
        os.unlink(tmp.name)
print(f'Events: {events.shape}')
print(events[['type', 'start', 'duration']].head(8))
print('\nRunning model.predict()...')
preds, segments = model.predict(events=events)
preds = np.asarray(preds)
print(f'Prediction shape: {preds.shape}')
print(f'  T = {preds.shape[0]}s   (1 Hz fMRI frequency)')
print(f' V = {preds.shape[1]} vertices (fsaverage5 cortical surface)') tmp.write(), tmp.flush(), os.fsync(tmp.fileno()), tmp.close() yazma dizisi, ince bir hata için kritik düzeltmedir. Dosya kapatılmadan bir with bloğu içinde get_events_dataframe() çağrısı yaparsanız, Python’un dahili yazma arabelleği henüz işletim sistemine senkronize edilmemiş olabilir ve tribev2 yolu okurken boş bir dosya okuyup ValueError yükseltebilir. os.fsync() çağrısı, tribev2 yolu açmadan önce işletim sistemi sayfa önbelleğinin diske yazıldığını garanti eder.
model.predict() bir (preds, segments) demeti döndürür. preds dizisi, tüm 20.484 fsaverage5 tepe noktası boyunca girdi başına saniyede bir kortikal tahmini temsil eden (T, 20484) şekline sahiptir. np.asarray() ile sarmalamak, modelin döndürdüğü dahili tür ne olursa olsun düz bir NumPy dizisi olmasını sağlar. preds’i aldıktan sonra, herhangi bir zaman adımında kortikal yanıtı görselleştirebilirsiniz:
T = preds.shape[0]
print(f'Timesteps: 0 to {T-1}')
T_SHOW = min(5, T - 1)
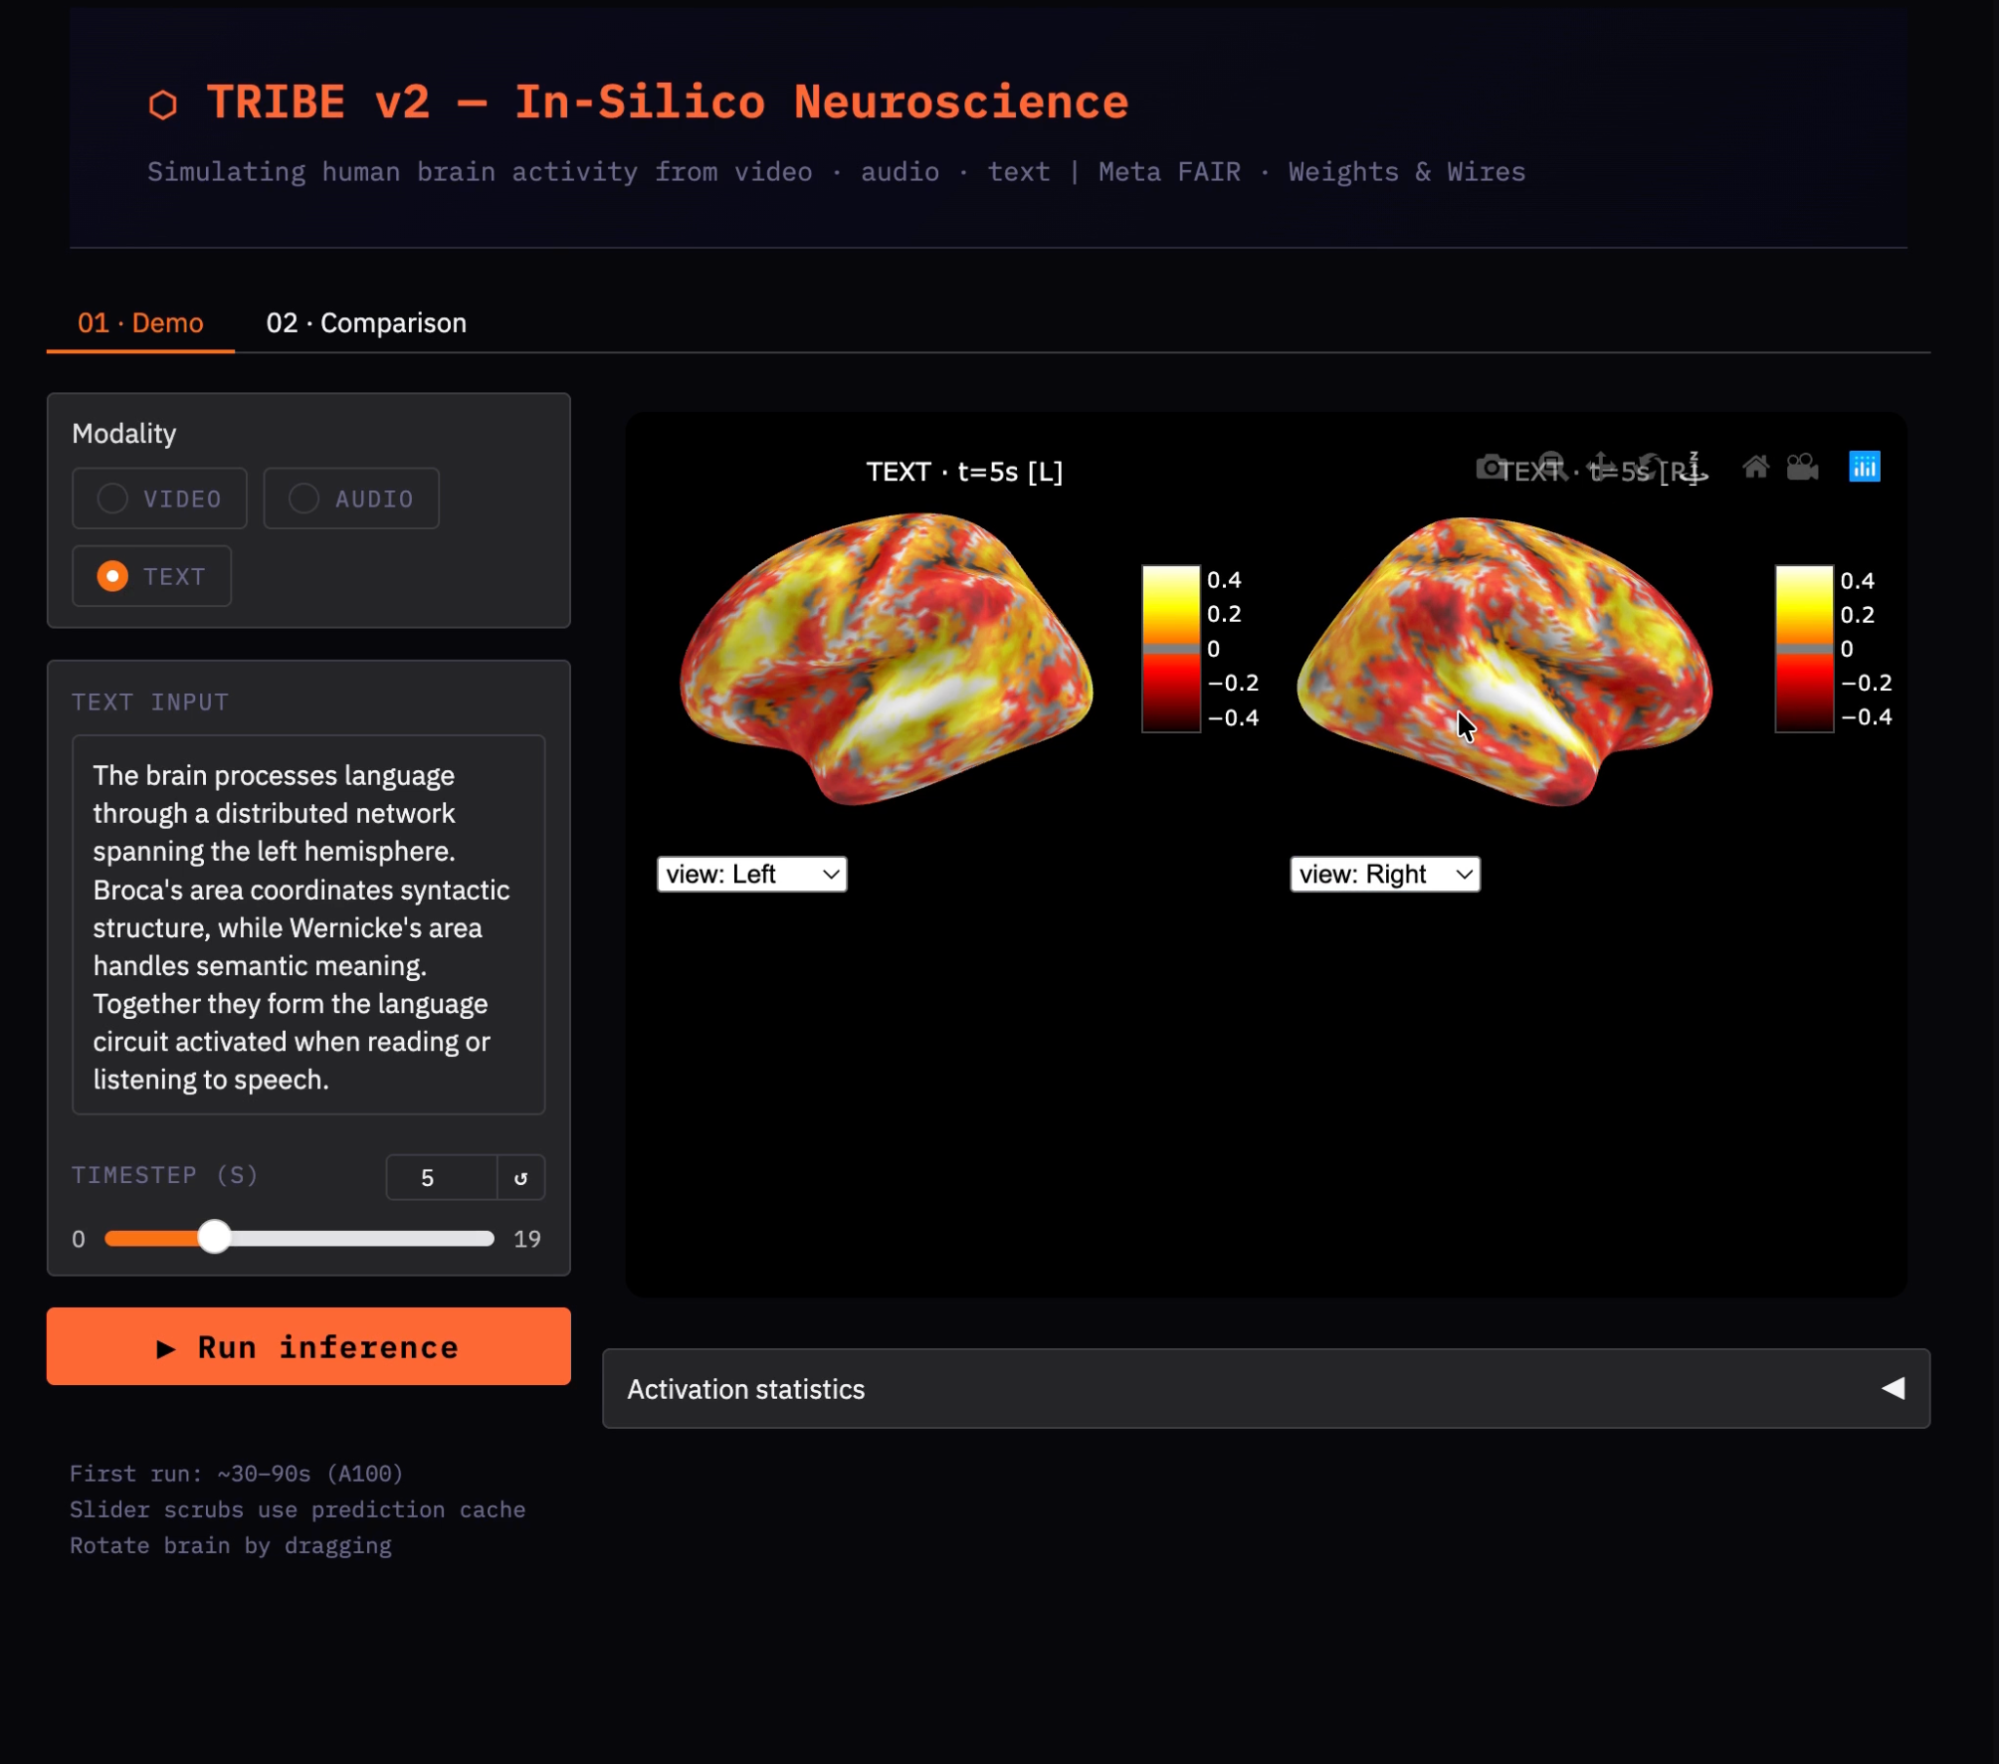
show_brain(preds[T_SHOW], title='Language stimulus', t=T_SHOW)
Varsayılan olarak t=5 kullanırız; çünkü BOLD (Blood-Oxygen-Level-Dependent) sinyali hemodinamik bir gecikmeye sahiptir ve damar yanıtı, uyaran başlangıcından yaklaşık 5–6 saniye sonra zirve yapar. t=0’da görselleştirmek, uyaran içeriğinden bağımsız olarak sıfıra yakın aktivite gösterir; çünkü beynin damar yanıtı henüz oluşmamıştır. min(5, T-1) koruması, girdinin 6’dan az zaman adımı üretmesi durumunda indeks hatasını engeller.
Tek bir aktivasyon haritası size hangi alanların etkin olduğunu söyler; ancak bir uyaranı diğerinden neyin ayırdığını söylemez. Bu adım, modele iki girdi gönderir ve dil içeriği ile görsel/uzamsal içerik arasındaki bölgeye özgü farklılıkları izole etmek için bir karşıtlık haritası (A − B) hesaplar.
Her koşul için yaz → temizle → kapat → çıkarım desenini tekrarlamak yerine, bunu tek bir text_to_preds() işlevinde sarıyoruz. Bu, kritik dosya temizleme adımlarının her iki koşul için de asla yanlışlıkla atlanmamasını sağlar.
TEXT_A = '''
She spoke slowly and clearly, her voice filling the quiet room.
Every sentence carried meaning, and each word was chosen with care.
Language connects us, the professor said, bridging minds across time.
'''
TEXT_B = '''
The canyon walls rose steeply, layers of red and orange sandstone.
A hawk circled overhead, its wings barely moving in the thermal current.
Shadows shifted as the sun tracked its arc across the open desert sky.
'''
def text_to_preds(text):
    tmp = tempfile.NamedTemporaryFile(
        delete=False, suffix='.txt', mode='w', encoding='utf-8')
    try:
        tmp.write(text.strip())
        tmp.flush()
        os.fsync(tmp.fileno())
        tmp.close()
        evts = model.get_events_dataframe(text_path=tmp.name)
        p, _ = model.predict(events=evts)
        return np.asarray(p)
    finally:
        if os.path.exists(tmp.name):
            os.unlink(tmp.name)
print('Condition A: language content...')
preds_a = text_to_preds(TEXT_A)
print('Condition B: visual/spatial content...')
preds_b = text_to_preds(TEXT_B)
Anlamsal içeriği farklı iki metin parçası kullanıyoruz; beklenen bulgu, dil içeriğinin sol hemisfer temporal korteksi daha fazla harekete geçirmesi, görsel/uzamsal içeriğin ise oksipital ve arka parietal korteksi daha fazla devreye sokmasıdır.
text_to_preds() işlevi, tam hattı tek bir yeniden kullanılabilir işlevde kapsüller; geçici dosyanın tribev2 tarafından okunmadan önce tamamen temizlenmesini sağlamak için Adım 8’deki aynı güvenli deseni uygular. encoding='utf-8' argümanı, platforma bağlı kodlama sorunlarından kaçınmak için açıktır.
Her iki koşul da tahmin edildiğine göre, her birini tek tek görselleştiriyor ve ardından tepe noktasına göre çıkarıp karşıtlık haritasını üretiyoruz.
T_shared = min(preds_a.shape[0], preds_b.shape[0])
t_show   = min(5, T_shared - 1)
print('\n[A] Language content:')
show_brain(preds_a[t_show], title='Condition A: Language', t=t_show)
print('\n[B] Visual/spatial content:')
show_brain(preds_b[t_show], title='Condition B: Visual', t=t_show)
print('\n[A − B] Contrast: Language > Visual')
show_brain(preds_a[t_show] - preds_b[t_show], title='Contrast A − B', t=t_show)
preds_a[t_show] - preds_b[t_show] karşıtlık haritası, pozitif değerlerin A koşulunun daha fazla etkinleştirdiği bölgeleri, negatif değerlerin ise B koşulunun daha fazla etkinleştirdiği bölgeleri gösterdiği doğrudan tepe-nokta bazlı bir çıkarmadır.
Her iki koşul da aynı metin işleme yolunu paylaştığından, ham haritalar genel olarak benzer görünecektir. Bu karşıtlık haritası, dil ve görsel içerik arasında alana özgü farklılıkları vurgular.
Beyin ısı haritaları, tek bir anda mekânsal desenleri gösterir. Bu adım zamansal bir bakış açısı ekler: Örneğin, tüm zaman adımlarında koşullar arasında genel aktivasyon nasıl karşılaştırılır ve iki koşul ne zaman en güçlü şekilde ayrışır?
import matplotlib.pyplot as plt
diff_norms = [
    np.linalg.norm(preds_a[i] - preds_b[i])
    for i in range(T_shared)
]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 3.5))
ax1.plot(np.abs(preds_a).mean(axis=1)[:T_shared],
         color='#e74c3c', linewidth=2, label='A: Language')
ax1.plot(np.abs(preds_b).mean(axis=1)[:T_shared],
         color='#3498db', linewidth=2, label='B: Visual')
ax1.set_title('Mean cortical activation over time')
ax1.set_xlabel('Time (s)'); ax1.legend(); ax1.grid(True, alpha=0.3)
ax2.plot(diff_norms, color='#f39c12', linewidth=2)
ax2.fill_between(range(T_shared), diff_norms, alpha=0.2, color='#f39c12')
ax2.set_title('||A − B|| difference over time')
ax2.set_xlabel('Time (s)'); ax2.grid(True, alpha=0.3)
plt.tight_layout(); plt.show()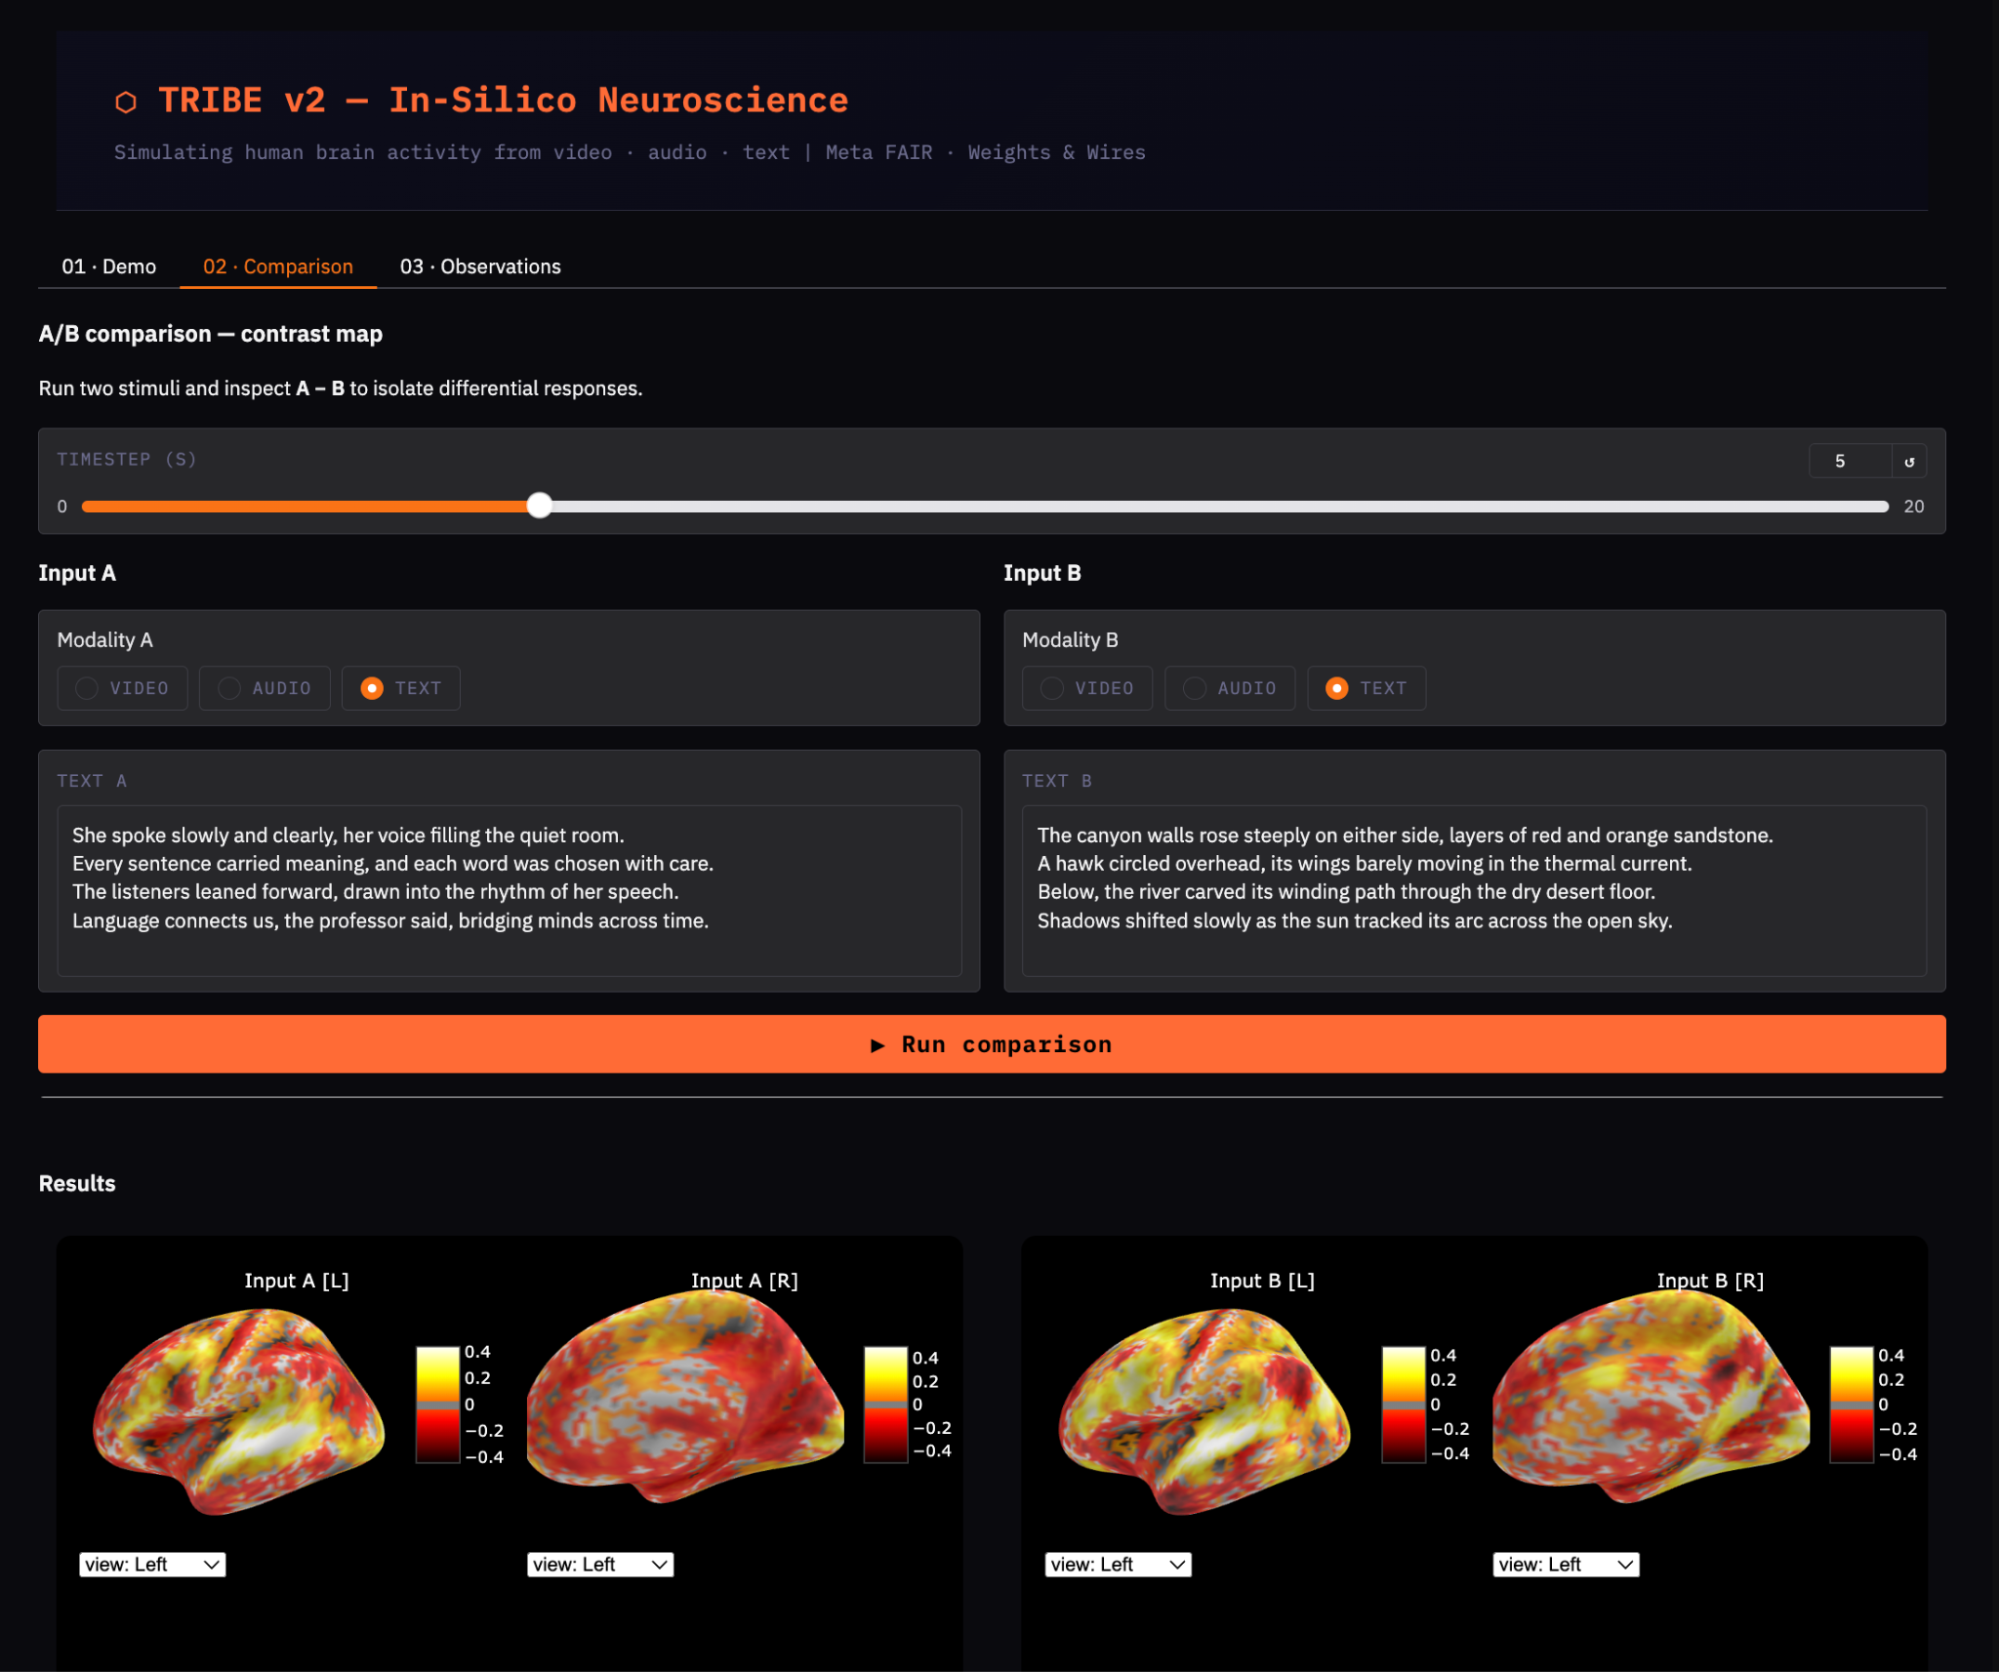
Sol grafik, her saniyede tüm 20.484 tepe noktası boyunca çöktürülmüş ortalama mutlak aktivasyon olan np.abs(preds).mean(axis=1)’i izler. Bu, her koşulun korteksi ne kadar güçlü devreye soktuğunu ve yanıtın ne zaman zirve yaptığını gösterir. Mutlak değeri almak önemlidir; çünkü tahmin edilen BOLD değerleri negatif (deaktivasyon) olabilir ve biz işaretli ortalama yerine büyüklüğü istiyoruz.
Sağ grafik, her zaman adımındaki fark vektörünün L2 normunu izler, np.linalg.norm(preds_a[i] - preds_b[i]). Bu eğride t=5–7 sn civarında bir zirve, hemodinamik gecikme ile tutarlıdır; bu nedenle her iki koşulun da ayrışmadan önce BOLD yanıtının oluşması için zamana ihtiyacı vardır. fill_between() taraması, ayrışmanın başlangıcını ve zirvesini görsel olarak belirgin kılar.
Bu son adım, çıkarım ve görselleştirme mantığını, temiz bir kullanıcı arayüzü, bir zaman adımı kaydırıcısı ve bir A/B karşılaştırma sekmesiyle bir Gradio uygulamasında sarar.
import gradio as gr
_pred_cache = {}
def _infer(mod, vid, aud, txt):
    """Run inference and cache the result. Subsequent calls return cached array."""
    key = (mod, vid, aud, hash(txt or ''))
    if key not in _pred_cache:
        if mod == 'video':
            evts = model.get_events_dataframe(video_path=vid)
        elif mod == 'audio':
            evts = model.get_events_dataframe(audio_path=aud)
        else:
            tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
            tmp.write((txt or '').strip()); tmp.flush()
            os.fsync(tmp.fileno()); tmp.close()
            evts = model.get_events_dataframe(text_path=tmp.name)
            os.unlink(tmp.name)
        p, _ = model.predict(events=evts)
        _pred_cache[key] = np.asarray(p)
    return _pred_cache[key]
demo.launch(
    share      = True,
    debug      = False,
    server_name= "0.0.0.0",
)
Gradio UI’nin ve çıkarım hattının nasıl bir araya geldiği şöyledir:
_infer() işlevi, girişleri hazırlayarak, model.predict() çağrısı yaparak ve tahmin edilen beyin aktivitesini döndürerek üç kipin (video, ses ve metin) tümünü yöneten merkezi çıkarım katmanı olarak görev yapar.
Bir tahmin önbelleği, kip, giriş yolları ve metnin bir karmasından oluşan bir anahtara göre sonuçları depolamak için kullanılır. Bu, özdeş girişlerin yinelenen model çıkarımını tetiklememesini sağlar.
Önbellekleme mekanizması kritiktir; çünkü kaydırıcılar gibi UI bileşenleri sık sık geri çağırmaları tetikler. Önbellekleme olmadan her etkileşim çıkarımı yeniden çalıştırırdı (yaklaşık ~60 saniye sürer); önbellekle birlikte ilk çalıştırmadan sonra sonuçlar anında döndürülür.
Arayüz, zaman içinde beyin aktivitesini keşfetmek için bir zaman adımı kaydırıcısına sahip tek girişli bir mod ve iki girdiyi çalıştırıp farklarını bir karşıtlık ısı haritası olarak görselleştiren bir karşılaştırma modu olmak üzere iki sekme sunar.
Son olarak, demo.launch(), share=True ile herkese açık bir URL oluşturacak ve server_name="0.0.0.0" ile harici erişime izin verecek şekilde yapılandırılmıştır; böylece uygulama kolayca dağıtılabilir.
Farklı girdiler (video, ses ve metin) boyunca demoyu çalıştırdıktan sonra, TRIBE v2’nin çıktılarının yorumlanmasına yardımcı olan bazı tutarlı desenler ortaya çıkar. Demodan bazı içgörüler:
Modelin %100 doğru olma iddiası yoktur ve kendine özgü tuzakları vardır:
TRIBE v2 güçlü bir araştırma aracıdır; ancak çıktıların nasıl yorumlanacağını etkileyen önemli sınırlamaları vardır. Bu sınırlamaları anlamak, tahminlerden bilimsel veya klinik sonuçlar çıkarmadan önce elzemdir.
Bu eğitimde, Google Colab A100 üzerinde çalışan bir TRIBE v2 hattı kurduk: iki somut hatayı (NumPy 2.x sürüm çakışması ve HuggingFace indirme zaman aşımı) çözmekten gerçek kortikal tahminler çalıştırmaya, bunları etkileşimli 3B beyin ısı haritaları olarak görselleştirmeye ve makaledeki in-silico paradigmayı yineleyen bir karşılaştırma deneyi yürütmeye kadar.
Bu eğitimden çıkarılacak en önemli dört mühendislik dersi şunlardır:
tribev2 yüklenmeden önce NumPy’yi <2.1’e sabitleyin ve çalışma zamanını yeniden başlatın
model.predict() çağrılmadan önce HF_HUB_DOWNLOAD_TIMEOUT=300 ayarlayın ve LLaMA’yı snapshot_download ile önden indirin
Geçici dosyaları modele yolunu vermeden önce her zaman yaz → flush() → fsync() → close() sırasını izleyin
Tahminleri bir sözlükte önbelleğe alın; böylece UI kaydırıcı etkileşimleri asla tekrar çıkarım çalıştırmasın.
Buradan iki doğal genişleme öne çıkıyor. İlki daha zengin uyaranlar: 30–60 saniyeyi kapsayan gerçek film klipleri veya podcast bölümleri, kısa metin pasajlarına kıyasla çok daha net zamansal dinamikler ve mekânsal desenler üretir.
İkincisi bireysel ince ayar: Belirli bir denekten yaklaşık 1 saatlik fMRI verisi verildiğinde, TRIBE v2’nin denek bloğu tek bir epokta ince ayarlanabilir ve makaledeki sonuçlara göre grup ortalaması modelinden 2–4x daha iyi kişiselleştirilmiş tahminler üretebilir.
Tam not defteri TRIBE v2 GitHub deposunda mevcuttur. Makale, özellikle Bölüm 2.5 (in-silico görsel deneyler) ve Bölüm 2.8 (çok kipli entegrasyon içgörüleri) tam okunmaya değerdir; bu, bu tür araçların sinirbilim araştırmaları için neleri mümkün kıldığını gösterir.
Derin Öğrenme Kursları
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.