Leerpad
Deep learning in Python
18 uur
TRIBE v2 (TRImodal Brain Encoder) is een deep learning-model dat naturalistische stimuli projecteert op voorspelde fMRI-hersenresponsen. Bij een videofragment, audiobestand of stuk tekst geeft het model een voorspelde BOLD-signaalwaarde voor elk van de 20.484 vertices op het fsaverage5-corticale oppervlak met 1 Hz, oftewel één voorspelling per seconde.
De voorspellingen zijn voor de gemiddelde proefpersoon (niet voor één specifiek brein), namelijk de canonieke groepsgemiddelde respons die TRIBE v2 leerde van 720 deelnemers over vier naturalistische datasets. De zero-shot-voorspellingen van het model presteren beter dan single-subject fMRI-opnames van de Human Connectome Project 7T-dataset, die de hoogste signaalkwaliteit in de trainingsset heeft.
|
Eigenschap |
Detail |
|
Output-ruimte |
20.484 corticale vertices op het fsaverage5-oppervlak en voorspellingen voor het hele brein over ongeveer 70.000 voxels (cortex + subcortex) |
|
Tijdresolutie |
1 Hz (komt overeen met fMRI TR-frequentie) |
|
Inputmodaliteiten |
Video (V-JEPA2-Giant), Audio (Wav2Vec-BERT 2.0), Tekst (LLaMA 3.2-3B) |
|
Encoderparameters |
~1B leerbare parameters in de transformer-integratielaag |
|
Trainingsdata |
1.115 uur aan fMRI van 720 proefpersonen over 4 datasets |
|
Generaliseerbaarheid |
Zero-shot naar nieuwe proefpersonen, taken en talen |
|
Licentie |
CC-BY-NC 4.0 (onderzoek, niet-commercieel) |
Het model is afgeleid van het paper A foundation model of vision, audition, and language for in-silico neuroscience, waarin wordt aangetoond dat TRIBE v2 de fusiform face area voor gezichten, de parahippocampale plaatsarea voor scenes, Broca's gebied voor complexe syntaxis en het links-lateralisatie taalnetwerk voor spraak herstelt, zonder enige fMRI-data tijdens inferentie.
TRIBE v2 heeft drie fasen die sequentieel draaien bij elke inferentieaanroep:
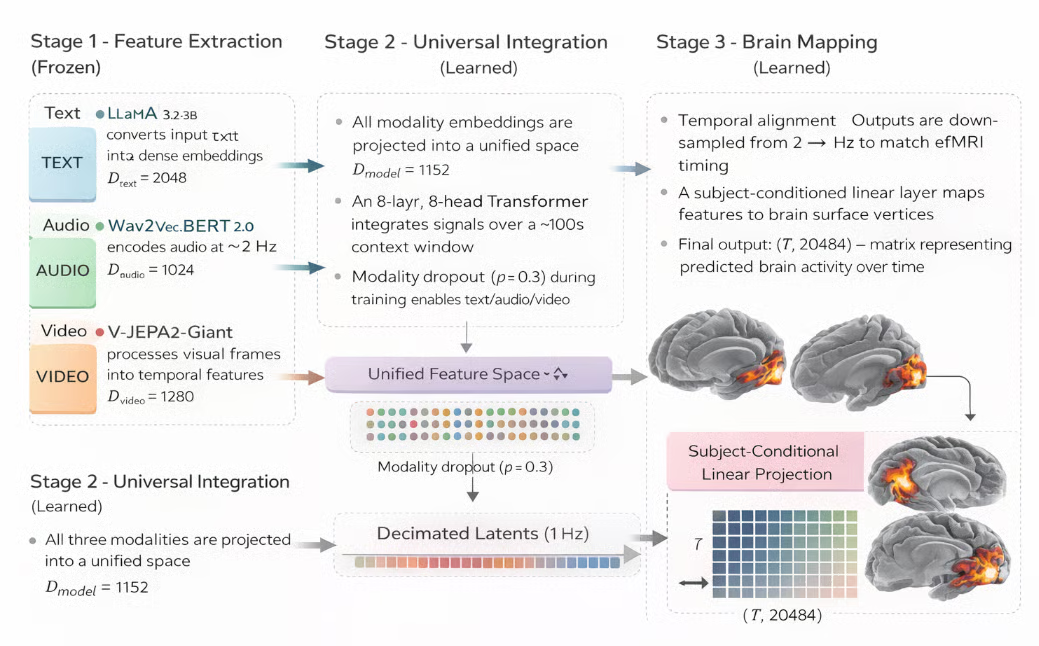
Figuur: TRIBE v2-model voor voorspelling van hersenactiviteit (Gegenereerd met AI)
Allereerst verwerken drie afzonderlijke voorgetrainde encoders onafhankelijk elke inputmodaliteit tot dichte, tijd-omlijnde embeddings. Geen van deze encoders wordt tijdens het trainen geüpdatet (bevroren), dus TRIBE v2 erft hun representaties zoals ze zijn. Dit zijn enkele metrics voor feature-extractie per modaliteit:
Tekst: LLaMA 3.2-3B zet invoertekst om in dichte embeddings (D = 2048)
Audio: Wav2Vec-BERT 2.0 encodeert audiosignalen op ~2 Hz (D = 1024)
Video: V-JEPA2-Giant verwerkt visuele frames tot temporele features (D = 1280)
De drie embeddingstromen worden samengevoegd tot één gedeelde representatie en verwerkt door een Transformer die over de tijd attend. Hier zitten de geleerde gewichten van TRIBE v2 en worden cross-modale interacties vastgelegd, als volgt:
Gedeelde representatie: Alle modaliteits-embeddings worden geprojecteerd in een uniform ruimte (D_model = 1152)
Transformer-fusie: Een 8-laags, 8-head Transformer integreert signalen over een lange (~100s) contextwindow
Modaliteitsflexibiliteit: Modality dropout (p = 0.3) maakt inferentie met elke subset (tekst/audio/video) mogelijk
De gefuseerde latente representatie wordt geprojecteerd op het corticale oppervlak om de uiteindelijke fMRI-voorspelling te produceren. Deze fase zet abstracte modelfeatures om in ruimtelijk en temporeel opgeloste schattingen van hersenactiviteit.
Omdat de drie feature-extractors bevroren zijn tijdens het trainen, leert TRIBE v2 alleen de projectielagen en transformergewichten die hun outputs integreren. Deze ontwerpkeuze is belangrijk omdat het model daardoor robuust is voor out-of-distribution stimuli: het erft de generalisatie van drie grootschalig voorgetrainde modellen, in plaats van end-to-end alleen op fMRI-data te zijn getraind.
Let op: een belangrijke trainingstruc is modality dropout. Tijdens het trainen wordt elke modaliteit onafhankelijk op nul gezet met kans 0,3. Dit dwingt het model om betekenisvolle voorspellingen te doen vanuit elke subset aan modaliteiten. Dus kun je tijdens inferentie alleen audio of alleen tekst doorgeven en alsnog een bruikbare corticale voorspelling krijgen.
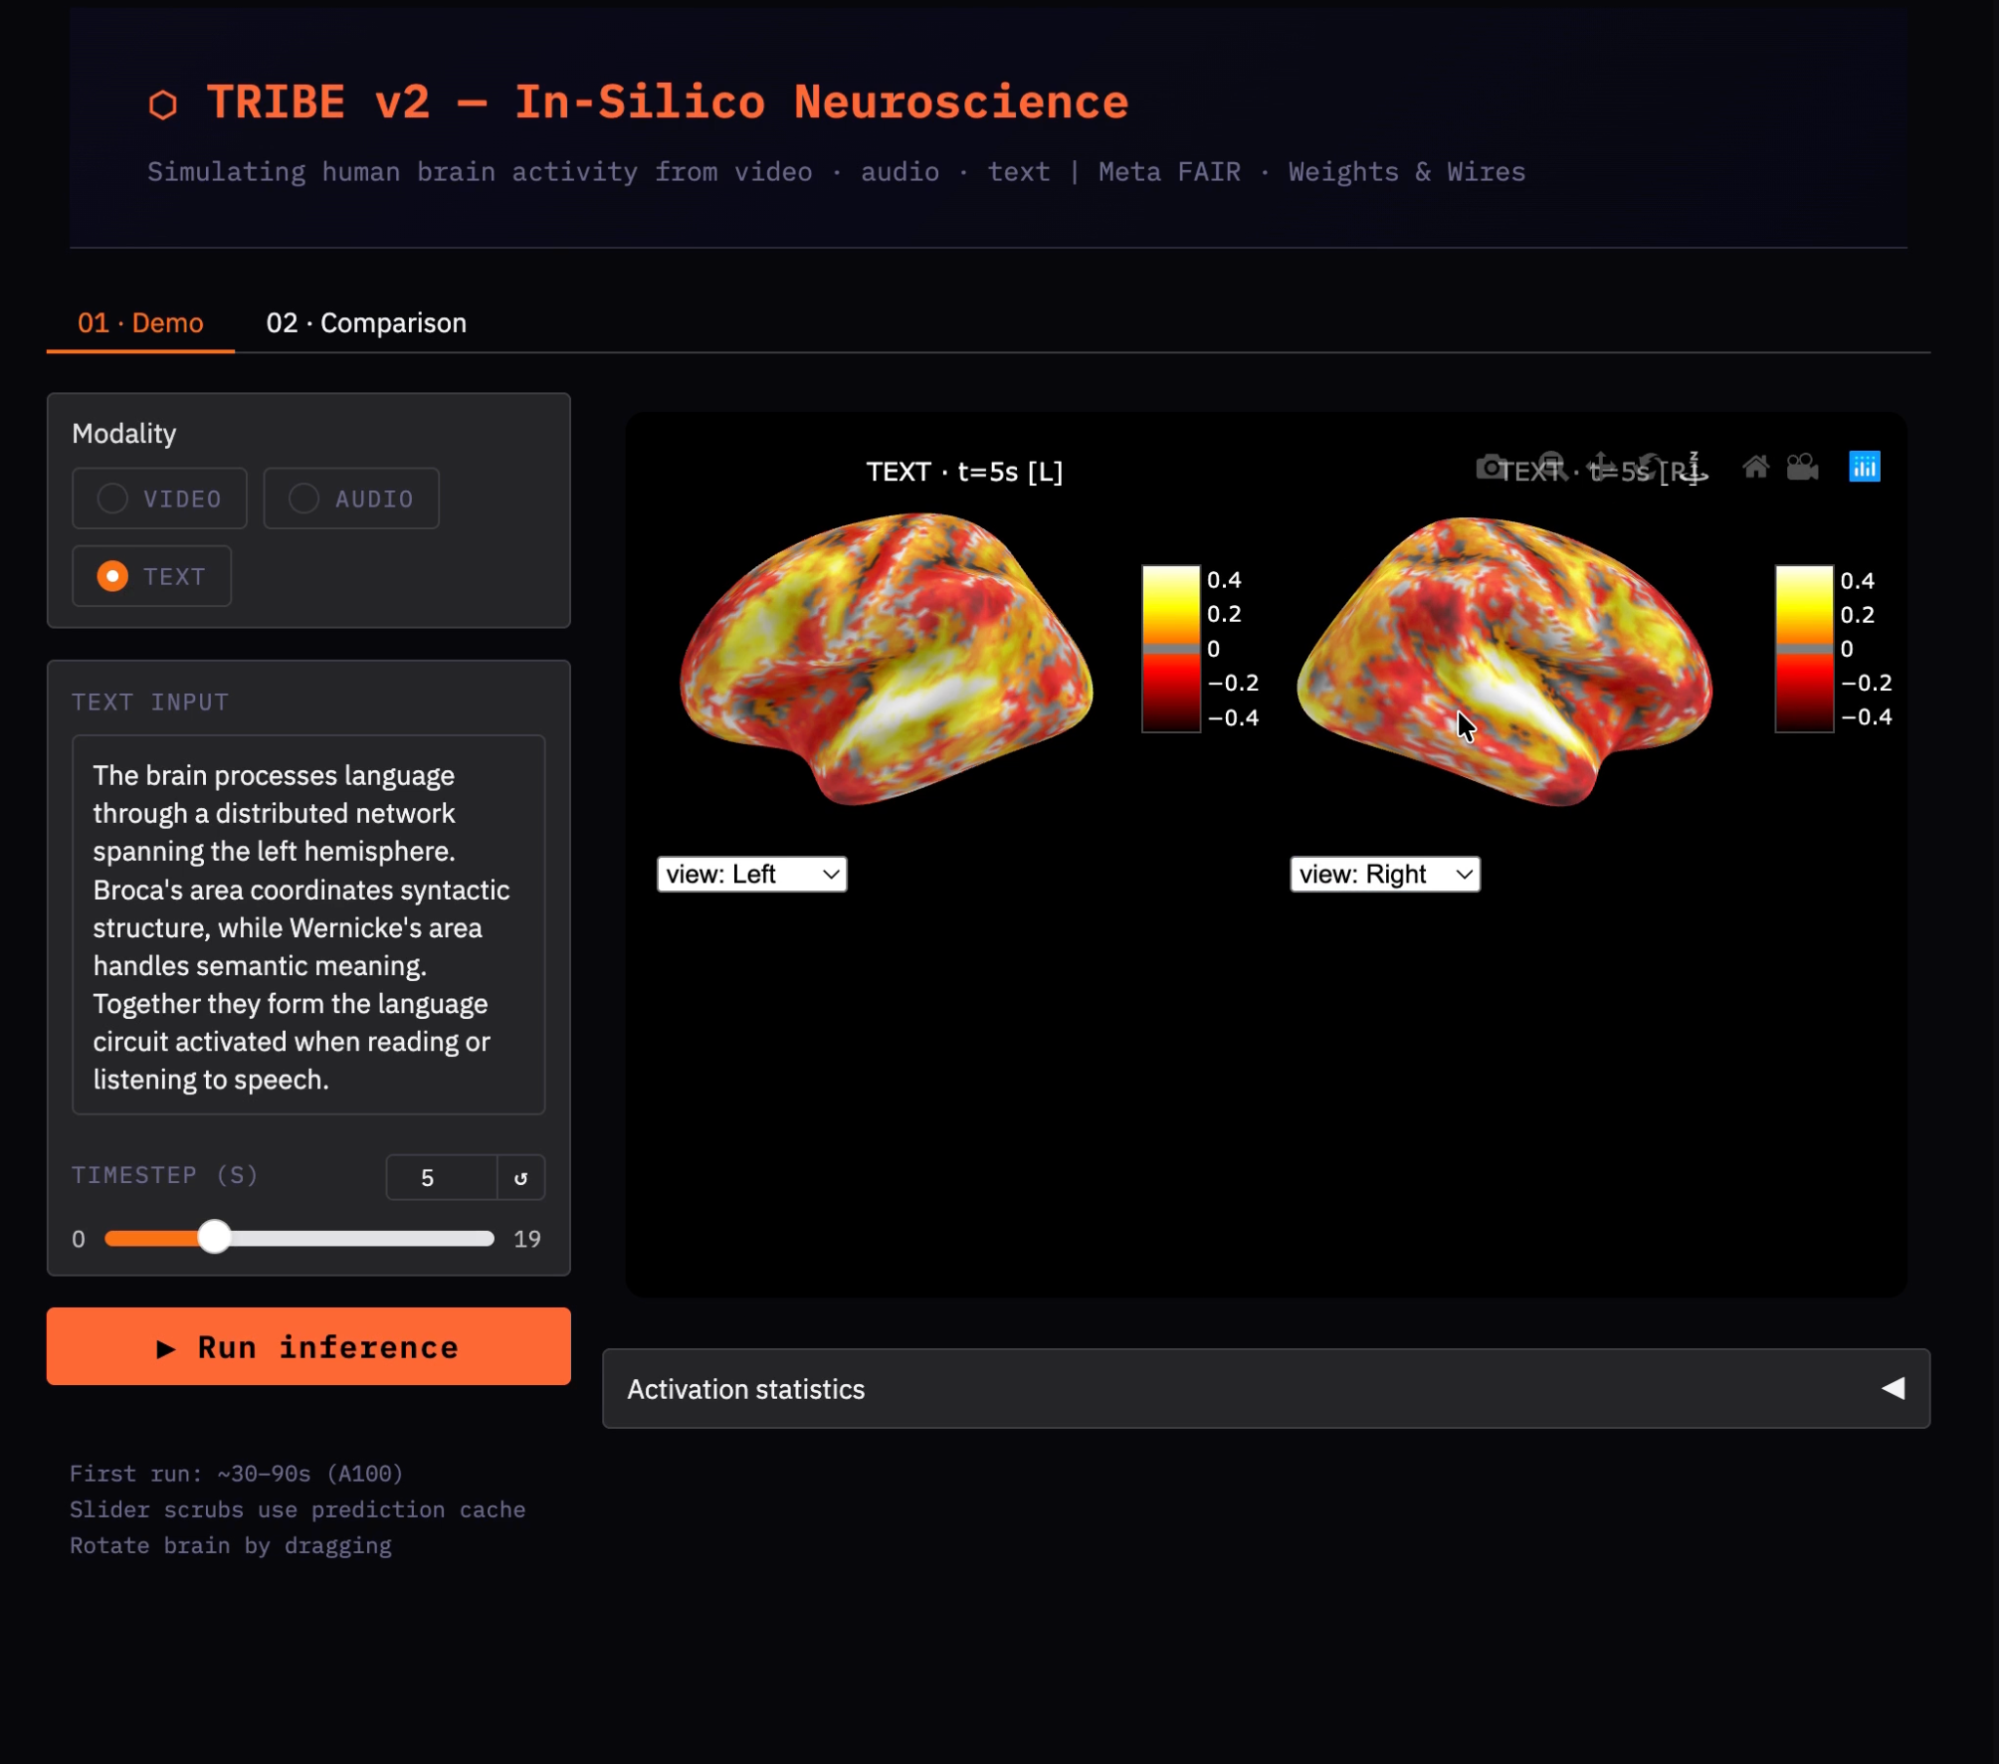
In dit onderdeel bouwen we een stapsgewijze workflow die TRIBE v2-inferentie draait op tekst-, audio- of video-inputs en de voorspelde corticale activiteit visualiseert als een interactieve 3D-hersenwarmtekaart. We voeren ook een vergelijksingsexperiment uit dat het in-silico paradigma uit het oorspronkelijke paper repliceert. Tot slot ontwikkelen we een Gradio-app waarmee iedereen de demo live kan verkennen.
Configureer voordat je begint je Colab-runtime. Je kunt ook elke andere service gebruiken met een stabiele A100 GPU met veel RAM.
TRIBE v2 laadt drie bevroren encoders tegelijk, waaronder LLaMA 3.2-3B (~7 GB), V-JEPA2-Giant (~14 GB) en Wav2Vec-BERT 2.0 (~1 GB), samen met de TRIBE-transformergewichten. De totale VRAM-footprint is 28–32 GB.
Opmerking: Een T4 (16 GB) raakt buiten geheugen wanneer model.predict() LLaMA laadt. Gebruik de A100 (40 GB) of A100 met High RAM (80 GB) voor betere prestaties.
Controleer je GPU voordat je iets installeert door het volgende uit te voeren:
import subprocess, sys
result = subprocess.run(
    ['nvidia-smi', '--query-gpu=name,memory.total',
     '--format=csv,noheader,nounits'],
    capture_output=True, text=True)
print(result.stdout.strip())
import torch
assert torch.cuda.is_available(), "No GPU detected"
props = torch.cuda.get_device_properties(0)
assert props.total_memory > 30e9, (
    f"Need ≥40 GB VRAM. Got {props.total_memory/1e9:.0f} GB. Switch to A100.")
print(f"GPU: {props.name} — {props.total_memory/1e9:.0f} GB")
De aanroep subprocess.run() roept nvidia-smi aan met de vlag --query-gpu om de GPU-naam en totale VRAM op te halen. De twee assert-statements fungeren als vroege exits; de eerste bevestigt dat CUDA beschikbaar is en de tweede controleert dat de totale VRAM meer dan 30 GB is. Hier hard falen is beter dan 10 minuten later stil falen binnen model.predict() met een cryptische CUDA out-of-memory-fout.
Sla deze stap over als je dit niet op Google Colab draait. Dit is de eerste bug die je zult tegenkomen, omdat Colab standaard met NumPy 2.x wordt geleverd. Verscheidene interne afhankelijkheden van TRIBE v2, met name neuralset, zijn gecompileerd tegen NumPy <2.1, waarin het symbool _center uit numpy._core.umath is verwijderd. Het resultaat is deze fout wanneer je probeert import tribev2 te doen:
ImportError
cannot import name '_center' from 'numpy._core.umath'
(/usr/local/lib/python3.12/dist-packages/numpy/_core/umath.py)
De fix is om NumPy te pinnen op <2.1 voordat tribev2 of een van zijn afhankelijkheden wordt geïnstalleerd, en dan de runtime te herstarten. Voer simpelweg de volgende cel uit, die de huidige NumPy verwijdert en vervangt door een versie onder 2.1.
import subprocess, sys
print("Pinning NumPy to <2.1 (required for neuralset compatibility)...")
subprocess.run([sys.executable, '-m', 'pip', 'uninstall', '-y', 'numpy'])
subprocess.run([sys.executable, '-m', 'pip', 'install', '-q',
                'numpy>=1.26.4,<2.1.0'])
Zodra de omgeving en afhankelijkheden vastliggen, kunnen we doorgaan met het installeren van TRIBE v2.
Met de kernel vers herstart en de gepinde NumPy geladen, kunnen we nu veilig het tribev2-pakket van GitHub installeren, samen met de visualisatie- en UI-bibliotheken.
import numpy as np
from packaging.version import Version
assert Version(np.__version__) < Version('2.1.0'), (
    f"NumPy is {np.__version__}. Run Step 2a and restart first.")
print(f"NumPy {np.__version__} Checked")
# Install tribev2 from GitHub
!pip install -q 'tribev2[plotting] @ git+https://github.com/facebookresearch/tribev2.git'
!pip install -q 'gradio>=4.19.0' 'nilearn>=0.10.3' 'plotly>=5.18.0'
De extra tribev2[plotting] installeert pyvista, een Python-bibliotheek voor 3D-visualisatie, en nilearn, een Python-bibliotheek voor neuro-imaging, naast het kernpakket. Installeren direct vanaf de GitHub-URL zorgt ervoor dat je de laatste commit krijgt zonder de repository lokaal te hoeven clonen.
De pakketten nilearn en gradio worden apart geïnstalleerd omdat hun versieconstraints flexibeler zijn en baat hebben bij onafhankelijke resolutie van de tribev2-afhankelijkheidsgrafiek.
De tekstencoder gebruikt LLaMA 3.2-3B, wat een afgeschermd model is op HuggingFace. Je moet expliciet Meta's licentie accepteren voordat de gewichten gedownload kunnen worden. Doe dit eenmalig:
Zodra je HF-token is ingesteld, voer je de volgende code uit om in te loggen op je account:
import os
# Load token from Colab Secrets
try:
    from google.colab import userdata
    os.environ['HF_TOKEN'] = userdata.get('HF_TOKEN')
    print("HF_TOKEN loaded from Colab Secrets")
except Exception:
    from huggingface_hub import login
    login()
De voorkeursroute gebruikt google.colab.userdata.get(), dat leest uit Colab's versleutelde Secrets-opslag, die niet per ongeluk kan worden blootgesteld in een gedeelde notebooklink.
De fallback roept huggingface_hub.login() aan, die interactief om invoer vraagt en het token maskeert tijdens het typen. Beide paden schrijven het token naar os.environ['HF_TOKEN'], waar de HuggingFace Hub-bibliotheek het automatisch oppikt bij het downloaden van afgeschermde modelgewichten.
Met NumPy gepind, authenticatie geconfigureerd en LLaMA gecachet, kunnen we nu de TRIBE v2-encodercheckpoint van HuggingFace laden. Dit downloadt ongeveer 1 GB bij de eerste run en duurt enkele seconden vanuit de cache bij volgende runs.
from pathlib import Path
from tribev2.demo_utils import TribeModel
import torch
CACHE_DIR = Path('/content/tribe_cache')
CACHE_DIR.mkdir(exist_ok=True)
print('Loading TRIBE v2 (first run downloads ~1 GB)...')
model = TribeModel.from_pretrained(
    'facebook/tribev2',
    cache_folder=str(CACHE_DIR)
)
print('Model loaded')
if torch.cuda.is_available():
    used  = torch.cuda.memory_allocated() / 1e9
    total = torch.cuda.get_device_properties(0).total_memory / 1e9
    print(f'VRAM after load: {used:.1f} / {total:.1f} GB')
TribeModel.from_pretrained() downloadt de TRIBE-encodercheckpoint van facebook/tribev2 op HuggingFace en slaat deze op in cache_folder. Deze checkpoint bevat de transformer-integratiegewichten en het subject-blok, maar niet de drie feature-extractors. Die worden apart opgehaald wanneer model.predict() voor het eerst elke modaliteit gebruikt.
Na het laden van alleen de TRIBE-encoder wordt ongeveer 2–4 GB aan VRAM toegewezen, terwijl de resterende 24–28 GB verbruikt zal worden wanneer model.predict() V-JEPA2-Giant en LLaMA 3.2-3B bij eerste gebruik laadt.
Nadat het TRIBE-model is geladen, triggert het voor het eerst aanroepen van model.predict() op tekstinput een luie download van de LLaMA 3.2-3B-gewichten (~6 GB). De standaard-time-out van HuggingFace Hub is 10 seconden en veroorzaakt deze fout midden in inferentie:
ReadTimeout
The read operation timed out
Computing word embeddings:  0%|  | 0/9 [00:10<?, ?it/s]
Om dit te verhelpen, verhoog je de time-out-omgevingsvariabelen en download je LLaMA vooraf expliciet met snapshot_download, zodat je zichtbare voortgang hebt en automatische hervatting bij onderbreking in plaats van een stille fout diep in predict().
import os
os.environ['HF_HUB_DOWNLOAD_TIMEOUT'] = '300'
os.environ['HF_HUB_HTTP_TIMEOUT']     = '300'
from huggingface_hub import snapshot_download
print("Pre-downloading LLaMA 3.2-3B (~6 GB)...")
print("Runs once — subsequent calls load from cache.\n")
snapshot_download(
    repo_id        = "meta-llama/Llama-3.2-3B",
    cache_dir      = "/content/tribe_cache/llama",
    ignore_patterns= ["*.bin"],
)
print("\n LLaMA 3.2-3B cached")
snapshot_download() downloadt een volledige repository naar de lokale cache met HuggingFace's range-requestprotocol, wat betekent dat het automatisch hervat als de verbinding midden in een bestand wegvalt. Het argument ignore_patterns=["*.bin"] slaat het oudere PyTorch-binaire formaat over en downloadt alleen de safetensors-bestanden, waardoor de totale downloadgrootte met ongeveer 40% afneemt.
Voor we echte inferentie draaien, richten we de visualisatielaag in. Deze helperfuncties zetten de ruwe (T, 20484)-voorspellingsarray om in interactieve 3D-hersenwarmtekaarten met nilearn.
TRIBE v2 retourneert voorspellingen als een NumPy-array met vorm (T, 20484), waarbij T het aantal seconden aan input is. De eerste 10.242 vertices zitten in de linkerhemisfeer en de resterende 10.242 in de rechterhemisfeer.
We gebruiken nilearn.plotting.view_surf om elke hemisfeer als een interactieve WebGL-oppervlakte te renderen. De opgeblazen mesh onthult sulcale geometrie die anders verborgen zou zijn in de plooien, en de sulcale dieptekaart geeft anatomische referentie onder de warmtekaart.
De fsaverage5-mesh is de standaard FreeSurfer-corticale template die TRIBE v2 gebruikt als output-ruimte. We downloaden hem hier één keer, zodat alle volgende visualisatieaanroepen ernaar kunnen verwijzen zonder opnieuw van het netwerk te halen.
import numpy as np
from nilearn import datasets as nl_datasets
from nilearn.plotting import view_surf
from IPython.display import display, HTML
N_PER_HEMI = 10242   # fsaverage5: 10242 vertices per hemisphere
print('Fetching fsaverage5 mesh...')
fsavg = nl_datasets.fetch_surf_fsaverage(mesh='fsaverage5')
print('Mesh ready')
print('Keys:', [k for k in fsavg.keys() if k != 'description'])
De fetch_surf_fsaverage(mesh='fsaverage5') downloadt de FreeSurfer-fsaverage5-template van nilearn's CDN en cachet deze. Het retourneert ook een Bunch-object (dictionary) met sleutels zoals infl_left, infl_right, sulc_left en sulc_right.
Deze sub-stap definieert de drie kernfuncties waarop alle visualisatie in deze tutorial steunt. De functie split_hemis() partitioneert de vertexarray, render_hemi() bouwt de interactieve WebGL-oppervlakte voor één hemisfeer, en show_brain() zet beide naast elkaar.
def split_hemis(v):
    n = v.shape[0]
    if n == 2 * N_PER_HEMI:
        return v[:N_PER_HEMI], v[N_PER_HEMI:]
    return v[:n//2], v[n//2:]
def render_hemi(pred_vec, hemi='left', title=''):
    lh, rh = split_hemis(pred_vec)
    data = lh if hemi == 'left' else rh
    vmax = max(float(np.percentile(np.abs(data), 99)), 1e-6)
    return view_surf(
        surf_mesh = fsavg[f'infl_{hemi}'],
        surf_map  = data,
        bg_map    = fsavg[f'sulc_{hemi}'],
        hemi      = hemi,
        threshold = '20%',
        cmap      = 'hot',
        black_bg  = True,
        vmax      = vmax,
        bg_on_data= True,
        colorbar  = True,
        title     = title,
    )
def show_brain(pred_vec, title='', t=None):
    sfx = f' — t={t}s' if t is not None else ''
    lv  = render_hemi(pred_vec, 'left',  f'{title} [Left]{sfx}')
    rv  = render_hemi(pred_vec, 'right', f'{title} [Right]{sfx}')
    html = (
        '<div style="display:flex;gap:10px;background:#000;'
        'border-radius:10px;">'
        f'<div style="flex:1">{lv.get_iframe(width="100%",height="460px")}</div>'
        f'<div style="flex:1">{rv.get_iframe(width="100%",height="460px")}</div>'
        '</div>'
    )
    display(HTML(html))
Laten we de functie van elke helper in detail bekijken:
De functie split_hemis() snijdt de voorspellingsvector op index 10.242, de standaard scheidingspunt voor de fsaverage5-mesh volgens FreeSurfer. De linkerhemisfeer beslaat indexen 0–10241 en de rechterhemisfeer 10242–20483. De fallback onderaan behandelt randgevallen waarbij het model een niet-standaard aantal vertices retourneert.
Binnen de functie render_hemi() wordt vmax berekend als het 99e percentiel van absolute activatiewaarden in plaats van de werkelijke maximumwaarde. Dit voorkomt dat één extreme vertex de hele kleurenschaal ineen laat klappen tot een smalle range, zodat het ruimtelijke patroon zichtbaar blijft.
De functie view_surf() retourneert een SurfaceView-object met 2,4 MB aan zelfstandige WebGL-HTML. De aanroep get_iframe() verpakt dit in een <iframe>-tag met de opgegeven afmetingen. Dus wanneer we display(HTML(...)) aanroepen met twee iframes naast elkaar, ontstaat de gesplitste linker-/rechterhemisfeerlay-out.
Met het model geladen en de visualisatiehelpers gereed, kunnen we onze eerste echte inferentie draaien.
Inferentie met TRIBE v2 verloopt in twee stappen. Eerst extraheert model.get_events_dataframe() tijd-omlijnde events uit de input, samen met woordtimings uit tekst, Wav2Vec-embeddings op 2 Hz uit audio of V-JEPA2-embeddings op 2 Hz uit videoframes.
De resulterende events-DataFrame wordt vervolgens doorgegeven aan model.predict(), dat de transformer en het subject-blok draait om de uiteindelijke corticale voorspellingen te produceren.
import tempfile, os
SAMPLE_TEXT = '''
The brain processes language through a distributed network in the left hemisphere.
Broca's area coordinates syntactic structure, while Wernicke's area handles semantics.
Together they form the language circuit activated when reading or hearing speech.
'''
tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
try:
    tmp.write(SAMPLE_TEXT.strip())
    tmp.flush()
    os.fsync(tmp.fileno())
    tmp.close()
    events = model.get_events_dataframe(text_path=tmp.name)
finally:
    if os.path.exists(tmp.name):
        os.unlink(tmp.name)
print(f'Events: {events.shape}')
print(events[['type', 'start', 'duration']].head(8))
print('\nRunning model.predict()...')
preds, segments = model.predict(events=events)
preds = np.asarray(preds)
print(f'Prediction shape: {preds.shape}')
print(f'  T = {preds.shape[0]}s   (1 Hz fMRI frequency)')
print(f'  V = {preds.shape[1]} vertices  (fsaverage5 cortical surface)')
De schrijfreeks tmp.write(), tmp.flush(), os.fsync(tmp.fileno()), tmp.close() is de cruciale fix voor een subtiele bug. Als je get_events_dataframe() binnen een with-blok aanroept voordat het bestand is gesloten, is de interne schrijfbuffer van Python mogelijk nog niet met het OS gesynchroniseerd, en leest tribev2 een leeg bestand en gooit ValueError. De aanroep os.fsync() garandeert dat de OS-pagecache naar schijf is weggeschreven voordat tribev2 het pad opent.
De model.predict() retourneert een tuple (preds, segments). De array preds heeft vorm (T, 20484), één corticale voorspelling per seconde input over alle 20.484 fsaverage5-vertices. Door hem te wikkelen in np.asarray() zorg je ervoor dat het een gewone NumPy-array is, ongeacht welk intern type het model retourneert. Zodra je preds hebt, kun je de corticale respons op elk tijdstip visualiseren:
T = preds.shape[0]
print(f'Timesteps: 0 to {T-1}')
T_SHOW = min(5, T - 1)
show_brain(preds[T_SHOW], title='Language stimulus', t=T_SHOW)
We defaulten naar t=5 omdat het BOLD (Blood-Oxygen-Level-Dependent)-signaal een hemodynamische vertraging heeft en de vasculaire respons op neurale activiteit ongeveer 5–6 seconden na stimulus-onset piekt. Visualiseren op t=0 laat bijna nul activatie zien ongeacht de stimulusinhoud, omdat de vasculaire respons van het brein dan nog niet is opgebouwd. De min(5, T-1)-guard voorkomt een indexfout wanneer de input minder dan 6 timesteps oplevert.
Een enkele activatiemap laat zien welke gebieden actief zijn, maar vertelt je niet wat de ene stimulus van de andere onderscheidt. In deze stap voeren we twee inputs door het model en berekenen we een contrastmap (A − B) om de regio-specifieke verschillen tussen taalinhoud en visueel/ruimtelijke inhoud te isoleren.
In plaats van voor elke conditie het patroon schrijven -> flush -> sluiten -> inferentie te herhalen, verpakken we het in één functie text_to_preds(). Dit zorgt ervoor dat de cruciale file-flushing-stappen nooit per ongeluk worden overgeslagen voor één van beide condities.
TEXT_A = '''
She spoke slowly and clearly, her voice filling the quiet room.
Every sentence carried meaning, and each word was chosen with care.
Language connects us, the professor said, bridging minds across time.
'''
TEXT_B = '''
The canyon walls rose steeply, layers of red and orange sandstone.
A hawk circled overhead, its wings barely moving in the thermal current.
Shadows shifted as the sun tracked its arc across the open desert sky.
'''
def text_to_preds(text):
    tmp = tempfile.NamedTemporaryFile(
        delete=False, suffix='.txt', mode='w', encoding='utf-8')
    try:
        tmp.write(text.strip())
        tmp.flush()
        os.fsync(tmp.fileno())
        tmp.close()
        evts = model.get_events_dataframe(text_path=tmp.name)
        p, _ = model.predict(events=evts)
        return np.asarray(p)
    finally:
        if os.path.exists(tmp.name):
            os.unlink(tmp.name)
print('Condition A: language content...')
preds_a = text_to_preds(TEXT_A)
print('Condition B: visual/spatial content...')
preds_b = text_to_preds(TEXT_B)
We gebruiken twee tekstpassages met verschillende semantische inhoud, met de verwachte bevinding dat taalinhoud de linkerhemisferische temporale cortex sterker aanstuurt, terwijl visueel/ruimtelijke inhoud de occipitale en posterieure pariëtale cortex sterker rekruteert.
De functie text_to_preds() kapselt de volledige pijplijn in een enkele herbruikbare functie, met dezelfde veilige aanpak als in stap 8 zodat het tijdelijke bestand altijd volledig is geflusht voordat tribev2 het leest. Het argument encoding='utf-8' is expliciet om platformafhankelijke coderingsproblemen te vermijden.
Nu beide condities zijn voorspeld, visualiseren we elk afzonderlijk en trekken we ze vervolgens vertex-voor-vertex af om de contrastmap te produceren.
T_shared = min(preds_a.shape[0], preds_b.shape[0])
t_show   = min(5, T_shared - 1)
print('\n[A] Language content:')
show_brain(preds_a[t_show], title='Condition A: Language', t=t_show)
print('\n[B] Visual/spatial content:')
show_brain(preds_b[t_show], title='Condition B: Visual', t=t_show)
print('\n[A − B] Contrast: Language > Visual')
show_brain(preds_a[t_show] - preds_b[t_show], title='Contrast A − B', t=t_show)
De contrastmap preds_a[t_show] - preds_b[t_show] is een directe vertex-gewijze aftrekking, waarbij positieve waarden gebieden aanduiden waar conditie A meer activeert, en negatieve waarden gebieden waar conditie B meer activeert.
Aangezien beide condities hetzelfde tekstverwerkingspad delen, zullen de ruwe kaarten grofweg vergelijkbaar ogen. Deze contrastmap accentueert domeinspecifieke verschillen tussen taal- en visuele inhoud.
De hersenwarmtekaarten laten ruimtelijke patronen zien op een enkel moment. Deze stap voegt een temporeel perspectief toe: hoe vergelijkt de totale activatie tussen condities over alle tijdstappen, en wanneer wijken de twee condities het sterkst af?
import matplotlib.pyplot as plt
diff_norms = [
    np.linalg.norm(preds_a[i] - preds_b[i])
    for i in range(T_shared)
]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 3.5))
ax1.plot(np.abs(preds_a).mean(axis=1)[:T_shared],
         color='#e74c3c', linewidth=2, label='A: Language')
ax1.plot(np.abs(preds_b).mean(axis=1)[:T_shared],
         color='#3498db', linewidth=2, label='B: Visual')
ax1.set_title('Mean cortical activation over time')
ax1.set_xlabel('Time (s)'); ax1.legend(); ax1.grid(True, alpha=0.3)
ax2.plot(diff_norms, color='#f39c12', linewidth=2)
ax2.fill_between(range(T_shared), diff_norms, alpha=0.2, color='#f39c12')
ax2.set_title('||A − B|| difference over time')
ax2.set_xlabel('Time (s)'); ax2.grid(True, alpha=0.3)
plt.tight_layout(); plt.show()
De linkerplot volgt np.abs(preds).mean(axis=1), de gemiddelde absolute activatie, samengevat over alle 20.484 vertices per seconde. Dit laat zien hoe sterk elke conditie de cortex aanspreekt en wanneer de respons piekt. Het nemen van de absolute waarde is belangrijk omdat voorspelde BOLD-waarden negatief (deactivatie) kunnen zijn en we de grootte willen, niet het getekende gemiddelde.
De rechterplot volgt de L2-norm van de verschilvector op elke tijdstap, np.linalg.norm(preds_a[i] - preds_b[i]). Een piek in deze curve rond t=5–7s is consistent met de hemodynamische vertraging: beide condities hebben tijd nodig voor de opbouw van de BOLD-respons voordat ze uiteenlopen. De fill_between()-arcering maakt het begin en de piek van de divergentie visueel duidelijk.
Deze laatste stap verpakt de inferentie- en visualisatielogica in een Gradio-app met een strakke UI, een tijdschuifregelaar en een A/B-vergelijkingstab.
import gradio as gr
_pred_cache = {}
def _infer(mod, vid, aud, txt):
    """Run inference and cache the result. Subsequent calls return cached array."""
    key = (mod, vid, aud, hash(txt or ''))
    if key not in _pred_cache:
        if mod == 'video':
            evts = model.get_events_dataframe(video_path=vid)
        elif mod == 'audio':
            evts = model.get_events_dataframe(audio_path=aud)
        else:
            tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
            tmp.write((txt or '').strip()); tmp.flush()
            os.fsync(tmp.fileno()); tmp.close()
            evts = model.get_events_dataframe(text_path=tmp.name)
            os.unlink(tmp.name)
        p, _ = model.predict(events=evts)
        _pred_cache[key] = np.asarray(p)
    return _pred_cache[key]
demo.launch(
    share      = True,
    debug      = False,
    server_name= "0.0.0.0",
)
Zo komen de Gradio-UI en de inferentiepijplijn samen:
De functie _infer() fungeert als de centrale inferentielaag en handelt alle drie de modaliteiten (video, audio en tekst) af door inputs voor te bereiden, model.predict() aan te roepen en de voorspelde hersenactiviteit te retourneren.
Een voorspellingcache wordt gebruikt om resultaten op te slaan op basis van een sleutel die bestaat uit de modaliteit, inputpaden en een hash van de tekst. Dit zorgt ervoor dat identieke inputs geen herhaalde modelinferentie triggeren.
De cachingmechaniek is cruciaal omdat UI-componenten zoals schuifregelaars vaak callbacks triggeren. Zonder caching zou elke interactie opnieuw inferentie draaien (tot ~60 seconden), terwijl met caching resultaten na de eerste run direct worden teruggegeven.
De interface biedt twee tabbladen: één met een single-inputmodus met een tijdschuifregelaar om hersenactiviteit over de tijd te verkennen, en een vergelijkingsmodus die twee inputs draait en hun verschil visualiseert als een contrasthittekaart.
Tot slot is demo.launch() geconfigureerd met share=True om een openbare URL te genereren en server_name="0.0.0.0" om externe toegang toe te staan, waardoor de app eenvoudig te deployen is.
Na het draaien van de demo op verschillende inputs (video, audio en tekst) komen er een paar consistente patronen naar voren die helpen de outputs van TRIBE v2 te interpreteren. Enkele inzichten uit de demo zijn:
Het model claimt geen 100% nauwkeurigheid en heeft eigen valkuilen:
TRIBE v2 is een krachtig onderzoeksinstrument, maar heeft belangrijke beperkingen die van invloed zijn op hoe de outputs moeten worden geïnterpreteerd. Deze begrijpen is essentieel voordat je wetenschappelijke of klinische conclusies aan de voorspellingen verbindt.
In deze tutorial hebben we een werkende TRIBE v2-pijplijn gebouwd op Google Colab A100: van het oplossen van twee concrete bugs (het NumPy 2.x-versieconflict en de HuggingFace-download-time-out) via het draaien van echte corticale voorspellingen, tot het visualiseren ervan als interactieve 3D-hersenwarmtekaarten en het uitvoeren van een vergelijksingsexperiment dat het in-silico paradigma uit het paper repliceert.
De vier belangrijkste engineeringlessen uit deze tutorial zijn:
Pin NumPy op <2.1 en herstart de runtime voordat je tribev2 installeert
Stel HF_HUB_DOWNLOAD_TIMEOUT=300 in en predownload LLaMA met snapshot_download voordat je model.predict() aanroept
Schrijf altijd → flush() → fsync() → close() tempbestanden voordat je hun pad aan het model doorgeeft
Cache voorspellingen in een dictionary, zodat UI-schuifinteracties nooit opnieuw inferentie draaien.
Vanaf hier springen twee natuurlijke uitbreidingen in het oog. De eerste is rijkere stimuli: echte filmclips of podcastsegmenten van 30–60 seconden leveren veel duidelijkere temporele dynamiek en ruimtelijke patronen op dan korte tekstpassages.
De tweede is individuele fine-tuning: met ~1 uur aan fMRI-data van een specifieke proefpersoon kan het subject-blok van TRIBE v2 in één epoch worden gefinetuned om gepersonaliseerde voorspellingen te produceren die het groepsgemiddelde model volgens het paper 2–4x overtreffen.
De volledige notebook is beschikbaar in de TRIBE v2 GitHub-repository. Het paper is de moeite van het volledig lezen waard, met name Sectie 2.5 (in-silico visie-experimenten) en Sectie 2.8 (inzichten in multimodale integratie), die laten zien wat dit soort tooling mogelijk maakt voor neurowetenschappelijk onderzoek.
Deep Learning-cursussen
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

