
据 Meta 提供的示例,这些模型能够分析文档中嵌入的图表并总结关键趋势。它们还可以解读地图,判断徒步路线中哪个路段最陡,或计算两点之间的距离。
Llama 视觉模型的使用场景
文本与图像推理的融合带来广泛的潜在应用,包括:
- 文档理解:模型可从包含图像、图形与图表的文档中提取并总结信息。例如,企业可借助 Llama 3.2 自动解读以可视化形式呈现的销售数据。
- 视觉问答:通过理解文本与图像,Llama 3.2 模型可基于视觉内容回答问题,例如识别场景中的物体或概括图像内容。
- 图像字幕生成:模型可以为图像生成字幕,适用于数字媒体或无障碍等需要理解图像内容的领域。
开放且可定制
Llama 3.2 的视觉模型开放且可定制。开发者可以通过 Meta 的微调框架Torchtune,对这些模型的预训练版和对齐版进行微调。
此外,这些模型可通过Torchchat本地部署,降低对云基础设施的依赖,为希望在本地或资源受限环境中部署 AI 系统的开发者提供方案。
这些视觉模型也可通过 Meta 的智能助手 Meta AI 进行测试。
Llama 3.2 视觉模型的工作原理
为使 Llama 3.2 视觉模型能够理解文本与图像,Meta 使用特殊适配器将一个预训练的图像编码器集成进现有语言模型中。适配器将图像数据与模型的文本处理部分连接,使其能够处理两类输入。
训练过程以 Llama 3.1 语言模型为起点。团队首先用大规模的图文配对数据训练模型,教会其建立二者之间的联系;随后使用更干净、更特定的数据进行精修,以提升对视觉内容的理解与推理能力。
在最后阶段,Meta 使用微调与合成数据生成等技术,确保模型给出有用且安全的回答。
基准测试:优势与不足
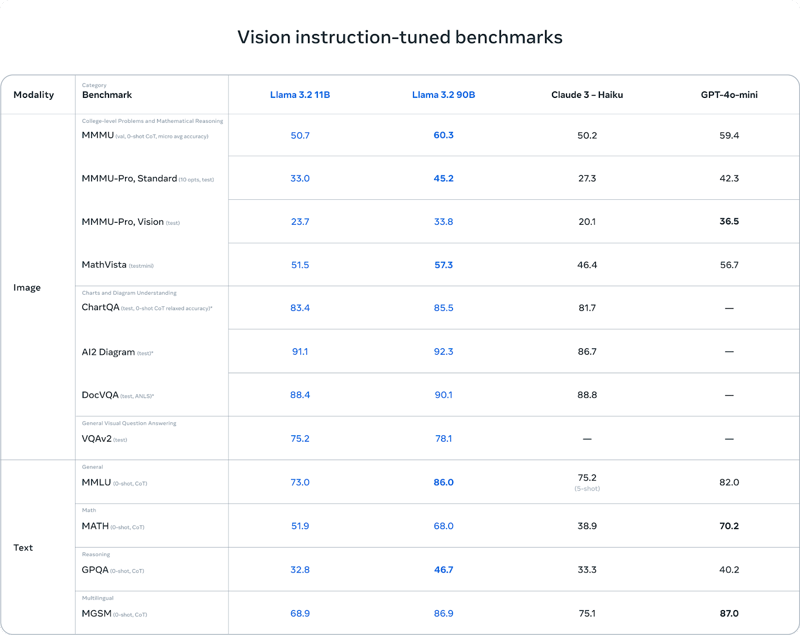
Llama 3.2 视觉模型在图表与示意图理解方面表现突出。在 AI2 Diagram(92.3)与 DocVQA(90.1)等基准上,Llama 3.2 优于 Claude 3 Haiku。这使其非常适合涉及文档级理解、视觉问答与从图表中抽取数据的任务。
在多语言任务(MGSM)中,Llama 3.2 也有良好表现,得分 86.9,几乎与 GPT-4o-mini 持平,对多语种场景的开发者而言是稳健的选择。
来源: Meta AI
尽管 Llama 3.2 在视觉相关任务中表现良好,但在其他方面仍有挑战。在测试基于视觉数据的数学推理的 MMMU-Pro Vision 中,GPT-4o-mini 得分 36.5,优于 Llama 的 33.8。
同样,在 MATH 基准中,GPT-4o-mini 的表现(70.2)显著领先于 Llama 3.2(51.9),表明 Llama 在数学推理任务上仍有改进空间。
Llama 3.2 1B 与 3B 轻量模型
Llama 3.2 的另一重大进展是在边缘与移动设备上引入轻量模型。这些 10 亿与 30 亿参数的模型在较小硬件上优化运行,同时在性能上保持合理权衡。
端侧 AI:实时且私密
这些模型面向移动设备设计,可在本地快速处理,无需将数据发送至云端。在边缘设备本地运行模型的两大好处是:
- 更快的响应时间:由于模型在设备端运行,几乎可以即时处理请求并生成响应。这对速度至关重要的实时交互尤其有用。
- 更强的隐私:采用本地处理,用户数据无需离开设备。这样可将个人消息或日程等敏感信息留存在用户掌控之中,而非发送至云端。
Llama 3.2 的轻量模型针对 Arm 处理器优化,并已在高通与联发科硬件上启用,后者驱动着当今大量移动与边缘设备。
Llama 3.2 1B 与 3B 的应用
轻量模型面向多种实用的端侧应用,例如:
1. 摘要生成: 用户可在设备端直接为大量文本(如邮件或会议记录)生成摘要,而无需依赖云服务。
2. AI 个人助理:模型可理解自然语言指令并执行任务,如创建待办清单或安排会议。
3. 文本改写:这些模型可即时增强或修改文本,适用于自动化编辑或改写等应用。
Llama 3.2 轻量模型的工作原理
Llama 3.2 轻量模型(1B 与 3B)旨在在移动与边缘设备上高效适配,同时保持较强性能。为此,Meta 采用了两项关键技术:剪枝与蒸馏。
来源: Meta AI
剪枝:让模型更小
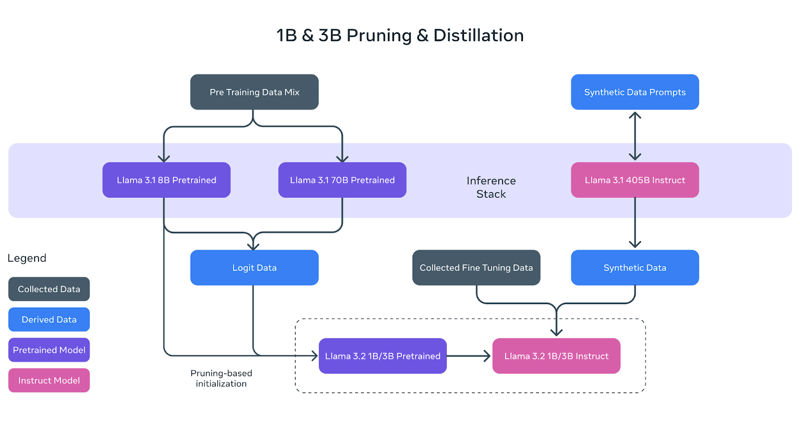
剪枝通过移除网络中不那么关键的部分来缩小原始 Llama 模型的体量,同时尽可能保留知识。在 Llama 3.2 的 1B 与 3B 模型中,该过程从更大的 Llama 3.1 8B 预训练模型开始。
通过系统性剪枝,Meta AI 团队在不显著牺牲性能的前提下,构建出更小、更高效的模型版本。上图中,8B 预训练模型(紫色框)经过剪枝与精修,成为规模更小的 Llama 3.2 1B/3B 模型的基础。
蒸馏:教会小模型
蒸馏是将更大更强的“教师”模型的知识迁移到较小“学生”模型的过程。在 Llama 3.2 中,使用更大规模的 Llama 3.1 8B 与 Llama 3.1 70B 模型的 logits(预测)来教导小模型。
借此,更小的 1B 与 3B 模型尽管体量缩减,仍能更高效地完成任务。上图展示了在预训练期间如何利用大模型的 logits 数据来引导 1B 与 3B 模型。
最终精修
在剪枝与蒸馏后,1B 与 3B 模型经历了与以往 Llama 模型类似的后训练阶段,包括有监督微调、拒绝采样与直接偏好优化等技术,以使模型输出更契合用户期望。
同时也生成了合成数据,以确保模型能够应对广泛任务,如摘要、改写与遵循指令。
如图所示,最终的 Llama 3.2 1B/3B instruct 模型是剪枝、蒸馏与大量后训练的成果。
基准测试:优势与不足
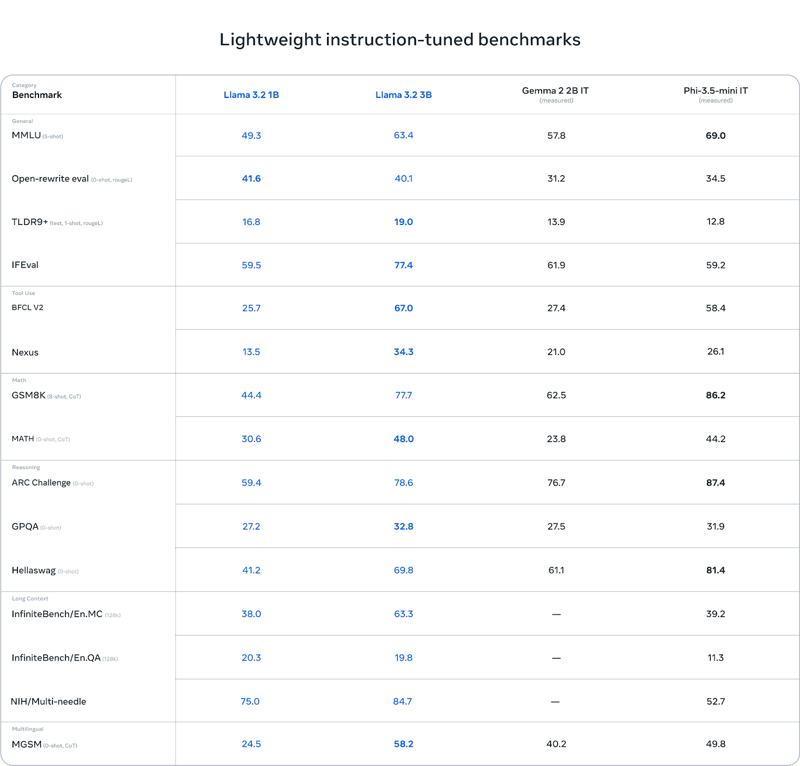
Llama 3.2 3B 在部分类别中表现突出,尤其是涉及推理的任务。例如在 ARC Challenge 中得分 78.6,超越 Gemma(76.7),仅略低于 Phi-3.5-mini(87.4)。在 Hellawag 基准上也表现良好,取得 69.8,领先 Gemma,并与 Phi 保持竞争力。
在 BFCL V2 等工具使用任务中,Llama 3.2 3B 同样亮眼,得分 67.0,领先两位竞品。这表明该 3B 模型在遵循指令与工具相关任务上具备良好能力。
来源: Meta AI
Llama Stack 发行版
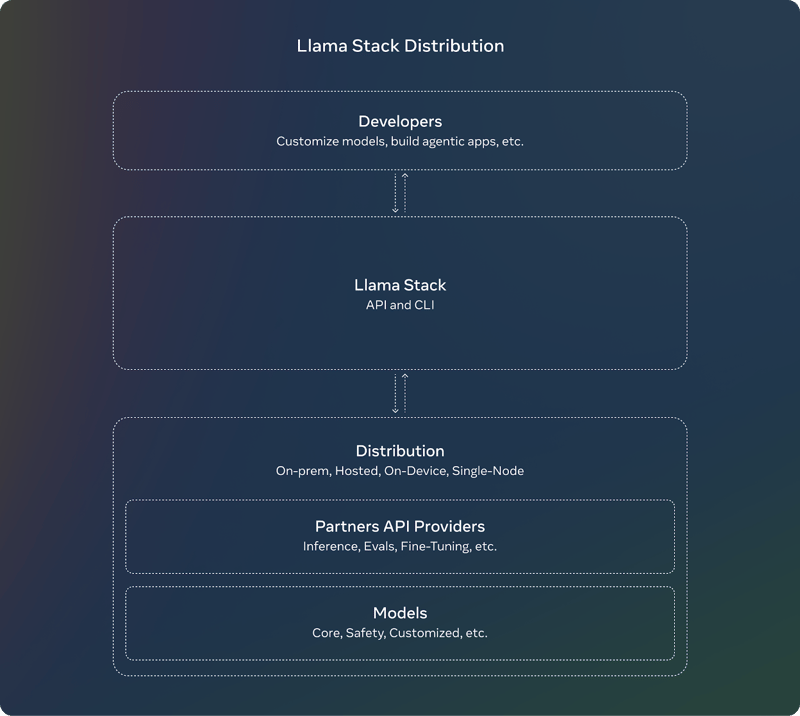
为配合 Llama 3.2 发布,Meta 推出 Llama Stack。对开发者而言,使用 Llama Stack 意味着无需操心大型模型的复杂搭建与部署细节,可以专注于构建应用,并信赖 Llama Stack 处理大量底层工作。
Llama Stack 的关键特性包括:
- 标准化 API:开发者可用其与 Llama 模型交互,而无需从零搭建。
- 全场景适配:Llama Stack 旨在跨多平台运行:
- 单机:在一台计算机上运行 Llama 模型。
- 本地部署:在自有服务器或私有云中使用模型。
- 公有云:通过AWS 或Google Cloud 等云服务商部署 Llama 模型。
- 移动与边缘设备:在手机或小型设备上运行 Llama 模型,而不依赖云端。
- 预构建方案:Llama Stack 提供“开箱即用”的解决方案,如文档分析或问答等常见任务的现成配置,可为开发者节省时间与精力。
- 内置安全:Stack 集成了安全特性,确保 AI 在部署期间以负责、合乎伦理的方式运行。
来源: Meta AI
Llama 3.2 的安全性
在 Llama 3.2 上,Meta 继续重视负责任的 AI。Llama Guard 3 已更新为包含支持 Llama 3.2 新多模态能力的视觉版,确保使用新图像理解功能的应用在伦理准则方面保持安全与合规。
此外,Llama Guard 3 1B 已针对资源更受限的环境进行优化,比以往版本更小更高效。
如何获取与下载 Llama 3.2 模型
获取与下载 Llama 3.2 模型相对直接。Meta 在多个平台提供这些模型,包括其官网与广受欢迎的 AI 模型托管与分享平台 Hugging Face。
您可以直接从Llama 官方网站下载 Llama 3.2 模型。Meta 为开发者提供轻量模型(1B 与 3B)以及更大的具备视觉能力的模型(11B 与 90B)。
Hugging Face 同样提供 Llama 3.2 模型,便于访问,且被 AI 社区的开发者广泛使用。
Llama 3.2 模型可在我们广泛的合作平台生态中即刻用于开发,包括 AMD、AWS、Databricks、Dell、Google Cloud、Groq、IBM、Intel、Microsoft Azure、NVIDIA、Oracle Cloud、Snowflake 等。
结语
Meta 发布的 Llama 3.2 为该系列首次引入多模态模型,重点聚焦具备视觉能力的模型与面向边缘和移动设备的轻量模型这两个方向。
11B 与 90B 多模态模型现可同时处理文本与图像;而 1B 与 3B 模型则针对小型设备的本地高效运行进行了优化。
本文已概述其要点——模型如何运作、实际应用,以及如何获取。
常见问题
Llama 3.2 是什么?与 Llama 3.1 有何不同?
Llama 3.2 引入多模态能力,使模型能够理解文本与图像。同时还提供面向边缘与移动端的轻量模型;相比之下,Llama 3.1 主要专注于文本处理。
Llama 3.2 视觉模型与 GPT-4o-mini 和 Claude 3 Haiku 相比如何?
Llama 3.2 视觉模型表现具有竞争力,擅长处理涉及图像与文本推理的任务。但在某些专业任务(如数学问题求解)上,可能略逊于 GPT-4o-mini。
Llama 3.2 是开源的吗?
是的,Llama 3.2 模型是开源的,可在 Llama 官方网站与 Hugging Face 下载。开发者可在多平台访问、微调并部署这些模型,具备良好的灵活性与可定制性。
什么是 Llama Stack?它对开发者为何重要?
Llama Stack 提供标准化 API 与预构建方案,可在云端到端侧等多种环境部署 Llama 模型。它简化了基于 Llama 3.2 构建 AI 应用的流程,便于集成与部署。
运行 Llama 3.2 的硬件需求是什么?
Llama 3.2 提供针对 Arm 处理器以及高通与联发科硬件优化的轻量模型,可在移动设备上高效运行。更大型的模型可能需要更强的 GPU 或基于云的基础设施以获得最佳表现。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。
Meta AI 宣布发布 Llama 3.2,为该系列首次引入多模态模型。Llama 3.2 聚焦两个关键方向:
本文将直击重点,概述全新 Llama 3.2 模型的关键方面,包括其工作原理、使用场景、获取方式等。您也可查看我们关于微调 Llama 3.2的独立指南。
Llama 3.2 11B 与 90B 视觉模型
Llama 3.2 的一大亮点是在 110 亿与 900 亿参数规模上引入了具备视觉能力的模型。
这些模型为 Llama 生态带来多模态能力,使其能够同时处理并理解文本与图像。
多模态能力
Llama 3.2 的视觉模型在需要图像识别与语言处理的任务中表现出色。它们可以回答有关图像的问题、生成描述性字幕,甚至对复杂的视觉数据进行推理。