Programa
Aprendizaje profundo en Python
18 h
TRIBE v2 (TRImodal Brain Encoder) es un modelo de deep learning que mapea estímulos naturalistas a respuestas de fMRI predichas. Dado un clip de vídeo, un archivo de audio o un bloque de texto, el modelo produce una señal BOLD predicha para cada uno de los 20.484 vértices de la superficie cortical fsaverage5 a 1 Hz, es decir, una predicción por segundo.
Las predicciones corresponden al sujeto promedio (no a un cerebro individual concreto), es decir, a la respuesta canónica de media de grupo que TRIBE v2 aprendió de 720 participantes a partir de cuatro conjuntos de datos naturalistas. Las predicciones zero-shot del modelo superan a las grabaciones de fMRI de sujeto único en el conjunto Human Connectome Project 7T, que tiene la mayor calidad de señal del conjunto de entrenamiento.
|
Propiedad |
Detalle |
|
Espacio de salida |
20.484 vértices corticales en la superficie fsaverage5 y predicciones de todo el cerebro en aproximadamente 70.000 vóxeles (corteza + subcorteza) |
|
Resolución temporal |
1 Hz (coincide con la frecuencia TR de fMRI) |
|
Modalidades de entrada |
Vídeo (V-JEPA2-Giant), audio (Wav2Vec-BERT 2.0), texto (LLaMA 3.2-3B) |
|
Parámetros del codificador |
~1B parámetros entrenables en la capa de integración tipo Transformer |
|
Datos de entrenamiento |
1.115 horas de fMRI de 720 sujetos en 4 conjuntos de datos |
|
Generalización |
Zero-shot a nuevos sujetos, tareas e idiomas |
|
Licencia |
CC-BY-NC 4.0 (uso en investigación, no comercial) |
El modelo se adapta del artículo A foundation model of vision, audition, and language for in-silico neuroscience, que demuestra que TRIBE v2 recupera el área fusiforme de las caras para rostros, el área para-hipocampal de lugares para escenas, el área de Broca para sintaxis compleja y la red del lenguaje lateralizada a la izquierda para habla, sin usar datos de fMRI en tiempo de inferencia.
TRIBE v2 tiene tres etapas que se ejecutan en secuencia en cada llamada de inferencia:
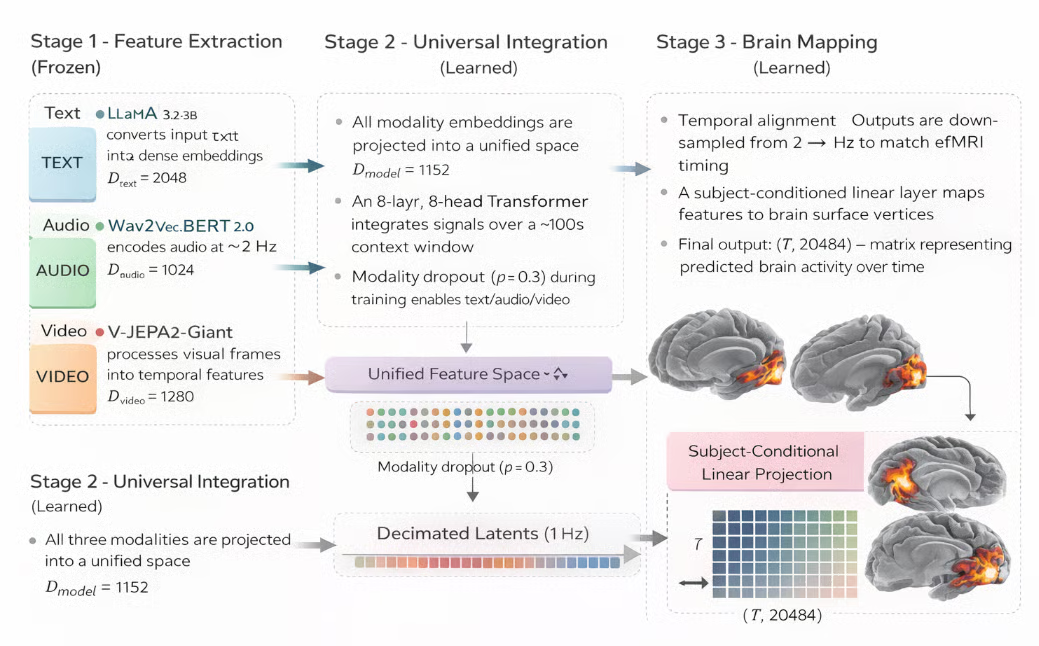
Figura: modelo de predicción de actividad cerebral TRIBE v2 (generada con IA)
Primero, tres codificadores preentrenados independientes procesan cada modalidad de entrada y la convierten en embeddings densos alineados en el tiempo. Ninguno de estos codificadores se actualiza durante el entrenamiento (están congelados), por lo que TRIBE v2 hereda sus representaciones tal cual. Estas son algunas métricas de extracción por modalidad:
Texto: LLaMA 3.2-3B convierte el texto de entrada en embeddings densos (D = 2048)
Audio: Wav2Vec-BERT 2.0 codifica señales de audio a ~2 Hz (D = 1024)
Vídeo: V-JEPA2-Giant procesa fotogramas en características temporales (D = 1280)
Los tres flujos de embeddings se fusionan en una representación compartida única y se procesan con un Transformer que atiende a lo largo del tiempo. Aquí residen los pesos aprendidos de TRIBE v2 y donde se capturan las interacciones entre modalidades del siguiente modo:
Representación compartida: Todos los embeddings se proyectan a un espacio unificado (D_model = 1152)
Fusión con Transformer: Un Transformer de 8 capas y 8 cabezas integra señales en una ventana de contexto larga (~100 s)
Flexibilidad de modalidades: El dropout de modalidad (p = 0,3) permite inferencia con cualquier subconjunto (texto/audio/vídeo)
La representación latente fusionada se proyecta sobre la superficie cortical para generar la predicción final de fMRI. Esta etapa convierte características abstractas del modelo en estimaciones de actividad cerebral con resolución espacial y temporal.
Como los tres extractores de características están congelados durante el entrenamiento, TRIBE v2 solo aprende las capas de proyección y los pesos del Transformer que integran sus salidas. Esta decisión de diseño es clave porque hace que el modelo sea robusto ante estímulos fuera de distribución: hereda la capacidad de generalización de tres modelos preentrenados a gran escala en lugar de entrenarse de extremo a extremo solo con datos de fMRI.
Nota: Un truco de entrenamiento importante es el dropout por modalidad. Durante el entrenamiento, cada modalidad se anula de forma independiente con probabilidad 0,3. Esto obliga al modelo a hacer predicciones útiles a partir de cualquier subconjunto de modalidades. Así que, en inferencia, puedes pasar solo audio o solo texto y aun así obtener una predicción cortical útil.
En esta sección, construiremos un flujo paso a paso que ejecuta la inferencia de TRIBE v2 con entradas de texto, audio o vídeo y visualiza la actividad cortical predicha como un mapa de calor 3D interactivo. También realizaremos un experimento comparativo que replica el paradigma in silico del artículo original. Por último, desarrollaremos una app en Gradio para explorar la demo en vivo.
Antes de empezar, configura tu runtime de Colab. También puedes usar cualquier otro servicio con una GPU A100 estable y con mucha RAM.
TRIBE v2 carga a la vez tres codificadores congelados, incluidos LLaMA 3.2-3B (~7 GB), V-JEPA2-Giant (~14 GB) y Wav2Vec-BERT 2.0 (~1 GB), junto con los pesos del Transformer de TRIBE. El uso total de VRAM es de 28–32 GB.
Nota: Una T4 (16 GB) se quedará sin memoria cuando model.predict() cargue LLaMA. Usa la A100 (40 GB) o A100 con High RAM (80 GB) para un mejor rendimiento.
Verifica tu GPU antes de instalar nada ejecutando lo siguiente:
import subprocess, sys
result = subprocess.run(
    ['nvidia-smi', '--query-gpu=name,memory.total',
     '--format=csv,noheader,nounits'],
    capture_output=True, text=True)
print(result.stdout.strip())
import torch
assert torch.cuda.is_available(), "No GPU detected"
props = torch.cuda.get_device_properties(0)
assert props.total_memory > 30e9, (
    f"Need ≥40 GB VRAM. Got {props.total_memory/1e9:.0f} GB. Switch to A100.")
print(f"GPU: {props.name} — {props.total_memory/1e9:.0f} GB")
La llamada subprocess.run() invoca nvidia-smi con la bandera --query-gpu para extraer el nombre de la GPU y la VRAM total. Las dos aserciones actúan como salidas tempranas; la primera confirma que CUDA está disponible y la segunda verifica que la VRAM total supera los 30 GB. Es mejor fallar de forma explícita aquí que fallar en silencio dentro de model.predict() 10 minutos después con un críptico error de falta de memoria de CUDA.
Sáltate este paso si no estás ejecutando esto en Google Colab. Este es el primer error con el que te encontrarás porque Colab trae NumPy 2.x por defecto. Varias dependencias internas de TRIBE v2, en concreto neuralset, se compilaron contra NumPy <2.1, que eliminó el símbolo _center de numpy._core.umath. Como resultado, aparece este error cuando intentas import tribev2:
ImportError
cannot import name '_center' from 'numpy._core.umath'
(/usr/local/lib/python3.12/dist-packages/numpy/_core/umath.py)
La solución es fijar NumPy a <2.1 antes de instalar tribev2 o cualquiera de sus dependencias y reiniciar el runtime. Simplemente ejecuta esta celda, que desinstala el NumPy actual y lo reemplaza por una versión inferior a 2.1.
import subprocess, sys
print("Pinning NumPy to <2.1 (required for neuralset compatibility)...")
subprocess.run([sys.executable, '-m', 'pip', 'uninstall', '-y', 'numpy'])
subprocess.run([sys.executable, '-m', 'pip', 'install', '-q',
                'numpy>=1.26.4,<2.1.0'])
Una vez fijado el entorno y las dependencias, podemos proceder a instalar TRIBE v2.
Con el kernel recién reiniciado y NumPy fijado, ya podemos instalar con seguridad el paquete tribev2 desde GitHub junto con las librerías de visualización y la interfaz.
import numpy as np
from packaging.version import Version
assert Version(np.__version__) < Version('2.1.0'), (
    f"NumPy is {np.__version__}. Run Step 2a and restart first.")
print(f"NumPy {np.__version__} Checked")
# Install tribev2 from GitHub
!pip install -q 'tribev2[plotting] @ git+https://github.com/facebookresearch/tribev2.git'
!pip install -q 'gradio>=4.19.0' 'nilearn>=0.10.3' 'plotly>=5.18.0'
El extra tribev2[plotting] instala pyvista, una librería de Python para visualización 3D, y nilearn, una librería para neuroimagen, junto con el paquete principal. Instalar directamente desde la URL de GitHub garantiza que obtienes el último commit sin necesidad de clonar el repositorio localmente.
Los paquetes nilearn y gradio se instalan por separado porque sus restricciones de versión son más flexibles y conviene resolverlas de manera independiente del grafo de dependencias de tribev2.
El codificador de texto usa LLaMA 3.2-3B, que es un modelo con acceso restringido en HuggingFace. Debes aceptar explícitamente la licencia de Meta antes de poder descargar los pesos. Hazlo una vez:
Una vez configurado tu token de HF, ejecuta este código para iniciar sesión en tu cuenta:
import os
# Load token from Colab Secrets
try:
    from google.colab import userdata
    os.environ['HF_TOKEN'] = userdata.get('HF_TOKEN')
    print("HF_TOKEN loaded from Colab Secrets")
except Exception:
    from huggingface_hub import login
    login()
La ruta preferente usa google.colab.userdata.get(), que lee del almacén cifrado de Secrets de Colab y no puede exponerse accidentalmente en un cuaderno compartido.
La alternativa llama a huggingface_hub.login(), que solicita el token de forma interactiva y lo oculta mientras lo escribes. Ambos métodos escriben el token en os.environ['HF_TOKEN'], desde donde la librería de HuggingFace Hub lo recogerá automáticamente al descargar pesos de modelos con acceso restringido.
Con NumPy fijado, la autenticación configurada y LLaMA en caché, ya podemos cargar el checkpoint del codificador TRIBE v2 desde HuggingFace. En la primera ejecución descarga aproximadamente 1 GB y en posteriores tarda unos segundos al cargar desde caché.
from pathlib import Path
from tribev2.demo_utils import TribeModel
import torch
CACHE_DIR = Path('/content/tribe_cache')
CACHE_DIR.mkdir(exist_ok=True)
print('Loading TRIBE v2 (first run downloads ~1 GB)...')
model = TribeModel.from_pretrained(
    'facebook/tribev2',
    cache_folder=str(CACHE_DIR)
)
print('Model loaded')
if torch.cuda.is_available():
    used  = torch.cuda.memory_allocated() / 1e9
    total = torch.cuda.get_device_properties(0).total_memory / 1e9
    print(f'VRAM after load: {used:.1f} / {total:.1f} GB')
TribeModel.from_pretrained() descarga el checkpoint del codificador TRIBE desde facebook/tribev2 en HuggingFace y lo guarda en cache_folder. Este checkpoint contiene los pesos de integración del Transformer y el bloque de sujeto, pero no los tres extractores de características. Esos se descargan por separado cuando model.predict() usa cada modalidad por primera vez.
Tras cargar solo el codificador TRIBE, se asignan aproximadamente 2–4 GB de VRAM, mientras que los 24–28 GB restantes se consumirán cuando model.predict() cargue V-JEPA2-Giant y LLaMA 3.2-3B en su primer uso.
Después de cargar el modelo TRIBE, la primera llamada a model.predict() con texto activa la descarga perezosa de los pesos de LLaMA 3.2-3B (~6 GB). El timeout por defecto de HuggingFace Hub es de 10 segundos, lo que provoca este error en mitad de la inferencia:
ReadTimeout
The read operation timed out
Computing word embeddings:  0%|  | 0/9 [00:10<?, ?it/s]
Para solucionarlo, aumenta las variables de entorno de timeout y después predescarga LLaMA explícitamente con snapshot_download para obtener progreso visible y reanudación automática en caso de interrupción, en lugar de un fallo silencioso dentro de predict().
import os
os.environ['HF_HUB_DOWNLOAD_TIMEOUT'] = '300'
os.environ['HF_HUB_HTTP_TIMEOUT']     = '300'
from huggingface_hub import snapshot_download
print("Pre-downloading LLaMA 3.2-3B (~6 GB)...")
print("Runs once — subsequent calls load from cache.\n")
snapshot_download(
    repo_id        = "meta-llama/Llama-3.2-3B",
    cache_dir      = "/content/tribe_cache/llama",
    ignore_patterns= ["*.bin"],
)
print("\n LLaMA 3.2-3B cached")
snapshot_download() descarga un repositorio completo a la caché local usando el protocolo de peticiones por rangos de HuggingFace, lo que permite reanudar automáticamente si la conexión se corta a mitad de archivo. El argumento ignore_patterns=["*.bin"] omite el formato binario antiguo de PyTorch y descarga solo los archivos safetensors, reduciendo el tamaño total de descarga alrededor de un 40%.
Antes de ejecutar inferencias reales, configuramos la capa de visualización. Estas funciones auxiliares convierten el array de predicciones (T, 20484) en mapas de calor 3D interactivos con nilearn.
TRIBE v2 devuelve las predicciones como un array de NumPy con forma (T, 20484), donde T es el número de segundos de entrada. Los primeros 10.242 vértices pertenecen al hemisferio izquierdo y los 10.242 restantes al derecho.
Usamos nilearn.plotting.view_surf para renderizar cada hemisferio como una superficie WebGL interactiva. La malla inflada expone la geometría de los surcos que de otro modo quedaría oculta, y el mapa de profundidad de surcos sirve como referencia anatómica bajo el mapa de calor.
La malla fsaverage5 es la plantilla cortical estándar de FreeSurfer que TRIBE v2 usa como espacio de salida. La descargamos una vez aquí para que las visualizaciones posteriores la reutilicen sin volver a pedirla por red.
import numpy as np
from nilearn import datasets as nl_datasets
from nilearn.plotting import view_surf
from IPython.display import display, HTML
N_PER_HEMI = 10242   # fsaverage5: 10242 vertices per hemisphere
print('Fetching fsaverage5 mesh...')
fsavg = nl_datasets.fetch_surf_fsaverage(mesh='fsaverage5')
print('Mesh ready')
print('Keys:', [k for k in fsavg.keys() if k != 'description'])
La función fetch_surf_fsaverage(mesh='fsaverage5') descarga la plantilla fsaverage5 de FreeSurfer desde la CDN de nilearn y la almacena en caché. También devuelve un objeto Bunch (diccionario) con claves como infl_left, infl_right, sulc_left y sulc_right.
Este subpaso define las tres funciones centrales de las que depende toda la visualización del tutorial. split_hemis() particiona el vector de vértices, render_hemi() construye la superficie WebGL interactiva para un hemisferio y show_brain() ensambla ambas en un diseño lado a lado.
def split_hemis(v):
    n = v.shape[0]
    if n == 2 * N_PER_HEMI:
        return v[:N_PER_HEMI], v[N_PER_HEMI:]
    return v[:n//2], v[n//2:]
def render_hemi(pred_vec, hemi='left', title=''):
    lh, rh = split_hemis(pred_vec)
    data = lh if hemi == 'left' else rh
    vmax = max(float(np.percentile(np.abs(data), 99)), 1e-6)
    return view_surf(
        surf_mesh = fsavg[f'infl_{hemi}'],
        surf_map  = data,
        bg_map    = fsavg[f'sulc_{hemi}'],
        hemi      = hemi,
        threshold = '20%',
        cmap      = 'hot',
        black_bg  = True,
        vmax      = vmax,
        bg_on_data= True,
        colorbar  = True,
        title     = title,
    )
def show_brain(pred_vec, title='', t=None):
    sfx = f' — t={t}s' if t is not None else ''
    lv  = render_hemi(pred_vec, 'left',  f'{title} [Left]{sfx}')
    rv  = render_hemi(pred_vec, 'right', f'{title} [Right]{sfx}')
    html = (
        '<div style="display:flex;gap:10px;background:#000;'
        'border-radius:10px;">'
        f'<div style="flex:1">{lv.get_iframe(width="100%",height="460px")}</div>'
        f'<div style="flex:1">{rv.get_iframe(width="100%",height="460px")}</div>'
        '</div>'
    )
    display(HTML(html))
Entendamos en detalle la función de cada helper:
La función split_hemis() corta el vector de predicción en el índice 10.242, que es el punto de partición estándar de la malla fsaverage5 según la convención de FreeSurfer. El hemisferio izquierdo ocupa los índices 0–10241 y el derecho 10242–20483. La rama alternativa maneja casos límite donde el modelo devuelve un número de vértices no estándar.
Dentro de render_hemi(), vmax se calcula como el percentil 99 de los valores absolutos de activación y no como el máximo real. Esto evita que un vértice extremo colapse toda la paleta de colores en un rango estrecho, haciendo visible el patrón espacial.
La función view_surf() devuelve un objeto SurfaceView con 2,4 MB de HTML WebGL autosuficiente. La llamada get_iframe() lo envuelve en una etiqueta <iframe> con el tamaño indicado. Así, al llamar a display(HTML(...)) con dos iframes en paralelo, obtenemos el diseño dividido izquierda/derecha.
Con el modelo cargado y las utilidades de visualización listas, podemos ejecutar la primera inferencia real.
La inferencia en TRIBE v2 sigue dos pasos. Primero, model.get_events_dataframe() extrae eventos alineados en el tiempo a partir de la entrada, junto con tiempos de palabras desde texto, embeddings de Wav2Vec a 2 Hz desde audio o embeddings de V-JEPA2 a 2 Hz desde fotogramas de vídeo.
El DataFrame de eventos resultante se pasa a model.predict(), que ejecuta el Transformer y el bloque de sujeto para producir las predicciones corticales finales.
import tempfile, os
SAMPLE_TEXT = '''
The brain processes language through a distributed network in the left hemisphere.
Broca's area coordinates syntactic structure, while Wernicke's area handles semantics.
Together they form the language circuit activated when reading or hearing speech.
'''
tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
try:
    tmp.write(SAMPLE_TEXT.strip())
    tmp.flush()
    os.fsync(tmp.fileno())
    tmp.close()
    events = model.get_events_dataframe(text_path=tmp.name)
finally:
    if os.path.exists(tmp.name):
        os.unlink(tmp.name)
print(f'Events: {events.shape}')
print(events[['type', 'start', 'duration']].head(8))
print('\nRunning model.predict()...')
preds, segments = model.predict(events=events)
preds = np.asarray(preds)
print(f'Prediction shape: {preds.shape}')
print(f'  T = {preds.shape[0]}s   (1 Hz fMRI frequency)')
print(f'  V = {preds.shape[1]} vertices  (fsaverage5 cortical surface)')
La secuencia de escritura tmp.write(), tmp.flush(), os.fsync(tmp.fileno()), tmp.close() es la corrección crítica para un bug sutil. Si llamas a get_events_dataframe() dentro de un bloque with antes de cerrar el archivo, el buffer interno de escritura de Python puede no haberse sincronizado aún con el SO, y tribev2 leerá un archivo vacío y lanzará ValueError. La llamada os.fsync() garantiza que la caché de páginas del SO se vacíe a disco antes de que tribev2 abra la ruta.
model.predict() devuelve una tupla (preds, segments). El array preds tiene forma (T, 20484): una predicción cortical por segundo de entrada en los 20.484 vértices de fsaverage5. Envolverlo con np.asarray() garantiza que sea un array de NumPy estándar independientemente del tipo interno que devuelva el modelo. Con preds listo, puedes visualizar la respuesta cortical en cualquier instante:
T = preds.shape[0]
print(f'Timesteps: 0 to {T-1}')
T_SHOW = min(5, T - 1)
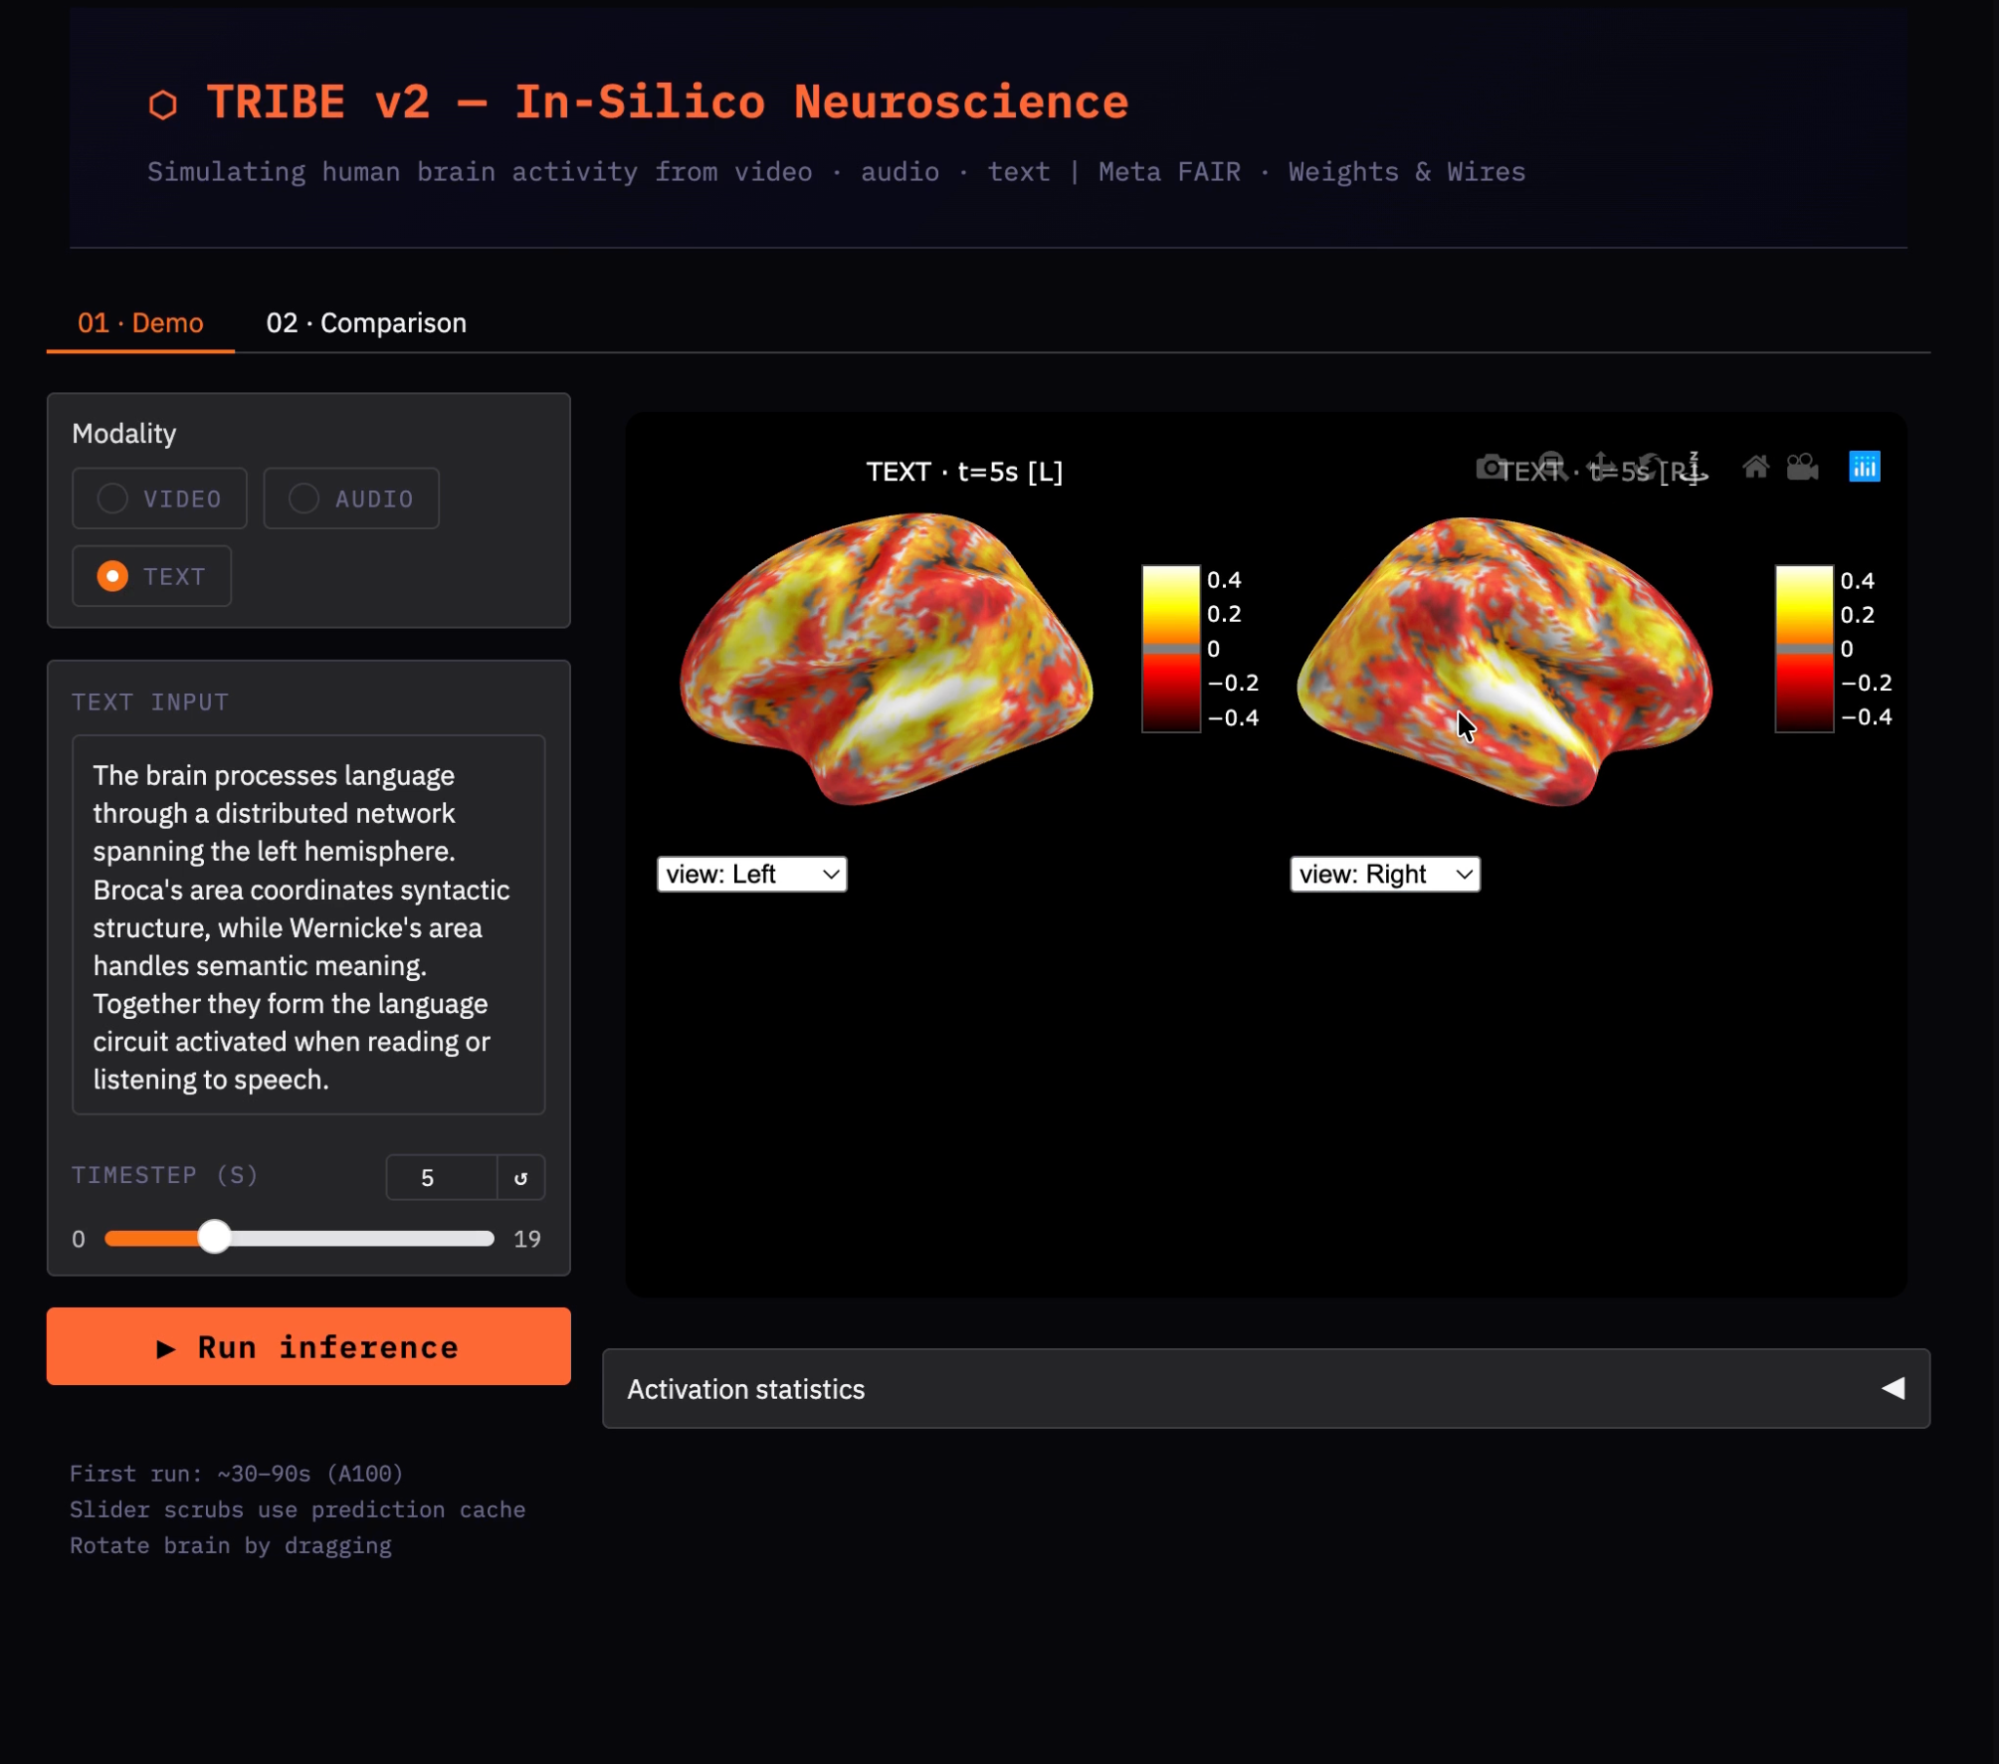
show_brain(preds[T_SHOW], title='Language stimulus', t=T_SHOW)
Por defecto usamos t=5 porque la señal BOLD (Blood-Oxygen-Level-Dependent) tiene un retardo hemodinámico y la respuesta vascular a la actividad neuronal alcanza su pico aproximadamente 5–6 segundos tras el inicio del estímulo. Visualizar en t=0 muestra activación casi nula independientemente del contenido, ya que la respuesta vascular aún no se ha acumulado. La guarda min(5, T-1) evita un error de índice cuando la entrada produce menos de 6 pasos temporales.
Un único mapa de activación te dice qué áreas están activas, pero no qué hace que un estímulo difiera de otro. Este paso ejecuta dos entradas por el modelo y calcula un mapa de contraste (A − B) para aislar las diferencias específicas por región entre contenido lingüístico y contenido visual/espacial.
En lugar de repetir el patrón escribir -> vaciar -> cerrar -> inferir para cada condición, lo encapsulamos en una única función text_to_preds(). Así nos aseguramos de no omitir por error los pasos críticos de vaciado de fichero en ninguna condición.
TEXT_A = '''
She spoke slowly and clearly, her voice filling the quiet room.
Every sentence carried meaning, and each word was chosen with care.
Language connects us, the professor said, bridging minds across time.
'''
TEXT_B = '''
The canyon walls rose steeply, layers of red and orange sandstone.
A hawk circled overhead, its wings barely moving in the thermal current.
Shadows shifted as the sun tracked its arc across the open desert sky.
'''
def text_to_preds(text):
    tmp = tempfile.NamedTemporaryFile(
        delete=False, suffix='.txt', mode='w', encoding='utf-8')
    try:
        tmp.write(text.strip())
        tmp.flush()
        os.fsync(tmp.fileno())
        tmp.close()
        evts = model.get_events_dataframe(text_path=tmp.name)
        p, _ = model.predict(events=evts)
        return np.asarray(p)
    finally:
        if os.path.exists(tmp.name):
            os.unlink(tmp.name)
print('Condition A: language content...')
preds_a = text_to_preds(TEXT_A)
print('Condition B: visual/spatial content...')
preds_b = text_to_preds(TEXT_B)
Usamos dos pasajes de texto con contenido semántico distinto, con el hallazgo esperado de que el contenido lingüístico activa más la corteza temporal del hemisferio izquierdo, mientras que el contenido visual/espacial recluta más la corteza occipital y parietal posterior.
La función text_to_preds() encapsula la canalización completa en una función reutilizable, aplicando el mismo patrón seguro del Paso 8 para que el archivo temporal siempre quede completamente vaciado antes de que tribev2 lo lea. El argumento encoding='utf-8' es explícito para evitar problemas de codificación dependientes de la plataforma.
Con ambas condiciones predichas, las visualizamos por separado y luego las restamos vértice a vértice para obtener el mapa de contraste.
T_shared = min(preds_a.shape[0], preds_b.shape[0])
t_show   = min(5, T_shared - 1)
print('\n[A] Language content:')
show_brain(preds_a[t_show], title='Condition A: Language', t=t_show)
print('\n[B] Visual/spatial content:')
show_brain(preds_b[t_show], title='Condition B: Visual', t=t_show)
print('\n[A − B] Contrast: Language > Visual')
show_brain(preds_a[t_show] - preds_b[t_show], title='Contrast A − B', t=t_show)
El mapa de contraste preds_a[t_show] - preds_b[t_show] es una resta directa por vértice, donde los valores positivos indican regiones donde la condición A activa más y los negativos donde la condición B activa más.
Como ambas condiciones comparten la misma ruta de procesamiento de texto, los mapas brutos tendrán un aspecto en general parecido. Este mapa de contraste resalta las diferencias específicas de dominio entre lenguaje y contenido visual.
Los mapas cerebrales muestran patrones espaciales en un momento concreto. Este paso añade una perspectiva temporal: ¿cómo se compara la activación global entre condiciones a lo largo de todos los instantes y cuándo divergen con más fuerza?
import matplotlib.pyplot as plt
diff_norms = [
    np.linalg.norm(preds_a[i] - preds_b[i])
    for i in range(T_shared)
]
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 3.5))
ax1.plot(np.abs(preds_a).mean(axis=1)[:T_shared],
         color='#e74c3c', linewidth=2, label='A: Language')
ax1.plot(np.abs(preds_b).mean(axis=1)[:T_shared],
         color='#3498db', linewidth=2, label='B: Visual')
ax1.set_title('Mean cortical activation over time')
ax1.set_xlabel('Time (s)'); ax1.legend(); ax1.grid(True, alpha=0.3)
ax2.plot(diff_norms, color='#f39c12', linewidth=2)
ax2.fill_between(range(T_shared), diff_norms, alpha=0.2, color='#f39c12')
ax2.set_title('||A − B|| difference over time')
ax2.set_xlabel('Time (s)'); ax2.grid(True, alpha=0.3)
plt.tight_layout(); plt.show()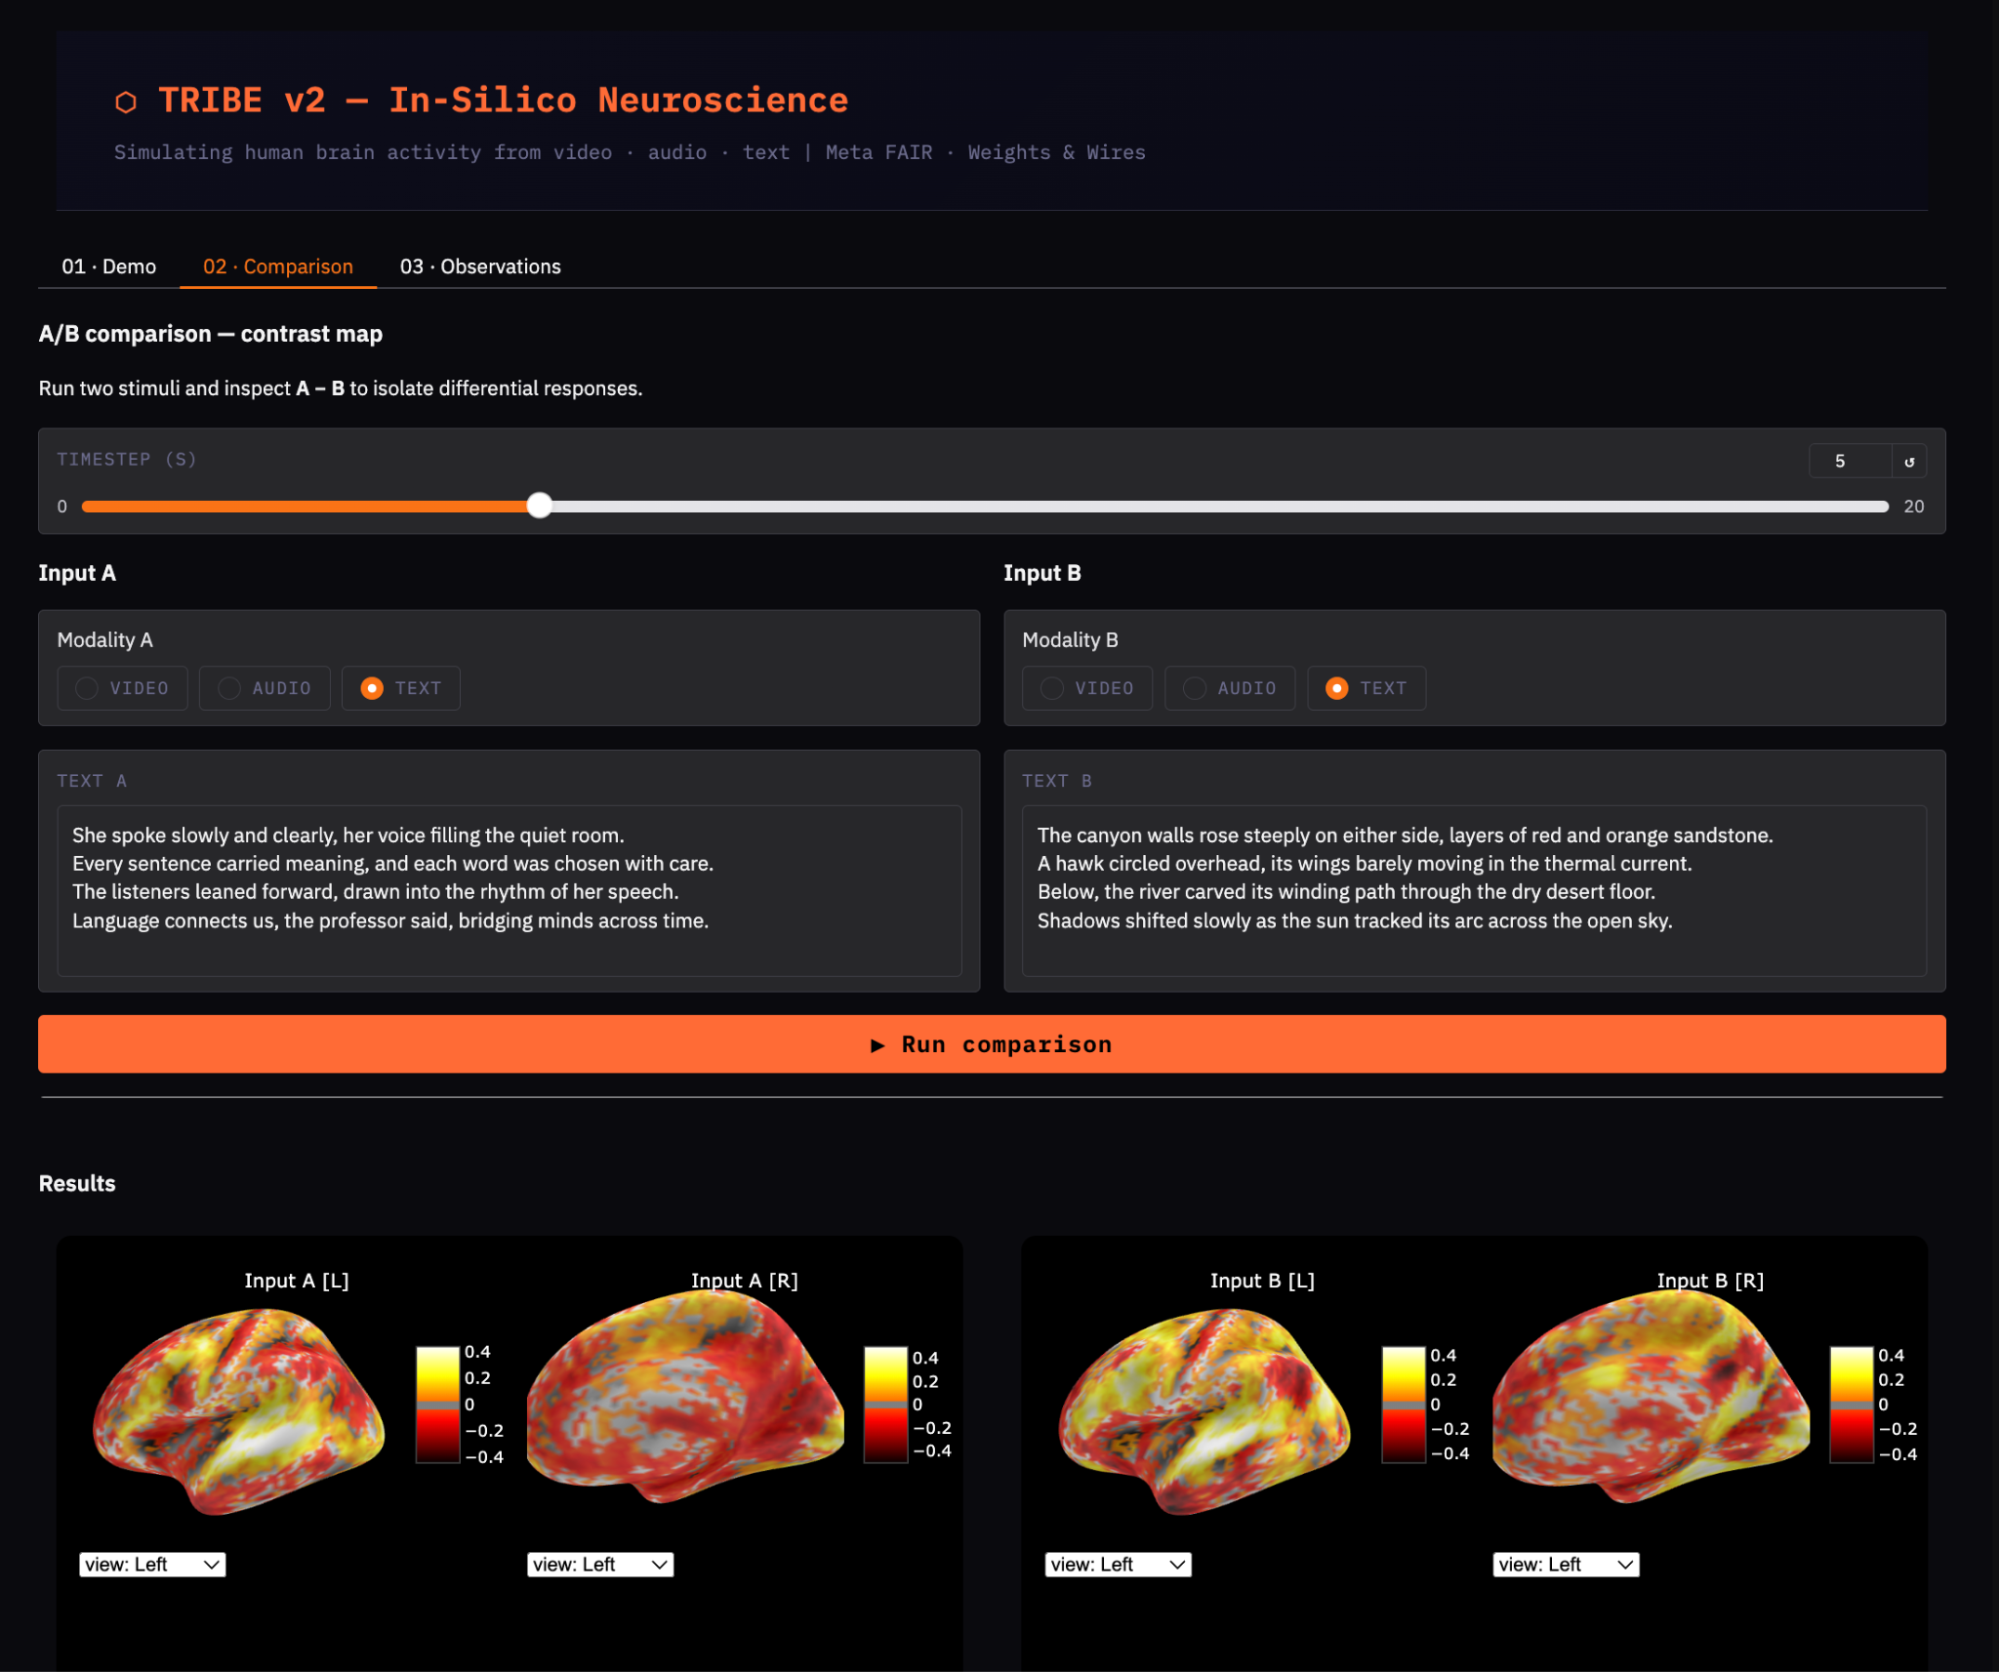
El gráfico de la izquierda representa np.abs(preds).mean(axis=1), la activación media absoluta colapsada en los 20.484 vértices en cada segundo. Muestra cuán intensamente cada condición activa la corteza y cuándo alcanza su pico la respuesta. Tomar el valor absoluto es importante porque los valores BOLD predichos pueden ser negativos (desactivación) y buscamos la magnitud, no la media con signo.
El gráfico de la derecha representa la norma L2 del vector diferencia en cada instante, np.linalg.norm(preds_a[i] - preds_b[i]). Un pico en esta curva alrededor de t=5–7 s es consistente con el retardo hemodinámico: ambas condiciones necesitan tiempo para que se acumule la respuesta BOLD antes de divergir. El sombreado con fill_between() hace más claro visualmente el inicio y el pico de la divergencia.
Este último paso envuelve la lógica de inferencia y visualización en una app de Gradio con una interfaz limpia, un control deslizante de tiempo y una pestaña de comparación A/B.
import gradio as gr
_pred_cache = {}
def _infer(mod, vid, aud, txt):
    """Run inference and cache the result. Subsequent calls return cached array."""
    key = (mod, vid, aud, hash(txt or ''))
    if key not in _pred_cache:
        if mod == 'video':
            evts = model.get_events_dataframe(video_path=vid)
        elif mod == 'audio':
            evts = model.get_events_dataframe(audio_path=aud)
        else:
            tmp = tempfile.NamedTemporaryFile(delete=False, suffix='.txt', mode='w')
            tmp.write((txt or '').strip()); tmp.flush()
            os.fsync(tmp.fileno()); tmp.close()
            evts = model.get_events_dataframe(text_path=tmp.name)
            os.unlink(tmp.name)
        p, _ = model.predict(events=evts)
        _pred_cache[key] = np.asarray(p)
    return _pred_cache[key]
demo.launch(
    share      = True,
    debug      = False,
    server_name= "0.0.0.0",
)
Así es como se combinan la UI de Gradio y la canalización de inferencia:
La función _infer() actúa como la capa central de inferencia, gestionando las tres modalidades (vídeo, audio y texto) preparando entradas, llamando a model.predict() y devolviendo la actividad cerebral predicha.
Se usa una caché de predicciones basada en una clave compuesta por la modalidad, las rutas de entrada y un hash del texto. Así, las entradas idénticas no vuelven a lanzar la inferencia del modelo.
El mecanismo de caché es crítico porque componentes de UI como los deslizadores lanzan callbacks con frecuencia. Sin caché, cada interacción reejecutaría la inferencia (hasta ~60 s); con caché, los resultados se devuelven al instante tras la primera ejecución.
La interfaz ofrece dos pestañas: un modo de entrada única con control deslizante de tiempo para explorar la actividad cerebral a lo largo del tiempo y un modo de comparación que ejecuta dos entradas y visualiza su diferencia como un mapa de calor de contraste.
Por último, demo.launch() está configurado con share=True para generar una URL pública y server_name="0.0.0.0" para permitir acceso externo, lo que facilita el despliegue de la app.
Tras ejecutar la demo con diferentes entradas (vídeo, audio y texto), emergen patrones consistentes que ayudan a interpretar las salidas de TRIBE v2. Algunas ideas de la demo son:
El modelo no pretende ser 100% preciso y tiene sus propias limitaciones:
TRIBE v2 es una potente herramienta de investigación, pero tiene limitaciones importantes que influyen en cómo deben interpretarse sus salidas. Entender estos límites es esencial antes de extraer conclusiones científicas o clínicas de las predicciones.
En este tutorial, construimos una canalización funcional de TRIBE v2 en Google Colab A100: desde resolver dos errores concretos (el conflicto de versiones de NumPy 2.x y el timeout de descarga de HuggingFace), pasando por generar predicciones corticales reales, hasta visualizarlas como mapas de calor 3D interactivos y ejecutar un experimento comparativo que replica el paradigma in silico del artículo.
Las cuatro lecciones de ingeniería más importantes del tutorial son:
Fija NumPy a <2.1 y reinicia el runtime antes de instalar tribev2
Establece HF_HUB_DOWNLOAD_TIMEOUT=300 y predescarga LLaMA con snapshot_download antes de llamar a model.predict()
Escribe siempre → flush() → fsync() → close() los archivos temporales antes de pasar su ruta al modelo
Cachea las predicciones en un diccionario para que las interacciones del deslizador de la UI no vuelvan a ejecutar la inferencia.
A partir de aquí destacan dos extensiones naturales. La primera son estímulos más ricos: clips de película reales o fragmentos de pódcast de 30–60 segundos producen dinámicas temporales y patrones espaciales mucho más claros que pasajes de texto cortos.
La segunda es el fine-tuning individual: con ~1 hora de fMRI de un sujeto específico, el bloque de sujeto de TRIBE v2 puede ajustarse en una época para producir predicciones personalizadas que superan al modelo promedio de grupo por 2–4x según los resultados del artículo.
El cuaderno completo está disponible en el repositorio de GitHub de TRIBE v2. Merece la pena leer el artículo completo, especialmente la Sección 2.5 (experimentos de visión in silico) y la Sección 2.8 (ideas sobre integración multimodal), que muestran lo que este tipo de herramientas hace posible en investigación en neurociencia.
Cursos de deep learning
Programa
Curso
Curso
blog
Abid Ali Awan
10 min
blog
blog
Dr Ana Rojo-Echeburúa
9 min
Tutorial
Aashi Dutt
14 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Dimitri Didmanidze
8 min