

Apache Hadoop 的生态系统
Hadoop 已成为数据处理的事实标准,就像 Excel 逐渐成为数据分析的默认软件一样。与 Excel 不同,Hadoop 是由开发人员而非“业务分析师”设计的,但其大规模采用与成功却取决于业务分析师而非开发人员。基于此,业界从功能角度对大数据问题进行了细分,并针对每个细分场景基于 Hadoop 开发了相应技术来应对挑战。这些工具共同构成了所谓的 Hadoop 生态系统。
Hadoop 生态系统丰富了 Hadoop 的能力,使其能够解决各类业务问题。迄今为止,Hadoop 生态系统由数百种技术组成,我们根据问题类型将其归为 14 类:抽象语言、Hadoop 上的 SQL(Hive 和 Pig)、计算模型(MapReduce 和 Tez)、实时处理工具(Storm 和 Spark Streaming)、数据库(HBase 和 Cassandra)、流式摄取工具(Kafka 和 Flume)、数据集成工具(Sqoop 和 Talend)、工作流协调工具(面向 Hadoop 的 Oozie 和 Control M)、分布式服务协调工具(Zookeeper)、集群管理工具(Ranger 和 Sentry)、用户界面工具(Hue 和 Jupyter)、内容索引工具(ElasticSearch 和 Splunk)、分布式文件系统(HDFS)以及资源管理器(YARN 和 MESOS)。本节将回顾构成这一大数据技术生态的各工具的功能。之后,如需深入了解,建议阅读我们在本文之后将推出的关于不同 Hadoop 生态组件的指南。下方的思维导图总体展示了 Hadoop 生态系统。
Hadoop 生态系统启发式地图
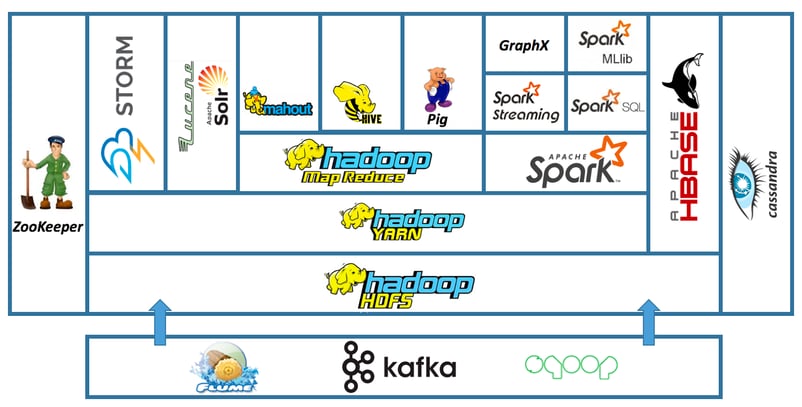
Hadoop 生态系统的基础配置包含以下技术:Spark、Hive、Pig、HBase、Sqoop、Storm、ZooKeeper、Oozie 和 Kafka。
Spark
在解释 Spark 是什么之前,先回顾一点:要让某个算法能在 Hadoop 的多节点集群上运行,它必须可并行化。因此,若算法可并行化(从而能利用集群的可扩展性),我们便说该算法具有“可扩展性”。Hadoop 是 MapReduce 计算模型的实现。MapReduce 的问题在于它建立在有向无环图模型之上。换言之,MapReduce 的操作序列以三段直接的顺序阶段运行,不存在迂回(Map -> Shuffle -> Reduce);各阶段都不是迭代(或循环)的。
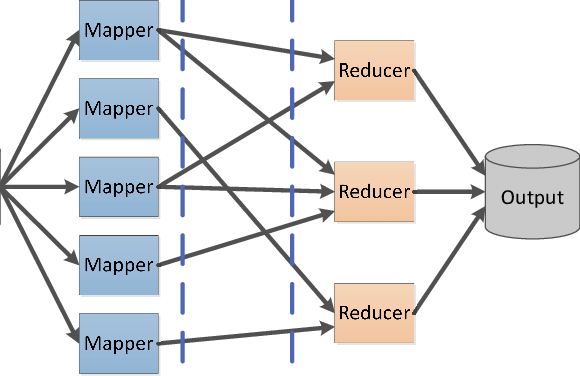
有向无环模型不适用于某些应用,尤其是那些在多次操作间复用数据的场景,如大多数统计学习算法以及迭代式、交互式的数据分析查询。Spark 回应了这些局限;它是在集群上进行内存中分布式处理的计算引擎。换句话说,它是一个分布式内存计算引擎。与批处理模式运行的 MapReduce 相比,Spark 的计算模型以交互模式工作,即在处理前将数据装载到内存,因而非常适合机器学习处理。
Hive
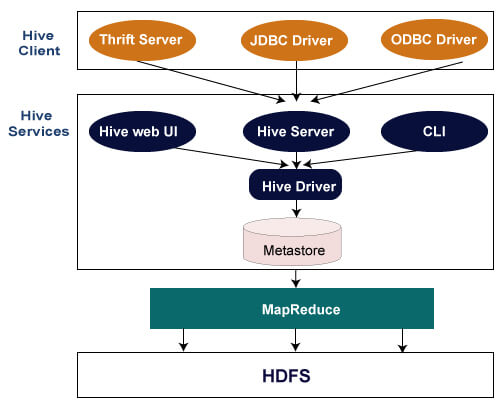
Hive 是类似数据仓库的计算基础设施,为存储在诸如 HDFS 等分布式文件系统上的海量数据提供查询与聚合服务。Hive 提供基于 SQL(ANSI-92 标准)的查询语言 HiveQL(Hive Query Language),用于查询存储在 HDFS 上的数据。HiveQL 还允许高阶用户/开发者将 Map 和 Reduce 函数直接集成到查询中,以覆盖更广泛的数据管理问题。当您用 HiveQL 编写查询时,Hive 会将该查询转换为一个 MapReduce 作业并提交给 JobTracker 执行。
Pig
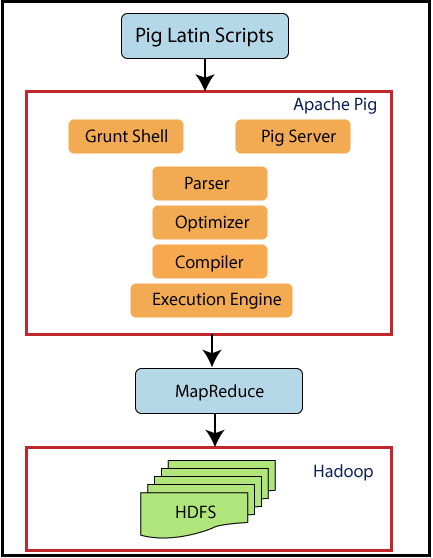
Pig 是 Hadoop 下的交互式数据流执行环境。它由两部分组成:一种称为 Pig Latin 的数据流表达语言,以及一个交互式数据流执行环境。
Pig 提供的语言 Pig Latin 大致类似 Perl、Python 或 Ruby 等脚本语言。然而,它比这些语言更专用,更适合描述为一种“数据流语言”。它允许您以 ETL 的方式,针对源数据编写按序的数据流查询,以在 Hadoop 下获得“目标”数据。这些数据流随后被转换为 MapReduce 函数并最终提交给作业跟踪器执行。简言之,Pig 是 Hadoop 的 ETL。用 Pig Latin 编程意味着通过称为算子的特定 Pig 语句,以相互独立但可嵌套的数据流描述数据如何加载、转换与聚合。掌握这些算子是精通 Pig Latin 编程的关键,尤其是相较 Hive,其算子数量并不多。
HBase
在介绍 HBase 前,先提醒一下:迄今用于数据管理的关系型数据库(RDBMS)在海量与多样化数据面前很快暴露出局限。RDBMS 仅用于管理结构化数据(按行/列的表格数据);此外,数据量的增长会增加请求延迟。这种延迟对于许多需要近实时响应的业务是有害的。为弥补这些不足,出现了称为“NoSQL”的新型数据库管理系统。这类系统不对数据施加特定结构,可将数据的存储与管理分布到多节点,并具备可扩展性。提醒一下,可扩展性意味着系统在处理负载增加时仍能保持稳定性能。HBase 属于这类数据库管理系统。
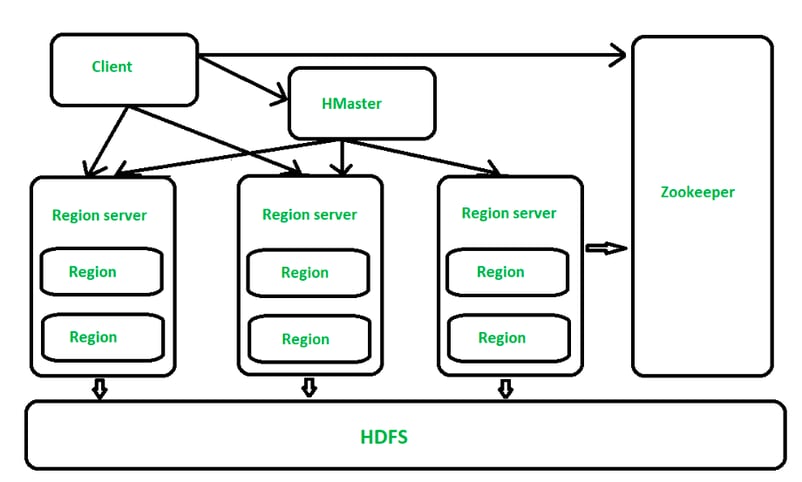
HBase 是一个分布式、列式的 DBMS,为存储在 HDFS 上的数据提供实时的读写访问。HDFS 提供批量的顺序数据访问,不适合如流式等快速访问需求;HBase 弥补了这些缺口,为存储在 HDFS 上的数据提供快速访问。
HBase 基于 Google 的“BigTable”数据库管理系统,可存储极其庞大的数据量(数十亿行/列)。它依赖 ZooKeeper——一个面向应用开发的分布式协调服务。
Sqoop
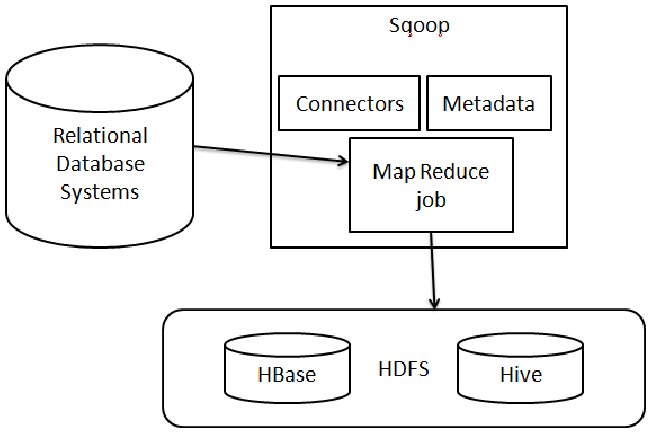
Sqoop 或 SQL-to-Hadoop 是一种在关系型数据库与 Hadoop 的 HDFS 之间双向传输数据的工具。它与 Hadoop 生态系统集成,是 Hadoop 中的数据摄取调度器。您可以使用 Sqoop 将 MySQL、Oracle 或 SQL Server 等 RDBMS 的数据导入 HDFS,在 Hadoop 中通过 MapReduce 或其他计算模型转换数据,再将其导回 RDBMS。之所以称其为数据摄取调度器,是因为它像 Oozie 一样能自动化该导入/导出流程并调度执行时间。作为用户,您只需编写用于执行导入/导出动作的 SQL 查询。此外,Sqoop 使用 MapReduce 导入与导出数据,既高效又具备容错性。
Storm
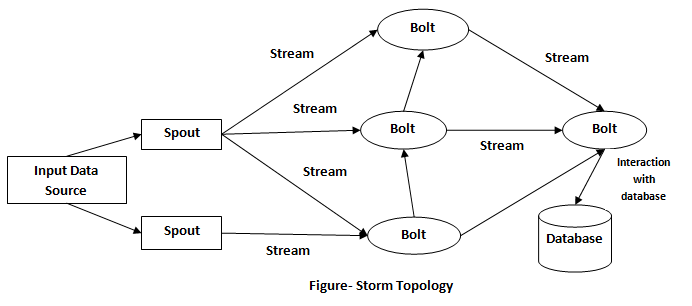
要理解 Storm,您需要理解 Lambda 架构(λ)的概念及其意义。您还需要理解“连接对象”的概念。所谓连接对象或物联网(IoT),是互联网向我们日常生活的延伸。它产生流式数据,并在大多数场景中要求实时处理。您熟悉的模型,如批处理模型,并不适应物联网所提出的实时问题。即便是交互式计算模型,也不适合做持续的实时处理。与企业财务、市场等运营系统产生的运营数据不同,这些数据即使以流式方式产生,也可被历史化以供后续处理;而在 IoT 或互联网等现象中产生的流式数据在创建后的瞬间即过期(或不再有效),因此需要立即处理。除了连接对象之外,诸如反欺诈、社交网络数据分析、地理定位等业务问题也要求极低的响应时间,几乎小于一秒。为在大数据背景下解决这一问题,提出了所谓的 λ 架构。这类架构在 MapReduce 之上增加两层额外处理层以降低延迟。Storm 是 λ 架构的软件实现。它使 Hadoop 下的应用能够对数据进行实时(或近实时)处理。
ZooKeeper
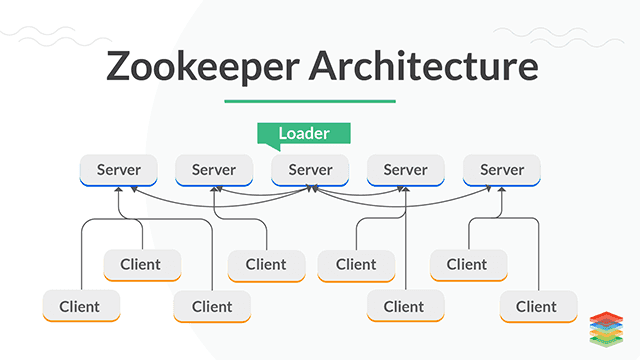
在执行并行任务时同步或协调各节点间的通信,是分布式应用开发中最困难的问题之一。为解决这一问题,Hadoop 将服务协调工具引入其生态系统,即 ZooKeeper。ZooKeeper 负责处理集群中分布式作业执行同步所固有的复杂性,这意味着 Hadoop 生态内的其他工具无需自行处理该问题。它还允许用户在不精通分布式编程的情况下开发分布式应用。撇开在 Hadoop 集群各节点间协调数据的复杂细节不谈,ZooKeeper 为分布式应用提供分布式配置服务、分发服务以及命名注册表。ZooKeeper 是 Hadoop 协调分布式作业的方式。
Oozie
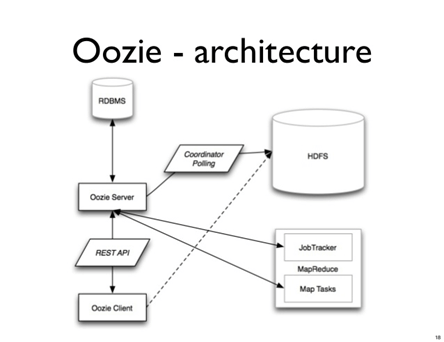
默认情况下,Hadoop 会按用户提交的顺序执行作业,而不考虑它们之间可能存在的关系。然而,Hadoop 所用于解决的问题通常需要编写一个或多个复杂作业。当两个作业被提交给 JobTracker(或 YARN)时,后者会在不考虑它们之间关联的情况下执行,这可能导致错误(异常)并使代码中止。如何管理与同一问题相关的多个作业的执行?为管理此类问题,目前最简单的解决方案是使用作业调度器,即 Oozie。
Oozie 是一个作为服务运行在 Hadoop 集群上的作业调度器。它用于调度 Hadoop 作业,更广义上用于调度所有可在集群上运行的作业的执行,如 Hive 脚本、MapReduce 作业、Hama 作业、Storm 作业等。它旨在自动管理 Hadoop 集群上数千个相互依赖作业的即时或延迟执行。要使用 Oozie,您只需配置两个 XML 文件:一个 Oozie 引擎配置文件和一个作业工作流配置文件。
Cloudera 简介
Cloudera 是一家总部位于加利福尼亚的美国公司,历史上专注于基于 Hadoop 分布式框架的大数据解决方案;目前正转向云端。在过去一年多里,Cloudera 不断在公有云 AWS、Azure 和 GCP 上扩展其解决方案。
CDP 简介
Cloudera Data Platform(CDP)是一款平台,允许企业在混合与多云环境中使用自助式分析来分析数据。它使组织能够在数小时内在云中创建数据湖,从而从全部数据中获取更大价值。
CDP 提供集成、多功能的自助式工具以分析并集中管理数据。此外,它提供企业级安全与治理,可部署在公有云、私有云与多云环境中。CDP 是 Cloudera 之前两大发行版(Cloudera Distribution of Hadoop,CDH 与 Hortonworks Data Platform,HDP)的后续发行版。
企业数据的自助访问是该服务的核心。新增并集成到平台中的云服务同样为分析师、数据科学家、IT 专业人士与开发人员提供对数据与分析的自助访问。将该平台与竞争对手区分开的关键词,是 Cloudera 提出的三大云原生 CDP 服务特性:自助式、多云与安全。
CDP 提供独特的公私结合路径、实时数据分析、可扩展的本地、云端与混合部署选项,以及“隐私优先”的架构。
CDP 公有云
CDP 公有云是一种平台即服务(PaaS),兼容云基础设施,并可在包括 OpenShift 等私有方案在内的各云提供商之间轻松迁移。CDP 被设计为完全集成的混合与多云,即一个平台即可管理全部数据生命周期用例。CDP 平台可在多种设置下与数据协同工作,包括 AWS、Azure 与 GCP 等公有云。此外,它还能根据需要自动扩缩工作负载与资源,以提升性能并降低成本。
CDP 公有云服务
以下是构成 CDP 公有云的主要组件:
-
CDP Data Engineering 是一体化配置,构建于 Apache Spark 之上。它通过借助 Apache Airflow 实现编排与自动化,简化企业数据分析团队的 ETL 流程,并提供高度完善的管道监控、可视化调试与管理工具。此外,它具备隔离的工作环境,并以容器化、可扩展、易迁移为特征。
-
CDP Data Hub 是一项允许从边缘到 AI 的高价值分析服务。Cloudera Data Hub 是云原生的数据管理与分析服务。它使 IT 与业务开发者能够更快地为任何场景构建业务应用,从流式到 ETL。数据集市、数据库与机器学习只是其广泛分析工作负载所覆盖服务的一部分。
-
CDP Data Warehouse 使 IT 能为 BI 分析师提供云原生的自助式分析体验。流处理、数据工程与分析在 CDP Data Warehouse 中实现了全面集成。此外,它拥有统一框架,可在私有、多公有或混合云中保护与治理您的所有数据与元数据。Cloudera Data Warehouse 服务让数据分析师能够轻松部署自助式数据仓库。它基于稳健、经过企业验证的 SQL 引擎。数百名用户可一键访问本地与云端的数据。资源可按需扩缩,且工作负载管理也通过直观工具实现自助。
-
CDP Machine Learning 便于部署协作式机器学习工作空间,使数据科学家能够利用企业数据。它使用原生且全面的工具优化机器学习工作流,以部署、分发并监控模型。借助该工具,组织只需几次点击即可快速部署新的机器学习工作空间,提供机器学习工作流所需工具与数据的自助访问。此外,无论在本地还是云端,数据复制都可以在不损害安全与治理的前提下快速完成。数据科学家还能自由选择工具,同时利用可按需调整的弹性资源。模型训练、数据工程、部署与模型管理可通过一站式界面快速完成,无需在平台间切换。
-
Cloudera Data Visualization 使用户能够在虚拟数据仓库中对数据建模,而无需移除或更新底层数据结构或表;并且可以在无需持续装载数据的情况下查询海量数据,从而节省时间与成本。
-
Cloudera Operational Database 是一种托管解决方案,将底层集群实例综合为一个数据库。它会基于集群工作负载利用率自动扩缩,提高在相同基础设施占用下的性能,并自动解决运维问题。
CDP 私有云
CDP 私有云更适合混合云部署,允许本地环境连接到公有云,同时保持一致、集成的安全与治理。在 CDP 私有云中,计算与存储是解耦的,允许两个集群独立扩展。Cloudera Shared Data Experience(SDX)可在 CDP 私有云基础集群上提供统一的安全、治理与元数据管理。此外,CDP 私有云用户可通过 Management Console 快速配置与部署 Cloudera 数据仓库与 Cloudera 机器学习服务,并按需扩展。
CDP 私有云服务
部分 CDP 公有云组件(如 Machine Learning 与 Data Warehouse)可在 CDP 私有云中使用。它利用覆盖流处理、数据工程、数据集市、运营数据库与数据科学的一组分析引擎,以支持传统工作负载。
HDFS 与 MapReduce 基础
HDFS 是 Hadoop 的分布式文件系统,也是 Hadoop 的核心组件,允许在多台服务器上存储与复制数据。结合 YARN,它提升了 HDFS Hadoop 集群的数据管理能力,从而实现高效的大数据处理。
您可以在通用硬件上运行 HDFS,这使其具有很强的容错性。每条数据都会被存储在多个位置,并可在任何情况下恢复。此外,这种副本机制还能对抗潜在的数据损坏。
HDFS 使用 NameNode 和 DataNode。DataNode 是用于存储数据的标准服务器。NameNode 包含元数据(存储在不同节点上的数据)。应用程序仅与 NameNode 交互,而 NameNode 按需与数据节点通信。
HDFS 还通过专注于移动操作而非移动数据来避免网络拥塞。这意味着应用程序可以在数据所在处直接访问数据。最后一个优势是其可移植性。它可以在不同类型的硬件上运行,且不存在任何兼容性问题。
什么是 MapReduce?它如何工作?
MapReduce 是 Apache Hadoop 的处理引擎,直接源自 Google 的 MapReduce。MapReduce 应用主要用 Java 编写。它通过对海量数据应用映射与归约步骤,来轻松计算并求解手头问题。映射步骤接收一个数据集,将其转换为另一个数据集,即将各个元素分解为称为元组的键/值对。第二个归约步骤接收映射过程的输出,并将这些数据元组合并为更小的一组元组。
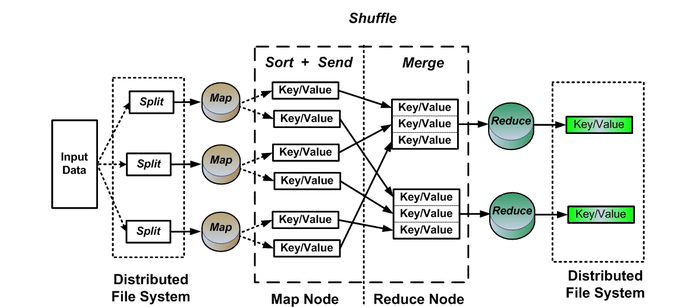
MapReduce 是高度并行的处理框架,可在海量通用硬件上轻松扩展,以满足对海量数据处理不断增长的需求。一旦映射与归约任务运行顺畅,只需调整配置即可在更大的数据集上运行。这种从单节点到数百甚至数千节点的极致可扩展能力,使 MapReduce 成为全球大数据专业人士的心头好。
MapReduce 提供广泛功能,包括:
- 实现大数据任务所需的并行处理。
- 适用于多种商业数据处理应用。
- 为集中式处理框架提供具成本效益的解决方案。
- 可与 SQL 集成,以便于并行处理能力。
Cloudera 的 Apache Hadoop 发行版
Cloudera 与 Hortonworks、MapR 一样,是 Hadoop 领域的历史性纯玩家之一。该集团在英特尔的支持下开发了 CDH,这是一套包含多种其他开源项目(如 Impala 与 Search)的 Hadoop 发行版,同时也提供安全与集成功能。
Impala 框架是交互式 SQL 查询引擎,允许直接查询存储于 HDFS、Apache HBase 或 AWS S3 的数据。该引擎依赖于 Hive 的其他技术与组件,如其 SQL 语法(HiveSQL)、开放数据库连接驱动(ODBC)以及查询界面。
Search 组件基于 Apache Solr 项目,这是一款构建在 Lucene 之上的数据索引与搜索引擎。将该技术集成到 CDH 中,可获得几乎实时的索引能力,以及对存储在 Hadoop 或 HBase 集群中的数据的访问。例如,Solr 技术允许在无需具备大量 SQL 技能的情况下执行复杂的全文搜索。Solr 使您能够查询 Hadoop 数据,而无需先移动数据。
Cloudera 提供多个 CDH 版本,每个版本具备不同的服务与集群管理功能,并提供不同级别的支持:
- Cloudera Express 是 CDH 的免费版本,包含 CDH 的元素和 Cloudera Manager 的核心功能。此外,它提供 Enterprise 版的 30 天评估权限。
- Cloudera Manager 是 CDH 的控制塔。该工具提供基于 Web 的管理控制台,用于部署、管理、监控与控制 CDH 部署的健康状况。它还包含一个 API,用于配置系统并检索有关 CDH 集群运行的指标与信息。
- Cloudera Enterprise 是付费许可版本,因此具有扩展功能。例如,它包含从 Cloudera Manager 与 Navigator 中提取的高级工具。
- Cloudera Manager Advanced Features 为 Cloudera Express 增加关键功能:运营报告、配额管理、配置日志、连续更新、服务重启、Kerberos 集成、LDAP 集成、SNMP 支持以及自动灾难恢复。
- Cloudera Navigator 仅随 Flex 与 Data Hub 版本提供,使得可在 CDH 平台内进行数据安全与治理管理。该工具支持企业的合规要求。借助它,数据管理者、分析师与管理员可以探索存储在 Hadoop 中的大量数据,并更轻松地管理用于保护 CDH 集群数据的加密密钥。
要搭建一个概念验证环境,您必须先下载并运行 Cloudera Manager Server 安装程序。
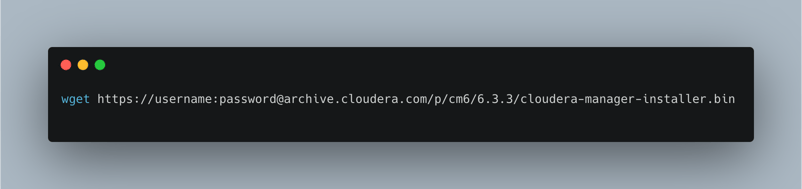
- 首先,您需要在浏览器中打开 Cloudera Manager 下载页面。在 Cloudera Manager 框中点击 Download Now。您也可以下载与您的 Cloudera Manager 版本相对应的安装程序。例如,对于 Cloudera Manager 6.3.3:
- 接下来,您需要运行 Cloudera Manager 安装程序。
首先,将 Cloudera-manager-installer.bin 修改为可执行权限:chmod u+x Cloudera-manager-installer.bin
运行安装程序,使用以下命令:sudo ./cloudera-manager-installer.bin --username=username --password=password
- 阅读并接受相关许可协议
安装程序随后会:
- 安装 Cloudera Manager 存储库文件。
- 安装 Oracle JDK。
- 安装 Cloudera Manager Server 与嵌入式 PostgreSQL 软件包。
安装完成后会显示 Cloudera Manager 管理控制台的完整 URL,包括端口号(默认 7180)。请先记下该 URL。然后按 Enter 选择 OK 以退出安装程序,并确认安装成功。
下一步是使用向导安装 CDH。
- 通过登录以下地址,进入您的 Cloudera Manager 管理控制台:HTTP://:7180,其中 为运行 Cloudera Manager Server 的主机的 FQDN 或 IP 地址。
- 登录 Cloudera Manager 管理控制台。默认凭据为:
**Username**: admin **Password**: admin
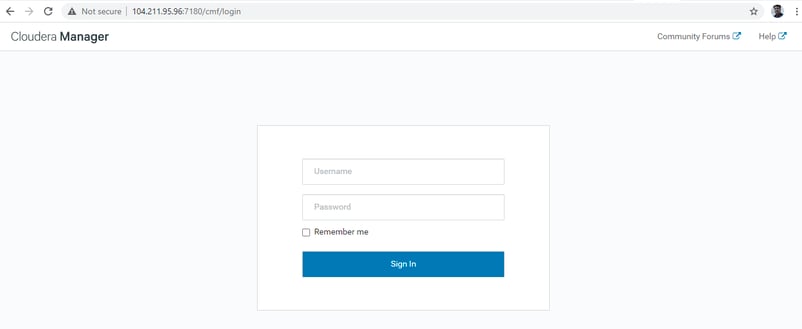
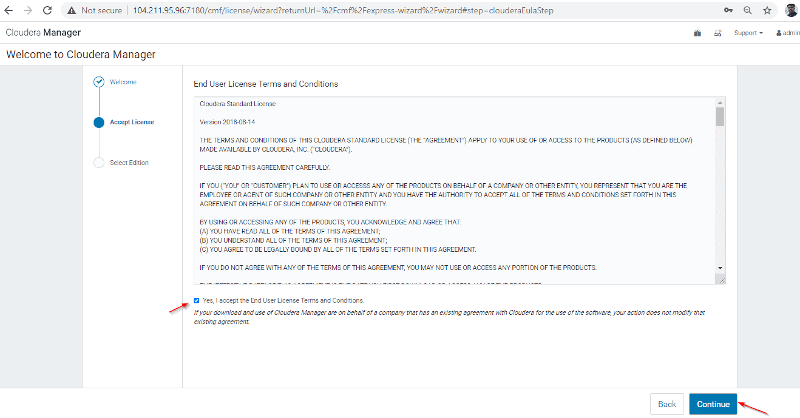
阅读条款并接受:点击 Continue,安装向导将启动。
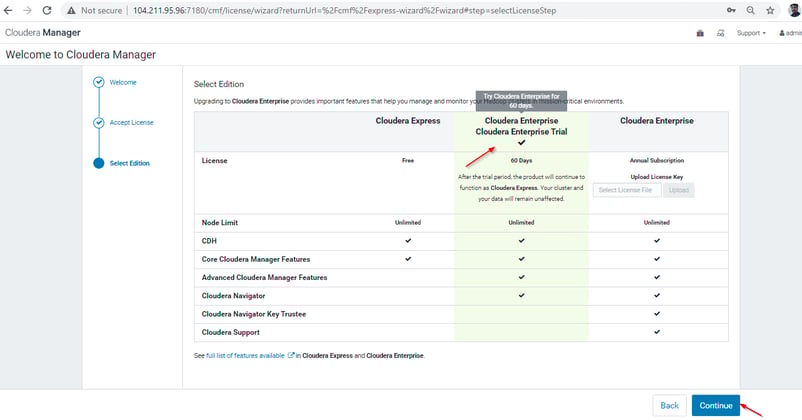
Cloudera Manager 的安装向导将引导您完成如下步骤:选择版本(Select Edition) 您可以选择要安装的版本,并可选安装许可证。
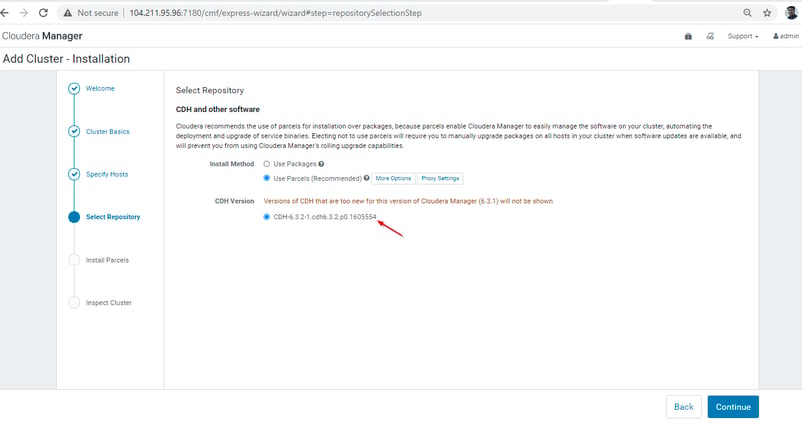
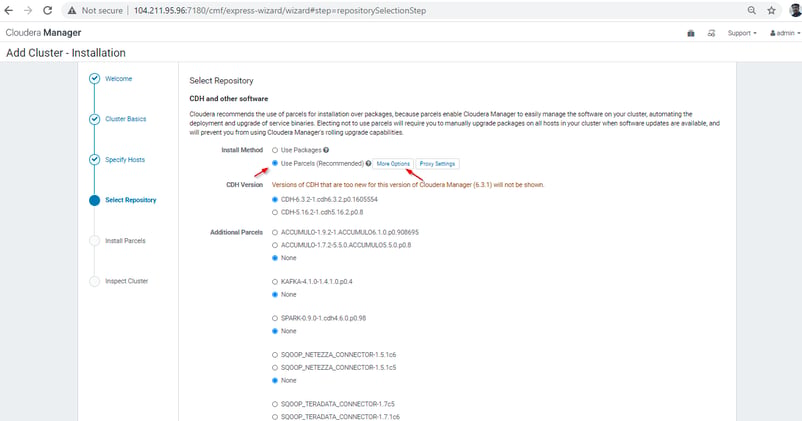
指定主机(Specify Hosts) 选择用于运行 CDH 和其他受管服务的主机。选择仓库(Select Repository) 在此您需要:
- 首先,选择用于安装的仓库类型。对于此概念验证集群,建议选择 Use Parcels。
- 然后,选择要安装的 CDH 版本以及希望安装的其他 Parcel。
- 您还可以选择要安装的 Cloudera Manager Agent 版本。
- 点击 Continue。
接受 JDK 许可(Accept JDK License) 通过安装 JDK 软件,您同意受 Oracle 二进制代码许可协议 约束。阅读许可条款并勾选相应选框后,点击 Continue。
输入登录凭据(Enter Login Credentials) 定义 root 账户、用户名、认证方式、SSH 端口与主机数量。
安装代理(Install Agents) 安装代理页面显示安装进度。您可展开任一主机的详情以查看安装日志。
安装 Parcels(Install Parcels) 安装 Parcels 页面显示您先前所选各 Parcel 的安装进度。您可以点击任一特定进度条查看该主机的详细信息。
检查主机(Inspect Hosts) 检查主机页面运行 Host Inspector 以查找常见配置问题。查看结果并处理识别出的问题。完成更改后,点击 Run Again 按钮以更新结果。
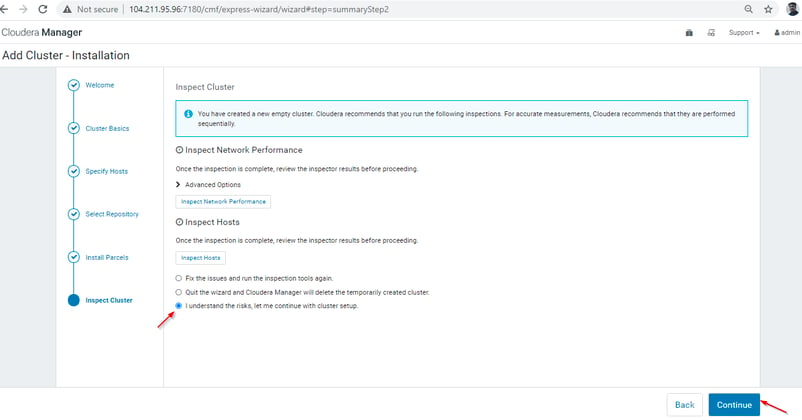
完成上述所有步骤后,集群设置向导将自动启动。
总结
Hadoop 为企业带来的益处十分可观。借助该框架,凭借其分布式计算能力,能够快速存储与处理海量数据。被处理的数据与应用可免受硬件故障的影响。如果某个节点故障,作业会直接重定向到其他节点,确保分布式计算不中断。所有数据的多份副本会自动存储。您可以在此处阅读更多成功案例,并关注我们的博客获取更多数据科学相关更新。
什么是 Apache Hadoop?
Hadoop 是一个用于分布式应用与数据密集型管理的开源 Java 框架。它允许应用在成千上万的节点与 PB 级数据上工作。Hadoop 的灵感来源于 Google 的 MapReduce、GoogleFS 和 BigTable 相关论文。
得益于 MapReduce 框架,它可以处理海量数据。MapReduce 并非将数据移至网络中进行处理,而是使处理软件直接“移向”数据所在处。
它本身并非一款产品,而是一套用于分布式数据存储与处理的框架。多家软件供应商已利用 Hadoop 构建了商业化的大数据管理产品。
Hadoop 数据系统在规模上不受限制,这意味着可以增加更多硬件与集群来支撑更重的负载,而无需重新配置或购买昂贵的软件许可。
Apache Hadoop 的历史与发展趋势
Cloudera 由数学家 Jeff Hammerbach(曾就职于贝尔斯登与 Facebook)于 2008 年共同创办,他负责数据分析并开发更佳广告投放的程序。其他联合创始人包括前 Google 员工 Christophe Bisciglia、曾参与 Hadoop 的前 Yahoo 员工 Amr Awadallah,以及 Cloudera CEO Mike Olson。首席架构师是 Doug Cutting,他是 Lucene 索引引擎与 Hadoop 分布式框架的幕后人物。
2018 年,Cloudera 与其主要竞争对手 Hortonworks 合并。此后公司开始进行业务重心调整,向云领域开放。2021 年,Cloudera 被两家私募股权基金 KKR 和 Clayton Dubilier & Rice 以 53 亿美元收购,为其持续拓展市场奠定了坚实基础。
Hadoop 的起点可追溯到 2002 年,当时 Doug Cutting 与 Mike Cafarella 开始从事 Apache Nutch 项目。Apache Nutch 致力于创建一套能够索引 10 亿网页的搜索引擎系统。经过大量研究,他们得出结论:这样的系统需要约 50 万美元的硬件成本,以及每月约 3 万美元的运营成本,代价极高。于是他们意识到,这样的项目架构无法绕开数十亿网页的规模。他们需要一种既能降低实现成本,又能解决大规模数据集存储与处理问题的方案。
2003 年,他们看到一篇由 Google 发表的论文,描述了用于存储海量数据的 Google 分布式文件系统 GFS(Google File System)的架构。他们意识到,这篇论文能够解决因网页抓取与索引而产生的大文件存储问题。但这仅能解决他们问题的一半。
2004 年,Google 又发表了一篇关于 MapReduce 技术的论文,提供了处理这些超大数据集的解决方案。对于 Doug Cutting 与 Mike Cafarella 在 Nutch 项目中遇到的问题,这篇论文构成了另一半答案。不过,这些技术(GFS 和 MapReduce)在 Google 当时只是白皮书层面的描述,尚未实现。Doug Cutting 从 Apache Lucene 的经验中深知,开源是让技术传播到更多人手中的极佳方式。因此,他与 Mike Cafarella 一起,开始在 Apache Nutch 项目中以开源方式实现 Google 的这些技术(GFS 与 MapReduce)。
2005 年,Cutting 发现 Nutch 仅能扩展到 20–40 个节点的集群。他很快意识到两个问题:(a)除非在更大规模集群上也能稳定工作,否则 Nutch 无法发挥其潜力;(b)仅凭两个人(Doug Cutting 与 Mike Cafarella)似乎不可能完成。Nutch 项目中的工程任务远超他的想象,于是他开始寻找愿意投入资源的公司。最终,他发现 Yahoo! 拥有一支渴望投入此项目的优秀工程师团队。
2006 年,Doug Cutting 携 Nutch 项目加入 Yahoo。他希望在 Yahoo 的帮助下,为全球提供一个开源、可靠且可扩展的计算框架。正是在 Yahoo,Cutting 将 Nutch 的分布式计算部分剥离,形成了新的 Hadoop 项目。他以儿子的黄色玩具小象为其命名“Hadoop”;这个词也独特且易于发音。他希望 Hadoop 能在数千个节点上良好运行,于是开始基于 GFS 与 MapReduce 打造 Hadoop。
2007 年,Yahoo 成功在 1000 节点集群上测试了 Hadoop,并开始投入使用。
2008 年 1 月,Yahoo 将 Hadoop 作为开源项目发布给 ASF(Apache 软件基金会)。2008 年 7 月,ASF 成功在 4000 节点集群上测试 Hadoop。
到 2009 年,Hadoop 成功在不到 17 小时内完成 1 PB 数据的排序,能够处理数十亿次搜索并索引数百万网页。同年,Doug Cutting 离开 Yahoo 加入 Cloudera,迎接将 Hadoop 推向其他行业的挑战。