

Ekosistem Apache Hadoop
Hadoop menjadi standar de facto untuk pemrosesan data, seperti halnya Excel secara bertahap menjadi perangkat lunak default untuk analisis data. Tidak seperti Excel, Hadoop dirancang oleh pengembang alih-alih "Analis Bisnis", namun adopsi dan keberhasilan skala besar bergantung pada analis bisnis, bukan pengembang. Karena itu, masalah Big Data disegmentasi dari sudut pandang fungsional, dan untuk setiap segmen, teknologi berbasis Hadoop dikembangkan untuk menghadapi tantangannya. Semua alat ini membentuk apa yang disebut ekosistem Hadoop.
Ekosistem Hadoop memperkaya Hadoop dan membuatnya mampu menyelesaikan beragam masalah bisnis. Hingga saat ini, ekosistem Hadoop terdiri dari ratusan teknologi yang kami kelompokkan ke dalam 14 kategori sesuai segmen permasalahannya: bahasa abstraksi, SQL di Hadoop (Hive dan Pig), model komputasi (MapReduce dan Tez), alat pemrosesan real-time (Storm dan Spark Streaming), basis data (HBase dan Cassandra), alat ingestion streaming (Kafka dan Flume), alat integrasi data (Sqoop dan Talend), alat koordinasi workflow (Oozie dan Control M for Hadoop), alat koordinasi layanan terdistribusi (Zookeeper), alat administrasi klaster (Ranger dan Sentry), alat antarmuka pengguna (Hue dan Jupyter), alat pengindeksan konten (ElasticSearch dan Splunk), sistem berkas terdistribusi (HDFS), dan pengelola sumber daya (YARN dan MESOS). Bagian ini akan meninjau fungsi setiap alat yang membentuk ekosistem teknologi Big Data ini. Setelah itu, jika Anda ingin melangkah lebih jauh, kami sarankan membaca panduan kami tentang berbagai elemen Ekosistem Hadoop yang akan mengikuti artikel ini. Peta pikiran berikut menyajikan ekosistem Hadoop secara global.
Peta heuristik ekosistem Hadoop
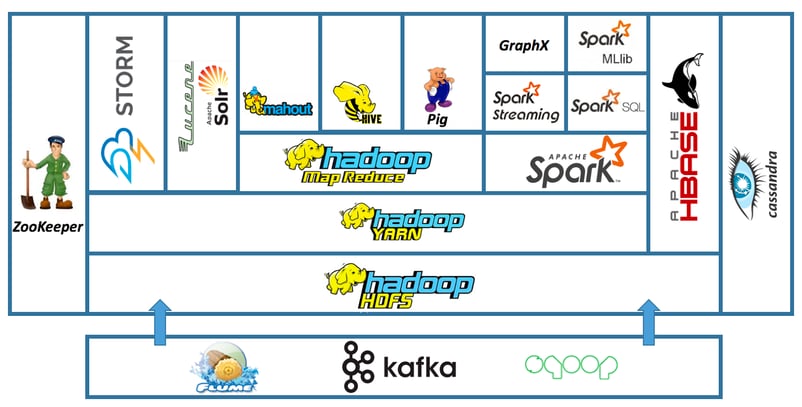
Konfigurasi dasar ekosistem Hadoop berisi teknologi berikut: Spark, Hive, Pig, HBase, Sqoop, Storm, ZooKeeper, Oozie, dan Kafka.
Spark
Sebelum menjelaskan apa itu Spark, mari ingat bahwa suatu algoritme harus dapat diparalelkan agar bisa berjalan pada klaster multi-node di Hadoop. Dengan demikian, suatu algoritme dikatakan "dapat diskalakan" jika dapat diparalelkan (dan karenanya dapat memanfaatkan skalabilitas sebuah klaster). Hadoop adalah implementasi dari model komputasi MapReduce. Masalah dengan MapReduce adalah ia dibangun di atas model Direct Acyclic Graph. Dengan kata lain, urutan operasi MapReduce berjalan dalam tiga fase sekuensial langsung tanpa belokan (Map -> Shuffle -> Reduce); tidak ada fase yang bersifat iteratif (atau siklik).
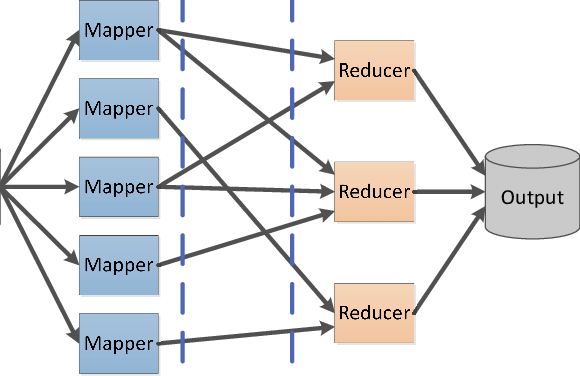
Model asiklik langsung tidak cocok untuk beberapa aplikasi, khususnya yang menggunakan kembali data di berbagai operasi, seperti sebagian besar algoritme pembelajaran statistik yang iteratif, dan kueri analisis data yang interaktif. Spark menjawab keterbatasan ini; ia adalah mesin komputasi yang melakukan pemrosesan terdistribusi di memori pada sebuah klaster. Dengan kata lain, ini adalah mesin komputasi in-memory terdistribusi. Dibandingkan MapReduce yang bekerja dalam mode batch, model komputasi Spark bekerja dalam mode interaktif, yakni merakit data di memori sebelum memprosesnya dan karenanya sangat cocok untuk pemrosesan Machine Learning.
Hive
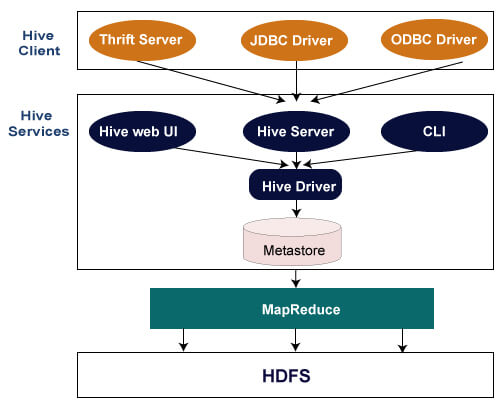
Hive adalah infrastruktur komputasi mirip Data Warehouse yang menyediakan layanan kueri dan agregasi untuk volume data yang sangat besar yang disimpan pada sistem berkas terdistribusi seperti HDFS. Hive menawarkan bahasa kueri berbasis SQL (standar ANSI-92) yang disebut HiveQL (Hive Query Language), yang mengarahkan kueri ke data yang disimpan di HDFS. HiveQL juga memungkinkan pengguna/pengembang tingkat lanjut untuk mengintegrasikan fungsi Map dan Reduce langsung ke dalam kueri mereka untuk mencakup rentang masalah manajemen data yang lebih luas. Ketika Anda menulis kueri dalam HiveQL, kueri tersebut diubah menjadi job MapReduce dan diserahkan ke JobTracker untuk dieksekusi oleh Hive.
Pig
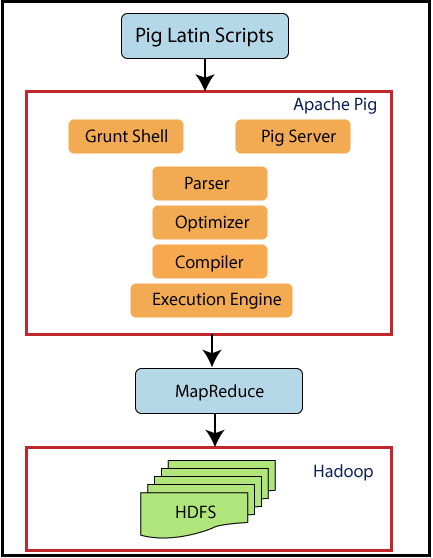
Pig adalah lingkungan eksekusi aliran data interaktif di bawah Hadoop. Terdiri dari 2 elemen: bahasa ekspresi aliran data yang disebut Pig Latin, dan lingkungan eksekusi aliran data interaktif.
Bahasa yang ditawarkan Pig, Pig Latin, secara garis besar mirip dengan bahasa skrip seperti Perl, Python, atau Ruby. Namun, ia lebih spesifik daripada bahasa-bahasa tersebut dan paling tepat disebut sebagai "bahasa aliran data". Ini memungkinkan Anda menulis kueri dalam rangkaian aliran sekuensial dari data sumber untuk mendapatkan data "target" di bawah Hadoop dengan cara ETL. Aliran ini kemudian diubah menjadi fungsi MapReduce yang akhirnya diserahkan ke job tracker untuk dieksekusi. Sederhananya, Pig adalah ETL-nya Hadoop. Pemrograman dalam Pig Latin berarti mendeskripsikan dalam aliran yang independen namun bersarang bagaimana data dimuat, diubah, dan diagregasi menggunakan pernyataan khusus Pig yang disebut operator. Menguasai operator-operator ini adalah kunci untuk menguasai pemrograman Pig Latin, apalagi jumlahnya lebih sedikit dibandingkan Hive.
HBase
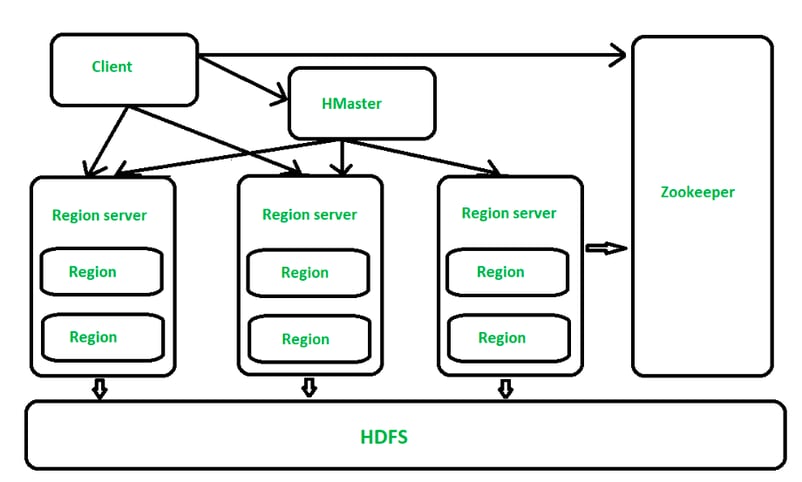
Sebelum membahas HBase, kami ingatkan bahwa RDBMS yang selama ini digunakan untuk pengelolaan data, sangat cepat menunjukkan batasnya menghadapi volume data yang tinggi dan keragaman data. Memang, RDBMS dirancang untuk mengelola hanya data terstruktur (tabel data baris/kolom); selain itu, peningkatan volume data meningkatkan latensi permintaan. Latensi ini merugikan banyak bisnis yang membutuhkan respons hampir real-time. DBMS baru yang disebut "NoSQL" dikembangkan untuk mengatasi keterbatasan ini. DBMS ini tidak menerapkan struktur tertentu pada data, dapat mendistribusikan penyimpanan dan pengelolaan data ke beberapa node, dan dapat diskalakan. Sebagai pengingat, skalabilitas berarti kinerja sistem tetap stabil seiring meningkatnya beban pemrosesan. HBase termasuk dalam kategori DBMS ini.
HBase adalah DBMS terdistribusi berorientasi kolom yang menyediakan akses baca dan tulis secara real-time ke data yang disimpan di HDFS. HDFS menyediakan akses sekuensial ke data dalam batch, yang tidak cocok untuk masalah akses data cepat seperti streaming; HBase menutupi celah ini dan menyediakan akses cepat ke data yang disimpan di HDFS.
HBase didasarkan pada DBMS "Big Table" milik Google dan dapat menyimpan volume data yang sangat besar (miliar baris/kolom). Ia bergantung pada ZooKeeper, layanan koordinasi terdistribusi untuk pengembangan aplikasi.
Sqoop
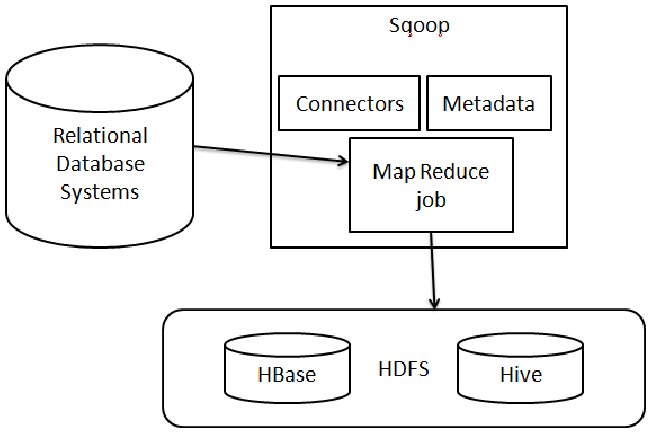
Sqoop atau SQL-to-Hadoop adalah alat yang mentransfer data dari basis data relasional ke HDFS Hadoop dan sebaliknya. Ia terintegrasi dengan ekosistem Hadoop dan merupakan penjadwal ingestion data di Hadoop. Anda dapat menggunakan Sqoop untuk mengimpor data dari RDBMS seperti MySQL, Oracle, atau SQL Server ke HDFS, mentransformasi data di Hadoop melalui MapReduce atau model komputasi lainnya, dan mengekspornya kembali ke RDBMS. Kami menyebutnya penjadwal ingestion data karena, seperti Oozie, ia mengotomatiskan proses impor/ekspor ini dan menjadwalkan waktu eksekusinya. Yang perlu Anda lakukan sebagai pengguna adalah menulis kueri SQL yang akan digunakan untuk melakukan pergerakan impor/ekspor. Selain itu, Sqoop menggunakan MapReduce untuk mengimpor dan mengekspor data, yang efisien dan toleran kesalahan.
Storm
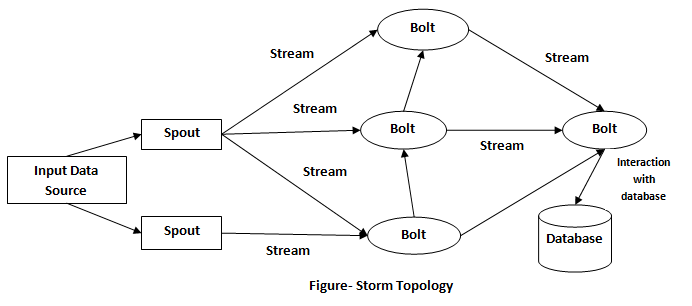
Untuk memahami Storm, Anda perlu memahami konsep arsitektur lambda (λ) dan pentingnya arsitektur lambda. Anda juga perlu memahami konsep objek terhubung. Objek terhubung atau Internet of Things (IoT) merepresentasikan perluasan Internet ke kehidupan sehari-hari. Ia menghasilkan data streaming dan dalam banyak kasus mengharuskan data diproses secara real-time. Model yang Anda kenal, seperti model batch, tidak cocok untuk masalah real-time yang diangkat oleh IoT. Bahkan model komputasi interaktif tidak cocok untuk melakukan pemrosesan berkelanjutan secara real-time. Berbeda dengan data operasional yang dihasilkan oleh sistem operasional perusahaan seperti keuangan pemasaran, yang sekalipun diproduksi dalam streaming masih dapat diarsipkan untuk pemrosesan kemudian, data yang diproduksi dalam streaming dalam fenomena seperti IoT atau Internet kedaluwarsa (atau tidak lagi valid) beberapa saat setelah dibuat, dan karena itu memerlukan pemrosesan segera. Selain objek terhubung, masalah bisnis seperti pencegahan penipuan, analisis data jejaring sosial, geolokasi membutuhkan waktu respons yang sangat rendah, hampir kurang dari satu detik. Untuk menyelesaikan masalah ini dalam konteks Big Data, dikembangkan arsitektur λ. Arsitektur ini menambahkan dua lapisan pemrosesan tambahan ke MapReduce untuk mengurangi latensi. Storm adalah implementasi perangkat lunak dari arsitektur λ. Ia memungkinkan aplikasi di bawah Hadoop yang memproses data secara real-time (atau hampir real-time).
ZooKeeper
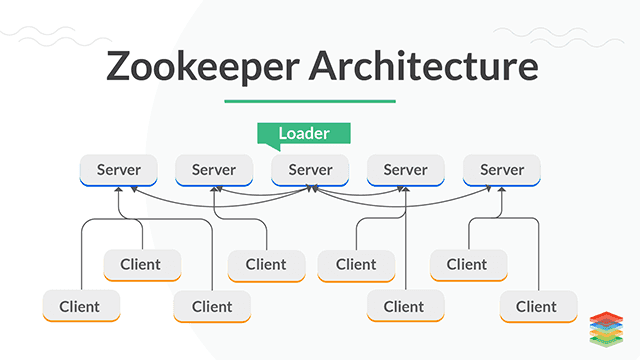
Menyinkronkan atau mengoordinasikan komunikasi antar node saat menjalankan tugas paralel adalah salah satu masalah tersulit dalam pengembangan aplikasi terdistribusi. Untuk menyelesaikan masalah ini Hadoop memasukkan alat koordinasi layanan ke dalam ekosistemnya, yakni ZooKeeper. ZooKeeper menangani kompleksitas bawaan dalam menyinkronkan eksekusi job terdistribusi di klaster dan berarti alat lain dalam ekosistem Hadoop tidak perlu menangani masalah ini sendiri. Ia juga memungkinkan pengguna mengembangkan aplikasi terdistribusi tanpa menjadi ahli pemrograman terdistribusi. Tanpa masuk ke detail kompleks koordinasi data antar node dalam klaster Hadoop, ZooKeeper menyediakan layanan konfigurasi terdistribusi, layanan distribusi, dan registri penamaan untuk aplikasi terdistribusi. ZooKeeper adalah cara Hadoop mengoordinasikan job terdistribusi.
Oozie
Secara default, Hadoop mengeksekusi job saat pengguna mengajukannya tanpa mempertimbangkan hubungan yang mungkin dimiliki satu sama lain. Namun, masalah yang menjadi alasan Hadoop digunakan umumnya memerlukan penulisan satu atau lebih job yang kompleks. Ketika dua job diajukan ke JobTracker (atau ke YARN), yang terakhir akan mengeksekusinya tanpa memperhatikan keterkaitan di antara keduanya, yang dapat menyebabkan kesalahan (exception) dan membuat kode terhenti. Bagaimana kita mengelola eksekusi beberapa job yang terkait dengan masalah yang sama? Untuk mengelola jenis masalah ini, solusi paling sederhana saat ini adalah menggunakan penjadwal job, dalam hal ini Oozie.
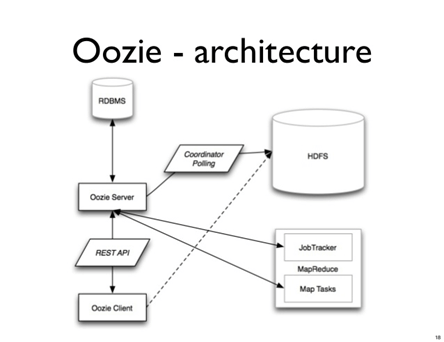
Oozie adalah penjadwal job yang berjalan sebagai layanan pada klaster Hadoop. Ia digunakan untuk menjadwalkan job Hadoop dan secara umum untuk menjadwalkan eksekusi semua job yang dapat berjalan pada klaster, seperti skrip Hive, job MapReduce, job Hama, job Storm, dan lain-lain. Ia dirancang untuk secara otomatis mengelola eksekusi segera atau tertunda dari ribuan job saling bergantung pada klaster Hadoop. Untuk menggunakan Oozie, Anda hanya perlu mengonfigurasi 2 berkas XML: berkas konfigurasi mesin Oozie dan berkas konfigurasi workflow job.
Mengenal Cloudera
Cloudera adalah perusahaan Amerika yang berbasis di California, berfokus pada pengembangan solusi Big Data yang secara historis berbasis pada kerangka kerja terdistribusi Hadoop; saat ini sedang berorientasi ulang ke cloud. Selama lebih dari setahun, Cloudera memperluas solusinya di cloud publik AWS, Azure, dan GCP.
Mengenal CDP
Cloudera Data Platform (CDP) adalah platform yang memungkinkan perusahaan menganalisis data dengan analitik swalayan di lingkungan hibrida dan multi-cloud. Ini memungkinkan organisasi mendapatkan lebih banyak nilai dari semua data mereka dengan membuat data lake di cloud dalam hitungan jam.
CDP menyediakan alat terpadu, multi-fungsi, dan swalayan untuk menganalisis dan memusatkan data. Selain itu, ia menawarkan keamanan dan tata kelola tingkat perusahaan dan dapat diterapkan di lingkungan publik, privat, dan multi-cloud. CDP adalah distribusi penerus dari dua distribusi Hadoop Cloudera sebelumnya: Cloudera Distribution of Hadoop (CDH) dan Hortonworks Data Platform (HDP).
Akses swalayan ke data perusahaan adalah inti dari layanan ini. Layanan cloud yang baru ditambahkan dan terintegrasi dalam platform juga menyediakan akses swalayan ke data dan analitik bagi analis, data scientist, profesional TI, dan pengembang. Kata kunci yang membedakan platform ini dari kompetitornya adalah tiga layanan Cloud-Native CDP yang dipresentasikan oleh Cloudera: swalayan, multi-cloud, dan keamanan.
CDP menawarkan pendekatan publik-privat yang unik, analitik data real-time, opsi penerapan on-premise, cloud, dan hibrida yang dapat diskalakan, serta arsitektur yang mengutamakan privasi.
CDP Public Cloud
CDP Public Cloud adalah Platform-as-a-Service (PaaS) yang kompatibel dengan infrastruktur cloud dan mudah dipindahkan antar berbagai penyedia cloud, termasuk solusi privat seperti OpenShift. CDP dirancang agar sepenuhnya hibrida dan multi-cloud, artinya satu platform dapat mengelola semua kasus penggunaan siklus hidup data. Platform CDP dapat bekerja dengan data dengan banyak pengaturan, termasuk cloud publik seperti AWS, Azure, dan GCP. Selain itu, ia dapat secara otomatis menskalakan beban kerja dan sumber daya naik atau turun untuk meningkatkan kinerja dan mengurangi biaya.
Layanan CDP Public Cloud
Berikut komponen utama yang membentuk CDP Public Cloud:
-
CDP Data Engineering adalah penyiapan serba lengkap. Ia dibangun di atas Apache Spark. Ia merampingkan proses ETL di seluruh tim analisis data perusahaan dengan memungkinkan orkestrasi dan otomatisasi dengan Apache Airflow serta menyediakan pemantauan pipeline yang canggih, debugging visual, dan alat manajemen. Selain itu, ia memiliki lingkungan kerja terisolasi dan bersifat terkontainerisasi, dapat diskalakan, dan mudah dipindahkan.
-
CDP Data Hub adalah layanan yang memungkinkan analitik bernilai tinggi dari Edge hingga AI. Cloudera Data Hub adalah layanan manajemen data dan analitik cloud-native. Ia memungkinkan pengembang TI dan bisnis membangun aplikasi bisnis lebih cepat untuk skenario apa pun, dari streaming hingga ETL. Data mart, basis data, dan Machine Learning hanyalah sebagian dari layanan yang tercakup di antara rentang beban kerja analitik yang luas.
-
CDP Data Warehouse adalah layanan yang memungkinkan TI menyediakan pengalaman analitik swalayan cloud-native bagi analis BI. Streaming, rekayasa data, dan analitik terintegrasi penuh ke dalam CDP Data Warehouse. Selain itu, ia memiliki kerangka kerja terpadu untuk mengamankan dan mengatur semua data dan metadata Anda di cloud privat, beberapa cloud publik, atau cloud hibrida. Layanan Cloudera Data Warehouse memudahkan penerapan data warehouse swalayan untuk analis data. Ini didasarkan pada mesin SQL yang tangguh dan teruji di tingkat perusahaan. Ratusan pengguna akan dapat mengakses data dengan sekali klik, baik on-premise maupun di cloud. Sumber daya dapat diskalakan sesuai permintaan, dan manajemen beban kerja juga bersifat swalayan dengan alat yang intuitif.
-
CDP Machine Learning memudahkan penerapan ruang kerja Machine Learning kolaboratif untuk memungkinkan data scientist memanfaatkan data perusahaan. Ia mengoptimalkan workflow ML menggunakan alat native dan komprehensif untuk menerapkan, mendistribusikan, dan memantau model. Dengan alat ini, organisasi dapat dengan cepat menerapkan ruang kerja Machine Learning baru hanya dengan beberapa klik untuk memungkinkan akses swalayan ke alat dan data yang diperlukan untuk workflow machine learning. Selain itu, replikasi data on-premise atau di cloud dapat dilakukan dengan cepat tanpa mengorbankan keamanan dan tata kelola. Data scientist juga dapat memilih alat mereka sambil memanfaatkan sumber daya elastis yang dapat disesuaikan dengan kebutuhan. Pelatihan model, rekayasa data, penerapan, dan pengelolaan model dilakukan dengan cepat melalui antarmuka serba ada, menghilangkan kebutuhan untuk berpindah platform.
-
Cloudera Data Visualization memungkinkan penggunanya memodelkan data di data warehouse virtual tanpa memindahkan atau memperbarui struktur atau tabel data yang mendasarinya, serta melakukan kueri terhadap sejumlah besar data tanpa terus-menerus memuat data, sehingga menghemat waktu dan biaya.
-
Cloudera Operational Database adalah solusi terkelola yang menyintesis instance klaster yang mendasarinya menjadi sebuah basis data. Ia akan secara otomatis menskalakan berdasarkan pemanfaatan beban kerja klaster, meningkatkan kinerja dalam jejak infrastruktur yang sama, dan secara otomatis menyelesaikan masalah operasional.
CDP Private Cloud
CDP Private Cloud lebih cocok untuk penerapan cloud hibrida, memungkinkan on-premise terhubung ke cloud publik sambil mempertahankan keamanan dan tata kelola yang konsisten dan terintegrasi. Pemrosesan dan penyimpanan dipisahkan di CDP Private Cloud, memungkinkan kedua klaster diskalakan secara independen. Tersedia pada klaster CDP Private Cloud Base, Cloudera Shared Data Experience (SDX) menyediakan keamanan, tata kelola, dan manajemen metadata terpadu. Selain itu, pengguna CDP Private Cloud dapat dengan cepat menyediakan dan menerapkan layanan Cloudera Data Warehousing dan Cloudera Machine Learning serta menskalakannya sesuai kebutuhan, menggunakan Management Console.
Layanan CDP Private Cloud
Beberapa komponen CDP Public Cloud, seperti Machine Learning dan Data Warehouse, tersedia di CDP Private Cloud. Ia menggunakan kumpulan mesin analitik yang mencakup streaming, rekayasa data, data mart, basis data operasional, dan data science untuk mendukung beban kerja tradisional.
Esensial HDFS dan MapReduce
HDFS adalah Hadoop's Distributed File System dan elemen sentral Hadoop, yang memungkinkan penyimpanan dan replikasi data pada beberapa server. Dikombinasikan dengan YARN, ini meningkatkan kemampuan manajemen data dari klaster HDFS Hadoop dan dengan demikian memungkinkan pemrosesan Big Data yang efisien.
Anda dapat menjalankan HDFS pada perangkat keras komoditas, yang membuatnya sangat toleran terhadap error. Setiap potongan data disimpan di beberapa tempat dan dapat dipulihkan dalam keadaan apa pun. Juga, replikasi ini memungkinkan melawan potensi kerusakan data.
HDFS menggunakan NameNode dan DataNode. DataNode adalah server standar tempat data disimpan. NameNode berisi metadata (data yang disimpan di berbagai node). Aplikasi hanya berinteraksi dengan NameNode, dan NameNode berkomunikasi dengan data node sesuai kebutuhan.
HDFS juga menghindari kemacetan jaringan dengan fokus pada memindahkan operasi, bukan memindahkan data. Ini berarti aplikasi dapat mengakses data di tempat data itu disimpan. Kekuatan terakhir adalah portabilitasnya. Ia dapat berjalan pada berbagai jenis perangkat keras tanpa masalah kompatibilitas.
Apa itu MapReduce, dan bagaimana cara kerjanya?
MapReduce adalah mesin pemrosesan dari Apache Hadoop, yang langsung diturunkan dari MapReduce milik Google. Aplikasi MapReduce pada dasarnya ditulis dalam Java. Ini memungkinkan seseorang dengan mudah menghitung jumlah data yang sangat besar dengan menerapkan langkah pemetaan dan reduksi untuk menemukan solusi atas masalah yang dihadapi. Langkah pemetaan mengambil satu set data untuk mengonversinya menjadi set data lain dengan menguraikan elemen individu menjadi pasangan kunci/nilai yang disebut tuple. Langkah reduksi kedua mengambil keluaran yang dihasilkan dari proses pemetaan dan menggabungkan tuple data menjadi kumpulan tuple yang lebih kecil.
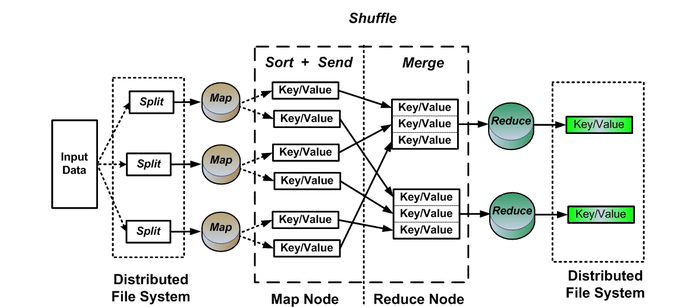
MapReduce adalah kerangka pemrosesan yang sangat paralel yang dapat dengan mudah diskalakan pada jumlah besar perangkat keras komoditas untuk memenuhi kebutuhan yang terus meningkat dalam memproses sejumlah besar data. Setelah tugas pemetaan dan reduksi berjalan mulus, yang diperlukan hanyalah perubahan konfigurasi untuk berjalan pada set data yang lebih besar. Jenis skalabilitas ekstrem ini, dari satu node ke ratusan bahkan ribuan node, adalah alasan MapReduce menjadi favorit para profesional Big Data di seluruh dunia.
MapReduce memungkinkan berbagai fitur, termasuk:
- Memungkinkan pemrosesan paralel yang diperlukan untuk melakukan tugas Big Data.
- Berlaku untuk beragam aplikasi pemrosesan data komersial
- Merupakan solusi hemat biaya untuk kerangka pemrosesan terpusat
- Dapat diintegrasikan dengan SQL untuk memfasilitasi kapabilitas pemrosesan paralel.
Distribusi Cloudera yang Mencakup Apache Hadoop
Cloudera adalah salah satu pure-player historis Hadoop, bersama Hortonworks dan MapR. Grup yang didukung Intel ini mengembangkan CDH, distribusi Hadoop yang mencakup beberapa proyek open-source lain, seperti Impala dan Search. Mereka juga menawarkan fitur keamanan dan integrasi.
Kerangka kerja Impala adalah mesin kueri SQL interaktif yang memungkinkan kueri langsung terhadap data yang disimpan di HDFS, Apache HBase, atau AWS S3. Mesin ini bergantung pada teknologi dan komponen lain dari Hive, seperti sintaks SQL-nya (HiveSQL), driver Open DataBase Connectivity, dan Query UI.
Komponen Search didasarkan pada proyek Apache Solr, sebuah mesin pengindeksan dan pencarian data yang dibangun di atas Lucene. Integrasi teknologi ini dalam CDH memberikan akses, misalnya, ke kapabilitas pengindeksan secara (hampir) real-time dan akses ke data yang disimpan dalam klaster Hadoop atau HBase. Teknologi Solr memungkinkan pencarian full-text yang kompleks tanpa keterampilan SQL yang luas. Solr memungkinkan Anda melakukan kueri pada data Hadoop, tetapi tanpa harus memindahkannya terlebih dahulu.
Cloudera menawarkan beberapa edisi CDH, masing-masing dengan fitur layanan dan manajemen klaster yang berbeda, dengan tingkat dukungan yang bervariasi:
- Cloudera Express adalah versi gratis CDH, yang mencakup elemen CDH dan fungsi inti Cloudera Manager. Selain itu, menyediakan akses ke versi evaluasi Enterprise selama 30 hari.
- Cloudera Manager adalah menara kontrol CDH. Alat ini menyediakan konsol administrasi berbasis web untuk menerapkan, mengelola, memantau, dan mengontrol kesehatan penerapan CDH. Ia juga menyertakan API untuk mengonfigurasi sistem dan mengambil metrik serta informasi tentang operasi klaster CDH.
- Cloudera Enterprise adalah versi berlisensi berbayar, dan karenanya dengan fitur yang diperluas. Misalnya, mencakup alat canggih yang diekstrak dari Cloudera Manager dan Navigator.
- Cloudera Manager Advanced Features menambahkan fitur-fitur kunci ke Cloudera Express: pelaporan operasional, manajemen kuota, log konfigurasi, pembaruan berkelanjutan, restart layanan, integrasi Kerberos, integrasi LDAP, dukungan SNMP, dan pemulihan bencana otomatis.
- Cloudera Navigator, yang hanya hadir dengan edisi Flex dan Data Hub, memungkinkan manajemen keamanan dan tata kelola data dalam platform CDH. Alat ini mendukung kendala kepatuhan perusahaan. Dengannya, pengelola data, analis, dan administrator dapat menelusuri volume data besar yang disimpan di Hadoop dan lebih mudah mengelola kunci enkripsi yang digunakan untuk mengamankan data dalam klaster CDH.
Untuk menyiapkan lingkungan proof-of-concept, Anda harus terlebih dahulu mengunduh dan menjalankan penginstal Cloudera Manager Server.
- Pertama, Anda perlu membuka Cloudera Manager Downloads di browser Anda. Pada kotak Cloudera Manager, klik Download Now. Anda juga dapat mengunduh penginstal untuk versi Cloudera Manager Anda. Misalnya, untuk Cloudera Manager 6.3.3:
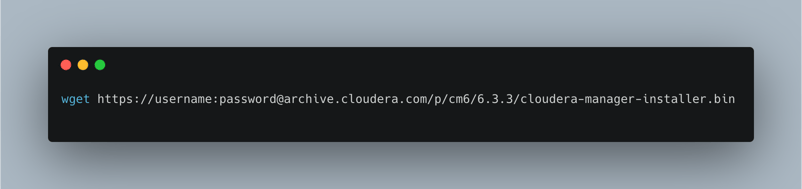
- Selanjutnya, Anda perlu menjalankan Cloudera Manager Installer.
Pertama, ubah Cloudera-manager-installer.bin agar memiliki izin eksekusi: chmod u+x Cloudera-manager-installer.bin
Untuk menjalankan penginstal, gunakan perintah berikut: sudo ./cloudera-manager-installer.bin --username=username --password=password
- Baca dan Terima Perjanjian Lisensi Terkait
Kemudian penginstal akan:
- Menginstal berkas repositori Cloudera Manager.
- Menginstal Oracle JDK.
- Menginstal Cloudera Manager Server dan paket PostgreSQL tertanam.
URL lengkap untuk Cloudera Manager Admin Console akan ditampilkan ketika instalasi selesai, termasuk nomor port (secara default 7180). Pertama, catat URL ini. Lalu, tekan Enter untuk memilih OK guna keluar dari penginstal dan mengonfirmasi instalasi berhasil.
Langkah berikutnya adalah menginstal CDH menggunakan Wizard.
- Buka Cloudera Manager Admin Console Anda dengan masuk ke: HTTP://:7180, di mana adalah FQDN atau alamat IP host tempat Cloudera Manager Server berjalan.
- Masuk ke Cloudera Manager Admin Console. Kredensial default adalah:
**Username**: admin **Password**: admin
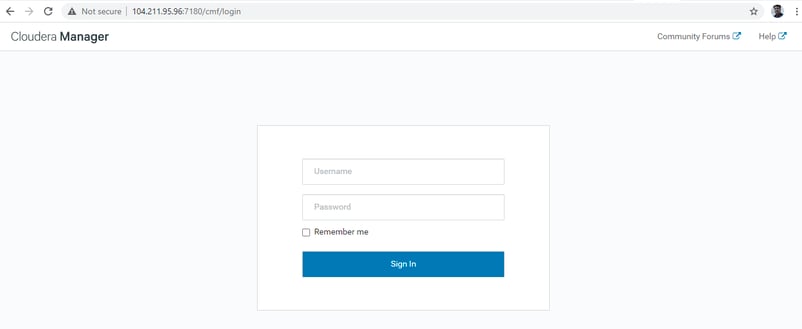
Baca syarat dan ketentuan lalu terima: Klik Continue, dan wizard instalasi akan mulai.
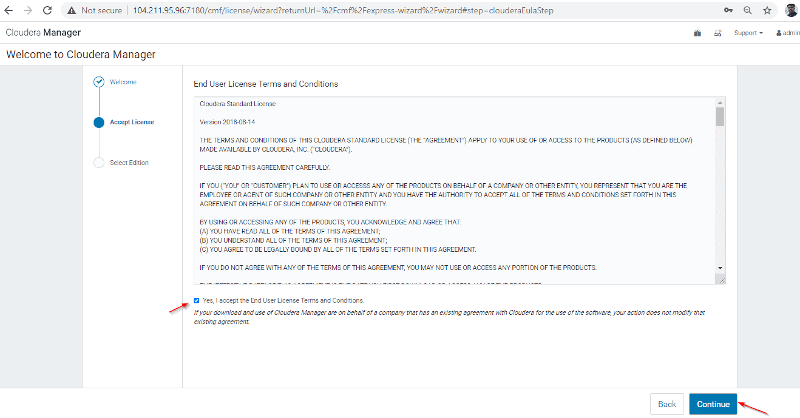
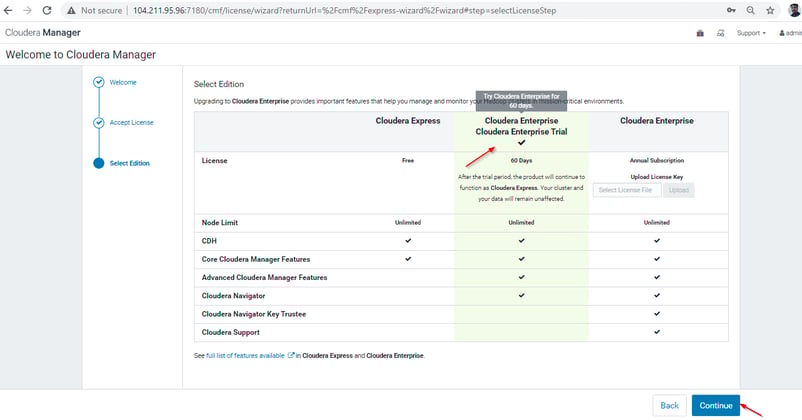
Wizard instalasi untuk Cloudera Manager akan memandu Anda melalui serangkaian langkah sebagai berikut: Select Edition Anda dapat memilih edisi yang akan dipasang, dan opsional Anda juga dapat memasang lisensi.
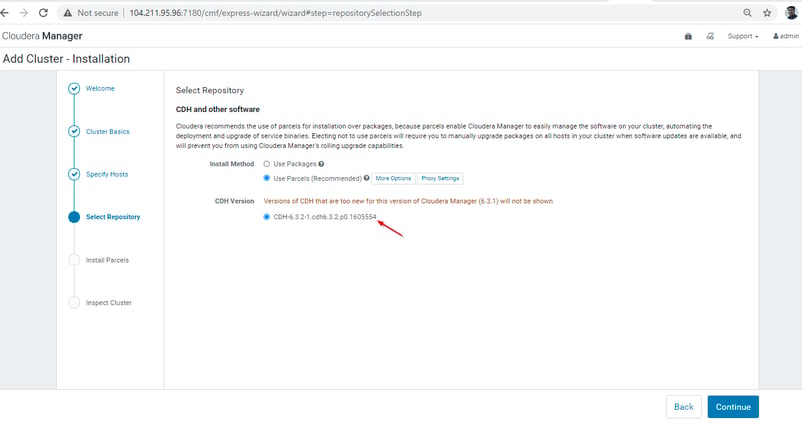
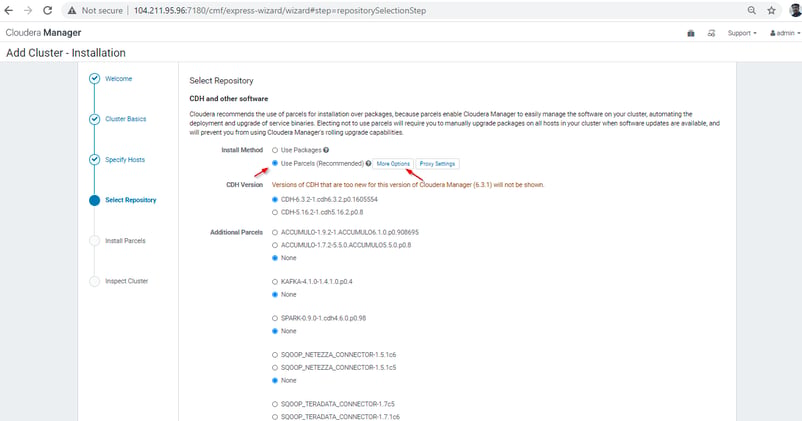
Specify Hosts Pilih host mana yang akan digunakan untuk menjalankan CDH dan layanan terkelola lainnya. Select Repository Di sini Anda perlu:
- Pertama, pilih jenis repositori yang akan digunakan untuk instalasi. Disarankan memilih Use Parcels untuk klaster proof-of-concept ini.
- Kemudian, Anda perlu memilih versi CDH yang akan dipasang dan Parcels tambahan apa pun yang ingin Anda pasang.
- Anda akan dapat memilih rilis Cloudera Manager Agent yang ingin Anda pasang.
- Klik Continue.
Accept JDK License Dengan memasang perangkat lunak JDK, Anda setuju untuk terikat oleh Oracle Binary Code License Agreement. Setelah membaca ketentuan lisensi dan mencentang kotak yang berlaku, klik Continue.
Enter Login Credentials Dengan mendefinisikan akun root, nama pengguna, metode autentikasi, port ssh, dan jumlah host.
Install Agents Halaman Install Agents menampilkan progres instalasi. Anda dapat memperluas detail untuk host mana pun guna melihat log instalasi.
Install Parcels Halaman Install Parcels menampilkan progres instalasi paket yang Anda pilih sebelumnya. Anda dapat mengklik bilah progres tertentu untuk detail tentang host tersebut.
Inspect Hosts Halaman Inspect Hosts menjalankan Host Inspector untuk mencari masalah konfigurasi umum. Lihat hasilnya dan atasi masalah yang teridentifikasi. Lalu, klik tombol Run Again untuk memperbarui hasil setelah melakukan perubahan.
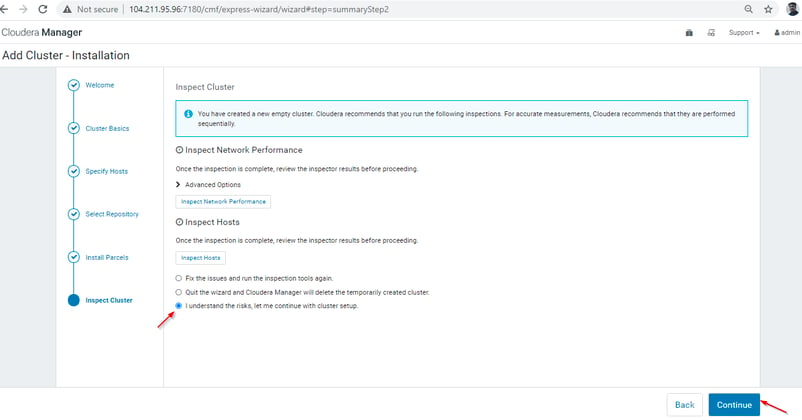
Setelah menyelesaikan semua langkah di atas, wizard Cluster Setup akan dimulai secara otomatis.
Ringkasan
Manfaat yang dibawa Hadoop bagi bisnis sangat besar. Berkat kerangka kerja ini, memungkinkan untuk menyimpan dan memproses sejumlah besar data dengan cepat berkat komputasi terdistribusi. Data dan aplikasi yang sedang diproses terlindungi dari kegagalan perangkat keras. Jika sebuah node gagal, job langsung dialihkan ke node lain untuk memastikan komputasi terdistribusi tidak gagal. Beberapa salinan semua data disimpan secara otomatis. Anda dapat membaca lebih lanjut tentang kisah sukses di sini, dan ikuti blog kami untuk pembaruan terkait data science.




Apa itu Apache Hadoop?
Hadoop adalah kerangka kerja Java open-source untuk aplikasi terdistribusi dan manajemen data intensif. Ini memungkinkan aplikasi bekerja dengan ribuan node dan petabyte data. Hadoop terinspirasi oleh publikasi Google tentang MapReduce, GoogleFS, dan BigTable.
Berkat kerangka kerja MapReduce, ia dapat menangani sejumlah besar data. Alih-alih memindahkan data ke jaringan untuk melakukan pemrosesan, MapReduce memungkinkan perangkat lunak pemrosesan berpindah langsung ke data.
Ini bukan produk per se, tetapi kerangka instruksi untuk penyimpanan dan pemrosesan data terdistribusi. Berbagai vendor perangkat lunak telah menggunakan Hadoop untuk membuat produk manajemen Big Data komersial.
Sistem data Hadoop tidak dibatasi dalam skala, yang berarti lebih banyak perangkat keras dan klaster dapat ditambahkan untuk mendukung beban yang lebih berat tanpa konfigurasi ulang atau pembelian lisensi perangkat lunak yang mahal.
Sejarah Apache Hadoop dan perkembangannya
Cloudera didirikan bersama pada 2008 oleh matematikawan Jeff Hammerbach, mantan karyawan Bear Stearns dan Facebook. Ia bertanggung jawab atas analisis data dan pengembangan program untuk penargetan iklan yang lebih baik. Co-founder lainnya adalah Christophe Bisciglia, mantan karyawan Google; Amr Awadallah, mantan karyawan Yahoo yang juga bekerja pada Hadoop; dan Mike Olson, CEO Cloudera. Arsitek utamanya adalah Doug Cutting, di balik mesin pengindeksan Lucene dan kerangka kerja terdistribusi Hadoop.
Pada 2018 Cloudera bergabung dengan pesaing utamanya: Hortonworks. Perusahaan kemudian mulai melakukan reorientasi bisnis untuk membuka diri ke dunia cloud. Pada 2021, Cloudera dibeli oleh dua dana ekuitas swasta, KKR dan Clayton Dubilier & Rice, sebesar $5,3 miliar, memberinya fondasi kuat untuk melanjutkan ekspansi pasar.
Hadoop dimulai oleh Doug Cutting dan Mike Cafarella pada 2002 ketika mereka berdua mulai mengerjakan proyek Apache Nutch. Proyek Apache Nutch menciptakan sistem mesin pencari yang dapat mengindeks 1 miliar halaman. Setelah banyak penelitian pada Nutch, mereka menyimpulkan bahwa sistem seperti itu akan menelan biaya sekitar setengah juta dolar untuk perangkat keras dan biaya operasional bulanan sekitar $30.000, yang sangat mahal. Dengan demikian, mereka menyadari bahwa arsitektur proyek mereka tidak akan mampu melewati miliaran halaman Web. Mereka menginginkan solusi yang dapat mengurangi biaya implementasi dan masalah penyimpanan serta pemrosesan set data besar.
Pada 2003, mereka menemukan sebuah artikel yang menggambarkan arsitektur sistem berkas terdistribusi Google, yang disebut GFS (Google File System), diterbitkan oleh Google, untuk menyimpan volume data yang sangat besar. Mereka tahu bahwa makalah ini dapat menyelesaikan masalah penyimpanan berkas besar yang dihasilkan oleh proses perayapan web dan pengindeksan. Namun makalah ini hanya separuh solusi untuk masalah mereka.
Pada 2004, Google menerbitkan makalah lain tentang teknik MapReduce, yang merupakan solusi untuk menangani set data besar tersebut. Makalah ini adalah separuh solusi lainnya bagi Doug Cutting dan Mike Cafarella untuk proyek Nutch mereka. Teknik-teknik ini (GFS dan MapReduce) saat itu hanya berupa white paper di Google. Google belum mengimplementasikan kedua teknik ini. Doug Cutting tahu dari pengalamannya dengan Apache Lucene bahwa open source adalah cara yang bagus untuk menyebarkan teknologi ke lebih banyak orang. Jadi, bersama Mike Cafarella, ia mulai mengimplementasikan teknik Google (GFS & MapReduce) sebagai open source dalam proyek Apache Nutch.
Pada 2005, Cutting menemukan bahwa Nutch terbatas hanya pada klaster 20-40 node. Ia cepat menyadari dua masalah: (a) Nutch tidak akan mencapai potensinya sampai bekerja secara andal pada klaster terbesar (b) Tampak mustahil dengan hanya dua orang (Doug Cutting & Mike Cafarella). Tugas rekayasa dalam proyek Nutch jauh lebih besar dari yang ia kira, jadi ia mulai mencari pekerjaan di perusahaan yang tertarik berinvestasi dalam upaya mereka. Ia menemukan bahwa Yahoo! memiliki tim insinyur hebat yang ingin sekali mengerjakan proyek ini.
Pada 2006, Doug Cutting bergabung dengan Yahoo dengan proyek Nutch. Ia ingin menyediakan kepada dunia sebuah kerangka komputasi open-source, andal, dan dapat diskalakan dengan bantuan Yahoo. Di Yahoo inilah Cutting memisahkan bagian komputasi terdistribusi dari Nutch dan membentuk proyek Hadoop yang baru. Ia menamai proyek itu Hadoop dari mainan gajah kuning milik putranya; itu juga kata unik yang mudah diucapkan. Ia ingin membuat Hadoop agar bekerja baik pada ribuan node, dan ia mulai mengerjakan Hadoop dengan GFS dan MapReduce.
Pada 2007, Yahoo berhasil menguji Hadoop pada klaster 1.000 node dan mulai menggunakannya.
Pada Januari 2008, Yahoo merilis Hadoop sebagai proyek open-source ke ASF (Apache Software Foundation). Pada Juli 2008, Apache Software Foundation berhasil menguji klaster 4000 node dengan Hadoop.
Pada 2009, Hadoop berhasil diuji untuk mengurutkan satu petabyte data dalam waktu kurang dari 17 jam untuk menangani miliaran pencarian dan mengindeks jutaan halaman web. Doug Cutting meninggalkan Yahoo dan bergabung dengan Cloudera untuk mengambil tantangan menyebarkan Hadoop ke industri lain.