

L'ecosistema di Apache Hadoop
Hadoop è diventato lo standard de facto per l'elaborazione dei dati, un po' come Excel è progressivamente diventato il software predefinito per l'analisi dei dati. A differenza di Excel, Hadoop è stato progettato da sviluppatori e non da "Business Analyst", eppure l'adozione su larga scala e il successo dipendono più dai business analyst che dagli sviluppatori. Per questo motivo i problemi del Big Data sono stati segmentati da un punto di vista funzionale e, per ciascun segmento, sono state sviluppate tecnologie basate su Hadoop per affrontarne le sfide. Tutti questi strumenti costituiscono quello che viene chiamato l'ecosistema Hadoop.
L'ecosistema Hadoop arricchisce Hadoop e lo rende capace di risolvere un'ampia varietà di problemi di business. Ad oggi, l'ecosistema Hadoop è composto da centinaia di tecnologie che abbiamo scelto di raggruppare in 14 categorie in base ai rispettivi ambiti: linguaggi di astrazione, SQL su Hadoop (Hive e Pig), modelli computazionali (MapReduce e Tez), strumenti di elaborazione in tempo reale (Storm e Spark Streaming), database (HBase e Cassandra), strumenti di ingestione in streaming (Kafka e Flume), strumenti di integrazione dati (Sqoop e Talend), strumenti di coordinamento dei workflow (Oozie e Control M for Hadoop), strumenti di coordinamento dei servizi distribuiti (Zookeeper), strumenti di amministrazione del cluster (Ranger e Sentry), strumenti di interfaccia utente (Hue e Jupyter), strumenti di indicizzazione dei contenuti (ElasticSearch e Splunk), file system distribuiti (HDFS) e gestori delle risorse (YARN e MESOS). In questa sezione passeremo in rassegna la funzione di ciascuno degli strumenti che compongono questo ecosistema di tecnologie Big Data. Dopodiché, se vuoi approfondire, ti consigliamo di leggere le nostre guide sui diversi elementi dell'ecosistema Hadoop che seguiranno questo articolo. La seguente mappa mentale presenta globalmente l'ecosistema Hadoop.
Mappa euristica dell'ecosistema Hadoop
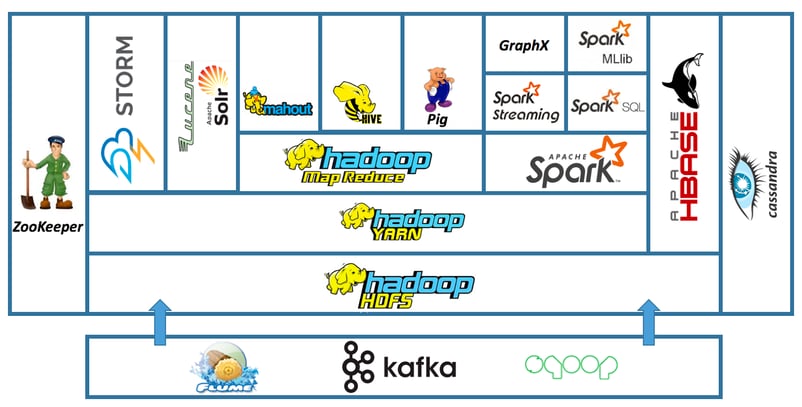
La configurazione di base dell'ecosistema Hadoop contiene le seguenti tecnologie: Spark, Hive, Pig, HBase, Sqoop, Storm, ZooKeeper, Oozie e Kafka.
Spark
Prima di spiegare cos'è Spark, ricordiamo che un algoritmo deve essere parallelizzabile per poter essere eseguito su un cluster multi-nodo in Hadoop. Così, un algoritmo si dice "scalabile" se è parallelizzabile (e può quindi sfruttare la scalabilità di un cluster). Hadoop è un'implementazione del modello di calcolo MapReduce. Il problema di MapReduce è che è costruito su un modello a grafo aciclico diretto. In altre parole, la sequenza di operazioni di MapReduce viene eseguita in tre fasi dirette e sequenziali senza deviazioni (Map -> Shuffle -> Reduce); nessuna fase è iterativa (o ciclica).
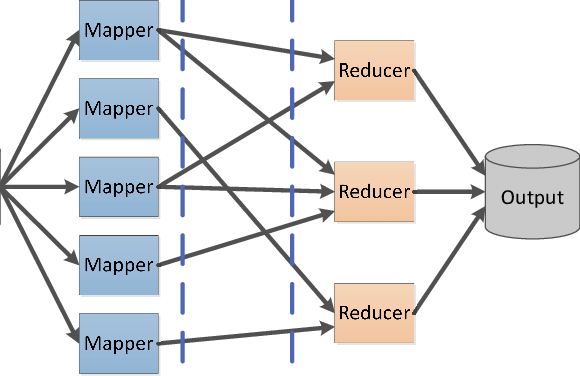
Il modello aciclico diretto non è adatto ad alcune applicazioni, in particolare a quelle che riutilizzano i dati in più operazioni, come la maggior parte degli algoritmi di apprendimento statistico, che sono iterativi, e le interrogazioni di analisi dati interattive. Spark risponde a questi limiti; è un motore di calcolo che esegue elaborazioni distribuite in memoria su un cluster. In altre parole, è un motore di calcolo distribuito in memoria. Rispetto a MapReduce, che lavora in modalità batch, il modello di calcolo di Spark funziona in modalità interattiva, cioè assembla i dati in memoria prima di elaborarli ed è quindi molto adatto ai processi di Machine Learning.
Hive
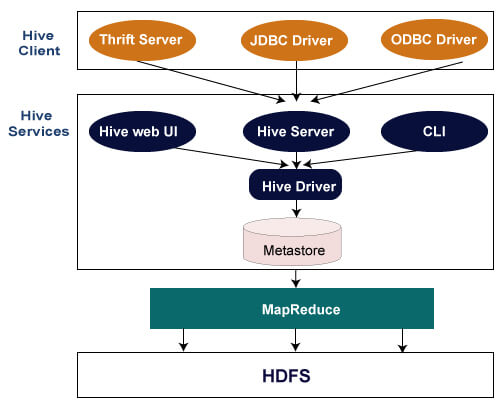
Hive è un'infrastruttura di calcolo simile a un Data Warehouse che fornisce servizi di interrogazione e aggregazione per volumi di dati molto grandi archiviati su un file system distribuito come HDFS. Hive offre un linguaggio di interrogazione basato su SQL (standard ANSI-92) chiamato HiveQL (Hive Query Language), che indirizza le query ai dati archiviati su HDFS. HiveQL consente anche agli utenti/sviluppatori avanzati di integrare funzioni Map e Reduce direttamente nelle loro query per coprire una gamma più ampia di problemi di gestione dei dati. Quando scrivi una query in HiveQL, quella query viene trasformata in un job MapReduce e inviata da Hive al JobTracker per l'esecuzione.
Pig
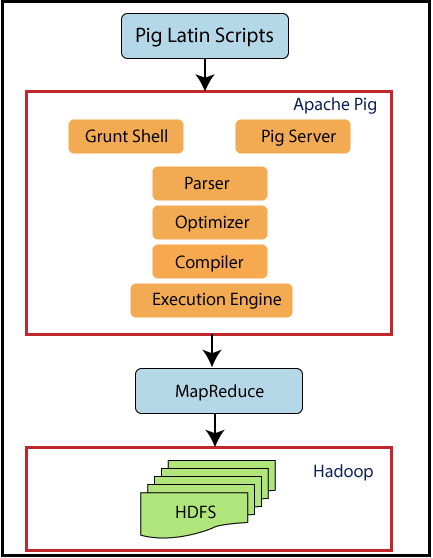
Pig è un ambiente interattivo di esecuzione di flussi di dati su Hadoop. È composto da 2 elementi: un linguaggio di espressione dei flussi di dati chiamato Pig Latin e un ambiente interattivo di esecuzione dei flussi di dati.
Il linguaggio offerto da Pig, il Pig Latin, è in qualche modo simile a linguaggi di scripting come Perl, Python o Ruby. Tuttavia, è più specifico di questi ultimi ed è meglio descritto come un "linguaggio di flusso dati". Ti permette di scrivere query in flussi sequenziali di dati sorgente per ottenere, in Hadoop, dati "di destinazione" alla maniera di un ETL. Questi flussi vengono poi trasformati in funzioni MapReduce che alla fine vengono inviate al job tracker per l'esecuzione. In poche parole, Pig è l'ETL di Hadoop. Programmare in Pig Latin significa descrivere, in flussi indipendenti ma annidati, come i dati vengono caricati, trasformati e aggregati utilizzando specifiche istruzioni Pig chiamate operatori. Padroneggiare questi operatori è la chiave per padroneggiare la programmazione in Pig Latin, anche perché sono pochi rispetto a Hive.
HBase
Prima di parlare di HBase, ricordiamo che gli RDBMS, utilizzati finora per la gestione dei dati, hanno mostrato molto rapidamente i loro limiti di fronte all'elevato volume e alla varietà dei dati. In effetti, gli RDBMS sono progettati per gestire solo dati strutturati (tabelle di dati per righe/colonne); inoltre, l'aumento del volume dei dati fa crescere la latenza delle richieste. Questa latenza è dannosa per molte attività che richiedono risposte in quasi tempo reale. Sono stati quindi sviluppati nuovi DBMS chiamati "NoSQL" per superare questi limiti. Questi non impongono alcuna struttura particolare ai dati, possono distribuire l'archiviazione e la gestione dei dati su più nodi e sono scalabili. Ricordiamo che scalabilità significa che le prestazioni del sistema rimangono stabili all'aumentare del carico di elaborazione. HBase appartiene a questa categoria di DBMS.
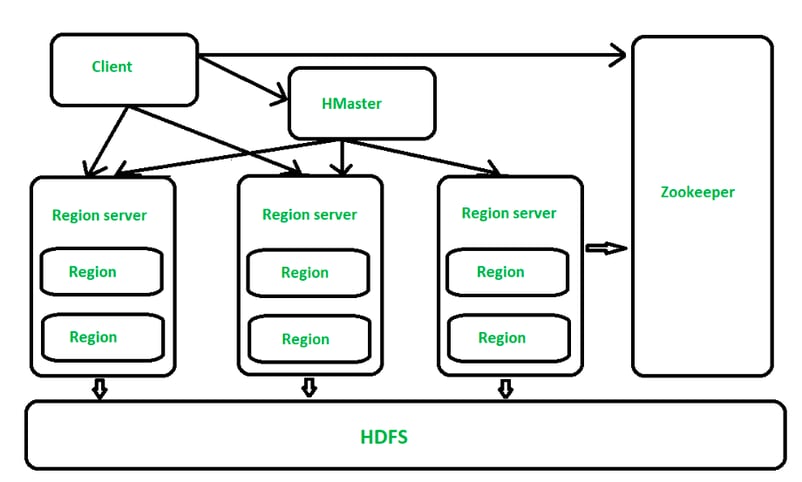
HBase è un DBMS distribuito e orientato alle colonne che fornisce accesso in lettura e scrittura in tempo reale ai dati archiviati su HDFS. HDFS offre accesso sequenziale ai dati in batch, non adatto a esigenze di accesso rapido ai dati come lo streaming; HBase colma queste lacune e fornisce accesso veloce ai dati archiviati su HDFS.
HBase si basa sul DBMS "Big Table" di Google e può archiviare volumi di dati molto grandi (miliardi di righe/colonne). Dipende da ZooKeeper, un servizio di coordinamento distribuito per lo sviluppo di applicazioni.
Sqoop
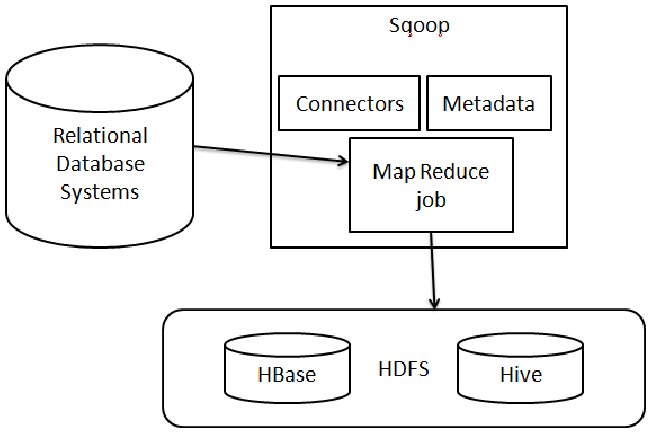
Sqoop, o SQL-to-Hadoop, è uno strumento che trasferisce dati da un database relazionale all'HDFS di Hadoop e viceversa. È integrato nell'ecosistema Hadoop ed è il pianificatore di ingestione dati in Hadoop. Puoi usare Sqoop per importare dati da RDBMS come MySQL, Oracle o SQL Server su HDFS, trasformare i dati in Hadoop tramite MapReduce o un altro modello di calcolo ed esportarli di nuovo nell'RDBMS. Lo chiamiamo pianificatore di ingestione dati perché, come Oozie, automatizza questo processo di import/export e ne pianifica l'orario di esecuzione. Come utente, tutto ciò che devi fare è scrivere le query SQL che verranno utilizzate per effettuare il movimento di import/export. Inoltre, Sqoop utilizza MapReduce per importare ed esportare i dati, cosa che è efficiente e tollerante ai guasti.
Storm
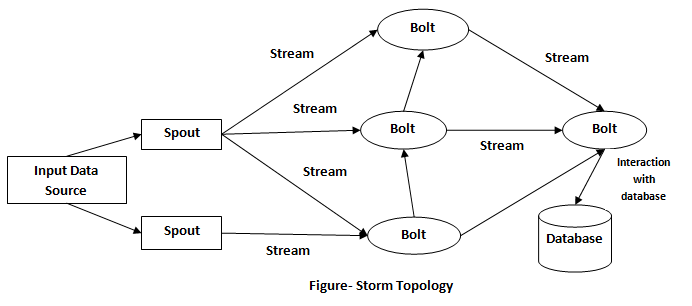
Per capire Storm, bisogna comprendere il concetto di architetture lambda (λ) e l'interesse per le architetture lambda. Bisogna anche capire il concetto di oggetti connessi. Gli oggetti connessi o Internet of Things (IoT) rappresentano l'estensione di Internet alla nostra vita quotidiana. Genera dati in streaming e richiede che i dati vengano elaborati in tempo reale nella maggior parte dei casi. I modelli a cui sei abituato, come i modelli batch, non sono adatti alle esigenze in tempo reale sollevate dall'IoT. Anche i modelli di calcolo interattivi non sono adatti a eseguire elaborazioni continue in tempo reale. A differenza dei dati operativi prodotti dai sistemi operativi di un'azienda, come finanza e marketing, che anche quando prodotti in streaming possono essere storicizzati per un'elaborazione successiva, i dati prodotti in streaming nell'ambito di fenomeni come l'IoT o Internet scadono (o non sono più validi) nei momenti successivi alla loro creazione e richiedono quindi un'elaborazione immediata. Oltre agli oggetti connessi, problemi di business come la lotta contro le frodi, l'analisi dei dati dei social network e la geolocalizzazione richiedono tempi di risposta molto bassi, quasi inferiori al secondo. Per risolvere questo problema in un contesto Big Data, sono state sviluppate le cosiddette architetture λ. Queste architetture aggiungono due livelli di elaborazione aggiuntivi a MapReduce per ridurre la latenza. Storm è un'implementazione software dell'architettura λ. Consente applicazioni su Hadoop che elaborano dati in tempo reale (o quasi).
ZooKeeper
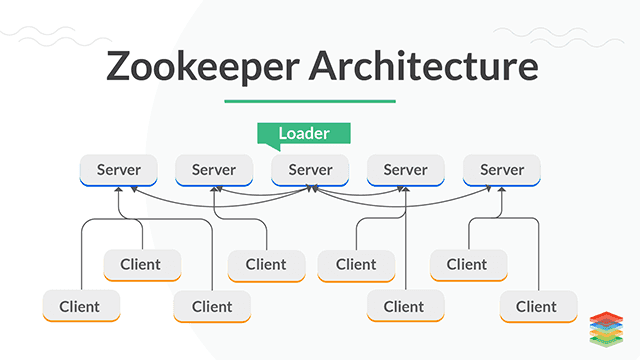
Sincronizzare o coordinare la comunicazione tra nodi durante l'esecuzione di compiti paralleli è uno dei problemi più difficili nello sviluppo di applicazioni distribuite. Per risolvere questo problema, Hadoop ha introdotto nell'ecosistema strumenti di coordinamento dei servizi, in questo caso ZooKeeper. ZooKeeper si occupa della complessità intrinseca della sincronizzazione dell'esecuzione di job distribuiti nel cluster e fa sì che gli altri strumenti dell'ecosistema Hadoop non debbano gestire da soli questo problema. Inoltre consente agli utenti di sviluppare applicazioni distribuite senza essere esperti di programmazione distribuita. Senza entrare nei dettagli complessi del coordinamento dei dati tra nodi in un cluster Hadoop, ZooKeeper fornisce un servizio di configurazione distribuito, un servizio di distribuzione e un registro dei nomi per applicazioni distribuite. ZooKeeper è il modo in cui Hadoop coordina i job distribuiti.
Oozie
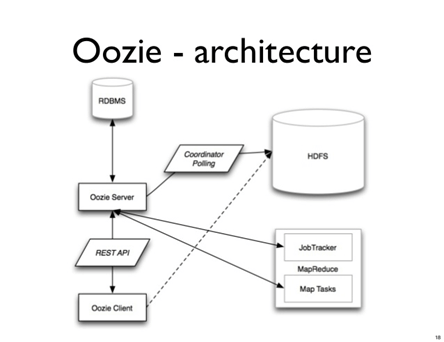
Per impostazione predefinita, Hadoop esegue i job nell'ordine in cui l'utente li invia, senza considerare le relazioni che possono avere tra loro. Tuttavia, i problemi per cui si usa Hadoop richiedono generalmente la scrittura di uno o più job complessi. Quando due job vengono inviati al JobTracker (o a YARN), questo li eseguirà senza prestare attenzione al legame tra loro, il che può causare un errore (eccezione) e portare all'arresto del codice. Come gestire l'esecuzione di più job collegati allo stesso problema? Per gestire questo tipo di problema, la soluzione più semplice attualmente è utilizzare un pianificatore di job, in questo caso Oozie.
Oozie è un pianificatore di job che viene eseguito come servizio su un cluster Hadoop. È utilizzato per pianificare i job Hadoop e, più in generale, per pianificare l'esecuzione di tutti i job che possono essere eseguiti su un cluster, come uno script Hive, un job MapReduce, un job Hama, un job Storm, ecc. È stato progettato per gestire automaticamente l'esecuzione immediata o differita di migliaia di job interdipendenti su un cluster Hadoop. Per utilizzare Oozie, è sufficiente configurare 2 file XML: un file di configurazione del motore Oozie e un file di configurazione del workflow del job.
Presentazione di Cloudera
Cloudera è un'azienda americana con sede in California, dedicata allo sviluppo di una soluzione Big Data storicamente basata sul framework distribuito Hadoop; attualmente si sta riorientando verso il cloud. Da oltre un anno, Cloudera sta espandendo la sua soluzione nei cloud pubblici AWS, Azure e GCP.
Presentazione di CDP
Cloudera Data Platform, CDP, è una piattaforma che consente alle aziende di analizzare i dati con analytics self-service in ambienti ibridi e multi-cloud. Permette alle organizzazioni di ottenere più valore da tutti i loro dati creando data lake nel cloud in poche ore.
CDP fornisce strumenti integrati, multifunzionali e self-service per analizzare e centralizzare i dati. Inoltre, offre sicurezza e governance a livello aziendale e può essere distribuita in ambienti pubblici, privati e multi-cloud. CDP è la distribuzione successiva alle due precedenti distribuzioni Hadoop di Cloudera: Cloudera Distribution of Hadoop (CDH) e Hortonworks Data Platform (HDP).
L'accesso self-service ai dati aziendali è al centro di questo servizio. I nuovi servizi cloud integrati nella piattaforma forniscono anch'essi accesso self-service a dati e analytics per analisti, data scientist, professionisti IT e sviluppatori. Le parole chiave che distinguono la piattaforma dalla concorrenza sono i tre servizi Cloud-Native di CDP presentati da Cloudera: self-service, multi-cloud e sicurezza.
CDP offre un approccio unico pubblico-privato, analytics in tempo reale, opzioni di distribuzione scalabili on-premise, nel cloud e ibride, e un'architettura privacy-first.
CDP Public Cloud
CDP Public Cloud è una Platform-as-a-Service (PaaS) compatibile con l'infrastruttura cloud e facilmente portabile tra vari provider cloud, incluse soluzioni private come OpenShift. CDP è stata progettata per essere completamente ibrida e multi-cloud, il che significa che un'unica piattaforma può gestire tutti i casi d'uso del ciclo di vita dei dati. La piattaforma CDP può lavorare con i dati in molte configurazioni, compresi cloud pubblici come AWS, Azure e GCP. Inoltre, può scalare automaticamente carichi di lavoro e risorse verso l'alto o verso il basso per migliorare le prestazioni e ridurre i costi.
Servizi di CDP Public Cloud
Ecco i principali componenti che compongono CDP Public Cloud:
-
CDP Data Engineering è un setup all-in-one. È costruito su Apache Spark. Snellisce i processi ETL tra i team di analisi dati aziendali abilitando orchestrazione e automazione con Apache Airflow e fornisce strumenti altamente evoluti di monitoraggio delle pipeline, debug visivo e gestione. Inoltre, dispone di ambienti di lavoro isolati ed è containerizzato, scalabile e facile da trasportare.
-
CDP Data Hub è un servizio che consente analytics ad alto valore dall'Edge all'AI. Cloudera Data Hub è un servizio cloud-native di gestione e analisi dei dati. Consente a sviluppatori IT e business di creare più velocemente applicazioni aziendali per qualsiasi scenario, dallo streaming all'ETL. Data mart, database e Machine Learning sono solo alcuni dei servizi coperti tra l'ampio ventaglio di carichi analitici.
-
CDP Data Warehouse è un servizio che consente all'IT di offrire un'esperienza di analytics self-service cloud-native per i BI analyst. Streaming, data engineering e analytics sono completamente integrati in CDP Data Warehouse. Inoltre, dispone di un framework unificato per mettere in sicurezza e governare tutti i tuoi dati e metadati in cloud privati, multipli pubblici o ibridi. Il servizio Cloudera Data Warehouse facilita il deploy di data warehouse self-service per gli analisti dei dati. Si basa su motori SQL robusti e collaudati a livello enterprise. Centinaia di utenti potranno accedere ai dati con un solo clic, sia on-premise che nel cloud. Le risorse possono essere scalate on demand secondo necessità, e la gestione dei carichi di lavoro è anch'essa self-service con strumenti intuitivi.
-
CDP Machine Learning semplifica il deploy di workspace collaborativi di Machine Learning per consentire ai data scientist di sfruttare i dati aziendali. Ottimizza i workflow di ML utilizzando strumenti nativi e completi per distribuire, distribuire in scala e monitorare i modelli. Con questo strumento, le organizzazioni possono distribuire rapidamente nuovi workspace di Machine Learning con pochi clic per abilitare l'accesso self-service agli strumenti e ai dati necessari ai workflow di machine learning. Inoltre, la replica dei dati on-premise o nel cloud può essere eseguita rapidamente senza compromettere sicurezza e governance. I data scientist possono anche scegliere i propri strumenti, sfruttando risorse elastiche adattabili alle loro esigenze. Training dei modelli, data engineering, deploy e gestione dei modelli vengono effettuati rapidamente attraverso un'interfaccia all-in-one, eliminando la necessità di passare tra piattaforme.
-
Cloudera Data Visualization consente agli utenti di modellare i dati nel data warehouse virtuale senza rimuovere o aggiornare le strutture o le tabelle sottostanti e di interrogare grandi quantità di dati senza caricarli continuamente, risparmiando così tempo e denaro.
-
Cloudera Operational Database è una soluzione gestita che sintetizza l'istanza del cluster sottostante in un database. Esegue lo scaling automatico in base all'utilizzo del carico di lavoro del cluster, migliora le prestazioni all'interno dello stesso perimetro infrastrutturale e risolve automaticamente i problemi operativi.
CDP Private Cloud
CDP Private Cloud è più adatto per distribuzioni cloud ibride, consentendo all'on-premise di connettersi ai cloud pubblici mantenendo sicurezza e governance coerenti e integrate. In CDP Private Cloud, elaborazione e storage sono disaccoppiati, consentendo a entrambi i cluster di scalare in modo indipendente. Disponibile su un cluster CDP Private Cloud Base, Cloudera Shared Data Experience (SDX) fornisce sicurezza, governance e gestione dei metadati unificate. Inoltre, gli utenti di CDP Private Cloud possono effettuare rapidamente il provisioning e il deploy dei servizi Cloudera Data Warehousing e Cloudera Machine Learning e scalarli secondo necessità, utilizzando la Management Console.
Servizi di CDP Private Cloud
Alcuni componenti di CDP Public Cloud, come Machine Learning e Data Warehouse, sono disponibili su CDP Private Cloud. Utilizza una raccolta di motori analitici che coprono streaming, data engineering, data mart, database operazionali e data science per supportare i carichi di lavoro tradizionali.
Fondamenti di HDFS e MapReduce
HDFS è l'Hadoop Distributed File System e l'elemento centrale di Hadoop, che consente di archiviare e replicare i dati su più server. In combinazione con YARN, aumenta le capacità di gestione dei dati del cluster HDFS di Hadoop e consente così un'elaborazione Big Data efficiente.
Puoi eseguire HDFS su hardware commodity, il che lo rende molto tollerante agli errori. Ogni porzione di dati è archiviata in più posizioni e può essere recuperata in qualsiasi circostanza. Inoltre, questa replica consente di contrastare potenziali corruzioni dei dati.
HDFS utilizza un NameNode e un DataNode. Il DataNode è un server standard su cui sono archiviati i dati. Il NameNode contiene i metadati (dati archiviati nei diversi nodi). L'applicazione interagisce solo con il NameNode, e il NameNode comunica con i data node secondo necessità.
HDFS evita anche la congestione della rete concentrandosi sullo spostamento delle operazioni piuttosto che dei dati. Ciò significa che le applicazioni possono accedere ai dati dove sono archiviati. L'ultimo punto di forza è la sua portabilità. Può essere eseguito su diversi tipi di hardware senza problemi di compatibilità.
Che cos'è MapReduce e come funziona?
MapReduce è il motore di elaborazione di Apache Hadoop, direttamente derivato da MapReduce di Google. L'applicazione MapReduce è essenzialmente scritta in Java. Permette di elaborare con facilità enormi quantità di dati applicando fasi di mappatura e riduzione per trovare una soluzione al problema in questione. La fase di mappatura prende un dataset per convertirlo in un altro dataset scomponendo gli elementi individuali in coppie chiave/valore chiamate tuple. La seconda fase di riduzione prende l'output derivato dal processo di mappatura e combina le tuple di dati in un insieme più piccolo di tuple.
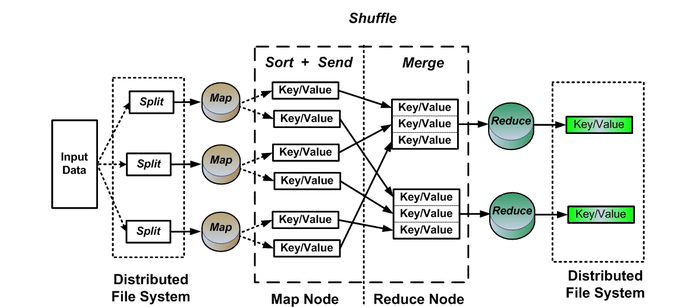
MapReduce è un framework di elaborazione altamente parallelo che può essere scalato con facilità su enormi quantità di hardware commodity per soddisfare la crescente necessità di elaborare grandi quantità di dati. Una volta che i task di mappatura e riduzione funzionano senza intoppi, è sufficiente una modifica alla configurazione per l'esecuzione su un dataset più ampio. Questo tipo di scalabilità estrema, da un singolo nodo a centinaia o addirittura migliaia di nodi, è ciò che rende MapReduce uno dei preferiti dai professionisti del Big Data di tutto il mondo.
MapReduce consente un'ampia gamma di funzionalità, tra cui:
- Abilita l'elaborazione parallela necessaria per svolgere attività Big Data.
- È applicabile a un'ampia varietà di applicazioni commerciali di elaborazione dati
- È una soluzione conveniente per i framework di elaborazione centralizzati
- Può essere integrato con SQL per facilitare le capacità di elaborazione parallela.
La distribuzione di Cloudera che include Apache Hadoop
Cloudera è uno dei pure player storici di Hadoop, insieme a Hortonworks e MapR. Il gruppo, sostenuto da Intel, sviluppa CDH, una distribuzione di Hadoop che include diversi altri progetti open source, come Impala e Search. Offre anche funzionalità di sicurezza e integrazione.
Il framework Impala è un motore di query SQL interattivo che consente query dirette sui dati archiviati in HDFS, Apache HBase o AWS S3. Questo motore si basa su altre tecnologie e componenti di Hive, come la sua sintassi SQL (HiveSQL), il driver Open DataBase Connectivity e la Query UI.
Il componente Search si basa sul progetto Apache Solr, un motore di indicizzazione e ricerca dei dati costruito su Lucene. L'integrazione di questa tecnologia in CDH dà accesso, ad esempio, a capacità di indicizzazione in (quasi) tempo reale e all'accesso ai dati archiviati in un cluster Hadoop o HBase. La tecnologia Solr consente ricerche full-text complesse senza vaste competenze SQL. Solr ti permette di interrogare i dati di Hadoop, ma senza doverli spostare prima.
Cloudera offre diverse edizioni di CDH, ciascuna con diverse funzionalità di servizio e gestione del cluster, con livelli di supporto variabili:
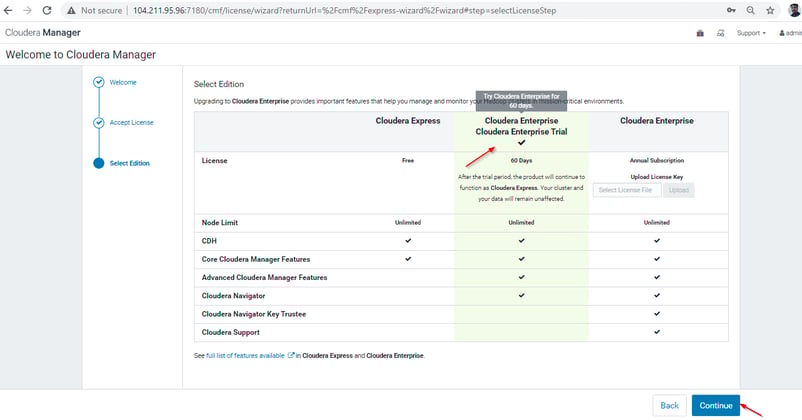
- Cloudera Express è la versione gratuita di CDH, che include gli elementi di CDH e le funzioni principali di Cloudera Manager. Inoltre, fornisce accesso a una versione di valutazione di 30 giorni della versione Enterprise.
- Cloudera Manager è la torre di controllo di CDH. Lo strumento fornisce una console di amministrazione web per distribuire, gestire, monitorare e controllare lo stato delle distribuzioni CDH. Include anche un'API per configurare il sistema e recuperare metriche e informazioni sul funzionamento di un cluster CDH.
- Cloudera Enterprise è una versione a licenza a pagamento, e quindi con funzionalità estese. Include, ad esempio, strumenti avanzati estratti da Cloudera Manager e Navigator.
- Cloudera Manager Advanced Features aggiunge funzionalità chiave a Cloudera Express: reportistica operativa, gestione delle quote, log di configurazione, aggiornamenti continui, riavvio dei servizi, integrazione Kerberos, integrazione LDAP, supporto SNMP e ripristino automatico in caso di disastro.
- Cloudera Navigator, disponibile solo con le edizioni Flex e Data Hub, abilita la gestione della sicurezza e della governance dei dati all'interno di una piattaforma CDH. Lo strumento supporta i vincoli di conformità delle aziende. Con esso, data manager, analisti e amministratori possono esplorare grandi volumi di dati archiviati in Hadoop e gestire più facilmente le chiavi di cifratura utilizzate per proteggere i dati in un cluster CDH.
Per impostare un ambiente di prova di concetto, devi prima scaricare ed eseguire l'installer di Cloudera Manager Server.
- Per prima cosa, apri Cloudera Manager Downloads nel browser. Nel riquadro Cloudera Manager, fai clic su Download Now. Puoi anche scaricare l'installer per la tua versione di Cloudera Manager. Ad esempio, per Cloudera Manager 6.3.3:
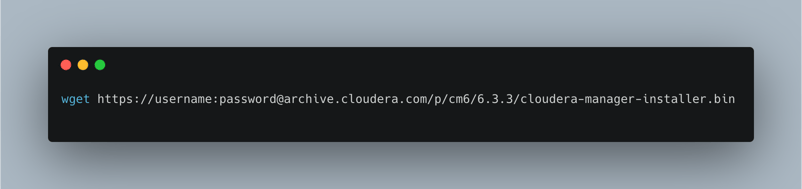
- Successivamente, devi eseguire il Cloudera Manager Installer.
Per prima cosa, modifica Cloudera-manager-installer.bin per renderlo eseguibile: chmod u+x Cloudera-manager-installer.bin
Per eseguire l'installer, usa il seguente comando: sudo ./cloudera-manager-installer.bin --username=username --password=password
- Leggi e accetta i contratti di licenza associati
L'installer quindi:
- Installa i file del repository di Cloudera Manager.
- Installa l'Oracle JDK.
- Installa i pacchetti Cloudera Manager Server e PostgreSQL incorporato.
L'URL completo per la Cloudera Manager Admin Console viene visualizzato al termine dell'installazione, incluso il numero di porta (predefinito 7180). Per prima cosa, annota questo URL. Poi premi Invio per scegliere OK, uscire dall'installer e confermare l'installazione riuscita.
Il passo successivo è installare CDH usando il Wizard.
- Vai alla tua Cloudera Manager Admin Console effettuando il login a: HTTP://:7180, dove è il FQDN o l'indirizzo IP dell'host su cui è in esecuzione Cloudera Manager Server.
- Accedi alla Cloudera Manager Admin Console. Le credenziali predefinite sono:
**Username**: admin **Password**: admin
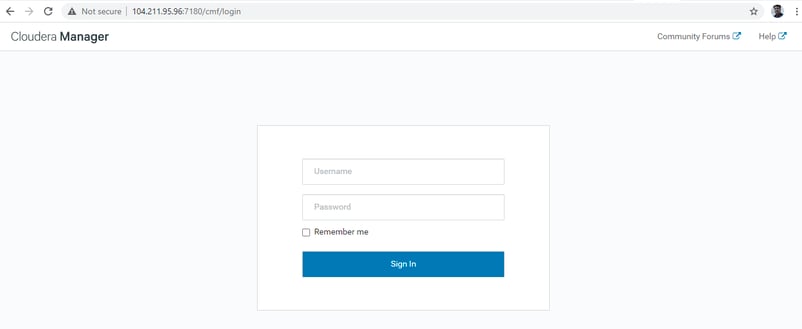
Leggi termini e condizioni e accettali: fai clic su Continue e si avvierà la procedura guidata di installazione.
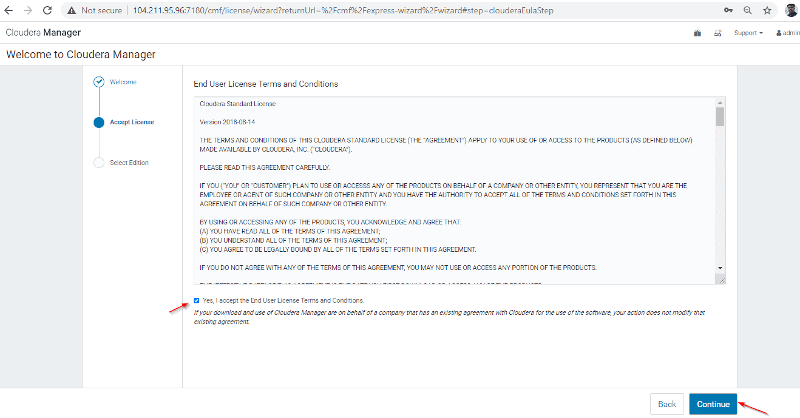
La procedura guidata di installazione di Cloudera Manager ti accompagnerà attraverso una serie di passaggi come segue: Select Edition Puoi selezionare l'edizione da installare e, facoltativamente, puoi anche installare una licenza.
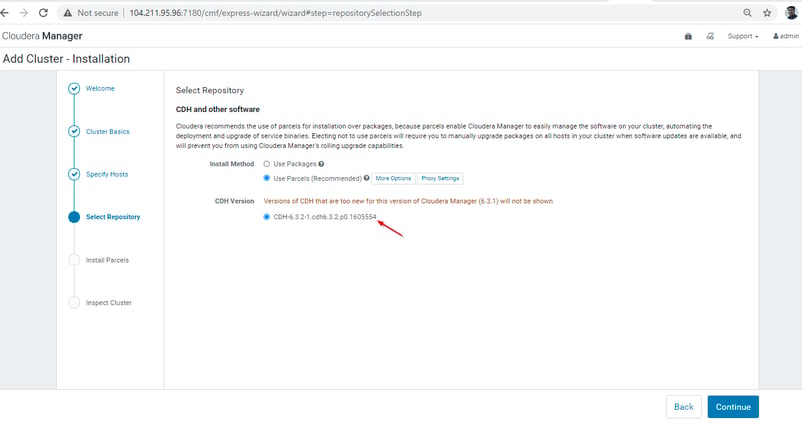
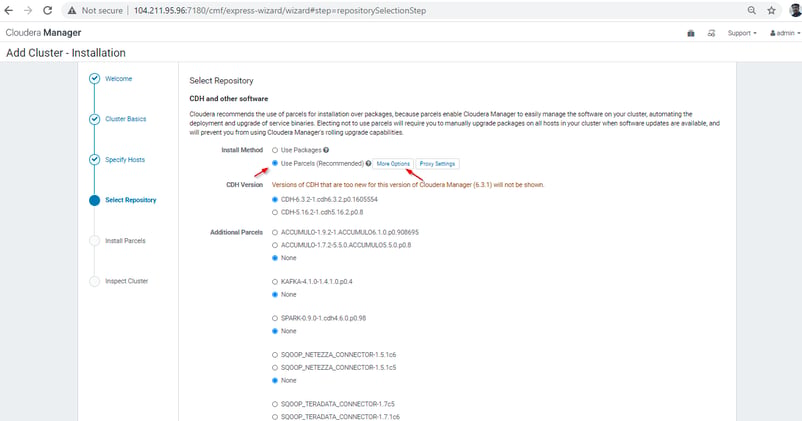
Specify Hosts Scegli quali host verranno utilizzati per eseguire CDH e gli altri servizi gestiti. Select Repository Qui devi:
- Per prima cosa, selezionare il tipo di repository da usare per l'installazione. Si consiglia di scegliere Use Parcels per questo cluster di prova di concetto.
- Poi, devi selezionare la versione di CDH da installare e gli eventuali Parcels aggiuntivi che vuoi installare.
- Potrai selezionare la release del Cloudera Manager Agent che vuoi installare.
- Fai clic su Continue.
Accept JDK License Installando il software JDK, accetti di essere vincolato dall'Oracle Binary Code License Agreement. Dopo aver letto i termini della licenza e aver selezionato le caselle applicabili, fai clic su Continue.
Enter Login Credentials Definendo un account root, username, metodo di autenticazione, porta ssh e il numero di host.
Install Agents La pagina Install Agents mostra l'avanzamento dell'installazione. Puoi espandere i dettagli per qualsiasi host per visualizzare il log di installazione.
Install Parcels La pagina Install Parcels visualizza l'avanzamento dell'installazione dei pacchetti selezionati in precedenza. Puoi fare clic su qualsiasi barra di avanzamento specifica per i dettagli relativi a quell'host.
Inspect Hosts La pagina Inspect Hosts esegue l'Host Inspector per cercare problemi di configurazione comuni. Visualizza i risultati e risolvi eventuali problemi identificati. Quindi fai clic sul pulsante Run Again per aggiornare i risultati dopo aver apportato eventuali modifiche.
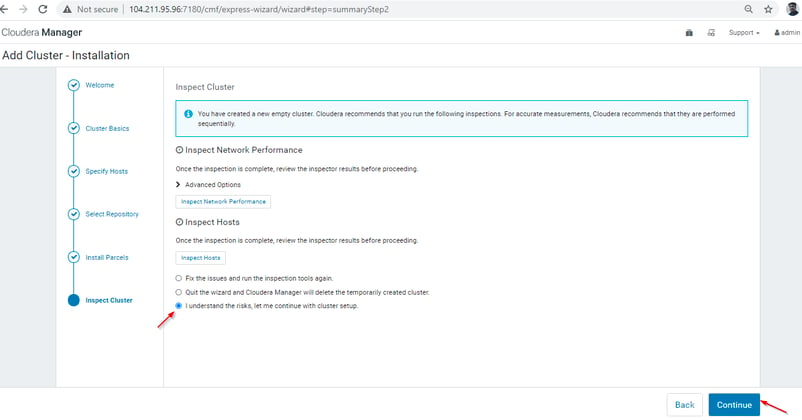
Dopo aver completato tutti i passaggi sopra, si avvierà automaticamente il Cluster Setup wizard.
Riepilogo
I benefici portati alle aziende da Hadoop sono considerevoli. Grazie a questo framework, è possibile archiviare ed elaborare grandi quantità di dati rapidamente grazie al suo calcolo distribuito. I dati e le applicazioni in elaborazione sono protetti dai guasti hardware. Se un nodo si guasta, i job vengono reindirizzati direttamente ad altri nodi per garantire che il calcolo distribuito non fallisca. Diverse copie di tutti i dati vengono archiviate automaticamente. Puoi leggere di più sulle storie di successo qui e seguire il nostro blog per altri aggiornamenti relativi alla data science.





Che cos'è Apache Hadoop?
Hadoop è un framework Java open source per applicazioni distribuite e gestione di dati intensivi. Consente alle applicazioni di lavorare con migliaia di nodi e petabyte di dati. Hadoop è stato ispirato dalle pubblicazioni di Google su MapReduce, GoogleFS e BigTable.
Grazie al framework MapReduce, può gestire enormi quantità di dati. Piuttosto che spostare i dati su una rete per effettuare l'elaborazione, MapReduce consente al software di elaborazione di spostarsi direttamente verso i dati.
Non è un prodotto in sé, ma un framework di istruzioni per l'archiviazione e l'elaborazione di dati distribuiti. Vari fornitori di software hanno utilizzato Hadoop per creare prodotti commerciali di gestione dei Big Data.
I sistemi dati Hadoop non sono limitati in scala, il che significa che si possono aggiungere più hardware e cluster per supportare carichi maggiori senza riconfigurazioni o acquisto di costose licenze software.
Storia di Apache Hadoop e tendenze
Cloudera è stata cofondata nel 2008 dal matematico Jeff Hammerbach, ex dipendente di Bear Stearns e Facebook. Era responsabile dell'analisi dei dati e dello sviluppo di programmi per un migliore targeting pubblicitario. Gli altri cofondatori sono Christophe Bisciglia, ex dipendente di Google, Amr Awadallah, ex dipendente di Yahoo che ha lavorato anche su Hadoop, e Mike Olson, CEO di Cloudera. L'architetto capo è Doug Cutting, autore del motore di indicizzazione Lucene e del framework distribuito Hadoop.
Nel 2018 Cloudera si è fusa con il suo principale concorrente: Hortonworks. L'azienda ha poi avviato un riposizionamento per aprirsi al mondo del cloud. Nel 2021, Cloudera è stata acquistata da due fondi di private equity, KKR e Clayton Dubilier & Rice, per 5,3 miliardi di dollari, ottenendo così una solida base per continuare l'espansione sul mercato.
Hadoop è iniziato con Doug Cutting e Mike Cafarella nel 2002, quando entrambi hanno iniziato a lavorare al progetto Apache Nutch. Il progetto Apache Nutch creò un sistema di motore di ricerca in grado di indicizzare 1 miliardo di pagine. Dopo molte ricerche su Nutch, conclusero che un tale sistema sarebbe costato circa mezzo milione di dollari in hardware e un costo operativo mensile di circa 30.000 dollari, che è molto costoso. Così, si resero conto che l'architettura del loro progetto non sarebbe stata in grado di aggirare i miliardi di pagine Web. Volevano una soluzione che potesse ridurre il costo di implementazione e il problema dell'archiviazione e dell'elaborazione di grandi set di dati.
Nel 2003 si imbatterono in un articolo che descriveva l'architettura del file system distribuito di Google, chiamato GFS (Google File System), pubblicato da Google, per l'archiviazione di enormi volumi di dati. Sapevano che questo paper poteva risolvere il loro problema di archiviazione di file enormi generati dai processi di web crawling e indicizzazione. Ma questo paper era solo mezza soluzione al loro problema.
Nel 2004, Google pubblicò un altro paper sulla tecnica MapReduce, che era la soluzione per gestire questi grandi set di dati. Questo paper fu l'altra mezza soluzione per Doug Cutting e Mike Cafarella per il loro progetto Nutch. Queste tecniche (GFS e MapReduce) erano solo su carta in Google. Google non implementò queste due tecniche. Doug Cutting sapeva per esperienza con Apache Lucene che l'open source è un ottimo modo per diffondere la tecnologia a più persone. Così, insieme a Mike Cafarella, iniziò a implementare in open source le tecniche di Google (GFS & MapReduce) nel progetto Apache Nutch.
Nel 2005, Cutting scoprì che Nutch era limitato a cluster di soli 20-40 nodi. Si rese rapidamente conto di due problemi: (a) Nutch non avrebbe raggiunto il suo potenziale finché non avesse funzionato in modo affidabile sui cluster più grandi (b) Sembrava impossibile con solo due persone (Doug Cutting & Mike Cafarella). Il compito di ingegneria nel progetto Nutch era molto più grande di quanto pensasse, quindi iniziò a cercare un lavoro presso un'azienda interessata a investire nei loro sforzi. Scoprì che Yahoo! aveva un grande team di ingegneri desiderosi di lavorare a questo progetto.
Nel 2006, Doug Cutting si unì a Yahoo con il progetto Nutch. Voleva fornire al mondo, con l'aiuto di Yahoo, un framework di calcolo open source, affidabile e scalabile. Fu in Yahoo che Cutting separò le parti di calcolo distribuito di Nutch e formò un nuovo progetto, Hadoop. Diede al progetto il nome Hadoop dal giocattolo, un elefante giallo, di suo figlio; era anche una parola unica e facile da pronunciare. Voleva creare Hadoop in modo che funzionasse bene su migliaia di nodi, e iniziò quindi a lavorare su Hadoop con GFS e MapReduce.
Nel 2007, Yahoo testò con successo Hadoop su un cluster da 1.000 nodi e iniziò a usarlo.
Nel gennaio 2008, Yahoo rilasciò Hadoop come progetto open source alla ASF (Apache Software Foundation). Nel luglio 2008, l'Apache Software Foundation testò con successo un cluster da 4000 nodi con Hadoop.
Nel 2009, Hadoop venne testato con successo per ordinare un petabyte di dati in meno di 17 ore per gestire miliardi di ricerche e indicizzare milioni di pagine web. Doug Cutting lasciò Yahoo ed entrò in Cloudera per affrontare la sfida di diffondere Hadoop in altri settori.