

Apache Hadoop का इकोसिस्टम
Hadoop डेटा प्रोसेसिंग के लिए डे फ़ैक्टो मानक बन गया, ठीक उसी तरह जैसे Excel धीरे-धीरे डेटा विश्लेषण के लिए डिफ़ॉल्ट सॉफ़्टवेयर बन गया है। Excel के विपरीत, Hadoop को "बिज़नेस एनालिस्ट्स" नहीं, बल्कि डेवलपर्स ने डिज़ाइन किया था; फिर भी बड़े पैमाने पर अपनाने और सफलता डेवलपर्स से अधिक बिज़नेस एनालिस्ट्स पर निर्भर करती है। इसी कारण बिग डेटा की समस्याओं को कार्यात्मक दृष्टिकोण से खंडित किया गया, और हर खंड की चुनौतियों को पूरा करने के लिए Hadoop-आधारित तकनीकें विकसित की गईं। ये सभी टूल मिलकर Hadoop इकोसिस्टम कहलाते हैं।
Hadoop इकोसिस्टम, Hadoop को समृद्ध बनाता है और इसे विभिन्न तरह की व्यावसायिक समस्याएँ सुलझाने में सक्षम करता है। आज तक, Hadoop इकोसिस्टम सैकड़ों तकनीकों से बना है जिन्हें हमने उनकी समस्या-श्रेणियों के आधार पर 14 वर्गों में समूहीकृत किया है: एब्स्ट्रैक्शन लैंग्वेजेज, Hadoop पर SQL (Hive और Pig), कम्प्यूटेशनल मॉडल (MapReduce और Tez), रीयल-टाइम प्रोसेसिंग टूल (Storm और Spark Streaming), डेटाबेस (HBase और Cassandra), स्ट्रीमिंग इन्जेशन टूल (Kafka और Flume), डेटा इंटीग्रेशन टूल (Sqoop और Talend), वर्कफ़्लो कोऑर्डिनेशन टूल (Oozie और Control M for Hadoop), डिस्ट्रीब्यूटेड सर्विस कोऑर्डिनेशन टूल (Zookeeper), क्लस्टर एडमिनिस्ट्रेशन टूल (Ranger और Sentry), यूज़र इंटरफ़ेस टूल (Hue और Jupyter), कंटेंट इंडेक्सिंग टूल (ElasticSearch और Splunk), डिस्ट्रीब्यूटेड फ़ाइल सिस्टम (HDFS), और रिसोर्स मैनेजर्स (YARN और MESOS)। यह खंड बिग डेटा तकनीकों के इस इकोसिस्टम के हर टूल के कार्य की समीक्षा करेगा। उसके बाद, यदि आप और गहराई में जाना चाहते हैं, तो हम अनुशंसा करते हैं कि आप Hadoop इकोसिस्टम के विभिन्न तत्वों पर हमारे मार्गदर्शकों को पढ़ें जो इस लेख के बाद आएंगे। निम्नलिखित माइंड मैप, Hadoop इकोसिस्टम का समग्र रूप से प्रस्तुतीकरण करता है।
Hadoop इकोसिस्टम हीयुरिस्टिक मैप
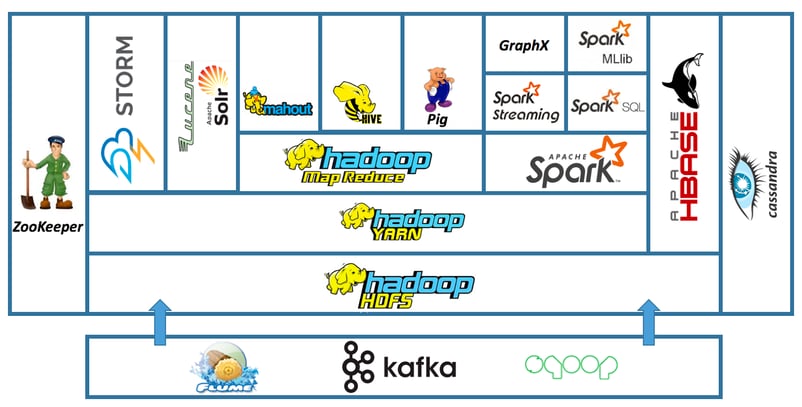
Hadoop इकोसिस्टम की बेसिक कॉन्फ़िगरेशन में निम्नलिखित तकनीकें शामिल होती हैं: Spark, Hive, Pig, HBase, Sqoop, Storm, ZooKeeper, Oozie, और Kafka।
Spark
Spark क्या है यह बताने से पहले, याद रखें कि Hadoop में किसी मल्टी-नोड क्लस्टर पर कोई एल्गोरिदम चलने के लिए उसका पैरेललाइज़ेबल होना आवश्यक है। इस प्रकार, कोई एल्गोरिदम "स्केलेबल" तब कहलाता है जब वह पैरेललाइज़ेबल हो (और इसलिए क्लस्टर की स्केलेबिलिटी का लाभ ले सके)। Hadoop, MapReduce कम्प्यूटिंग मॉडल का एक इम्प्लीमेंटेशन है। MapReduce की समस्या यह है कि यह एक डायरेक्ट एसीक्लिक ग्राफ मॉडल पर आधारित है। दूसरे शब्दों में, MapReduce ऑपरेशन क्रम तीन प्रत्यक्ष अनुक्रमिक चरणों में बिना मोड़ के चलता है (Map -> Shuffle -> Reduce); कोई भी चरण आवर्ती (या चक्रीय) नहीं है।
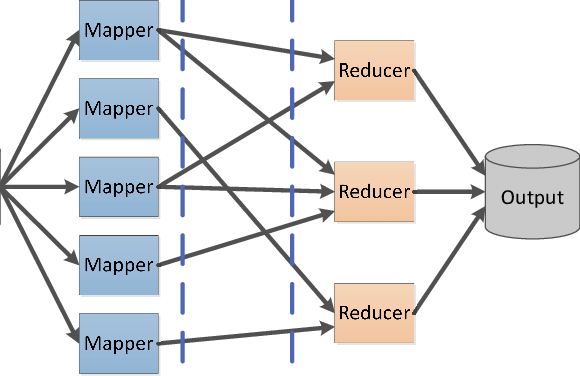
डायरेक्ट एसीक्लिक मॉडल कुछ अनुप्रयोगों के लिए उपयुक्त नहीं है, विशेषकर वे जो कई ऑपरेशनों में डेटा का पुन: उपयोग करते हैं, जैसे कि अधिकांश सांख्यिकीय लर्निंग एल्गोरिदम, जो आवर्ती होते हैं, और इंटरैक्टिव डेटा विश्लेषण क्वेरीज़। Spark इन सीमाओं का उत्तर है; यह एक कम्प्यूटेशनल इंजन है जो क्लस्टर पर इन-मेमोरी डिस्ट्रीब्यूटेड प्रोसेसिंग करता है। दूसरे शब्दों में, यह एक डिस्ट्रीब्यूटेड इन-मेमोरी कम्प्यूटिंग इंजन है। MapReduce, जो बैच मोड में काम करता है, की तुलना में Spark का कम्प्यूटेशन मॉडल इंटरैक्टिव मोड में काम करता है, यानी प्रोसेसिंग से पहले डेटा को मेमोरी में एकत्र करता है और इसलिए मशीन लर्निंग प्रोसेसिंग के लिए बेहद उपयुक्त है।
Hive
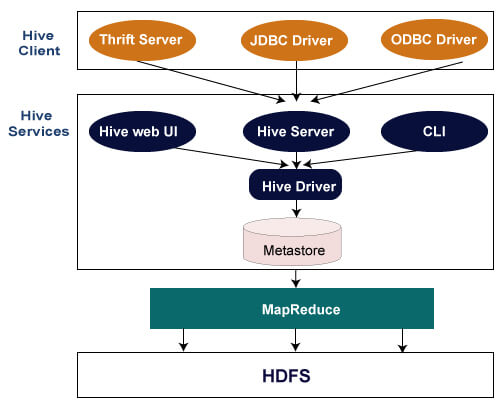
Hive एक डेटा वेयरहाउस के समान कम्प्यूटिंग इंफ्रास्ट्रक्चर है जो HDFS जैसे डिस्ट्रीब्यूटेड फ़ाइल सिस्टम पर संग्रहीत बहुत बड़े डेटा वॉल्यूम के लिए क्वेरी और एग्रीगेशन सेवाएँ प्रदान करता है। Hive एक SQL-आधारित (ANSI-92 मानक) क्वेरी लैंग्वेज प्रदान करता है जिसे HiveQL (Hive Query Language) कहा जाता है, जो HDFS पर संग्रहीत डेटा पर क्वेरीज़ चलाता है। HiveQL उन्नत उपयोगकर्ताओं/डेवलपर्स को अपनी क्वेरी में सीधे Map और Reduce फ़ंक्शन्स एकीकृत करने की अनुमति देता है ताकि डेटा प्रबंधन समस्याओं की व्यापक शृंखला को कवर किया जा सके। जब आप HiveQL में कोई क्वेरी लिखते हैं, तो Hive उस क्वेरी को एक MapReduce जॉब में बदलकर JobTracker को निष्पादन के लिए सबमिट करता है।
Pig
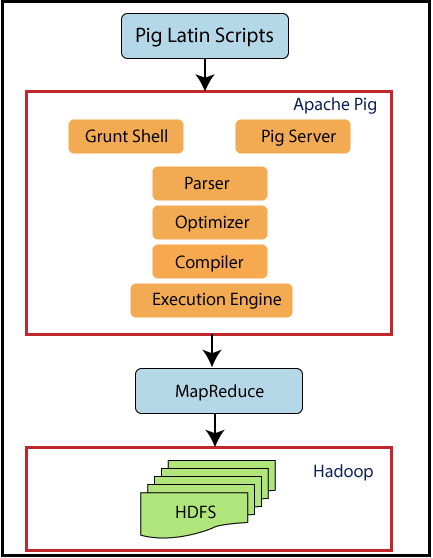
Pig, Hadoop के अंतर्गत एक इंटरैक्टिव डेटा फ़्लो निष्पादन परिवेश है। यह 2 तत्वों से मिलकर बना है: एक डेटा फ़्लो एक्सप्रेशन लैंग्वेज जिसे Pig Latin कहा जाता है, और एक इंटरैक्टिव डेटा फ़्लो निष्पादन परिवेश।
Pig द्वारा दी गई भाषा, Pig Latin, मोटे तौर पर Perl, Python, या Ruby जैसी स्क्रिप्टिंग भाषाओं के समान है। हालाँकि, यह उनसे अधिक विशिष्ट है और इसे "डेटा फ़्लो लैंग्वेज" के रूप में सबसे अच्छा वर्णित किया जा सकता है। यह आपको स्रोत डेटा की क्रमिक धाराओं में क्वेरी लिखने की अनुमति देता है ताकि Hadoop के अंतर्गत "लक्ष्य" डेटा प्राप्त हो सके, कुछ हद तक ETL की शैली में। इन फ़्लोज़ को फिर MapReduce फ़ंक्शन्स में रूपांतरित किया जाता है जिन्हें अंततः निष्पादन के लिए जॉब ट्रैकर को सबमिट किया जाता है। सरल शब्दों में, Pig Hadoop का ETL है। Pig Latin में प्रोग्रामिंग करने का अर्थ है स्वतंत्र लेकिन नेस्टेड स्ट्रीम्स में यह बताना कि डेटा कैसे लोड, ट्रांसफ़ॉर्म और एग्रीगेट किया जाता है, विशेष Pig स्टेटमेंट्स जिन्हें ऑपरेटर्स कहा जाता है, का उपयोग करते हुए। इन ऑपरेटर्स में महारत हासिल करना, खासकर जबकि ये Hive की तुलना में कम हैं, Pig Latin प्रोग्रामिंग में महारत की कुंजी है।
HBase
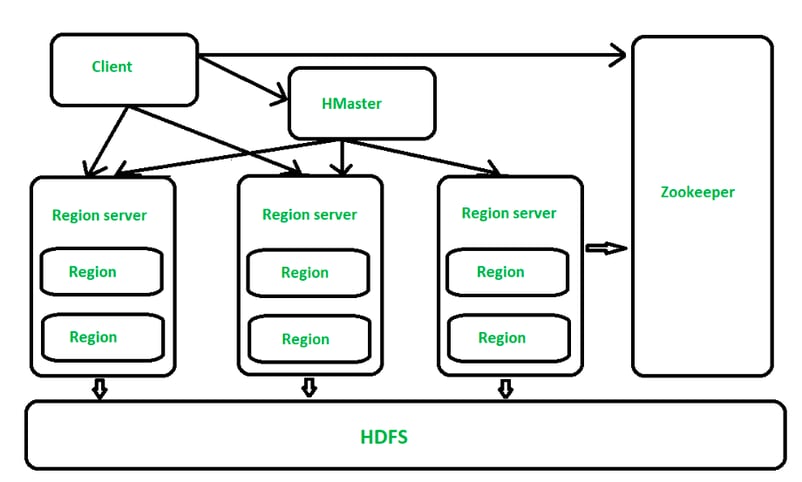
HBase पर बात करने से पहले, याद दिलाएँ कि अब तक डेटा प्रबंधन के लिए उपयोग किए गए RDBMS उच्च डेटा वॉल्यूम और डेटा की विविधता के सामने बहुत जल्दी अपनी सीमाएँ दिखा चुके हैं। दरअसल, RDBMS केवल संरचित डेटा (पंक्ति/स्तंभ वाली तालिकाएँ) को प्रबंधित करने के लिए डिज़ाइन किए गए हैं; साथ ही, डेटा वॉल्यूम बढ़ने से अनुरोधों की लेटेंसी बढ़ जाती है। यह लेटेंसी उन कई व्यवसायों के लिए हानिकारक है जिन्हें लगभग रीयल-टाइम प्रतिक्रियाएँ चाहिए। इन सीमाओं को दूर करने के लिए "NoSQL" कहलाने वाले नए DBMS विकसित किए गए। ये डेटा पर कोई विशिष्ट संरचना नहीं थोपते, डेटा के स्टोरेज और प्रबंधन को कई नोड्स पर वितरित कर सकते हैं, और स्केलेबल होते हैं। याद रहे, स्केलेबिलिटी का अर्थ है कि प्रोसेसिंग लोड बढ़ने पर भी सिस्टम का परफॉर्मेंस स्थिर रहे। HBase इसी श्रेणी के DBMS में आता है।
HBase एक डिस्ट्रीब्यूटेड, कॉलम-ओरिएंटेड DBMS है जो HDFS पर संग्रहीत डेटा तक रीयल-टाइम रीड और राइट एक्सेस प्रदान करता है। HDFS डेटा तक बैच में सीक्वेंशियल एक्सेस देता है, जो स्ट्रीमिंग जैसी तेज़ डेटा एक्सेस समस्याओं के लिए उपयुक्त नहीं है; HBase इन खाइयों को भरता है और HDFS पर संग्रहीत डेटा तक तेज़ पहुँच प्रदान करता है।
HBase, Google के "Big Table" DBMS पर आधारित है और बहुत बड़े पैमाने (अरबों पंक्तियाँ/स्तंभ) पर डेटा स्टोर कर सकता है। यह ZooKeeper पर निर्भर करता है, जो एप्लिकेशन विकास के लिए एक डिस्ट्रीब्यूटेड कोऑर्डिनेशन सर्विस है।
Sqoop
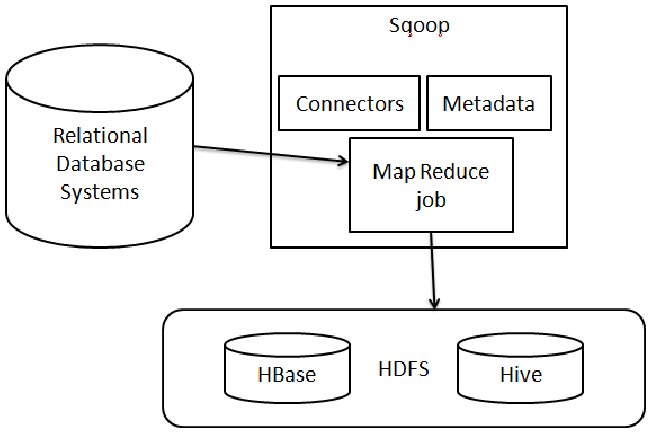
Sqoop या SQL-to-Hadoop एक टूल है जो रिलेशनल डेटाबेस से Hadoop के HDFS में और विपरीत दिशा में डेटा ट्रांसफ़र करता है। यह Hadoop इकोसिस्टम के साथ इंटीग्रेटेड है और Hadoop में डेटा इन्जेशन शेड्यूलर है। आप Sqoop का उपयोग MySQL, Oracle, या SQL Server जैसे RDBMS से HDFS में डेटा आयात करने, Hadoop में MapReduce या किसी अन्य कम्प्यूटेशनल मॉडल के माध्यम से डेटा ट्रांसफ़ॉर्म करने, और फिर उसे वापस RDBMS में निर्यात करने के लिए कर सकते हैं। हम इसे डेटा इन्जेशन शेड्यूलर इसलिए कहते हैं क्योंकि Oozie की तरह यह आयात/निर्यात प्रक्रिया को स्वचालित करता है और उसके निष्पादन समय को शेड्यूल करता है। उपयोगकर्ता के रूप में आपको बस वे SQL क्वेरी लिखनी होती हैं जिनका उपयोग आयात/निर्यात मूवमेंट करने के लिए होगा। इसके अलावा, Sqoop डेटा आयात और निर्यात करने के लिए MapReduce का उपयोग करता है, जो कुशल और फॉल्ट-टॉलरेंट है।
Storm
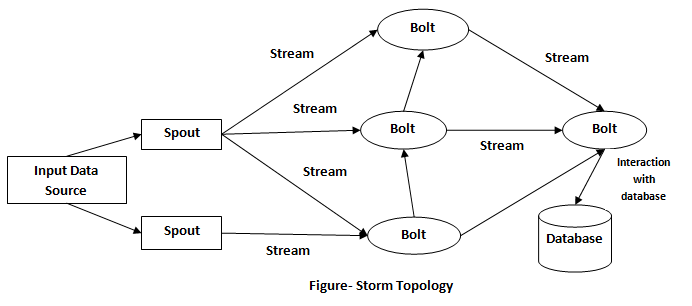
Storm को समझने के लिए आपको लैम्ब्डा आर्किटेक्चर (λ) की अवधारणा और उनके महत्व को समझना होगा। आपको कनेक्टेड ऑब्जेक्ट्स की अवधारणा समझनी होगी। कनेक्टेड ऑब्जेक्ट्स या Internet of Things (IoT) हमारे दैनिक जीवन में इंटरनेट का विस्तार हैं। ये स्ट्रीमिंग डेटा उत्पन्न करते हैं और ज्यादातर मामलों में डेटा का रीयल-टाइम प्रोसेसिंग आवश्यक होता है। जिन मॉडलों से आप परिचित हैं, जैसे बैच मॉडल, वे IoT द्वारा उठाए गए रीयल-टाइम मुद्दों के लिए उपयुक्त नहीं हैं। यहाँ तक कि इंटरैक्टिव कम्प्यूटिंग मॉडल भी रीयल-टाइम में सतत प्रोसेसिंग करने के लिए अनुकूल नहीं हैं। किसी कंपनी की ऑपरेशनल प्रणालियों जैसे वित्त या मार्केटिंग द्वारा उत्पन्न परिचालन डेटा, जो स्ट्रीमिंग में भी उत्पन्न हो सकता है, को बाद में प्रोसेसिंग के लिए ऐतिहासिक रूप से संग्रहीत किया जा सकता है; इसके विपरीत, IoT या इंटरनेट जैसे परिघटनाओं के हिस्से के रूप में स्ट्रीमिंग में उत्पन्न डेटा, अपनी रचना के तुरंत बाद ही एक्सपायर हो जाता है (या मान्य नहीं रहता), और इसलिए तत्काल प्रोसेसिंग की आवश्यकता होती है। कनेक्टेड ऑब्जेक्ट्स के अलावा, धोखाधड़ी से लड़ाई, सोशल नेटवर्क डेटा का विश्लेषण, जियोलोकेशन जैसे व्यावसायिक समस्याओं को बहुत कम प्रतिक्रिया समय चाहिए, लगभग एक सेकंड से भी कम। इस समस्या को बिग डेटा संदर्भ में हल करने के लिए तथाकथित λ आर्किटेक्चर विकसित किए गए। ये आर्किटेक्चर लेटेंसी को कम करने के लिए MapReduce में दो अतिरिक्त प्रोसेसिंग लेयर्स जोड़ते हैं। Storm, λ आर्किटेक्चर का एक सॉफ़्टवेयर इम्प्लीमेंटेशन है। यह Hadoop के अंतर्गत ऐसी एप्लिकेशन को सक्षम करता है जो डेटा को रीयल (या निकट रीयल) टाइम में प्रोसेस करती हैं।
ZooKeeper
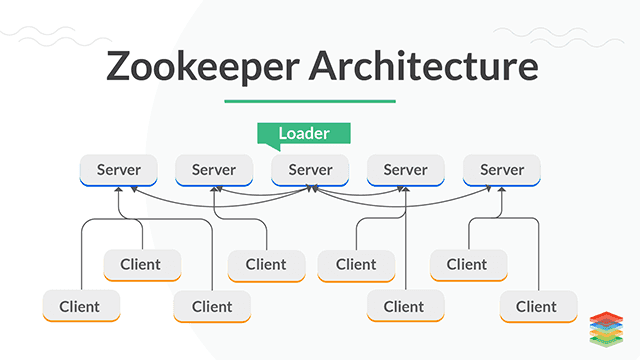
समानांतर कार्यों के निष्पादन के दौरान नोड्स के बीच संचार को सिंक्रोनाइज़ या कोऑर्डिनेट करना, डिस्ट्रीब्यूटेड एप्लिकेशन डेवलपमेंट की सबसे कठिन समस्याओं में से एक है। इस समस्या को हल करने के लिए Hadoop ने अपने इकोसिस्टम में सर्विस कोऑर्डिनेशन टूल जोड़े हैं, जिनमें ZooKeeper प्रमुख है। ZooKeeper क्लस्टर में डिस्ट्रीब्यूटेड जॉब्स के निष्पादन के सिंक्रोनाइज़ेशन की अन्तर्निहित जटिलता को संभाल लेता है, और Hadoop इकोसिस्टम के अन्य टूल्स को स्वयं इस समस्या से नहीं जूझना पड़ता। यह उपयोगकर्ताओं को डिस्ट्रीब्यूटेड प्रोग्रामिंग में विशेषज्ञ हुए बिना डिस्ट्रीब्यूटेड एप्लिकेशन्स विकसित करने की अनुमति भी देता है। Hadoop क्लस्टर में नोड्स के बीच डेटा के कोऑर्डिनेशन के जटिल विवरण में जाए बिना, ZooKeeper डिस्ट्रीब्यूटेड एप्लिकेशन्स के लिए एक डिस्ट्रीब्यूटेड कॉन्फ़िगरेशन सर्विस, एक डिस्ट्रिब्यूशन सर्विस, और एक नेमिंग रजिस्ट्री प्रदान करता है। ZooKeeper वह माध्यम है जिसके ज़रिए Hadoop डिस्ट्रीब्यूटेड जॉब्स का समन्वय करता है।
Oozie
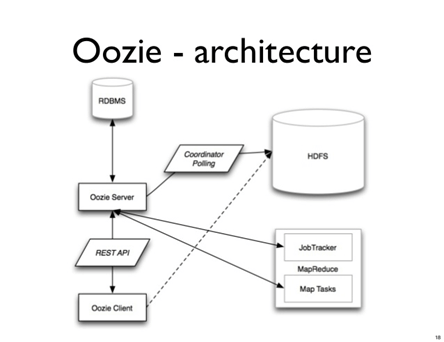
डिफ़ॉल्ट रूप से, Hadoop जॉब्स को उसी क्रम में निष्पादित करता है जैसे उपयोगकर्ता उन्हें सबमिट करता है, बिना इस पर ध्यान दिए कि उनके बीच आपसी संबंध क्या है। हालाँकि, जिन समस्याओं के लिए Hadoop का उपयोग होता है, वे आमतौर पर एक या अधिक जटिल जॉब्स लिखने की मांग करती हैं। जब दो जॉब्स JobTracker (या YARN) को सबमिट किए जाते हैं, तो वह उनके आपसी लिंक पर ध्यान दिए बिना उन्हें निष्पादित करेगा, जो त्रुटि (एक्सेप्शन) का कारण बन सकता है और कोड को रोक सकता है। ऐसे में, एक ही समस्या से संबंधित कई जॉब्स के निष्पादन का प्रबंधन कैसे करें? इस प्रकार की समस्या को प्रबंधित करने के लिए, वर्तमान में सबसे सरल समाधान है जॉब शेड्यूलर का उपयोग करना, यानी Oozie।
Oozie एक जॉब शेड्यूलर है जो Hadoop क्लस्टर पर एक सर्विस के रूप में चलता है। इसका उपयोग Hadoop जॉब्स को शेड्यूल करने के लिए, और सामान्य रूप से क्लस्टर पर चलने वाले सभी जॉब्स—जैसे Hive स्क्रिप्ट, MapReduce जॉब, Hama जॉब, Storm जॉब, आदि—के निष्पादन को शेड्यूल करने के लिए होता है। इसे इस तरह डिज़ाइन किया गया है कि यह Hadoop क्लस्टर पर हजारों परस्पर निर्भर जॉब्स के तात्कालिक या विलंबित निष्पादन का स्वचालित रूप से प्रबंधन कर सके। Oozie का उपयोग करने के लिए, आपको केवल 2 XML फ़ाइलों को कॉन्फ़िगर करना होता है: एक Oozie इंजन कॉन्फ़िगरेशन फ़ाइल और एक जॉब वर्कफ़्लो कॉन्फ़िगरेशन फ़ाइल।
Cloudera का परिचय
Cloudera कैलिफ़ोर्निया स्थित एक अमेरिकी कंपनी है, जो ऐतिहासिक रूप से Hadoop डिस्ट्रीब्यूटेड फ़्रेमवर्क पर आधारित एक बिग डेटा समाधान विकसित करने के लिए समर्पित रही है; वर्तमान में यह क्लाउड की ओर पुनर्संरेखित हो रही है। एक वर्ष से अधिक समय से, Cloudera AWS, Azure और GCP जैसे पब्लिक क्लाउड्स में अपने समाधान का विस्तार कर रही है।
CDP का परिचय
Cloudera Data Platform CDP एक प्लेटफ़ॉर्म है जो कंपनियों को हाइब्रिड और मल्टी-क्लाउड परिवेशों में सेल्फ़-सर्विस एनालिटिक्स के साथ डेटा का विश्लेषण करने की अनुमति देता है। यह संगठनों को कुछ घंटों में क्लाउड में डेटा लेक्स बनाकर अपने समस्त डेटा से अधिक मूल्य निकालने में सक्षम बनाता है।
CDP डेटा का विश्लेषण और केंद्रीकरण करने के लिए एकीकृत, बहु-कार्यात्मक, सेल्फ़-सर्विस टूल प्रदान करता है। इसके अलावा, यह एंटरप्राइज़-स्तरीय सुरक्षा और गवर्नेंस प्रदान करता है और पब्लिक, प्राइवेट और मल्टी-क्लाउड परिवेशों में परिनियोजित किया जा सकता है। CDP, Cloudera की पिछली दो Hadoop डिस्ट्रीब्यूशन्स—Cloudera Distribution of Hadoop (CDH) और Hortonworks Data Platform (HDP)—के बाद की डिस्ट्रीब्यूशन है।
एंटरप्राइज़ डेटा तक सेल्फ़-सर्विस ऐक्सेस इस सेवा का मूल है। प्लेटफ़ॉर्म में एकीकृत नई जोड़ी गई क्लाउड सेवाएँ भी विश्लेषकों, डेटा वैज्ञानिकों, आईटी पेशेवरों और डेवलपर्स के लिए डेटा और एनालिटिक्स तक सेल्फ़-सर्विस ऐक्सेस प्रदान करती हैं। वे कीवर्ड जो प्लेटफ़ॉर्म को इसके प्रतिस्पर्धियों से अलग करते हैं, Cloudera द्वारा प्रस्तुत तीन क्लाउड-नेटिव CDP सेवाएँ हैं: सेल्फ़-सर्विस, मल्टी-क्लाउड, और सुरक्षा।
CDP एक अद्वितीय सार्वजनिक-निजी दृष्टिकोण, रीयल-टाइम डेटा एनालिटिक्स, ऑन-प्रिमाइस, क्लाउड और हाइब्रिड परिनियोजन विकल्पों में स्केलेबिलिटी, और प्राइवेसी-फ़र्स्ट आर्किटेक्चर प्रदान करता है।
CDP पब्लिक क्लाउड
CDP पब्लिक क्लाउड एक Platform-as-a-Service (PaaS) है जो क्लाउड इन्फ्रास्ट्रक्चर के साथ संगत है और निजी समाधानों जैसे OpenShift सहित विभिन्न क्लाउड प्रदाताओं के बीच आसानी से पोर्टेबल है। CDP को पूरी तरह हाइब्रिड और मल्टी-क्लाउड होने के लिए डिज़ाइन किया गया है, यानी एक ही प्लेटफ़ॉर्म सभी डेटा लाइफ़साइकल उपयोग मामलों का प्रबंधन कर सकता है। CDP प्लेटफ़ॉर्म कई सेटिंग्स में डेटा के साथ काम कर सकता है, जिनमें AWS, Azure और GCP जैसे पब्लिक क्लाउड शामिल हैं। इसके अलावा, यह प्रदर्शन में सुधार और लागत घटाने के लिए वर्कलोड और संसाधनों को स्वचालित रूप से ऊपर या नीचे स्केल कर सकता है।
CDP पब्लिक क्लाउड सेवाएँ
यहाँ CDP पब्लिक क्लाउड के प्रमुख घटक हैं:
-
CDP Data Engineering एक ऑल-इन-वन सेटअप है। यह Apache Spark पर आधारित है। यह Apache Airflow के साथ ऑर्केस्ट्रेशन और ऑटोमेशन सक्षम करके एंटरप्राइज़ डेटा विश्लेषण टीमों में ETL प्रक्रियाओं को सुव्यवस्थित करता है और उच्च विकसित पाइपलाइन मॉनिटरिंग, विज़ुअल डिबगिंग और प्रबंधन टूल प्रदान करता है। इसके अलावा, इसमें आइसोलेटेड कार्य परिवेश हैं और यह कंटेनराइज़्ड, स्केलेबल और आसानी से पोर्टेबल है।
-
CDP Data Hub एक सेवा है जो Edge से AI तक उच्च-मूल्य एनालिटिक्स की अनुमति देती है। Cloudera Data Hub एक क्लाउड-नेटिव डेटा प्रबंधन और एनालिटिक्स सेवा है। यह आईटी और बिज़नेस डेवलपर्स को स्ट्रीमिंग से लेकर ETL तक किसी भी परिदृश्य के लिए तेजी से बिज़नेस एप्लिकेशन बनाने में सक्षम बनाती है। डेटा मार्ट्स, डेटाबेस और मशीन लर्निंग, व्यापक विश्लेषणात्मक वर्कलोड्स में शामिल सेवाओं में से कुछ हैं।
-
CDP Data Warehouse एक सेवा है जो आईटी को BI विश्लेषकों के लिए क्लाउड-नेटिव सेल्फ़-सर्विस एनालिटिक्स अनुभव प्रदान करने में सक्षम बनाती है। स्ट्रीमिंग, डेटा इंजीनियरिंग और एनालिटिक्स CDP Data Warehouse में पूर्ण रूप से एकीकृत हैं। इसके अलावा, इसमें आपके निजी, एकाधिक सार्वजनिक, या हाइब्रिड क्लाउड्स में सभी डेटा और मेटाडेटा को सुरक्षित और गवर्न करने के लिए एक एकीकृत फ़्रेमवर्क है। Cloudera Data Warehouse सेवा डेटा विश्लेषकों के लिए सेल्फ़-सर्विस डेटा वेयरहाउस को आसानी से परिनियोजित करना संभव बनाती है। यह मज़बूत, एंटरप्राइज़-टेस्टेड SQL इंजनों पर आधारित है। सैकड़ों उपयोगकर्ता एक क्लिक में, ऑन-प्रिमाइस और क्लाउड दोनों पर, डेटा तक पहुँच सकेंगे। संसाधनों को आवश्यकता अनुसार ऑन-डिमांड स्केल किया जा सकता है, और वर्कलोड प्रबंधन भी सहज टूल्स के साथ सेल्फ़-सर्विस है।
-
CDP Machine Learning सहयोगात्मक मशीन लर्निंग वर्कस्पेसेज़ को परिनियोजित करना आसान बनाता है ताकि डेटा वैज्ञानिक एंटरप्राइज़ डेटा का लाभ उठा सकें। यह मॉडलों को तैनात करने, वितरित करने और मॉनिटर करने के लिए नेटिव और व्यापक टूल्स का उपयोग करके ML वर्कफ़्लोज़ को अनुकूलित करता है। इस टूल के साथ, संगठन कुछ क्लिक में नए मशीन लर्निंग वर्कस्पेसेज़ को जल्दी से परिनियोजित कर सकते हैं ताकि मशीन लर्निंग वर्कफ़्लोज़ के लिए आवश्यक टूल्स और डेटा तक सेल्फ़-सर्विस पहुँच सक्षम हो सके। साथ ही, ऑन-प्रिमाइस या क्लाउड में डेटा प्रतिकृति सुरक्षा और गवर्नेंस से समझौता किए बिना तेज़ी से की जा सकती है। डेटा वैज्ञानिक अपने टूल्स भी चुन सकते हैं, जबकि अपनी आवश्यकताओं के अनुसार अनुकूलित की जा सकने वाली इलास्टिक संसाधनों का लाभ उठा सकते हैं। मॉडल ट्रेनिंग, डेटा इंजीनियरिंग, डिप्लॉयमेंट, और मॉडल प्रबंधन एक ऑल-इन-वन इंटरफ़ेस के माध्यम से तेज़ी से हो जाता है, जिससे प्लेटफ़ॉर्म्स के बीच स्विच करने की आवश्यकता समाप्त हो जाती है।
-
Cloudera Data Visualization अपने उपयोगकर्ताओं को वर्चुअल डेटा वेयरहाउस में डेटा को मॉडल करने में सक्षम बनाता है, बिना आधारभूत डेटा संरचनाओं या टेबलों को हटाए या अपडेट किए, और लगातार डेटा लोड किए बिना बड़े पैमाने पर डेटा पर क्वेरी करने में सक्षम बनाता है, इस प्रकार समय और धन दोनों की बचत होती है।
-
Cloudera Operational Database एक प्रबंधित समाधान है जो अंतर्निहित क्लस्टर इंस्टेंस को एक डेटाबेस में संश्लेषित करता है। यह क्लस्टर वर्कलोड उपयोग के आधार पर स्वतः स्केल होगा, समान इन्फ्रास्ट्रक्चर फ़ुटप्रिंट के भीतर परफॉर्मेंस में सुधार करेगा, और ऑपरेशनल मुद्दों को स्वतः हल करेगा।
CDP प्राइवेट क्लाउड
CDP प्राइवेट क्लाउड हाइब्रिड क्लाउड परिनियोजनों के लिए अधिक उपयुक्त है, जो ऑन-प्रिमाइस को पब्लिक क्लाउड्स से जोड़ने की अनुमति देता है, जबकि सुसंगत, एकीकृत सुरक्षा और गवर्नेंस बनाए रखता है। CDP प्राइवेट क्लाउड में प्रोसेसिंग और स्टोरेज को अलग किया गया है, जिससे दोनों क्लस्टर्स को स्वतंत्र रूप से स्केल किया जा सकता है। CDP प्राइवेट क्लाउड बेस क्लस्टर पर उपलब्ध Cloudera Shared Data Experience (SDX) एकीकृत सुरक्षा, गवर्नेंस और मेटाडेटा प्रबंधन प्रदान करता है। इसके अलावा, CDP प्राइवेट क्लाउड उपयोगकर्ता Management Console का उपयोग करके Cloudera Data Warehousing और Cloudera Machine Learning सेवाओं को तेज़ी से प्रोवीज़न और परिनियोजित कर सकते हैं और आवश्यकता अनुसार उन्हें स्केल कर सकते हैं।
CDP प्राइवेट क्लाउड सेवाएँ
CDP पब्लिक क्लाउड के कुछ घटक, जैसे Machine Learning और Data Warehouse, CDP प्राइवेट क्लाउड पर उपलब्ध हैं। यह स्ट्रीमिंग, डेटा इंजीनियरिंग, डेटा मार्ट्स, ऑपरेशनल डेटाबेस और डेटा साइंस को कवर करने वाले विश्लेषणात्मक इंजनों के संग्रह का उपयोग पारंपरिक वर्कलोड्स को सपोर्ट करने के लिए करता है।
HDFS और MapReduce के मूल तत्व
HDFS, Hadoop का डिस्ट्रीब्यूटेड फ़ाइल सिस्टम है और Hadoop का केंद्रीय तत्व है, जो कई सर्वरों पर डेटा को संग्रहीत और प्रतिकृत करने की अनुमति देता है। YARN के साथ संयोजन में, यह HDFS Hadoop क्लस्टर की डेटा प्रबंधन क्षमताओं को बढ़ाता है और इस प्रकार कुशल बिग डेटा प्रोसेसिंग सक्षम करता है।
आप HDFS को कम लागत वाले हार्डवेयर पर चला सकते हैं, जो इसे त्रुटि-सहनशील बनाता है। डेटा के हर हिस्से को कई स्थानों पर संग्रहीत किया जाता है और किसी भी परिस्थिति में पुनर्प्राप्त किया जा सकता है। साथ ही, यह प्रतिकृति संभावित डेटा करप्शन के खिलाफ बचाव में सहायक होती है।
HDFS एक NameNode और एक DataNode का उपयोग करता है। DataNode एक मानक सर्वर है जिस पर डेटा संग्रहीत होता है। NameNode में मेटाडेटा होता है (विभिन्न नोड्स में संग्रहीत डेटा की जानकारी)। एप्लिकेशन केवल NameNode के साथ इंटरैक्ट करता है, और NameNode आवश्यकता अनुसार डेटा नोड्स से संवाद करता है।
HDFS डेटा को इधर-उधर भेजने के बजाय ऑपरेशनों को स्थानांतरित करने पर ध्यान देकर नेटवर्क भीड़ से भी बचाता है। इसका अर्थ है कि एप्लिकेशन उसी जगह डेटा तक पहुंच सकते हैं जहाँ वह संग्रहीत है। इसकी अंतिम मजबूती इसकी पोर्टेबिलिटी है। यह अलग-अलग प्रकार के हार्डवेयर पर बिना किसी अनुकूलता (कम्पैटिबिलिटी) समस्या के चल सकता है।
MapReduce क्या है, और यह कैसे काम करता है?
MapReduce, Apache Hadoop का प्रोसेसिंग इंजन है, जो सीधे Google के MapReduce से व्युत्पन्न है। MapReduce एप्लिकेशन मूलतः Java में लिखा जाता है। यह मैपिंग और रिडक्शन चरणों को लागू करके बड़े पैमाने पर डेटा को आसानी से प्रोसेस करने देता है, ताकि वर्तमान समस्या का समाधान निकाला जा सके। मैपिंग चरण किसी डेटासेट को लेकर उसे दूसरे डेटासेट में परिवर्तित करता है, जिसमें व्यक्तिगत तत्वों को ट्यूपल कहलाने वाले key/value पेयर्स में तोड़ा जाता है। दूसरा रिडक्शन चरण मैपिंग प्रक्रिया से निकले आउटपुट को लेकर डेटा ट्यूपल्स को एक छोटे सेट में संयोजित कर देता है।
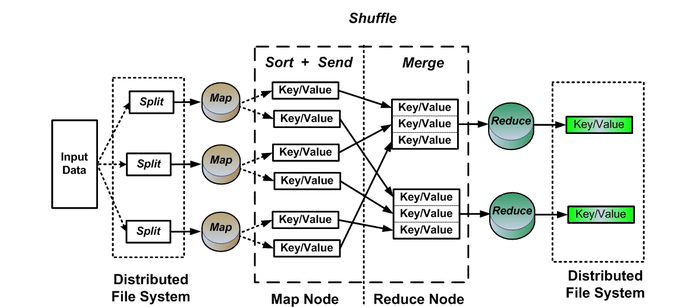
MapReduce एक अत्यधिक समानांतर (पैरेलल) प्रोसेसिंग फ्रेमवर्क है, जिसे बड़े पैमाने के कॉमोडिटी हार्डवेयर पर आसानी से स्केल किया जा सकता है, ताकि भारी मात्रा में डेटा प्रोसेस करने की बढ़ती जरूरतों को पूरा किया जा सके। एक बार मैपिंग और रिडक्शन टास्क सुचारू रूप से चलने लगें, तो बड़े डेटा सेट पर चलाने के लिए केवल कॉन्फिगरेशन बदलना पर्याप्त होता है। इस तरह की अतिविस्तृत स्केलेबिलिटी—एकल नोड से सैकड़ों या हज़ारों नोड्स तक—ही MapReduce को दुनिया भर के बिग डेटा प्रोफेशनल्स की पसंद बनाती है।
MapReduce अनेक सुविधाएं प्रदान करता है, जिनमें शामिल हैं:
- यह बिग डेटा कार्यों के लिए आवश्यक समानांतर प्रोसेसिंग सक्षम करता है।
- यह वाणिज्यिक डेटा प्रोसेसिंग एप्लिकेशनों की एक विस्तृत श्रेणी पर लागू होता है।
- यह केंद्रीकृत प्रोसेसिंग फ्रेमवर्क्स के लिए किफायती समाधान है।
- यह SQL के साथ एकीकृत होकर समानांतर प्रोसेसिंग क्षमताओं को सुगम बनाता है।
Apache Hadoop सहित Cloudera का डिस्ट्रीब्यूशन
Cloudera, Hortonworks और MapR के साथ, Hadoop के ऐतिहासिक प्योअर-प्लेयर में से एक है। Intel द्वारा समर्थित यह समूह CDH विकसित करता है, जो Hadoop का एक डिस्ट्रीब्यूशन है और इसमें Impala तथा Search जैसे कई अन्य ओपन-सोर्स प्रोजेक्ट शामिल हैं। यह सुरक्षा और इंटीग्रेशन सुविधाएं भी प्रदान करता है।
Impala फ्रेमवर्क एक इंटरैक्टिव SQL क्वेरी इंजन है, जो HDFS, Apache HBase या AWS S3 में संग्रहीत डेटा पर सीधे क्वेरी करने देता है। यह इंजन Hive की अन्य तकनीकों और कंपोनेंट्स पर निर्भर करता है, जैसे इसका SQL सिंटैक्स (HiveSQL), Open DataBase Connectivity ड्राइवर, और Query UI।
Search कंपोनेंट Apache Solr प्रोजेक्ट पर आधारित है, जो Lucene पर निर्मित एक डेटा इंडेक्सिंग और सर्च इंजन है। CDH में इस तकनीक के इंटीग्रेशन से, उदाहरण के लिए, (लगभग) रियल-टाइम इंडेक्सिंग क्षमताओं और Hadoop या HBase क्लस्टर में संग्रहीत डेटा तक पहुंच मिलती है। Solr तकनीक व्यापक फुल-टेक्स्ट सर्च की सुविधा देती है, वह भी उन्नत SQL कौशल के बिना। Solr आपको Hadoop डेटा पर क्वेरी करने देता है, बिना उसे पहले स्थानांतरित किए।
Cloudera, CDH की कई एडिशन प्रदान करता है, जिनमें सेवाओं और क्लस्टर प्रबंधन की सुविधाएं अलग-अलग स्तर के सपोर्ट के साथ आती हैं:
- Cloudera Express, CDH का निःशुल्क संस्करण है, जिसमें CDH के तत्व और Cloudera Manager के कोर फंक्शंस शामिल होते हैं। इसके अलावा, यह एंटरप्राइज़ संस्करण के 30-दिन के मूल्यांकन संस्करण तक पहुंच भी देता है।
- Cloudera Manager, CDH का कंट्रोल टावर है। यह टूल CDH डिप्लॉयमेंट्स को डिप्लॉय, मैनेज, मॉनिटर और उनकी सेहत नियंत्रित करने के लिए एक वेब-आधारित एडमिनिस्ट्रेशन कंसोल प्रदान करता है। इसमें एक API भी शामिल है, जिससे सिस्टम को कॉन्फ़िगर किया जा सकता है और CDH क्लस्टर के संचालन से संबंधित मेट्रिक्स और जानकारी प्राप्त की जा सकती है।
- Cloudera Enterprise एक सशुल्क लाइसेंस संस्करण है, और इसलिए विस्तारित सुविधाओं के साथ आता है। इसमें, उदाहरण के लिए, Cloudera Manager और Navigator से निकाले गए एडवांस्ड टूल शामिल हैं।
- Cloudera Manager Advanced Features, Cloudera Express में प्रमुख सुविधाएं जोड़ता है: ऑपरेशनल रिपोर्टिंग, कोटा मैनेजमेंट, कॉन्फ़िगरेशन लॉग्स, सतत अपडेट्स, सर्विस रिस्टार्ट्स, Kerberos इंटीग्रेशन, LDAP इंटीग्रेशन, SNMP सपोर्ट, और स्वचालित आपदा पुनर्प्राप्ति।
- Cloudera Navigator, जो केवल Flex और Data Hub एडिशन के साथ आता है, CDH प्लेटफ़ॉर्म के भीतर डेटा सुरक्षा और गवर्नेंस प्रबंधन सक्षम करता है। यह टूल कंपनियों की अनुपालन बाध्यताओं का समर्थन करता है। इसके साथ, डेटा मैनेजर्स, विश्लेषक और प्रशासक Hadoop में संग्रहीत बड़े डेटा वॉल्यूम्स की खोज कर सकते हैं और CDH क्लस्टर में डेटा को सुरक्षित करने के लिए प्रयोग होने वाली एन्क्रिप्शन चाबियों का प्रबंधन अधिक आसानी से कर सकते हैं।
प्रूफ-ऑफ-कॉन्सेप्ट वातावरण स्थापित करने के लिए, सबसे पहले आपको Cloudera Manager Server इंस्टॉलर डाउनलोड कर चलाना होगा।
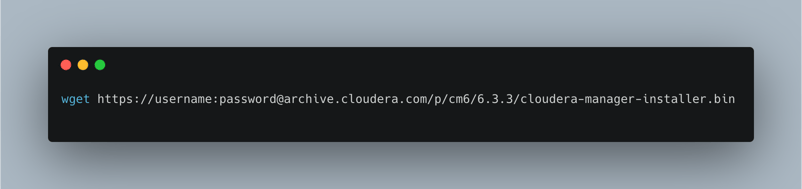
- सबसे पहले, अपने ब्राउज़र में Cloudera Manager Downloads खोलें। Cloudera Manager बॉक्स में, Download Now पर क्लिक करें। आप अपने Cloudera Manager संस्करण के लिए इंस्टॉलर भी डाउनलोड कर सकते हैं। उदाहरण के लिए, Cloudera Manager 6.3.3 के लिए:
- अगला, आपको Cloudera Manager Installer चलाना होगा।
सबसे पहले, Cloudera-manager-installer.bin को निष्पादन अनुमति देने के लिए बदलें: chmod u+x Cloudera-manager-installer.bin
इंस्टॉलर चलाने के लिए, निम्न कमांड का उपयोग करें: sudo ./cloudera-manager-installer.bin --username=username --password=password
- संबंधित लाइसेंस अनुबंध पढ़ें और स्वीकार करें
इसके बाद इंस्टॉलर:
- Cloudera Manager रिपॉजिटरी फाइलें इंस्टॉल करता है।
- Oracle JDK इंस्टॉल करता है।
- Cloudera Manager Server और एम्बेडेड PostgreSQL पैकेज इंस्टॉल करता है।
इंस्टॉलेशन पूरा होने पर Cloudera Manager Admin Console का पूरा URL पोर्ट नंबर सहित प्रदर्शित होता है (डिफॉल्ट रूप से 7180)। पहले, इस URL को नोट कर लें। फिर, OK चुनने और सफल इंस्टॉलेशन की पुष्टि करते हुए इंस्टॉलर से बाहर निकलने के लिए Enter दबाएं।
अगला चरण विज़ार्ड का उपयोग करके CDH इंस्टॉल करना है।
- अपना Cloudera Manager Admin Console खोलें: HTTP://:7180 पर लॉग इन करें, जहाँ वह FQDN या होस्ट का IP पता है जिस पर Cloudera Manager Server चल रहा है।
- Cloudera Manager Admin Console में लॉग इन करें। डिफॉल्ट क्रेडेंशियल्स हैं:
**Username**: admin **Password**: admin
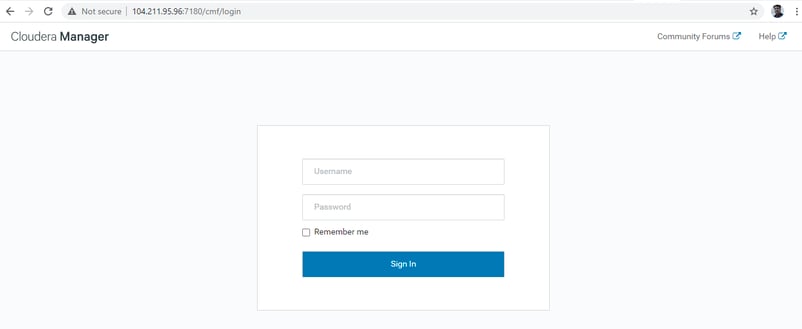
नियम और शर्तें पढ़ें और उन्हें स्वीकार करें: Continue पर क्लिक करें, और इंस्टॉलेशन विज़ार्ड शुरू हो जाएगा।
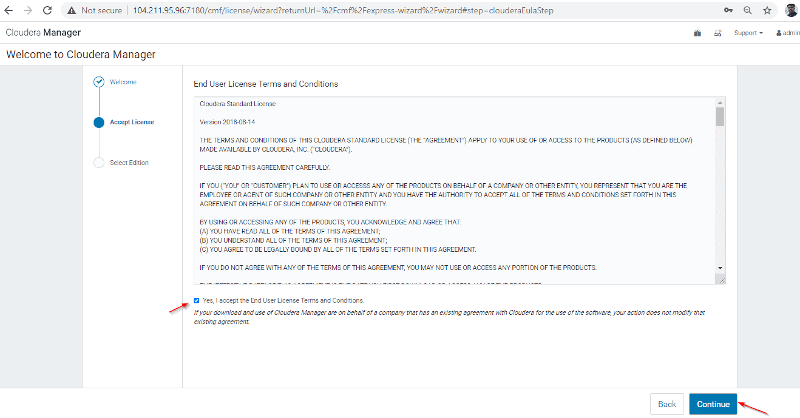
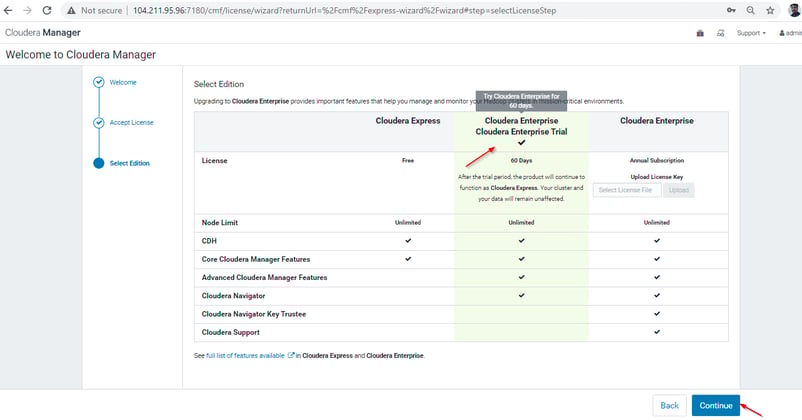
Cloudera Manager का इंस्टॉलेशन विज़ार्ड आपको निम्न चरणों की श्रृंखला से गुज़ारेगा: Select Edition आप इंस्टॉल करने के लिए एडिशन चुन सकते हैं, और वैकल्पिक रूप से आप एक लाइसेंस भी इंस्टॉल कर सकते हैं।
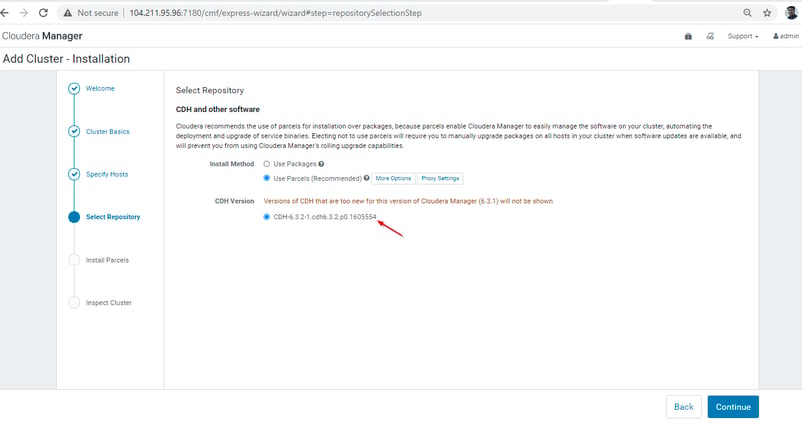
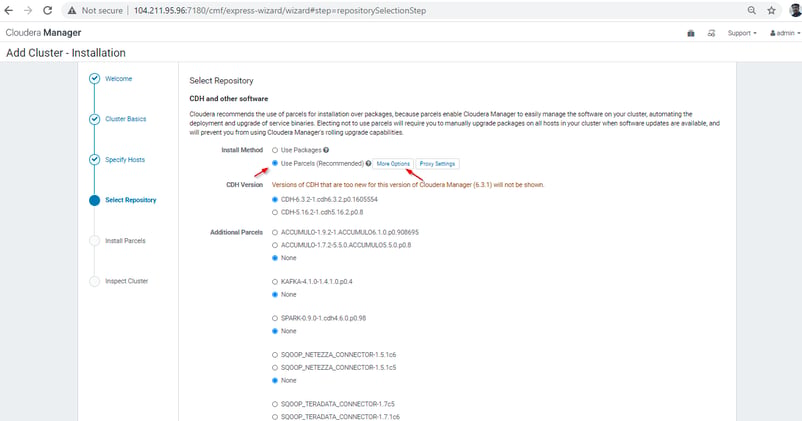
Specify Hosts चुनें कि CDH और अन्य प्रबंधित सेवाएं किन होस्ट्स पर चलेंगी। Select Repository यहाँ आपको यह करना है:
- सबसे पहले, इंस्टॉलेशन के लिए उपयोग होने वाले रिपॉजिटरी प्रकार का चयन करें। इस प्रूफ-ऑफ-कॉन्सेप्ट क्लस्टर के लिए Use Parcels चुनना अनुशंसित है।
- फिर, इंस्टॉल करने के लिए CDH का संस्करण और कोई भी अतिरिक्त Parcels चुनें, जिन्हें आप इंस्टॉल करना चाहते हैं।
- आप वह Cloudera Manager Agent रिलीज़ चुन सकेंगे जिसे आप इंस्टॉल करना चाहते हैं।
- Continue पर क्लिक करें।
Accept JDK License JDK सॉफ़्टवेयर इंस्टॉल करके, आप Oracle Binary Code License Agreement से बंधे होने के लिए सहमत होते हैं। लाइसेंस की शर्तें पढ़ने और लागू बॉक्सों को चेक करने के बाद, Continue पर क्लिक करें।
Enter Login Credentials एक रूट अकाउंट, यूज़रनेम, ऑथेंटिकेशन मेथड, ssh पोर्ट और होस्ट्स की संख्या को परिभाषित करके।
Install Agents Install Agents पेज इंस्टॉलेशन की प्रगति दिखाता है। आप किसी भी होस्ट का विवरण विस्तृत करके इंस्टॉलेशन लॉग देख सकते हैं।
Install Parcels Install Parcels पेज उन पार्सल्स की इंस्टॉलेशन प्रगति दिखाता है जिन्हें आपने पहले चुना था। आप किसी विशिष्ट प्रोग्रेस बार पर क्लिक करके उस होस्ट से संबंधित विवरण देख सकते हैं।
Inspect Hosts Inspect Hosts पेज, सामान्य कॉन्फ़िगरेशन समस्याओं को खोजने के लिए Host Inspector चलाता है। परिणाम देखें और पहचानी गई समस्याओं का समाधान करें। फिर, कोई भी बदलाव करने के बाद परिणाम अपडेट करने के लिए Run Again बटन पर क्लिक करें।
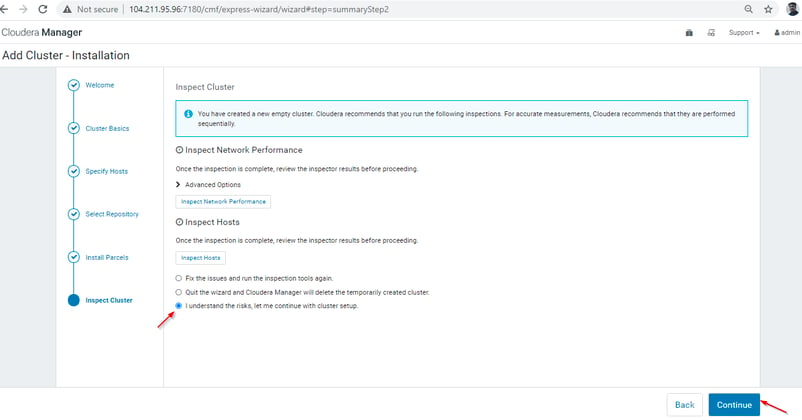
उपरोक्त सभी चरण पूरे करने के बाद, Cluster Setup विज़ार्ड स्वतः शुरू हो जाएगा।
सारांश
Hadoop द्वारा व्यवसायों को मिलने वाले लाभ उल्लेखनीय हैं। इस फ्रेमवर्क की बदौलत, वितरित कंप्यूटिंग के कारण बड़े पैमाने पर डेटा को तेज़ी से संग्रहीत और प्रोसेस करना संभव है। प्रोसेस किए जा रहे डेटा और एप्लिकेशनों को हार्डवेयर विफलता से सुरक्षा मिलती है। यदि कोई नोड विफल हो जाता है, तो जॉब्स सीधे अन्य नोड्स पर रीडायरेक्ट हो जाते हैं ताकि वितरित कंप्यूटिंग बाधित न हो। सभी डेटा की कई प्रतियां स्वतः संग्रहीत होती हैं। आप और अधिक सफलता की कहानियाँ यहाँ पढ़ सकते हैं, और डेटा साइंस से संबंधित अपडेट्स के लिए हमारे ब्लॉग का अनुसरण करें।
Apache Hadoop क्या है?
Hadoop वितरित अनुप्रयोगों और डेटा-गहन प्रबंधन के लिए एक ओपन-सोर्स Java फ़्रेमवर्क है। यह अनुप्रयोगों को हजारों नोड्स और पेटाबाइट्स डेटा के साथ काम करने की अनुमति देता है। Hadoop को Google के MapReduce, GoogleFS और BigTable प्रकाशनों से प्रेरणा मिली।
MapReduce फ़्रेमवर्क की बदौलत यह अत्यधिक बड़े डेटा को संभाल सकता है। डेटा को प्रोसेसिंग के लिए नेटवर्क पर ले जाने के बजाय, MapReduce प्रोसेसिंग सॉफ़्टवेयर को सीधे डेटा के पास ले जाता है।
यह स्वयं में कोई उत्पाद नहीं है, बल्कि वितरित डेटा के स्टोरेज और प्रोसेसिंग के लिए निर्देशों का एक फ़्रेमवर्क है। विभिन्न सॉफ़्टवेयर विक्रेताओं ने Hadoop का उपयोग करके व्यावसायिक बिग डेटा प्रबंधन उत्पाद बनाए हैं।
Hadoop डेटा सिस्टम पैमाने में सीमित नहीं हैं, अर्थात अधिक हार्डवेयर और क्लस्टर जोड़कर भारी लोड को सपोर्ट किया जा सकता है, वह भी बिना पुनः कॉन्फ़िगरेशन या महंगे सॉफ़्टवेयर लाइसेंस खरीदे।
Apache Hadoop का इतिहास और उसकी रुझान
Cloudera की सह-स्थापना 2008 में गणितज्ञ Jeff Hammerbach ने की थी, जो पहले Bear Stearns और Facebook में कार्यरत थे। वे डेटा विश्लेषण और बेहतर विज्ञापन टार्गेटिंग के लिए प्रोग्राम विकसित करने की ज़िम्मेदारी संभालते थे। अन्य सह-संस्थापकों में Christophe Bisciglia, पूर्व Google कर्मचारी; Amr Awadallah, पूर्व Yahoo कर्मचारी जिन्होंने Hadoop पर भी काम किया; और Cloudera के CEO Mike Olson शामिल हैं। मुख्य आर्किटेक्ट Doug Cutting हैं, जो Lucene इंडेक्सिंग इंजन और Hadoop वितरित फ़्रेमवर्क के पीछे रहे हैं।
2018 में Cloudera ने अपने प्रमुख प्रतिद्वंद्वी Hortonworks के साथ विलय किया। इसके बाद कंपनी ने अपने व्यापार का पुनर्मुखीकरण शुरू किया ताकि क्लाउड की दुनिया के लिए खुल सके। 2021 में Cloudera को दो प्राइवेट इक्विटी फंड्स, KKR और Clayton Dubilier & Rice ने 5.3 बिलियन डॉलर में अधिग्रहित किया, जिससे उसे अपने बाज़ार विस्तार को जारी रखने के लिए मजबूत आधार मिला।
Hadoop की शुरुआत 2002 में Doug Cutting और Mike Cafarella से हुई जब दोनों ने Apache Nutch प्रोजेक्ट पर काम शुरू किया। Apache Nutch प्रोजेक्ट ने एक ऐसा सर्च इंजन सिस्टम बनाया जो 1 बिलियन पेजेज को इंडेक्स कर सके। Nutch पर काफी शोध के बाद, उन्होंने निष्कर्ष निकाला कि ऐसे सिस्टम की हार्डवेयर लागत लगभग पाँच लाख डॉलर और मासिक परिचालन लागत लगभग 30,000 डॉलर होगी, जो बहुत महंगी थी। इस प्रकार, उन्होंने महसूस किया कि उनकी प्रोजेक्ट आर्किटेक्चर अरबों वेब पेजों को संभालने में सक्षम नहीं होगी। वे ऐसी समाधान चाहते थे जो क्रियान्वयन लागत और बड़े डेटा सेट्स के भंडारण व प्रोसेसिंग की समस्या को कम कर सके।
2003 में उन्हें Google द्वारा प्रकाशित एक लेख मिला जिसमें Google के वितरित फाइल सिस्टम, GFS (Google File System) की आर्किटेक्चर का वर्णन था, जो विशाल मात्रा के डेटा को स्टोर करने के लिए था। वे समझ गए कि यह पेपर वेब क्रॉलिंग और इंडेक्सिंग प्रक्रियाओं के चलते उत्पन्न होने वाली विशाल फाइलों के भंडारण की उनकी समस्या को हल कर सकता है। लेकिन यह पेपर उनकी समस्या का केवल आधा समाधान था।
2004 में Google ने MapReduce तकनीक पर एक और पेपर प्रकाशित किया, जो इन बड़े डेटा सेट्स को संभालने का समाधान था। यह पेपर Doug Cutting और Mike Cafarella के Nutch प्रोजेक्ट के लिए दूसरा आधा समाधान था। ये तकनीकें (GFS और MapReduce) Google में केवल श्वेतपत्र स्तर पर थीं। Google ने इन दोनों तकनीकों को लागू नहीं किया था। Doug Cutting को Apache Lucene के अनुभव से पता था कि ओपन सोर्स तकनीक को अधिक लोगों तक पहुँचाने का बेहतरीन तरीका है। इसलिए, उन्होंने Mike Cafarella के साथ मिलकर Apache Nutch प्रोजेक्ट में Google की तकनीकों (GFS और MapReduce) को ओपन सोर्स में लागू करना शुरू किया।
2005 में Cutting ने पाया कि Nutch केवल 20-40 नोड क्लस्टर्स तक सीमित है। उन्होंने तुरंत दो समस्याएँ देखीं: (a) Nutch तब तक अपनी क्षमता तक नहीं पहुँचेगा जब तक वह सबसे बड़े क्लस्टर्स पर भरोसेमंद रूप से काम न करे (b) यह केवल दो लोगों (Doug Cutting और Mike Cafarella) के साथ असंभव सा लग रहा था। Nutch प्रोजेक्ट में इंजीनियरिंग कार्य उनकी सोच से कहीं बड़ा था, इसलिए उन्होंने ऐसी कंपनी में नौकरी की तलाश शुरू की जो उनके प्रयासों में निवेश करने को तैयार हो। उन्हें पता चला कि Yahoo! के पास बेहतरीन इंजीनियरों की टीम है जो इस प्रोजेक्ट पर काम करने के लिए उत्सुक थी।
2006 में Doug Cutting Nutch प्रोजेक्ट के साथ Yahoo से जुड़े। वे Yahoo की मदद से दुनिया को एक ओपन-सोर्स, भरोसेमंद और स्केलेबल कंप्यूटिंग फ़्रेमवर्क प्रदान करना चाहते थे। Yahoo में ही Cutting ने Nutch के वितरित कंप्यूटिंग हिस्सों को अलग करके एक नया Hadoop प्रोजेक्ट बनाया। उन्होंने इस प्रोजेक्ट का नाम अपने बेटे के पीले खिलौना हाथी पर रखा; यह एक अनोखा और उच्चारण में आसान शब्द भी था। वे Hadoop को इस तरह बनाना चाहते थे कि वह हजारों नोड्स पर अच्छी तरह काम करे, और इसी उद्देश्य से उन्होंने GFS और MapReduce के साथ Hadoop पर काम शुरू किया।
2007 में Yahoo ने 1,000-नोड क्लस्टर पर Hadoop का सफल परीक्षण किया और इसका उपयोग शुरू किया।
जनवरी 2008 में Yahoo ने Hadoop को ओपन-सोर्स प्रोजेक्ट के रूप में ASF (Apache Software Foundation) को जारी किया। जुलाई 2008 में Apache Software Foundation ने 4000-नोड क्लस्टर पर Hadoop का सफल परीक्षण किया।
2009 तक Hadoop ने सफलतापूर्वक एक पेटाबाइट डेटा को 17 घंटे से कम समय में सॉर्ट करने का परीक्षण किया, ताकि अरबों खोजों को संभाल सके और लाखों वेब पेजों को इंडेक्स कर सके। Doug Cutting ने Yahoo छोड़ा और Cloudera से जुड़ गए ताकि Hadoop को अन्य उद्योगों तक फैलाने की चुनौती ले सकें।