

Het ecosysteem van Apache Hadoop
Hadoop werd de de-factostandaard voor gegevensverwerking, net zoals Excel geleidelijk de standaardsoftware voor data-analyse is geworden. In tegenstelling tot Excel is Hadoop ontworpen door ontwikkelaars in plaats van door "Business Analysts", maar grootschalige adoptie en succes hangen juist meer af van business-analisten dan van ontwikkelaars. Daarom zijn de problemen van Big Data functioneel opgedeeld en is voor elk segment Hadoop-gebaseerde technologie ontwikkeld om de bijbehorende uitdagingen aan te pakken. Al deze tools vormen samen wat het Hadoop-ecosysteem wordt genoemd.
Het Hadoop-ecosysteem verrijkt Hadoop en maakt het in staat een brede waaier aan bedrijfsproblemen op te lossen. Het Hadoop-ecosysteem bestaat inmiddels uit honderden technologieën die we ervoor hebben gekozen te groeperen in 14 categorieën op basis van hun probleemsegment: abstractietalen, SQL op Hadoop (Hive en Pig), rekemodellen (MapReduce en Tez), tools voor realtimeverwerking (Storm en Spark Streaming), databases (HBase en Cassandra), tools voor streaming-ingestie (Kafka en Flume), data-integratietools (Sqoop en Talend), workflowcoördinatietools (Oozie en Control M for Hadoop), tools voor gedistribueerde servicecoördinatie (Zookeeper), clusterbeheertools (Ranger en Sentry), tools voor gebruikersinterfaces (Hue en Jupyter), tools voor contentindexering (ElasticSearch en Splunk), gedistribueerde bestandssystemen (HDFS) en resourcemanagers (YARN en MESOS). In deze sectie bespreken we de functie van elk van de tools die dit ecosysteem van Big Data-technologieën vormen. Wil je daarna dieper gaan, lees dan onze gidsen over de verschillende onderdelen van het Hadoop-ecosysteem die op dit artikel zullen volgen. De volgende mindmap toont het Hadoop-ecosysteem in grote lijnen.
Heuristische kaart van het Hadoop-ecosysteem
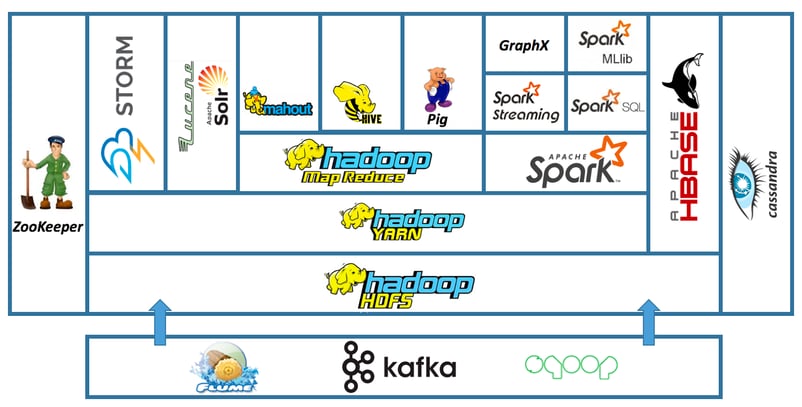
De basisconfiguratie van het Hadoop-ecosysteem bevat de volgende technologieën: Spark, Hive, Pig, HBase, Sqoop, Storm, ZooKeeper, Oozie en Kafka.
Spark
Voordat we uitleggen wat Spark is, moeten we ons herinneren dat een algoritme paralleliseerbaar moet zijn om op een multi-nodecluster in Hadoop te kunnen draaien. Een algoritme wordt dus "schaalbaar" genoemd als het paralleliseerbaar is (en dus kan profiteren van de schaalbaarheid van een cluster). Hadoop is een implementatie van het MapReduce-rekenmodel. Het probleem met MapReduce is dat het is opgebouwd rond een Directed Acyclic Graph-model. Met andere woorden: de MapReduce-bewerking verloopt in drie directe, sequentiële fasen zonder omwegen (Map -> Shuffle -> Reduce); geen enkele fase is iteratief (of cyclisch).
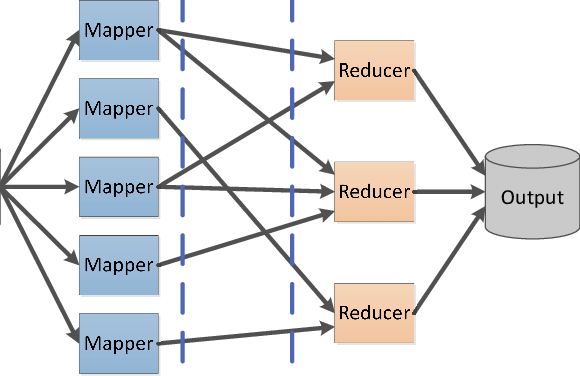
Het acyclische, directe model is ongeschikt voor sommige toepassingen, met name die welke data hergebruiken over meerdere bewerkingen, zoals de meeste statistische leeralgoritmen, die iteratief en interactieve data-analysequeries zijn. Spark biedt een antwoord op deze beperkingen; het is een rekeneindige die gedistribueerde verwerking in het geheugen uitvoert op een cluster. Met andere woorden: het is een gedistribueerde in-memory rekenengine. In vergelijking met MapReduce, dat in batchmodus werkt, draait het rekenmodel van Spark in interactieve modus, dus het verzamelt de data eerst in het geheugen voordat het ze verwerkt en is daardoor zeer geschikt voor Machine Learning-verwerking.
Hive
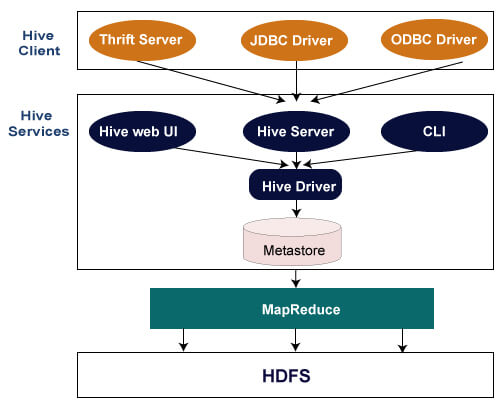
Hive is een rekene-infrastructuur vergelijkbaar met een datawarehouse die query- en aggregatiediensten biedt voor zeer grote hoeveelheden data die zijn opgeslagen op een gedistribueerd bestandssysteem zoals HDFS. Hive biedt een SQL-gebaseerde (ANSI-92-standaard) querytaal, HiveQL (Hive Query Language) genaamd, die queries uitvoert op data die zijn opgeslagen op HDFS. HiveQL stelt gevorderde gebruikers/ontwikkelaars ook in staat Map- en Reduce-functies direct in hun queries te integreren om een breder scala aan datamanagementproblemen te dekken. Wanneer je een query in HiveQL schrijft, wordt die query door Hive omgezet in een MapReduce-job en ter uitvoering ingediend bij de JobTracker.
Pig
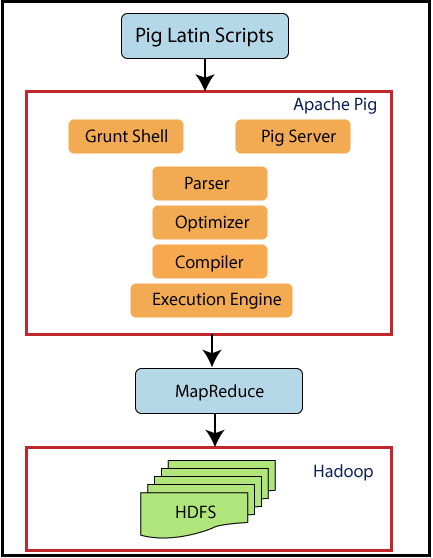
Pig is een interactieve dataflow-uitvoeringsomgeving onder Hadoop. Het bestaat uit 2 elementen: een dataflow-expressietaal genaamd Pig Latin en een interactieve dataflow-uitvoeringsomgeving.
De taal die Pig biedt, Pig Latin, lijkt in grote lijnen op scripttalen zoals Perl, Python of Ruby. Toch is hij specifieker dan die talen en kun je hem het best omschrijven als een "dataflowtaal". Je kunt ermee queries schrijven in sequentiële stromen van brondata om "doel"-data te verkrijgen onder Hadoop, op de manier van een ETL. Deze stromen worden vervolgens omgezet in MapReduce-functies die uiteindelijk worden ingediend bij de jobtracker voor uitvoering. Simpel gezegd: Pig is de ETL van Hadoop. Programmeren in Pig Latin betekent dat je in onafhankelijke maar geneste stromen beschrijft hoe data worden geladen, getransformeerd en geaggregeerd met behulp van specifieke Pig-instructies die operators worden genoemd. Het beheersen van deze operators is de sleutel tot Pig Latin-programmering, temeer daar het er vergeleken met Hive relatief weinig zijn.
HBase
Voordat we HBase bespreken, herinneren we eraan dat de RDBMS-systemen die tot nu toe voor databeheer zijn gebruikt al snel hun beperkingen lieten zien bij grote hoeveelheden data en datavariëteit. RDBMS zijn immers ontworpen om alleen gestructureerde data te beheren (tabellen met rijen/kolommen); bovendien verhoogt een groter datavolume de latentie van verzoeken. Die latentie is nadelig voor veel bedrijven die reacties in near-realtime nodig hebben. Nieuwe DBMS'en, "NoSQL" genoemd, zijn ontwikkeld om deze beperkingen aan te pakken. Ze leggen geen specifieke structuur op aan de data, kunnen opslag en beheer over meerdere nodes verdelen en zijn schaalbaar. Ter herinnering: schaalbaarheid betekent dat de systeemprestaties stabiel blijven naarmate de verwerkingslast toeneemt. HBase behoort tot deze categorie DBMS.
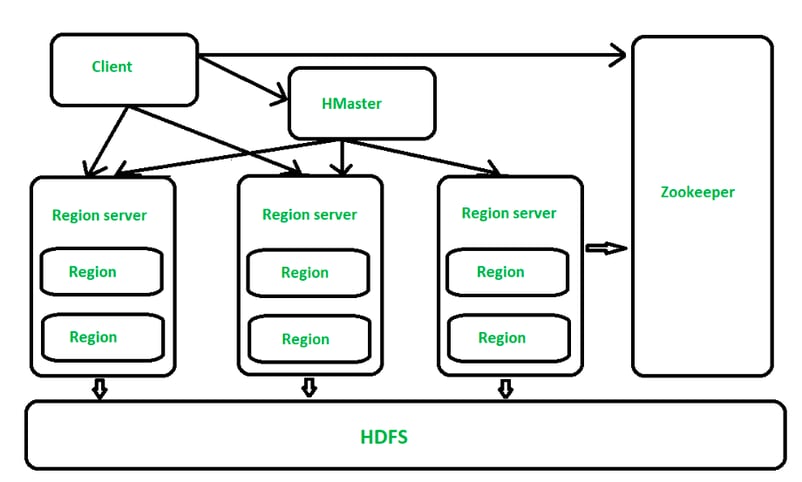
HBase is een gedistribueerd, kolomgeoriënteerd DBMS dat realtime lees- en schrijftoegang biedt tot data die zijn opgeslagen op HDFS. HDFS biedt sequentiële batchtoegang tot data en is niet geschikt voor snelle data-toegangsproblemen zoals streaming; HBase vult die leemte op en biedt snelle toegang tot data die op HDFS zijn opgeslagen.
HBase is gebaseerd op Googles DBMS "BigTable" en kan zeer grote hoeveelheden data opslaan (miljarden rijen/kolommen). Het is afhankelijk van ZooKeeper, een gedistribueerde coördinatieservice voor applicatieontwikkeling.
Sqoop
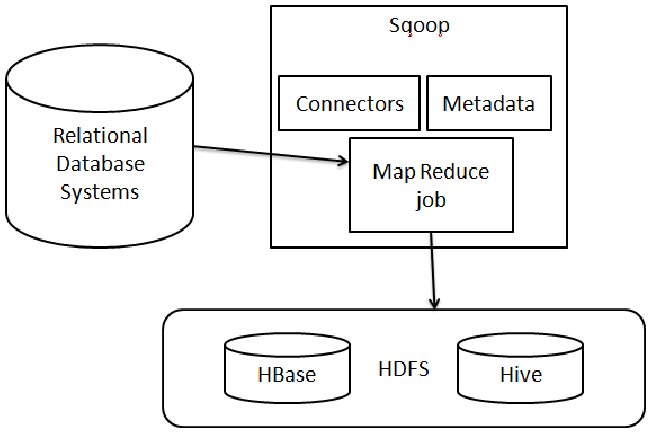
Sqoop of SQL-to-Hadoop is een tool die data overdraagt van een relationele database naar HDFS van Hadoop en omgekeerd. Het is geïntegreerd in het Hadoop-ecosysteem en is de data-ingestiescheduler in Hadoop. Je kunt Sqoop gebruiken om data uit RDBMS'en zoals MySQL, Oracle of SQL Server naar HDFS te importeren, de data in Hadoop te transformeren via MapReduce of een ander rekenmodel, en ze weer te exporteren naar de RDBMS. We noemen het een data-ingestiescheduler omdat het, net als Oozie, dit import-/exportproces automatiseert en het uitvoeringstijdstip inplant. Het enige wat je als gebruiker hoeft te doen, is de SQL-queries schrijven die worden gebruikt om de import-/exportbeweging uit te voeren. Bovendien gebruikt Sqoop MapReduce om data te importeren en exporteren, wat efficiënt en fouttolerant is.
Storm
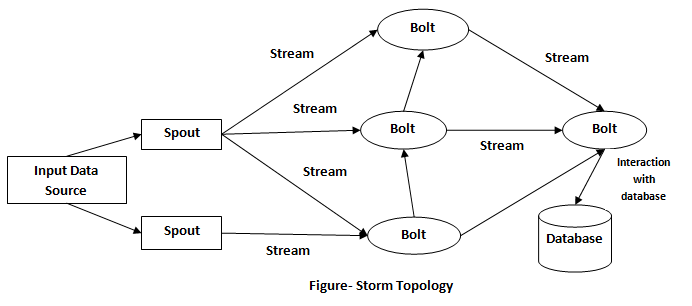
Om Storm te begrijpen, moet je het concept van lambda-architecturen (λ) en het nut ervan begrijpen. Je moet ook het concept van verbonden objecten begrijpen. Verbonden objecten, of Internet of Things (IoT), vormen de uitbreiding van het internet naar ons dagelijks leven. Het genereert streamingdata en vereist dat de data in de meeste gevallen realtime worden verwerkt. De modellen die je kent, zoals batchmodellen, zijn niet aangepast aan de realtimevraagstukken die door IoT worden opgeworpen. Zelfs interactieve rekenmodellen zijn niet geschikt om continu in realtime te verwerken. In tegenstelling tot operationele data die worden geproduceerd door de operationele systemen van een bedrijf, zoals financiën of marketing, en die zelfs wanneer ze in streaming worden geproduceerd, kunnen worden gehistoriseerd voor latere verwerking, verouderen data die in streaming worden geproduceerd in het kader van fenomenen zoals IoT of het internet (of zijn ze niet langer geldig) in de momenten na hun creatie en vereisen daarom onmiddellijke verwerking. Afgezien van verbonden objecten vragen bedrijfsproblemen zoals fraudebestrijding, analyse van sociale netwerken en geolocatie om zeer lage responstijden, vaak minder dan een seconde. Om dit probleem in een Big Data-context op te lossen, zijn zogenaamde λ-architecturen ontwikkeld. Deze architecturen voegen twee extra verwerkingslagen toe aan MapReduce om de latentie te verlagen. Storm is een software-implementatie van de λ-architectuur. Het maakt toepassingen onder Hadoop mogelijk die data in (near) realtime verwerken.
ZooKeeper
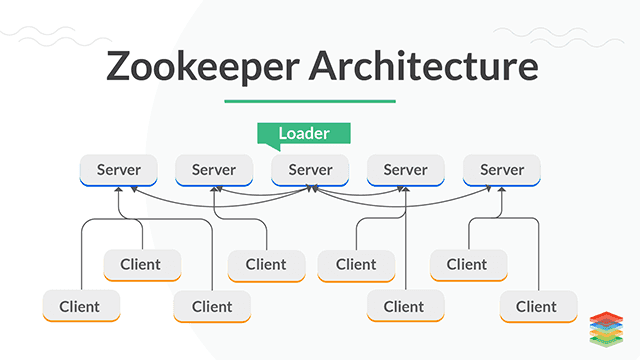
Het synchroniseren of coördineren van communicatie tussen nodes bij het uitvoeren van parallelle taken is een van de moeilijkste problemen in de ontwikkeling van gedistribueerde applicaties. Om dit op te lossen heeft Hadoop servicecoördinatietools in zijn ecosysteem geïntroduceerd, in dit geval ZooKeeper. ZooKeeper neemt de inherente complexiteit weg van het synchroniseren van de uitvoering van gedistribueerde jobs in het cluster, zodat andere tools in het Hadoop-ecosysteem dit probleem niet zelf hoeven op te lossen. Het stelt gebruikers ook in staat gedistribueerde applicaties te ontwikkelen zonder experts te zijn in gedistribueerd programmeren. Zonder in te gaan op de complexe details van datacoördinatie tussen nodes in een Hadoop-cluster: ZooKeeper biedt een gedistribueerde configuratieservice, een distributieservice en een namenregister voor gedistribueerde applicaties. ZooKeeper is de manier waarop Hadoop gedistribueerde jobs coördineert.
Oozie
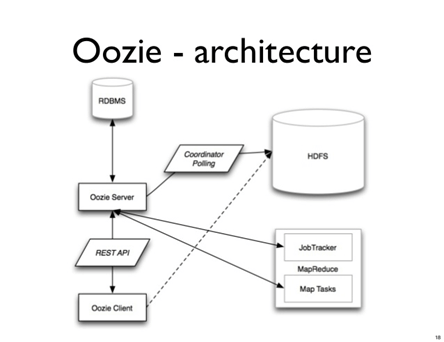
Standaard voert Hadoop jobs uit zoals de gebruiker ze indient, zonder rekening te houden met eventuele onderlinge relaties. De problemen waarvoor Hadoop wordt ingezet, vereisen echter doorgaans het schrijven van één of meer complexe jobs. Wanneer twee jobs bij de JobTracker (of bij YARN) worden ingediend, zal die ze uitvoeren zonder acht te slaan op de onderlinge koppeling, wat een fout (exception) kan veroorzaken en ertoe kan leiden dat de code stopt. Hoe beheren we de uitvoering van meerdere jobs die betrekking hebben op hetzelfde probleem? Voor dit type probleem is de eenvoudigste oplossing momenteel een jobscheduler te gebruiken, in dit geval Oozie.
Oozie is een jobscheduler die als service draait op een Hadoop-cluster. Het wordt gebruikt voor het inplannen van Hadoop-jobs en meer in het algemeen voor het plannen van alle jobs die op een cluster kunnen draaien, zoals een Hive-script, MapReduce-job, Hama-job, Storm-job, enz. Het is ontworpen om de directe of uitgestelde uitvoering van duizenden onderling afhankelijke jobs op een Hadoop-cluster automatisch te beheren. Om Oozie te gebruiken, hoef je slechts 2 XML-bestanden te configureren: een configuratiebestand voor de Oozie-engine en een configuratiebestand voor de jobworkflow.
Kennismaken met Cloudera
Cloudera is een Amerikaans bedrijf uit Californië dat zich toelegt op de ontwikkeling van een Big Data-oplossing die historisch is gebaseerd op het gedistribueerde Hadoop-framework; het heroriënteert zich momenteel richting de cloud. Al meer dan een jaar breidt Cloudera zijn oplossing uit naar de publieke clouds AWS, Azure en GCP.
Kennismaken met CDP
De Cloudera Data Platform CDP is een platform waarmee bedrijven data kunnen analyseren met selfservice-analytics in hybride en multicloudomgevingen. Het stelt organisaties in staat meer waarde uit al hun data te halen door binnen enkele uren datalakes in de cloud te creëren.
CDP biedt geïntegreerde, multifunctionele, selfservicetools om data te analyseren en te centraliseren. Daarnaast biedt het security en governance op ondernemingsniveau en kan het worden uitgerold in publieke, private en multicloudomgevingen. CDP is de opvolgende distributie van Cloudera's twee eerdere Hadoop-distributies: Cloudera Distribution of Hadoop (CDH) en Hortonworks Data Platform (HDP).
Selfservice-toegang tot bedrijfsdata staat centraal in deze dienst. De nieuw toegevoegde clouddiensten die in het platform zijn geïntegreerd, bieden ook selfservice-toegang tot data en analytics voor analisten, data scientists, IT-professionals en ontwikkelaars. De sleutelwoorden die het platform onderscheiden van de concurrentie zijn de drie cloud-native CDP-diensten die Cloudera presenteert: selfservice, multicloud en security.
CDP biedt een unieke publiek-private aanpak, realtime data-analyse, schaalbare on-premises-, cloud- en hybride implementatieopties en een privacy-first-architectuur.
CDP Public Cloud
CDP Public Cloud is een Platform-as-a-Service (PaaS) die compatibel is met cloudinfrastructuur en gemakkelijk overdraagbaar tussen verschillende cloudproviders, inclusief private oplossingen zoals OpenShift. CDP is ontworpen om volledig hybride en multicloud te zijn, wat betekent dat één platform alle use-cases in de datalevenscyclus kan beheren. Het CDP-platform kan met data werken binnen veel omgevingen, waaronder publieke clouds zoals AWS, Azure en GCP. Bovendien kan het workloads en resources automatisch op- of afschalen om de prestaties te verbeteren en kosten te verlagen.
CDP Public Cloud-diensten
Dit zijn de belangrijkste componenten waaruit CDP Public Cloud bestaat:
-
CDP Data Engineering is een alles-in-één setup. Het is gebouwd op Apache Spark. Het stroomlijnt ETL-processen voor enterprise-data-analyticateams door orkestratie en automatisering met Apache Airflow mogelijk te maken en biedt zeer geavanceerde pijplijnmonitoring, visueel debuggen en beheertools. Daarnaast heeft het geïsoleerde werkomgevingen en is het gecontaineriseerd, schaalbaar en eenvoudig te verplaatsen.
-
CDP Data Hub is een dienst die analytics met hoge waarde mogelijk maakt van Edge tot AI. De Cloudera Data Hub is een cloud-native data- en analyticaservice. Het stelt IT- en businessontwikkelaars in staat om sneller bedrijfsapplicaties te bouwen voor elk scenario, van streaming tot ETL. Datamarts, databases en Machine Learning zijn slechts enkele van de diensten binnen het brede spectrum aan analytische workloads.
-
CDP Data Warehouse is een dienst waarmee IT een cloud-native selfservice-analyticservaring kan bieden voor BI-analisten. Streaming, data engineering en analytics zijn volledig geïntegreerd in CDP Data Warehouse. Bovendien heeft het een uniform raamwerk om al je data en metadata te beveiligen en te beheren over private, meerdere publieke of hybride clouds. De Cloudera Data Warehouse-dienst maakt het eenvoudig om selfservice-datawarehouses voor data-analisten te implementeren. Het is gebaseerd op robuuste, enterpriseteste SQL-engines. Honderden gebruikers kunnen met één klik toegang krijgen tot data, zowel on-premises als in de cloud. Resources kunnen on-demand worden opgeschaald indien nodig, en workloadbeheer is eveneens selfservice met intuïtieve tools.
-
CDP Machine Learning maakt het eenvoudig om collaboratieve Machine Learning-werkruimten te implementeren zodat data scientists gebruik kunnen maken van enterprisedata. Het optimaliseert ML-workflows met native en uitgebreide tools om modellen te deployen, te distribueren en te monitoren. Met deze tool kunnen organisaties snel nieuwe Machine Learning-werkruimten implementeren met een paar klikken om selfservice-toegang te bieden tot de tools en data die nodig zijn voor ML-workflows. Bovendien kan datareplicatie on-premises of in de cloud snel worden uitgevoerd zonder in te boeten aan security en governance. Data scientists kunnen ook hun eigen tools kiezen, terwijl ze profiteren van elastische resources die op hun behoeften kunnen worden afgestemd. Modeltraining, data engineering, uitrol en modelbeheer verlopen snel via een alles-in-één interface, waardoor wisselen tussen platforms overbodig wordt.
-
Cloudera Data Visualization stelt gebruikers in staat om data te modelleren in het virtuele datawarehouse zonder onderliggende datastructuren of tabellen te verwijderen of te updaten, en om grote hoeveelheden data te bevragen zonder voortdurend data te laden, wat tijd en geld bespaart.
-
Cloudera Operational Database is een beheerde oplossing die de onderliggende clusterinstantie samenbrengt tot een database. Deze schaalt automatisch op basis van het gebruik van de clusterworkload, verbetert de prestaties binnen dezelfde infrastructuurfootprint en lost operationele issues automatisch op.
CDP Private Cloud
CDP Private Cloud is beter geschikt voor hybride cloudimplementaties, waarmee on-premises kunnen worden gekoppeld aan publieke clouds, terwijl consistente, geïntegreerde security en governance behouden blijven. Verwerking en opslag zijn ontkoppeld in CDP Private Cloud, waardoor beide clusters onafhankelijk kunnen schalen. Beschikbaar op een CDP Private Cloud Base-cluster biedt Cloudera Shared Data Experience (SDX) uniforme security, governance en metadatabeheer. Daarnaast kunnen CDP Private Cloud-gebruikers met Management Console snel Cloudera Data Warehousing- en Cloudera Machine Learning-diensten inrichten en implementeren en ze naar behoefte schalen.
CDP Private Cloud-diensten
Sommige componenten van CDP Public Cloud, zoals Machine Learning en Data Warehouse, zijn beschikbaar op CDP Private Cloud. Het gebruikt een verzameling analytische engines die streaming, data engineering, datamarts, operationele databases en data science dekken om traditionele workloads te ondersteunen.
Essentials van HDFS en MapReduce
HDFS is Hadoop's Distributed File System en het centrale element van Hadoop, waarmee data op meerdere servers kunnen worden opgeslagen en gerepliceerd. In combinatie met YARN vergroot het de databeheercapaciteiten van het HDFS-Hadoop-cluster en maakt het efficiënte Big Data-verwerking mogelijk.
Je kunt HDFS draaien op commodity-hardware, wat het zeer fouttolerant maakt. Elk datapakket wordt op meerdere plaatsen opgeslagen en kan onder alle omstandigheden worden hersteld. Deze replicatie helpt ook om potentiële datacorruptie te bestrijden.
HDFS gebruikt een NameNode en een DataNode. De DataNode is een standaardserver waarop data worden opgeslagen. De NameNode bevat metadata (data die op de verschillende nodes zijn opgeslagen). De applicatie communiceert alleen met de NameNode, en de NameNode communiceert met de datanodes wanneer dat nodig is.
HDFS voorkomt ook netwerkcongestie door te focussen op het verplaatsen van bewerkingen in plaats van het verplaatsen van data. Dit betekent dat applicaties toegang kunnen krijgen tot de data waar deze zijn opgeslagen. Een laatste kracht is de portabiliteit. Het kan draaien op verschillende soorten hardware zonder compatibiliteitsproblemen.
Wat is MapReduce, en hoe werkt het?
MapReduce is de verwerkingsengine van Apache Hadoop, rechtstreeks afgeleid van Googles MapReduce. De MapReduce-applicatie is in essentie geschreven in Java. Het stelt je in staat om enorme hoeveelheden data eenvoudig te verwerken door mapping- en reductiestappen toe te passen om een oplossing te vinden voor het voorliggende probleem. De mappingstap neemt een dataset en zet die om in een andere dataset door de individuele elementen op te splitsen in sleutel-/waardekoppels, zogenaamde tuples. De tweede reductiestap neemt de output van het mappingproces en combineert de datatuples tot een kleinere set tuples.
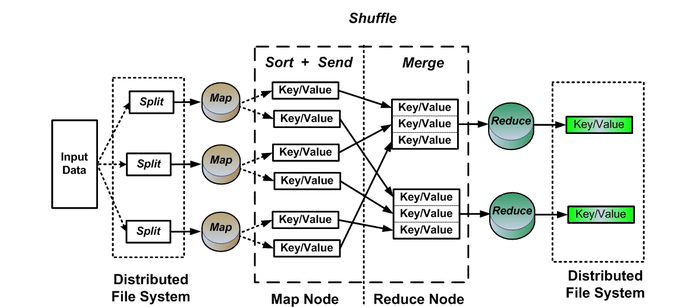
MapReduce is een sterk parallel verwerkingsframework dat eenvoudig kan worden opgeschaald op enorme hoeveelheden commodity-hardware om te voldoen aan de groeiende behoefte aan het verwerken van grote hoeveelheden data. Zodra de mapping- en reductietaken soepel draaien, is slechts een configuratiewijziging nodig om op een grotere dataset te draaien. Dit soort extreme schaalbaarheid, van één node naar honderden of zelfs duizenden nodes, maakt MapReduce een favoriet van Big Data-professionals over de hele wereld.
MapReduce biedt een breed scala aan mogelijkheden, waaronder:
- Het maakt parallelle verwerking mogelijk die nodig is voor Big Data-taken.
- Het is toepasbaar op een grote verscheidenheid aan commerciële dataverwerkingstoepassingen
- Het is een kosteneffectieve oplossing voor gecentraliseerde verwerkingsframeworks
- Het kan worden geïntegreerd met SQL om parallelle verwerkingsmogelijkheden te faciliteren.
Cloudera's distributie inclusief Apache Hadoop
Cloudera is een van de historische pure players van Hadoop, naast Hortonworks en MapR. De door Intel gesteunde groep ontwikkelt CDH, een distributie van Hadoop die verschillende andere open-sourceprojecten omvat, zoals Impala en Search. Het biedt ook security- en integratiefuncties.
Het Impala-framework is een interactieve SQL-queryengine die directe queries van data in HDFS, Apache HBase of AWS S3 mogelijk maakt. Deze engine steunt op andere technologieën en componenten van Hive, zoals de SQL-syntaxis (HiveSQL), de Open DataBase Connectivity-driver en Query UI.
De Search-component is gebaseerd op het Apache Solr-project, een data-indexerings- en zoekmachine gebouwd op Lucene. De integratie van deze technologie in CDH geeft bijvoorbeeld toegang tot indexeringsmogelijkheden in (bijna) realtime en toegang tot data die zijn opgeslagen in een Hadoop- of HBase-cluster. Met Solr-technologie kun je complexe fulltext-zoekopdrachten uitvoeren zonder uitgebreide SQL-vaardigheden. Solr stelt je in staat Hadoop-data te bevragen, zonder die eerst te hoeven verplaatsen.
Cloudera biedt verschillende edities van CDH, elk met verschillende service- en clusterbeheerfuncties en variërende niveaus van support:
- Cloudera Express is de gratis versie van CDH, die de elementen van CDH en de kernfuncties van Cloudera Manager bevat. Daarnaast krijg je toegang tot een evaluatieversie van 30 dagen van de Enterprise-versie.
- Cloudera Manager is de controletoren van CDH. De tool biedt een webgebaseerde beheerconsole om CDH-implementaties te deployen, beheren, monitoren en de gezondheid ervan te bewaken. Het omvat ook een API om het systeem te configureren en metrics en informatie op te halen over de werking van een CDH-cluster.
- Cloudera Enterprise is een betaalde licentieversie, dus met uitgebreide functies. Het omvat bijvoorbeeld geavanceerde tools uit Cloudera Manager en Navigator.
- Cloudera Manager Advanced Features voegt kernfuncties toe aan Cloudera Express: operationele rapportage, quotabeheer, configuratielogs, continue updates, herstarten van services, Kerberos-integratie, LDAP-integratie, SNMP-ondersteuning en automatische disaster recovery.
- Cloudera Navigator, dat alleen wordt meegeleverd met de Flex- en Data Hub-edities, biedt beheer van databeveiliging en governance binnen een CDH-platform. De tool ondersteunt de compliance-eisen van bedrijven. Hiermee kunnen databeheerders, analisten en beheerders grote hoeveelheden data die in Hadoop zijn opgeslagen verkennen en eenvoudiger de encryptiesleutels beheren die worden gebruikt om de data in een CDH-cluster te beveiligen.
Om een proof-of-conceptomgeving op te zetten, moet je eerst de Cloudera Manager Server-installer downloaden en uitvoeren.
- Open eerst Cloudera Manager Downloads in je browser. Klik in het vak Cloudera Manager op Download Now. Je kunt ook de installer downloaden voor jouw versie van Cloudera Manager. Bijvoorbeeld voor Cloudera Manager 6.3.3:
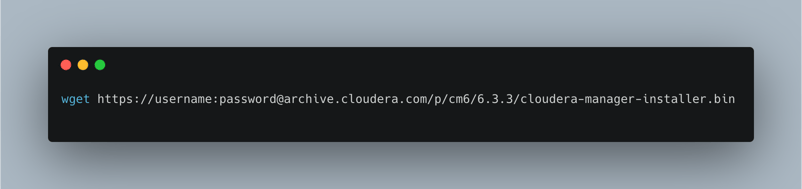
- Vervolgens moet je de Cloudera Manager Installer uitvoeren.
Maak eerst Cloudera-manager-installer.bin uitvoerbaar: chmod u+x Cloudera-manager-installer.bin
Gebruik de volgende opdracht om de installer uit te voeren: sudo ./cloudera-manager-installer.bin --username=username --password=password
- Lees en accepteer de bijbehorende licentieovereenkomsten
De installer:
- Installeert de repositorybestanden van Cloudera Manager.
- Installeert de Oracle JDK.
- Installeert de Cloudera Manager Server en embedded PostgreSQL-pakketten.
De volledige URL voor de Cloudera Manager Admin Console wordt weergegeven zodra de installatie is voltooid, inclusief het poortnummer (standaard 7180). Noteer eerst deze URL. Druk vervolgens op Enter om OK te kiezen, de installer af te sluiten en de geslaagde installatie te bevestigen.
De volgende stap is CDH installeren met de Wizard.
- Ga naar je Cloudera Manager Admin Console door in te loggen op: HTTP://:7180, waarbij het FQDN of het IP-adres is van de host waarop Cloudera Manager Server draait.
- Log in op Cloudera Manager Admin Console. De standaardgegevens zijn:
**Username**: admin **Password**: admin
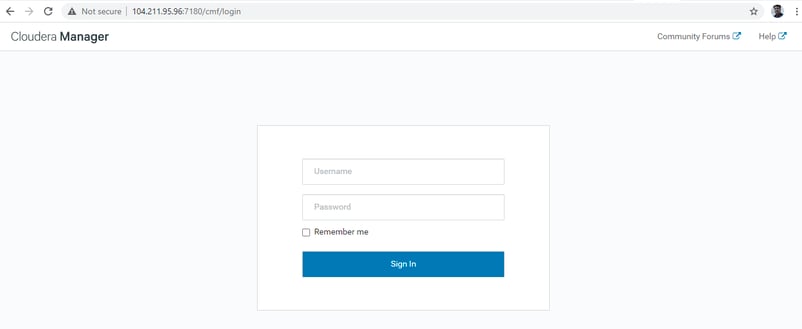
Lees de voorwaarden en accepteer ze: klik op Continue en de installatiewizard wordt gestart.
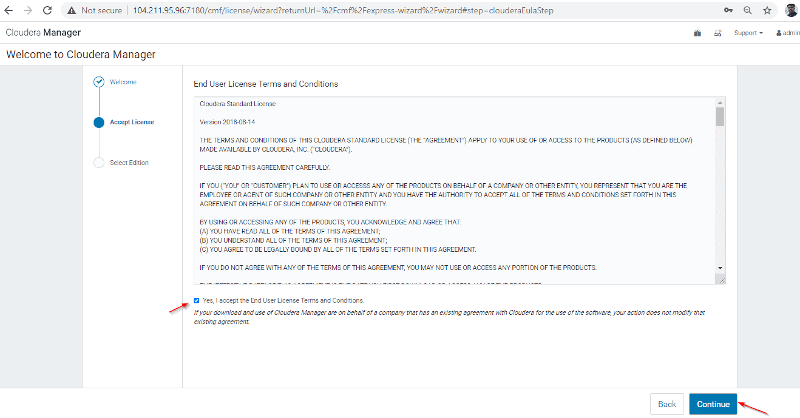
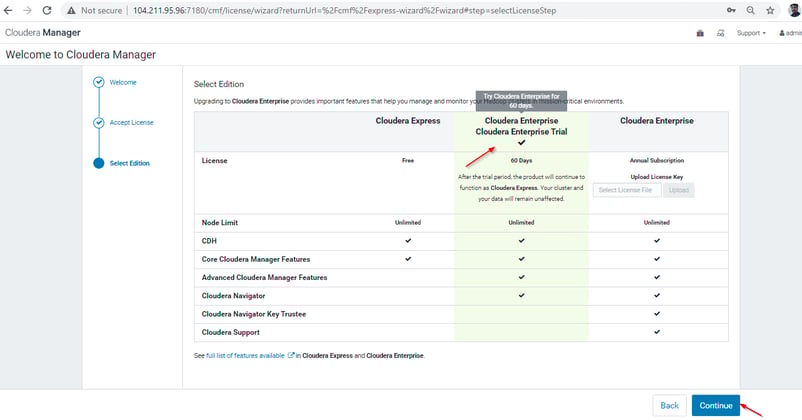
De installatiewizard voor Cloudera Manager leidt je door een reeks stappen als volgt: Select Edition Je kunt de editie selecteren om te installeren en optioneel kun je ook een licentie installeren.
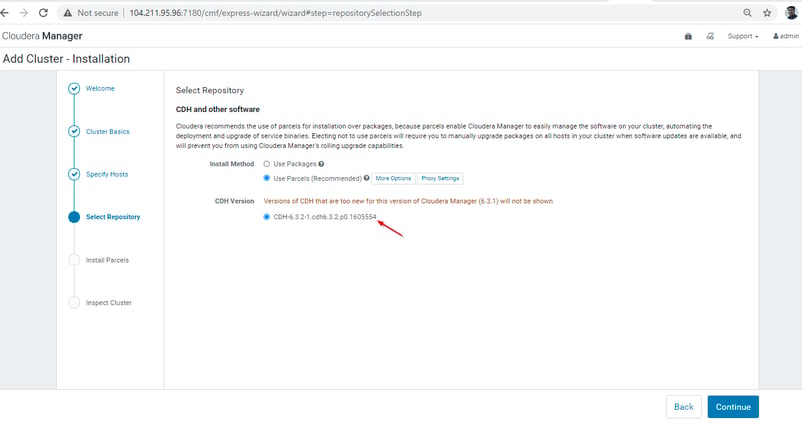
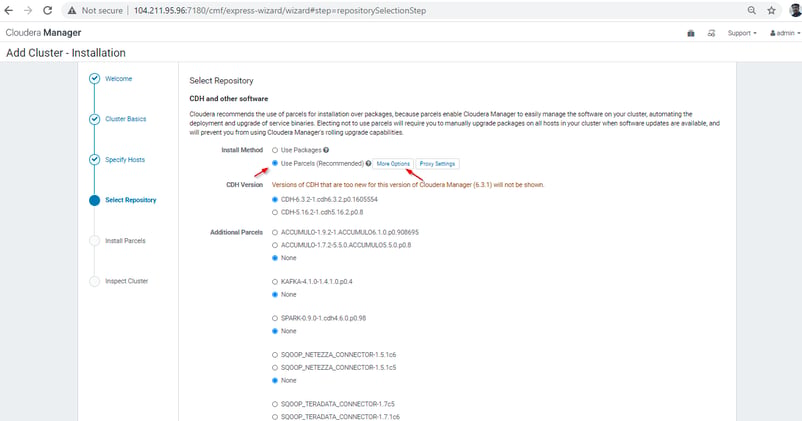
Specify Hosts Kies welke hosts worden gebruikt om CDH en andere beheerde services te draaien. Select Repository Hier moet je:
- Kies eerst het repositorytype voor de installatie. Voor dit proof-of-conceptcluster wordt aanbevolen Use Parcels te kiezen.
- Selecteer vervolgens de versie van CDH die je wilt installeren en eventuele extra Parcels die je wilt installeren.
- Je kunt de release van de Cloudera Manager Agent kiezen die je wilt installeren.
- Klik op Continue.
Accept JDK License Door de JDK-software te installeren, ga je akkoord met de Oracle Binary Code License Agreement. Nadat je de licentievoorwaarden hebt gelezen en de toepasselijke vakjes hebt aangevinkt, klik je op Continue.
Enter Login Credentials Door een rootaccount, gebruikersnaam, authenticatiemethode, ssh-poort en het aantal hosts te definiëren.
Install Agents De pagina Install Agents toont de voortgang van de installatie. Je kunt de details voor een host uitklappen om het installatielogboek te bekijken.
Install Parcels De pagina Install Parcels toont de installatievoortgang van de parcels die je eerder hebt geselecteerd. Je kunt op een specifieke voortgangsbalk klikken voor details over die host.
Inspect Hosts De pagina Inspect Hosts voert de Host Inspector uit om te zoeken naar veelvoorkomende configuratieproblemen. Bekijk de resultaten en los eventuele gedetecteerde problemen op. Klik daarna op de knop Run Again om de resultaten bij te werken nadat je wijzigingen hebt aangebracht.
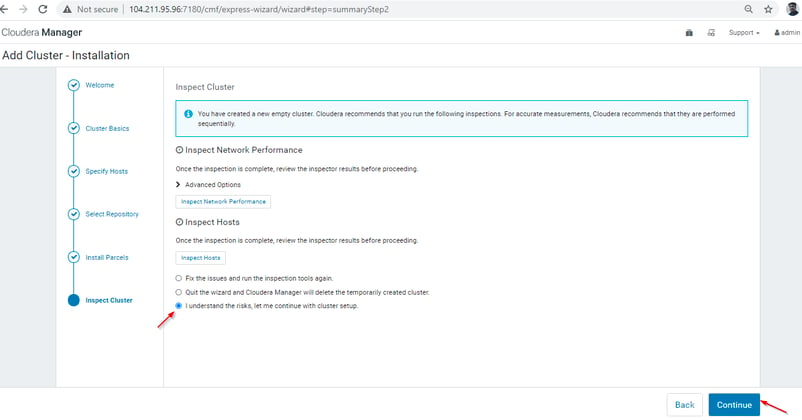
Na het voltooien van alle bovenstaande stappen wordt de Cluster Setup-wizard automatisch gestart.
Samenvatting
De voordelen die Hadoop bedrijven biedt, zijn aanzienlijk. Dankzij dit framework is het mogelijk om grote hoeveelheden data snel op te slaan en te verwerken dankzij de gedistribueerde verwerking. De data en applicaties die worden verwerkt, zijn beschermd tegen hardwarestoringen. Als een node uitvalt, worden jobs direct doorgestuurd naar andere nodes om te waarborgen dat de gedistribueerde verwerking niet faalt. Van alle data worden automatisch meerdere kopieën opgeslagen. Je kunt hier meer lezen over de succesverhalen hier, en volg onze blog voor meer updates over data science.


Wat is Apache Hadoop?
Hadoop is een open-source Java-framework voor gedistribueerde applicaties en data-intensief beheer. Het stelt applicaties in staat te werken met duizenden nodes en petabytes aan data. Hadoop is geïnspireerd door de publicaties over Google's MapReduce, GoogleFS en BigTable.
Dankzij het MapReduce-framework kan het enorme hoeveelheden data verwerken. In plaats van de data over een netwerk te verplaatsen om de verwerking te doen, laat MapReduce de verwerkingssoftware zich direct naar de data verplaatsen.
Het is op zichzelf geen product, maar een framework met instructies voor opslag en verwerking van gedistribueerde data. Diverse softwareleveranciers hebben Hadoop gebruikt om commerciële Big Data-beheerproducten te creëren.
Hadoop-datasystemen zijn niet beperkt in schaal, wat betekent dat je meer hardware en clusters kunt toevoegen om een grotere belasting te ondersteunen zonder herconfiguratie of de aanschaf van dure softwarelicenties.
Geschiedenis van Apache Hadoop en de trends
Cloudera werd in 2008 mede opgericht door wiskundige Jeff Hammerbach, voormalig medewerker van Bear Stearns en Facebook. Hij was verantwoordelijk voor data-analyse en het ontwikkelen van programma's voor betere advertentietargeting. De andere medeoprichters zijn Christophe Bisciglia, ex-Google-medewerker, Amr Awadallah, ex-Yahoo-medewerker die ook aan Hadoop werkte, en Mike Olson, CEO van Cloudera. De hoofdarchitect is Doug Cutting, de man achter de Lucene-indexeringsengine en het gedistribueerde Hadoop-framework.
In 2018 fuseerde Cloudera met zijn grootste concurrent: Hortonworks. Het bedrijf begon vervolgens aan een heroriëntatie om zich te openen naar de wereld van de cloud. In 2021 werd Cloudera gekocht door twee private-equityfondsen, KKR en Clayton Dubilier & Rice, voor 5,3 miljard dollar, wat het een solide basis gaf om zijn marktuitbreiding voort te zetten.
Hadoop begon bij Doug Cutting en Mike Cafarella in 2002, toen zij samen aan het Apache Nutch-project begonnen te werken. Het Apache Nutch-project creëerde een zoekmachinesysteem dat 1 miljard pagina's kon indexeren. Na veel onderzoek naar Nutch concludeerden ze dat zo'n systeem ongeveer een half miljoen dollar aan hardware zou kosten en een maandelijkse operationele kost van ongeveer 30.000 dollar, wat erg duur is. Ze realiseerden zich dat de architectuur van hun project niet in staat zou zijn de miljarden webpagina's te omzeilen. Ze wilden een oplossing die de implementatiekosten en het probleem van opslag en verwerking van grote datasets kon verlagen.
In 2003 stuitten ze op een artikel dat de architectuur van Google's gedistribueerde bestandssysteem beschreef, GFS (Google File System) genaamd, gepubliceerd door Google, voor het opslaan van enorme hoeveelheden data. Ze wisten dat dit paper hun probleem van het opslaan van grote bestanden, gegenereerd door webcrawling- en indexeringsprocessen, kon oplossen. Maar dit paper bood slechts een halve oplossing voor hun probleem.
In 2004 publiceerde Google een ander paper over de MapReduce-techniek, wat de oplossing was om deze grote datasets te verwerken. Dit paper was een andere halve oplossing voor Doug Cutting en Mike Cafarella voor hun Nutch-project. Deze technieken (GFS en MapReduce) bestonden bij Google alleen op papier. Google had deze twee technieken niet geïmplementeerd. Doug Cutting wist uit ervaring met Apache Lucene dat open source een geweldige manier is om technologie naar meer mensen te verspreiden. Dus begon hij, samen met Mike Cafarella, met het implementeren van Googles technieken (GFS & MapReduce) in open source in het Apache Nutch-project.
In 2005 ontdekte Cutting dat Nutch beperkt was tot clusters van slechts 20-40 nodes. Hij realiseerde zich snel twee problemen: (a) Nutch zou zijn potentieel niet bereiken zolang het niet betrouwbaar werkte op de grootste clusters (b) het leek onmogelijk met slechts twee mensen (Doug Cutting & Mike Cafarella). De engineeringtaak in het Nutch-project was veel groter dan hij dacht, dus begon hij te zoeken naar een baan bij een bedrijf dat in hun inspanningen wilde investeren. Hij ontdekte dat Yahoo! een geweldig team van ingenieurs had dat graag aan dit project wilde werken.
In 2006 sloot Doug Cutting zich met het Nutch-project aan bij Yahoo. Met hulp van Yahoo wilde hij de wereld een open-source, betrouwbaar en schaalbaar rekenframework bieden. Bij Yahoo scheidde Cutting de gedistribueerde rekenonderdelen van Nutch af en vormde een nieuw Hadoop-project. Hij noemde het project Hadoop naar de gele speelgoedolifant van zijn zoon; het was ook een uniek woord dat gemakkelijk uit te spreken was. Hij wilde Hadoop zo ontwikkelen dat het goed zou werken op duizenden nodes, en begon daarom te werken aan Hadoop met GFS en MapReduce.
In 2007 testte Yahoo Hadoop met succes op een cluster van 1.000 nodes en begon het te gebruiken.
In januari 2008 bracht Yahoo Hadoop als open-sourceproject uit bij de ASF (Apache Software Foundation). In juli 2008 testte de Apache Software Foundation met succes een cluster met 4000 nodes met Hadoop.
Tegen 2009 testte Hadoop met succes het sorteren van een petabyte aan data in minder dan 17 uur, om miljarden zoekopdrachten te verwerken en miljoenen webpagina's te indexeren. Doug Cutting verliet Yahoo en ging naar Cloudera om de uitdaging aan te gaan om Hadoop naar andere sectoren te brengen.