

Apache Hadoop ekosistemi
Hadoop, tıpkı Excel'in zamanla veri analizi için varsayılan yazılım haline gelmesi gibi, veri işleme için fiili standart haline geldi. Excel'den farklı olarak Hadoop, "İş Analistleri" yerine geliştiriciler tarafından tasarlandı; yine de, geniş çaplı benimsenme ve başarı geliştiricilerden çok iş analistlerine bağlıdır. Bu nedenle, Büyük Veri sorunları işlevsel bir bakış açısıyla bölümlere ayrılmış ve her bölümdeki zorlukları karşılamak üzere Hadoop tabanlı teknolojiler geliştirilmiştir. Bu araçların tümü Hadoop ekosistemi olarak adlandırılır.
Hadoop ekosistemi, Hadoop'u zenginleştirir ve çok çeşitli iş problemlerini çözebilecek hale getirir. Bugüne kadar Hadoop ekosistemi, sorun alanlarına göre 14 kategoriye ayırmayı seçtiğimiz yüzlerce teknolojiden oluşmaktadır: soyutlama dilleri, Hadoop üzerinde SQL (Hive ve Pig), hesaplama modelleri (MapReduce ve Tez), gerçek zamanlı işleme araçları (Storm ve Spark Streaming), veritabanları (HBase ve Cassandra), akış alma araçları (Kafka ve Flume), veri entegrasyon araçları (Sqoop ve Talend), iş akışı koordinasyon araçları (Hadoop için Oozie ve Control M), dağıtık servis koordinasyon araçları (Zookeeper), küme yönetim araçları (Ranger ve Sentry), kullanıcı arayüzü araçları (Hue ve Jupyter), içerik indeksleme araçları (ElasticSearch ve Splunk), dağıtık dosya sistemleri (HDFS) ve kaynak yöneticileri (YARN ve MESOS). Bu bölüm, Büyük Veri teknolojileri ekosistemini oluşturan her bir aracın işlevini gözden geçirecektir. Ardından daha ileri gitmek isterseniz, bu makaleyi takip edecek farklı Hadoop Ekosistemi öğeleriyle ilgili rehberlerimizi okumanızı öneririz. Aşağıdaki zihin haritası, Hadoop ekosistemini genel hatlarıyla sunar.
Hadoop ekosistemi sezgisel haritası
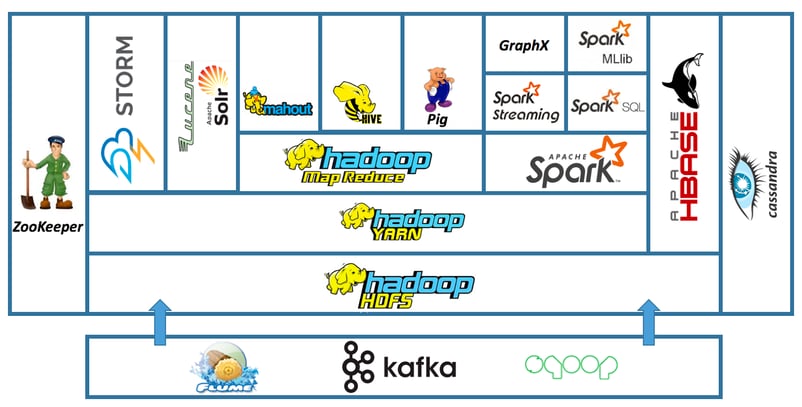
Hadoop ekosisteminin temel yapılandırması şu teknolojileri içerir: Spark, Hive, Pig, HBase, Sqoop, Storm, ZooKeeper, Oozie ve Kafka.
Spark
Spark'ın ne olduğunu açıklamadan önce, bir algoritmanın Hadoop'ta çok düğümlü bir kümede çalışabilmesi için paralelleştirilebilir olması gerektiğini hatırlayalım. Böylece bir algoritma, paralelleştirilebilir ise "ölçeklenebilir" olarak adlandırılır (ve dolayısıyla bir kümenin ölçeklenebilirliğinden faydalanabilir). Hadoop, MapReduce hesaplama modelinin bir uygulamasıdır. MapReduce'un sorunu, Yönlü Asiklik Grafik modeline dayanmasıdır. Başka bir deyişle, MapReduce işlem dizisi dolambaçsız şekilde üç ardışık aşamada çalışır (Map -> Shuffle -> Reduce); hiçbir aşama yinelenmeli (veya döngüsel) değildir.
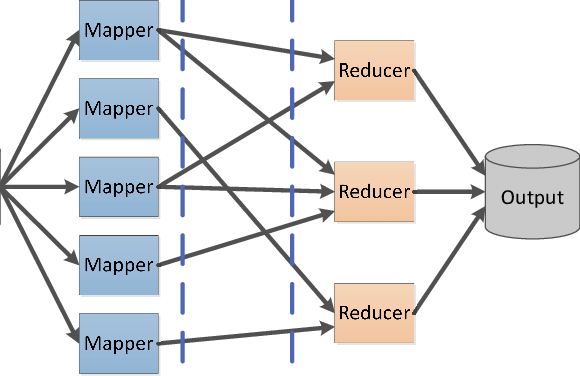
Yönlü asiklik model, özellikle birden çok işlem boyunca veriyi yeniden kullanan, çoğu istatistiksel öğrenme algoritması gibi yinelenmeli ve etkileşimli veri analizi sorguları gibi bazı uygulamalar için uygun değildir. Spark bu sınırlamalara yanıt verir; küme üzerinde bellekte dağıtık işlem yapan bir hesaplama motorudur. Başka bir deyişle, dağıtık bir bellek içi hesaplama motorudur. Toplu modda çalışan MapReduce ile karşılaştırıldığında, Spark'ın hesaplama modeli etkileşimli modda çalışır; yani veriyi işlemden önce bellekte toplar ve bu nedenle Makine Öğrenimi işlemleri için oldukça uygundur.
Hive
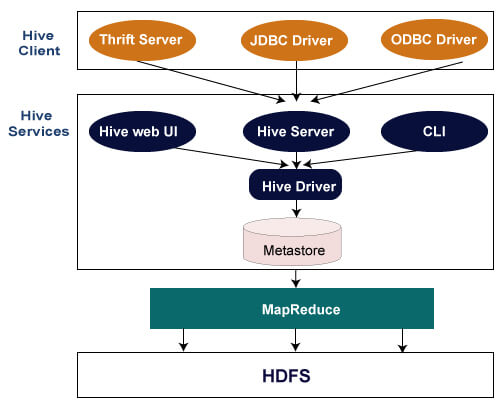
Hive, HDFS gibi dağıtık bir dosya sisteminde depolanan çok büyük veri hacimleri için sorgulama ve toplulaştırma hizmetleri sunan, Veri Ambarına benzer bir hesaplama altyapısıdır. Hive, HDFS üzerinde depolanan verilere yönelik sorguları ele alan HiveQL (Hive Query Language) adlı SQL tabanlı (ANSI-92 standardı) bir sorgu dili sunar. HiveQL ayrıca ileri düzey kullanıcıların/geliştiricilerin daha geniş bir veri yönetimi sorun yelpazesini kapsamak için Map ve Reduce işlevlerini doğrudan sorgularına entegre etmelerine olanak tanır. HiveQL'de bir sorgu yazdığınızda, bu sorgu Hive tarafından bir MapReduce işine dönüştürülür ve yürütülmek üzere JobTracker'a gönderilir.
Pig
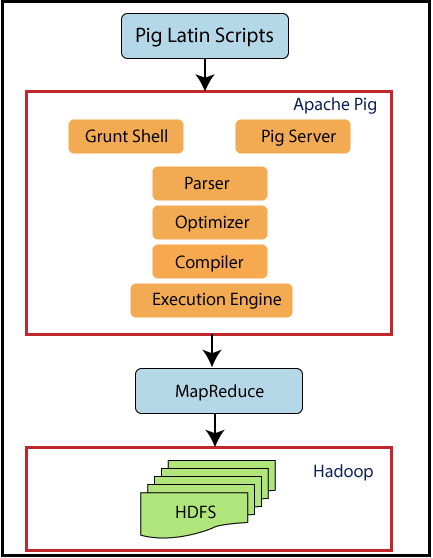
Pig, Hadoop altında etkileşimli bir veri akışı yürütme ortamıdır. İki unsurdan oluşur: Pig Latin adlı bir veri akışı ifade dili ve etkileşimli bir veri akışı yürütme ortamı.
Pig'in sunduğu dil, Pig Latin, kabaca Perl, Python veya Ruby gibi betik dillerine benzer. Ancak onlardan daha özeldir ve en iyi "veri akışı dili" olarak tanımlanır. ETL tarzında, kaynak verilerin ardışık akışları halinde Hadoop altında "hedef" veriyi elde etmek için sorgular yazmanıza olanak tanır. Bu akışlar daha sonra MapReduce işlevlerine dönüştürülür ve yürütme için job tracker'a gönderilir. Kısaca, Pig Hadoop'un ETL'idir. Pig Latin'de programlama, belirli Pig deyimleri olan operatörleri kullanarak verinin nasıl yüklendiğini, dönüştürüldüğünü ve toplandığını, birbirinden bağımsız ama iç içe geçmiş akışlar halinde tanımlamak demektir. Bu operatörlere hâkim olmak, özellikle sayıları Hive'a kıyasla az olduğundan, Pig Latin programlamasına hâkim olmanın anahtarıdır.
HBase
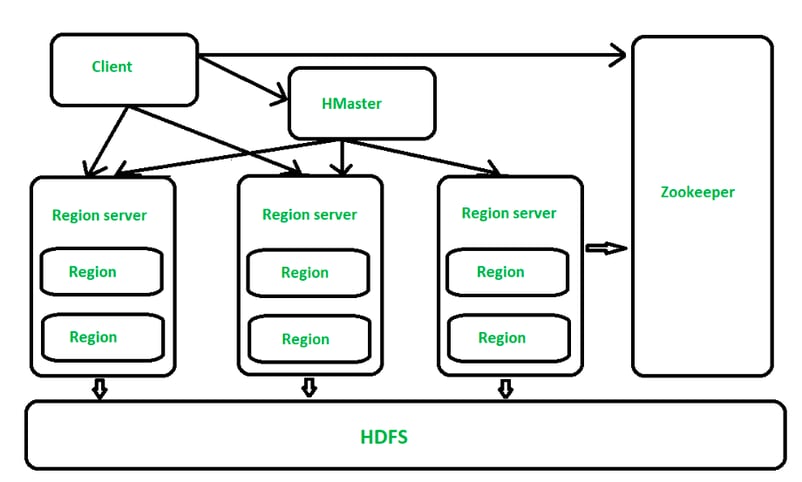
HBase'den bahsetmeden önce, bugüne kadar veri yönetimi için kullanılan İVTYS'lerin (RDBMS) yüksek veri hacmi ve veri çeşitliliği karşısında çok hızlı şekilde sınırlarını gösterdiğini hatırlatalım. Nitekim İVTYS'ler yalnızca yapılandırılmış verileri (satır/sütun tablosu) yönetmek için tasarlanmıştır; ayrıca veri hacmi arttıkça isteklerin gecikmesi de artar. Bu gecikme, gerçek zamana yakın yanıtlar gerektiren birçok işletme için sakıncalıdır. Bu sınırlamaları aşmak için "NoSQL" adı verilen yeni VTYS'ler geliştirilmiştir. Bunlar veriye belirli bir yapı dayatmaz, verinin depolanmasını ve yönetimini birden çok düğüme dağıtabilir ve ölçeklenebilirdir. Hatırlatmak gerekirse, ölçeklenebilirlik, sistemin performansının işlem yükü arttıkça sabit kalması anlamına gelir. HBase bu VTYS kategorisine aittir.
HBase, HDFS üzerinde depolanan verilere gerçek zamanlı okuma ve yazma erişimi sağlayan, dağıtık, sütun odaklı bir VTYS'dir. HDFS, veriye toplu halde sıralı erişim sağlar; akış gibi hızlı veri erişimi gerektiren konular için uygun değildir; HBase bu boşlukları kapatır ve HDFS üzerinde depolanan veriye hızlı erişim sağlar.
HBase, Google'ın "Big Table" VTYS'sine dayanır ve çok büyük veri hacimlerini (milyarlarca satır/sütun) depolayabilir. Uygulama geliştirme için dağıtık bir koordinasyon servisi olan ZooKeeper'a bağımlıdır.
Sqoop
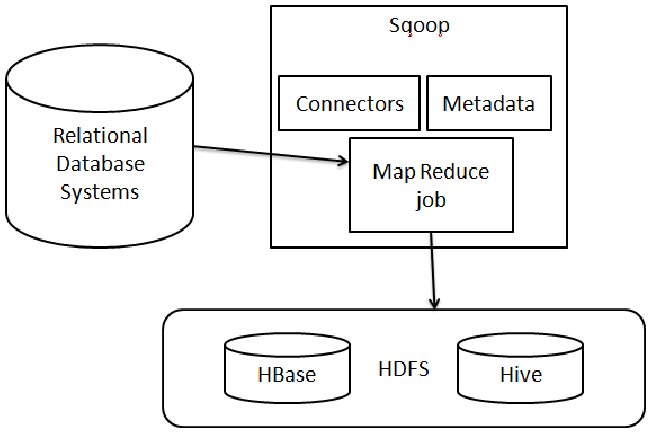
Sqoop veya SQL-to-Hadoop, ilişkisel bir veritabanından Hadoop'un HDFS'ine ve tersi yönde veri aktaran bir araçtır. Hadoop ekosistemiyle entegredir ve Hadoop'da veri alma zamanlayıcısıdır. MySQL, Oracle veya SQL Server gibi İVTYS'lerden veriyi HDFS'e aktarmak, veriyi Hadoop içinde MapReduce veya başka bir hesaplama modeliyle dönüştürmek ve ardından tekrar İVTYS'ye dışa aktarmak için Sqoop'u kullanabilirsiniz. Oozie gibi, bu içe/dışa aktarma sürecini otomatikleştirdiği ve yürütme zamanını planladığı için buna veri alma zamanlayıcısı diyoruz. Kullanıcı olarak tek yapmanız gereken, içe/dışa aktarımı gerçekleştirecek SQL sorgularını yazmaktır. Ayrıca Sqoop, veriyi içe ve dışa aktarmak için MapReduce kullanır; bu da verimlidir ve hataya dayanıklıdır.
Storm
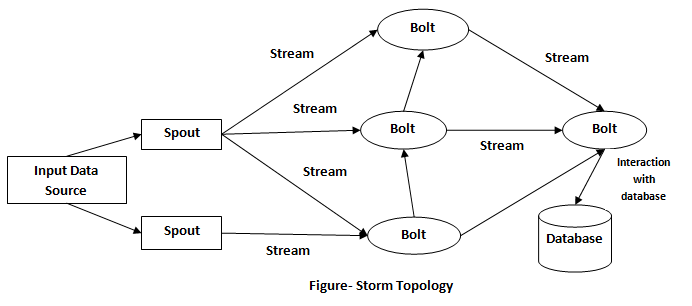
Storm'u anlamak için, lambda (λ) mimarileri kavramını ve bu mimarilerin önemini anlamanız gerekir. Bağlı nesneler kavramını da anlamalısınız. Bağlı nesneler veya Nesnelerin İnterneti (IoT), internetin günlük yaşamımıza uzanmasını temsil eder. Akış verisi üretir ve çoğu konuda verinin gerçek zamanlı işlenmesini gerektirir. Aşina olduğunuz toplu modeller gibi modeller, IoT'nin ortaya çıkardığı gerçek zamanlı sorunlara uyarlanmış değildir. Etkileşimli hesaplama modelleri dahi sürekli gerçek zamanlı işlem yapmak için uygun değildir. Bir şirketin finans veya pazarlama gibi operasyonel sistemleri tarafından üretilen operasyonel veriler akış halinde üretilse bile daha sonra işlenmek üzere tarihsel hâle getirilebilirken, IoT veya internet gibi olgular kapsamında akış halinde üretilen veriler, oluşturulmalarını izleyen anlarda geçerliliğini yitirir (veya artık geçerli olmaz) ve bu nedenle anında işlenmeleri gerekir. Bağlı nesnelerin yanı sıra, sahtekârlıkla mücadele, sosyal ağ verilerinin analizi, coğrafi konumlandırma gibi iş sorunları da neredeyse bir saniyeden az yanıt süreleri gerektirir. Bu sorunu Büyük Veri bağlamında çözmek için λ olarak adlandırılan mimariler geliştirilmiştir. Bu mimariler, gecikmeyi azaltmak için MapReduce'a iki ek işleme katmanı ekler. Storm, λ mimarisinin yazılımsal bir uygulamasıdır. Hadoop altında veriyi gerçek zamanda (veya gerçeğe yakın zamanda) işleyen uygulamalara olanak tanır.
ZooKeeper
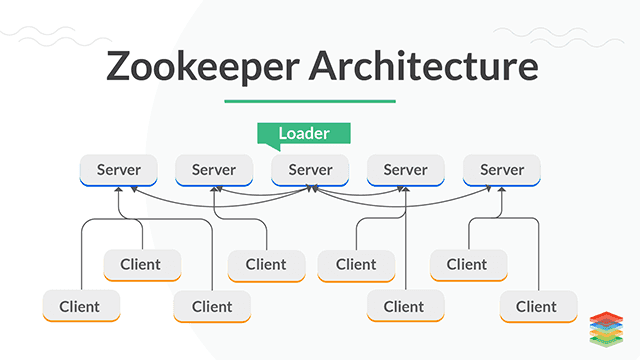
Paralel görevler yürütülürken düğümler arasındaki iletişimi senkronize etmek veya koordine etmek, dağıtık uygulama geliştirmede en zor sorunlardan biridir. Bu sorunu çözmek için Hadoop ekosistemine servis koordinasyon araçları, yani ZooKeeper dahil edilmiştir. ZooKeeper, kümede dağıtık işlerin yürütülmesinin senkronize edilmesinin doğasında bulunan karmaşıklığı üstlenir ve Hadoop ekosistemindeki diğer araçların bu sorunla kendilerinin uğraşmak zorunda kalmamasını sağlar. Ayrıca kullanıcıların, dağıtık programlama uzmanı olmadan dağıtık uygulamalar geliştirmelerine olanak verir. Hadoop kümesinde düğümler arasında verinin koordinasyonunun karmaşık ayrıntılarına girmeden, ZooKeeper dağıtık uygulamalar için dağıtık yapılandırma servisi, dağıtım servisi ve adlandırma kayıt defteri sağlar. ZooKeeper, Hadoop'un dağıtık işleri koordine etme yoludur.
Oozie
Varsayılan olarak, Hadoop işleri kullanıcı gönderdiği gibi, aralarında bir ilişki olup olmadığını dikkate almadan yürütür. Ancak Hadoop'un kullanıldığı sorunlar genellikle bir veya birden fazla karmaşık iş yazılmasını gerektirir. İki iş JobTracker'a (veya YARN'a) gönderildiğinde, aralarındaki bağlantıya dikkat etmeden yürütüleceklerdir; bu da bir hataya (istisna) neden olabilir ve kodun durmasına yol açabilir. Birbiriyle ilişkili birden fazla işin yürütülmesini nasıl yönetebiliriz? Bu tür bir sorunu yönetmek için, mevcut en basit çözüm bir iş zamanlayıcı kullanmaktır; bu da Oozie'dir.
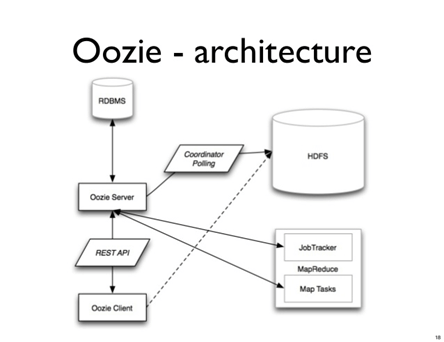
Oozie, bir Hadoop kümesi üzerinde bir servis olarak çalışan bir iş zamanlayıcıdır. Hadoop işlerini ve genel olarak bir kümede çalıştırılabilen tüm işlerin (ör. bir Hive betiği, MapReduce işi, Hama işi, Storm işi vb.) yürütülmesini zamanlamak için kullanılır. Bir Hadoop kümesinde birbirine bağımlı binlerce işin anlık veya gecikmeli yürütümünü otomatik olarak yönetmek üzere tasarlanmıştır. Oozie'yi kullanmak için yalnızca 2 XML dosyasını yapılandırmanız gerekir: bir Oozie motoru yapılandırma dosyası ve bir iş akışı yapılandırma dosyası.
Cloudera'ya Giriş
Cloudera, merkezi Kaliforniya'da olan, tarihsel olarak Hadoop dağıtık çerçevesine dayanan bir Büyük Veri çözümü geliştirmeye adanmış bir Amerikan şirketidir; günümüzde odağını buluta kaydırmaktadır. Bir yılı aşkın süredir Cloudera, çözümünü AWS, Azure ve GCP gibi genel bulutlarda genişletmektedir.
CDP'ye Giriş
Cloudera Data Platform (CDP), şirketlerin hibrit ve çoklu bulut ortamlarında self servis analitiklerle verileri analiz etmelerine olanak tanıyan bir platformdur. Saatler içinde bulutta veri gölleri oluşturarak kuruluşların tüm verilerinden daha fazla değer elde etmelerini sağlar.
CDP, verileri analiz etmek ve merkezileştirmek için entegre, çok işlevli, self servis araçlar sunar. Ek olarak, kurumsal düzeyde güvenlik ve yönetişim sağlar ve genel, özel ve çoklu bulut ortamlarında dağıtılabilir. CDP, Cloudera'nın önceki iki Hadoop dağıtımı olan Cloudera Distribution of Hadoop (CDH) ve Hortonworks Data Platform (HDP) sonrasında gelen dağıtımdır.
Kurumsal veriye self servis erişim bu hizmetin özündedir. Platforma entegre edilen yeni bulut hizmetleri, analistler, veri bilimcileri, BT uzmanları ve geliştiriciler için veriye ve analitiklere self servis erişim de sağlar. Platformu rakiplerinden ayıran anahtar kelimeler, Cloudera'nın sunduğu üç Bulut-Doğası CDP hizmetidir: self servis, çoklu bulut ve güvenlik.
CDP, benzersiz bir kamu-özel yaklaşımı, gerçek zamanlı veri analitiği, ölçeklenebilir şirket içi, bulut ve hibrit dağıtım seçenekleri ve gizlilik öncelikli bir mimari sunar.
CDP Public Cloud
CDP Public Cloud, bulut altyapısıyla uyumlu ve OpenShift gibi özel çözümler de dahil olmak üzere çeşitli bulut sağlayıcıları arasında kolayca taşınabilir bir Hizmet Olarak Platform (PaaS)'tur. CDP tamamen hibrit ve çoklu bulut olacak şekilde tasarlanmıştır; yani tek bir platform tüm veri yaşam döngüsü kullanım senaryolarını yönetebilir. CDP platformu, AWS, Azure ve GCP gibi genel bulutlar dahil birçok kurulumda verilerle çalışabilir. Ayrıca, performansı artırmak ve maliyetleri azaltmak için iş yüklerini ve kaynakları otomatik olarak ölçeklendirip küçültebilir.
CDP Public Cloud Hizmetleri
İşte CDP Public Cloud'u oluşturan başlıca bileşenler:
-
CDP Data Engineering, hepsi bir arada bir kurulumdur. Apache Spark üzerine inşa edilmiştir. Apache Airflow ile orkestrasyon ve otomasyonu mümkün kılarak kurumsal veri analizi ekipleri arasında ETL süreçlerini kolaylaştırır ve gelişmiş hat izleme, görsel hata ayıklama ve yönetim araçları sunar. Ayrıca yalıtılmış çalışma ortamlarına sahiptir ve konteynerleştirilmiş, ölçeklenebilir ve taşınması kolaydır.
-
CDP Data Hub, Edge'den Yapay Zekâya kadar yüksek değerli analitiklere olanak tanıyan bir hizmettir. Cloudera Data Hub, bulut-yerel bir veri yönetimi ve analitik hizmetidir. BT ve iş geliştiricilerinin, akıştan ETL'ye kadar her senaryo için iş uygulamalarını daha hızlı geliştirmelerini sağlar. Veri pazarları, veritabanları ve Makine Öğrenimi, geniş analitik iş yükleri yelpazesinde kapsanan hizmetlerden sadece birkaçıdır.
-
CDP Data Warehouse, BT'nin BI analistleri için bulut-yerel self servis analitik deneyimi sunmasını sağlayan bir hizmettir. Akış, veri mühendisliği ve analitik, CDP Data Warehouse'a tamamen entegredir. Ayrıca, özel, birden çok genel veya hibrit bulut genelinde tüm veri ve metaverinizi güvence altına almak ve yönetmek için birleşik bir çerçeveye sahiptir. Cloudera Data Warehouse hizmeti, veri analistleri için self servis veri ambarlarını dağıtmayı kolaylaştırır. Sağlam, kurumsal ölçekte test edilmiş SQL motorlarına dayanır. Yüzlerce kullanıcı, hem şirket içinde hem de bulutta, tek tıkla verilere erişebilecektir. Kaynaklar ihtiyaç duyulduğunda isteğe bağlı olarak ölçeklendirilebilir ve iş yükü yönetimi de sezgisel araçlarla self servistir.
-
CDP Machine Learning, veri bilimcilerin kurumsal veriden yararlanmasını sağlamak için işbirlikçi Makine Öğrenimi çalışma alanlarını dağıtmayı kolaylaştırır. Modelleri dağıtmak, ölçeklendirmek ve izlemek için yerel ve kapsamlı araçlarla ML iş akışlarını optimize eder. Bu araçla kuruluşlar, makine öğrenimi iş akışları için gerekli araçlara ve verilere self servis erişimi etkinleştirmek üzere birkaç tıklamayla yeni Makine Öğrenimi çalışma alanlarını hızla dağıtabilir. Ayrıca, şirket içinde veya bulutta veri çoğaltması güvenlik ve yönetişimden ödün vermeden hızla yapılabilir. Veri bilimciler, ihtiyaçlarına göre uyarlanabilen elastik kaynaklardan yararlanırken araçlarını da seçebilir. Model eğitimi, veri mühendisliği, dağıtım ve model yönetimi, platformlar arasında geçiş ihtiyacını ortadan kaldıran hepsi bir arada bir arayüz üzerinden hızla gerçekleştirilir.
-
Cloudera Data Visualization, kullanıcıların sanal veri ambarında veriyi, alttaki veri yapılarını veya tabloları kaldırmadan ya da güncellemeden modellemesine ve sürekli veri yüklemesi yapmadan büyük miktarda veriyi sorgulamasına olanak tanır; böylece zaman ve maliyet tasarrufu sağlar.
-
Cloudera Operational Database, alttaki küme örneğini bir veritabanına sentezleyen yönetilen bir çözümdür. Küme iş yükü kullanımına göre otomatik olarak ölçeklenecek, aynı altyapı alanında performansı artıracak ve operasyonel sorunları otomatik olarak çözecektir.
CDP Private Cloud
CDP Private Cloud, hibrit bulut dağıtımları için daha uygundur; şirket içini genel bulutlara bağlarken tutarlı, entegre güvenlik ve yönetişimi korur. CDP Private Cloud'da işleme ve depolama ayrıştırılmıştır; böylece her iki küme de bağımsız olarak ölçeklenebilir. CDP Private Cloud Base kümesinde sunulan Cloudera Shared Data Experience (SDX), birleşik güvenlik, yönetişim ve metaveri yönetimi sağlar. Ayrıca CDP Private Cloud kullanıcıları, Yönetim Konsolu'nu kullanarak Cloudera Data Warehousing ve Cloudera Machine Learning hizmetlerini hızla hazırlayıp dağıtabilir ve ihtiyaç duyuldukça ölçeklendirebilir.
CDP Private Cloud Hizmetleri
Machine Learning ve Data Warehouse gibi bazı CDP Public Cloud bileşenleri, CDP Private Cloud üzerinde de mevcuttur. Geleneksel iş yüklerini desteklemek üzere akış, veri mühendisliği, veri pazarları, operasyonel veritabanları ve veri bilimini kapsayan bir analitik motorlar koleksiyonu kullanır.
HDFS ve MapReduce'un Temelleri
HDFS, Hadoop'un Dağıtık Dosya Sistemi ve Hadoop'un merkezi unsurudur; verilerin birden fazla sunucuda saklanmasına ve çoğaltılmasına olanak tanır. YARN ile birlikte, HDFS Hadoop kümesinin veri yönetimi yeteneklerini artırır ve böylece verimli Büyük Veri işleme sağlar.
HDFS'i hazır donanım üzerinde çalıştırabilirsiniz; bu da onu hatalara karşı çok dayanıklı kılar. Her veri parçası birkaç yerde saklanır ve her koşulda geri kazanılabilir. Ayrıca bu çoğaltma, olası veri bozulmalarıyla mücadele etmeye yardımcı olur.
HDFS, bir NameNode ve bir DataNode kullanır. DataNode, verinin depolandığı standart bir sunucudur. NameNode, meta verileri (farklı düğümlerde depolanan veriler) içerir. Uygulama yalnızca NameNode ile etkileşime girer ve NameNode gerektiğinde veri düğümleriyle iletişim kurar.
HDFS ayrıca veriyi taşımak yerine işlemleri taşımaya odaklanarak ağ tıkanıklığını önler. Bu, uygulamaların veriye depolandığı yerde erişebilmesi anlamına gelir. Son gücü ise taşınabilirliğidir. Herhangi bir uyumluluk sorunu olmadan farklı donanım türlerinde çalışabilir.
Mapreduce nedir ve nasıl çalışır?
MapReduce, doğrudan Google'ın MapReduce'undan türetilmiş, Apache Hadoop'un işleme motorudur. MapReduce uygulaması esasen Java ile yazılır. Ele alınan probleme çözüm bulmak için eşleme ve indirgeme adımlarını uygulayarak çok büyük miktarda veriyi kolaylıkla hesaplamayı sağlar. Eşleme adımı, bir veri kümesini, bireysel öğeleri tuple adı verilen anahtar/değer çiftlerine ayrıştırarak başka bir veri kümesine dönüştürür. İkinci indirgeme adımı ise eşleme işleminden elde edilen çıktıyı alır ve veri tuple'larını daha küçük bir tuple kümesi halinde birleştirir.
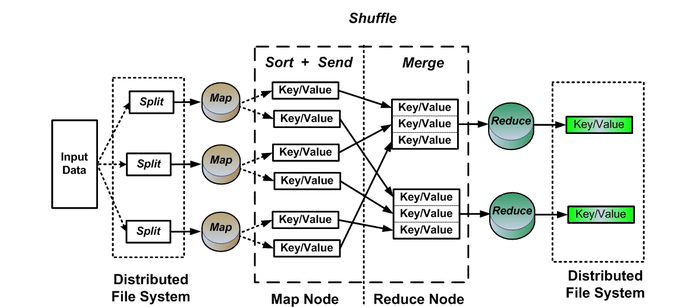
MapReduce, büyük miktarda hazır donanım üzerinde kolayca ölçeklenebilen, yüksek düzeyde paralel bir işleme çerçevesidir; büyük miktarda veriyi işleme ihtiyacının artmasına uyum sağlar. Eşleme ve indirgeme görevleri sorunsuz çalıştıktan sonra, daha büyük bir veri kümesi üzerinde çalıştırmak için tek gereken bir yapılandırma değişikliğidir. Tek bir düğümden yüzlerce hatta binlerce düğüme uzanan bu tür aşırı ölçeklenebilirlik, MapReduce'u dünya çapındaki Büyük Veri profesyonellerinin favorisi yapmaktadır.
MapReduce, aşağıdakiler de dahil geniş bir özellik yelpazesi sunar:
- Büyük Veri görevlerini gerçekleştirmek için gereken paralel işlemeyi sağlar.
- Çok çeşitli ticari veri işleme uygulamalarına uygulanabilir
- Merkezi işlem çerçeveleri için uygun maliyetli bir çözümdür
- Paralel işleme yeteneklerini kolaylaştırmak için SQL ile entegre edilebilir.
Apache Hadoop İçeren Cloudera Dağıtımı
Cloudera, Hortonworks ve MapR ile birlikte Hadoop'un köklü saf oyuncularından biridir. Intel destekli grup, Impala ve Search gibi birkaç diğer açık kaynak projeyi de içeren bir Hadoop dağıtımı olan CDH'yi geliştirir. Ayrıca güvenlik ve entegrasyon özellikleri sunar.
Impala çerçevesi, HDFS, Apache HBase veya AWS S3'te depolanan verilere doğrudan sorgular yapılmasını sağlayan etkileşimli bir SQL sorgu motorudur. Bu motor, SQL sözdizimi (HiveSQL), Open DataBase Connectivity sürücüsü ve Query UI gibi Hive'dan gelen diğer teknoloji ve bileşenlere dayanır.
Search bileşeni, Lucene üzerine inşa edilmiş bir veri indeksleme ve arama motoru olan Apache Solr projesine dayanır. Bu teknolojinin CDH'ye entegrasyonu, örneğin (hemen hemen) gerçek zamanlı indeksleme yeteneklerine ve Hadoop veya HBase kümesinde depolanan verilere erişime olanak tanır. Solr teknolojisi, kapsamlı SQL becerileri gerektirmeden karmaşık tam metin aramaları sağlar. Solr, Hadoop verisini önce taşımak zorunda kalmadan sorgulamanıza olanak tanır.
Cloudera, her biri farklı hizmet ve küme yönetimi özelliklerine ve farklı destek seviyelerine sahip çeşitli CDH sürümleri sunar:
- Cloudera Express, CDH'nin ücretsiz sürümüdür; CDH öğelerini ve Cloudera Manager'ın temel işlevlerini içerir. Ayrıca Enterprise sürümünün 30 günlük deneme sürümüne erişim sağlar.
- Cloudera Manager, CDH'nin kontrol kulesidir. Araç, CDH dağıtımlarını dağıtmak, yönetmek, izlemek ve sağlık durumunu kontrol etmek için web tabanlı bir yönetim konsolu sağlar. Ayrıca sistemi yapılandırmak ve bir CDH kümesinin çalışmasına ilişkin metrikleri ve bilgileri almak için bir API içerir.
- Cloudera Enterprise, ücretli lisans sürümüdür ve bu nedenle genişletilmiş özelliklere sahiptir. Örneğin, Cloudera Manager ve Navigator'dan alınan gelişmiş araçları içerir.
- Cloudera Manager Advanced Features, Cloudera Express'e temel özellikler ekler: operasyonel raporlama, kota yönetimi, yapılandırma günlükleri, sürekli güncellemeler, servis yeniden başlatmaları, Kerberos entegrasyonu, LDAP entegrasyonu, SNMP desteği ve otomatik felaket kurtarma.
- Yalnızca Flex ve Data Hub sürümleriyle gelen Cloudera Navigator, bir CDH platformu içinde veri güvenliği ve yönetişim yönetimini mümkün kılar. Araç, şirketlerin uyumluluk kısıtlarını destekler. Bununla, veri yöneticileri, analistler ve yöneticiler, Hadoop'da depolanan büyük veri hacimlerini keşfedebilir ve bir CDH kümesindeki veriyi güvenceye almak için kullanılan şifreleme anahtarlarını daha kolay yönetebilir.
Bir kavram kanıtı ortamı kurmak için önce Cloudera Manager Server yükleyicisini indirip çalıştırmanız gerekir.
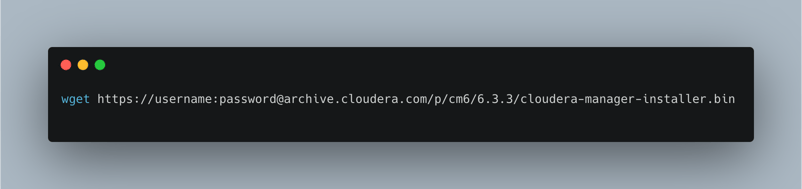
- Öncelikle tarayıcınızda Cloudera Manager İndirmeleri sayfasını açmanız gerekir. Cloudera Manager kutusunda Şimdi İndir'e tıklayın. Ayrıca Cloudera Manager sürümünüz için yükleyiciyi indirebilirsiniz. Örneğin, Cloudera Manager 6.3.3 için:
- Sonra, Cloudera Manager Yükleyicisini çalıştırmanız gerekir.
Önce, Cloudera-manager-installer.bin dosyasına çalıştırma izni verin: chmod u+x Cloudera-manager-installer.bin
Yükleyiciyi çalıştırmak için şu komutu kullanın: sudo ./cloudera-manager-installer.bin --username=username --password=password
- İlgili Lisans Sözleşmelerini Okuyun ve Kabul Edin
Yükleyici daha sonra şunları yapar:
- Cloudera Manager depo dosyalarını yükler.
- Oracle JDK'yı yükler.
- Cloudera Manager Server ve gömülü PostgreSQL paketlerini yükler.
Kurulum tamamlandığında, Cloudera Manager Yönetim Konsolu için tam URL, bağlantı noktası numarasıyla birlikte (varsayılan olarak 7180) görüntülenir. Önce bu URL'yi not alın. Ardından, yükleyiciden çıkmak ve başarılı kurulumu onaylamak için Enter'a basarak Tamam'ı seçin.
Sonraki adım, Sihirbaz'ı kullanarak CDH'yi yüklemektir.
- Cloudera Manager Server'ın çalıştığı ana bilgisayarın FQDN veya IP adresi yerine geçmek üzere HTTP://:7180 adresine giriş yaparak Cloudera Manager Yönetim Konsolunuza gidin.
- Cloudera Manager Yönetim Konsoluna giriş yapın. Varsayılan kimlik bilgileri şunlardır:
**Username**: admin **Password**: admin
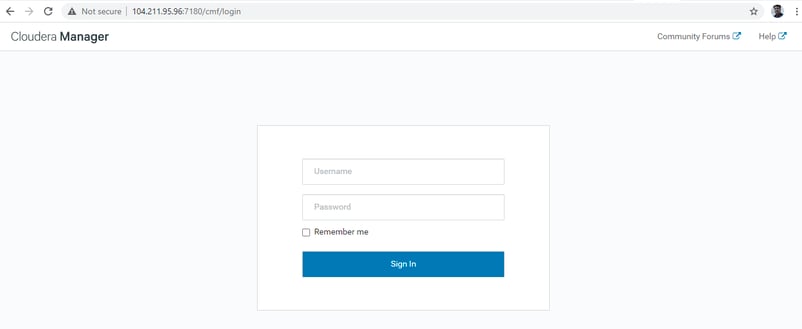
Şartlar ve koşulları okuyun ve kabul edin: Devam'a tıklayın, kurulum sihirbazı başlayacaktır.
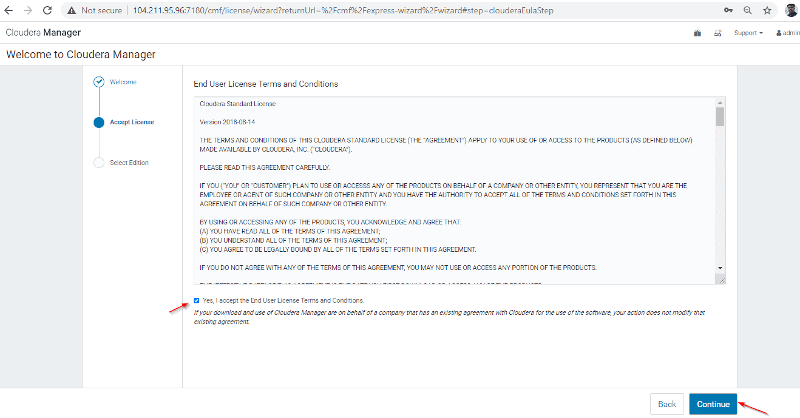
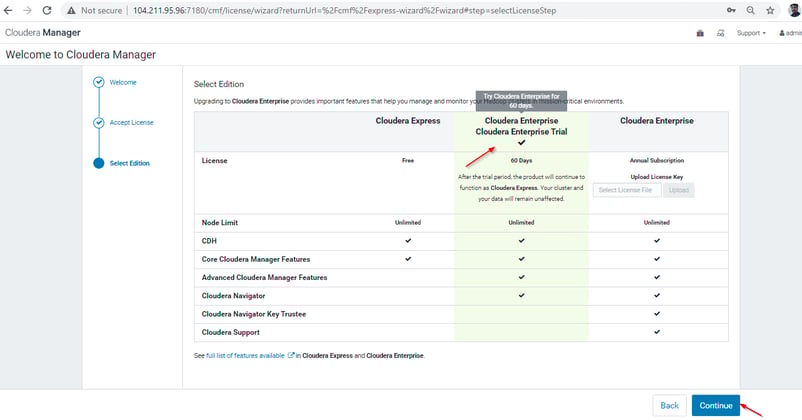
Cloudera Manager için kurulum sihirbazı sizi şu adımlardan oluşan bir dizi süreçten geçirir: Sürüm Seçin Yüklenecek sürümü seçebilirsiniz ve isteğe bağlı olarak bir lisans da yükleyebilirsiniz.
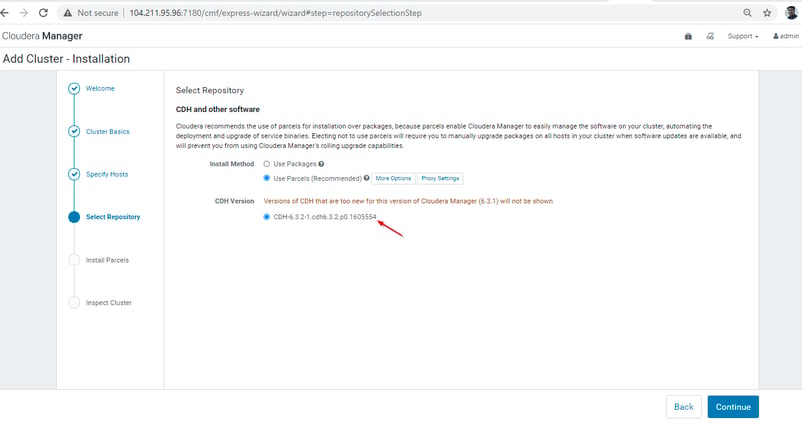
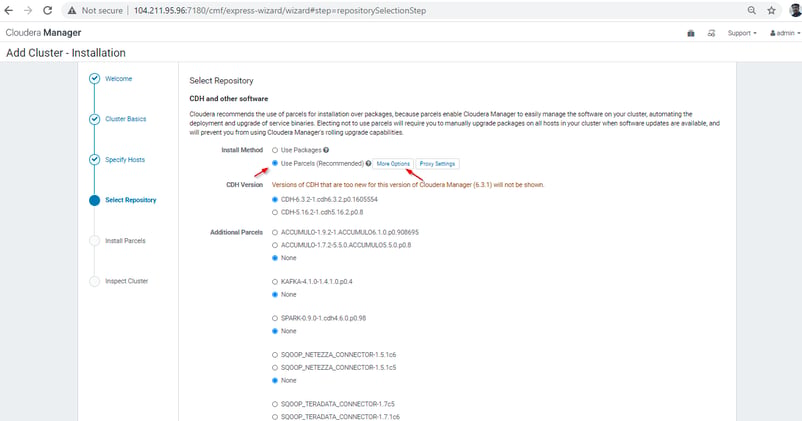
Ana Bilgisayarları Belirtin CDH ve diğer yönetilen hizmetleri çalıştırmak için hangi ana bilgisayarların kullanılacağını seçin. Depoyu Seçin Burada şunları yapmanız gerekir:
- Öncelikle, kurulumda kullanılacak depo türünü seçin. Bu kavram kanıtı kümesi için Use Parcels seçeneğini tercih etmeniz önerilir.
- Ardından, yüklenecek CDH sürümünü ve yüklemek istediğiniz ek Paketleri (Parcels) seçmeniz gerekir.
- Yüklemek istediğiniz Cloudera Manager Agent sürümünü seçebileceksiniz.
- Devam'a tıklayın.
JDK Lisansını Kabul Edin JDK yazılımını yükleyerek, Oracle İkili Kod Lisans Sözleşmesi ile bağlı olmayı kabul edersiniz. Lisans koşullarını okuduktan ve ilgili kutuları işaretledikten sonra Devam'a tıklayın.
Giriş Kimlik Bilgilerini Girin Kök hesap, kullanıcı adı, kimlik doğrulama yöntemi, ssh bağlantı noktası ve ana bilgisayar sayısını tanımlayarak.
Agent'ları Yükleyin Agent'ları Yükle sayfası, kurulumun ilerleme durumunu gösterir. Herhangi bir ana bilgisayar için ayrıntıları genişleterek kurulum günlüğünü görüntüleyebilirsiniz.
Paketleri Yükleyin Paketleri Yükle sayfası, daha önce seçtiğiniz paketlerin kurulum ilerlemesini görüntüler. O ana bilgisayara ilişkin ayrıntılar için herhangi bir ilerleme çubuğuna tıklayabilirsiniz.
Ana Bilgisayarları Denetleyin Ana Bilgisayarları Denetle sayfası, yaygın yapılandırma sorunlarını aramak için Host Inspector'ı çalıştırır. Sonuçları görüntüleyin ve tespit edilen sorunları giderin. Ardından, değişiklik yaptıktan sonra sonuçları güncellemek için Tekrar Çalıştır düğmesine tıklayın.
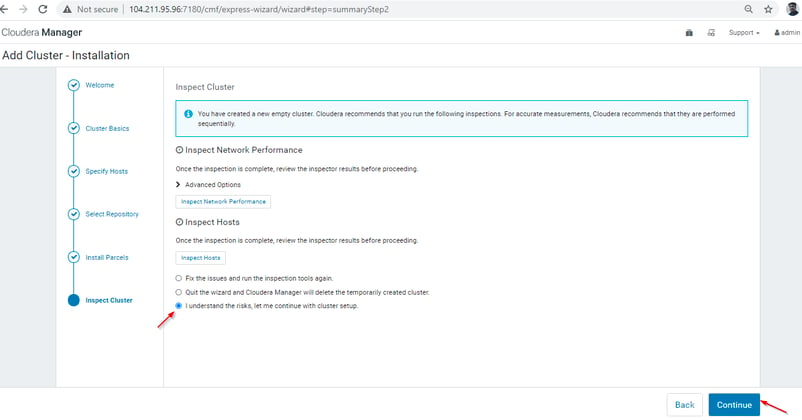
Yukarıdaki adımların tümünü tamamladıktan sonra, Küme Kurulumu sihirbazı otomatik olarak başlayacaktır.
Özet
Hadoop'un işletmelere sağladığı faydalar önemli ölçüdedir. Bu çerçeve sayesinde, dağıtık hesaplama sayesinde büyük miktarda veriyi hızlıca depolamak ve işlemek mümkündür. İşlenen veri ve uygulamalar donanım arızalarına karşı korunur. Bir düğüm arızalandığında, işler dağıtık hesaplamanın başarısız olmamasını sağlamak için doğrudan diğer düğümlere yönlendirilir. Tüm verilerin birkaç kopyası otomatik olarak saklanır. Başarı hikâyeleri hakkında daha fazlasını buradan okuyabilir ve veri bilimiyle ilgili güncellemeler için blogumuzu takip edebilirsiniz.



Apache Hadoop nedir?
Hadoop, dağıtık uygulamalar ve veri yoğun yönetim için açık kaynaklı bir Java çerçevesidir. Uygulamaların binlerce düğüm ve petabaytlarca veriyle çalışmasına olanak tanır. Hadoop, Google'ın MapReduce, GoogleFS ve BigTable yayınlarından esinlenmiştir.
MapReduce çerçevesi sayesinde çok büyük miktarda veriyi yönetebilir. İşlem yapmak için veriyi ağa taşımak yerine, MapReduce, işleme yazılımının doğrudan verinin yanına taşınmasına olanak tanır.
Baştan sona bir ürün değil, dağıtık verinin depolanması ve işlenmesine yönelik bir talimatlar çerçevesidir. Çeşitli yazılım satıcıları, ticari Büyük Veri yönetim ürünleri oluşturmak için Hadoop'u kullanmıştır.
Hadoop veri sistemleri ölçekle sınırlı değildir; bu da daha ağır yükü desteklemek için, yeniden yapılandırma veya pahalı yazılım lisansları satın alma gerektirmeden daha fazla donanım ve küme eklenebileceği anlamına gelir.
Apache Hadoop'un tarihi ve eğilimleri
Cloudera, 2008 yılında, matematikçi ve eski Bear Stearns ile Facebook çalışanı Jeff Hammerbach tarafından ortaklaşa kuruldu. Kendisi, veri analizi ve daha iyi reklam hedefleme için programlar geliştirmekten sorumluydu. Diğer kurucular arasında eski bir Google çalışanı olan Christophe Bisciglia; Hadoop üzerinde de çalışmış eski bir Yahoo çalışanı Amr Awadallah ve Cloudera CEO'su Mike Olson yer alır. Baş mimar, Lucene indeksleme motoru ve Hadoop dağıtık çerçevesinin arkasındaki isim olan Doug Cutting'dir.
2018'de Cloudera, başlıca rakibi Hortonworks ile birleşti. Firma ardından bulut dünyasına açılmak için bir iş yönelimi başlattı. 2021'de Cloudera, KKR ve Clayton Dubilier & Rice adlı iki özel sermaye fonu tarafından 5,3 milyar dolara satın alındı ve pazar genişlemesini sürdürmek için sağlam bir temel kazandı.
Hadoop, Doug Cutting ve Mike Cafarella ile 2002'de ikisinin Apache Nutch projesi üzerinde çalışmaya başlamasıyla ortaya çıktı. Apache Nutch projesi, 1 milyar sayfayı indeksleyebilen bir arama motoru sistemi oluşturdu. Nutch üzerinde çok sayıda araştırma yaptıktan sonra, böyle bir sistemin donanımda yaklaşık yarım milyon dolara ve aylık yaklaşık 30.000 dolar işletme maliyetine mal olacağını, yani çok pahalı olacağını sonucuna vardılar. Böylece, projelerinin mimarisinin milyarlarca web sayfasını aşamayacağını fark ettiler. Uygulama maliyetini ve büyük veri kümelerinin depolanması ve işlenmesi sorununu azaltabilecek bir çözüm istiyorlardı.
2003'te, Google tarafından yayımlanan, büyük veri hacimlerini depolamak için tasarlanan Google'ın dağıtık dosya sistemi mimarisini anlatan GFS (Google File System) makalesine rastladılar. Bu makalenin, web taraması ve indeksleme süreçleri nedeniyle üretilen devasa dosyaları depolama sorunlarını çözebileceğini biliyorlardı. Ancak bu makale sorunlarının yalnızca yarısına çözüm sağlıyordu.
2004'te, Google, bu büyük veri kümelerinin işlenmesine çözüm olan MapReduce tekniği üzerine başka bir makale yayımladı. Bu makale, Doug Cutting ve Mike Cafarella'nın Nutch projesi için bir diğer yarım çözümdü. Bu teknikler (GFS ve MapReduce) Google'da yalnızca beyaz kâğıt üzerindeydi. Google bu iki tekniği uygulamamıştı. Doug Cutting, Apache Lucene deneyiminden açık kaynağın teknolojiyi daha fazla kişiye yaymanın harika bir yolu olduğunu biliyordu. Böylece Mike Cafarella ile birlikte, Google'ın tekniklerini (GFS & MapReduce) Apache Nutch projesinde açık kaynak olarak uygulamaya başladı.
2005'te Cutting, Nutch'un yalnızca 20-40 düğümlü kümelerle sınırlı olduğunu keşfetti. Hızla iki sorunu fark etti: (a) Nutch, en büyük kümelerde güvenilir şekilde çalışmadıkça potansiyeline ulaşamayacaktı (b) Bunun yalnızca iki kişiyle (Doug Cutting & Mike Cafarella) imkânsız göründüğüydü. Nutch projesindeki mühendislik görevi düşündüğünden çok daha büyüktü; bu yüzden çabalarına yatırım yapmakla ilgilenen bir şirketle iş aramaya başladı. Yahoo!'nun bu projede çalışmaya hevesli harika bir mühendis ekibine sahip olduğunu keşfetti.
2006'da, Doug Cutting Nutch projesiyle birlikte Yahoo'ya katıldı. Yahoo'nun yardımıyla dünyaya açık kaynaklı, güvenilir ve ölçeklenebilir bir hesaplama çerçevesi sunmak istiyordu. Cutting, Nutch'un dağıtık hesaplama bölümlerini burada ayırdı ve yeni bir Hadoop projesi oluşturdu. Projeye, oğlunun sarı oyuncak filinden esinlenerek Hadoop adını verdi; ayrıca telaffuzu kolay, benzersiz bir kelimeydi. Hadoop'u binlerce düğüm üzerinde iyi çalışacak şekilde oluşturmak istedi ve GFS ile MapReduce üzerinde Hadoop üzerinde çalışmaya başladı.
2007'de Yahoo, Hadoop'u 1.000 düğümlü bir kümede başarıyla test etti ve kullanmaya başladı.
Ocak 2008'de Yahoo, Hadoop'u açık kaynak proje olarak ASF'ye (Apache Software Foundation) yayımladı. Temmuz 2008'de Apache Software Foundation, Hadoop ile 4000 düğümlü bir kümeyi başarıyla test etti.
2009'a gelindiğinde, Hadoop, milyarlarca aramayı yönetmek ve milyonlarca web sayfasını indekslemek için bir petabayt veriyi 17 saatten kısa sürede sıralamayı başarıyla test ediyordu. Doug Cutting Yahoo'dan ayrıldı ve Hadoop'u diğer sektörlere yayma meydan okumasını üstlenmek için Cloudera'ya katıldı.