

Hệ sinh thái của Apache Hadoop
Hadoop đã trở thành tiêu chuẩn de facto cho xử lý dữ liệu, tương tự như cách Excel dần trở thành phần mềm mặc định cho phân tích dữ liệu. Khác với Excel, Hadoop được thiết kế bởi các nhà phát triển chứ không phải "Chuyên viên Phân tích Kinh doanh", tuy nhiên việc ứng dụng trên diện rộng và thành công lại phụ thuộc vào các chuyên viên phân tích kinh doanh hơn là nhà phát triển. Vì lý do đó, các vấn đề của Big Data đã được phân đoạn theo góc độ chức năng, và cho mỗi phân đoạn, các công nghệ dựa trên Hadoop đã được phát triển để giải quyết thách thức của nó. Tất cả các công cụ này hợp thành cái gọi là hệ sinh thái Hadoop.
Hệ sinh thái Hadoop làm phong phú Hadoop và giúp nó có khả năng giải quyết nhiều bài toán kinh doanh đa dạng. Cho đến nay, hệ sinh thái Hadoop gồm hàng trăm công nghệ mà chúng tôi chọn nhóm vào 14 danh mục theo phân đoạn vấn đề: ngôn ngữ trừu tượng, SQL trên Hadoop (Hive và Pig), mô hình tính toán (MapReduce và Tez), công cụ xử lý thời gian thực (Storm và Spark Streaming), cơ sở dữ liệu (HBase và Cassandra), công cụ thu nạp dữ liệu streaming (Kafka và Flume), công cụ tích hợp dữ liệu (Sqoop và Talend), công cụ điều phối luồng công việc (Oozie và Control M for Hadoop), công cụ phối hợp dịch vụ phân tán (Zookeeper), công cụ quản trị cụm (Ranger và Sentry), công cụ giao diện người dùng (Hue và Jupyter), công cụ lập chỉ mục nội dung (ElasticSearch và Splunk), hệ thống tệp phân tán (HDFS), và bộ quản lý tài nguyên (YARN và MESOS). Phần này sẽ điểm qua chức năng của từng công cụ cấu thành hệ sinh thái công nghệ Big Data này. Sau đó, nếu bạn muốn tìm hiểu sâu hơn, chúng tôi khuyến nghị bạn đọc các hướng dẫn về các thành phần khác nhau của Hệ sinh thái Hadoop sẽ tiếp nối bài viết này. Sơ đồ tư duy sau đây trình bày tổng quan hệ sinh thái Hadoop.
Bản đồ heuristic hệ sinh thái Hadoop
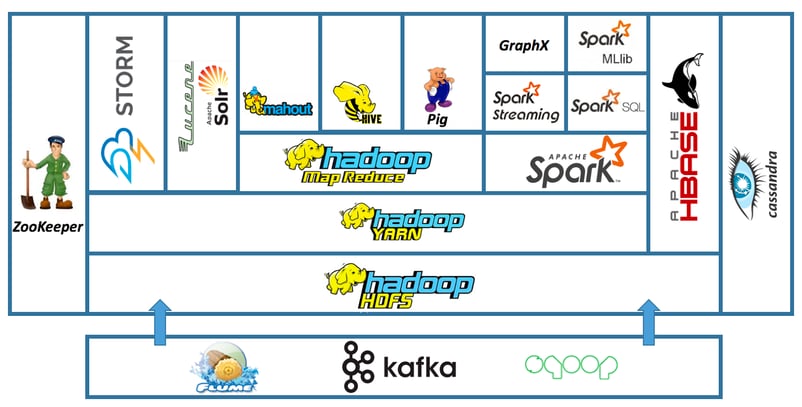
Cấu hình cơ bản của hệ sinh thái Hadoop bao gồm các công nghệ sau: Spark, Hive, Pig, HBase, Sqoop, Storm, ZooKeeper, Oozie và Kafka.
Spark
Trước khi giải thích Spark là gì, hãy nhớ rằng để một thuật toán có thể chạy trên cụm nhiều nút trong Hadoop thì nó phải có khả năng song song hóa. Như vậy, một thuật toán được coi là "scalable" nếu có thể song song hóa (và do đó tận dụng khả năng mở rộng của cụm). Hadoop là một hiện thực hóa của mô hình tính toán MapReduce. Vấn đề với MapReduce là nó được xây dựng trên mô hình Đồ thị Có Hướng Phi Chu trình (DAG). Nói cách khác, chuỗi thao tác MapReduce chạy theo ba pha tuần tự trực tiếp không rẽ nhánh (Map -> Shuffle -> Reduce); không pha nào là lặp (hay chu kỳ).
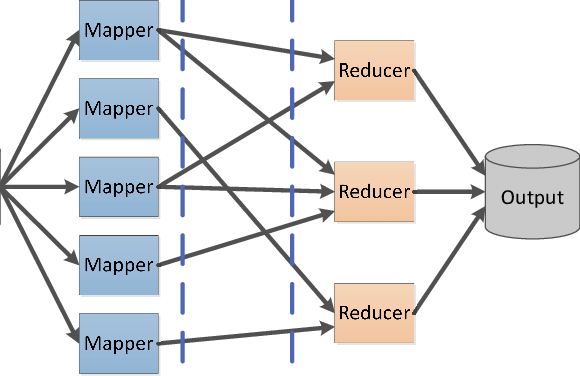
Mô hình phi chu trình trực tiếp không phù hợp với một số ứng dụng, đặc biệt là những ứng dụng tái sử dụng dữ liệu qua nhiều thao tác, như hầu hết các thuật toán học thống kê vốn mang tính lặp, và các truy vấn phân tích dữ liệu tương tác. Spark khắc phục những hạn chế này; nó là một động cơ tính toán thực hiện xử lý phân tán trong bộ nhớ trên một cụm. Nói cách khác, đó là một engine tính toán trong bộ nhớ phân tán. So với MapReduce hoạt động theo lô (batch), mô hình tính toán của Spark hoạt động ở chế độ tương tác, tức là gom dữ liệu vào bộ nhớ trước khi xử lý nên rất phù hợp cho các tác vụ Machine Learning.
Hive
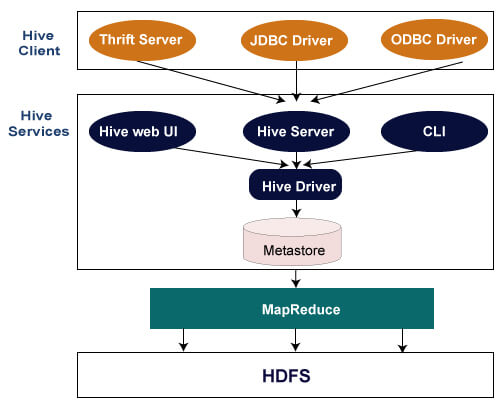
Hive là một hạ tầng tính toán tương tự như Data Warehouse cung cấp dịch vụ truy vấn và tổng hợp cho khối lượng dữ liệu rất lớn được lưu trữ trên hệ thống tệp phân tán như HDFS. Hive cung cấp một ngôn ngữ truy vấn dựa trên SQL (chuẩn ANSI-92) gọi là HiveQL (Hive Query Language), dùng để gửi truy vấn đến dữ liệu lưu trên HDFS. HiveQL cũng cho phép người dùng/nhà phát triển nâng cao tích hợp trực tiếp các hàm Map và Reduce vào truy vấn để bao phủ dải vấn đề quản lý dữ liệu rộng hơn. Khi bạn viết truy vấn bằng HiveQL, truy vấn đó được chuyển thành một job MapReduce và được Hive gửi lên JobTracker để thực thi.
Pig
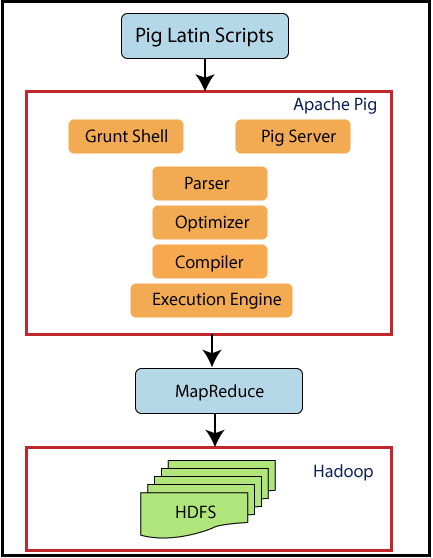
Pig là môi trường thực thi luồng dữ liệu tương tác trên Hadoop. Nó gồm 2 thành phần: một ngôn ngữ biểu đạt luồng dữ liệu gọi là Pig Latin, và một môi trường thực thi luồng dữ liệu tương tác.
Ngôn ngữ do Pig cung cấp, Pig Latin, gần giống các ngôn ngữ scripting như Perl, Python hoặc Ruby. Tuy nhiên, nó chuyên biệt hơn và được mô tả chính xác nhất là một "ngôn ngữ luồng dữ liệu". Nó cho phép bạn viết các truy vấn theo chuỗi tuần tự từ dữ liệu nguồn để thu được dữ liệu "đích" trên Hadoop theo kiểu ETL. Các luồng này sau đó được chuyển thành các hàm MapReduce và cuối cùng được gửi lên job tracker để thực thi. Nói ngắn gọn, Pig là ETL của Hadoop. Lập trình bằng Pig Latin nghĩa là mô tả trong các luồng độc lập nhưng lồng nhau cách dữ liệu được nạp, biến đổi và tổng hợp bằng những mệnh đề riêng của Pig gọi là operators. Nắm vững các operators này là chìa khóa để thành thạo Pig Latin, nhất là vì số lượng của chúng ít hơn so với Hive.
HBase
Trước khi nói về HBase, chúng ta nhắc lại rằng các RDBMS, vốn được dùng để quản lý dữ liệu cho đến nay, đã nhanh chóng bộc lộ giới hạn trước khối lượng và sự đa dạng dữ liệu cao. Thật vậy, RDBMS được thiết kế chỉ để quản lý dữ liệu có cấu trúc (bảng dữ liệu dạng hàng/cột); hơn nữa, khối lượng dữ liệu tăng khiến độ trễ truy vấn tăng theo. Độ trễ này gây bất lợi cho nhiều doanh nghiệp cần phản hồi gần thời gian thực. Các Hệ quản trị CSDL mới gọi là "NoSQL" đã được phát triển để khắc phục những hạn chế này. Chúng không áp đặt cấu trúc cụ thể lên dữ liệu, có thể phân phối việc lưu trữ và quản lý dữ liệu trên nhiều nút và có khả năng mở rộng. Nhắc lại, khả năng mở rộng nghĩa là hiệu năng hệ thống vẫn ổn định khi tải xử lý tăng. HBase thuộc nhóm Hệ quản trị CSDL này.
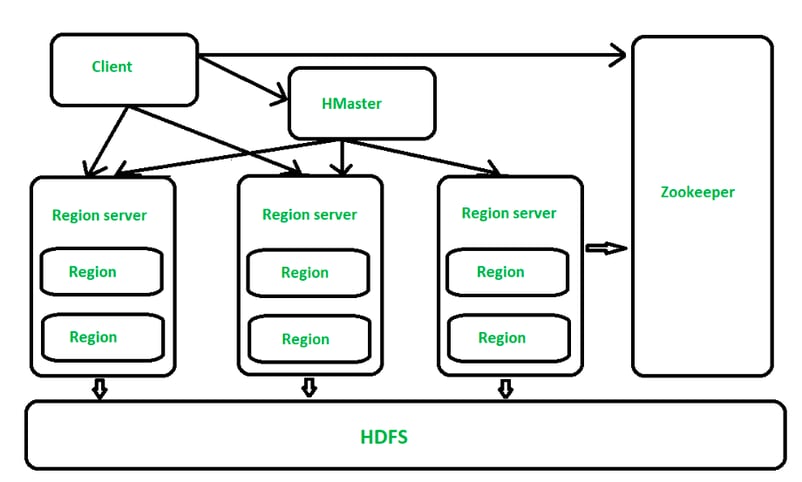
HBase là Hệ quản trị CSDL phân tán, định hướng cột, cung cấp truy cập đọc/ghi thời gian thực tới dữ liệu lưu trên HDFS. HDFS cung cấp truy cập tuần tự theo lô, không phù hợp cho các vấn đề truy cập dữ liệu nhanh như streaming; HBase bù đắp khoảng trống này và cung cấp truy cập nhanh tới dữ liệu lưu trên HDFS.
HBase dựa trên Hệ quản trị CSDL "Big Table" của Google và có thể lưu trữ khối lượng dữ liệu rất lớn (tỷ hàng/cột). Nó phụ thuộc vào ZooKeeper, một dịch vụ phối hợp phân tán dùng cho phát triển ứng dụng.
Sqoop
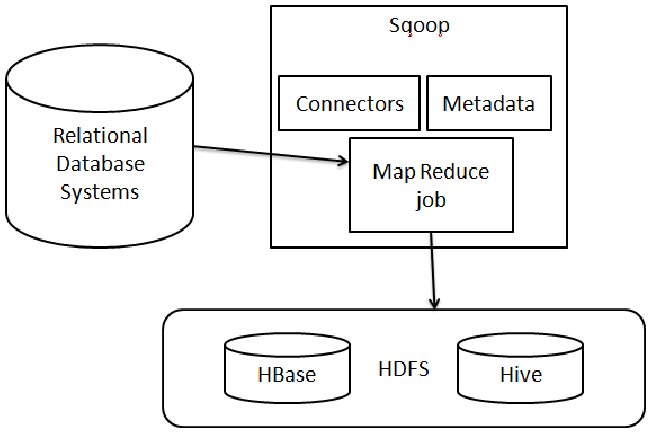
Sqoop hay SQL-to-Hadoop là công cụ chuyển dữ liệu từ cơ sở dữ liệu quan hệ sang HDFS của Hadoop và ngược lại. Nó tích hợp với hệ sinh thái Hadoop và là bộ lập lịch thu nạp dữ liệu trong Hadoop. Bạn có thể dùng Sqoop để nhập dữ liệu từ các RDBMS như MySQL, Oracle, hoặc SQL Server vào HDFS, biến đổi dữ liệu trong Hadoop qua MapReduce hoặc mô hình tính toán khác, rồi xuất ngược lại về RDBMS. Chúng tôi gọi đó là bộ lập lịch thu nạp dữ liệu vì, giống Oozie, nó tự động hóa quy trình nhập/xuất này và lên lịch thời gian chạy. Việc bạn cần làm với tư cách người dùng là viết các truy vấn SQL dùng để thực hiện luồng nhập/xuất. Hơn nữa, Sqoop sử dụng MapReduce để nhập và xuất dữ liệu, vốn hiệu quả và chịu lỗi tốt.
Storm
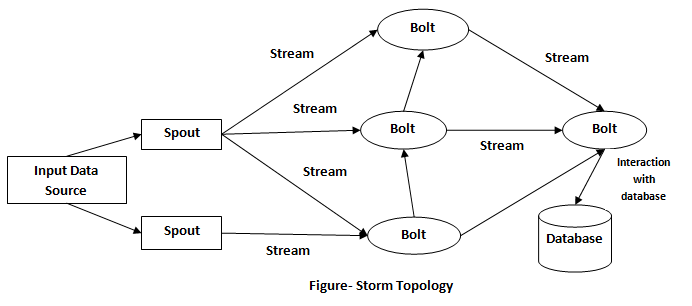
Để hiểu Storm, bạn cần hiểu khái niệm kiến trúc lambda (λ) và lợi ích của chúng. Bạn cũng cần hiểu khái niệm thiết bị kết nối. Các thiết bị kết nối hay Internet of Things (IoT) đại diện cho sự mở rộng của Internet vào đời sống hằng ngày. Nó tạo ra dữ liệu streaming và đòi hỏi dữ liệu được xử lý theo thời gian thực trong hầu hết các vấn đề của nó. Các mô hình bạn quen thuộc như batch không phù hợp với các vấn đề thời gian thực do IoT đặt ra. Ngay cả các mô hình tính toán tương tác cũng không thích hợp để xử lý liên tục theo thời gian thực. Khác với dữ liệu vận hành do các hệ thống nghiệp vụ của doanh nghiệp như tài chính, marketing tạo ra, vốn ngay cả khi được tạo theo dòng vẫn có thể lưu lịch sử để xử lý sau, dữ liệu sinh ra theo dòng trong các hiện tượng như IoT hay Internet sẽ hết hạn (hoặc không còn hợp lệ) ngay những khoảnh khắc sau khi được tạo, do đó yêu cầu xử lý tức thời. Ngoài thiết bị kết nối, các bài toán kinh doanh như chống gian lận, phân tích dữ liệu mạng xã hội, định vị địa lý đòi hỏi thời gian đáp ứng rất thấp, gần như dưới một giây. Để giải quyết vấn đề này trong bối cảnh Big Data, các kiến trúc λ đã được phát triển. Những kiến trúc này bổ sung hai lớp xử lý bổ sung lên MapReduce nhằm giảm độ trễ. Storm là một hiện thực phần mềm của kiến trúc λ. Nó cho phép các ứng dụng dưới Hadoop xử lý dữ liệu theo thời gian thực (hoặc gần thời gian thực).
ZooKeeper
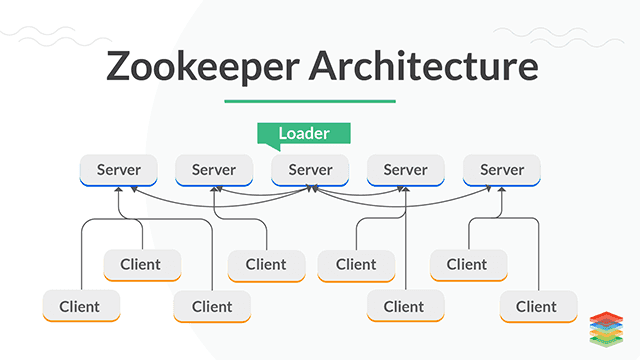
Đồng bộ hoặc phối hợp truyền thông giữa các nút khi thực thi tác vụ song song là một trong những vấn đề khó nhất trong phát triển ứng dụng phân tán. Để giải quyết vấn đề này, Hadoop đã đưa các công cụ phối hợp dịch vụ vào hệ sinh thái của mình, cụ thể là ZooKeeper. ZooKeeper xử lý sự phức tạp vốn có của việc đồng bộ thực thi các job phân tán trong cụm và giúp các công cụ khác trong hệ sinh thái Hadoop không phải tự xử lý vấn đề này. Nó cũng cho phép người dùng phát triển ứng dụng phân tán mà không cần là chuyên gia lập trình phân tán. Không đi sâu vào chi tiết phức tạp của việc phối hợp dữ liệu giữa các nút trong cụm Hadoop, ZooKeeper cung cấp dịch vụ cấu hình phân tán, dịch vụ phân phối và sổ đăng ký định danh cho các ứng dụng phân tán. ZooKeeper là cách Hadoop điều phối các job phân tán.
Oozie
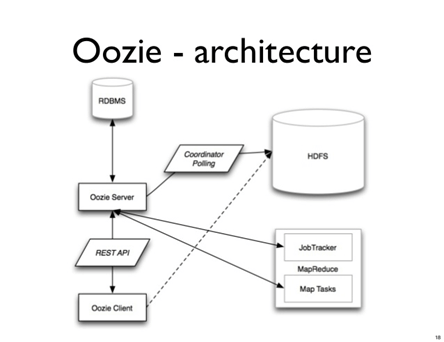
Mặc định, Hadoop thực thi các job theo thứ tự người dùng gửi lên mà không xét đến mối quan hệ giữa chúng. Tuy nhiên, các vấn đề mà Hadoop được dùng để giải quyết thường yêu cầu viết một hoặc nhiều job phức tạp. Khi hai job được gửi lên JobTracker (hoặc YARN), bộ này sẽ thực thi mà không chú ý đến liên kết giữa chúng, có thể gây lỗi (exception) và khiến mã bị dừng. Làm sao quản lý việc thực thi nhiều job liên quan đến cùng một vấn đề? Để quản lý kiểu vấn đề này, giải pháp đơn giản nhất hiện nay là dùng một bộ lập lịch job, cụ thể là Oozie.
Oozie là bộ lập lịch job chạy như một dịch vụ trên cụm Hadoop. Nó được dùng để lập lịch các job của Hadoop và nói rộng hơn là lập lịch thực thi mọi job có thể chạy trên cụm, như script Hive, job MapReduce, job Hama, job Storm, v.v. Nó được thiết kế để tự động quản lý việc thực thi tức thời hoặc trì hoãn của hàng nghìn job phụ thuộc lẫn nhau trên cụm Hadoop. Để dùng Oozie, bạn chỉ cần cấu hình 2 tệp XML: một tệp cấu hình engine Oozie và một tệp cấu hình workflow của job.
Giới thiệu Cloudera
Cloudera là công ty Mỹ có trụ sở tại California, chuyên phát triển giải pháp Big Data dựa trên nền tảng phân tán Hadoop theo lịch sử; hiện công ty đang tái định hướng lên đám mây. Hơn một năm qua, Cloudera đã mở rộng giải pháp của mình trên các đám mây công cộng AWS, Azure và GCP.
Giới thiệu CDP
Cloudera Data Platform (CDP) là một nền tảng cho phép doanh nghiệp phân tích dữ liệu với khả năng phân tích tự phục vụ trong môi trường lai và đa đám mây. Nó cho phép tổ chức khai thác nhiều giá trị hơn từ toàn bộ dữ liệu bằng cách tạo các data lake trên đám mây chỉ trong vài giờ.
CDP cung cấp các công cụ tích hợp, đa chức năng, tự phục vụ để phân tích và tập trung dữ liệu. Ngoài ra, nó mang lại bảo mật và quản trị trên toàn doanh nghiệp và có thể được triển khai trên môi trường đám mây công cộng, riêng tư và đa đám mây. CDP là bản phân phối kế tiếp sau hai bản phân phối Hadoop trước đây của Cloudera: Cloudera Distribution of Hadoop (CDH) và Hortonworks Data Platform (HDP).
Truy cập tự phục vụ vào dữ liệu doanh nghiệp là trọng tâm của dịch vụ này. Các dịch vụ đám mây mới được bổ sung và tích hợp vào nền tảng cũng cung cấp quyền truy cập tự phục vụ vào dữ liệu và phân tích cho nhà phân tích, nhà khoa học dữ liệu, chuyên viên CNTT và nhà phát triển. Những từ khóa giúp nền tảng khác biệt so với đối thủ là ba dịch vụ Cloud-Native CDP do Cloudera giới thiệu: tự phục vụ, đa đám mây và bảo mật.
CDP đưa ra cách tiếp cận công - tư độc đáo, phân tích dữ liệu thời gian thực, các tùy chọn triển khai linh hoạt tại chỗ, trên đám mây và lai, cùng kiến trúc ưu tiên quyền riêng tư.
CDP Public Cloud
CDP Public Cloud là Platform-as-a-Service (PaaS) tương thích với hạ tầng đám mây và dễ dàng di chuyển giữa nhiều nhà cung cấp đám mây, bao gồm cả giải pháp riêng như OpenShift. CDP được thiết kế để hoàn toàn lai và đa đám mây, nghĩa là một nền tảng duy nhất có thể quản lý tất cả các trường hợp sử dụng vòng đời dữ liệu. Nền tảng CDP có thể làm việc với dữ liệu trong nhiều thiết lập, bao gồm các đám mây công cộng như AWS, Azure và GCP. Ngoài ra, nó có thể tự động mở rộng hoặc thu hẹp khối lượng công việc và tài nguyên để cải thiện hiệu năng và giảm chi phí.
Các dịch vụ CDP Public Cloud
Dưới đây là những thành phần chính tạo nên CDP Public Cloud:
-
CDP Data Engineering là một thiết lập tất cả-trong-một. Nó được xây dựng trên Apache Spark. Nó tinh gọn các quy trình ETL trên các nhóm phân tích dữ liệu doanh nghiệp bằng cách cho phép điều phối và tự động hóa với Apache Airflow, và cung cấp các công cụ giám sát pipeline phát triển cao, gỡ lỗi trực quan và quản trị. Ngoài ra, nó có môi trường làm việc tách biệt, đóng gói container, có khả năng mở rộng và dễ di chuyển.
-
CDP Data Hub là dịch vụ cho phép phân tích giá trị cao từ Edge đến AI. Cloudera Data Hub là dịch vụ quản lý và phân tích dữ liệu gốc đám mây. Nó cho phép đội ngũ CNTT và nhà phát triển nghiệp vụ xây dựng ứng dụng kinh doanh nhanh hơn cho mọi kịch bản, từ streaming đến ETL. Data mart, cơ sở dữ liệu và Machine Learning chỉ là vài dịch vụ trong số dải khối lượng công việc phân tích rộng mà nó bao phủ.
-
CDP Data Warehouse là dịch vụ cho phép CNTT cung cấp trải nghiệm phân tích tự phục vụ gốc đám mây cho các nhà phân tích BI. Streaming, kỹ thuật dữ liệu và phân tích được tích hợp đầy đủ trong CDP Data Warehouse. Ngoài ra, nó có khung thống nhất để bảo mật và quản trị toàn bộ dữ liệu và metadata của bạn trên đám mây riêng, nhiều đám mây công cộng hoặc môi trường lai. Dịch vụ Cloudera Data Warehouse giúp dễ dàng triển khai các kho dữ liệu tự phục vụ cho nhà phân tích dữ liệu. Nó dựa trên các engine SQL vững chắc đã được kiểm chứng cấp doanh nghiệp. Hàng trăm người dùng có thể truy cập dữ liệu chỉ với một cú nhấp, cả tại chỗ lẫn trên đám mây. Tài nguyên có thể mở rộng theo nhu cầu, và quản lý khối lượng công việc cũng tự phục vụ với các công cụ trực quan.
-
CDP Machine Learning giúp dễ dàng triển khai các không gian làm việc Machine Learning cộng tác để các nhà khoa học dữ liệu tận dụng dữ liệu doanh nghiệp. Nó tối ưu hóa quy trình ML bằng các công cụ bản địa và toàn diện để triển khai, phân phối và giám sát mô hình. Với công cụ này, tổ chức có thể nhanh chóng triển khai các không gian làm việc Machine Learning chỉ bằng vài cú nhấp để cho phép truy cập tự phục vụ tới công cụ và dữ liệu cần cho quy trình ML. Thêm nữa, sao chép dữ liệu tại chỗ hoặc trên đám mây có thể thực hiện nhanh mà không ảnh hưởng đến bảo mật và quản trị. Các nhà khoa học dữ liệu cũng có thể chọn công cụ của họ trong khi tận dụng tài nguyên co giãn điều chỉnh theo nhu cầu. Huấn luyện mô hình, kỹ thuật dữ liệu, triển khai và quản trị mô hình được thực hiện nhanh qua giao diện tất cả-trong-một, loại bỏ nhu cầu chuyển đổi nền tảng.
-
Cloudera Data Visualization cho phép người dùng mô hình hóa dữ liệu trong kho dữ liệu ảo mà không cần loại bỏ hay cập nhật các cấu trúc hay bảng dữ liệu bên dưới, và truy vấn khối lượng dữ liệu lớn mà không phải liên tục nạp dữ liệu, từ đó tiết kiệm thời gian và chi phí.
-
Cloudera Operational Database là giải pháp được quản lý, tổng hợp phiên bản cụm bên dưới thành một cơ sở dữ liệu. Nó sẽ tự động mở rộng dựa trên mức sử dụng khối lượng công việc của cụm, cải thiện hiệu năng trong cùng hạ tầng và tự động khắc phục các vấn đề vận hành.
CDP Private Cloud
CDP Private Cloud phù hợp hơn cho các triển khai đám mây lai, cho phép tại chỗ kết nối với đám mây công cộng trong khi vẫn duy trì bảo mật và quản trị tích hợp, nhất quán. Xử lý và lưu trữ được tách rời trong CDP Private Cloud, cho phép cả hai cụm mở rộng độc lập. Có sẵn trên cụm CDP Private Cloud Base, Cloudera Shared Data Experience (SDX) cung cấp bảo mật, quản trị và quản lý metadata hợp nhất. Ngoài ra, người dùng CDP Private Cloud có thể nhanh chóng cấp phát và triển khai các dịch vụ Cloudera Data Warehousing và Cloudera Machine Learning và mở rộng chúng khi cần, sử dụng Management Console.
Các dịch vụ CDP Private Cloud
Một số thành phần của CDP Public Cloud, như Machine Learning và Data Warehouse, có sẵn trên CDP Private Cloud. Nó sử dụng một tập hợp các engine phân tích bao phủ streaming, kỹ thuật dữ liệu, data mart, cơ sở dữ liệu vận hành và khoa học dữ liệu để hỗ trợ các khối lượng công việc truyền thống.
Những điều cốt yếu về HDFS và MapReduce
HDFS là Hệ thống Tệp Phân tán của Hadoop và là thành phần trung tâm của Hadoop, cho phép lưu trữ và sao chép dữ liệu trên nhiều máy chủ. Kết hợp với YARN, nó gia tăng khả năng quản lý dữ liệu của cụm HDFS Hadoop và nhờ đó cho phép xử lý Big Data hiệu quả.
Bạn có thể chạy HDFS trên phần cứng thông dụng, giúp nó chịu lỗi rất tốt. Mỗi phần dữ liệu được lưu ở nhiều nơi và có thể phục hồi trong mọi tình huống. Ngoài ra, việc sao chép này giúp chống lại khả năng hỏng dữ liệu.
HDFS sử dụng NameNode và DataNode. DataNode là máy chủ tiêu chuẩn nơi dữ liệu được lưu trữ. NameNode chứa metadata (dữ liệu về dữ liệu được lưu ở các nút khác nhau). Ứng dụng chỉ tương tác với NameNode, và NameNode giao tiếp với các data node khi cần.
HDFS cũng tránh tắc nghẽn mạng bằng cách tập trung vào di chuyển thao tác thay vì di chuyển dữ liệu. Điều này có nghĩa là ứng dụng có thể truy cập dữ liệu ngay nơi nó được lưu. Thế mạnh cuối cùng là tính di động. Nó có thể chạy trên nhiều loại phần cứng khác nhau mà không gặp vấn đề tương thích.
Mapreduce là gì và nó hoạt động như thế nào?
MapReduce là engine xử lý của Apache Hadoop, trực tiếp phát triển từ MapReduce của Google. Ứng dụng MapReduce về cơ bản được viết bằng Java. Nó cho phép dễ dàng tính toán lượng dữ liệu khổng lồ bằng cách áp dụng các bước ánh xạ và rút gọn để tìm lời giải cho vấn đề đặt ra. Bước ánh xạ lấy một tập dữ liệu để chuyển thành tập dữ liệu khác bằng cách phân rã các phần tử riêng lẻ thành các cặp khóa/giá trị gọi là tuple. Bước rút gọn thứ hai lấy đầu ra từ quá trình ánh xạ và kết hợp các tuple dữ liệu thành một tập tuple nhỏ hơn.
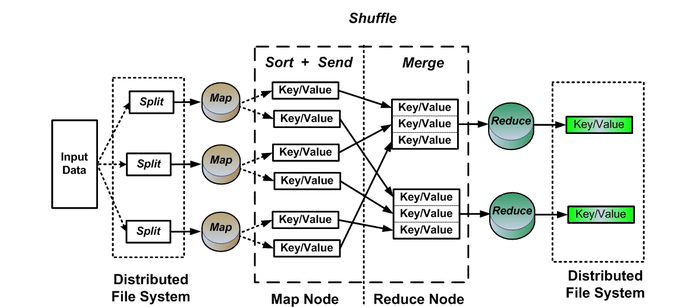
MapReduce là khung xử lý song song cao có thể dễ dàng mở rộng trên lượng lớn phần cứng thông dụng để đáp ứng nhu cầu ngày càng tăng trong xử lý khối lượng dữ liệu lớn. Khi các tác vụ ánh xạ và rút gọn chạy trơn tru, tất cả những gì cần thiết chỉ là thay đổi cấu hình để chạy trên tập dữ liệu lớn hơn. Kiểu khả năng mở rộng cực hạn này, từ một nút đến hàng trăm hay thậm chí hàng nghìn nút, là điều khiến MapReduce trở thành lựa chọn ưa thích của các chuyên gia Big Data trên toàn thế giới.
MapReduce cho phép một loạt khả năng, bao gồm:
- Nó cho phép xử lý song song cần thiết để thực hiện các tác vụ Big Data.
- Nó có thể áp dụng cho nhiều ứng dụng xử lý dữ liệu thương mại đa dạng
- Nó là giải pháp tiết kiệm chi phí cho các khung xử lý tập trung
- Nó có thể tích hợp với SQL để hỗ trợ năng lực xử lý song song.
Bản phân phối của Cloudera bao gồm Apache Hadoop
Cloudera là một trong những nhà cung cấp thuần túy lịch sử của Hadoop, bên cạnh Hortonworks và MapR. Tập đoàn được Intel hậu thuẫn phát triển CDH, một bản phân phối Hadoop bao gồm một số dự án nguồn mở khác như Impala và Search. Họ cũng cung cấp các tính năng bảo mật và tích hợp.
Khung Impala là engine truy vấn SQL tương tác cho phép truy vấn trực tiếp dữ liệu lưu trong HDFS, Apache HBase hoặc AWS S3. Engine này dựa trên các công nghệ và thành phần khác từ Hive, như cú pháp SQL (HiveSQL), trình điều khiển Open DataBase Connectivity và Query UI.
Thành phần Search dựa trên dự án Apache Solr, một engine tìm kiếm và lập chỉ mục dữ liệu xây dựng trên Lucene. Việc tích hợp công nghệ này trong CDH cho phép, ví dụ, khả năng lập chỉ mục gần như thời gian thực và truy cập dữ liệu lưu trong cụm Hadoop hoặc HBase. Công nghệ Solr cho phép tìm kiếm toàn văn bản phức tạp mà không cần kỹ năng SQL sâu. Solr cho phép bạn truy vấn dữ liệu Hadoop mà không cần di chuyển nó trước.
Cloudera cung cấp một số ấn bản CDH, mỗi ấn bản có các tính năng dịch vụ và quản lý cụm khác nhau, với các mức hỗ trợ khác nhau:
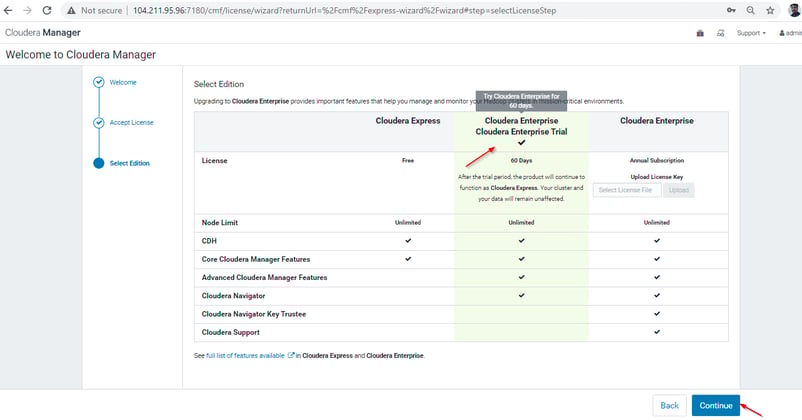
- Cloudera Express là phiên bản miễn phí của CDH, bao gồm các thành phần của CDH và các chức năng cốt lõi của Cloudera Manager. Ngoài ra, nó cung cấp quyền truy cập bản dùng thử 30 ngày của phiên bản Enterprise.
- Cloudera Manager là tháp điều khiển của CDH. Công cụ cung cấp bảng điều khiển quản trị dựa trên web để triển khai, quản lý, giám sát và kiểm soát tình trạng của các triển khai CDH. Nó cũng bao gồm API để cấu hình hệ thống và truy xuất số liệu cùng thông tin về hoạt động của cụm CDH.
- Cloudera Enterprise là phiên bản có phí, do đó có tính năng mở rộng. Nó bao gồm, ví dụ, các công cụ nâng cao trích xuất từ Cloudera Manager và Navigator.
- Cloudera Manager Advanced Features bổ sung các tính năng chủ chốt cho Cloudera Express: báo cáo vận hành, quản lý hạn ngạch, nhật ký cấu hình, cập nhật liên tục, khởi động lại dịch vụ, tích hợp Kerberos, tích hợp LDAP, hỗ trợ SNMP và khôi phục thảm họa tự động.
- Cloudera Navigator, chỉ đi kèm với các ấn bản Flex và Data Hub, cho phép quản lý bảo mật và quản trị dữ liệu trong một nền tảng CDH. Công cụ hỗ trợ các ràng buộc tuân thủ của doanh nghiệp. Với nó, quản lý dữ liệu, nhà phân tích và quản trị viên có thể khám phá khối lượng dữ liệu lớn lưu trong Hadoop và dễ dàng quản lý khóa mã hóa dùng để bảo vệ dữ liệu trong cụm CDH.
Để thiết lập môi trường thử nghiệm proof-of-concept, trước tiên bạn phải tải xuống và chạy trình cài đặt Cloudera Manager Server.
- Đầu tiên, bạn cần mở Cloudera Manager Downloads trong trình duyệt. Trong ô Cloudera Manager, nhấp Download Now. Bạn cũng có thể tải trình cài đặt cho phiên bản Cloudera Manager của mình. Ví dụ, với Cloudera Manager 6.3.3:
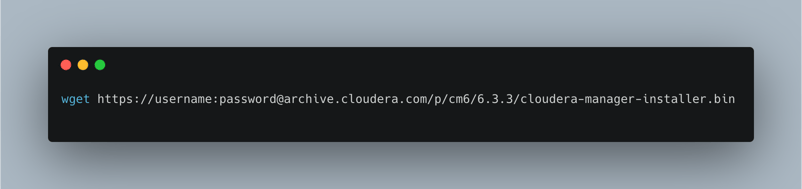
- Tiếp theo, bạn cần chạy Trình cài đặt Cloudera Manager.
Trước tiên, đổi Cloudera-manager-installer.bin để có quyền thực thi: chmod u+x Cloudera-manager-installer.bin
Để chạy trình cài đặt, dùng lệnh sau: sudo ./cloudera-manager-installer.bin --username=username --password=password
- Đọc và Chấp nhận Các Thỏa thuận Giấy phép Liên quan
Trình cài đặt sau đó:
- Cài đặt các tệp kho Cloudera Manager.
- Cài đặt Oracle JDK.
- Cài đặt Cloudera Manager Server và các gói PostgreSQL nhúng.
URL đầy đủ cho Bảng điều khiển Quản trị Cloudera Manager sẽ hiển thị khi cài đặt hoàn tất, bao gồm cả số cổng (mặc định 7180). Trước hết, hãy ghi lại URL này. Sau đó, nhấn Enter để chọn OK thoát trình cài đặt và xác nhận cài đặt thành công.
Bước tiếp theo là cài đặt CDH bằng Trình hướng dẫn.
- Truy cập Bảng điều khiển Quản trị Cloudera Manager bằng cách đăng nhập vào: HTTP://:7180, trong đó là FQDN hoặc địa chỉ IP của máy chủ đang chạy Cloudera Manager Server.
- Đăng nhập vào Bảng điều khiển Quản trị Cloudera Manager. Thông tin mặc định là:
**Username**: admin **Password**: admin
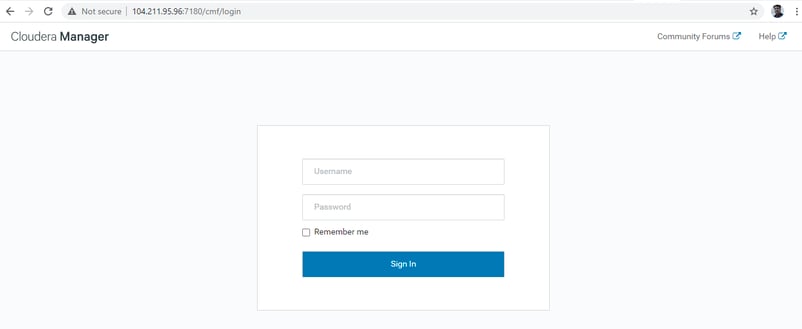
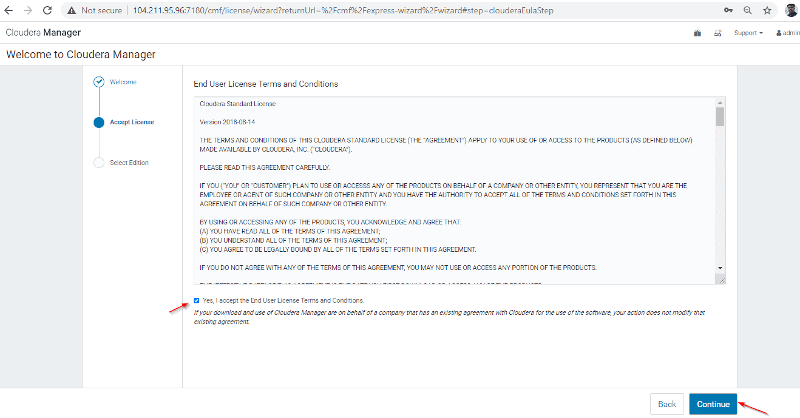
Đọc điều khoản và điều kiện và chấp nhận: Nhấp Continue, trình hướng dẫn cài đặt sẽ bắt đầu.
Trình hướng dẫn cài đặt cho Cloudera Manager sẽ đưa bạn qua một loạt bước như sau: Select Edition Bạn có thể chọn ấn bản để cài đặt, và tùy chọn cài thêm giấy phép.
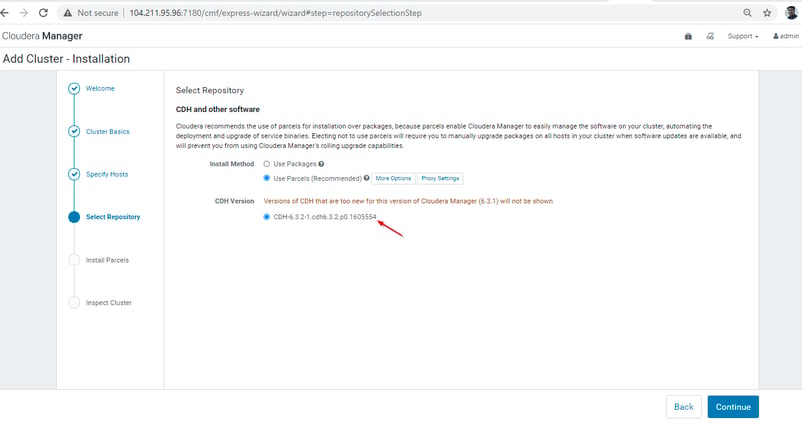
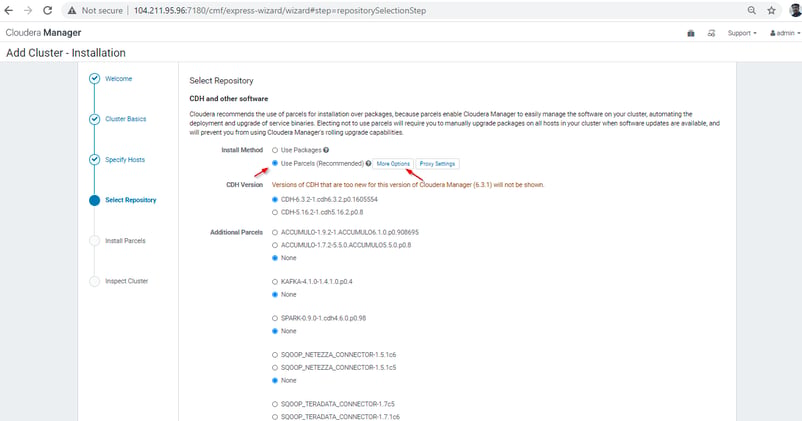
Specify Hosts Chọn các host sẽ dùng để chạy CDH và các dịch vụ được quản lý khác. Select Repository Ở đây bạn cần:
- Đầu tiên, chọn loại kho để dùng cho cài đặt. Khuyến nghị chọn Use Parcels cho cụm proof-of-concept này.
- Sau đó, bạn cần chọn phiên bản CDH để cài và bất kỳ Parcel bổ sung nào muốn cài.
- Bạn sẽ có thể chọn bản phát hành của Cloudera Manager Agent muốn cài đặt.
- Nhấp Continue.
Accept JDK License Khi cài phần mềm JDK, bạn đồng ý bị ràng buộc bởi Oracle Binary Code License Agreement. Sau khi đọc các điều khoản giấy phép và đánh dấu vào các ô áp dụng, nhấp Continue.
Enter Login Credentials Bằng cách định nghĩa tài khoản root, tên người dùng, phương thức xác thực, cổng ssh và số lượng host.
Install Agents Trang Install Agents hiển thị tiến độ cài đặt. Bạn có thể mở rộng chi tiết cho bất kỳ host nào để xem nhật ký cài đặt.
Install Parcels Trang Install Parcels hiển thị tiến độ cài đặt các parcel bạn đã chọn trước đó. Bạn có thể nhấp vào bất kỳ thanh tiến độ cụ thể nào để xem chi tiết về host đó.
Inspect Hosts Trang Inspect Hosts chạy Host Inspector để tìm các vấn đề cấu hình phổ biến. Xem kết quả và xử lý bất kỳ vấn đề nào được xác định. Sau đó, nhấp nút Run Again để cập nhật kết quả sau khi thực hiện các thay đổi.
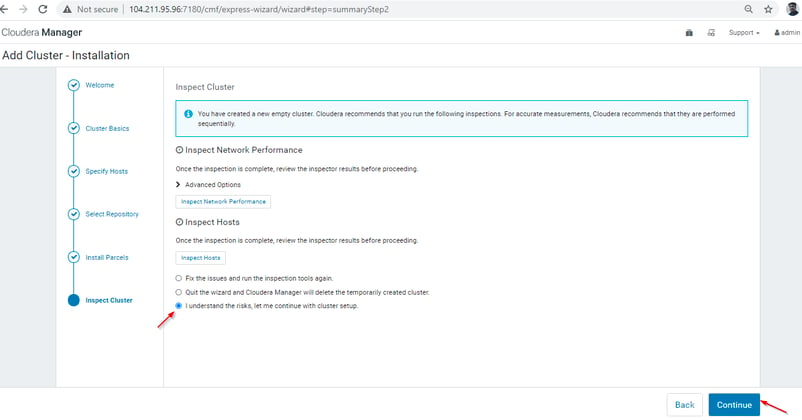
Sau khi hoàn tất tất cả các bước trên, trình hướng dẫn Thiết lập Cụm sẽ tự động khởi chạy.
Tóm tắt
Lợi ích mà Hadoop mang lại cho doanh nghiệp là đáng kể. Nhờ framework này, có thể lưu trữ và xử lý lượng dữ liệu lớn một cách nhanh chóng nhờ tính toán phân tán. Dữ liệu và ứng dụng đang được xử lý được bảo vệ trước lỗi phần cứng. Nếu một nút gặp sự cố, các job sẽ được chuyển hướng trực tiếp sang các nút khác để đảm bảo tính toán phân tán không bị gián đoạn. Nhiều bản sao của toàn bộ dữ liệu được lưu tự động. Bạn có thể đọc thêm về các câu chuyện thành công tại đây, và theo dõi blog của chúng tôi để cập nhật thêm về khoa học dữ liệu.


Apache Hadoop là gì?
Hadoop là một framework Java mã nguồn mở dành cho ứng dụng phân tán và quản lý dữ liệu cường độ cao. Nó cho phép ứng dụng làm việc với hàng nghìn nút và petabyte dữ liệu. Hadoop lấy cảm hứng từ các công bố của Google về MapReduce, GoogleFS và BigTable.
Nhờ framework MapReduce, nó có thể xử lý lượng dữ liệu khổng lồ. Thay vì di chuyển dữ liệu qua mạng để xử lý, MapReduce cho phép phần mềm xử lý di chuyển thẳng đến dữ liệu.
Nó không phải là một sản phẩm theo nghĩa đen, mà là một khung hướng dẫn cho lưu trữ và xử lý dữ liệu phân tán. Nhiều nhà cung cấp phần mềm đã sử dụng Hadoop để tạo ra các sản phẩm quản lý Big Data thương mại.
Hệ thống dữ liệu Hadoop không bị giới hạn về quy mô, nghĩa là có thể bổ sung thêm phần cứng và cụm để hỗ trợ tải nặng hơn mà không cần cấu hình lại hay mua giấy phép phần mềm đắt đỏ.
Lịch sử Apache Hadoop và các xu hướng
Cloudera được đồng sáng lập năm 2008 bởi nhà toán học Jeff Hammerbach, cựu nhân viên Bear Stearns và Facebook. Ông phụ trách phân tích dữ liệu và phát triển chương trình cho mục tiêu quảng cáo tốt hơn. Các đồng sáng lập khác là Christophe Bisciglia, cựu nhân viên Google; Amr Awadallah, cựu nhân viên Yahoo cũng từng làm việc với Hadoop; và Mike Olson, CEO của Cloudera. Kiến trúc sư trưởng là Doug Cutting, người đứng sau engine lập chỉ mục Lucene và nền tảng phân tán Hadoop.
Năm 2018 Cloudera sáp nhập với đối thủ chính: Hortonworks. Công ty sau đó bắt đầu tái định hướng kinh doanh để mở ra thế giới đám mây. Năm 2021, Cloudera được hai quỹ đầu tư tư nhân KKR và Clayton Dubilier & Rice mua lại với giá 5,3 tỷ đô la, mang lại nền tảng vững chắc để tiếp tục mở rộng thị trường.
Hadoop bắt đầu với Doug Cutting và Mike Cafarella vào năm 2002 khi họ cùng làm việc trên dự án Apache Nutch. Dự án Apache Nutch tạo ra hệ thống công cụ tìm kiếm có thể lập chỉ mục 1 tỷ trang. Sau nhiều nghiên cứu về Nutch, họ kết luận rằng một hệ thống như vậy sẽ tốn khoảng nửa triệu đô la phần cứng và chi phí vận hành hàng tháng khoảng 30.000 đô la, rất đắt đỏ. Do đó, họ nhận ra kiến trúc dự án của mình sẽ không thể vượt qua hàng tỷ trang web. Họ muốn một giải pháp có thể giảm chi phí triển khai và bài toán lưu trữ, xử lý các tập dữ liệu lớn.
Năm 2003, họ bắt gặp một bài báo mô tả kiến trúc hệ thống tệp phân tán của Google, gọi là GFS (Google File System), do Google công bố, để lưu trữ khối lượng dữ liệu khổng lồ. Họ biết rằng tài liệu này có thể giải quyết vấn đề lưu trữ các tệp lớn phát sinh do quá trình thu thập và lập chỉ mục web. Nhưng bài báo này chỉ là nửa lời giải cho vấn đề của họ.
Năm 2004, Google công bố một bài báo khác về kỹ thuật MapReduce, đây là lời giải cho việc xử lý các tập dữ liệu lớn đó. Bài báo này là nửa lời giải còn lại cho Doug Cutting và Mike Cafarella trong dự án Nutch. Những kỹ thuật này (GFS và MapReduce) lúc đó chỉ là bài báo trắng tại Google. Google chưa hiện thực hai kỹ thuật này. Doug Cutting biết từ kinh nghiệm với Apache Lucene rằng mã nguồn mở là cách tuyệt vời để lan tỏa công nghệ tới nhiều người. Vì vậy, cùng với Mike Cafarella, ông bắt đầu hiện thực các kỹ thuật của Google (GFS & MapReduce) trong mã nguồn mở trong dự án Apache Nutch.
Năm 2005, Cutting phát hiện Nutch bị giới hạn ở các cụm chỉ 20–40 nút. Ông nhanh chóng nhận ra hai vấn đề: (a) Nutch sẽ không đạt tiềm năng trừ khi hoạt động ổn định trên các cụm lớn nhất (b) Có vẻ như không thể với chỉ hai người (Doug Cutting & Mike Cafarella). Nhiệm vụ kỹ thuật trong dự án Nutch lớn hơn nhiều so với ông nghĩ, nên ông bắt đầu tìm việc tại công ty sẵn sàng đầu tư cho nỗ lực này. Ông phát hiện Yahoo! có một đội kỹ sư mạnh, háo hức làm việc trên dự án.
Năm 2006, Doug Cutting gia nhập Yahoo cùng dự án Nutch. Ông muốn cung cấp cho thế giới một framework tính toán mã nguồn mở, tin cậy và có khả năng mở rộng với sự hỗ trợ của Yahoo. Tại Yahoo, Cutting tách phần tính toán phân tán của Nutch và lập một dự án mới là Hadoop. Ông đặt tên dự án là Hadoop theo chú voi đồ chơi màu vàng của con trai; đây cũng là một từ độc đáo, dễ phát âm. Ông muốn tạo Hadoop theo cách hoạt động tốt trên hàng nghìn nút, và bắt đầu làm việc với Hadoop dùng GFS và MapReduce.
Năm 2007, Yahoo thử nghiệm thành công Hadoop trên cụm 1.000 nút và bắt đầu sử dụng.
Tháng 1 năm 2008, Yahoo phát hành Hadoop như một dự án mã nguồn mở cho ASF (Apache Software Foundation). Tháng 7 năm 2008, Apache Software Foundation thử nghiệm thành công cụm 4.000 nút với Hadoop.
Đến năm 2009, Hadoop đã thử nghiệm thành công việc sắp xếp một petabyte dữ liệu trong chưa đầy 17 giờ để xử lý hàng tỷ lượt tìm kiếm và lập chỉ mục hàng triệu trang web. Doug Cutting rời Yahoo và gia nhập Cloudera để đón nhận thách thức đưa Hadoop đến các ngành khác.