

Python में डेटा प्लॉट्स के सामान्य प्रकार
आइए उन सबसे आम डेटा प्लॉट्स से शुरू करें जो कई क्षेत्रों में व्यापक रूप से उपयोग होते हैं और अधिकांश Python डेटा विज़ुअलाइज़ेशन लाइब्रेरीज़ (कुछ बहुत ही संकीर्ण-विशेषीकृत लाइब्रेरीज़ को छोड़कर) में बनाए जा सकते हैं।
बार चार्ट
बार चार्ट श्रेणीबद्ध (categorical) डेटा के संख्यात्मक मानों को प्रदर्शित करने और विभिन्न श्रेणियों की तुलना करने के लिए सबसे सामान्य डेटा विज़ुअलाइज़ेशन है। श्रेणियों को समान चौड़ाई वाले आयताकार बार्स द्वारा दर्शाया जाता है, जिनकी ऊंचाई (वर्टिकल बार चार्ट्स के लिए) या लंबाई (हॉरिज़ॉन्टल बार चार्ट्स के लिए) संबंधित संख्यात्मक मानों के अनुपात में होती है।
matplotlib में एक बुनियादी बार चार्ट बनाने के लिए, हम matplotlib.pyplot.bar() फ़ंक्शन का उपयोग इस प्रकार करते हैं:
# Data preparation
penguins_grouped = penguins[['species', 'bill_length_mm']].groupby('species').mean().reset_index()
# Creating a bar chart
plt.bar(penguins_grouped['species'], penguins_grouped['bill_length_mm'])
plt.title('Average penguin bill length by species')
plt.show()
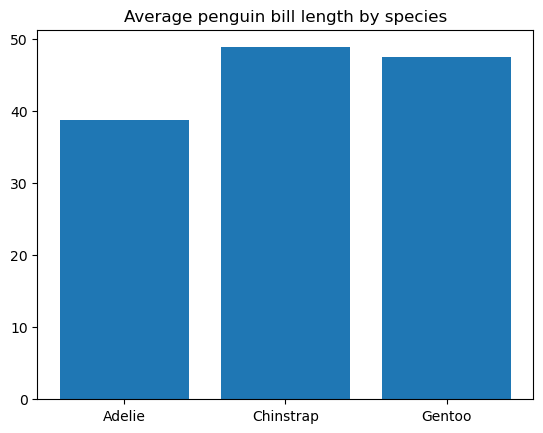
हम बार की चौड़ाई और रंग, किनारों की चौड़ाई और रंग समायोजित कर सकते हैं, बार्स पर टिक लेबल जोड़ सकते हैं, पैटर्न से भर सकते हैं, आदि।
लाइन प्लॉट
लाइन प्लॉट एक ऐसा चार्ट है जो x-अक्ष के साथ बाएं से दाएं किसी चर की प्रगति को सीधे रेखा खंडों से जुड़े डेटा बिंदुओं के माध्यम से दर्शाता है। प्रायः, किसी चर में समय के साथ होने वाले परिवर्तन को प्लॉट किया जाता है। वास्तव में, लाइन प्लॉट्स का उपयोग अक्सर टाइम सीरीज़ को विज़ुअलाइज़ करने के लिए किया जाता है, जैसा कि Matplotlib टाइम सीरीज़ लाइन प्लॉट्स ट्यूटोरियल में बताया गया है।
हम matplotlib में matplotlib.pyplot.plot() फ़ंक्शन का उपयोग करके एक बुनियादी लाइन प्लॉट इस प्रकार बना सकते हैं:
# Data preparation
flights_grouped = flights[['year', 'passengers']].astype({'year': 'string'}).groupby('year').sum().reset_index()
# Creating a line plot
plt.plot(flights_grouped['year'], flights_grouped['passengers'])
plt.title('Total number of passengers by year')
plt.show()
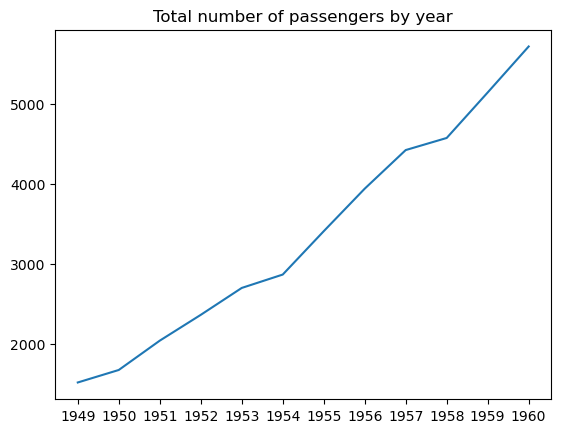
लाइन की चौड़ाई, शैली, रंग और पारदर्शिता समायोजित करना, मार्कर्स जोड़ना और उन्हें अनुकूलित करना संभव है।
Line Plots in MatplotLib with Python ट्यूटोरियल matplotlib में लाइन प्लॉट बनाने और अनुकूलित करने के और स्पष्टीकरण व उदाहरण देता है। seaborn में लाइन प्लॉट बनाने और अनुकूलित करने के लिए Python Seaborn Line Plot Tutorial: Create Data Visualizations पढ़ें।
स्कैटर प्लॉट
स्कैटर प्लॉट ऐसा विज़ुअलाइज़ेशन है जो द्वि-चर (दो चरों) के बीच संबंधों को निर्देशांक तल पर बिंदुओं के रूप में दर्शाता है। इसका उपयोग यह जांचने के लिए होता है कि क्या दोनों चरों में सहसंबंध है, वह कितना मजबूत है, और क्या डेटा में स्पष्ट क्लस्टर्स हैं।
नीचे दिया गया कोड matplotlib.pyplot.scatter() फ़ंक्शन का उपयोग करके matplotlib में एक बुनियादी स्कैटर प्लॉट बनाना दर्शाता है:
# Creating a scatter plot
plt.scatter(penguins['bill_length_mm'], penguins['bill_depth_mm'])
plt.title('Penguin bill length vs. bill depth')
plt.show()
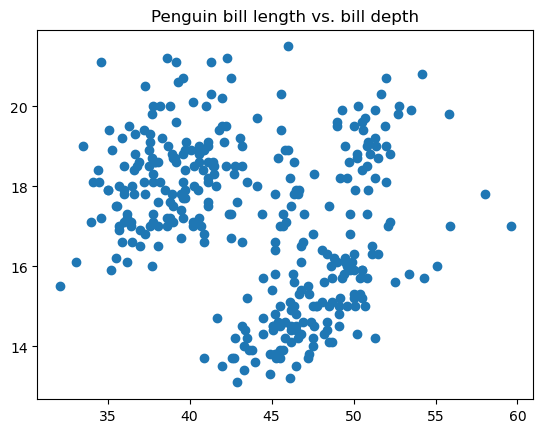
हम बिंदुओं के आकार, शैली, रंग, पारदर्शिता, किनारों की चौड़ाई और रंग आदि समायोजित कर सकते हैं।
स्कैटर प्लॉट्स (और अन्य) के बारे में अधिक पढ़ने के लिए यह ट्यूटोरियल देखें: Data Demystified: Data Visualizations that Capture Relationships.
हिस्टोग्राम
हिस्टोग्राम एक ऐसा प्लॉट है जो किसी संख्यात्मक चर के मानों के आवृत्ति-वितरण का प्रतिनिधित्व करता है। आंतरिक रूप से, यह डेटा को मान-परास समूहों (bins) में बांटता है, प्रत्येक बिन में आने वाले बिंदुओं की संख्या गिनता है, और हर बिन को एक वर्टिकल बार के रूप में दिखाता है, जिसकी ऊंचाई उस बिन की गिनती के अनुपात में होती है। हिस्टोग्राम को बार चार्ट का एक विशेष प्रकार माना जा सकता है, अंतर यह है कि bins सतत होने के कारण इसके सटे हुए बार्स के बीच अंतराल नहीं होते।
हम matplotlib.pyplot.hist() फ़ंक्शन का उपयोग करके matplotlib में आसानी से एक बुनियादी हिस्टोग्राम बना सकते हैं:
# Creating a histogram
plt.hist(penguins['bill_length_mm'])
plt.title('Penguin bill length distribution')
plt.show()
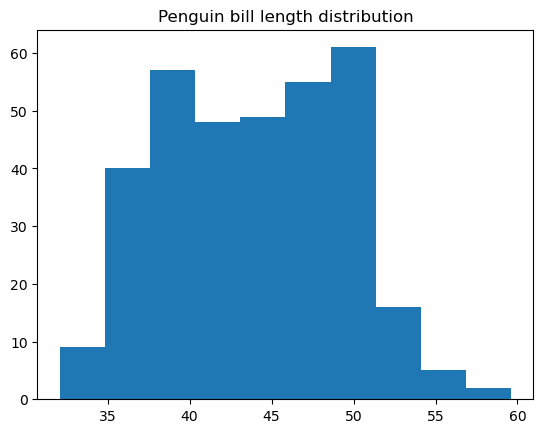
इस फ़ंक्शन के भीतर कई चीजें अनुकूलित की जा सकती हैं, जैसे हिस्टोग्राम का रंग और शैली, बिन्स की संख्या, बिन किनारे, बिन्स की निचली और ऊपरी सीमा, हिस्टोग्राम सामान्य है या संचयी, आदि।
अधिक हिस्टोग्राम उदाहरणों के लिए देखें Histograms in Matplotlib और How to Create a Histogram with Plotly।
बॉक्स प्लॉट
बॉक्स प्लॉट ऐसा प्लॉट है जो डेटा के पाँच वर्णनात्मक आँकड़े दिखाता है: न्यूनतम और अधिकतम मान (आउटलायर्स को छोड़कर), माध्यिका (median), और पहला व तीसरा क्वारटाइल। वैकल्पिक रूप से, यह औसत मान भी दिखा सकता है। यदि आप केवल इन आँकड़ों में रुचि रखते हैं और मूल वितरण में नहीं उतरना चाहते, तो बॉक्स प्लॉट उपयुक्त है।
11 Data Visualization Techniques for Every Use-Case with Examples ट्यूटोरियल में, अन्य बातों के साथ, यह भी विस्तार से बताया गया है कि बॉक्स प्लॉट से किस प्रकार की सांख्यिकीय जानकारी प्राप्त की जा सकती है।
हम matplotlib में matplotlib.pyplot.boxplot() फ़ंक्शन का उपयोग करके एक बुनियादी बॉक्स प्लॉट इस प्रकार बना सकते हैं:
# Data preparation
penguins_cleaned = penguins.dropna()
# Creating a box plot
plt.boxplot(penguins_cleaned['bill_length_mm'])
plt.title('Penguin bill length distribution')
plt.show()
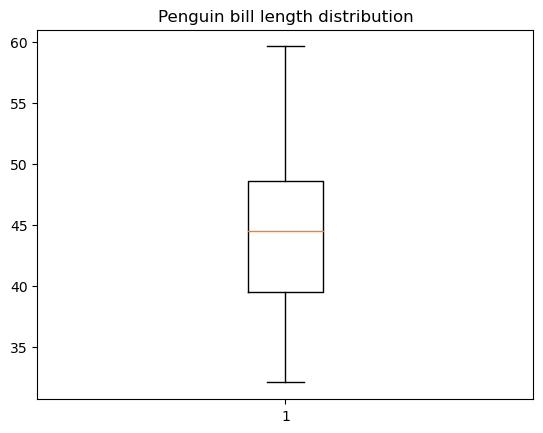
बॉक्स प्लॉट को काफी हद तक अनुकूलित किया जा सकता है: बॉक्स की चौड़ाई और उन्मुखीकरण, बॉक्स और व्हिस्कर की स्थिति, विभिन्न तत्वों की दृश्यता और शैली, आदि।
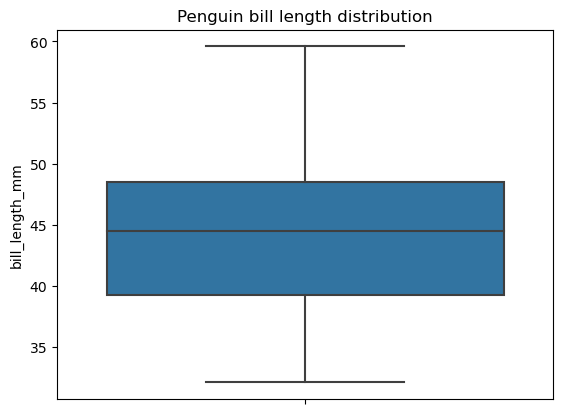
ध्यान दें कि इस फ़ंक्शन से बॉक्स प्लॉट बनाने के लिए, पहले यह सुनिश्चित करना होगा कि डेटा में missing values न हों। ऊपर दिए उदाहरण में, प्लॉटिंग से पहले हमने missing values हटा दी थीं। तुलना के लिए, Seaborn लाइब्रेरी में यह सीमा नहीं है और वह बैकग्राउंड में missing values को संभाल लेती है, जैसे नीचे:
# Creating a box plot
sns.boxplot(data=penguins, y='bill_length_mm')
plt.title('Penguin bill length distribution')
plt.show()
पाई चार्ट
पाई चार्ट एक वृत्त के रूप में दर्शाया जाता है जिसे सेक्टर्स में बाँटा गया होता है। प्रत्येक सेक्टर श्रेणीबद्ध डेटा की किसी श्रेणी के अनुरूप होता है, और सेक्टर का कोण उस श्रेणी के अनुपात को पूरे के हिस्से के रूप में दर्शाता है। बार चार्ट्स के विपरीत, पाई चार्ट्स का उद्देश्य उन श्रेणियों को दिखाना है जो मिलकर संपूर्ण बनाती हैं, जैसे किसी जहाज के यात्री।
पाई चार्ट्स की कुछ कमियां हैं:
- मानव आंख के लिए कोणों की व्याख्या लंबाइयों की तुलना में कठिन होती है और वे अक्सर भ्रामक हो सकते हैं।
- पांच या अधिक श्रेणियों के मामले में इनकी दक्षता कम हो जाती है।
- ये एक से अधिक श्रेणीबद्ध डेटा सेट प्रदर्शित नहीं कर सकते; यानी इन्हें बार चार्ट्स की तरह ग्रुप नहीं किया जा सकता।
- ये वास्तविक मानों को आसानी से प्रकट नहीं करते।
- जिन श्रेणियों के मानों में बहुत कम अंतर होता है, उनके मामले में ये सूचनात्मक नहीं होते।
इसलिए, पाई चार्ट्स का सीमित और सावधानीपूर्वक उपयोग करना चाहिए।
matplotlib में एक बुनियादी पाई चार्ट बनाने के लिए, हमें matplotlib.pyplot.pie() फ़ंक्शन का इस प्रकार उपयोग करना होगा:
# Data preparation
titanic_grouped = titanic.groupby('class')['pclass'].count().reset_index()
# Creating a pie chart
plt.pie(titanic_grouped['pclass'], labels=titanic_grouped['class'])
plt.title('Number of passengers by class')
plt.show()
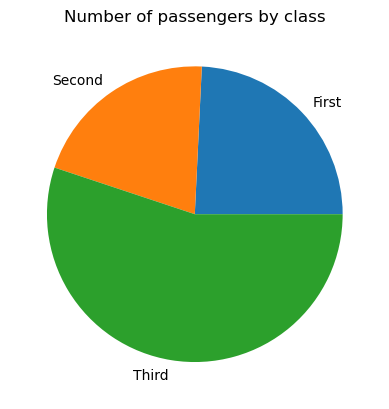
आवश्यकता होने पर, हम अपने पाई प्लॉट को समायोजित कर सकते हैं: वेज के रंग बदलना, कुछ वेज (आमतौर पर बहुत छोटे) को ऑफसेट करना, सर्कल का रेडियस बदलना, लेबल के फ़ॉर्मैट को अनुकूलित करना, कुछ या सभी वेज को पैटर्न से भरना, आदि।
पाई चार्ट्स पर गहराई से पढ़ने के लिए, जिनमें प्रतिशत जोड़ना और exploded slices शामिल हैं, देखें Python Pie Chart: Build and Style with Pandas and Matplotlib।
Python में उन्नत प्रकार के डेटा प्लॉट्स
इस खंड में, हम विभिन्न उन्नत डेटा प्लॉट्स का अन्वेषण करेंगे। इनमें से कुछ, पिछली धारा में बताए गए सामान्य विज़ुअलाइज़ेशन प्रकारों के परिष्कृत रूप हैं, जबकि कुछ स्वतंत्र प्रकार हैं।
ग्रुप्ड बार चार्ट
जहाँ सामान्य बार चार्ट का उपयोग किसी श्रेणीबद्ध चर के संख्यात्मक मानों को श्रेणी के अनुसार दिखाने के लिए होता है, वहीं ग्रुप्ड बार चार्ट वही उद्देश्य दो श्रेणीबद्ध चरों के पार पूरा करता है। ग्राफिक रूप से, इसका मतलब है कि हमारे पास कई बार समूह होते हैं; प्रत्येक समूह पहले चर की एक श्रेणी से संबंधित होता है और उन समूहों का हर बार दूसरे चर की किसी श्रेणी से संबंधित होता है। ग्रुप्ड बार चार्ट तब सबसे अच्छे काम करते हैं जब दूसरे चर में अधिकतम तीन श्रेणियाँ हों; अन्यथा, वे बहुत भरे-भरे लगते हैं और कम सहायक होते हैं।
सामान्य बार चार्ट की तरह, हम matplotlib से भी ग्रुप्ड बार चार्ट बना सकते हैं। हालांकि, Seaborn लाइब्रेरी का seaborn.barplot() फ़ंक्शन ऐसे प्लॉट्स के लिए अधिक सुविधाजनक है। चलिए पेंगुइन की चोंच की लंबाई के लिए दो श्रेणीबद्ध चरों—species और sex—के पार एक बुनियादी ग्रुप्ड बार चार्ट का उदाहरण देखते हैं।
# Creating a grouped bar chart
sns.barplot(data=penguins, x='species', y='bill_length_mm', hue='sex')
plt.title('Penguin bill length by species and sex')
plt.show()
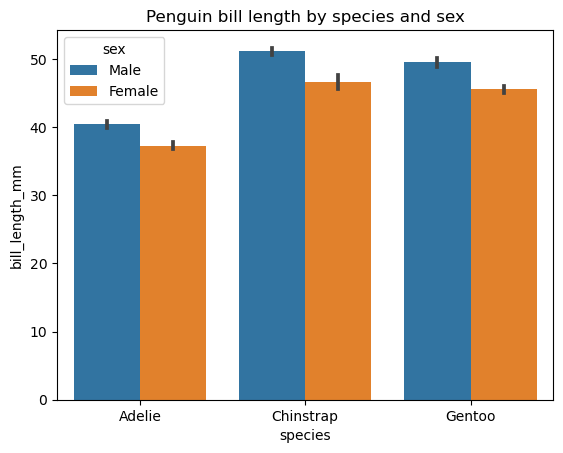
दूसरा श्रेणीबद्ध चर hue पैरामीटर के माध्यम से जोड़ा जाता है। इस फ़ंक्शन के अन्य वैकल्पिक पैरामीटर बार्स के उन्मुखीकरण, चौड़ाई, और रंग, श्रेणियों के क्रम, सांख्यिकीय एस्टिमेटर आदि को बदलने की सुविधा देते हैं।
Seaborn के साथ प्लॉटिंग में गहराई से जाने के लिए यह कोर्स देखें: Intermediate Data Visualization with Seaborn।
स्टैक्ड एरिया चार्ट
स्टैक्ड एरिया चार्ट एक सामान्य एरिया चार्ट (जो मूलतः एक लाइन प्लॉट है जिसमें रेखा के नीचे का क्षेत्र रंगा या पैटर्न से भरा होता है) का विस्तारित रूप है, जिसमें कई क्षेत्र होते हैं, प्रत्येक किसी विशिष्ट चर के अनुरूप, और वे एक-दूसरे के ऊपर स्टैक किए जाते हैं। ऐसे चार्ट तब उपयोगी होते हैं जब हमें चरों के एक समूह की समग्र प्रगति के साथ-साथ प्रत्येक चर के व्यक्तिगत योगदान को भी ट्रैक करना हो। लाइन प्लॉट्स की तरह, स्टैक्ड एरिया चार्ट भी प्रायः समय के साथ परिवर्तन दर्शाते हैं।
स्टैक्ड एरिया चार्ट की मुख्य सीमा ध्यान में रखें: ये अधिकतर सामान्य रुझान को पकड़ने में सहायक होते हैं, न कि स्टैक किए गए क्षेत्रों के सटीक मानों को।
matplotlib में एक बुनियादी स्टैक्ड एरिया चार्ट बनाने के लिए हम matplotlib.pyplot.stackplot() फ़ंक्शन का इस प्रकार उपयोग करते हैं:
# Data preparation
flights_grouped = flights.groupby(['year', 'month']).mean().reset_index()
flights_49_50 = pd.DataFrame(list(zip(flights_grouped.loc[:11, 'month'].tolist(), flights_grouped.loc[:11, 'passengers'].tolist(), flights_grouped.loc[12:23, 'passengers'].tolist())), columns=['month', '1949', '1950'])
# Creating a stacked area chart
plt.stackplot(flights_49_50['month'], flights_49_50['1949'], flights_49_50['1950'], labels=['1949', '1950'])
plt.title('Number of passengers in 1949 and 1950 by month')
plt.legend()
plt.show()
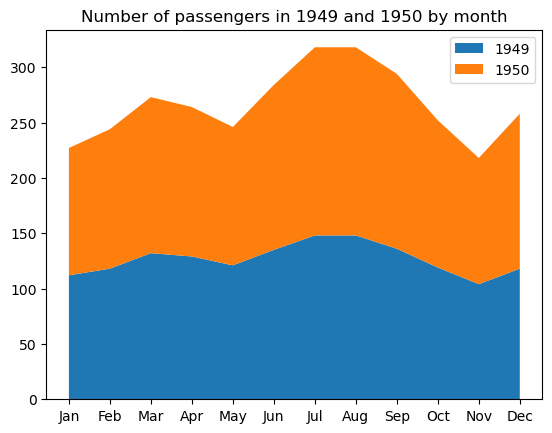
इस ग्राफ़ के कुछ अनुकूलन योग्य गुण हैं: क्षेत्रों के रंग, पारदर्शिता, भराव पैटर्न, रेखा की चौड़ाई, शैली, रंग, पारदर्शिता, आदि।
मल्टिपल बॉक्स प्लॉट
सामान्य प्रकारों वाले खंड में, हमने बॉक्स प्लॉट को एक ऐसा विज़ुअलाइज़ेशन बताया जो डेटा के पाँच वर्णनात्मक आँकड़े दिखाता है। कभी-कभी, हम इन आँकड़ों को किसी श्रेणीबद्ध चर की प्रत्येक श्रेणी के लिए अलग-अलग प्रदर्शित और तुलना करना चाहेंगे। ऐसे में, हमें एक ही प्लॉट एरिया पर कई बॉक्स प्लॉट करने होंगे, जिसे हम seaborn.boxplot() फ़ंक्शन से आसानी से कर सकते हैं, जैसे:
# Creating multiple box plots
sns.boxplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
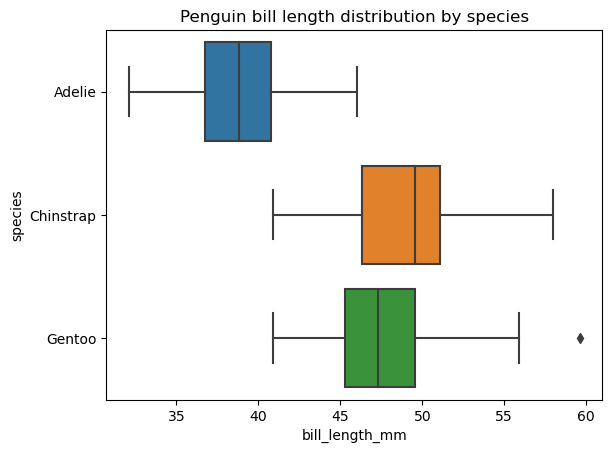
बॉक्स प्लॉट्स के क्रम, उन्मुखीकरण, रंग, पारदर्शिता, चौड़ाई, विभिन्न तत्वों के गुण, प्लॉट एरिया पर एक और श्रेणीबद्ध चर जोड़ना आदि बदले जा सकते हैं।
वायलिन प्लॉट
वायलिन प्लॉट बॉक्स प्लॉट जैसा ही होता है और वही समग्र आँकड़े दिखाता है, बस यह डेटा के वितरण के आकार को भी दर्शाता है। बॉक्स प्लॉट्स की तरह, हम किसी डेटा के लिए एक एकल वायलिन प्लॉट या, अधिकतर, किसी श्रेणीबद्ध चर की प्रत्येक श्रेणी के लिए कई वायलिन प्लॉट बना सकते हैं।
वायलिन प्लॉट्स बनाने और अनुकूलित करने के लिए seaborn, matplotlib की तुलना में अधिक सक्षम है। seaborn में एक बुनियादी वायलिन प्लॉट बनाने के लिए seaborn.violinplot() फ़ंक्शन का इस प्रकार उपयोग करें:
# Creating a violin plot
sns.violinplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
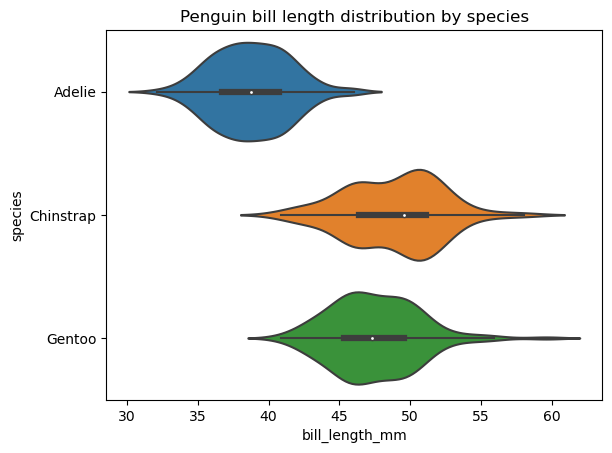
हम वायलिन्स के क्रम, उन्मुखीकरण, रंग, पारदर्शिता, चौड़ाई, विभिन्न तत्वों के गुण, वितरण को चरम डेटा बिंदुओं से आगे तक विस्तारित करना, प्लॉट एरिया पर एक और श्रेणीबद्ध चर जोड़ना, वायलिन के भीतर डेटा बिंदुओं के निरूपण का तरीका चुनना, आदि बदल सकते हैं।
हीटमैप
हीटमैप तालिका-शैली का विज़ुअलाइज़ेशन है जिसमें प्रत्येक संख्यात्मक डेटा बिंदु को चुने हुए कलर स्केल और डेटा सेट में उसकी परिमाण के अनुसार रंगित किया जाता है। इन प्लॉट्स का मुख्य विचार डेटा के संभावित हॉट और कोल्ड स्पॉट्स को उजागर करना है, जिन्हें विशेष ध्यान की आवश्यकता हो सकती है।
कई मामलों में, हीटमैप बनाने से पहले डेटा का कुछ प्रीप्रोसेसिंग आवश्यक होता है—आमतौर पर डेटा क्लीनिंग और नॉर्मलाइज़ेशन।
नीचे दिया गया कोड (आवश्यक प्रीप्रोसेसिंग के बाद) seaborn.heatmap() फ़ंक्शन का उपयोग करके एक बुनियादी हीटमैप बनाना दिखाता है:
# Data preparation
from sklearn import preprocessing
car_crashes_cleaned = car_crashes.drop(labels='abbrev', axis=1).iloc[0:10]
min_max_scaler = preprocessing.MinMaxScaler()
car_crashes_normalized = pd.DataFrame(min_max_scaler.fit_transform(car_crashes_cleaned.values), columns=car_crashes_cleaned.columns)
# Creating a heatmap
sns.heatmap(car_crashes_normalized, annot=True)
plt.title('Car crash heatmap for the first 10 car crashes')
plt.show()
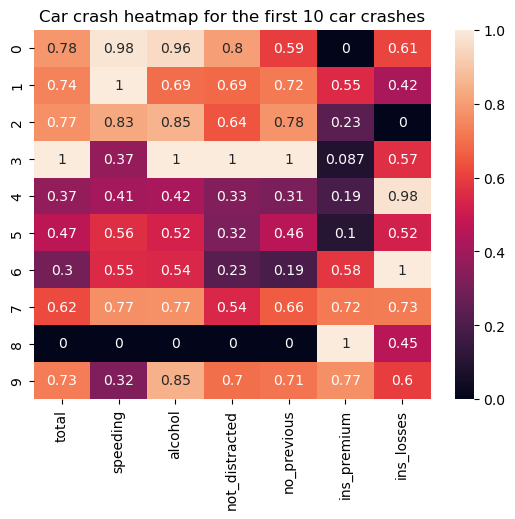
संभावित समायोजनों में कोलormap चुनना, एंकरिंग मान परिभाषित करना, एनोटेशन का फ़ॉर्मैट तय करना, विभाजक रेखाओं को कस्टमाइज़ करना, मास्क लगाना, आदि शामिल हैं।
कस्टम कोलormap और एनोटेशन सहित विस्तृत हीटमैप गाइड के लिए पढ़ें Seaborn Heatmaps: A Guide to Data Visualization।
Python में अपरंपरागत डेटा प्लॉट्स
अंत में, आइए कुछ कम उपयोग में आने वाले या कम जाने-माने डेटा विज़ुअलाइज़ेशन प्रकारों पर नज़र डालें। इनमें से कई के अधिक लोकप्रिय ग्राफ़ प्रकारों में कम से कम एक समकक्ष मौजूद हैं। फिर भी, कुछ खास मामलों में, ये अपरंपरागत विज़ुअलाइज़ेशन आमतौर पर उपयोग होने वाले प्लॉट्स की तुलना में अधिक प्रभावी साबित हो सकते हैं।
स्टेम प्लॉट
स्टेम प्लॉट वस्तुतः बार चार्ट को प्रदर्शित करने का एक और तरीका है; इसमें ठोस बार्स के बजाय पतली रेखाएँ होती हैं, जिनके शीर्ष पर वैकल्पिक मार्कर्स हो सकते हैं। स्टेम प्लॉट बार चार्ट का अनावश्यक वैरिएशन लग सकता है, परंतु जब कई श्रेणियों को विज़ुअलाइज़ करना हो, तब यह बेहतर विकल्प है। स्टेम प्लॉट्स का लाभ यह है कि उनका डेटा-इंक अनुपात बेहतर होता है, जिससे पठनीयता बढ़ती है।
matplotlib में एक बुनियादी स्टेम प्लॉट बनाने के लिए, हम matplotlib.pyplot.stem() फ़ंक्शन का इस प्रकार उपयोग करते हैं:
# Data preparation
fmri_grouped = fmri.groupby('subject')[['subject', 'signal']].max()
# Creating a stem plot
plt.stem(fmri_grouped['subject'], fmri_grouped['signal'])
plt.title('FMRI maximum signal by subject')
plt.show()
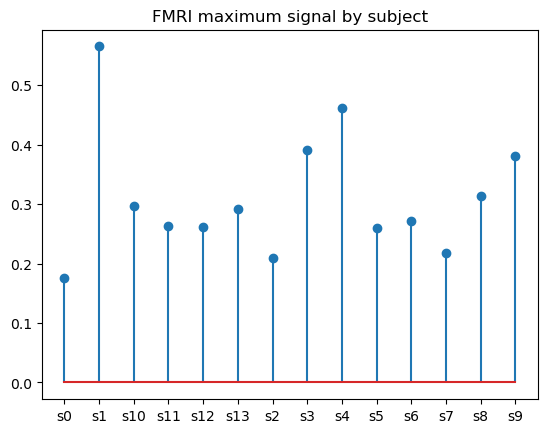
हम वैकल्पिक पैरामीटर्स के साथ स्टेम के उन्मुखीकरण को बदल सकते हैं और स्टेम, बेसलाइन तथा मार्कर के गुणों को अनुकूलित कर सकते हैं।
स्ट्रिप और स्वॉर्म प्लॉट्स
ये दोनों बहुत मिलते-जुलते विज़ुअलाइज़ेशन श्रेणीबद्ध चर के लिए स्कैटर प्लॉट के रूप में देखे जा सकते हैं: स्ट्रिप और स्वॉर्म दोनों प्लॉट डेटा वितरण के अंदरूनी हिस्से को दिखाते हैं, जिनमें सैम्पल साइज और व्यक्तिगत डेटा बिंदुओं की स्थिति शामिल होती है, परंतु वर्णनात्मक आँकड़े शामिल नहीं होते। मुख्य अंतर यह है कि स्ट्रिप प्लॉट में डेटा बिंदु एक-दूसरे पर चढ़ सकते हैं, जबकि स्वॉर्म प्लॉट में नहीं; स्वॉर्म प्लॉट में बिंदु श्रेणीबद्ध अक्ष के साथ समायोजित होकर लगते हैं।
ध्यान रखें कि स्ट्रिप और स्वॉर्म दोनों प्लॉट्स केवल अपेक्षाकृत छोटे डेटा सेट्स के लिए सहायक होते हैं।
यहाँ seaborn.stripplot() फ़ंक्शन से स्ट्रिप प्लॉट बनाने का तरीका है:
# Creating a strip plot
sns.stripplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
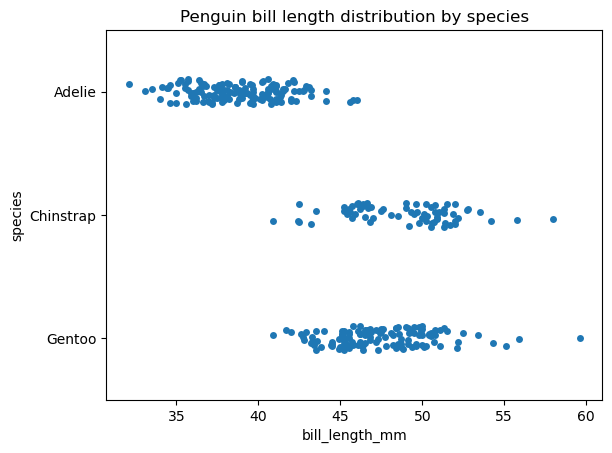
अब, उसी डेटा के लिए seaborn.swarmplot() फ़ंक्शन से स्वॉर्म प्लॉट बनाते हैं और अंतर देखते हैं:
# Creating a swarm plot
sns.swarmplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
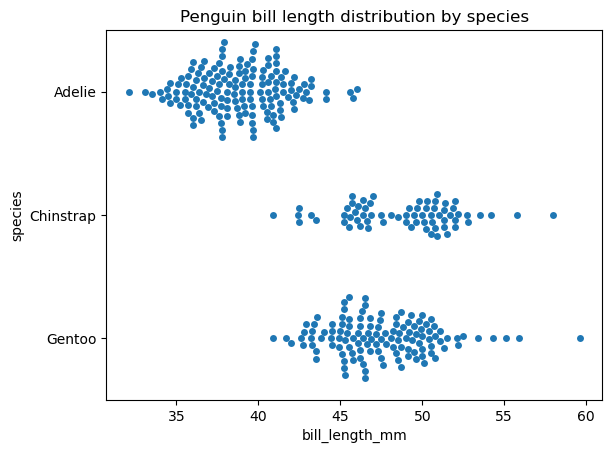
seaborn.stripplot() और seaborn.swarmplot() का सिंटैक्स काफी समान है। दोनों में कुछ अनुकूलन योग्य गुण हैं: प्लॉट का क्रम और उन्मुखीकरण, तथा मार्कर के गुण जैसे शैली, आकार, रंग, पारदर्शिता, आदि। स्ट्रिप प्लॉट में बिंदुओं के ओवरलैप को कम करने के लिए मार्कर की पारदर्शिता समायोजित करना सहायक होता है।
ट्रीमैप
ट्रीमैप ऐसा प्लॉट है जिसमें श्रेणीबद्ध डेटा के संख्यात्मक मानों को एक आयताकार फ्रेम के भीतर रखे गए आयतों के समूह के रूप में दिखाया जाता है; प्रत्येक आयत का क्षेत्रफल संबंधित श्रेणी के मान के अनुपात में होता है। उद्देश्य की दृष्टि से, ट्रीमैप्स बार चार्ट्स और पाई चार्ट्स के समान हैं। पाई चार्ट्स की तरह, ये प्रायः उन श्रेणियों को दर्शाने के लिए होते हैं जो मिलकर संपूर्ण बनती हैं। जब श्रेणियाँ दस तक हों और उनके मानों में स्पष्ट अंतर हो, तब ट्रीमैप्स प्रभावी और आकर्षक लग सकते हैं।
ट्रीमैप्स की कमियाँ पाई चार्ट्स जैसी ही हैं:
- क्षेत्रफल मानव आंख के लिए लंबाइयों की तुलना में समझना कठिन होता है और वे अक्सर भ्रामक हो सकते हैं।
- दस से अधिक श्रेणियों के मामले में इनकी दक्षता घटती है।
- ये एक से अधिक श्रेणीबद्ध डेटा सेट प्रदर्शित नहीं कर सकते; यानी इन्हें बार चार्ट्स की तरह ग्रुप नहीं किया जा सकता।
- ये वास्तविक मानों को आसानी से प्रकट नहीं करते।
- जिन श्रेणियों के मानों में बहुत कम अंतर होता है, उनके मामले में ये सूचनात्मक नहीं होते।
इन बिंदुओं को ध्यान में रखते हुए, ट्रीमैप्स का सीमित उपयोग करें और केवल तब जब वे सबसे उपयुक्त हों।
Python में ट्रीमैप बनाने के लिए, पहले squarify लाइब्रेरी इंस्टॉल और इम्पोर्ट करनी होगी: pip install squarify, फिर import squarify। नीचे दिया कोड एक बुनियादी ट्रीमैप बनाता है:
import squarify
# Data preparation
diamonds_grouped = diamonds[['cut', 'price']].groupby('cut').mean().reset_index()
# Creating a treemap
squarify.plot(sizes=diamonds_grouped['price'], label=diamonds_grouped['cut'])
plt.title('Average diamond price by cut')
plt.show()
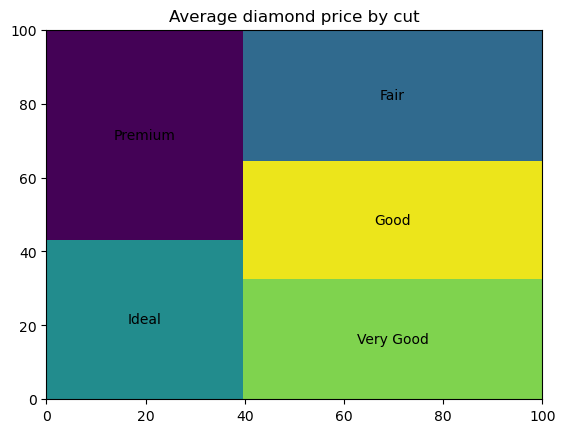
हम आयतों के रंग और पारदर्शिता को कस्टमाइज़ कर सकते हैं, उन्हें पैटर्न से भर सकते हैं, किनारों के गुण समायोजित कर सकते हैं, आयतों के बीच छोटा गैप जोड़ सकते हैं, और लेबल टेक्स्ट के गुणों को ट्यून कर सकते हैं।
Python में plotly लाइब्रेरी से ट्रीमैप बनाने का एक और तरीका भी है। इसके बारे में अधिक पढ़ने के लिए यह ट्यूटोरियल देखें: What is Data Visualization? A Guide for Data Scientists।
वर्ड क्लाउड
वर्ड क्लाउड पाठ्य (text) डेटा का ऐसा विज़ुअलाइज़ेशन है जिसमें प्रत्येक शब्द का फ़ॉन्ट आकार उस शब्द के इनपुट पाठ में आवृत्ति के अनुरूप होता है। वर्ड क्लाउड का उपयोग किसी पाठ में सबसे महत्वपूर्ण शब्दों की पहचान करने में मदद करता है।
हालाँकि वर्ड क्लाउड हमेशा आकर्षक होते हैं और किसी भी लक्ष्य दर्शक वर्ग के लिए सहज रूप से समझ में आते हैं, फिर भी हमें इस प्रकार के डेटा प्लॉट्स की कुछ अंतर्निहित सीमाओं के बारे में जागरूक रहना चाहिए:
- वर्ड क्लाउड बनाते समय अक्सर समय लेने वाली डेटा तैयारी करनी पड़ती है।
- ज्यादातर टेक्स्ट माइनिंग टूल्स की तरह वर्ड क्लाउड भी संदर्भ से रहित होते हैं और गलत व्याख्या की आशंका रहती है। उदाहरण के लिए, वे किसी टेक्स्ट में व्यंग्य, निषेध या शब्दों के अलंकारिक अर्थ को नहीं पकड़ते।
- ये स्पष्ट शब्द रैंकिंग नहीं देते। यानी हम सबसे आवृत्त शब्द, दूसरा, तीसरा, शायद चौथा तो अलग पहचान लेते हैं, फिर सब कुछ उतना साफ़ नहीं रहता।
- ये शब्द आवृत्तियों के सटीक मान नहीं दिखाते।
- ये एक दृष्टि भ्रम पैदा करते हैं कि लंबाई में बड़े शब्द, समान आवृत्ति वाले छोटे शब्दों से बड़े दिखते हैं।
- बहुत सारे वर्टिकल शब्द होना या मास्क लगाना ग्राफ़ की पठनीयता घटा देता है।
वर्ड क्लाउड का एक दिलचस्प और कम-ज्ञात उपयोग यह है कि हम उन्हें शब्द आवृत्ति के बजाय प्रत्येक शब्द को सौंपे गए किसी अन्य गुण के आधार पर भी बना सकते हैं। उदाहरण के लिए, हम देशों की एक डिक्शनरी बना सकते हैं, हर देश को उसकी जनसंख्या का मान दे सकते हैं और इन डाटा को प्रदर्शित कर सकते हैं।
Python में वर्ड क्लाउड बनाने के लिए हमें एक विशेष wordcloud लाइब्रेरी का उपयोग करना होगा। पहले इसे इंस्टॉल करना होगा (pip install wordcloud), फिर WordCloud क्लास और stopwords इम्पोर्ट करें: from wordcloud import WordCloud, STOPWORDS। नीचे दिया गया कोड एक बेसिक वर्ड क्लाउड जनरेट करता है:
from wordcloud import WordCloud, STOPWORDS
text = 'cat cat cat cat cat cat dog dog dog dog dog panda panda panda panda koala koala koala rabbit rabbit fox'
# Creating a word cloud
wordcloud = WordCloud().generate(text)
plt.imshow(wordcloud)
plt.title('Words by their frequency in the text')
plt.axis('off')
plt.show()
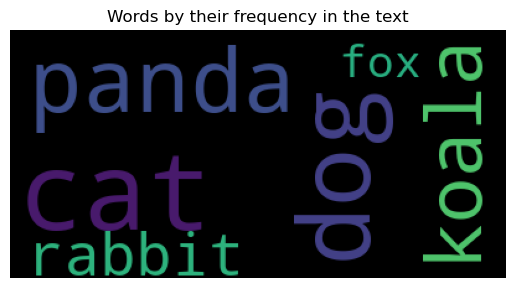
वर्ड क्लाउड के आयाम समायोजित करना, बैकग्राउंड रंग बदलना, शब्दों के प्रदर्शन के लिए कलरमैप देना, वर्टिकल की तुलना में हॉरिजॉन्टल शब्दों को प्राथमिकता देना, अधिकतम प्रदर्शित शब्दों की संख्या सीमित करना, स्टॉपवर्ड्स सूची अपडेट करना, फ़ॉन्ट साइज़ सीमित करना, शब्द कोलोकेशंस का ध्यान रखना, ग्राफ़ की पुनरुत्पादनशीलता सुनिश्चित करना आदि संभव है।
यदि आप Python में वर्ड क्लाउड के बारे में और सीखना चाहते हैं, तो यह बेहतरीन लेख देखें: Generating WordClouds in Python Tutorial।
त्वरित संदर्भ: सही प्लॉट कैसे चुनें
| प्लॉट का प्रकार | सबसे उपयुक्त | लाइब्रेरी | फ़ंक्शन |
|---|---|---|---|
| बार चार्ट | श्रेणियों की तुलना | matplotlib | plt.bar() |
| लाइन प्लॉट | समय के साथ रुझान | matplotlib | plt.plot() |
| स्कैटर प्लॉट | दो चरों के बीच सहसंबंध | matplotlib | plt.scatter() |
| हिस्टोग्राम | एकल चर का वितरण | matplotlib | plt.hist() |
| बॉक्स प्लॉट | सारांश आँकड़े और आउट्लायर | seaborn | sns.boxplot() |
| पाई चार्ट | कुल का हिस्सा (संयम से उपयोग करें) | matplotlib | plt.pie() |
| ग्रुप्ड बार चार्ट | दो चरों में श्रेणियाँ | seaborn | sns.barplot() |
| स्टैक्ड एरिया चार्ट | समय के साथ संचयी रुझान | matplotlib | plt.stackplot() |
| वायलिन प्लॉट | वितरण का आकार + आँकड़े | seaborn | sns.violinplot() |
| हीटमैप | मैट्रिक्स डेटा में पैटर्न | seaborn | sns.heatmap() |
| स्टेम प्लॉट | कई श्रेणियाँ (बार चार्ट से अधिक साफ़) | matplotlib | plt.stem() |
| स्ट्रिप / स्वॉर्म प्लॉट | श्रेणी के अनुसार व्यक्तिगत डेटा पॉइंट | seaborn | sns.stripplot() / sns.swarmplot() |
| ट्रीमैप | कुल के पदानुक्रमित हिस्से | squarify | squarify.plot() |
| वर्ड क्लाउड | टेक्स्ट में शब्द आवृत्ति | wordcloud | WordCloud() |
अंतिम विचार
मैंने इस लेख में 14 प्रकार के डेटा प्लॉट कवर किए हैं—रोज़मर्रा के बार चार्ट और स्कैटर प्लॉट से लेकर कम सामान्य ट्रीमैप और वर्ड क्लाउड तक। प्रत्येक प्लॉट प्रकार एक खास ज़रूरत पूरी करता है: बार चार्ट श्रेणियों की तुलना करते हैं, स्कैटर प्लॉट सहसंबंध दिखाते हैं, हीटमैप मैट्रिक्स डेटा में पैटर्न उजागर करते हैं, आदि।
यहाँ दिए गए कोड उदाहरण matplotlib और seaborn के डिफॉल्ट्स का उपयोग करते हैं, लेकिन दोनों लाइब्रेरीज़ में गहरी कस्टमाइज़ेशन की सुविधा है। सही प्लॉट चुनना दो सवालों पर आता है: आपके पास किस तरह का डेटा है, और आप कौन-सा संबंध दिखाना चाहते हैं?
कौन-सा प्लॉट प्रकार कब उपयोग करें, इस पर त्वरित संदर्भ के लिए देखें: 11 Data Visualization Techniques for Every Use-Case with Examples।
Python डेटा विज़ुअलाइज़ेशन के लिए कई टूल्स में से एक है। यदि आप अन्य परिवेशों में काम करते हैं, तो ये कोर्स देखने लायक हैं:

IBM प्रमाणित डेटा साइंटिस्ट (2020); इससे पहले विश्वभर में तेल और गैस क्षेत्रों के पेट्रोलियम भूविज्ञानी/जियोमॉडलर, 12+ वर्षों के अंतरराष्ट्रीय कार्य अनुभव के साथ। Python, R और SQL में दक्ष। विशेषज्ञता के क्षेत्र: डेटा क्लीनिंग, डेटा मैनिपुलेशन, डेटा विज़ुअलाइज़ेशन, डेटा विश्लेषण, डेटा मॉडलिंग, सांख्यिकी, स्टोरीटेलिंग, मशीन लर्निंग। डेटा साइंस समुदायों का प्रबंधन करने और डेटा साइंस व करियर विषयों पर लेखों व ट्यूटोरियल्स के लेखन/समीक्षा में व्यापक अनुभव।
डेटा प्लॉट बनाना एक्सप्लोरेटरी डेटा एनालिसिस का एक महत्वपूर्ण चरण है। कौन-सा विज़ुअलाइज़ेशन बनाना है, यह जानने से हम अपने डेटा से मूल्यवान, कई बार अप्रत्याशित, अंतर्दृष्टियाँ निकाल सकते हैं।
इस लेख में, मैं सामान्य से लेकर अनौपचारिक तक, डेटा प्लॉट्स के विभिन्न प्रकारों पर चर्चा करूंगा। हर प्लॉट प्रकार के लिए, मैं बताऊंगा कि वह क्या दिखाता है, कब उपयोग करना चाहिए, कब बचना चाहिए, और Python में उसे कैसे बनाना है।
संक्षेप में
Matplotlib, Seaborn, और Pandas इंस्टॉल करना
अपने प्लॉट्स पर अभ्यास करने के लिए कुछ डेटा पाने हेतु, पहले आवश्यक Python लाइब्रेरियाँ और Seaborn लाइब्रेरी के कुछ बिल्ट-इन डेटासेट्स डाउनलोड करते हैं:
हर प्रकार के डेटा प्लॉट के लिए, हम उसका एक बुनियादी उदाहरण बनाएंगे, न्यूनतम या बिना किसी कस्टमाइज़ेशन के, ताकि हर विधि कैसे काम करती है यह दिखाया जा सके। फिर भी, हम हर प्लॉट में एक उपयुक्त शीर्षक जोड़ेंगे ताकि वह अधिक अर्थपूर्ण लगे। कई उदाहरणों के लिए, हमें पहले से डेटा का प्रीप्रोसेसिंग करना होगा (कोड में # Data preparation के रूप में कॉमेंट किया गया है)।
हम अधिकतर matplotlib और Seaborn में काम करेंगे। यदि आप इन लाइब्रेरियों में प्लॉटिंग से परिचित नहीं हैं और एक त्वरित परिचय चाहिए, तो आप निम्नलिखित शिक्षण सामग्री देख सकते हैं:
Python डेटा विज़ुअलाइज़ेशन में गहराई से जाने के लिए, Data Visualization with Python स्किल ट्रैक देखें।