Wenn ein Chatbot schlechte Antworten gibt, ist der erste Reflex oft: den Prompt prüfen. Das funktioniert bei einem einzelnen LLM-Call. Bei Agenten, die Tool-Aufrufe tätigen, reicht das nicht mehr.
Genau diesen fehlenden Kontext liefern LLM-Observability-Plattformen. Sie sind keine herkömmlichen Monitoring-Tools. Klassische Tools zeigen Latenz und Fehlerraten. Eine LLM-Observability-Plattform zeigt dir, welcher Tool-Aufruf schlechte Ergebnisse zurückgab und ob eine Prompt-Änderung die Output-Qualität verbessert hat.
Sowohl Langfuse als auch LangSmith decken Tracing, Evaluation und Prompt-Management ab und haben Anfang 2026 große Updates veröffentlicht. Austauschbar sind sie trotzdem nicht. Am Ende entscheiden deine Deploy-Anforderungen, dein Tech-Stack und wie dein Team Evaluations durchführt.
Kurzfassung: Langfuse passt zu Teams, die Open-Source-Self-Hosting, Datenhoheit oder einen Stack außerhalb von LangChain brauchen. LangSmith passt zu Teams, die eine framework-agnostische Plattform mit integrierter Observability, Evaluation, Debugging und produktionsreifen Workflows für LLM-Anwendungen wollen. Wenn beides nicht zutrifft, schau dir die Preise an.
Was sind Langfuse und LangSmith?
Beide Produkte machen LLM-Anwendungen beobachtbar, testbar und debugbar. Das steckt jeweils dahinter:
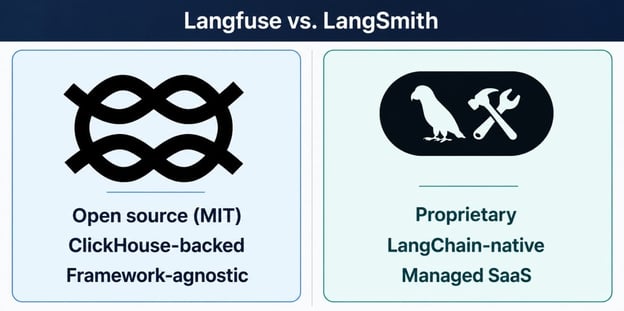
Überblick zur Positionierung von Langfuse vs. LangSmith. Bild: Autor.
Was ist Langfuse?
Langfuse ist eine Open-Source-Plattform für LLM-Engineering, gestartet 2023. Sie bietet Tracing, Prompt-Management, Evaluation (LLM-as-judge, Human Annotation und Code-basierte Checks), Datensatz-Experimente sowie Kosten- und Latenz-Monitoring. Das Open-Source-Core-Produkt ist unter MIT-Lizenz verfügbar.
Im Januar 2026 kündigte ClickHouse eine Series-D über 400 Millionen US-Dollar an und übernahm Langfuse. Langfuse ist nun Teil von ClickHouse, der spaltenorientierten Datenbank, die bereits das Langfuse-Backend betrieb. Die MIT-Lizenz und die Open-Source-Identität blieben laut Ankündigung unverändert.
Langfuse läuft als Managed Cloud Service mit Regionen in den USA, der EU und Japan oder als selbstgehostete Open-Source-Instanz ohne Softwarelizenzkosten.
Was ist LangSmith?
LangSmith ist eine framework-agnostische Observability- und Evaluationsplattform von LangChain Inc., dem Team hinter LangChain, LangGraph und Deep Agents. Die Plattform ist proprietär und Closed Source. LangChain sammelte im Oktober 2025 125 Millionen US-Dollar bei einer Bewertung von 1,25 Milliarden US-Dollar ein.
Zu den Hauptfunktionen zählen Tracing über einen gesamten Run, visuelles Debugging, automatisierte Evaluations, Produktionsmonitoring sowie Prompt-Management über Prompt Hub und Playground. Im Mai 2026 startete LangChain SmithDB, eine Rust-basierte Datenschicht, die inzwischen 100% der US-Cloud-Ingestion von LangSmith verarbeitet. SmithDB ist auf die speziellen Datenlasten von LLM-Anwendungen ausgelegt und senkt die P50-Ladezeit von Trace-Bäumen auf 92 Millisekunden sowie die Volltextsuchtzeit auf 400 Millisekunden.
LangSmith ist als Managed Cloud Service, als BYOC-Deployment (Daten im VPC des Kunden) oder als selbstgehostete Enterprise-Variante verfügbar. Außerdem kündigte LangChain an, dass selbstgehostetes LangSmith Bring-Your-Own-Key (BYOK) für Engine unterstützt, den In‑Platform-Agenten zum Finden und Beheben von Fehlern in LLM-Anwendungen.
Open Source vs. Managed SaaS
Der Kernunterschied ist nicht einfach „Open Source vs. nicht Open Source“. Es geht um Kontrolle und Portabilität auf der einen Seite sowie gemanagte Workflows auf der anderen. Mit Langfuse kannst du den Stack in deiner eigenen Infrastruktur ohne Lizenzkosten betreiben. LangSmith bietet Managed Cloud, BYOC und Self-Hosting mit tiefem nativen Support für LangChain, LangGraph und Deep Agents – ohne Pflicht, diese Frameworks zu nutzen.
Ein Update ändert die Perspektive: LangSmith unterstützt OpenTelemetry-Tracing über das langsmith[otel]-Paket und die Umgebungsvariable LANGSMITH_OTEL_ENABLED=true. Das ist eine von mehreren Möglichkeiten, LangSmith mit Non‑LangChain-Anwendungen einzusetzen.
So sind die beiden Plattformen strukturiert positioniert:
|
Dimension
|
Langfuse
|
LangSmith
|
|
Quellmodell
|
Open Source (MIT)
|
Proprietär, Closed Source
|
|
Self-Hosting
|
Kostenloses MIT-Self-Hosting; Enterprise-Controls kostenpflichtig
|
Enterprise-Vertrag erforderlich
|
|
Framework-Ansatz
|
Framework-übergreifend; breite Integrationen; OTel-native
|
Framework-übergreifend; OTel-Support
|
|
Datenhoheit
|
Vollständig; Air-Gap-Deployment möglich
|
Hybride und selbstgehostete Optionen für Enterprise-Kunden
|
|
Backend-Datenbank
|
ClickHouse
|
SmithDB (Rust/DataFusion)
|
|
Preismodell
|
Einheitenbasiert (Traces + Observations + Scores)
|
Seat-basiert plus Trace-basiert mit zwei Retention-Tiers
|
|
Compliance
|
SOC 2 Typ II, ISO 27001, GDPR, HIPAA
|
SOC 2 Typ II, GDPR, HIPAA
|
Im Folgenden zeige ich, was diese Unterschiede in der Praxis bedeuten.
Tracing und Observability
Beim Tracing beginnen sich die Produkte zu unterscheiden. Beide erfassen LLM-Calls, Tool-Aufrufe und Metadaten. In Agenten-Workflows werden die Unterschiede schneller sichtbar als in einfachen Prompt-Response-Apps.
Request Tracing
Langfuse baut hierarchische Traces, die LLM-Calls, Tool-Aufrufe, Embeddings und Retrieval-Schritte erfassen. Du kannst nach User, Session, Kosten, Latenz oder Custom-Metadaten filtern. Im Mai 2026 kam Volltextsuche auf Basis der nativen FTS-Engine von ClickHouse hinzu – Suchzeiten sanken von zuvor knapp 20 Sekunden auf unter eine halbe Sekunde.
LangSmith erfasst jeden LLM-Call und jede Tool-Nutzung als inspizierbaren Run-Tree. Mit SmithDB für die US-Cloud-Ingestion laden Trace-Bäume bei P50 in 92 Millisekunden. Außerdem gibt es unüberwachtes Topic-Clustering, das Traces nach Themen gruppiert – ein guter Startpunkt, wenn unklar ist, wo das Problem liegt.
Sichtbarkeit von Agent-Workflows
Langfuse führte im November 2025 Agent Graphs ein. Sie visualisieren den Ausführungsfluss mehrstufiger Agenten, indem sie die Graph-Struktur aus Timings und Verschachtelung der Observations ableiten. Funktioniert mit jedem instrumentierten Framework, inklusive nativer LangGraph-Unterstützung. Zeitgleich kam die Trace Log View hinzu, die eine flache Ereignisfolge von Agent-Schritten zeigt – hilfreich bei stark verzweigten oder loopenden Workflows.
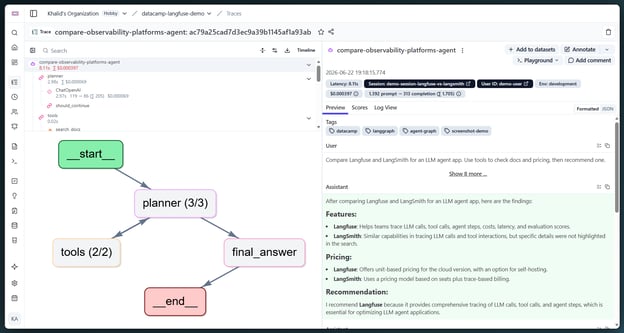
Langfuse-Agent-Graph für LangGraph-Ausführung. Bild: Autor.
LangSmiths LangGraph-Tracing erfasst jeden Node, jede Edge und jeden Zustandsübergang eines Runs – ohne weitere Konfiguration außer einer Umgebungsvariable. In LangSmith Studio kannst du die Agent-Ausführung schrittweise durchgehen, den Zustand an jedem Node inspizieren und einen Trace mit anderem Modell oder Prompt erneut abspielen. In einer LangGraph-App liefert das mehr Kontext als ein generischer Trace-Baum.Im September 2026 veröffentlichte LangSmith Trajectories, um Traces leichter zu debuggen und mit Fachexpertinnen und -experten in Feedback-Loops einzubinden.
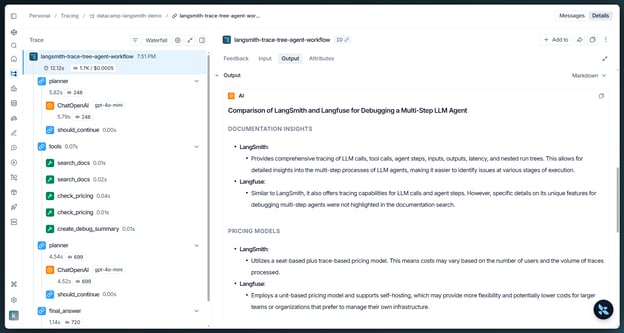
LangSmith-Trace-Baum für einen Agent-Workflow. Bild: Autor.
Monitoring in Produktion
Für das Produktionsmonitoring tracken beide Plattformen Latenz, Token-Nutzung, Kosten und Fehlerraten. LangSmith bietet PagerDuty- und Webhook-Alerts für Incidents sowie Monitoring-Workflows, die an Traces und Evaluations gekoppelt sind. Langfuse bietet Budgetwarnungen mit konfigurierbaren Schwellenwerten. Auf dieser Ebene sind die Monitoring-Funktionen ähnlich.
Offline- und Online-Evaluation
Tracing zeigt, was passiert ist. Evaluation zeigt, ob es gut war. In der Praxis sind diese Tools nützlicher, wenn Evaluation Teil des Workflows ist – nicht nur ein Pre-Launch-Häkchen.
LLM-as-a-judge und Code-Evaluatoren
Langfuses LLM-as-judge ist seit Juni 2025 vollständig Open Source unter MIT. Jede selbstgehostete Instanz ab v3.65.0 nutzt sie ohne kommerzielle Lizenz. Im Mai 2026 veröffentlichte Langfuse Code Evaluators: Python- oder TypeScript-evaluate-Funktionen, die du direkt in der Langfuse-UI schreibst. Sie führen deterministische Checks aus – etwa JSON-Schema-Validierung, Regex-Validierung oder die Prüfung von Tool-Argumenten – ohne Token-Kosten oder Judge-Model-Calls.
LangSmith bietet konfigurierbare LLM-as-judge-Evaluatoren mit Booleschen, kategorialen und kontinuierlichen Feedback-Typen sowie Templates für Security, Safety und Quality. Unterstützt wird außerdem Few-Shot-Korrektur: Menschlich gekennzeichnete Korrekturen fließen als Few-Shot-Beispiele zurück, um die Kalibrierung des Evaluators über die Zeit zu verbessern.
Datasets, Experimente und Human Annotation
Offline-Evaluation funktioniert in beiden Plattformen über Datasets und Side-by-Side-Experimentvergleiche. Langfuse ergänzte im November 2025 Score Analytics, um die Übereinstimmung der Evaluatoren nach Precision, Recall, F1, Kosten und Accuracy zu messen. Ebenfalls im November 2025 kam Baseline Comparison: Du markierst einen Run als Referenz und erkennst Regressionen dagegen.
Die GitHub-Actions-CI/CD-Integration von Langfuse, veröffentlicht im Mai 2026 über langfuse/experiment-action, lässt Workflows fehlschlagen, wenn Experiment-Scores unter einen Schwellwert fallen. Damit wird Evaluation zum Deployment-Gate statt zur Nachher-Prüfung.
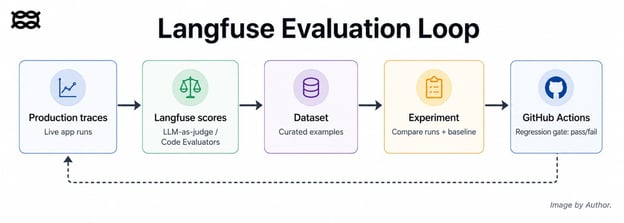
Langfuse-Evaluationsschleife mit GitHub Actions. Bild: Autor.
Bei LangSmith gibt es einen wichtigen Billing-Aspekt: Evaluatoren, die Feedback zu Traces hinzufügen, können diese Traces auf erweiterte Retention hochstufen. Wie im Preisabschnitt beschrieben, beeinflusst das die Kosten von Evaluations-Workflows.
Prompt-Versionierung, Deployment und A/B-Tests
Prompt-Management ist hier mehr als Versionshistorie. Der Workflow lautet: in der Sandbox iterieren, gegen einen Datensatz testen, in Produktion heben und bei Bedarf sauber zurückrollen.
Langfuse vergibt für jede Prompt-Version eine Versions-ID und nutzt Labels wie production und staging, um zu steuern, welche Version live ist. Das Ändern eines Labels in der UI ist dein Deploy- oder Rollback-Mechanismus. Prompts werden clientseitig im SDK gecacht, sodass Produktivaufrufe keine zusätzliche Latenz durch das Fetching der aktiven Version haben. Geschützte Labels erlauben Admins, festzulegen, welche Rollen das production-Label ändern dürfen – wichtig bei Teams mit unterschiedlich weitreichenden Berechtigungen.
LangSmith verwaltet Prompts über Prompt und Context Hub mit Commit-Hash-Versionierung, um exakt definierte Versionen programmgesteuert zu pinnen. Der Prompt Hub enthält eine Community-Bibliothek, die es bei Langfuse so nicht gibt. A/B-Tests über Datensatz-Experimente sind auf beiden Plattformen verfügbar.
In dieser Kategorie liegen die Produkte näher beieinander als bei Hosting, Preisgestaltung oder Framework-Setup.
Langfuse vs. LangSmith für Agenten-Anwendungen
Agenten haben viele Features der letzten zwölf Monate getrieben. Hier zählt, worauf der Agent gebaut ist.
Langfuse zeigt verfügbare Tools an, markiert aufgerufene Tools und zeigt Argumente sowie Call-IDs. Erweiterte Observation-Typen unterscheiden Tool-Calls, Embeddings und Guardrail-Calls in der Trace-Ansicht. Wie oben erwähnt, können Code Evaluators Tool-Argumente auch gegen ein Schema prüfen. Der MCP-Server wurde im Mai 2026 auf 15 Toolkategorien ausgebaut, sodass Agenten in Claude Code, Cursor oder OpenAI Codex Langfuse-Daten programmatisch abfragen können.
Der LangGraph-Punkt aus dem Tracing-Teil gilt hier erneut: LangSmith bietet State-Inspection an jedem Node, Trace-Replay mit alternativen Modellen und LangSmith Studio für visuelles Step-through-Debugging. Das Engineering-Team von Monte Carlo, das ein produktives System mit Hunderten Sub-Agenten betreibt, nannte diese Zero-Setup-LangGraph-Integration als Schlüsselfaktor für die Wahl.
Für Agenten auf Basis von CrewAI, Pydantic AI oder anderen Multi-Agent-Frameworks hat Langfuse breitere native Instrumentierung und benötigt oft weniger manuelle Einrichtung.
Framework- und SDK-Integrationen
Langfuse listet breite Integrationen über Modellanbieter, Frameworks, Gateways, No-Code-Tools, Analytics und Dev-Tools. Frameworks umfassen LangChain, LangGraph, OpenAI Agents SDK, Pydantic AI, CrewAI, AutoGen, DSPy, Haystack, LlamaIndex und weitere. Die Plattform ist auf SDK-Ebene OpenTelemetry‑native.
LangSmiths native SDKs decken Python, TypeScript, Go und Java ab. Neben LangChain, LangGraph und Deep Agents funktioniert es mit dem OpenAI SDK, dem Anthropic SDK, dem Vercel AI SDK, LlamaIndex, Custom-Implementierungen und OpenTelemetry. Es ist also keineswegs ein reines LangChain-Tracing-Tool.
Die praktische Frage ist nicht nur, ob ein Framework unterstützt wird – die meisten populären laufen auf beiden Plattformen. Sie lautet: Wie viel Instrumentierung musst du selbst schreiben?
Langfuse Open Source vs. LangSmith Enterprise
Self-Hosting verändert die Betriebs- und Compliance-Lage stärker als die meisten Feature-Kategorien.
Self-Hosting mit Langfuse ist unter MIT kostenlos. Docker Compose eignet sich für Entwicklung oder Evaluation; für Produktion wird meist Kubernetes mit Helm auf GKE, EKS oder AKS genutzt. Zum Stack gehören ClickHouse, PostgreSQL, Redis und S3-kompatibler Storage; empfohlen sind VMs mit mindestens 4 Kernen und 16 GiB RAM. Die Softwarelizenz kostet nichts, aber Infrastruktur und Betrieb liegen bei deinem Team. Die kostenpflichtige selbstgehostete Enterprise Edition ergänzt dedizierten Support, Audit-Logs, SCIM und SLAs.
Bei der Compliance hält Langfuse Cloud SOC 2 Typ II, ISO 27001, GDPR und HIPAA. LangSmith Cloud hält SOC 2 Typ II, GDPR und HIPAA. ISO 27001 ist für LangSmith nicht gelistet. Wenn eure Beschaffung das verlangt, ist das ein konkreter Unterschied.
Self-Hosting bei LangSmith erfordert einen Enterprise-Vertrag. Es gibt keinen Open-Source- oder kostenlosen Self-Hosting-Pfad. Alle drei Deployment-Modelle (Cloud, Bring-Your-Own-Cloud (BYOC) und Self-Hosted) fallen unter Enterprise. SmithDB ist in allen Hosting-Varianten verfügbar.
Preise: Langfuse vs. LangSmith
Die Listenpreise erzählen nicht die ganze Geschichte.
Die Preisgestaltung ändert sich in diesem Segment oft. Die folgenden Zahlen basieren auf den offiziellen Seiten, die ich im Juni 2026 geprüft habe. Prüfe vor der Budgetplanung unbedingt die aktuellen Pricing-Seiten.
Langfuse-Preise
Langfuse Cloud berechnet nach Einheiten: Eine Einheit entspricht einem Trace, einer Observation oder einem Score. Die Formel lautet Units = Traces + Observations + Scores. Ein Tool-lastiger Agent-Run kann also mehr kosten als ein einfacher Prompt-Response-Trace. Der kostenlose Hobby-Plan umfasst 50.000 Einheiten pro Monat, 30 Tage Retention und zwei Nutzer. Core kostet 29 $/Monat mit 100.000 inkludierten Einheiten, unbegrenzten Nutzern und 90 Tagen Retention. Pro liegt bei 199 $/Monat mit 3 Jahren Datenzugriff und Compliance-Zertifizierungen. Enterprise startet bei 2.499 $/Monat mit individuellen Volumenpreisen. Mehrverbrauch beginnt bei 8 $ pro 100.000 zusätzliche Einheiten.
Wie erwähnt, hat selbstgehostetes Langfuse keine Softwarelizenzkosten. SCIM, Audit-Logs und Enterprise-Support erfordern eine kommerzielle Lizenz.
LangSmith-Preise
LangSmith berechnet pro Seat und pro Trace. Der Developer-Plan ist kostenlos mit 5.000 Traces pro Monat, einem Seat und 14 Tagen Retention. Plus kostet 39 $ pro Seat und Monat mit 10.000 Basistraces inklusive. Basistraces haben 14 Tage Retention; erweiterte Traces behalten Daten 400 Tage und kosten extra. Ein Fünf-Personen-Team auf Plus zahlt 195 $/Monat für Seats, bevor Trace-Mehrverbrauch anfällt. Enterprise-Preise sind individuell.
Mechanik der Datenaufbewahrung
Wie erwähnt, wird erweiterte Retention automatisch ausgelöst, wenn Evaluatoren Feedback zu Traces hinzufügen. Lies die LangSmith-Billing-Doku zu Auto-Extended Retention, bevor du Evaluations-Pipelines aufsetzt.
Diese Details sind wichtig, weil kleine Unterschiede bei Trace-Tiefe, Evaluator-Nutzung und Retention die Monatsrechnung spürbar verändern können.
Vergleichstabelle: Langfuse vs. LangSmith
Die Hauptunterschiede betreffen Eigentum/Hoheit, Framework-Fit, Evaluations-Workflow und Preisgestaltung. Die Tabelle fasst das vor der finalen Entscheidung zusammen.
|
Feature
|
Langfuse
|
LangSmith
|
|
Open Source
|
Ja (MIT)
|
Nein (proprietär)
|
|
Self-Hosting
|
Kostenloses MIT-Self-Hosting; Enterprise-Controls kostenpflichtig
|
Enterprise-Vertrag erforderlich
|
|
Evaluation
|
LLM-as-judge (MIT), Code Evaluators, Human Annotation, CI/CD
|
LLM-as-judge, Human Annotation, Online-Evaluatoren, Few-Shot-Korrektur
|
|
Prompt-Management
|
Label-basiertes Deployment, SDK-Caching, Prompt-Komposability
|
Commit-Hash-Versionierung, Community Prompt Hub
|
|
Ökosystem
|
Breite Integrationen, OTel-native, framework-übergreifend
|
Framework-übergreifend; OTel-Support
|
|
Agent-Support
|
Agent Graphs, Trace Log View, Code Evaluators, MCP-Server
|
LangSmith Studio, natives LangGraph-Tracing, State-Inspection
|
|
Compliance
|
SOC 2 Typ II, ISO 27001, GDPR, HIPAA
|
SOC 2 Typ II, GDPR, HIPAA
|
|
Preismodell
|
Einheitenbasiert; unbegrenzte Nutzer in bezahlten Plänen
|
Seat- + Trace-basiert; zwei Retention-Tiers
|
|
Fit
|
Datenhoheit, Non‑LangChain-Stacks, CI/CD-Evaluation
|
LangGraph-Teams, Präferenz für Managed SaaS
|
Erstens: Fokussiere nicht nur auf Tracing. Tracing zeigt, was passiert ist, aber Evaluation zeigt, ob der Output taugt. Wenn du nur nach Trace-Visualisierung entscheidest, wählst du das falsche Kriterium.
Zweitens: Behalte die Preismechanik im Blick. Wie oben beschrieben, wachsen die Langfuse-Kosten mit der Trace-Tiefe, während LangSmiths erweiterte Retention die Kosten automatisierter Evaluations verändern kann. Rechne vor der Produktion durch.
Drittens: Self-Hosting bedeutet bei beiden Produkten nicht dasselbe. Der Abschnitt oben zeigt warum. Wenn Datenhoheit ein Muss ist, kann dieser Unterschied die Entscheidung vorwegnehmen.
Und schließlich: Entscheide nicht nur nach Framework-Kompatibilität. Beide Plattformen unterstützen mehrere Stacks – und Stacks ändern sich. Deploy-Anforderungen und Evaluations-Workflows sind später schwerer auszutauschen.
Wann du Langfuse wählen solltest
Nach den oben beschriebenen Trade-offs passt Langfuse besser, wenn:
- Dein Team native Integrationen für Frameworks wie CrewAI, Pydantic AI, LlamaIndex oder direkte API-Calls zu OpenAI oder Anthropic möchte.
- Datenhoheit nicht verhandelbar ist und LLM-Ein-/Ausgaben sowie Traces in eurer eigenen Infrastruktur bleiben müssen.
- Dein Team CI/CD-integrierte Evaluation mit automatischen Regressions-Gates via GitHub Actions will.
- Du planbare Kosten für ein wachsendes Team brauchst, da die bezahlten Cloud-Pläne unbegrenzte Nutzer enthalten.
Wann du LangSmith wählen solltest
Auf derselben Grundlage passt LangSmith besser, wenn:
- Du eine modell- und framework-agnostische Plattform für Observability, Evaluation, Debugging und Produktionsmonitoring über LLM-Anwendungen hinweg willst – mit besonders tiefem Support für LangChain-Frameworks.
- Dein Team eine gemanagte Plattform möchte, die den gesamten Agent-Improvement-Loop unterstützt.
- Du eine sehr performante Datenbank für Trace-Daten willst, die du auf deiner bevorzugten Infrastruktur betreiben kannst.
- Deine Anforderungen über Observability hinausgehen – inklusive Evaluation, Produktionsmonitoring, Agent-Server und LLM Gateway von LangSmith.
- Du Traces, Datasets, Experimente, Online-Evaluations, Human Feedback und Produktionsmonitoring in einem Workflow bündeln willst.
Fazit
Langfuse und LangSmith lösen beide ein echtes Problem und haben sich im letzten Jahr stark verändert. Der Trade-off ist inzwischen klar.
Die Entscheidung dreht sich nicht darum, wer mehr Features hat. Es ist der bereits beschriebene Trade-off zwischen Ownership und Ökosystem. Brauchst du einen Open-Source-Pfad mit direkter Kontrolle über deinen Datenstack – oder möchtest du eine gemanagte Plattform mit integrierter Observability, Evaluation und Produktions-Workflows?
Ein Hinweis vor der Entscheidung: Beide Plattformen entwickeln sich schnell. Schau vorab in die Changelogs.
Für weiteren Kontext zum LangChain-Ökosystem empfehlen wir unser Tutorial „LangChain vs. LangGraph vs. LangSmith vs. LangFlow“.




Wenn ein Chatbot schlechte Antworten gibt, ist der erste Reflex oft: den Prompt prüfen. Das funktioniert bei einem einzelnen LLM-Call. Bei Agenten, die Tool-Aufrufe tätigen, reicht das nicht mehr.
Genau diesen fehlenden Kontext liefern LLM-Observability-Plattformen. Sie sind keine herkömmlichen Monitoring-Tools. Klassische Tools zeigen Latenz und Fehlerraten. Eine LLM-Observability-Plattform zeigt dir, welcher Tool-Aufruf schlechte Ergebnisse zurückgab und ob eine Prompt-Änderung die Output-Qualität verbessert hat.
Sowohl Langfuse als auch LangSmith decken Tracing, Evaluation und Prompt-Management ab und haben Anfang 2026 große Updates veröffentlicht. Austauschbar sind sie trotzdem nicht. Am Ende entscheiden deine Deploy-Anforderungen, dein Tech-Stack und wie dein Team Evaluations durchführt.
Kurzfassung: Langfuse passt zu Teams, die Open-Source-Self-Hosting, Datenhoheit oder einen Stack außerhalb von LangChain brauchen. LangSmith passt zu Teams, die eine framework-agnostische Plattform mit integrierter Observability, Evaluation, Debugging und produktionsreifen Workflows für LLM-Anwendungen wollen. Wenn beides nicht zutrifft, schau dir die Preise an.
Was sind Langfuse und LangSmith?
Beide Produkte machen LLM-Anwendungen beobachtbar, testbar und debugbar. Das steckt jeweils dahinter:
Überblick zur Positionierung von Langfuse vs. LangSmith. Bild: Autor.
Was ist Langfuse?
Langfuse ist eine Open-Source-Plattform für LLM-Engineering, gestartet 2023. Sie bietet Tracing, Prompt-Management, Evaluation (LLM-as-judge, Human Annotation und Code-basierte Checks), Datensatz-Experimente sowie Kosten- und Latenz-Monitoring. Das Open-Source-Core-Produkt ist unter MIT-Lizenz verfügbar.
Im Januar 2026 kündigte ClickHouse eine Series-D über 400 Millionen US-Dollar an und übernahm Langfuse. Langfuse ist nun Teil von ClickHouse, der spaltenorientierten Datenbank, die bereits das Langfuse-Backend betrieb. Die MIT-Lizenz und die Open-Source-Identität blieben laut Ankündigung unverändert.
Langfuse läuft als Managed Cloud Service mit Regionen in den USA, der EU und Japan oder als selbstgehostete Open-Source-Instanz ohne Softwarelizenzkosten.
Was ist LangSmith?
LangSmith ist eine framework-agnostische Observability- und Evaluationsplattform von LangChain Inc., dem Team hinter LangChain, LangGraph und Deep Agents. Die Plattform ist proprietär und Closed Source. LangChain sammelte im Oktober 2025 125 Millionen US-Dollar bei einer Bewertung von 1,25 Milliarden US-Dollar ein.
Zu den Hauptfunktionen zählen Tracing über einen gesamten Run, visuelles Debugging, automatisierte Evaluations, Produktionsmonitoring sowie Prompt-Management über Prompt Hub und Playground. Im Mai 2026 startete LangChain SmithDB, eine Rust-basierte Datenschicht, die inzwischen 100% der US-Cloud-Ingestion von LangSmith verarbeitet. SmithDB ist auf die speziellen Datenlasten von LLM-Anwendungen ausgelegt und senkt die P50-Ladezeit von Trace-Bäumen auf 92 Millisekunden sowie die Volltextsuchtzeit auf 400 Millisekunden.
LangSmith ist als Managed Cloud Service, als BYOC-Deployment (Daten im VPC des Kunden) oder als selbstgehostete Enterprise-Variante verfügbar. Außerdem kündigte LangChain an, dass selbstgehostetes LangSmith Bring-Your-Own-Key (BYOK) für Engine unterstützt, den In‑Platform-Agenten zum Finden und Beheben von Fehlern in LLM-Anwendungen.
Open Source vs. Managed SaaS
Der Kernunterschied ist nicht einfach „Open Source vs. nicht Open Source“. Es geht um Kontrolle und Portabilität auf der einen Seite sowie gemanagte Workflows auf der anderen. Mit Langfuse kannst du den Stack in deiner eigenen Infrastruktur ohne Lizenzkosten betreiben. LangSmith bietet Managed Cloud, BYOC und Self-Hosting mit tiefem nativen Support für LangChain, LangGraph und Deep Agents – ohne Pflicht, diese Frameworks zu nutzen.
Ein Update ändert die Perspektive: LangSmith unterstützt OpenTelemetry-Tracing über das
langsmith[otel]-Paket und die UmgebungsvariableLANGSMITH_OTEL_ENABLED=true. Das ist eine von mehreren Möglichkeiten, LangSmith mit Non‑LangChain-Anwendungen einzusetzen.So sind die beiden Plattformen strukturiert positioniert:
Dimension
Langfuse
LangSmith
Quellmodell
Open Source (MIT)
Proprietär, Closed Source
Self-Hosting
Kostenloses MIT-Self-Hosting; Enterprise-Controls kostenpflichtig
Enterprise-Vertrag erforderlich
Framework-Ansatz
Framework-übergreifend; breite Integrationen; OTel-native
Framework-übergreifend; OTel-Support
Datenhoheit
Vollständig; Air-Gap-Deployment möglich
Hybride und selbstgehostete Optionen für Enterprise-Kunden
Backend-Datenbank
ClickHouse
SmithDB (Rust/DataFusion)
Preismodell
Einheitenbasiert (Traces + Observations + Scores)
Seat-basiert plus Trace-basiert mit zwei Retention-Tiers
Compliance
SOC 2 Typ II, ISO 27001, GDPR, HIPAA
SOC 2 Typ II, GDPR, HIPAA
Im Folgenden zeige ich, was diese Unterschiede in der Praxis bedeuten.
Tracing und Observability
Beim Tracing beginnen sich die Produkte zu unterscheiden. Beide erfassen LLM-Calls, Tool-Aufrufe und Metadaten. In Agenten-Workflows werden die Unterschiede schneller sichtbar als in einfachen Prompt-Response-Apps.
Request Tracing
Langfuse baut hierarchische Traces, die LLM-Calls, Tool-Aufrufe, Embeddings und Retrieval-Schritte erfassen. Du kannst nach User, Session, Kosten, Latenz oder Custom-Metadaten filtern. Im Mai 2026 kam Volltextsuche auf Basis der nativen FTS-Engine von ClickHouse hinzu – Suchzeiten sanken von zuvor knapp 20 Sekunden auf unter eine halbe Sekunde.
LangSmith erfasst jeden LLM-Call und jede Tool-Nutzung als inspizierbaren Run-Tree. Mit SmithDB für die US-Cloud-Ingestion laden Trace-Bäume bei P50 in 92 Millisekunden. Außerdem gibt es unüberwachtes Topic-Clustering, das Traces nach Themen gruppiert – ein guter Startpunkt, wenn unklar ist, wo das Problem liegt.
Sichtbarkeit von Agent-Workflows
Langfuse führte im November 2025 Agent Graphs ein. Sie visualisieren den Ausführungsfluss mehrstufiger Agenten, indem sie die Graph-Struktur aus Timings und Verschachtelung der Observations ableiten. Funktioniert mit jedem instrumentierten Framework, inklusive nativer LangGraph-Unterstützung. Zeitgleich kam die Trace Log View hinzu, die eine flache Ereignisfolge von Agent-Schritten zeigt – hilfreich bei stark verzweigten oder loopenden Workflows.
Langfuse-Agent-Graph für LangGraph-Ausführung. Bild: Autor.
LangSmiths LangGraph-Tracing erfasst jeden Node, jede Edge und jeden Zustandsübergang eines Runs – ohne weitere Konfiguration außer einer Umgebungsvariable. In LangSmith Studio kannst du die Agent-Ausführung schrittweise durchgehen, den Zustand an jedem Node inspizieren und einen Trace mit anderem Modell oder Prompt erneut abspielen. In einer LangGraph-App liefert das mehr Kontext als ein generischer Trace-Baum.Im September 2026 veröffentlichte LangSmith Trajectories, um Traces leichter zu debuggen und mit Fachexpertinnen und -experten in Feedback-Loops einzubinden.
LangSmith-Trace-Baum für einen Agent-Workflow. Bild: Autor.
Monitoring in Produktion
Für das Produktionsmonitoring tracken beide Plattformen Latenz, Token-Nutzung, Kosten und Fehlerraten. LangSmith bietet PagerDuty- und Webhook-Alerts für Incidents sowie Monitoring-Workflows, die an Traces und Evaluations gekoppelt sind. Langfuse bietet Budgetwarnungen mit konfigurierbaren Schwellenwerten. Auf dieser Ebene sind die Monitoring-Funktionen ähnlich.
Offline- und Online-Evaluation
Tracing zeigt, was passiert ist. Evaluation zeigt, ob es gut war. In der Praxis sind diese Tools nützlicher, wenn Evaluation Teil des Workflows ist – nicht nur ein Pre-Launch-Häkchen.
LLM-as-a-judge und Code-Evaluatoren
Langfuses LLM-as-judge ist seit Juni 2025 vollständig Open Source unter MIT. Jede selbstgehostete Instanz ab v3.65.0 nutzt sie ohne kommerzielle Lizenz. Im Mai 2026 veröffentlichte Langfuse Code Evaluators: Python- oder TypeScript-
evaluate-Funktionen, die du direkt in der Langfuse-UI schreibst. Sie führen deterministische Checks aus – etwa JSON-Schema-Validierung, Regex-Validierung oder die Prüfung von Tool-Argumenten – ohne Token-Kosten oder Judge-Model-Calls.LangSmith bietet konfigurierbare LLM-as-judge-Evaluatoren mit Booleschen, kategorialen und kontinuierlichen Feedback-Typen sowie Templates für Security, Safety und Quality. Unterstützt wird außerdem Few-Shot-Korrektur: Menschlich gekennzeichnete Korrekturen fließen als Few-Shot-Beispiele zurück, um die Kalibrierung des Evaluators über die Zeit zu verbessern.
Datasets, Experimente und Human Annotation
Offline-Evaluation funktioniert in beiden Plattformen über Datasets und Side-by-Side-Experimentvergleiche. Langfuse ergänzte im November 2025 Score Analytics, um die Übereinstimmung der Evaluatoren nach Precision, Recall, F1, Kosten und Accuracy zu messen. Ebenfalls im November 2025 kam Baseline Comparison: Du markierst einen Run als Referenz und erkennst Regressionen dagegen.
Die GitHub-Actions-CI/CD-Integration von Langfuse, veröffentlicht im Mai 2026 über
langfuse/experiment-action, lässt Workflows fehlschlagen, wenn Experiment-Scores unter einen Schwellwert fallen. Damit wird Evaluation zum Deployment-Gate statt zur Nachher-Prüfung.Langfuse-Evaluationsschleife mit GitHub Actions. Bild: Autor.
Bei LangSmith gibt es einen wichtigen Billing-Aspekt: Evaluatoren, die Feedback zu Traces hinzufügen, können diese Traces auf erweiterte Retention hochstufen. Wie im Preisabschnitt beschrieben, beeinflusst das die Kosten von Evaluations-Workflows.
Prompt-Versionierung, Deployment und A/B-Tests
Prompt-Management ist hier mehr als Versionshistorie. Der Workflow lautet: in der Sandbox iterieren, gegen einen Datensatz testen, in Produktion heben und bei Bedarf sauber zurückrollen.
Langfuse vergibt für jede Prompt-Version eine Versions-ID und nutzt Labels wie
productionundstaging, um zu steuern, welche Version live ist. Das Ändern eines Labels in der UI ist dein Deploy- oder Rollback-Mechanismus. Prompts werden clientseitig im SDK gecacht, sodass Produktivaufrufe keine zusätzliche Latenz durch das Fetching der aktiven Version haben. Geschützte Labels erlauben Admins, festzulegen, welche Rollen dasproduction-Label ändern dürfen – wichtig bei Teams mit unterschiedlich weitreichenden Berechtigungen.LangSmith verwaltet Prompts über Prompt und Context Hub mit Commit-Hash-Versionierung, um exakt definierte Versionen programmgesteuert zu pinnen. Der Prompt Hub enthält eine Community-Bibliothek, die es bei Langfuse so nicht gibt. A/B-Tests über Datensatz-Experimente sind auf beiden Plattformen verfügbar.
In dieser Kategorie liegen die Produkte näher beieinander als bei Hosting, Preisgestaltung oder Framework-Setup.
Langfuse vs. LangSmith für Agenten-Anwendungen
Agenten haben viele Features der letzten zwölf Monate getrieben. Hier zählt, worauf der Agent gebaut ist.
Langfuse zeigt verfügbare Tools an, markiert aufgerufene Tools und zeigt Argumente sowie Call-IDs. Erweiterte Observation-Typen unterscheiden Tool-Calls, Embeddings und Guardrail-Calls in der Trace-Ansicht. Wie oben erwähnt, können Code Evaluators Tool-Argumente auch gegen ein Schema prüfen. Der MCP-Server wurde im Mai 2026 auf 15 Toolkategorien ausgebaut, sodass Agenten in Claude Code, Cursor oder OpenAI Codex Langfuse-Daten programmatisch abfragen können.
Der LangGraph-Punkt aus dem Tracing-Teil gilt hier erneut: LangSmith bietet State-Inspection an jedem Node, Trace-Replay mit alternativen Modellen und LangSmith Studio für visuelles Step-through-Debugging. Das Engineering-Team von Monte Carlo, das ein produktives System mit Hunderten Sub-Agenten betreibt, nannte diese Zero-Setup-LangGraph-Integration als Schlüsselfaktor für die Wahl.
Für Agenten auf Basis von CrewAI, Pydantic AI oder anderen Multi-Agent-Frameworks hat Langfuse breitere native Instrumentierung und benötigt oft weniger manuelle Einrichtung.
Framework- und SDK-Integrationen
Langfuse listet breite Integrationen über Modellanbieter, Frameworks, Gateways, No-Code-Tools, Analytics und Dev-Tools. Frameworks umfassen LangChain, LangGraph, OpenAI Agents SDK, Pydantic AI, CrewAI, AutoGen, DSPy, Haystack, LlamaIndex und weitere. Die Plattform ist auf SDK-Ebene OpenTelemetry‑native.
LangSmiths native SDKs decken Python, TypeScript, Go und Java ab. Neben LangChain, LangGraph und Deep Agents funktioniert es mit dem OpenAI SDK, dem Anthropic SDK, dem Vercel AI SDK, LlamaIndex, Custom-Implementierungen und OpenTelemetry. Es ist also keineswegs ein reines LangChain-Tracing-Tool.
Die praktische Frage ist nicht nur, ob ein Framework unterstützt wird – die meisten populären laufen auf beiden Plattformen. Sie lautet: Wie viel Instrumentierung musst du selbst schreiben?
Langfuse Open Source vs. LangSmith Enterprise
Self-Hosting verändert die Betriebs- und Compliance-Lage stärker als die meisten Feature-Kategorien.
Self-Hosting mit Langfuse ist unter MIT kostenlos. Docker Compose eignet sich für Entwicklung oder Evaluation; für Produktion wird meist Kubernetes mit Helm auf GKE, EKS oder AKS genutzt. Zum Stack gehören ClickHouse, PostgreSQL, Redis und S3-kompatibler Storage; empfohlen sind VMs mit mindestens 4 Kernen und 16 GiB RAM. Die Softwarelizenz kostet nichts, aber Infrastruktur und Betrieb liegen bei deinem Team. Die kostenpflichtige selbstgehostete Enterprise Edition ergänzt dedizierten Support, Audit-Logs, SCIM und SLAs.
Bei der Compliance hält Langfuse Cloud SOC 2 Typ II, ISO 27001, GDPR und HIPAA. LangSmith Cloud hält SOC 2 Typ II, GDPR und HIPAA. ISO 27001 ist für LangSmith nicht gelistet. Wenn eure Beschaffung das verlangt, ist das ein konkreter Unterschied.
Self-Hosting bei LangSmith erfordert einen Enterprise-Vertrag. Es gibt keinen Open-Source- oder kostenlosen Self-Hosting-Pfad. Alle drei Deployment-Modelle (Cloud, Bring-Your-Own-Cloud (BYOC) und Self-Hosted) fallen unter Enterprise. SmithDB ist in allen Hosting-Varianten verfügbar.
Preise: Langfuse vs. LangSmith
Die Listenpreise erzählen nicht die ganze Geschichte.
Die Preisgestaltung ändert sich in diesem Segment oft. Die folgenden Zahlen basieren auf den offiziellen Seiten, die ich im Juni 2026 geprüft habe. Prüfe vor der Budgetplanung unbedingt die aktuellen Pricing-Seiten.
Langfuse-Preise
Langfuse Cloud berechnet nach Einheiten: Eine Einheit entspricht einem Trace, einer Observation oder einem Score. Die Formel lautet
Units = Traces + Observations + Scores. Ein Tool-lastiger Agent-Run kann also mehr kosten als ein einfacher Prompt-Response-Trace. Der kostenlose Hobby-Plan umfasst 50.000 Einheiten pro Monat, 30 Tage Retention und zwei Nutzer. Core kostet 29 $/Monat mit 100.000 inkludierten Einheiten, unbegrenzten Nutzern und 90 Tagen Retention. Pro liegt bei 199 $/Monat mit 3 Jahren Datenzugriff und Compliance-Zertifizierungen. Enterprise startet bei 2.499 $/Monat mit individuellen Volumenpreisen. Mehrverbrauch beginnt bei 8 $ pro 100.000 zusätzliche Einheiten.Wie erwähnt, hat selbstgehostetes Langfuse keine Softwarelizenzkosten. SCIM, Audit-Logs und Enterprise-Support erfordern eine kommerzielle Lizenz.
LangSmith-Preise
LangSmith berechnet pro Seat und pro Trace. Der Developer-Plan ist kostenlos mit 5.000 Traces pro Monat, einem Seat und 14 Tagen Retention. Plus kostet 39 $ pro Seat und Monat mit 10.000 Basistraces inklusive. Basistraces haben 14 Tage Retention; erweiterte Traces behalten Daten 400 Tage und kosten extra. Ein Fünf-Personen-Team auf Plus zahlt 195 $/Monat für Seats, bevor Trace-Mehrverbrauch anfällt. Enterprise-Preise sind individuell.
Mechanik der Datenaufbewahrung
Wie erwähnt, wird erweiterte Retention automatisch ausgelöst, wenn Evaluatoren Feedback zu Traces hinzufügen. Lies die LangSmith-Billing-Doku zu Auto-Extended Retention, bevor du Evaluations-Pipelines aufsetzt.
Diese Details sind wichtig, weil kleine Unterschiede bei Trace-Tiefe, Evaluator-Nutzung und Retention die Monatsrechnung spürbar verändern können.
Vergleichstabelle: Langfuse vs. LangSmith
Die Hauptunterschiede betreffen Eigentum/Hoheit, Framework-Fit, Evaluations-Workflow und Preisgestaltung. Die Tabelle fasst das vor der finalen Entscheidung zusammen.
Feature
Langfuse
LangSmith
Open Source
Ja (MIT)
Nein (proprietär)
Self-Hosting
Kostenloses MIT-Self-Hosting; Enterprise-Controls kostenpflichtig
Enterprise-Vertrag erforderlich
Evaluation
LLM-as-judge (MIT), Code Evaluators, Human Annotation, CI/CD
LLM-as-judge, Human Annotation, Online-Evaluatoren, Few-Shot-Korrektur
Prompt-Management
Label-basiertes Deployment, SDK-Caching, Prompt-Komposability
Commit-Hash-Versionierung, Community Prompt Hub
Ökosystem
Breite Integrationen, OTel-native, framework-übergreifend
Framework-übergreifend; OTel-Support
Agent-Support
Agent Graphs, Trace Log View, Code Evaluators, MCP-Server
LangSmith Studio, natives LangGraph-Tracing, State-Inspection
Compliance
SOC 2 Typ II, ISO 27001, GDPR, HIPAA
SOC 2 Typ II, GDPR, HIPAA
Preismodell
Einheitenbasiert; unbegrenzte Nutzer in bezahlten Plänen
Seat- + Trace-basiert; zwei Retention-Tiers
Fit
Datenhoheit, Non‑LangChain-Stacks, CI/CD-Evaluation
LangGraph-Teams, Präferenz für Managed SaaS
Fehler bei der Wahl einer LLM-Observability-Plattform
Erstens: Fokussiere nicht nur auf Tracing. Tracing zeigt, was passiert ist, aber Evaluation zeigt, ob der Output taugt. Wenn du nur nach Trace-Visualisierung entscheidest, wählst du das falsche Kriterium.
Zweitens: Behalte die Preismechanik im Blick. Wie oben beschrieben, wachsen die Langfuse-Kosten mit der Trace-Tiefe, während LangSmiths erweiterte Retention die Kosten automatisierter Evaluations verändern kann. Rechne vor der Produktion durch.
Drittens: Self-Hosting bedeutet bei beiden Produkten nicht dasselbe. Der Abschnitt oben zeigt warum. Wenn Datenhoheit ein Muss ist, kann dieser Unterschied die Entscheidung vorwegnehmen.
Und schließlich: Entscheide nicht nur nach Framework-Kompatibilität. Beide Plattformen unterstützen mehrere Stacks – und Stacks ändern sich. Deploy-Anforderungen und Evaluations-Workflows sind später schwerer auszutauschen.
Wann du Langfuse wählen solltest
Nach den oben beschriebenen Trade-offs passt Langfuse besser, wenn:
Wann du LangSmith wählen solltest
Auf derselben Grundlage passt LangSmith besser, wenn:
Fazit
Langfuse und LangSmith lösen beide ein echtes Problem und haben sich im letzten Jahr stark verändert. Der Trade-off ist inzwischen klar.
Die Entscheidung dreht sich nicht darum, wer mehr Features hat. Es ist der bereits beschriebene Trade-off zwischen Ownership und Ökosystem. Brauchst du einen Open-Source-Pfad mit direkter Kontrolle über deinen Datenstack – oder möchtest du eine gemanagte Plattform mit integrierter Observability, Evaluation und Produktions-Workflows?
Ein Hinweis vor der Entscheidung: Beide Plattformen entwickeln sich schnell. Schau vorab in die Changelogs.
Für weiteren Kontext zum LangChain-Ökosystem empfehlen wir unser Tutorial „LangChain vs. LangGraph vs. LangSmith vs. LangFlow“.