
Kurs
Einführung in Python
4 Std.
7M
Mit der Exploratory Data Analysis (EDA) und dem Basismodell in der Tasche kannst du jetzt an dein erstes echtes Machine-Learning-Modell gehen.
Hinweis: Dieses Tutorial basiert auf einer Facebook Live Code-along-Session; Du kannst sie hier erneut ansehen:
Bevor du loslegst, importiere alle benötigten Bibliotheken:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')
data, das Trainings- und Testset kombiniert. Das machst du, weil du die Daten etwas vorverarbeiten willst und sicherstellen möchtest, dass alle Schritte sowohl auf das Training- als auch auf das Testset angewendet werden.# Store target variable of training data in a safe place
survived_train = df_train.Survived
# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])
data mit der Methode info() an.data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Es gibt 2 numerische Variablen mit fehlenden Werten.
Welche sind das?
Genau, es fehlen Werte in den Spalten 'Age' und 'Fare'! Aus dem Ergebnis von .info() oben siehst du, dass für Age 263 Werte fehlen, denn es gibt nur 1046 Non-Null-Werte bei insgesamt 1309 Einträgen im DataFrame. Ideal wäre natürlich, wenn alle 1309 Einträge befüllt wären, aber das ist hier nicht der Fall!
Zum Glück fehlt bei Fare nur ein einziger Wert. Beachte auch, dass 'Cabin' und 'Embarked' ebenfalls Lücken haben, um die du dich später kümmern musst.
Jetzt konzentrierst du dich aber auf die numerischen Variablen: Du imputierst beziehungsweise füllst die fehlenden Werte in 'Age' und 'Fare' mit dem Median der jeweiligen Variablen, wo er bekannt ist.
Hinweis: Hier nimmst du den Median, weil er Ausreißer robust abbildet. Der Median eignet sich also, wenn die Verteilung schief ist. Alternativen wären der Mittelwert (Summe durch Anzahl) oder der Modus (am häufigsten vorkommender Wert).
# Impute missing numerical variables
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())

# Check out info of data
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1309 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1309 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Das sieht doch schon deutlich besser aus, oder?
Erinnere dich außerdem: Im vorherigen Tutorial und im Notebook gab es einige Features, die du für die Vorhersage nutzen wolltest, weil die EDA gezeigt hat, dass sie für 'Survived' relevant sind. Eines davon war 'Fare', aber auch 'Age' und 'Sex'!
Da Modelle meist numerische Eingaben erwarten, willst du Kategorien in Zahlen kodieren. Also wandelst du 'male' und 'female' in numerische Features um. Dafür kannst du die pandas-Funktion .get_dummies() verwenden:
data = pd.get_dummies(data, columns=['Sex'], drop_first=True)
data.head()
| PassengerId | Pclass | Name | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Sex_male | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | 1 |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | 0 |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | 0 |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | 0 |
| 4 | 5 | 3 | Allen, Mr. William Henry | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | 1 |
.get_dummies() erzeugt für jede Ausprägung in 'Sex' eine neue Spalte. Es würde also eine Spalte 'Sex_female' und eine 'Sex_male' anlegen, die codieren, ob die Zeile männlich oder weiblich ist.
Da du aber das Argument drop_first gesetzt hast, wurde 'Sex_female' entfernt, weil beide Spalten dieselbe Information tragen.
Damit hast du eine neue Spalte 'Sex_male', die 1 ist, wenn der Eintrag männlich ist, und 0, wenn er weiblich ist.
.get_dummies() wird einer deiner besten Helfer bei der Datenaufbereitung für Machine Learning sein!
['Sex_male', 'Fare', 'Age','Pclass', 'SibSp'] aus deinem DataFrame aus, um dein erstes Machine-Learning-Modell zu bauen:# Select columns and view head
data = data[['Sex_male', 'Fare', 'Age','Pclass', 'SibSp']]
data.head()
| Sex_male | Fare | Age | Pclass | SibSp | |
|---|---|---|---|---|---|
| 0 | 1 | 7.2500 | 22.0 | 3 | 1 |
| 1 | 0 | 71.2833 | 38.0 | 1 | 1 |
| 2 | 0 | 7.9250 | 26.0 | 3 | 0 |
| 3 | 0 | 53.1000 | 35.0 | 1 | 1 |
| 4 | 1 | 8.0500 | 35.0 | 3 | 0 |
.info(), um data zu prüfen:data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 5 columns):
Sex_male    1309 non-null uint8
Fare        1309 non-null float64
Age         1309 non-null float64
Pclass      1309 non-null int64
SibSp       1309 non-null int64
dtypes: float64(2), int64(2), uint8(1)
memory usage: 52.4 KB
Alle Einträge sind jetzt befüllt. Top!
Bis hierhin hast du die Daten so aufbereitet, dass du dein erstes Machine-Learning-Modell bauen kannst. Das heißt: Jetzt geht es endlich los!
Mehr zu pandas findest du in unserem Lernpfad Data Manipulation with Python.
Was ist ein Decision-Tree-Classifier? Es ist ein Baum, mit dem du Datenpunkte, also Zielvariablen, anhand von Feature-Variablen klassifizierst.
Im Beispiel unten stellt die Wurzelknoten-Frage die erste Entscheidung: "War 'Sex_male' kleiner als 0.5?" Anders gesagt: Handelt es sich um weiblich. Ist die Antwort True, gehst du links weiter und erhältst 'Survived'. Bei False gehst du rechts weiter und erhältst 'Dead'.
Um die Zusatzinfos in den Knoten wie gini, samples oder value brauchst du dich erstmal nicht zu kümmern. Das kannst du später vertiefen!
'Male' zu einer Vorhersage 'Dead' führt.Hinweis: Tatsächlich entscheidet hier der Gini-Koeffizient. Wir gehen an dieser Stelle nicht tiefer darauf ein.
data fitst, teilst du es wieder in Trainings- und Testset:data_train = data.iloc[:891]
data_test = data.iloc[891:]
scikit-learn. Das erwartet Arrays statt DataFrames, also wandle sie um:X = data_train.values
test = data_test.values
y = survived_train.values
max_depth=3 und fit es dann. Hinweis: Das Modell nennst du clf als Abkürzung für "Classifier".# Instantiate model and fit to data
clf = tree.DecisionTreeClassifier(max_depth=3)
clf.fit(X, y)
DecisionTreeClassifier(class_weight=None, criterion='gini', max_depth=3,
            max_features=None, max_leaf_nodes=None,
            min_impurity_decrease=0.0, min_impurity_split=None,
            min_samples_leaf=1, min_samples_split=2,
            min_weight_fraction_leaf=0.0, presort=False, random_state=None,
            splitter='best')
Die Feature-Variablen X sind das erste Argument, das du an .fit() übergibst, die Zielvariable y das zweite.
Die Ausgabe fasst die wichtigsten Parameter deines Decision-Tree-Classifiers zusammen, etwa die maximale Tiefe von 3.
'Survived' und speicherst die Vorhersagen darin. Exportiere die Spalten 'PassengerId' und 'Survived' aus df_test als .csv und reiche sie bei Kaggle ein.# Make predictions and store in 'Survived' column of df_test
Y_pred = clf.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/1st_dec_tree.csv', index=False)
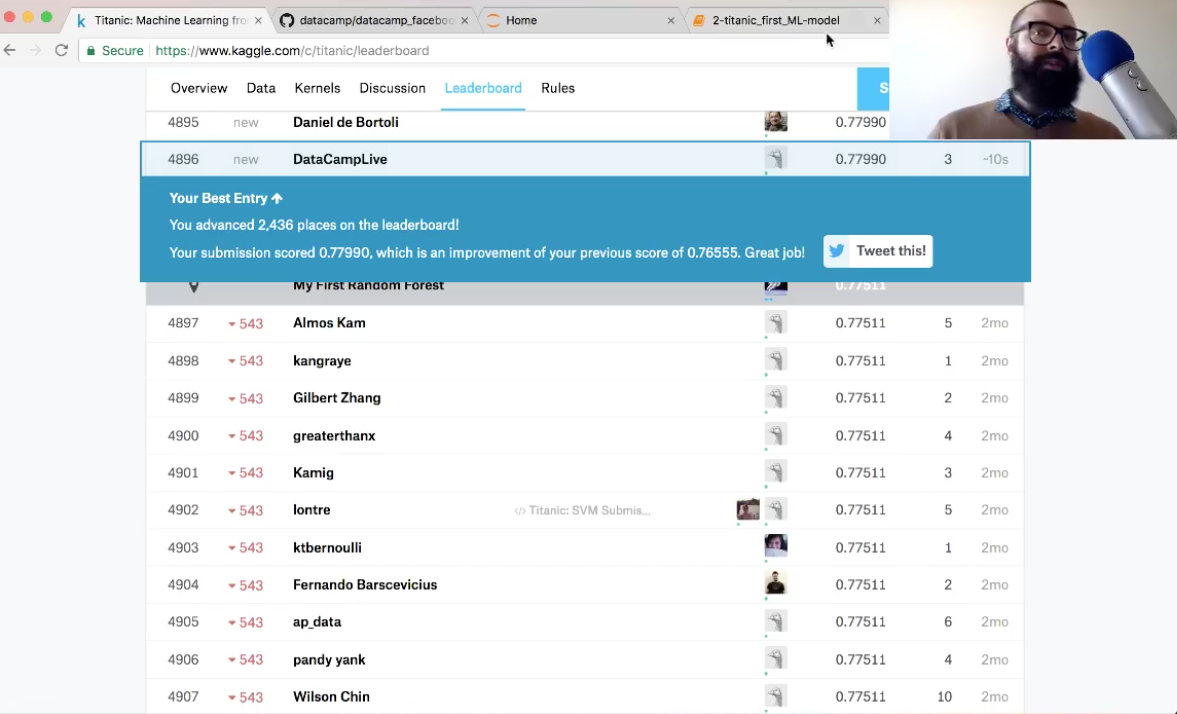
Die Accuracy liegt bei 78%. Du hast über 2.000 Plätze gutgemacht!
Glückwunsch, du hast die Daten so aufbereitet, dass du dein erstes Machine-Learning-Modell bauen konntest. Und oben drauf hast du es auch gebaut: einen Decision-Tree-Classifier.
Als Nächstes klärst du, was es mit dem Argument max_depth auf sich hat, warum du es so gewählt hast, und du schaust dir train_test_split an.
Mehr zu scikit-learn findest du im Kurs Supervised Learning with scikit-learn.
Der eben gebaute Decision-Tree-Classifier hat max_depth=3 und sieht so aus:
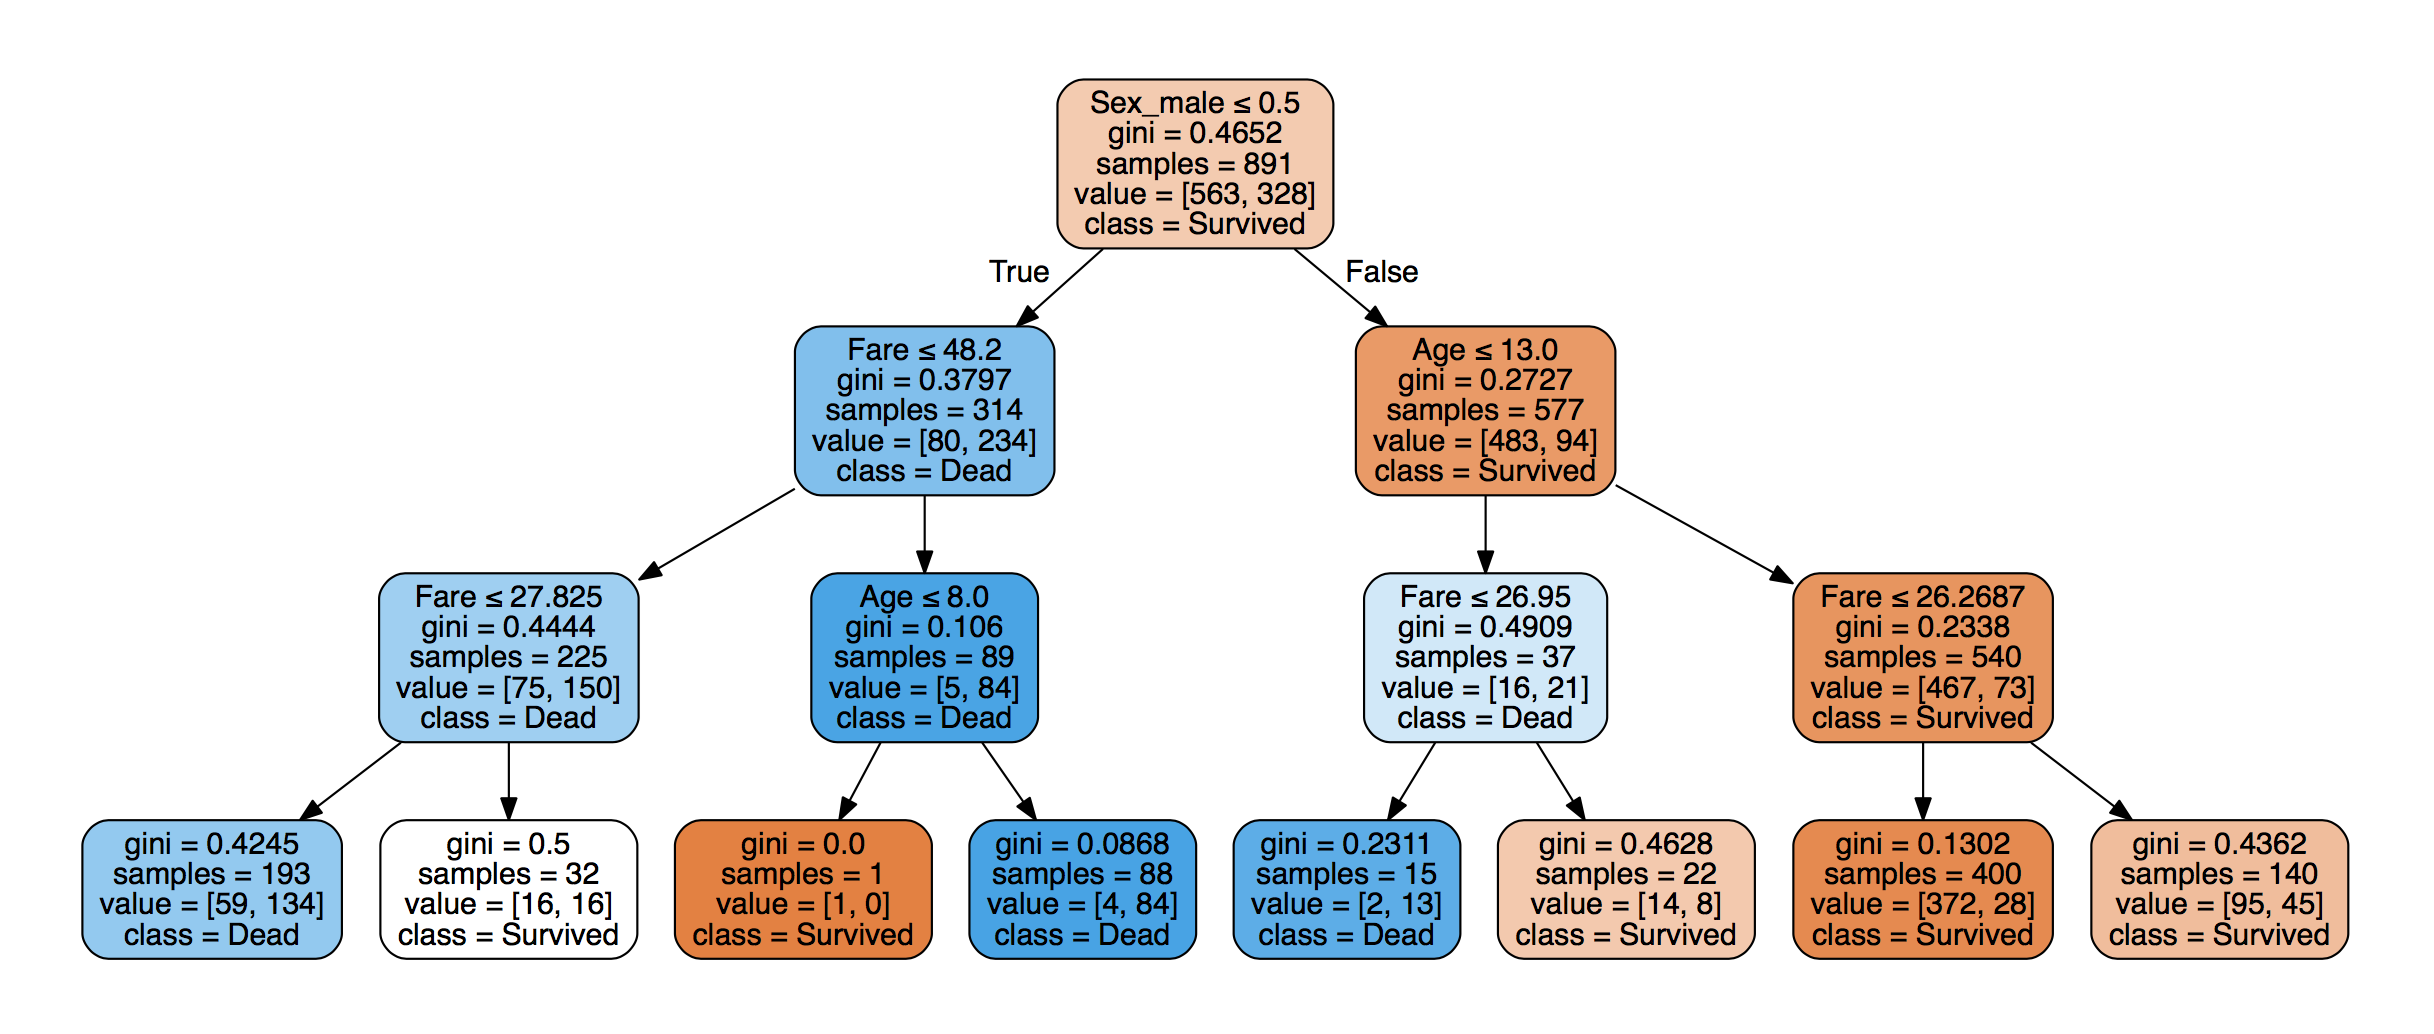
Der maximale Abstand zwischen erster und letzter Entscheidung beträgt 3, daher max_depth=3.
Hinweis: Mit graphviz kannst du solche Grafiken erzeugen. Details findest du in der scikit-learn-Dokumentation hier.
Beim Bauen dieses Modells erzeugst du im Raum der Feature-Variablen im Grunde eine Entscheidungsgrenze, zum Beispiel so (Abbildung von hier):
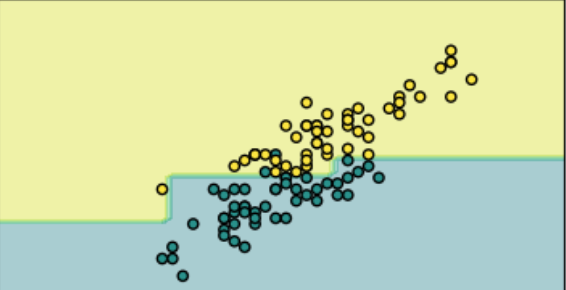
max_depth=3 wählen?Die Baumtiefe ist ein Hyperparameter, also ein Parameter, den du vor dem Fitten festlegen musst. Wählst du eine größere max_depth, wird die Entscheidungsgrenze komplexer.
Ist deine Entscheidungsgrenze zu komplex, überfittest du: Das Modell beschreibt dann auch Rauschen statt nur Signal.
Ist max_depth zu klein, unterfittest du: Das Modell fängt zu wenig vom Signal ein.
Wie erkennst du Über- oder Unterfitting?
Hinweis: Das ist der Bias-Varianz-Trade-off. Details sparen wir uns hier.
Eine Möglichkeit ist, ein Testset aus den Trainingsdaten herauszuhalten. Du fitst auf dem Trainingsset, sagst das Testset voraus und prüfst die Performance auf diesen unbekannten Daten.
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.33, random_state=42, stratify=y)
max_depth von 1 bis 9 und plottest die Accuracy auf Train- und Testset:# Setup arrays to store train and test accuracies
dep = np.arange(1, 9)
train_accuracy = np.empty(len(dep))
test_accuracy = np.empty(len(dep))
# Loop over different values of k
for i, k in enumerate(dep):
# Setup a Decision Tree Classifier
clf = tree.DecisionTreeClassifier(max_depth=k)
# Fit the classifier to the training data
clf.fit(X_train, y_train)
#Compute accuracy on the training set
train_accuracy[i] = clf.score(X_train, y_train)
#Compute accuracy on the testing set
test_accuracy[i] = clf.score(X_test, y_test)
# Generate plot
plt.title('clf: Varying depth of tree')
plt.plot(dep, test_accuracy, label = 'Testing Accuracy')
plt.plot(dep, train_accuracy, label = 'Training Accuracy')
plt.legend()
plt.xlabel('Depth of tree')
plt.ylabel('Accuracy')
plt.show()
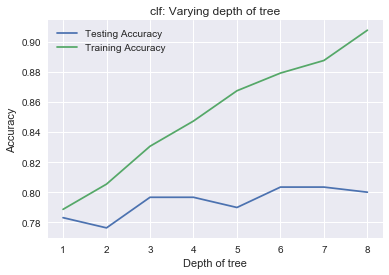
Mit steigender max_depth passt du die Trainingsdaten immer besser, weil der Baum Entscheidungen trifft, die das Training exakt beschreiben. Die Trainingsgenauigkeit steigt also weiter an. Für das Testset siehst du das aber nicht: Du überfittest.
Darum hast du max_depth=3 gewählt.
In diesem Tutorial hast du deine Daten so vorbereitet, dass du dein erstes Machine-Learning-Modell bauen konntest. Anschließend hast du tatsächlich dein erstes Modell gebaut: einen Decision-Tree-Classifier. Zum Schluss hast du train_test_split kennengelernt und gesehen, wie es bei der Wahl von ML-Hyperparametern hilft.
Im nächsten Tutorial, das am 10. Januar 2018 in der DataCamp Community erscheint, lernst du Feature Engineering kennen und baust neue Modelle!
Bis dahin: Wenn du mehr über scikit-learn erfahren möchtest, schau dir den DataCamp-Kurs Supervised Learning with scikit-learn an.
Machine-Learning-Kurse
Kurs
Kurs