Kurs
Einführung in Python
4 Std.
7M
Anfang dieses Monats habe ich eine Facebook Live Code-Along-Session durchgeführt, in der ich (und alle, die mitprogrammiert haben) mehrere Algorithmen mit steigender Komplexität gebaut habe, um vorherzusagen, ob ein bestimmter Passagier der Titanic überlebt hat oder nicht – basierend auf Daten wie dem gezahlten Fahrpreis, dem Einschiffungshafen und dem Alter.
In diesem Beitrag gehst du einige der Inhalte aus dieser Session noch einmal durch. Wenn du sie dir erneut ansehen oder den Beitrag zusammen mit dem Video verfolgen möchtest, findest du es hier:
Insbesondere wirst du dich erinnern, dass wir überwachte Lernmodelle gebaut haben.
Überwachtes Lernen ist der Bereich des Machine Learnings (ML), bei dem Labels wie „Überlebt“ oder „Nicht überlebt“ vorhergesagt werden. Solche Modelle lernen aus gelabelten Daten, also Daten, die angeben, ob ein Passagier überlebt hat (das sogenannte „Modelltraining“), und treffen anschließend Vorhersagen auf ungelabelten Daten.
Auf Kaggle, einer Plattform für Wettbewerbe im Bereich Vorhersagemodelle und Analytics, heißen diese Datensätze Train- und Test-Set, weil
Kaggle teilt dir dann den Prozentsatz deiner korrekten Vorhersagen mit: Das ist die Genauigkeit (Accuracy) deines Modells.
Wie du vielleicht schon weißt, eignet sich folgender Ansatz für überwachtes Lernen:
In dieser Code-Along-Session hast du all diese Schritte gemacht bzw. wirst sie gleich machen!
Hinweis: Wir haben auch Kurse, mit denen du Machine Learning für das Titanic-Datenset in Python und R direkt umsetzen kannst.
Der erste Schritt ist immer, die Daten zu importieren und dir schnell einen Überblick über den Datensatz zu verschaffen. In diesem Fall importierst du das Paket pandas und nutzt die Funktion read_csv(), um die Daten einzulesen:
Hinweis: In den folgenden Code-Blöcken sind weitere Pakete und Modulimporte wie matplotlib, sklearn und seaborn bereits vorhanden. Du wirst sie später intensiver für (statistische) Datenvisualisierung und Machine Learning einsetzen!
Außerdem nutzt du den IPython-Magic-Befehl %matplotlib inline, damit die Plots direkt im Notebook erscheinen. Mit sns.set() stellst du den Visualisierungsstil auf den Seaborn-Standard um:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn import tree
from sklearn.metrics import accuracy_score

# Figures inline and set visualization style
%matplotlib inline
sns.set()
Also los: Importiere die Daten und mach den ersten Schritt bei der Dateninspektion:
# Import test and train datasets
df_train = pd.read_csv('../data/train.csv')
df_test = pd.read_csv('../data/test.csv')

# View first lines of training data
df_train.head(n=4)
| PassengerId | Survived | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 0 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S |
| 1 | 2 | 1 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C |
| 2 | 3 | 1 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S |
| 3 | 4 | 1 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S |
Was all diese Features bedeuten, findest du in der Kaggle-Dokumentation hier.
Bevor du weitermachst, beachte folgende Begrifflichkeiten:
Mit diesem Wissen kannst du deine Daten weiter erkunden, z. B. mit der Funktion head(), die dir die ersten fünf Zeilen eines Datensatzes anzeigt:
# View first lines of test data
df_test.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 892 | 3 | Kelly, Mr. James | male | 34.5 | 0 | 0 | 330911 | 7.8292 | NaN | Q |
| 1 | 893 | 3 | Wilkes, Mrs. James (Ellen Needs) | female | 47.0 | 1 | 0 | 363272 | 7.0000 | NaN | S |
| 2 | 894 | 2 | Myles, Mr. Thomas Francis | male | 62.0 | 0 | 0 | 240276 | 9.6875 | NaN | Q |
| 3 | 895 | 3 | Wirz, Mr. Albert | male | 27.0 | 0 | 0 | 315154 | 8.6625 | NaN | S |
| 4 | 896 | 3 | Hirvonen, Mrs. Alexander (Helga E Lindqvist) | female | 22.0 | 1 | 1 | 3101298 | 12.2875 | NaN | S |
Beachte, dass der DataFrame df_test die Spalte 'Survived' nicht enthält – genau diese willst du ja vorhersagen!
.info() kannst du dir Datentypen, fehlende Werte und mehr (von df_train) anzeigen lassen.df_train.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 891 entries, 0 to 890
Data columns (total 12 columns):
PassengerId    891 non-null int64
Survived       891 non-null int64
Pclass         891 non-null int64
Name           891 non-null object
Sex            891 non-null object
Age            714 non-null float64
SibSp          891 non-null int64
Parch          891 non-null int64
Ticket         891 non-null object
Fare           891 non-null float64
Cabin          204 non-null object
Embarked       889 non-null object
dtypes: float64(2), int64(5), object(5)
memory usage: 83.6+ KB
Hier siehst du, dass es in der Spalte „Age“ nur 714 Nicht-Null-Werte in einem DataFrame mit 891 Zeilen gibt. Das bedeutet, es fehlen 177 Werte.
.describe(), um dir zusammenfassende Statistiken der numerischen Spalten von df_train anzeigen zu lassen.df_train.describe()
| PassengerId | Survived | Pclass | Age | SibSp | Parch | Fare | |
|---|---|---|---|---|---|---|---|
| count | 891.000000 | 891.000000 | 891.000000 | 714.000000 | 891.000000 | 891.000000 | 891.000000 |
| mean | 446.000000 | 0.383838 | 2.308642 | 29.699118 | 0.523008 | 0.381594 | 32.204208 |
| std | 257.353842 | 0.486592 | 0.836071 | 14.526497 | 1.102743 | 0.806057 | 49.693429 |
| min | 1.000000 | 0.000000 | 1.000000 | 0.420000 | 0.000000 | 0.000000 | 0.000000 |
| 25% | 223.500000 | 0.000000 | 2.000000 | 20.125000 | 0.000000 | 0.000000 | 7.910400 |
| 50% | 446.000000 | 0.000000 | 3.000000 | 28.000000 | 0.000000 | 0.000000 | 14.454200 |
| 75% | 668.500000 | 1.000000 | 3.000000 | 38.000000 | 1.000000 | 0.000000 | 31.000000 |
| max | 891.000000 | 1.000000 | 3.000000 | 80.000000 | 8.000000 | 6.000000 | 512.329200 |
Jetzt, da du ein Gefühl für die Daten hast und einige Statistiken kennst, ist es Zeit, die Daten auch zu visualisieren – mit dem Paket seaborn:
seaborn ein Balkendiagramm zur Titanic-Überlebensrate, also deiner Zielvariable.sns.countplot(x='Survived', data=df_train);
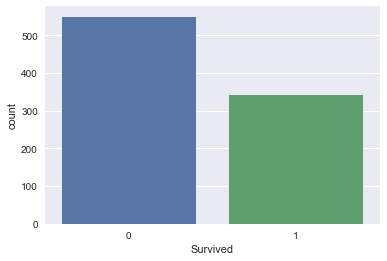
Fazit: Im Trainingsset haben weniger Menschen überlebt als nicht überlebt. Lass uns also ein erstes Modell bauen, das vorhersagt, dass niemand überlebt hat.
Das ist natürlich ein schwaches Modell, denn wir wissen, dass Menschen überlebt haben. Aber es liefert uns eine Baseline: Jedes spätere Modell muss besser abschneiden als dieses.
Das geht so:
df_test eine Spalte 'Survived', die für alle Zeilen „nicht überlebt“ codiert.'PassengerId' und 'Survived' von df_test als .csv und reiche sie bei Kaggle ein.df_test['Survived'] = 0
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/no_survivors.csv', index=False)
Welche Genauigkeit bekommst du damit? Die Accuracy auf Kaggle liegt bei 62,7.
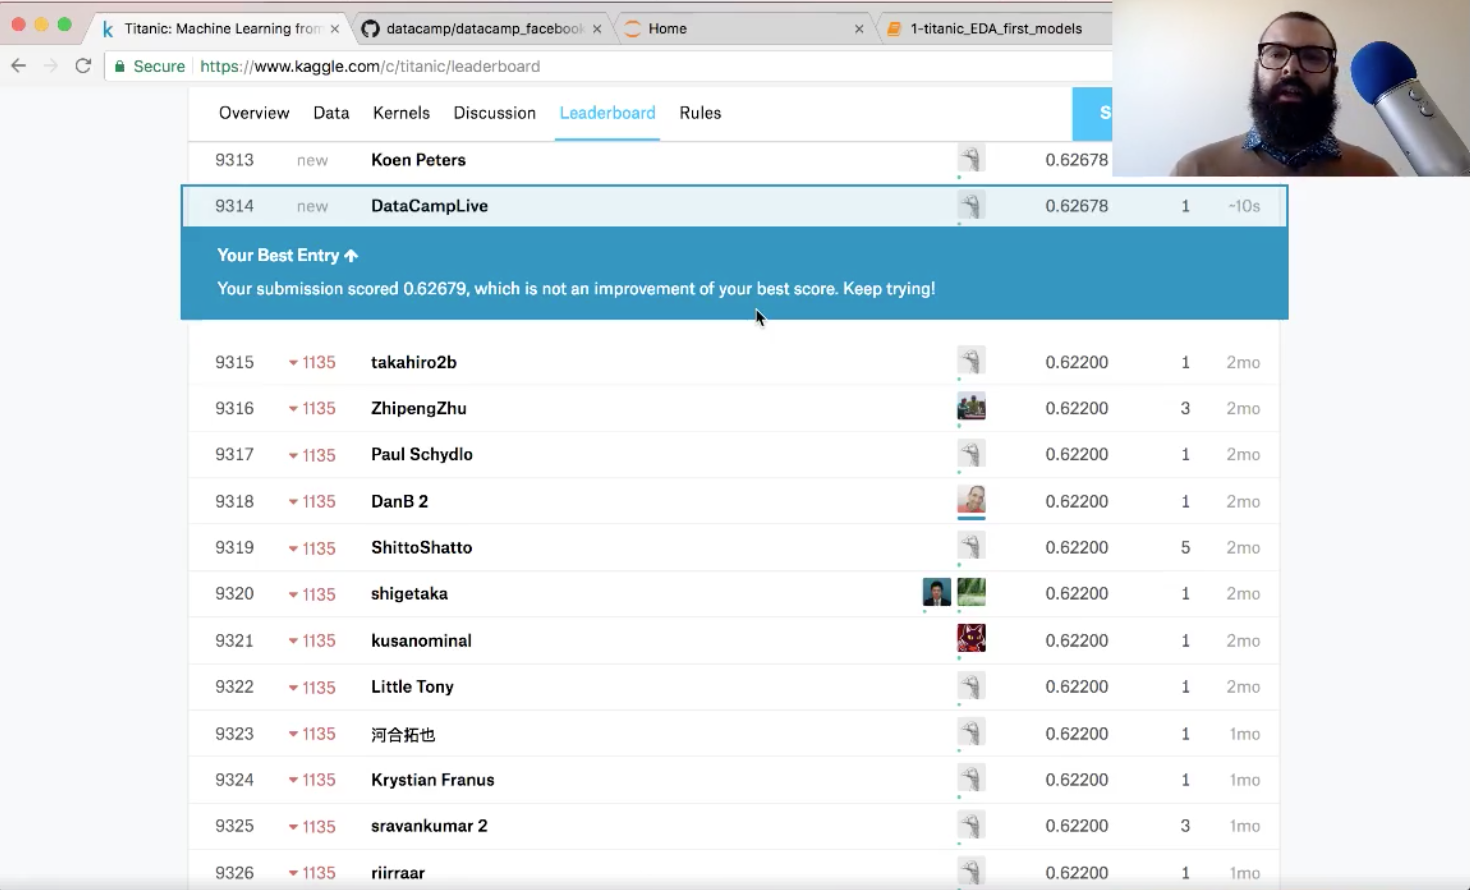
Gar nicht so schlecht!
Wichtiger Hinweis: Du solltest auch andere Metriken als Accuracy verwenden!
Nachdem du ein schnelles Basismodell gebaut hast, geht es in die nächste Runde: Lass uns mehr EDA machen und bald ein weiteres Modell bauen!
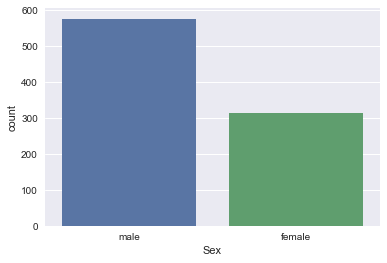
seaborn, um ein Balkendiagramm für das Feature 'Sex' des Titanic-Datensatzes (df_train) zu erstellen.sns.countplot(x='Sex', data=df_train);
'Survived', aufgeteilt (facettiert) nach dem Feature 'Sex'.sns.factorplot(x='Survived', col='Sex', kind='count', data=df_train);
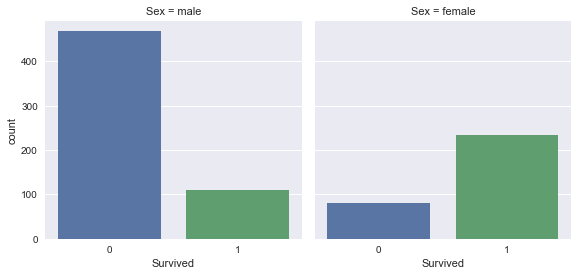
Fazit: Frauen hatten eine höhere Überlebenswahrscheinlichkeit als Männer.
pandas herausfinden, wie viele Frauen und wie viele Männer überlebt haben:df_train.groupby(['Sex']).Survived.sum()
Sex
female    233
male      109
Name: Survived, dtype: int64
pandas den Anteil der überlebenden Frauen und der überlebenden Männer:print(df_train[df_train.Sex == 'female'].Survived.sum()/df_train[df_train.Sex == 'female'].Survived.count())
print(df_train[df_train.Sex == 'male'].Survived.sum()/df_train[df_train.Sex == 'male'].Survived.count())
0.742038216561
0.188908145581
74% der Frauen überlebten, während 19% der Männer überlebten.
Baue nun ein zweites Modell und sage voraus, dass alle Frauen überlebt haben und alle Männer nicht. Auch das ist nicht realistisch, liefert aber eine bessere Baseline für den Vergleich mit zukünftigen Modellen.
df_test eine Spalte 'Survived', die obige Vorhersage abbildet.'PassengerId' und 'Survived' von df_test als .csv und reiche sie bei Kaggle ein.df_test['Survived'] = df_test.Sex == 'female'
df_test['Survived'] = df_test.Survived.apply(lambda x: int(x))
df_test.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Survived | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 892 | 3 | Kelly, Mr. James | male | 34.5 | 0 | 0 | 330911 | 7.8292 | NaN | Q | 0 |
| 1 | 893 | 3 | Wilkes, Mrs. James (Ellen Needs) | female | 47.0 | 1 | 0 | 363272 | 7.0000 | NaN | S | 1 |
| 2 | 894 | 2 | Myles, Mr. Thomas Francis | male | 62.0 | 0 | 0 | 240276 | 9.6875 | NaN | Q | 0 |
| 3 | 895 | 3 | Wirz, Mr. Albert | male | 27.0 | 0 | 0 | 315154 | 8.6625 | NaN | S | 0 |
| 4 | 896 | 3 | Hirvonen, Mrs. Alexander (Helga E Lindqvist) | female | 22.0 | 1 | 1 | 3101298 | 12.2875 | NaN | S | 1 |
df_test[['PassengerId', 'Survived']].to_csv('../data/predictions/women_survive.csv', index=False)
Welche Genauigkeit erzielt dieses Modell bei Kaggle?
Die Accuracy auf Kaggle beträgt 76,6%:
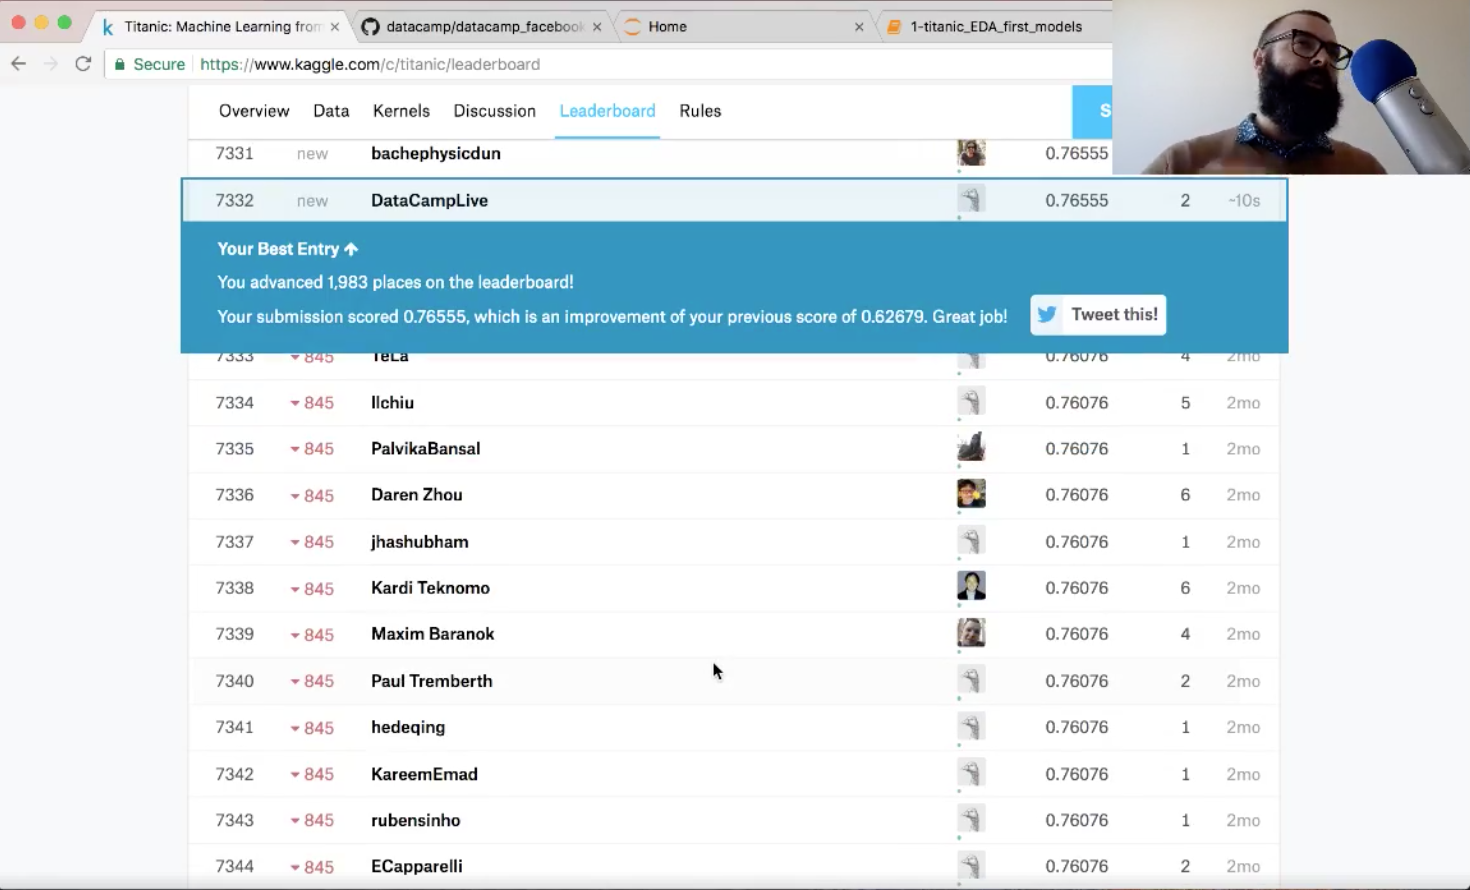
Mit dieser Einreichung bist du um etwa 2.000 Plätze im Leaderboard nach oben geklettert! Außerdem hast du deine Punktzahl verbessert – starke Leistung!
seaborn, um Balkendiagramme der Zielvariable 'Survived' facettiert nach 'Pclass' zu erstellen.sns.factorplot(x='Survived', col='Pclass', kind='count', data=df_train);
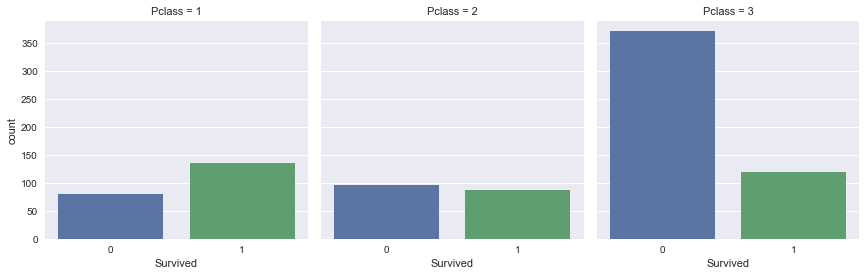
Fazit: Passagiere der ersten Klasse hatten bessere Überlebenschancen. Passagiere der dritten Klasse hatten deutlich schlechtere Chancen.
seaborn Balkendiagramme von 'Survived', facettiert nach 'Embarked'.sns.factorplot(x='Survived', col='Embarked', kind='count', data=df_train);
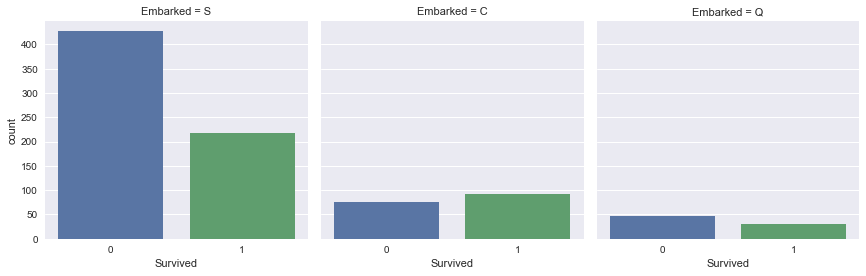
Fazit: Passagiere, die in Southampton einstiegen, hatten tendenziell geringere Überlebenschancen.
seaborn, um ein Histogramm der Spalte 'Fare' von df_train zu plotten.sns.distplot(df_train.Fare, kde=False);
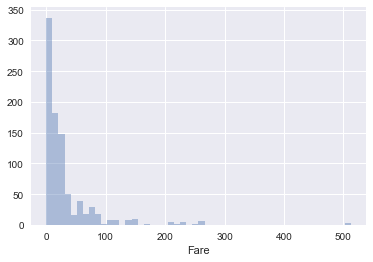
Fazit: Die meisten Passagiere zahlten weniger als 100 für die Überfahrt.
pandas-Plotmethode, um die Spalte 'Fare' für jede Ausprägung von 'Survived' im selben Plot darzustellen.df_train.groupby('Survived').Fare.hist(alpha=0.6);
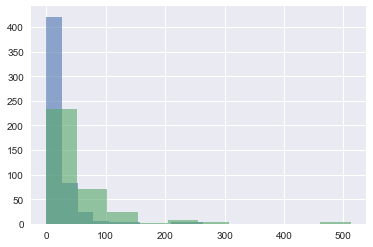
Fazit: Es sieht so aus, als hätten diejenigen mit höherem Fahrpreis eine größere Überlebenschance gehabt.
seaborn, um ein Histogramm der Spalte 'Age' von df_train zu plotten. Entferne zuvor fehlende Werte.df_train_drop = df_train.dropna()
sns.distplot(df_train_drop.Age, kde=False);
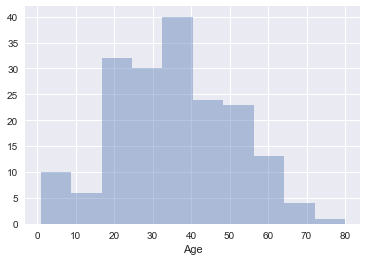
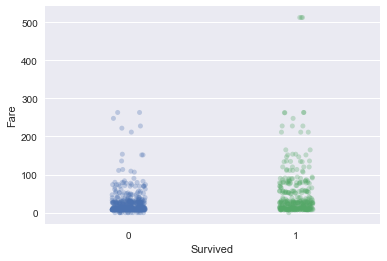
'Fare' mit 'Survived' auf der x-Achse.sns.stripplot(x='Survived', y='Fare', data=df_train, alpha=0.3, jitter=True);
sns.swarmplot(x='Survived', y='Fare', data=df_train);
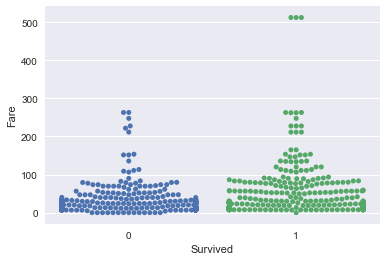
Fazit: Der Fahrpreis korreliert eindeutig mit der Überlebenswahrscheinlichkeit.
.describe(), um zusammenfassende Statistiken von 'Fare' in Abhängigkeit vom Überleben anzuzeigen.df_train.groupby('Survived').Fare.describe()
| count | mean | std | min | 25% | 50% | 75% | max | |
|---|---|---|---|---|---|---|---|---|
| Survived | ||||||||
| 0 | 549.0 | 22.117887 | 31.388207 | 0.0 | 7.8542 | 10.5 | 26.0 | 263.0000 |
| 1 | 342.0 | 48.395408 | 66.596998 | 0.0 | 12.4750 | 26.0 | 57.0 | 512.3292 |
seaborn, um einen Scatterplot von 'Age' gegen 'Fare' zu erstellen, eingefärbt nach 'Survived'.sns.lmplot(x='Age', y='Fare', hue='Survived', data=df_train, fit_reg=False, scatter_kws={'alpha':0.5});
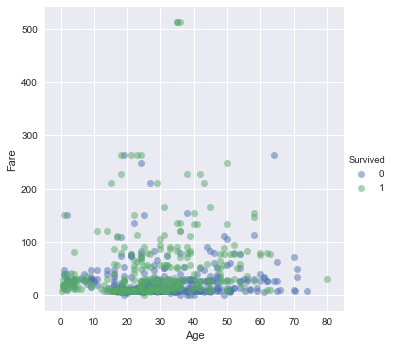
Fazit: Es scheint, dass Überlebende entweder deutlich mehr für ihr Ticket zahlten oder jung waren.
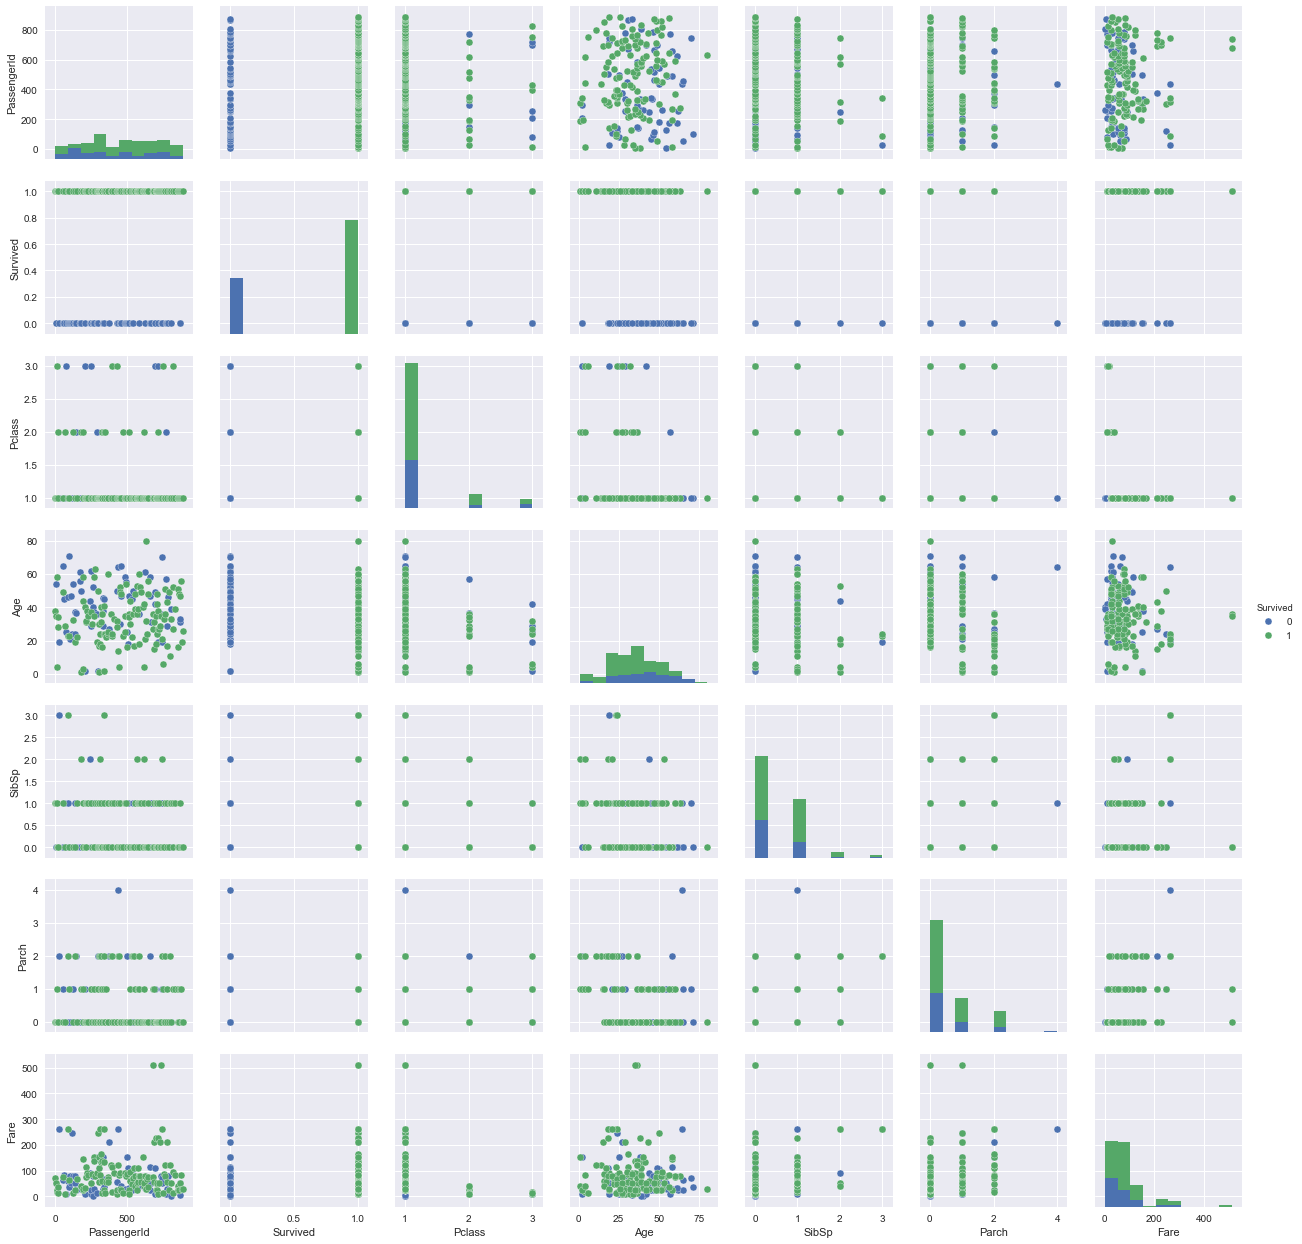
seaborn ein Pairplot von df_train, eingefärbt nach 'Survived'. Ein Pairplot fasst viele der bisherigen Erkenntnisse in einem Raster zusammen.sns.pairplot(df_train_drop, hue='Survived');
In diesem Tutorial hast du erfolgreich:
Im nächsten Beitrag nimmst du dir Zeit, Machine-Learning-Modelle auf Basis der hier gewonnenen Erkenntnisse zu bauen. Das machen wir im nächsten Post zu diesem Projekt (Veröffentlichung am 27. Dezember).
Python-Kurse
Kurs
Kurs