
Curso
Introdução ao Python
4 h
7M
Com a Análise Exploratória de Dados (EDA) e o modelo baseline em mãos, você já pode começar a trabalhar no seu primeiro modelo real de Machine Learning.
Observação: este tutorial é baseado em uma sessão de code along transmitida ao vivo no Facebook; você pode assistir novamente aqui:
Antes de começar, importe todas as bibliotecas necessárias:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')
data que combina treino e teste. Fazemos isso porque vamos pré-processar os dados e queremos garantir que qualquer transformação aplicada no treino também seja aplicada no teste.# Store target variable of training data in a safe place
survived_train = df_train.Survived
# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])
data usando o método info().data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Há 2 variáveis numéricas com valores ausentes.
Quais são elas?
Isso mesmo: faltam valores nas colunas 'Age' e 'Fare'! No resultado do método .info() acima, dá para ver que faltam 263 valores na primeira coluna, já que há apenas 1046 valores não nulos em um total de 1309 linhas do DataFrame. O ideal seria ter todos os 1309 preenchidos, mas não é o caso aqui!
Felizmente, em Fare falta apenas um valor. Repare também que 'Cabin' e 'Embarked' têm ausências e você vai precisar tratar isso em algum momento.
Por agora, vamos focar nas variáveis numéricas: vamos imputar, ou seja, preencher os valores faltantes de 'Age' e 'Fare' usando a mediana dessas variáveis onde elas existem.
Observação: neste caso usamos a mediana porque ela lida bem com outliers. Em outras palavras, é útil quando a distribuição é assimétrica. Outras formas de imputar seriam usar a média (soma dos valores dividida pela quantidade) ou a moda (o valor mais frequente).
# Impute missing numerical variables
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())

# Check out info of data
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1309 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1309 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Bem melhor, né?
No tutorial anterior e no notebook, você viu várias features promissoras para prever 'Survived', com base na EDA. Uma delas foi 'Fare', mas também 'Age' e 'Sex'!
Como os modelos de machine learning geralmente trabalham com entradas numéricas, vamos codificar o sexo em números, transformando 'male' e 'female'. Você pode usar a função pandas .get_dummies() para isso:
data = pd.get_dummies(data, columns=['Sex'], drop_first=True)
data.head()
| PassengerId | Pclass | Name | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Sex_male | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | 1 |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | 0 |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | 0 |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | 0 |
| 4 | 5 | 3 | Allen, Mr. William Henry | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | 1 |
.get_dummies() cria uma nova coluna para cada opção em 'Sex'. Assim, ela criaria 'Sex_female' para female e 'Sex_male' para male, indicando se a linha é masculina ou feminina.
Como adicionamos o argumento drop_first, 'Sex_female' foi descartada, já que essas duas colunas codificariam a mesma informação.
Então, no fim, criamos apenas 'Sex_male', que recebe 1 se a linha é masculina e 0 se é feminina.
.get_dummies() vai ser um dos seus melhores aliados na manipulação de dados para machine learning!
['Sex_male', 'Fare', 'Age','Pclass', 'SibSp'] do DataFrame para construir seu primeiro modelo de machine learning:# Select columns and view head
data = data[['Sex_male', 'Fare', 'Age','Pclass', 'SibSp']]
data.head()
| Sex_male | Fare | Age | Pclass | SibSp | |
|---|---|---|---|---|---|
| 0 | 1 | 7.2500 | 22.0 | 3 | 1 |
| 1 | 0 | 71.2833 | 38.0 | 1 | 1 |
| 2 | 0 | 7.9250 | 26.0 | 3 | 0 |
| 3 | 0 | 53.1000 | 35.0 | 1 | 1 |
| 4 | 1 | 8.0500 | 35.0 | 3 | 0 |
.info() para inspecionar data:data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 5 columns):
Sex_male    1309 non-null uint8
Fare        1309 non-null float64
Age         1309 non-null float64
Pclass      1309 non-null int64
SibSp       1309 non-null int64
dtypes: float64(2), int64(2), uint8(1)
memory usage: 52.4 KB
Todas as linhas agora estão completas. Ótimo trabalho!
Até aqui, você deixou os dados prontos para construir seu primeiro modelo de machine learning. Isso significa que finalmente podemos treinar o primeiro modelo!
Para saber mais sobre pandas, confira nossa trilha Data Manipulation with Python.
O que é um classificador de árvore de decisão? É uma árvore que permite classificar pontos de dados (variável alvo) com base em variáveis de entrada (features).
Por exemplo, a árvore abaixo tem um nó raiz que força uma primeira decisão com a pergunta: "'Sex_male' é menor que 0,5?". Em outras palavras, o ponto de dado é feminino? Se a resposta for True, siga à esquerda e o resultado é 'Survived'. Se for False, siga à direita e o resultado é 'Dead'.
Por enquanto, não se preocupe com as informações adicionais nos nós, como gini, samples ou value. Você pode checar isso depois!
'Male' leva à previsão 'Dead'.Observação: na prática é o coeficiente gini que orienta essas decisões. Por ora, não vamos nos aprofundar nisso.
data, separe novamente em treino e teste:data_train = data.iloc[:891]
data_test = data.iloc[891:]
scikit-learn, que espera arrays (e não DataFrames). Então, transforme-os:X = data_train.values
test = data_test.values
y = survived_train.values
max_depth=3 e depois ajuste-o aos dados. Observação: chamamos o modelo de clf, abreviação de "Classifier".# Instantiate model and fit to data
clf = tree.DecisionTreeClassifier(max_depth=3)
clf.fit(X, y)
DecisionTreeClassifier(class_weight=None, criterion='gini', max_depth=3,
            max_features=None, max_leaf_nodes=None,
            min_impurity_decrease=0.0, min_impurity_split=None,
            min_samples_leaf=1, min_samples_split=2,
            min_weight_fraction_leaf=0.0, presort=False, random_state=None,
            splitter='best')
As variáveis de entrada X são o primeiro argumento passado a .fit(), enquanto a variável alvo, y, é o segundo.
A saída mostra tudo o que você precisa saber sobre o classificador que acabou de construir: por exemplo, a profundidade máxima está definida como 3.
'Survived' e armazene nelas as previsões. Salve as colunas 'PassengerId' e 'Survived' de df_test em um .csv e envie ao Kaggle.# Make predictions and store in 'Survived' column of df_test
Y_pred = clf.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/1st_dec_tree.csv', index=False)
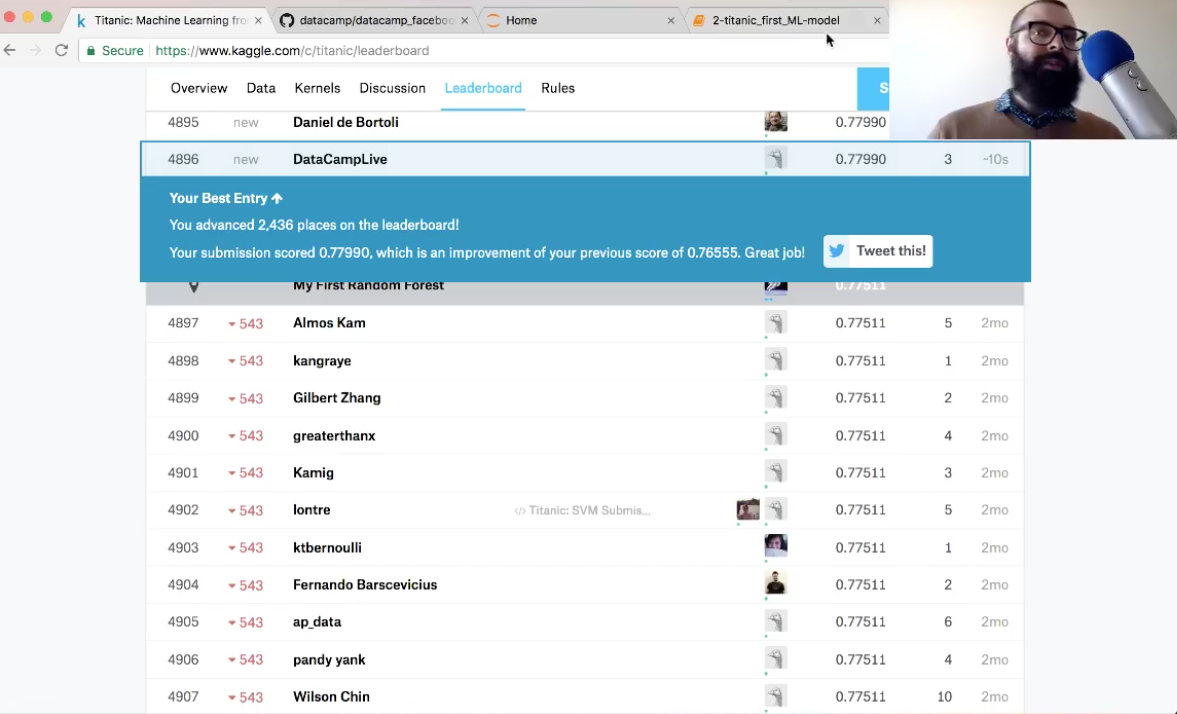
A acurácia foi de 78%. Você subiu mais de 2.000 posições!
Parabéns! Você deixou os dados prontos e construiu seu primeiro modelo de machine learning: um classificador de árvore de decisão.
Agora vamos entender o que é o argumento max_depth, por que escolhemos esse valor e explorar o train_test_split.
Para saber mais sobre scikit-learn, confira nosso curso Supervised Learning with scikit-learn.
O classificador que você construiu tem max_depth=3 e se parece com isto:
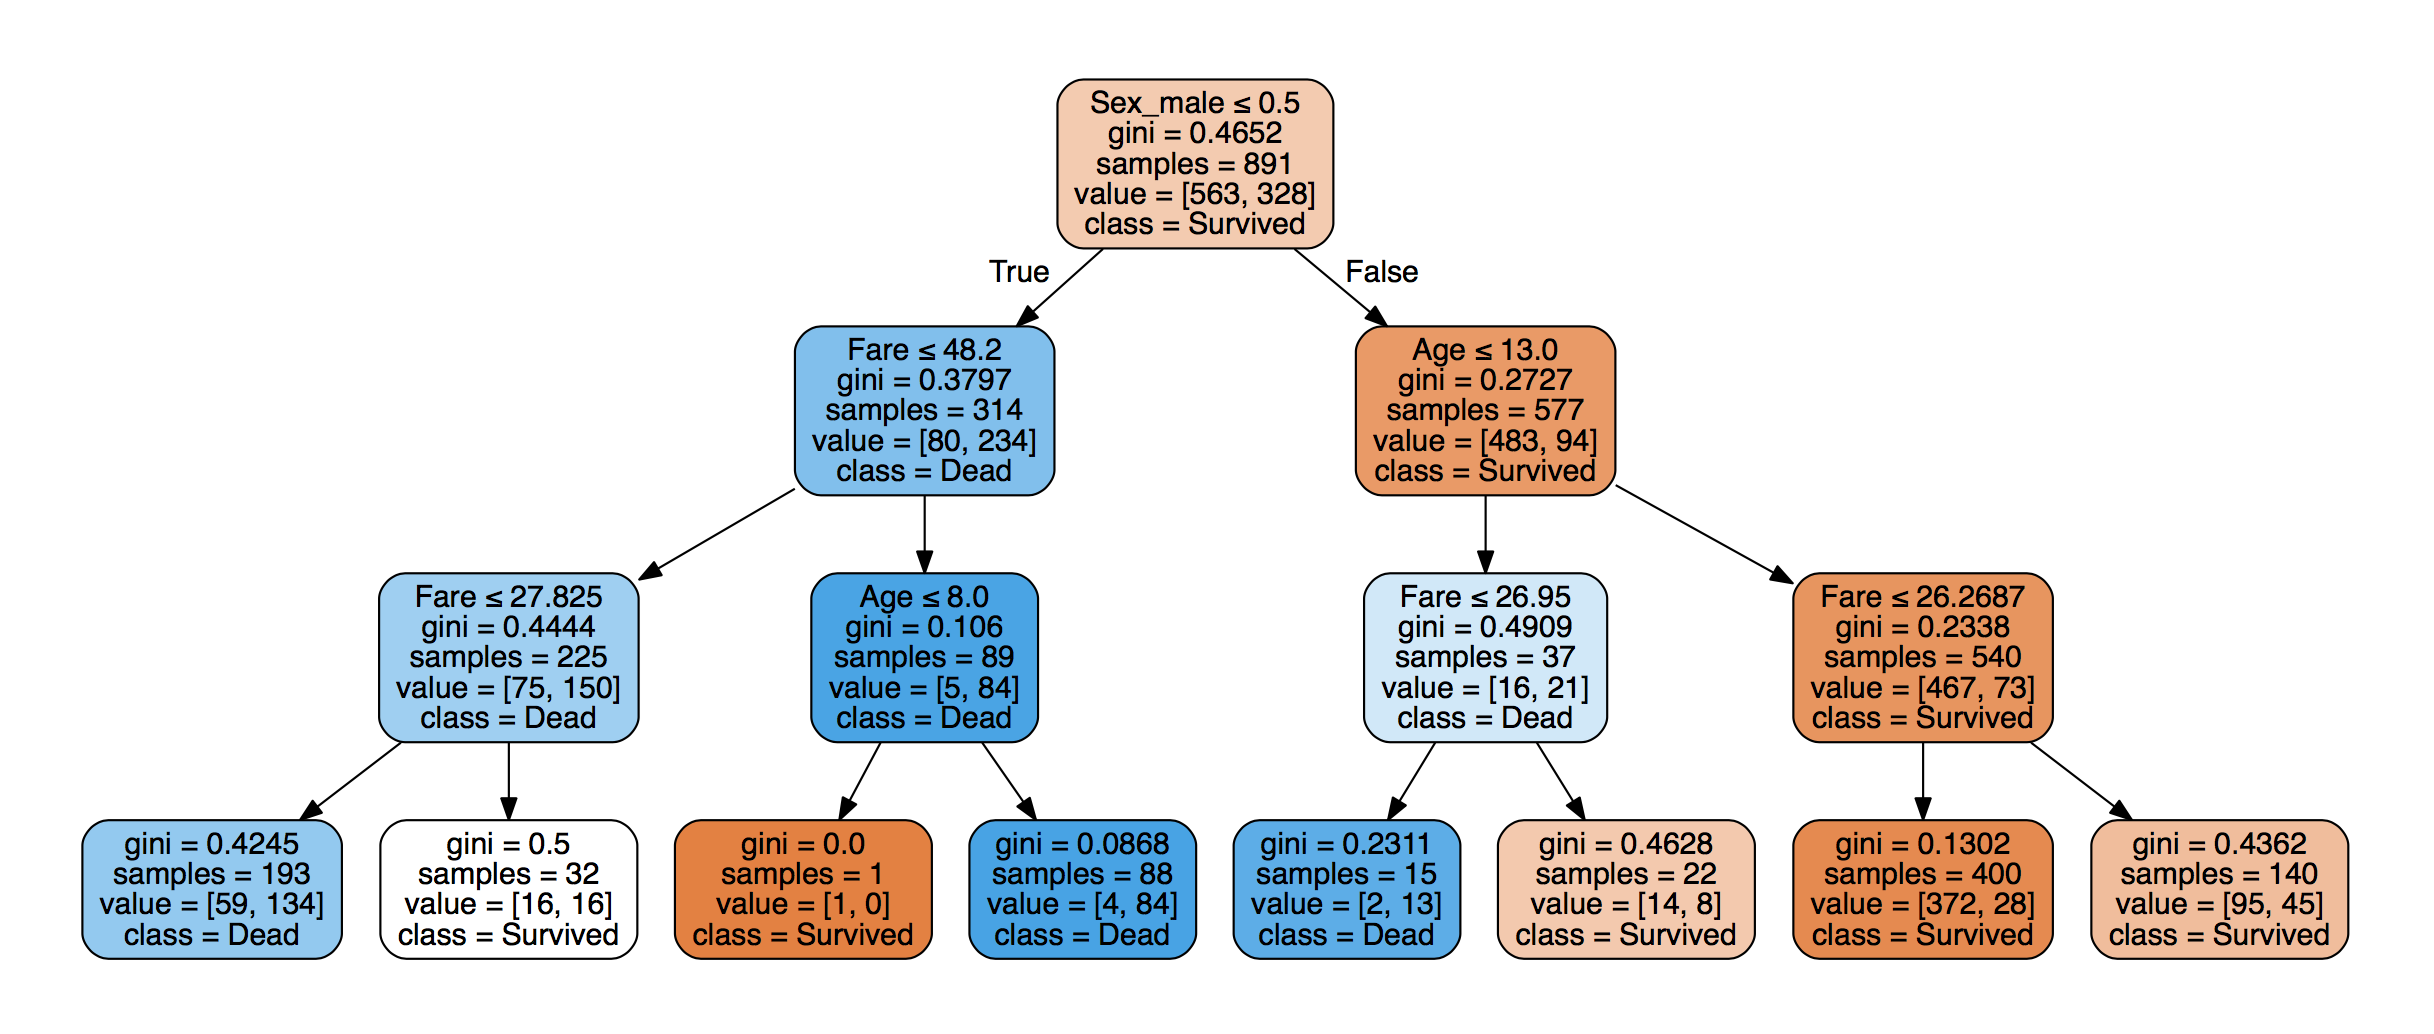
A distância máxima entre a primeira decisão e a última é 3, por isso max_depth=3.
Observação: você pode usar graphviz para gerar figuras como esta. Veja a documentação do scikit-learn aqui para mais detalhes.
Ao construir esse modelo, essencialmente criamos uma fronteira de decisão no espaço das features, por exemplo (imagem de aqui):
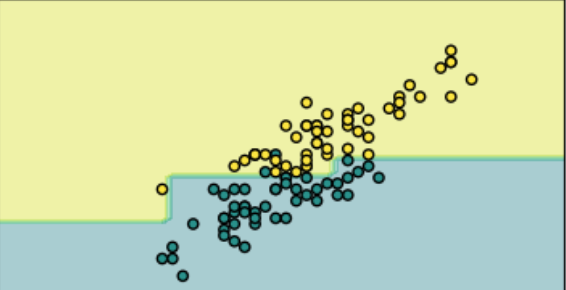
max_depth=3?A profundidade da árvore é um hiperparâmetro, ou seja, um parâmetro que você define antes de ajustar o modelo. Se você escolher um max_depth maior, terá uma fronteira de decisão mais complexa.
Se a fronteira de decisão for complexa demais, você pode superajustar (overfitting), ou seja, o modelo passa a capturar ruído além do sinal.
Se o max_depth for muito pequeno, você pode subajustar (underfitting), deixando de capturar sinal suficiente.
Mas como saber se há overfitting ou underfitting?
Observação: isso também é conhecido como trade-off viés-variância; não vamos entrar em detalhes aqui, só para completar!
Uma forma é separar um conjunto de teste a partir dos dados de treino. Ajuste o modelo no treino, faça previsões no teste e veja o desempenho no teste.
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.33, random_state=42, stratify=y)
max_depth de 1 a 9 e plote a acurácia nos conjuntos de treino e teste:# Setup arrays to store train and test accuracies
dep = np.arange(1, 9)
train_accuracy = np.empty(len(dep))
test_accuracy = np.empty(len(dep))
# Loop over different values of k
for i, k in enumerate(dep):
# Setup a Decision Tree Classifier
clf = tree.DecisionTreeClassifier(max_depth=k)
# Fit the classifier to the training data
clf.fit(X_train, y_train)
#Compute accuracy on the training set
train_accuracy[i] = clf.score(X_train, y_train)
#Compute accuracy on the testing set
test_accuracy[i] = clf.score(X_test, y_test)
# Generate plot
plt.title('clf: Varying depth of tree')
plt.plot(dep, test_accuracy, label = 'Testing Accuracy')
plt.plot(dep, train_accuracy, label = 'Training Accuracy')
plt.legend()
plt.xlabel('Depth of tree')
plt.ylabel('Accuracy')
plt.show()
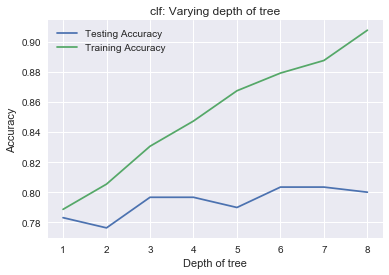
Conforme você aumenta o max_depth, o ajuste ao treino melhora cada vez mais, porque as decisões passam a descrever melhor o conjunto de treino. A acurácia no treino sobe sem parar, mas isso não acontece com o teste: é overfitting.
Por isso escolhemos max_depth=3.
Neste tutorial, você deixou os dados prontos para construir seu primeiro modelo de machine learning. Depois, também construiu seu primeiro modelo: um classificador de árvore de decisão. Por fim, você conheceu o train_test_split e como ele ajuda a escolher hiperparâmetros de modelos de ML.
No próximo tutorial, que sairá na DataCamp Community em 10 de janeiro de 2018, você vai aprender a criar novas features e a construir novos modelos!
Enquanto isso, se quiser explorar mais sobre scikit-learn, confira o curso da DataCamp Supervised Learning with scikit-learn.
Cursos de machine learning
Curso
Curso
Tutorial
Kevin Babitz
8 min
Tutorial
Moez Ali
14 min
Tutorial
Arunn Thevapalan
15 min
Tutorial
Avinash Navlani
10 min
Tutorial
Tutorial
Abid Ali Awan
11 min





