
Curso
Introducción a los modelos Claude
3 h
14.3K
En los últimos días se han intensificado los rumores sobre el próximo lanzamiento de Anthropic. Aunque muchos esperaban Claude Sonnet 5, la primera novedad del año llega en forma de Claude Opus 4.6.
Con una ventana de contexto de 1 millón de tokens, razonamiento adaptativo, compactación de conversaciones y una batería de benchmarks en los que lidera, Claude Opus 4.6 mejora a Opus 4.5. Como lo define Anthropic, han actualizado su modelo más inteligente. Junto con el modelo, Anthropic también lanzó equipos de agentes en Claude Code y Claude in PowerPoint.
En este artículo, cubrimos todo lo nuevo de Claude Opus 4.6: repasamos sus funciones, exploramos los benchmarks y lo ponemos a prueba con varios ejemplos prácticos.
Para conocer algunas de las últimas funciones de Claude, te recomiendo nuestros tutoriales de Claude Cowork y Claude Code, así como nuestro tutorial de OpenClaw. Para comparar con otros competidores, lee nuestras guías Muse Spark vs Claude Opus 4.6 y GPT-5.4 vs Claude Opus 4.6.
Claude Opus 4.6 es el último modelo de lenguaje grande de Anthropic. Tras Opus 4.5, supone una mejora notable del nivel de modelo más "inteligente" de la compañía.
Según el blog de lanzamiento, Anthropic afirma que pone más foco en código agentivo, razonamiento profundo y autocorrección. Es decir, cambia de la acción a la acción sostenida.
Opus 4.6 está diseñado para planificar con más cuidado, mantener la coherencia durante periodos más largos e identificar errores en su propio proceso. Todo esto hace que Claude Opus 4.6 lidere varios benchmarks, incluido el primer puesto en la evaluación de código Terminal-Bench 2.0 y superar a otros modelos de frontera en Humanity’s Last Exam.
Una de las mejoras que más me llama la atención es la ventana de contexto de Claude Opus 4.6. Con 1 millón de tokens en beta, se pone a la altura de Gemini 3, lo que significa que puede procesar más información sin perder el hilo del contexto.
Mientras tanto, Anthropic ha publicado el sucesor de Opus. Te recomiendo leer nuestra guía de Claude Opus 4.7 para estar al día.
Claude Opus 4.6 introduce varias funciones destacadas, muchas de ellas enfocadas en flujos de trabajo con agentes. Veamos los puntos clave:
Los equipos de agentes mejoran los "subagentes" vistos en versiones anteriores de Claude. Permiten crear múltiples instancias de Claude totalmente independientes que pueden trabajar en paralelo. Una sesión actúa como agente "líder" que coordina, mientras que los "compañeros" se encargan de la ejecución.
Lo más interesante es que cada miembro del equipo tiene su propia ventana de contexto, lo que permite ejecuciones más completas. Además, cada compañero puede comunicarse directamente con los demás del equipo.
Claro que esta función tiene una posible desventaja: el coste. Como cada agente tiene su propia ventana de contexto, puedes devorar tokens rápidamente. Por ello, Anthropic recomienda usarlos en escenarios con alta complejidad.
Una función muy práctica de Claude Opus 4.6 es la compactación del contexto. Este pequeño gran cambio ayuda a evitar problemas cuando ejecutas flujos largos que llenan la ventana de contexto. Normalmente, chocas con un límite y el rendimiento empieza a degradarse.
Con la compactación de conversaciones, Claude Opus 4.6 detecta automáticamente cuándo una conversación está llegando a un umbral de tokens y resume el intercambio en un bloque conciso (un bloque de compactación).
Esto ayuda a preservar lo esencial de tus interacciones y a la vez liberar espacio para seguir trabajando. Si piensas usar agentes orientados a tareas que deban ejecutarse durante mucho tiempo, esta memoria mejorada puede mantenerlos en el buen camino.
Dos funciones de Claude Opus 4.6 determinan si necesita usar razonamiento extendido y con qué intensidad aplicarlo.
El razonamiento adaptativo permite al modelo estimar la complejidad de tu prompt. En función de esa complejidad, decide si usar razonamiento extendido. En lugar de un ajuste manual del número de tokens dedicados a esto, Claude ajusta su presupuesto según la dificultad de cada solicitud.
El parámetro de esfuerzo te deja definir si Claude es más prudente o más dispuesto a gastar tokens. En esencia, te permite equilibrar eficiencia de tokens y exhaustividad de las respuestas.
Si usas Claude Opus 4.6 en la API, puedes fijar estos parámetros manualmente. Por ejemplo:
Hace poco hablamos de Claude in Excel, mostrando cómo el complemento te puede ayudar desde un panel lateral de tu hoja de Excel. Además de mejorar esta herramienta, Anthropic anunció Claude in PowerPoint.
Esta integración respeta tus patrones de diapositivas, tipografías y maquetaciones. Puedes darle tu plantilla corporativa y pedirle que construya una sección concreta, o seleccionar una diapositiva y pedirle que convierta un texto denso en un diagrama nativo y editable.
El énfasis en generar objetos editables de PowerPoint y no simples "imágenes de diapositivas" lo convierte en una herramienta de productividad real y no solo en un generador de ideas.
Claude in PowerPoint está actualmente en vista previa de investigación para usuarios Max y Enterprise.
Muchas de las promesas de Opus 4.6 giran en torno a tareas de programación más complejas y razonamiento más profundo. Estas habilidades se apoyan en algo básico: sostener múltiples restricciones en mente, razonar a través de varios pasos y detectar errores.
Con esto en mente, sometimos a Opus 4.6 a una serie de retos de lógica multietapa, matemáticas y código. Queríamos ver si podíamos destapar debilidades conocidas y habituales en LLMs: errores de cálculo en cascada, razonamiento espacial (siempre problemático) y cuestiones con restricciones. También incluimos una tarea de depuración específica porque el anuncio de Anthropic presumía del buen desempeño de Opus 4.6 en análisis de causa raíz y otros problemas de debugging.
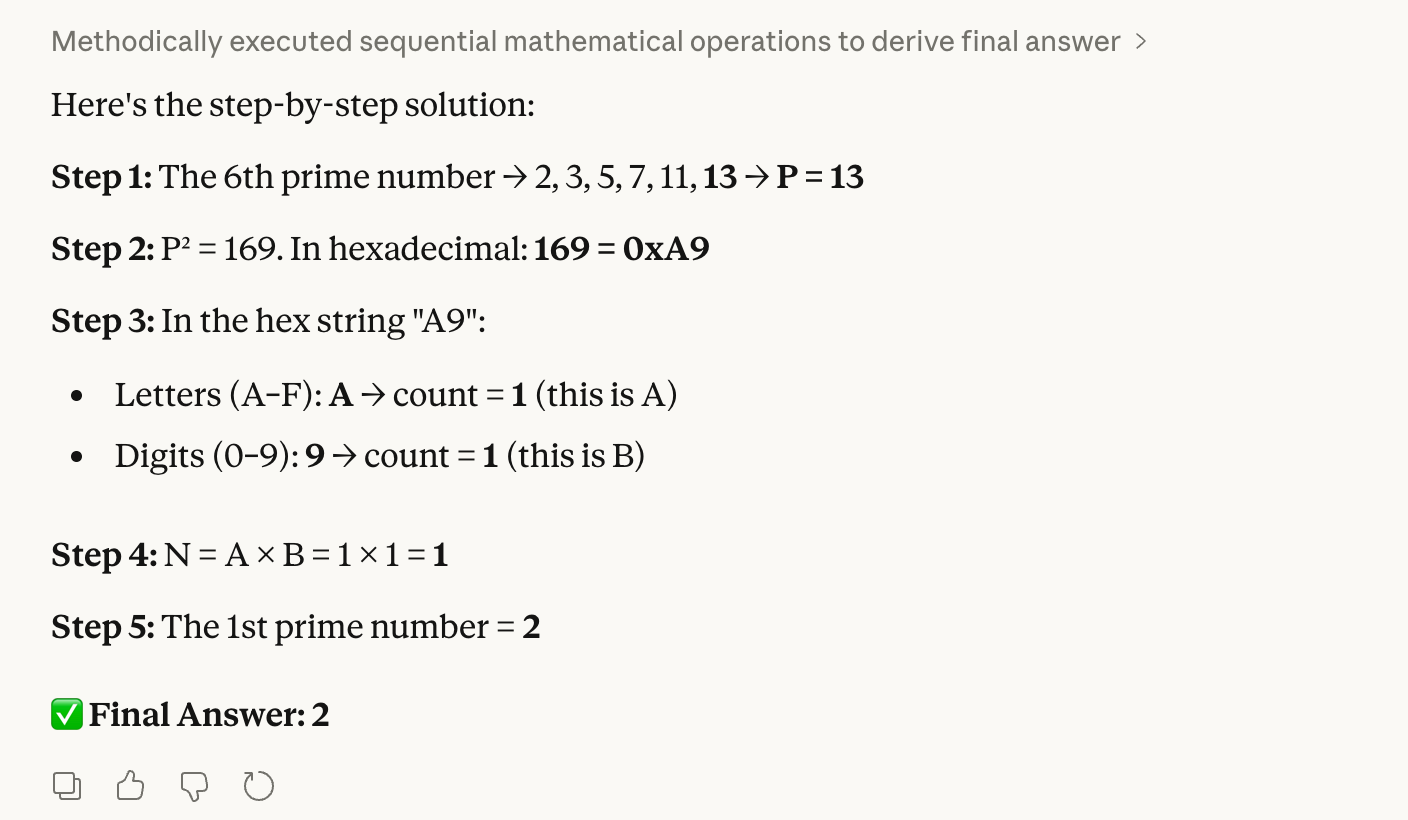
La primera prueba combina números primos, hexadecimales y conteo:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
Suena algo enrevesado, pero es fácil de verificar para nosotros. Sabemos que la respuesta correcta es 2 porque el 6.º primo es 13; 13 al cuadrado es 169, que en hex es "A9". Esto tiene 1 letra × 1 dígito, lo que da 1 al multiplicarlos, y el primer primo es 2.
La preocupación es que el modelo pueda fallar en la conversión a hex y arrastre el error hasta el final. Como verás, Opus 4.6 no tuvo ningún problema:
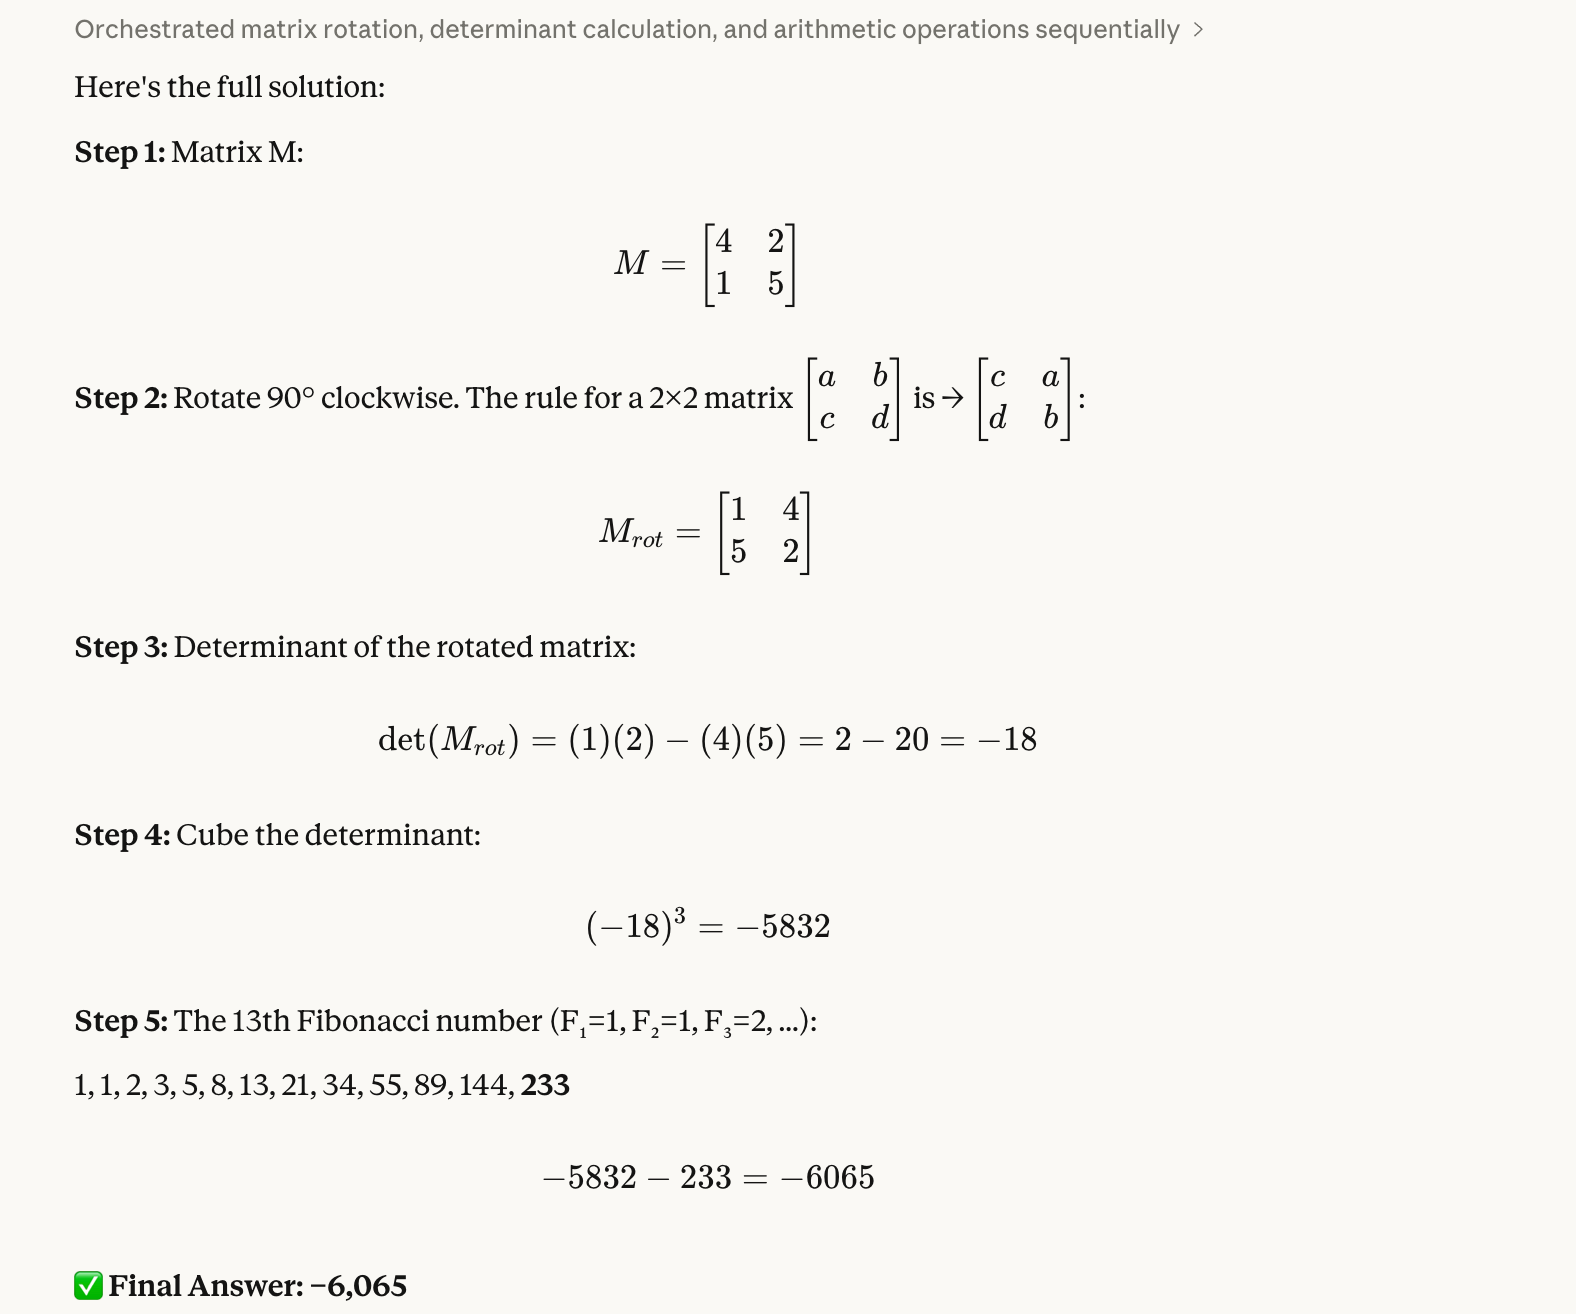
La segunda prueba evalúa razonamiento espacial y manejo de números negativos:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
Esta nos llevó un poco más de trabajo para verificar. La respuesta correcta es -6.065. Lo sabemos porque la matriz rotada es [[1, 4], [5, 2]]; luego podemos usar Python para hallar el determinante, que es -18; al elevar al cubo obtenemos -5.832; finalmente restamos 233 y da -6.065.
Nos gustaba esta prueba porque, por experiencia, los modelos suelen permutar mal los elementos de la matriz o pierden el signo negativo por el camino. De nuevo, Opus 4.6 lo resolvió sin problema:
En la tercera prueba, planteamos un problema de satisfacción de restricciones que exige backtracking:
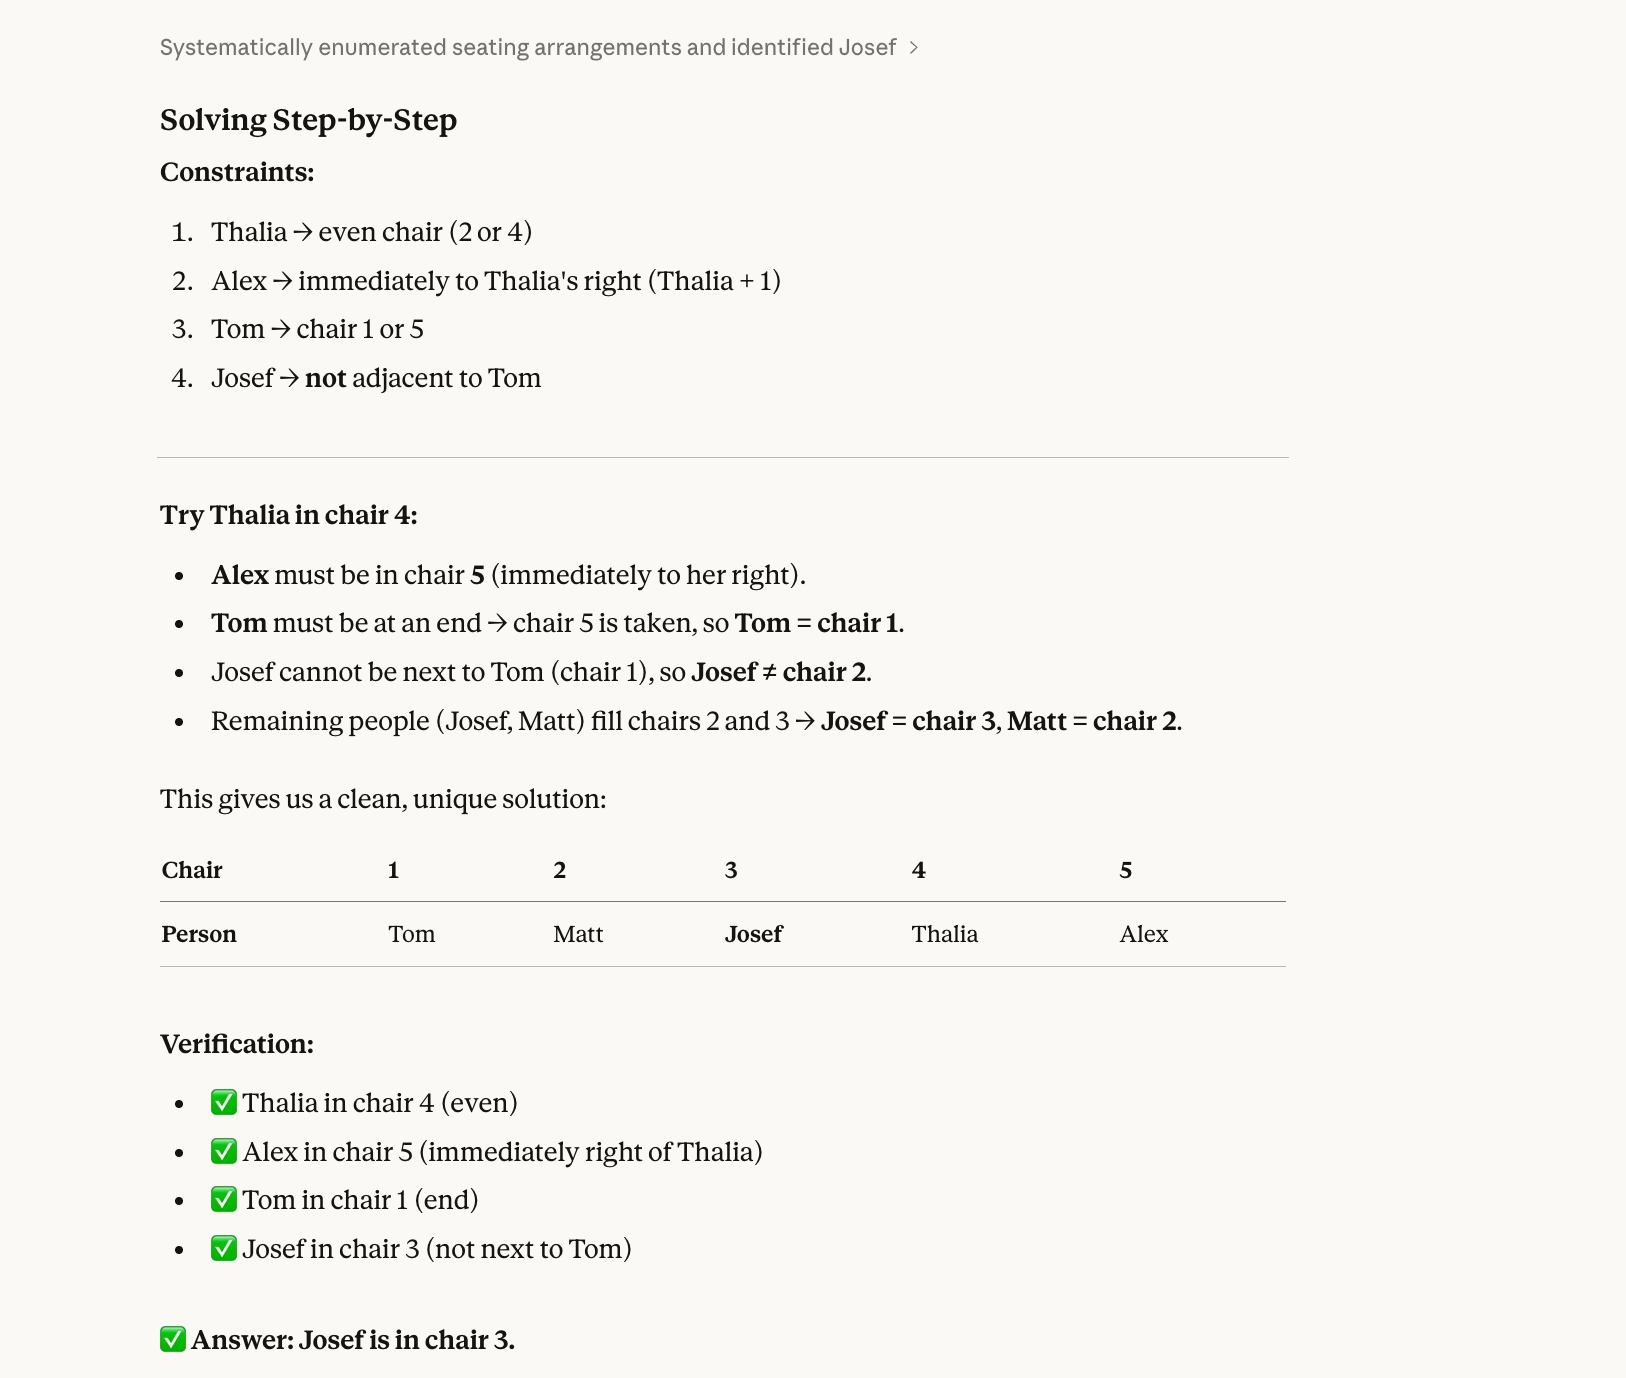
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
La respuesta correcta es Josef. (Alex-1, Matt-2, Josef-3, Thalia-4, Tom-5.) Puedes resolverlo en papel con algo de paciencia.
Los modelos suelen fallar este tipo de preguntas porque históricamente resuelven de forma secuencial, no holística. Leen "Thalia está en una silla par" y eligen una (digamos, la 2) sin comprobar si esa elección encaja con todas las demás restricciones. Luego se comprometen, rellenan más sillas y al final topan con un conflicto, pero ya se han encajonado y no vuelven atrás para probar a Thalia en la silla 4.
Opus 4.6 también acertó en esta:
La cuarta prueba evalúa visualización espacial e intuición física:
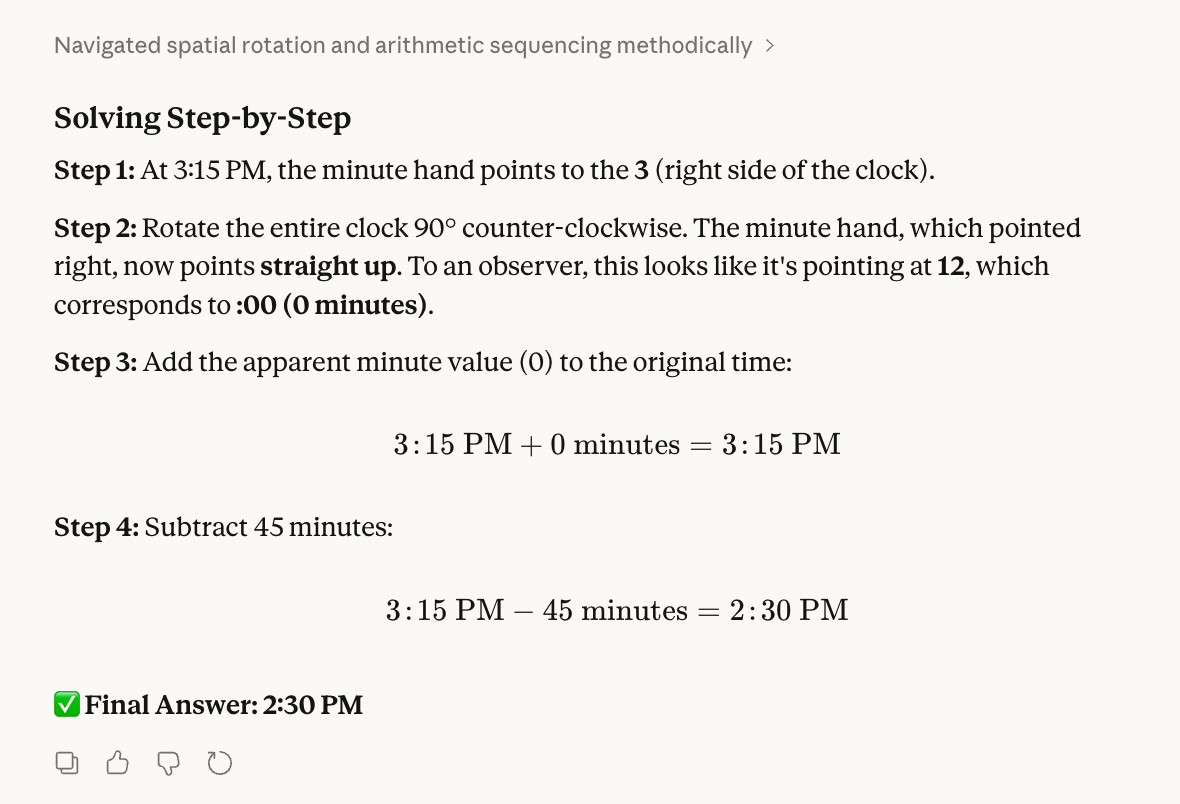
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
Para comprobarlo, literalmente me quité el reloj y lo giré.
La respuesta correcta es 14:30. A las 3:15, la manecilla de minutos apunta al "3". Cuando giré el reloj poniendo el 12 hacia la ventana de mi izquierda, el "3" quedó donde estaba el "12". Luego sumé 0 a 3:15, resté 45 minutos y obtuve las 14:30.
Al diseñar la prueba, esperábamos que los modelos confundieran girar la esfera del reloj con mover la manecilla. También hemos visto que tienden a sospechar de sumar 0 y, por tanto, fuerzan otro número.
Sin embargo, Opus 4.6 resolvió el problema y dio la respuesta correcta:
La quinta prueba combina aritmética modular con filtrado de primos:
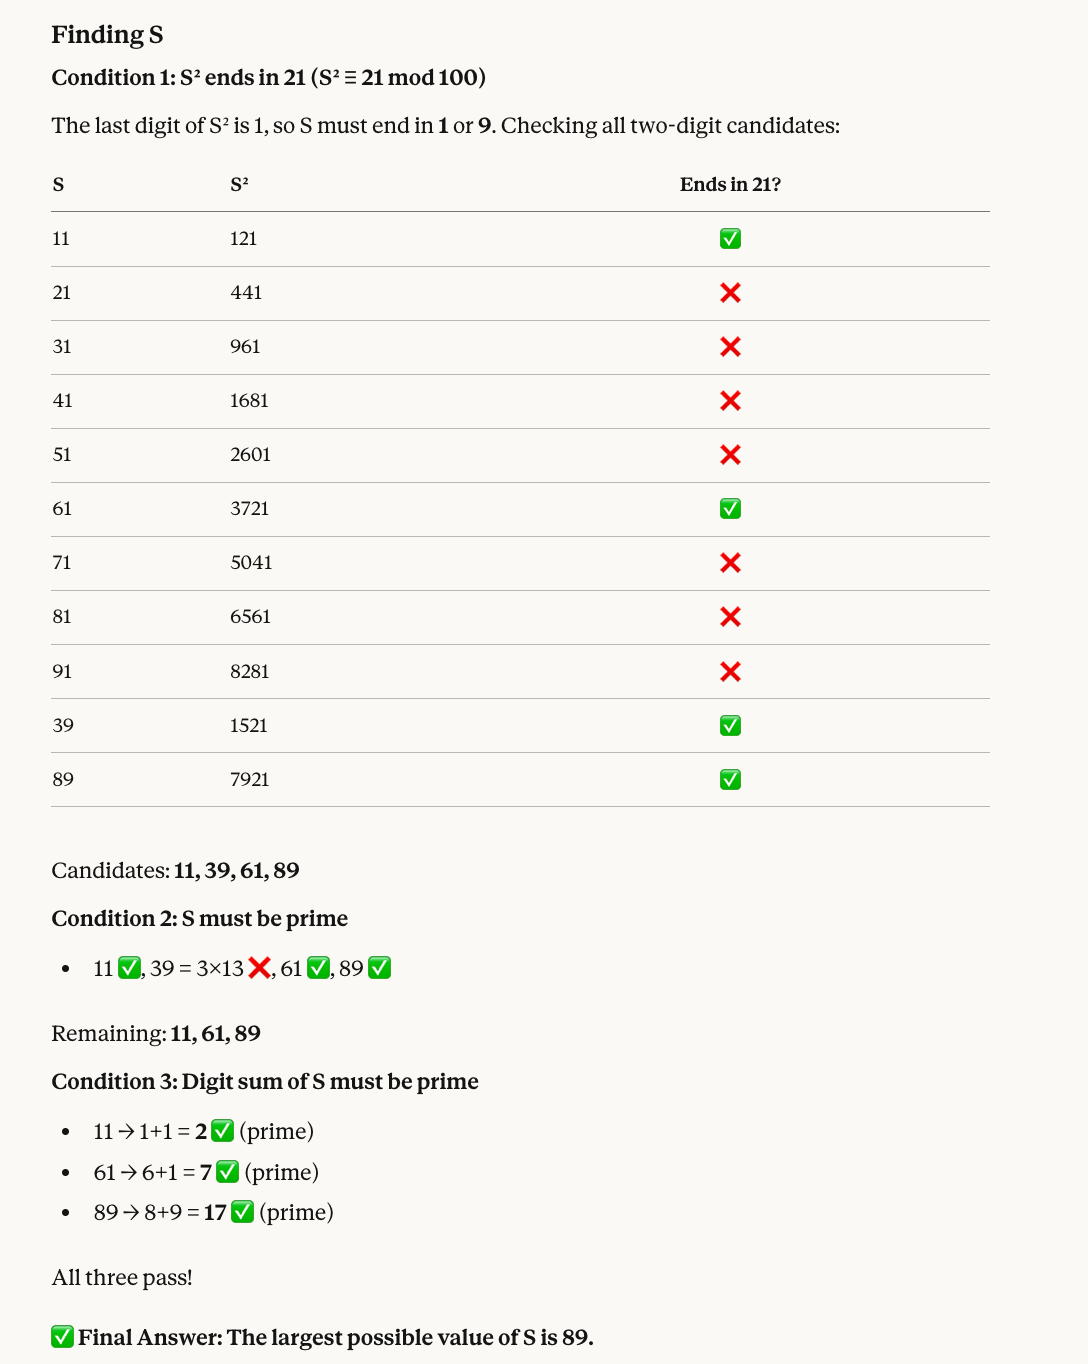
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
Esta es la razón por la que el número correcto es 89: Los números cuyo cuadrado termina en 21 incluyen 11, 39, 61 y 89. De ellos, 39 no es primo, así que quedan 11, 61 y 89. Los tres tienen suma de dígitos prima (2, 7 y 17, respectivamente), así que el mayor es 89.
Opus 4.6 volvió a acertar y, además, incluyó un visual útil:
La siguiente prueba encadena factoriales, manipulación de cadenas y números primos:
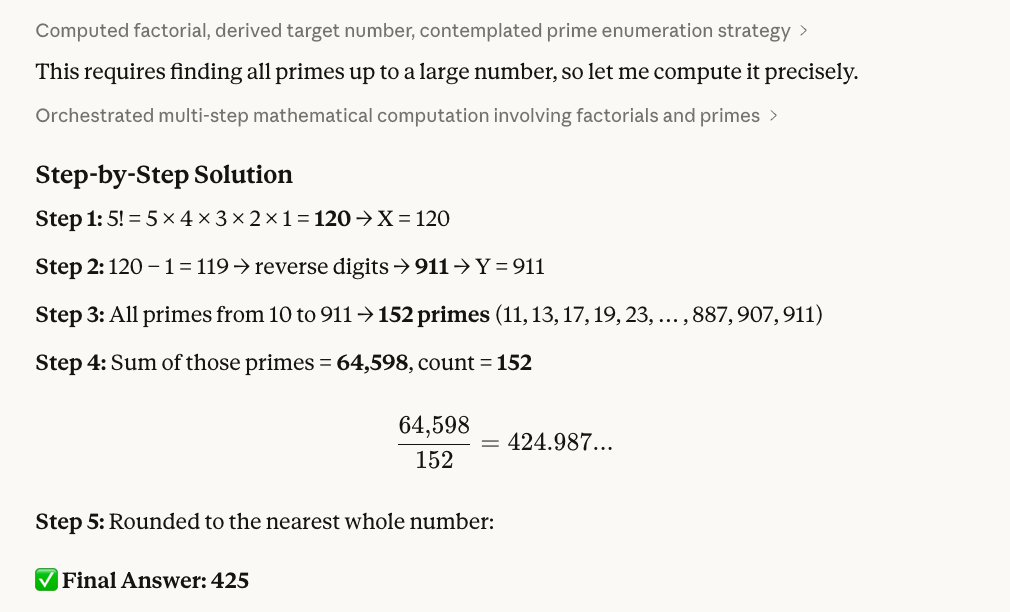
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
Así verificamos que 425 es la respuesta correcta: 5! = 120; restamos 1 para obtener 119; invertimos los dígitos y queda 911. Luego, con este código en R (abajo), vemos que hay 152 primos entre 10 y 911, y su suma es 64.598. Por último, dividimos y redondeamos: 64.598 ÷ 152 ≈ 425.
Este es el script en R que usamos:
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
cat("Step 5: Rounded =", round(avg), "\n")La siguiente prueba apunta a una de las grandes promesas de Opus 4.6: diagnosticar bugs en el código. Sabemos que los modelos suelen trazar el código línea a línea correctamente pero no conectan ese trazo con el fallo de fondo.
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
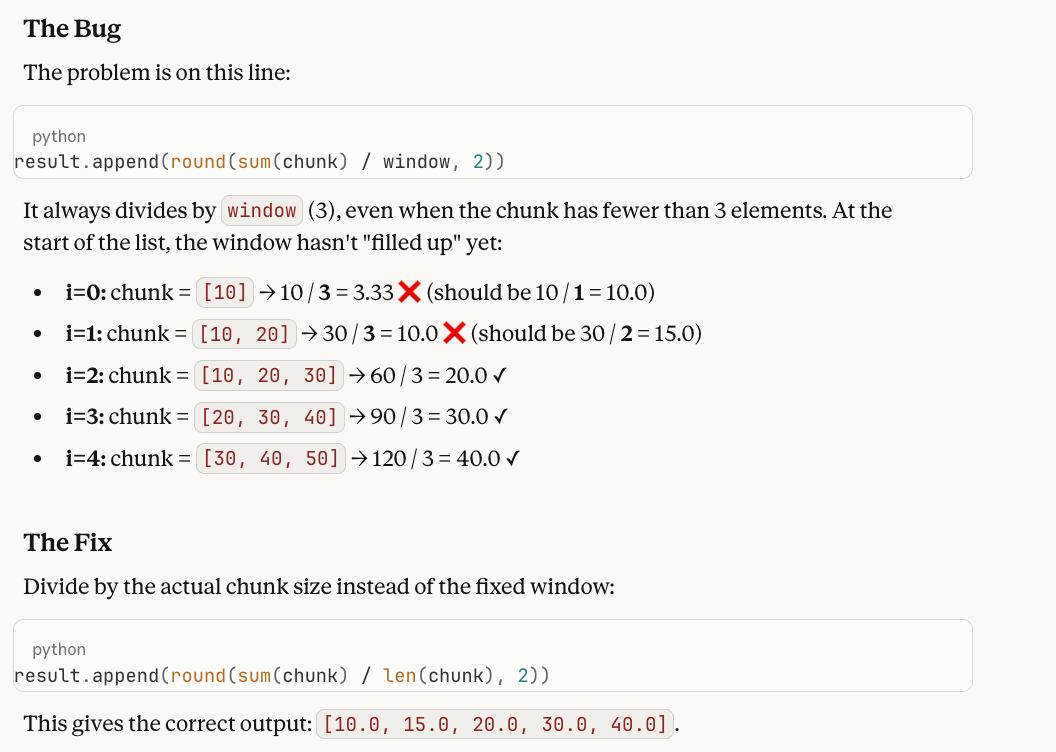
Esta es la explicación y por qué sirve como prueba: la función siempre divide por window (3), incluso cuando al principio la porción tiene menos de 3 elementos. La salida con bug es [3.33, 10.0, 20.0, 30.0, 40.0], pero los dos primeros valores deberían ser 10.0 y 15.0, ya que esas porciones contienen solo 1 y 2 elementos, respectivamente. La corrección es cambiar / window por / len(chunk).
Nos gusta esta prueba porque los modelos a menudo siguen el bucle a la perfección, pero luego dicen "la salida parece correcta": ven las cuentas paso a paso y no señalan que dividir un único elemento entre 3 está mal. Exige mantener la intención (qué debe hacer una media móvil) junto a la ejecución (qué hace el código en realidad) y detectar la brecha entre ambas.
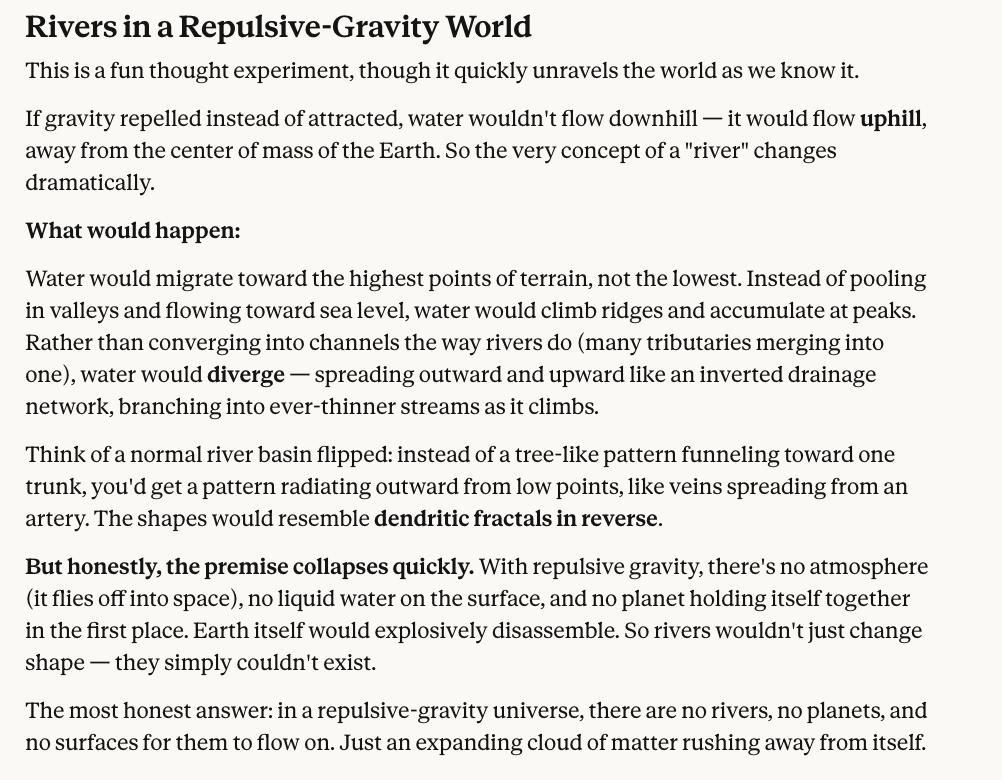
La última prueba no tiene matemáticas, solo razonamiento contrafactual.
In a world where gravity repels objects instead of attracting them, what shape would rivers take?No hay una única respuesta correcta, y cuesta imaginarlo. Pero buscamos que el modelo razone sobre las implicaciones, y creemos que la respuesta de Claude Opus 4.6 es bastante razonable.
En resumen, Opus 4.6 logró una puntuación perfecta, aunque, como has visto, incluimos una pregunta con respuesta algo subjetiva, así que el veredicto final es tuyo.
Opus 4.6 es el líder indiscutible en al menos cuatro benchmarks importantes:
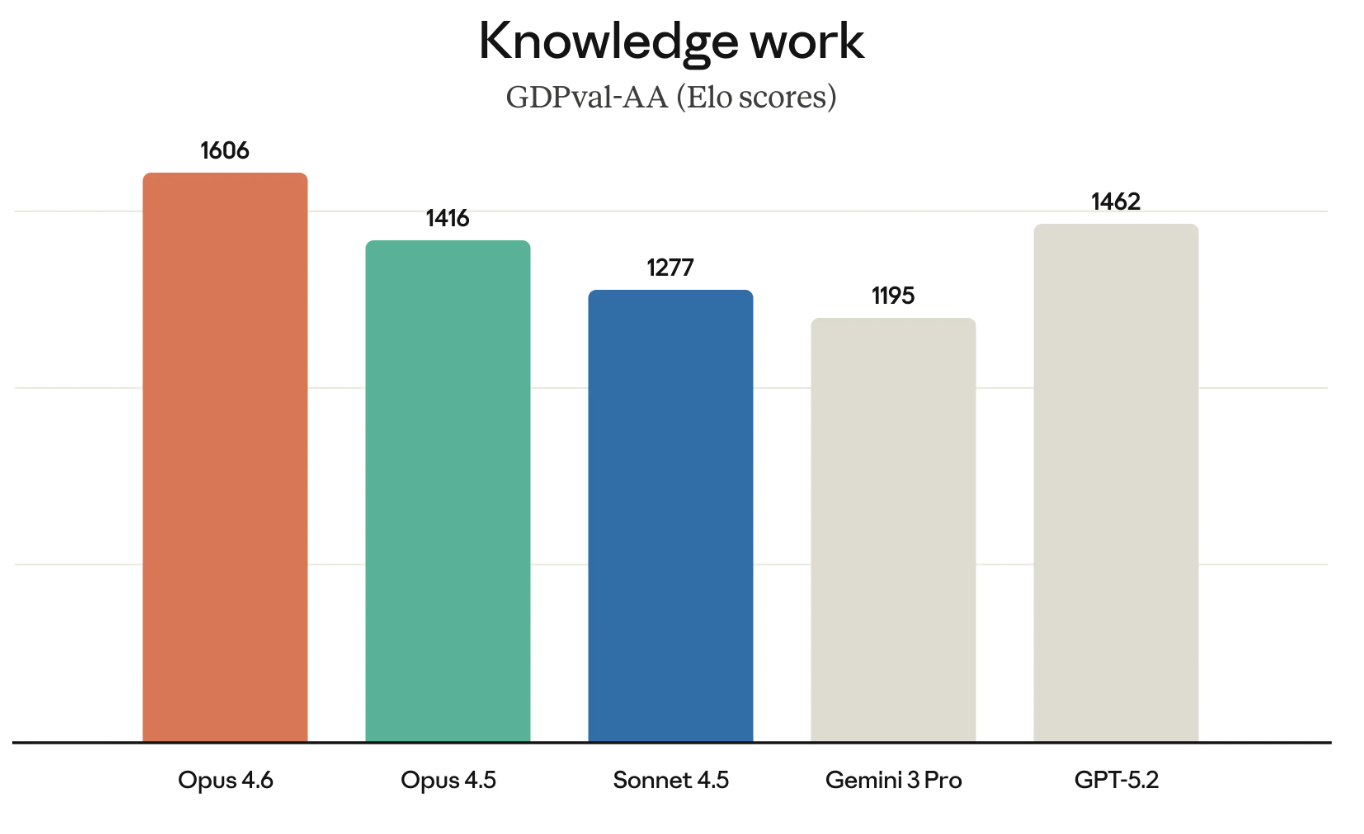
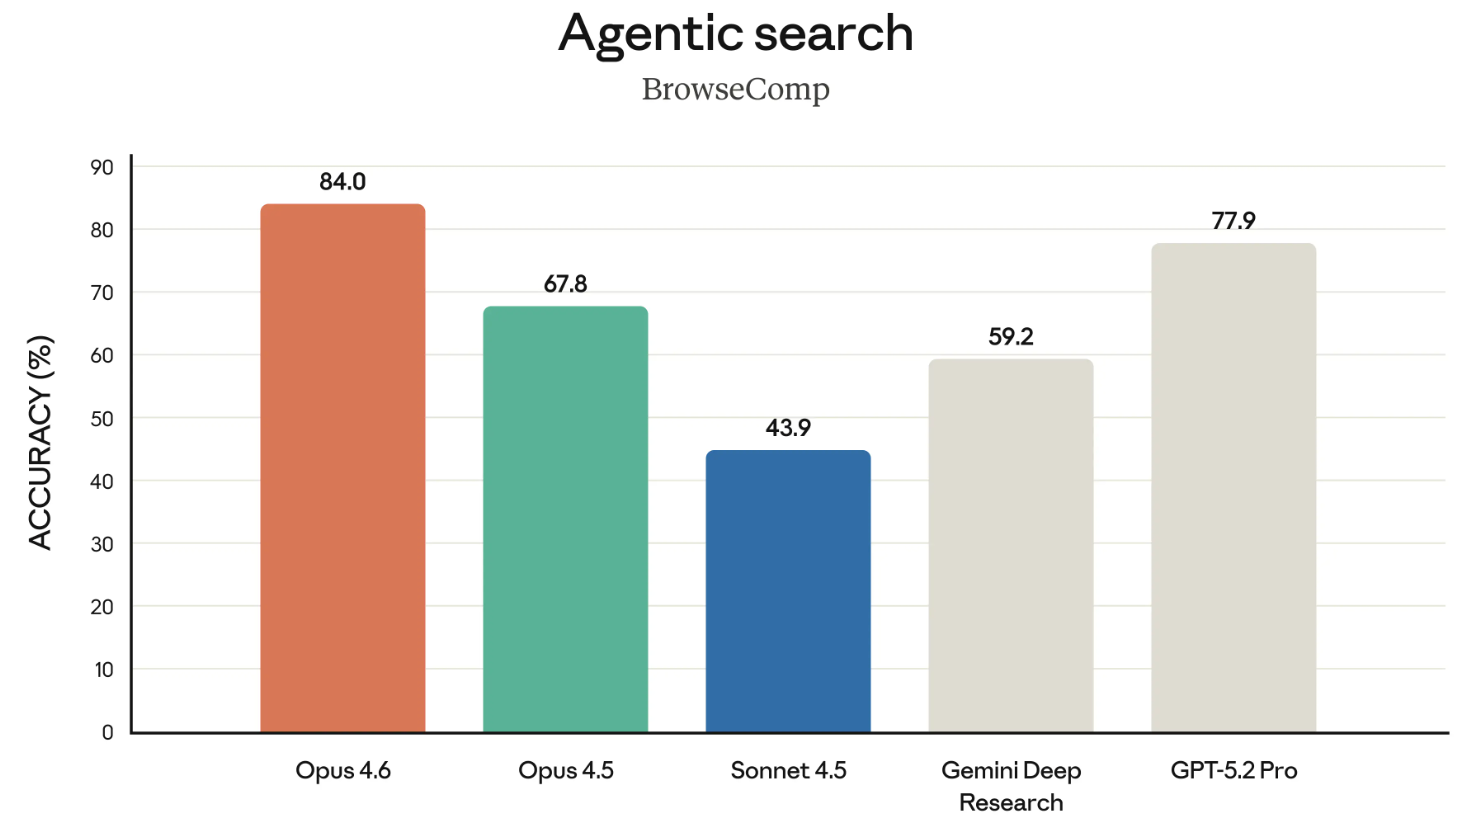
Terminal-Bench 2.0 es un benchmark de código agentivo; Humanity’s Last Exam evalúa el razonamiento complejo; GDPval-AA mide el rendimiento en trabajo de conocimiento; BrowseComp mide la capacidad del modelo para encontrar información difícil de localizar en internet.
Los modelos Claude se han ganado la fama de ser de los mejores programando. Empecemos por los resultados en el benchmark Terminal-Bench 2.0.
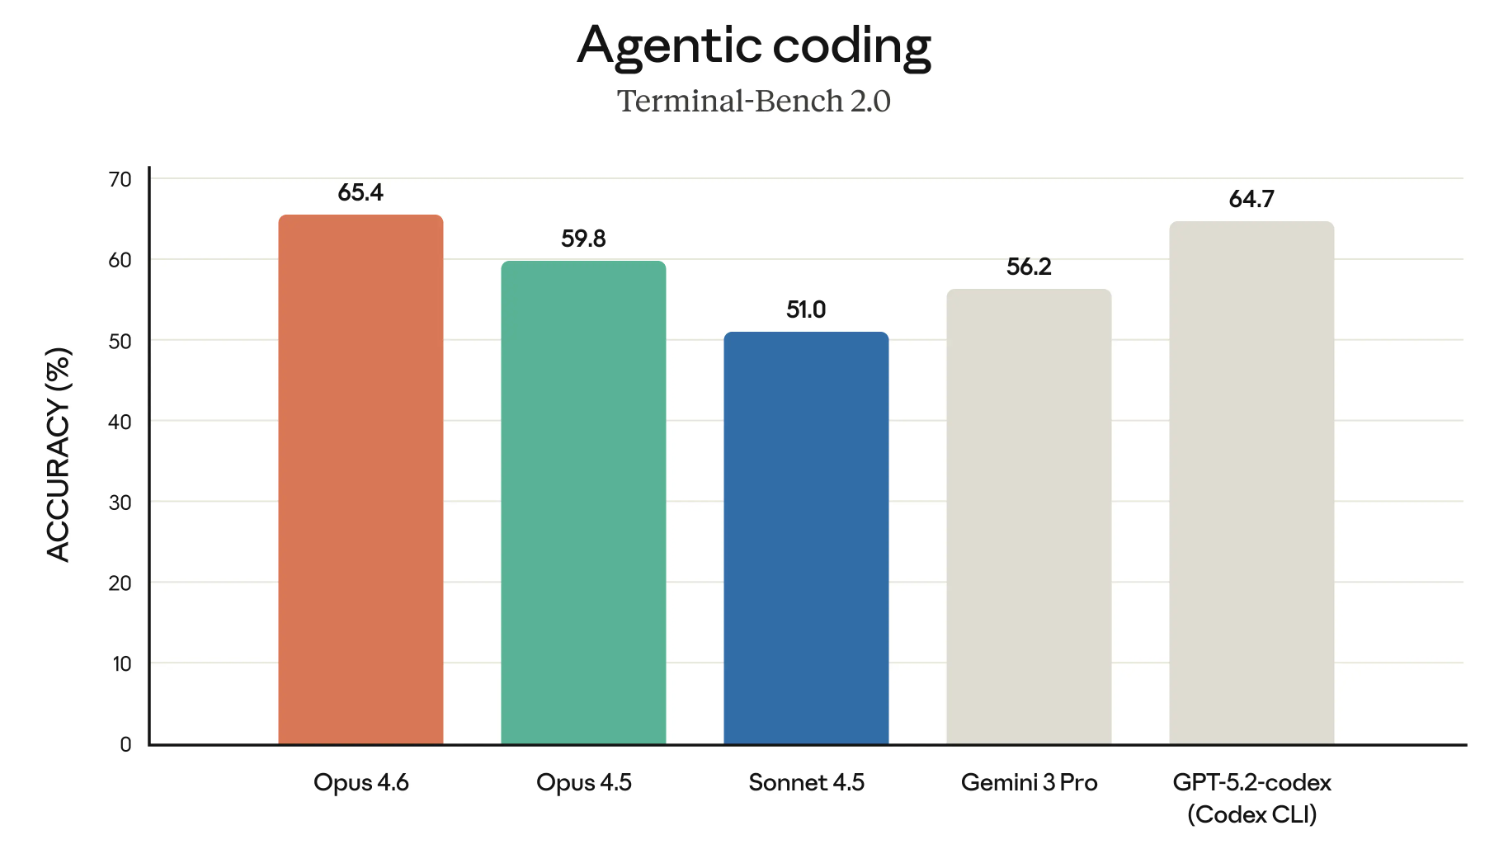
Si el gráfico de arriba parece destacar a Opus 4.6 frente a GPT-5.2-codex, es seguramente intencionado. Anthropic ha retado directamente a OpenAI en varias áreas últimamente y está reforzando su caso para uso enterprise.
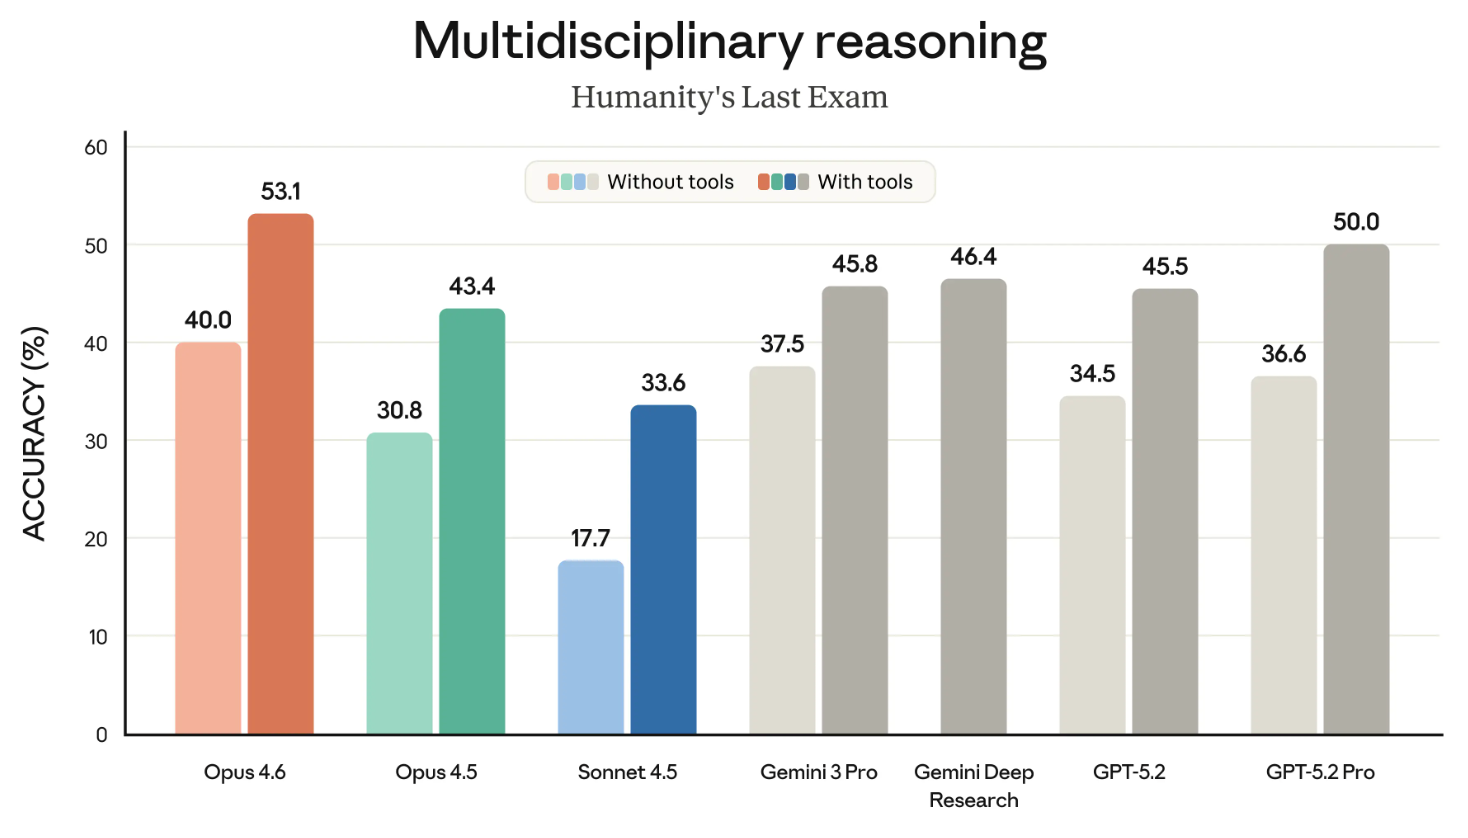
Humanity’s Last Exam es uno de los benchmarks más conocidos y que seguimos de cerca. Mide la capacidad de razonamiento general de un modelo.
El siguiente gráfico muestra el éxito de los distintos modelos de frontera en HLE, con y sin herramientas. ("Con herramientas" significa que el modelo puede usar capacidades externas como buscar en la web o ejecutar código).
Quizá este gráfico funcionaría mejor como dos gráficos. Aun así, el mensaje es claro: Opus 4.6 lidera tanto "con herramientas" como "sin herramientas".
GDPval-AA (como sugiere el nombre) evalúa lo que se considera trabajo de conocimiento con valor económico. Piensa en cosas como ejecutar modelos financieros o hacer investigación.
GDPval-AA y benchmarks similares ganan peso porque miden el tipo de trabajo por el que las empresas realmente pagan. El éxito de Opus 4.6 en GDPval-AA es también otro reto directo a la gama GPT, porque OpenAI y Anthropic compiten por muchos de los mismos clientes.
BrowseComp es el último benchmark reseñable del lanzamiento. Mide la capacidad del modelo para localizar información difícil en la web. Un poco de contexto: OpenAI desarrolló BrowseComp para mostrar las capacidades de búsqueda de sus propios modelos.
En un gesto deliberado, en este lanzamiento Anthropic enlazó directamente al anuncio de abril de 2025 de OpenAI sobre BrowseComp al destacar que Opus 4.6 encabeza ese ranking. Un movimiento algo irónico: citarles su propio benchmark.
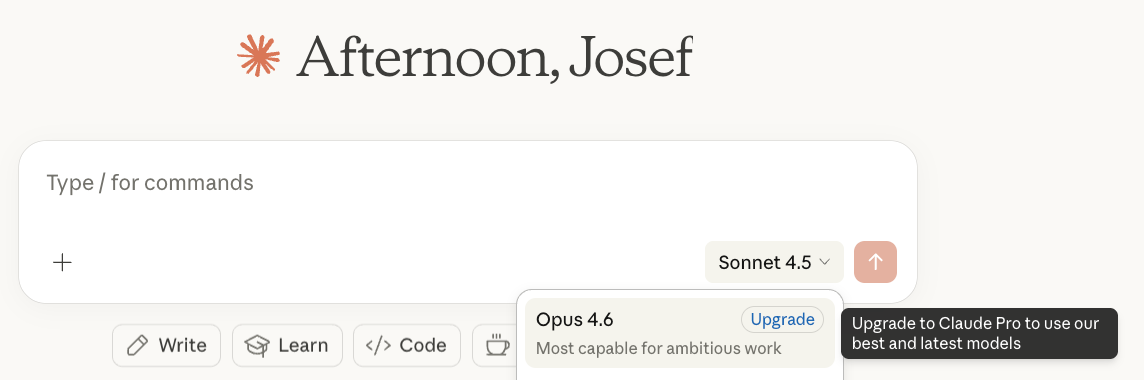
Opus 4.6 está ampliamente disponible en el momento de publicar este artículo. Eso sí, no puedes acceder a Opus 4.6 sin pasar a una cuenta pro, que además te da otras ventajas, como poder usar Claude in Excel.
Si eres desarrollador, usa claude-opus-4-6 en la API de Claude. El precio no ha cambiado: sigue siendo 5/25 $ por millón de tokens. Si te lía ver dos cifras, piensa que la primera es lo que pagas por los tokens que envías al modelo (tus prompts) y la segunda por los tokens que genera en la respuesta.
Claude Opus 4.6 encabeza rankings como GPDVal-AA, que mide cómo rinde un modelo en tareas con impacto económico, justo lo que más preocupa a los grandes clientes enterprise. OpenAI puede que se haya sentido aludida, porque horas antes del lanzamiento de Opus 4.6 anunció OpenAI Frontier, una nueva plataforma empresarial para crear, desplegar y gestionar agentes de IA en producción.
En otras palabras, más que competir en benchmarks de modelo, Frontier indica que OpenAI se centra en la infraestructura alrededor de su suite, dotando a los agentes de contexto empresarial compartido, permisos y la capacidad de recibir y aprender de feedback con el tiempo. Si pierde terreno en benchmarks, OpenAI estaría señalando que su plataforma está mejor posicionada para hacer que los agentes sean realmente útiles en una empresa.
Que eso sea un giro estratégico o una admisión tácita de que pierde la carrera de modelos, te toca decidirlo a ti.
En conjunto, nos convence lo que trae Anthropic con Claude Opus 4.6 y tenemos ganas de trastear con los equipos de agentes. Si quieres saber más sobre la familia Claude, no te pierdas el curso Introduction to Claude Models.
Learn AI with DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Ryan Ong
8 min
Tutorial
Abid Ali Awan
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Tutorial
Arunn Thevapalan
13 min