
Curso
Introdução aos modelos Claude
3 h
14.3K
Rumores sobre o próximo lançamento da Anthropic circularam nos últimos dias. Enquanto muitos esperavam o Claude Sonnet 5, o primeiro lançamento do ano veio na forma do Claude Opus 4.6.
Com uma janela de contexto de 1 milhão de tokens, raciocínio adaptativo, compactação de conversas e uma série de benchmarks líderes, o Claude Opus 4.6 é uma evolução do Opus 4.5. Como a Anthropic descreve, eles aprimoraram seu modelo mais inteligente. Junto com o modelo, a Anthropic também lançou equipes de agentes no Claude Code e o Claude no PowerPoint.
Neste artigo, vamos cobrir tudo que há de novo no Claude Opus 4.6, explorando os novos recursos, analisando os benchmarks e colocando o modelo à prova com vários exemplos práticos.
Para saber mais sobre alguns dos recursos mais recentes do Claude, recomendo conferir nossos guias de Claude Cowork e Claude Code, além do nosso tutorial do OpenClaw. Para uma comparação com outros concorrentes, leia nossos guias sobre Muse Spark vs Claude Opus 4.6 e GPT-5.4 vs Claude Opus 4.6.
O Claude Opus 4.6 é o mais recente modelo de linguagem da Anthropic. Dando sequência ao Opus 4.5, ele representa uma atualização significativa no nível de modelo mais “inteligente” da empresa.
Segundo o post de lançamento, a Anthropic afirma que há um foco maior em codificação agentiva, raciocínio profundo e autocorreção. Em outras palavras, há uma mudança de ação para ação sustentada.
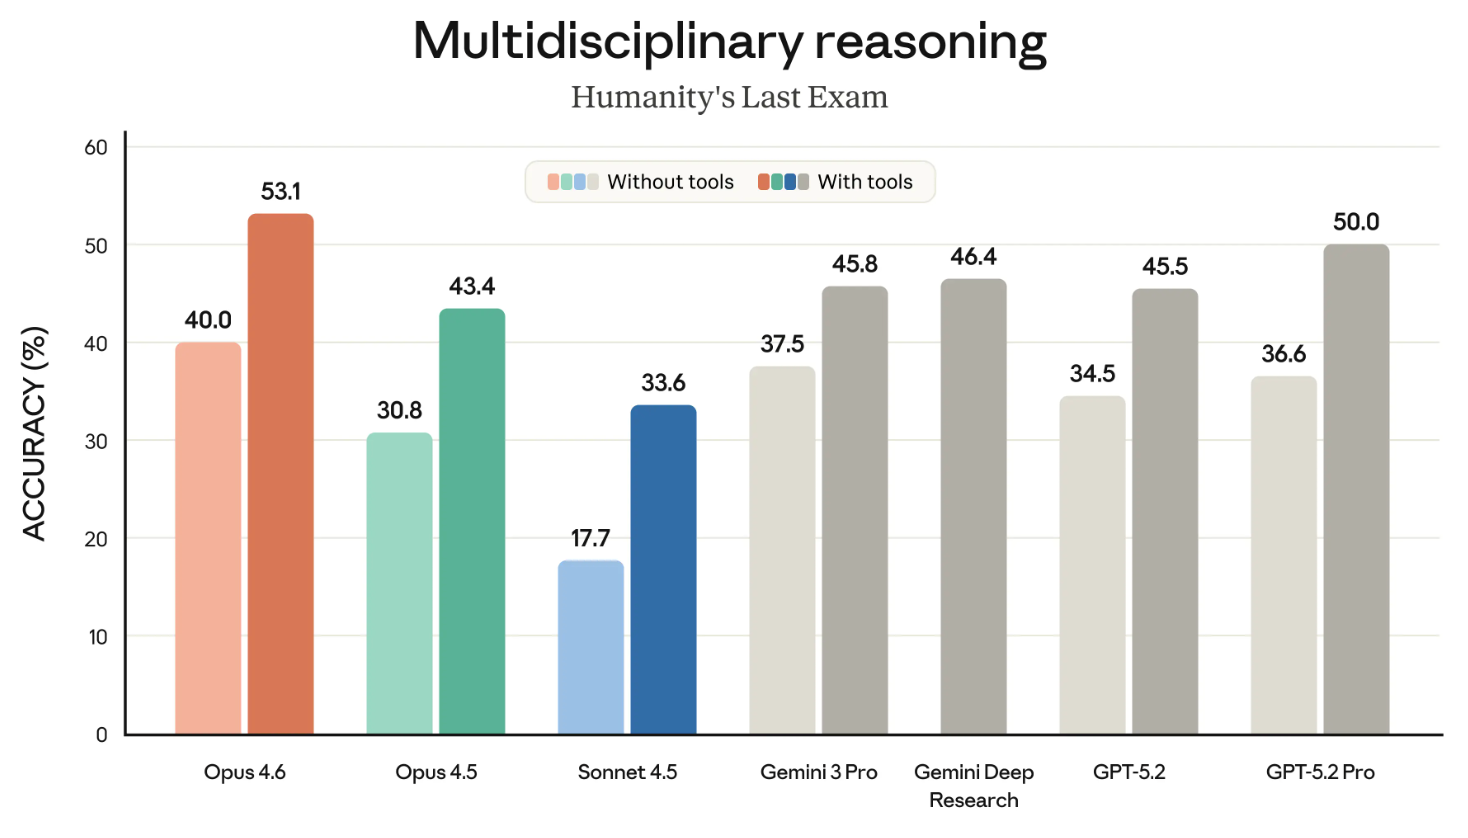
O Opus 4.6 foi projetado para planejar com mais cuidado, tem mais coerência ao longo de períodos longos e identifica erros no próprio raciocínio. Tudo isso faz com que o Claude Opus 4.6 lidere diversos benchmarks, incluindo a melhor nota na avaliação de código Terminal-Bench 2.0 e superando outros modelos de fronteira no Humanity’s Last Exam.
Um dos pontos que mais chamam atenção é a janela de contexto aprimorada do Claude Opus 4.6. Com 1 milhão de tokens no beta, o novo modelo fica no mesmo patamar do Gemini 3, permitindo processar mais informação sem perder o fio do contexto.
Enquanto isso, a Anthropic já publicou a versão sucessora do Opus. Recomendo ler nosso guia do Claude Opus 4.7 para ficar por dentro.
Há vários recursos novos importantes no Claude Opus 4.6, muitos deles focados em fluxos de trabalho com agentes. Vamos aos principais:
As equipes de agentes são uma evolução em relação aos “subagentes” que vimos em versões anteriores do Claude. Elas permitem criar várias instâncias totalmente independentes do Claude que trabalham em paralelo. Uma sessão é o agente “líder” que coordena tudo, enquanto os “colegas” cuidam da execução.
O mais interessante é que cada membro da equipe tem sua própria janela de contexto, possibilitando uma execução mais completa. Cada colega também pode se comunicar diretamente com os demais da equipe.
Claro que isso tem um potencial efeito colateral: o custo. Como cada agente tem sua própria janela de contexto, você pode consumir tokens rapidamente. Por isso, a Anthropic recomenda usar esse recurso em cenários com maior complexidade.
Um recurso bacana do Claude Opus 4.6 é a compactação de contexto. Esse aprimoramento de usabilidade ajuda a evitar problemas quando você roda fluxos longos que estouram a janela de contexto. Normalmente, você bateria no “teto” de contexto e o desempenho começaria a cair.
Com a compactação de conversas, o Claude Opus 4.6 detecta automaticamente quando a conversa está chegando ao limite de tokens e resume o histórico em um bloco conciso (um bloco de compactação).
Esse recurso ajuda a preservar o essencial das interações e, ao mesmo tempo, liberar espaço para você continuar trabalhando. Se você pretende usar agentes orientados a tarefas que precisam rodar por muito tempo, isso pode mantê-los no trilho com uma memória bem melhor.
Duas funcionalidades do Claude Opus 4.6 determinam se é necessário usar raciocínio estendido e com qual intensidade.
O raciocínio adaptativo permite ao modelo avaliar a complexidade do seu prompt. Com base nisso, ele decide se vai usar raciocínio estendido. Em vez de ter uma configuração manual de quantos tokens usar, o Claude ajusta seu “orçamento” conforme a complexidade de cada solicitação.
O parâmetro de esforço permite definir quão disposto ou conservador o Claude será ao gastar tokens. Essencialmente, você equilibra eficiência de tokens e nível de profundidade das respostas.
Ao usar o Claude Opus 4.6 pela API, você pode ajustar esses parâmetros manualmente. Por exemplo:
Recentemente, cobrimos o Claude no Excel, mostrando como o complemento pode ajudar em várias tarefas em um painel lateral da sua planilha. Além de melhorar a funcionalidade dessa ferramenta, a Anthropic anunciou o Claude no PowerPoint.
Essa integração respeita seus mestres de slide, fontes e layouts. Você pode fornecer um template corporativo e pedir para construir uma seção específica, ou selecionar um slide e pedir para converter um texto denso em um diagrama nativo e editável.
O foco em gerar objetos editáveis do PowerPoint, e não apenas “imagens de slides”, torna essa integração uma ferramenta real de produtividade, não só um gerador de ideias.
O Claude no PowerPoint está atualmente em preview de pesquisa para usuários Max e Enterprise.
Muitas das promessas do Opus 4.6 giram em torno de tarefas de código mais difíceis e raciocínio mais profundo. Essas habilidades dependem de uma base: manter múltiplas restrições em mente, raciocinar em várias etapas e capturar erros.
Com isso em mente, colocamos o Opus 4.6 em uma série de desafios de lógica, matemática e programação de múltiplas etapas. Queríamos ver se conseguiríamos expor algumas fraquezas conhecidas e comuns dos LLMs — como erros de cálculo em cascata, raciocínio espacial (sempre complicado) e questões com restrições. Também incluímos uma tarefa específica de debugging porque o anúncio da Anthropic destacou a capacidade do Opus 4.6 em análise de causa raiz e outros problemas de depuração.
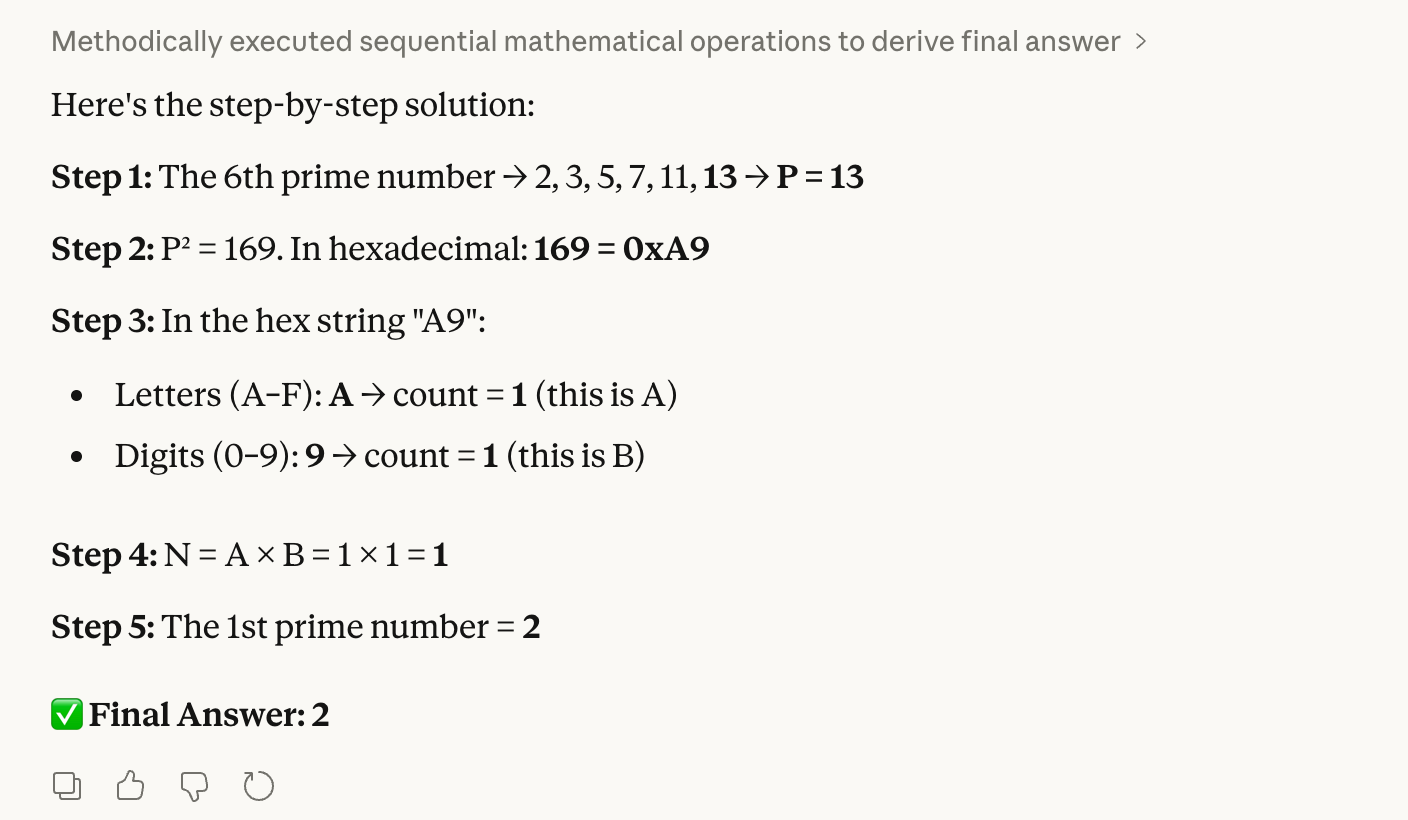
Nosso primeiro teste combina números primos, hexadecimais e contagem:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
Parece complexo, mas é fácil de verificar. A resposta correta é 2, porque o 6º primo é 13; 13 ao quadrado é 169, que em hexa é "A9". Isso tem 1 letra × 1 dígito, o que dá 1; o 1º primo é 2.
A preocupação é o modelo se atrapalhar na conversão para hexa, causando erro em cascata no resultado final. Como você vê, o Opus 4.6 não teve dificuldade:
O segundo teste avalia raciocínio espacial e tratamento de números negativos:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
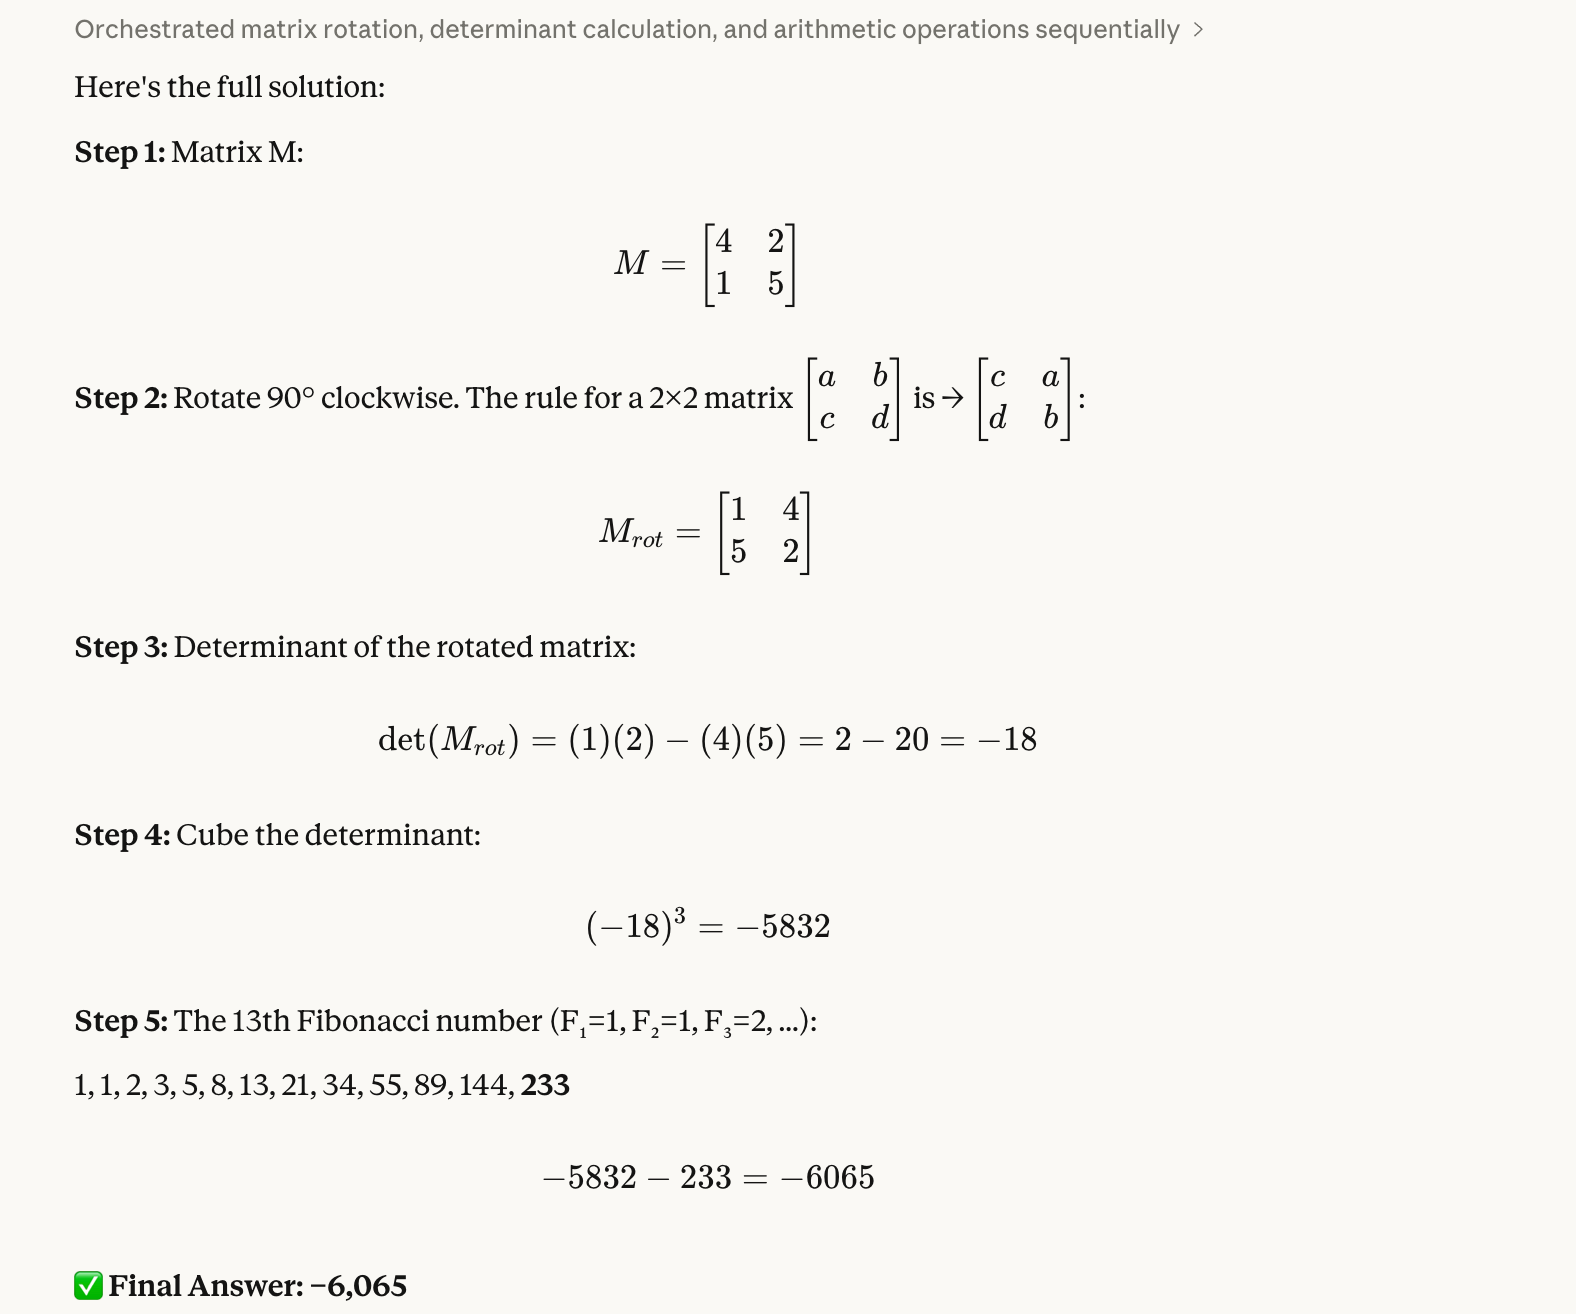
Esse deu mais trabalho para validar. A resposta correta é -6.065. Sabemos disso porque a matriz rotacionada é [[1, 4], [5, 2]]; usando Python, o determinante é -18; elevando ao cubo, obtemos -5.832; por fim, subtraímos 233 e chegamos a -6.065.
Escolhemos esse teste porque modelos costumam trocar elementos da matriz de forma errada ou perdem o sinal negativo no caminho. Mais uma vez, o Opus 4.6 se saiu bem:
No terceiro teste, usamos um problema de satisfação de restrições que exige backtracking:
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
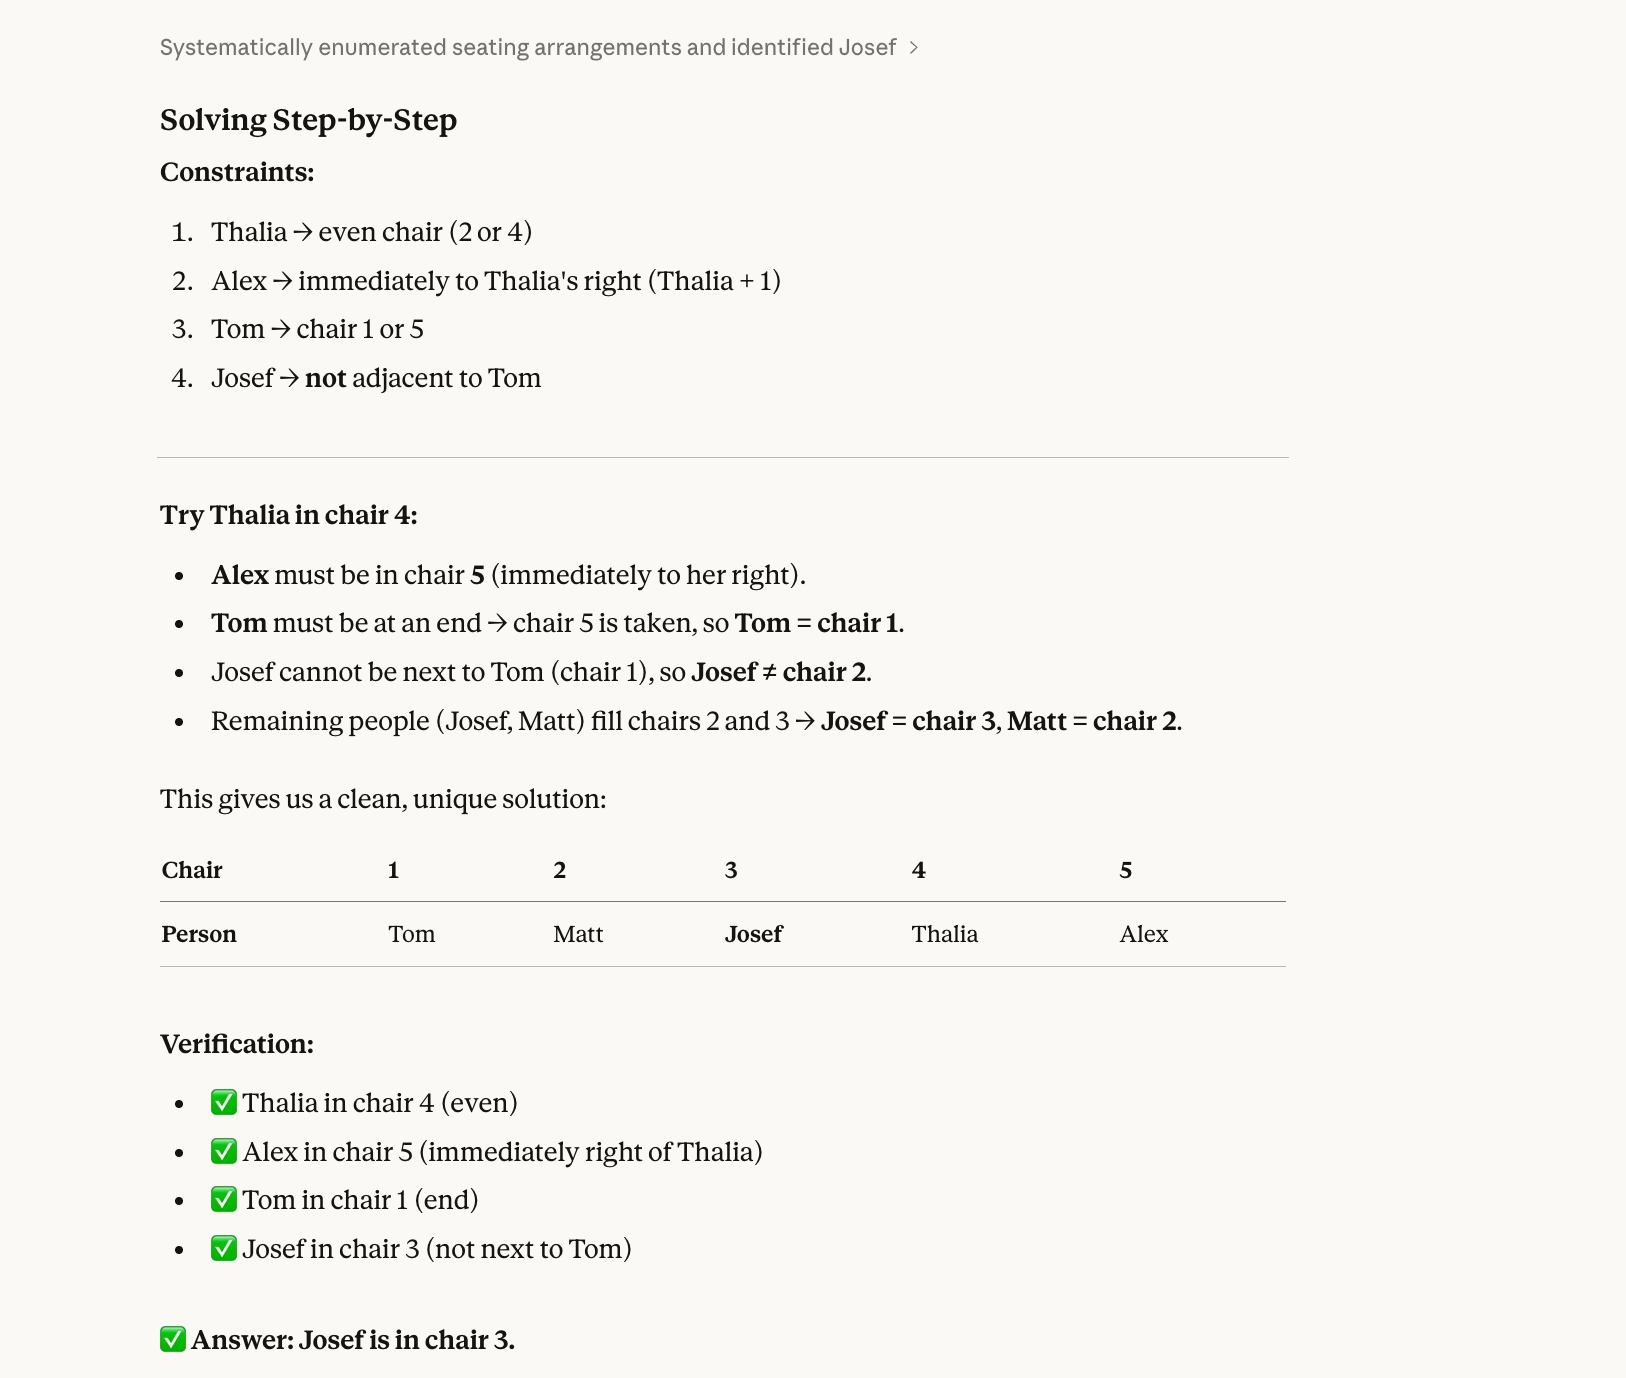
A resposta correta é Josef. (Alex-1, Matt-2, Josef-3, Thalia-4, Tom-5.) Dá para resolver no papel com um pouco de paciência.
Modelos costumam errar esse tipo de questão porque resolvem sequencialmente, não de forma holística. Leem “Thalia está em uma cadeira par” e escolhem uma (digamos, cadeira 2) sem checar se isso bate com todas as outras restrições. Aí se comprometem com a escolha, preenchem o resto e acabam num conflito sem voltar e testar a Thalia na cadeira 4.
O Opus 4.6 também acertou aqui:
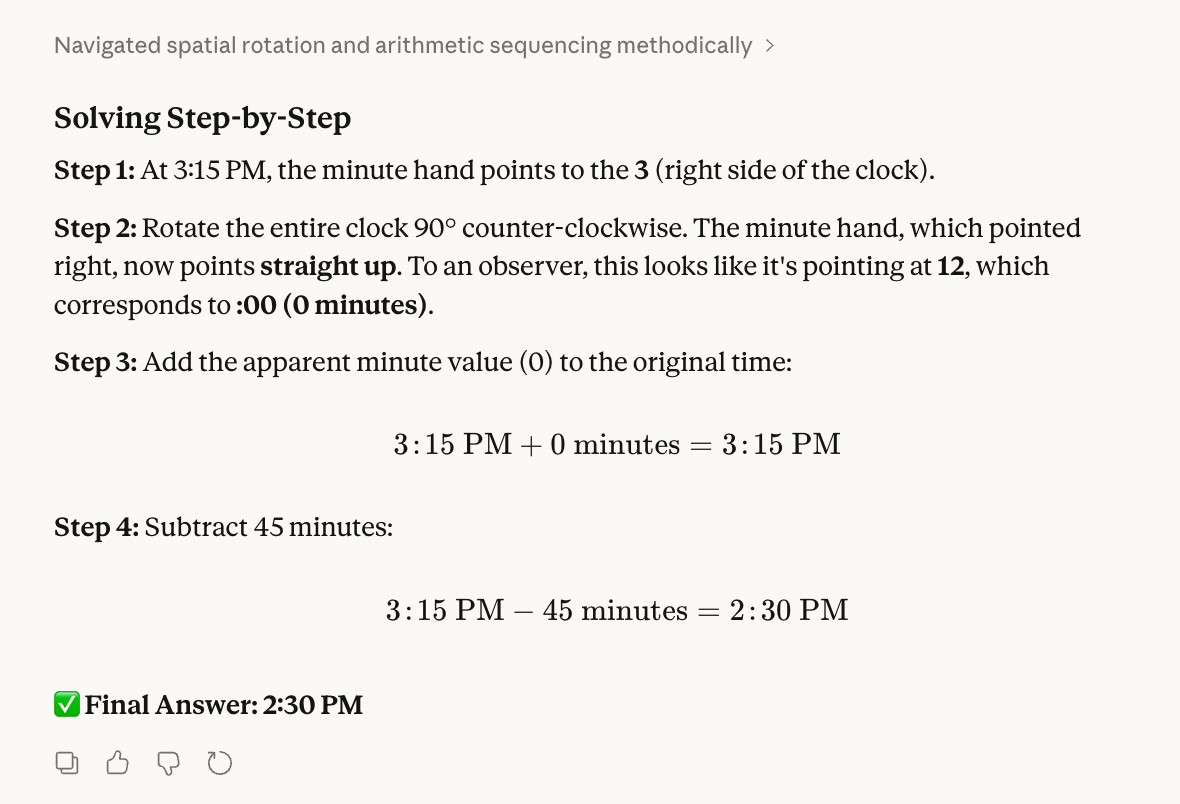
O quarto teste avalia visualização espacial e intuição física:
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
Para validar, eu literalmente girei o relógio do meu pulso.
A resposta correta é 14h30. Às 3:15, o ponteiro dos minutos aponta para o “3”. Quando girei o 12 para a janela à esquerda, o “3” foi para onde estava o “12”. Somei 0 a 3:15, subtraí 45 minutos e cheguei a 14h30.
Ao criar o teste, esperávamos que os modelos confundissem girar o mostrador com mover o ponteiro. Também ouvimos que modelos tendem a desconfiar de somar 0 e tentam forçar outro número.
Mesmo assim, o Opus 4.6 resolveu; acertou a resposta:
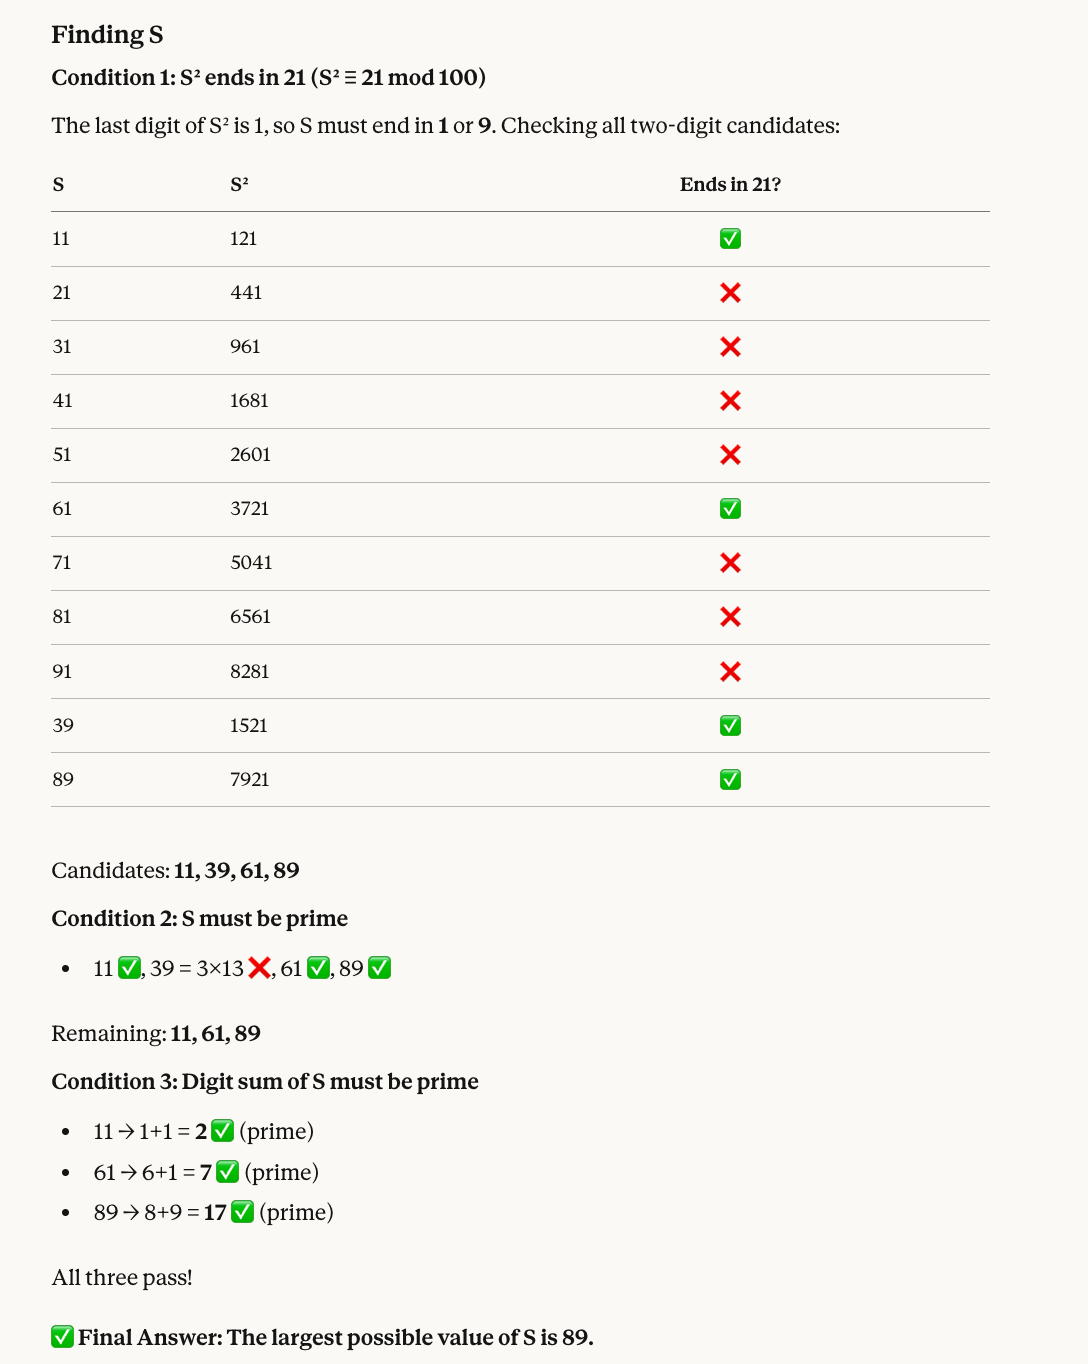
O quinto teste combina aritmética modular com filtragem de primos:
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
Por que o número correto é 89: Números cujo quadrado termina em 21 incluem 11, 39, 61 e 89. Desses, 39 não é primo, então sobram 11, 61 e 89. A soma dos dígitos dos três é prima (2, 7 e 17, respectivamente), então o maior é 89.
O Opus 4.6 acertou de novo e ainda incluiu um visual útil:
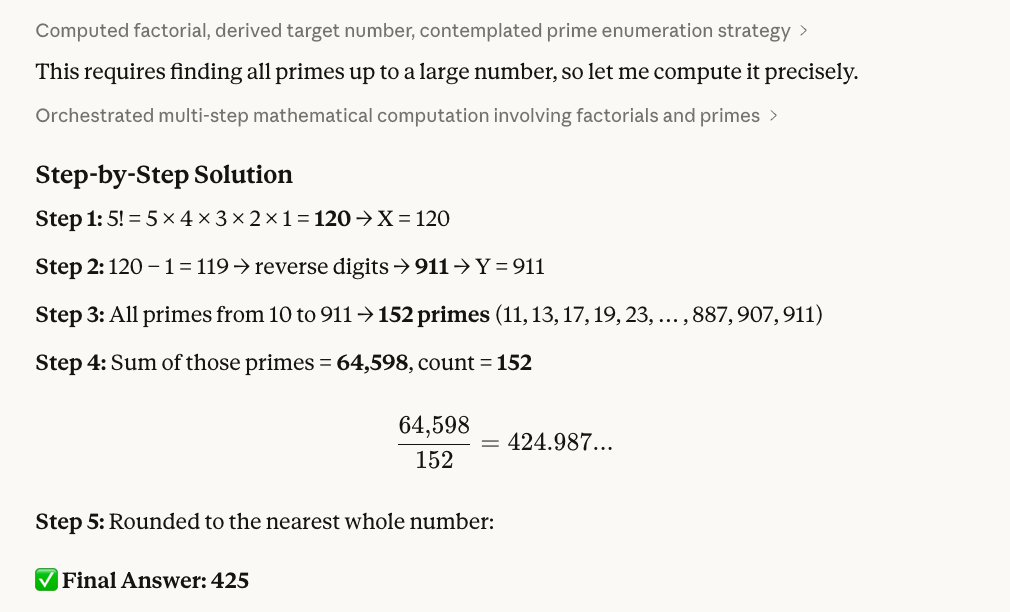
O próximo teste encadeia fatorial, manipulação de string e primos:
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
Como validamos 425 como resposta correta: 5! = 120; subtraindo 1, temos 119; invertendo os dígitos, 911. Usando R (abaixo), vimos que há 152 primos entre 10 e 911 e a soma é 64.598. Por fim, dividimos e arredondamos: 64.598 ÷ 152 ≈ 425.
Aqui está o script em R que usamos:
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
cat("Step 5: Rounded =", round(avg), "\n")O próximo teste mira uma das grandes promessas do Opus 4.6: diagnosticar bugs em código. Sabemos que modelos muitas vezes traçam o código linha a linha corretamente, mas não conectam o traço ao defeito real.
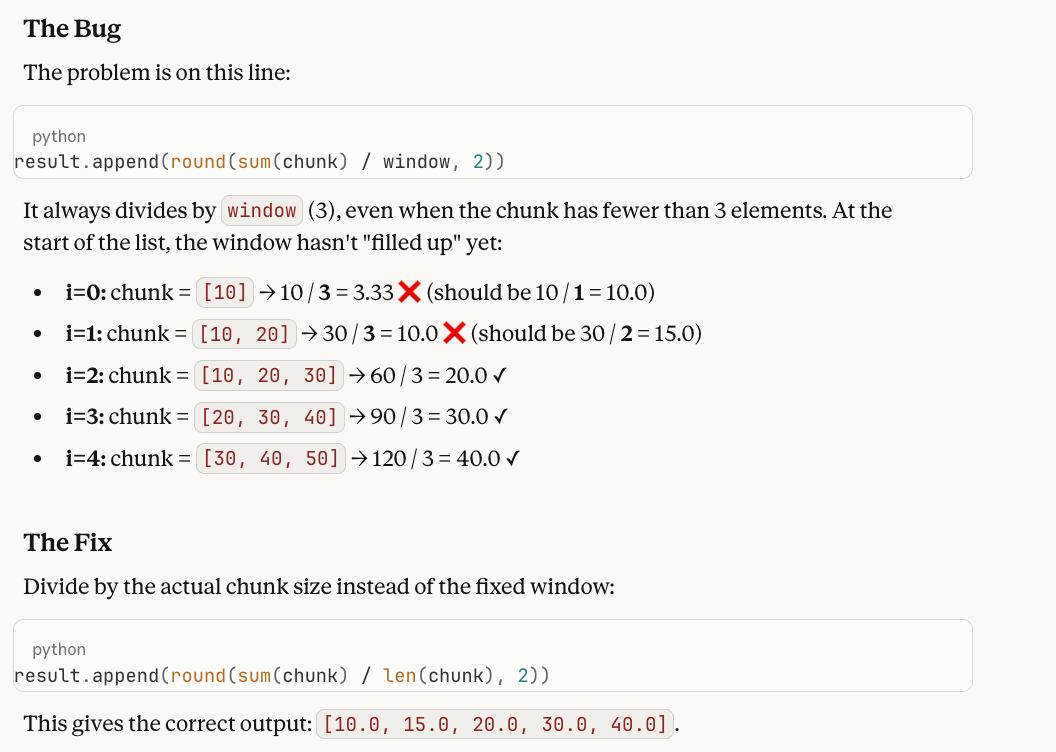
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
Aqui está a resposta e por que o teste funciona: a função sempre divide por window (3), mesmo quando o chunk tem menos de 3 elementos no início da lista. A saída com bug é [3.33, 10.0, 20.0, 30.0, 40.0], mas os dois primeiros valores deveriam ser 10.0 e 15.0, já que esses chunks têm apenas 1 e 2 elementos, respectivamente. O conserto é trocar / window por / len(chunk).
Gostamos desse teste porque modelos muitas vezes percorrem o loop perfeitamente, mas dizem “a saída parece correta” — eles veem a matemática passo a passo e não sinalizam que dividir um único elemento por 3 está errado. É preciso manter a intenção (o que uma média móvel deve fazer) junto com a execução (o que o código de fato faz) e notar o descompasso.
Nosso último teste não tem matemática, só raciocínio contrafactual.
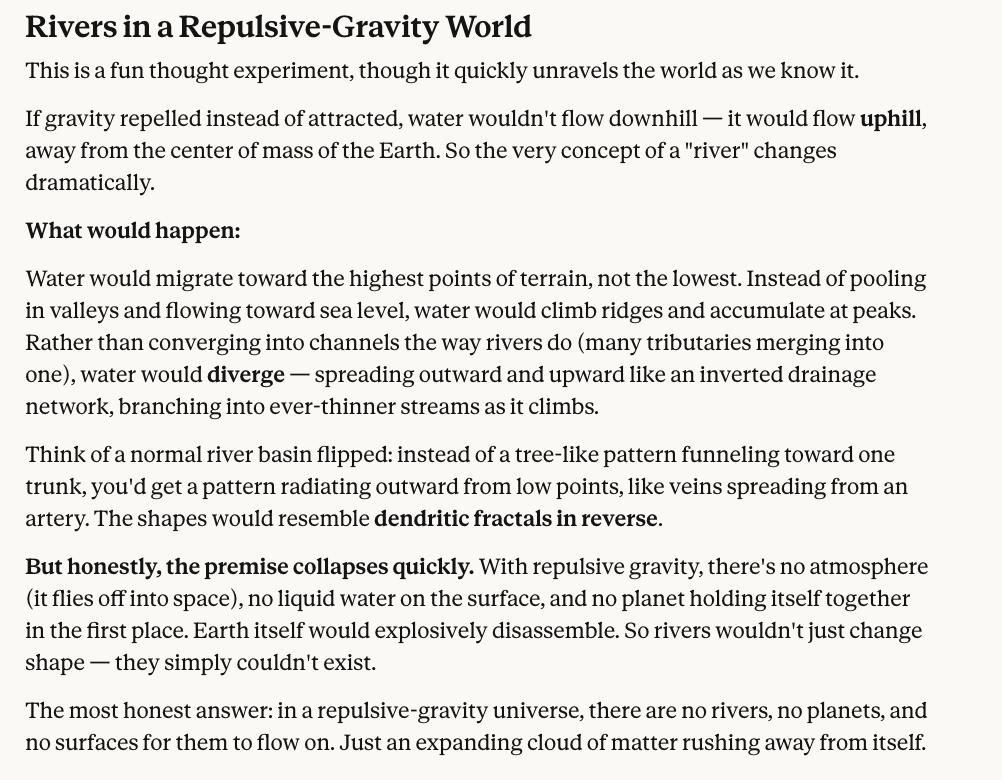
In a world where gravity repels objects instead of attracting them, what shape would rivers take?Claro, não existe uma única resposta correta, e é difícil de imaginar. Mas queremos que o modelo pelo menos raciocine sobre as implicações — e achamos que a resposta do Claude Opus 4.6 é bem razoável.
Resumindo, o Opus 4.6 fez pontuação perfeita, embora, como você viu, incluímos uma questão com resposta mais subjetiva — então o veredito final é seu.
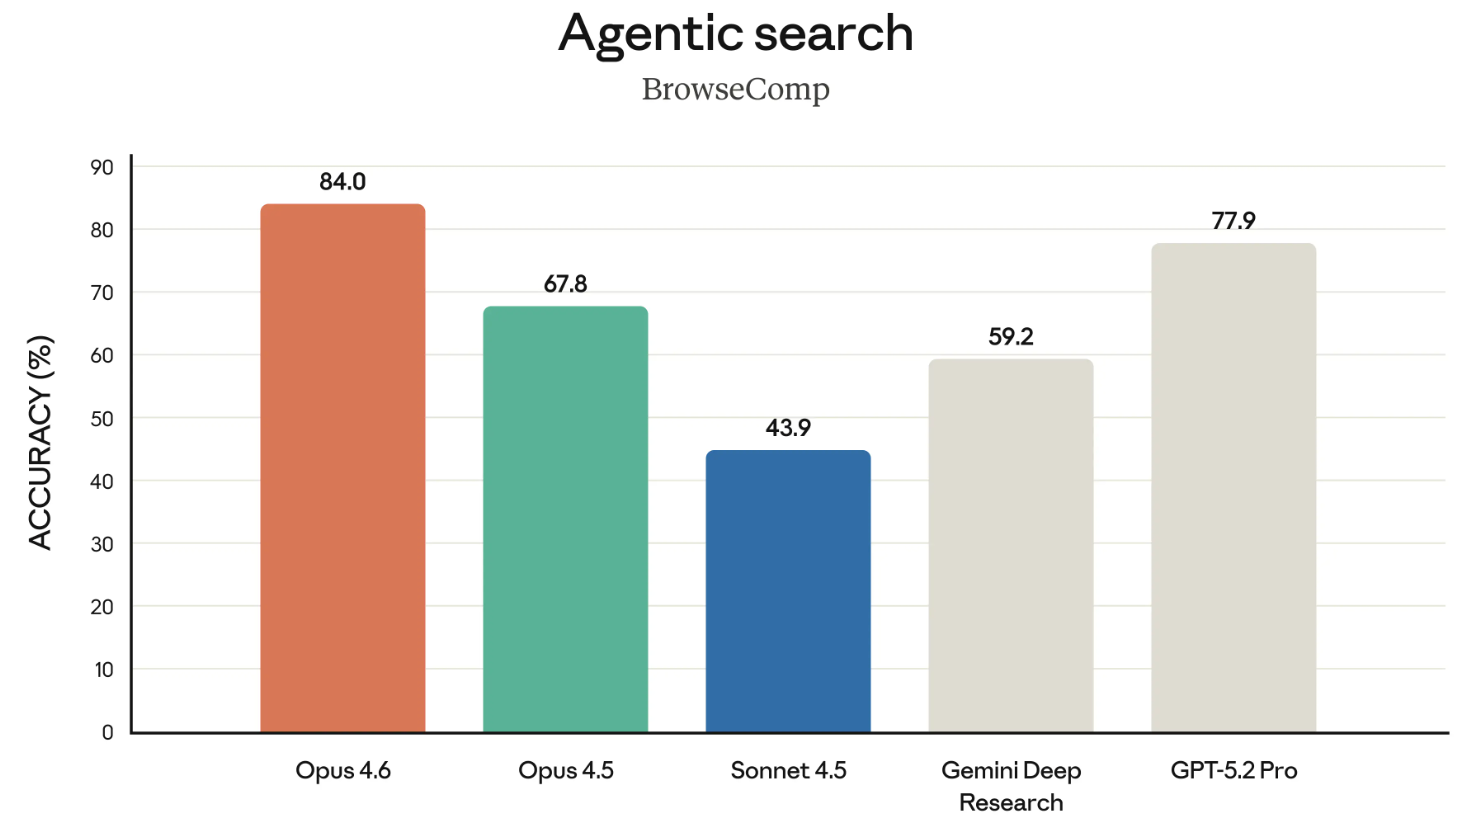
O Opus 4.6 lidera, sem contestação, pelo menos quatro benchmarks importantes:
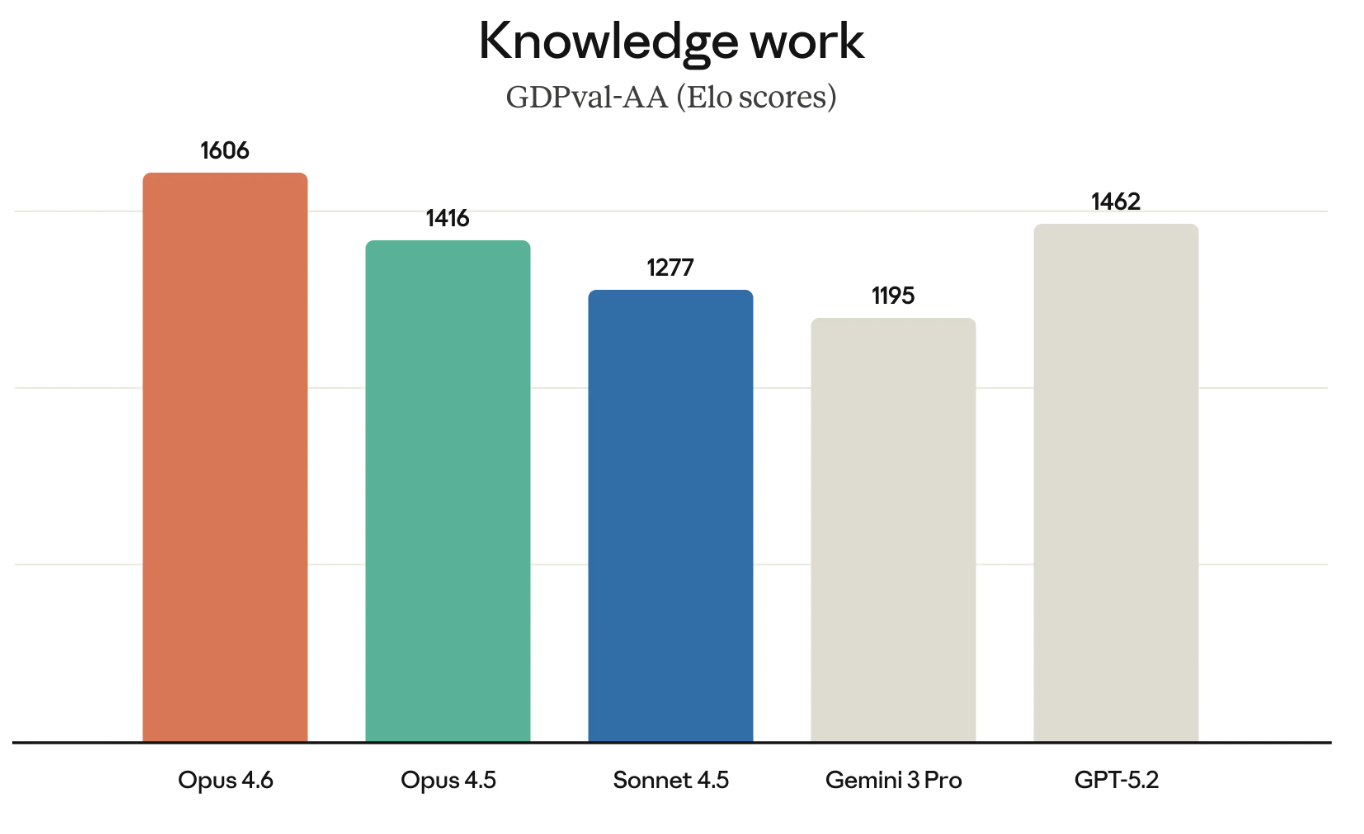
O Terminal-Bench 2.0 avalia codificação agentiva; o Humanity’s Last Exam mede raciocínio complexo; o GDPval-AA testa desempenho em trabalho do conhecimento; o BrowseComp mede a capacidade do modelo de encontrar informações difíceis na web.
Os modelos Claude têm reputação merecida como excelentes programadores. Então começamos pelos resultados do benchmark Terminal-Bench 2.0.
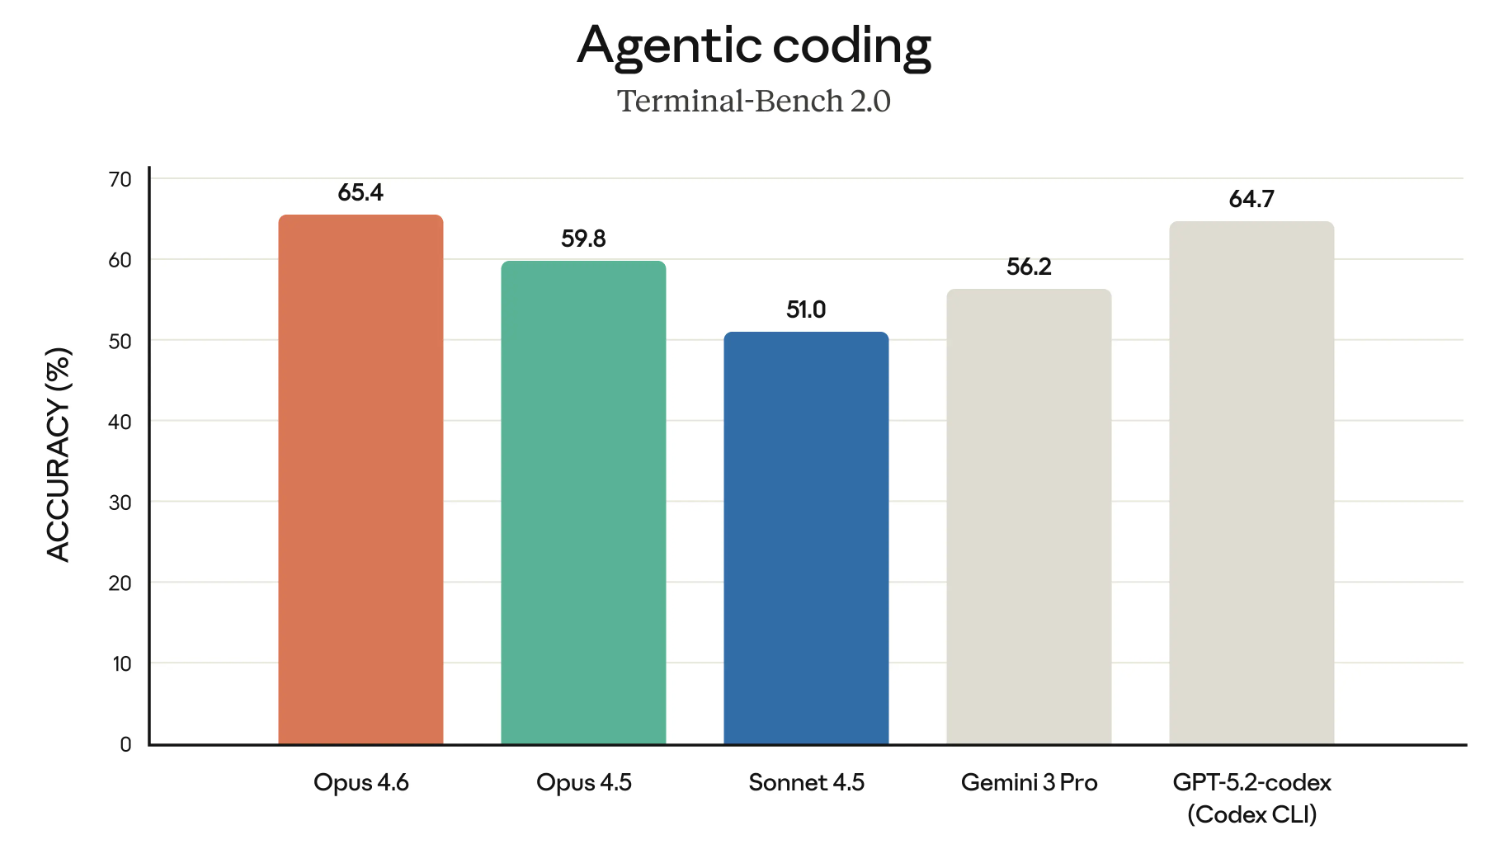
Se o gráfico acima parece destacar o Opus 4.6 em relação ao GPT-5.2-codex — bom, certamente é intencional. A Anthropic vem desafiando diretamente a OpenAI em várias frentes e está construindo um caso forte para o uso corporativo.
O Humanity’s Last Exam é um dos benchmarks mais conhecidos — e que todos acompanhamos de perto. Ele mede a capacidade geral de raciocínio do modelo.
O gráfico a seguir mostra o desempenho dos modelos de fronteira no HLE com e sem ferramentas. (“Com ferramentas” significa que o modelo pôde usar capacidades externas, como busca na web e execução de código.)
Talvez esse gráfico ficasse melhor dividido em dois. Mas o recado é claro: o Opus 4.6 lidera tanto “com ferramentas” quanto “sem ferramentas”.
O GDPval-AA (como o nome sugere) é um teste do chamado trabalho do conhecimento com valor econômico. Pense em rodar modelos financeiros ou conduzir pesquisas.
O GDPval-AA e benchmarks semelhantes são cada vez mais importantes porque medem exatamente o tipo de trabalho pelo qual as empresas pagam. O sucesso do Opus 4.6 no GDPval-AA é também um desafio direto ao conjunto de modelos GPT, já que OpenAI e Anthropic disputam muitos dos mesmos clientes.
O BrowseComp é o último benchmark digno de nota neste lançamento. Ele mede a capacidade do modelo de rastrear informações difíceis de achar online. Um pouco de história: a OpenAI desenvolveu o BrowseComp para demonstrar as capacidades de busca de seus próprios modelos.
Num movimento direto, neste lançamento a Anthropic linkou ao anúncio da OpenAI de abril de 2025 sobre o BrowseComp ao destacar que o Opus 4.6 lidera esse ranking. Um toque provocativo, citando o benchmark da própria OpenAI contra ela.
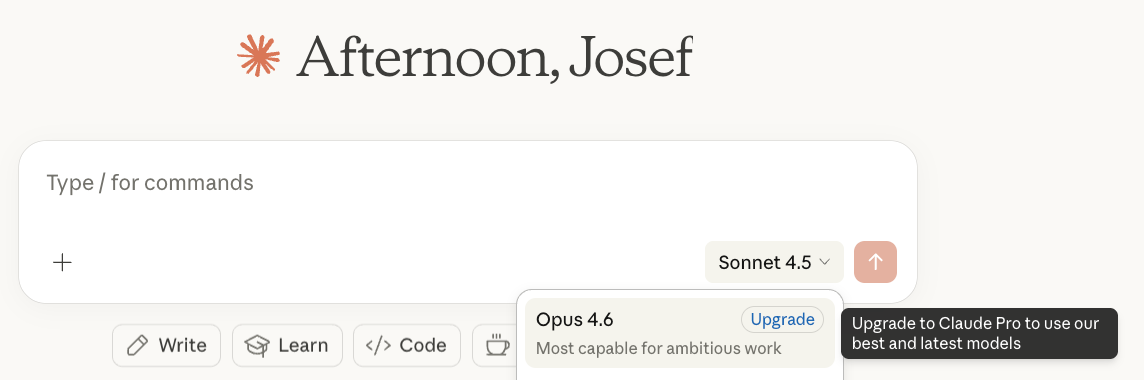
O Opus 4.6 está amplamente disponível na data deste artigo. Porém, você não consegue acessá-lo sem fazer upgrade para uma conta Pro, que traz outros benefícios, como usar o Claude no Excel.
Se você é desenvolvedor, use o claude-opus-4-6 na API do Claude. O preço não mudou: continua US$ 5/US$ 25 por milhão de tokens. Se ficou confuso com os dois números, saiba que o primeiro é o que você paga para enviar tokens ao modelo (seus prompts) e o segundo é o que você paga pelos tokens que ele gera de volta (as respostas).
O Claude Opus 4.6 lidera em benchmarks importantes como o GPDVal-AA, que mede quão bem um modelo executa tarefas economicamente relevantes — exatamente o que importa para grandes empresas. A OpenAI pode ter sentido o impacto, já que horas antes do lançamento do Opus 4.6, anunciou o OpenAI Frontier, uma nova plataforma enterprise para construir, implantar e gerenciar agentes de IA em produção.
Ou seja, em vez de competir em benchmarks de modelos, o Frontier mostra que a OpenAI está focada na infraestrutura ao redor de sua suíte — dando aos agentes de IA contexto de negócio compartilhado, permissões e capacidade de receber e aprender com feedback ao longo do tempo. Perdendo terreno nos benchmarks, a OpenAI sinaliza que sua plataforma está melhor posicionada para tornar agentes realmente úteis dentro das empresas.
Se isso é uma mudança estratégica ou um reconhecimento tácito de que está perdendo a corrida de modelos, fica a seu critério.
No geral, ficamos impressionados com o que a Anthropic está entregando com o Claude Opus 4.6 e estamos animados para colocar as equipes de agentes para trabalhar. Se você quer conhecer melhor a família Claude, confira o curso Introduction to Claude Models.
Aprenda IA com a DataCamp
Curso
Curso
Curso
blog
Khalid Abdelaty
15 min
blog
Richie Cotton
7 min
blog
Abid Ali Awan
9 min
blog
Abid Ali Awan
8 min
Tutorial
Abid Ali Awan
Tutorial
Zoumana Keita
14 min





