
Kurs
Einführung in die Claude-Modelle
3 Std.
14.5K
In den letzten Tagen kursierten Gerüchte über Anthropics nächsten Release. Viele rechneten mit Claude Sonnet 5, doch das erste Update des Jahres heiße nun Claude Opus 4.6.
Mit einem Kontextfenster von 1 Million Tokens, adaptivem Denken, Gesprächskomprimierung und einer Reihe von Spitzenwerten in Benchmarks ist Claude Opus 4.6 ein klares Upgrade gegenüber Opus 4.5. Anthropic nennt es die Aufrüstung seines smartesten Modells. Parallel dazu hat Anthropic Agententeams in Claude Code und Claude in PowerPoint vorgestellt.
In diesem Artikel zeigen wir alles Neue in Claude Opus 4.6, gehen die Features durch, beleuchten Benchmarks und testen das Modell mit mehreren praktischen Beispielen.
Wenn du mehr über die neuesten Claude-Features erfahren willst, schau dir unsere Guides zu Claude Cowork und Claude Code an sowie unser OpenClaw-Tutorial. Für Vergleiche mit anderen Modellen lies unsere Guides zu Muse Spark vs Claude Opus 4.6 und GPT-5.4 vs Claude Opus 4.6.
Claude Opus 4.6 ist das neueste Large Language Model von Anthropic. Aufbauend auf Opus 4.5 markiert es ein deutliches Upgrade der „smartesten“ Modellstufe des Unternehmens.
Laut Release-Blog liegt der Schwerpunkt stärker auf agentischem Coding, tiefem Reasoning und Selbstkorrektur. Heißt: weniger einmalige Aktion, mehr nachhaltige Ausführung.
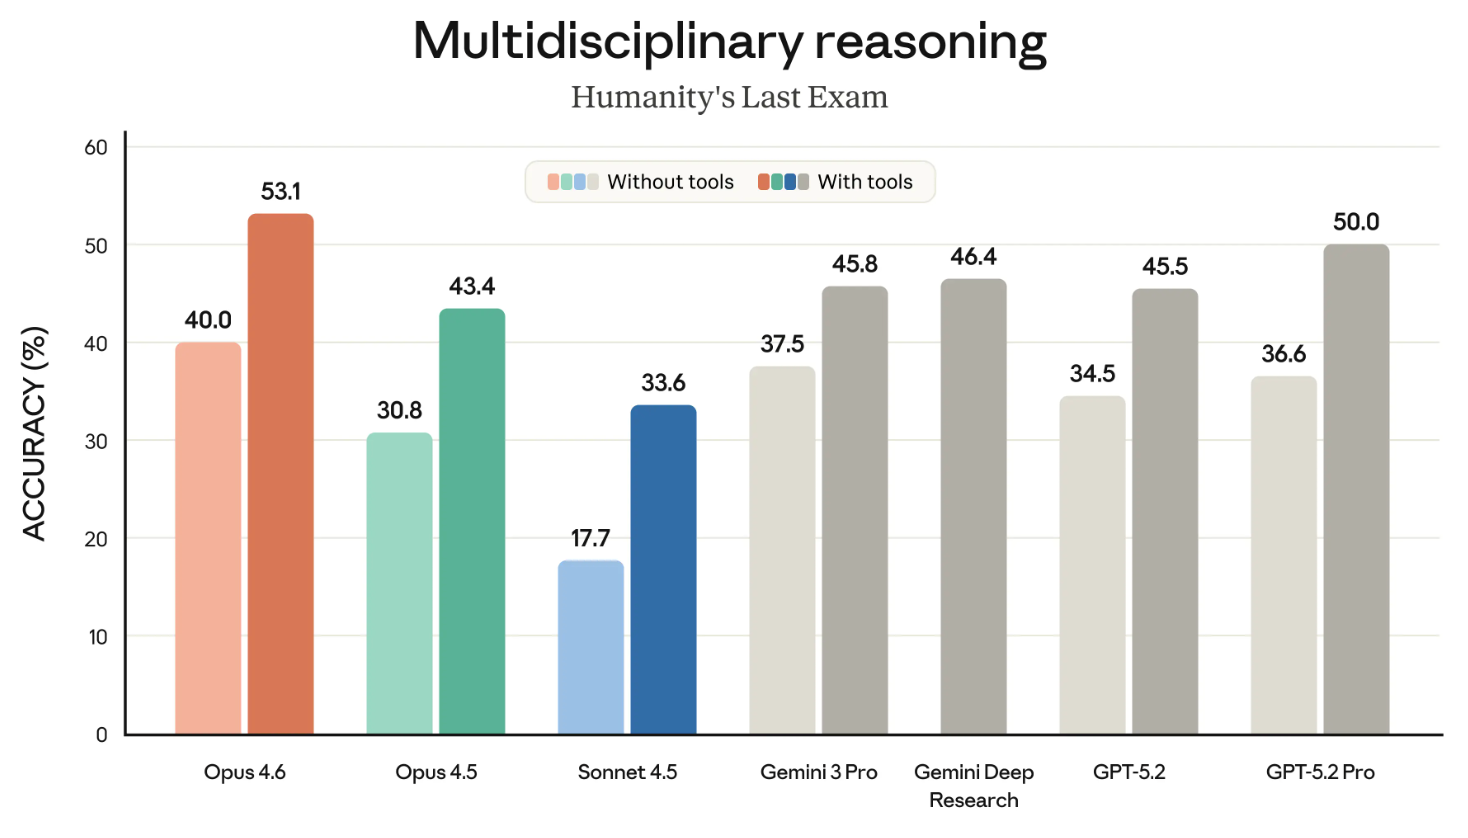
Opus 4.6 plant sorgfältiger, bleibt über längere Kontexte hinweg kohärent und erkennt eigene Fehler. Dadurch führt Claude Opus 4.6 mehrere Benchmarks an, inklusive der Top-Wertung im Terminal-Bench-2.0-Coding-Test, und schlägt alle anderen Frontier-Modelle bei Humanity’s Last Exam.
Besonders ins Auge fällt das verbesserte Kontextfenster von Claude Opus 4.6. Mit 1 Million Tokens in der Beta zieht das neue Modell mit Gemini 3 gleich und kann mehr Informationen verarbeiten, ohne den roten Faden zu verlieren.
Inzwischen hat Anthropic die Nachfolgeversion von Opus veröffentlicht. Lies unseren Guide zu Claude Opus 4.7, um auf dem Laufenden zu bleiben.
Claude Opus 4.6 bringt mehrere bemerkenswerte Neuerungen, von denen viele auf agentische Workflows zielen. Hier die wichtigsten Punkte:
Agententeams sind ein Upgrade der „Subagenten“ aus früheren Claude-Versionen. Damit kannst du mehrere, vollständig unabhängige Claude-Instanzen parallel starten. Eine Session ist der „Lead“-Agent, der koordiniert, während „Teamkollegen“ die Ausführung übernehmen.
Spannend: Jedes Teammitglied hat sein eigenes Kontextfenster, was eine gründlichere Ausführung erlaubt. Teamkollegen können außerdem direkt miteinander kommunizieren.
Natürlich hat das auch eine Kehrseite – die Kosten. Da jeder Agent ein eigenes Kontextfenster hat, können Tokens schnell verbraucht sein. Anthropic empfiehlt den Einsatz daher bei höherer Komplexität.
Ein praktisches Feature von Claude Opus 4.6 ist die Kontextkomprimierung. Dieses Quality-of-Life-Update beugt Problemen bei langen Workflows vor, die das Kontextfenster ausreizen und zu Leistungseinbußen führen.
Mit der Gesprächskomprimierung erkennt Claude Opus 4.6 automatisch, wenn eine Unterhaltung einen Tokengrenzwert erreicht, und fasst sie in einem kompakten Block zusammen (Compaction-Block).
So bleiben die Essentials deiner Interaktion erhalten, während du zugleich Platz schaffst, um weiterzuarbeiten. Wenn du aufgabenorientierte Agenten planst, die lange laufen, hilft das, sie mit deutlich besserem Gedächtnis auf Kurs zu halten.
Zwei Funktionen steuern, ob Claude Opus 4.6 Extended Thinking nutzt und wie viel Aufwand es dafür betreibt.
Adaptives Denken erlaubt dem Modell, die Komplexität deiner Eingabe einzuschätzen. Je nach Einfachheit oder Komplexität entscheidet es, ob Extended Thinking nötig ist. Statt eines festen manuellen Settings für die Tokenanzahl passt Claude das Budget pro Anfrage dynamisch an.
Mit dem Effort-Parameter legst du fest, wie großzügig oder sparsam Claude Tokens einsetzt. Kurz: Du balancierst zwischen Tokeneffizienz und Gründlichkeit der Antworten.
In der API kannst du diese Parameter manuell setzen. Zum Beispiel:
Kürzlich haben wir Claude in Excel vorgestellt und gezeigt, wie das Add-on dich im Seitenbereich deiner Tabelle bei verschiedenen Aufgaben unterstützt. Neben Verbesserungen dafür hat Anthropic nun Claude in PowerPoint angekündigt.
Die Integration respektiert deine Folienmaster, Schriften und Layouts. Du kannst ein Corporate-Template bereitstellen und dir bestimmte Abschnitte bauen lassen oder eine Folie auswählen und dichten Text in ein natives, editierbares Diagramm umwandeln lassen.
Der Fokus auf editierbare PowerPoint-Objekte statt bloßer „Bilder von Folien“ macht daraus ein echtes Produktivitätswerkzeug und nicht nur einen Ideengeber.
Claude in PowerPoint ist derzeit als Research Preview für Max- und Enterprise-Nutzer verfügbar.
Viele der großen Versprechen von Opus 4.6 betreffen anspruchsvollere Coding-Aufgaben und tieferes Reasoning. Diese Kompetenzen bauen auf Basics auf: mehrere Randbedingungen im Blick behalten, in vielen Schritten schlussfolgern und Fehler erkennen.
Mit diesem Fokus haben wir Opus 4.6 einer Reihe mehrstufiger Logik-, Mathe- und Coding-Challenges unterzogen. Ziel war es, bekannte LLM-Schwächen offenzulegen – zum Beispiel kaskadierende Rechenfehler, räumliches Denken (klassische Schwachstelle) und Fragen mit harten Constraints. Außerdem haben wir eine konkrete Debugging-Aufgabe aufgenommen, weil Anthropic in der Ankündigung Root-Cause-Analyse und Debugging besonders hervorgehoben hat.
Unser erster Test kombiniert Primzahlen, Hexadezimalzahlen und Zählen:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
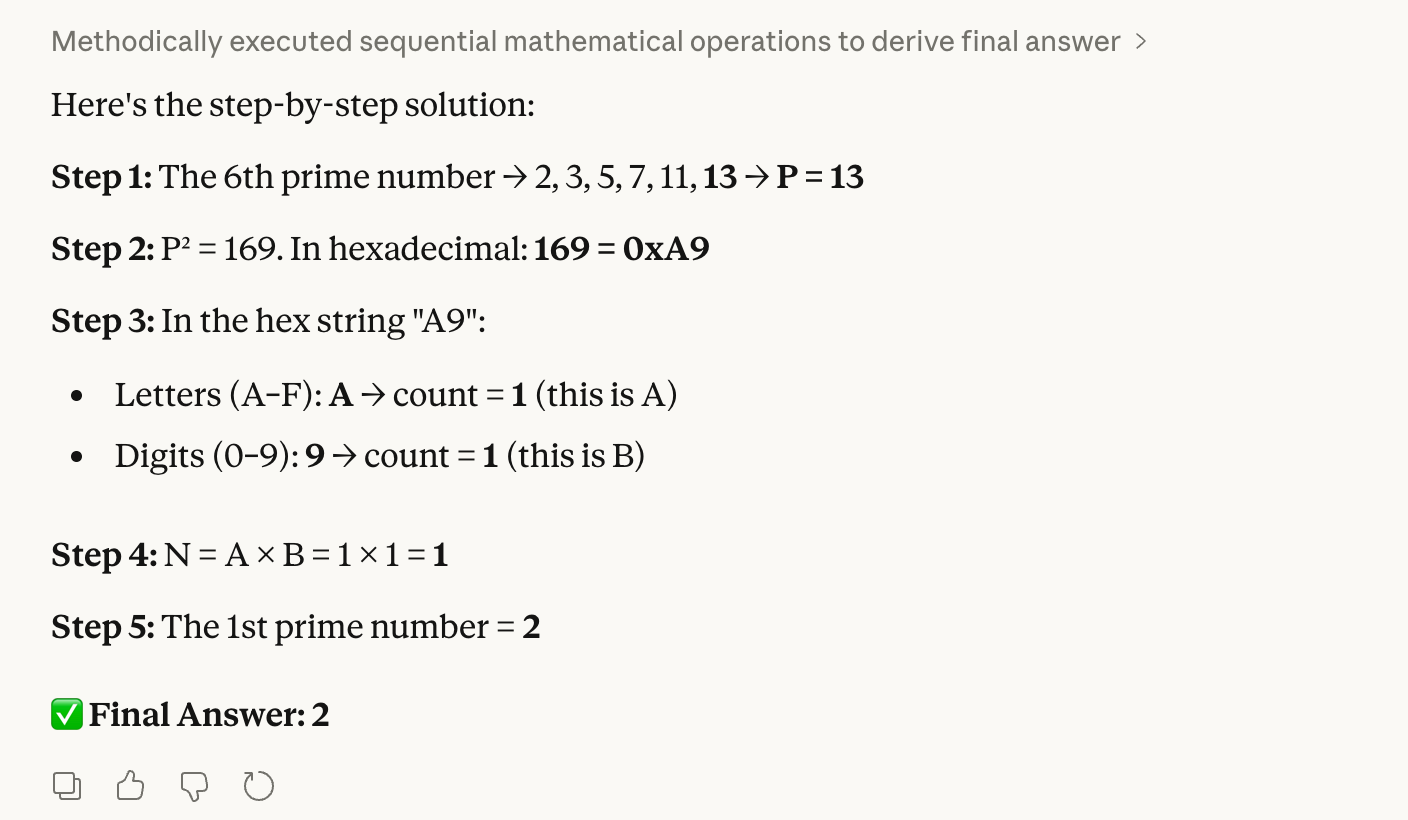
Klingt etwas verschachtelt, ist aber für uns Menschen gut überprüfbar. Die richtige Antwort ist 2, denn die 6. Primzahl ist 13; 13 zum Quadrat ist 169, in Hex ist das „A9“. Das sind 1 Buchstabe × 1 Ziffer, also 1; die 1. Primzahl ist 2.
Die Sorge: Beim Hex-Umrechnen könnte das Modell stolpern, was alle Folgeschritte verfälscht. Wie du siehst, hatte Opus 4.6 keinerlei Probleme:
Der zweite Test prüft räumliches Denken und den Umgang mit negativen Zahlen:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
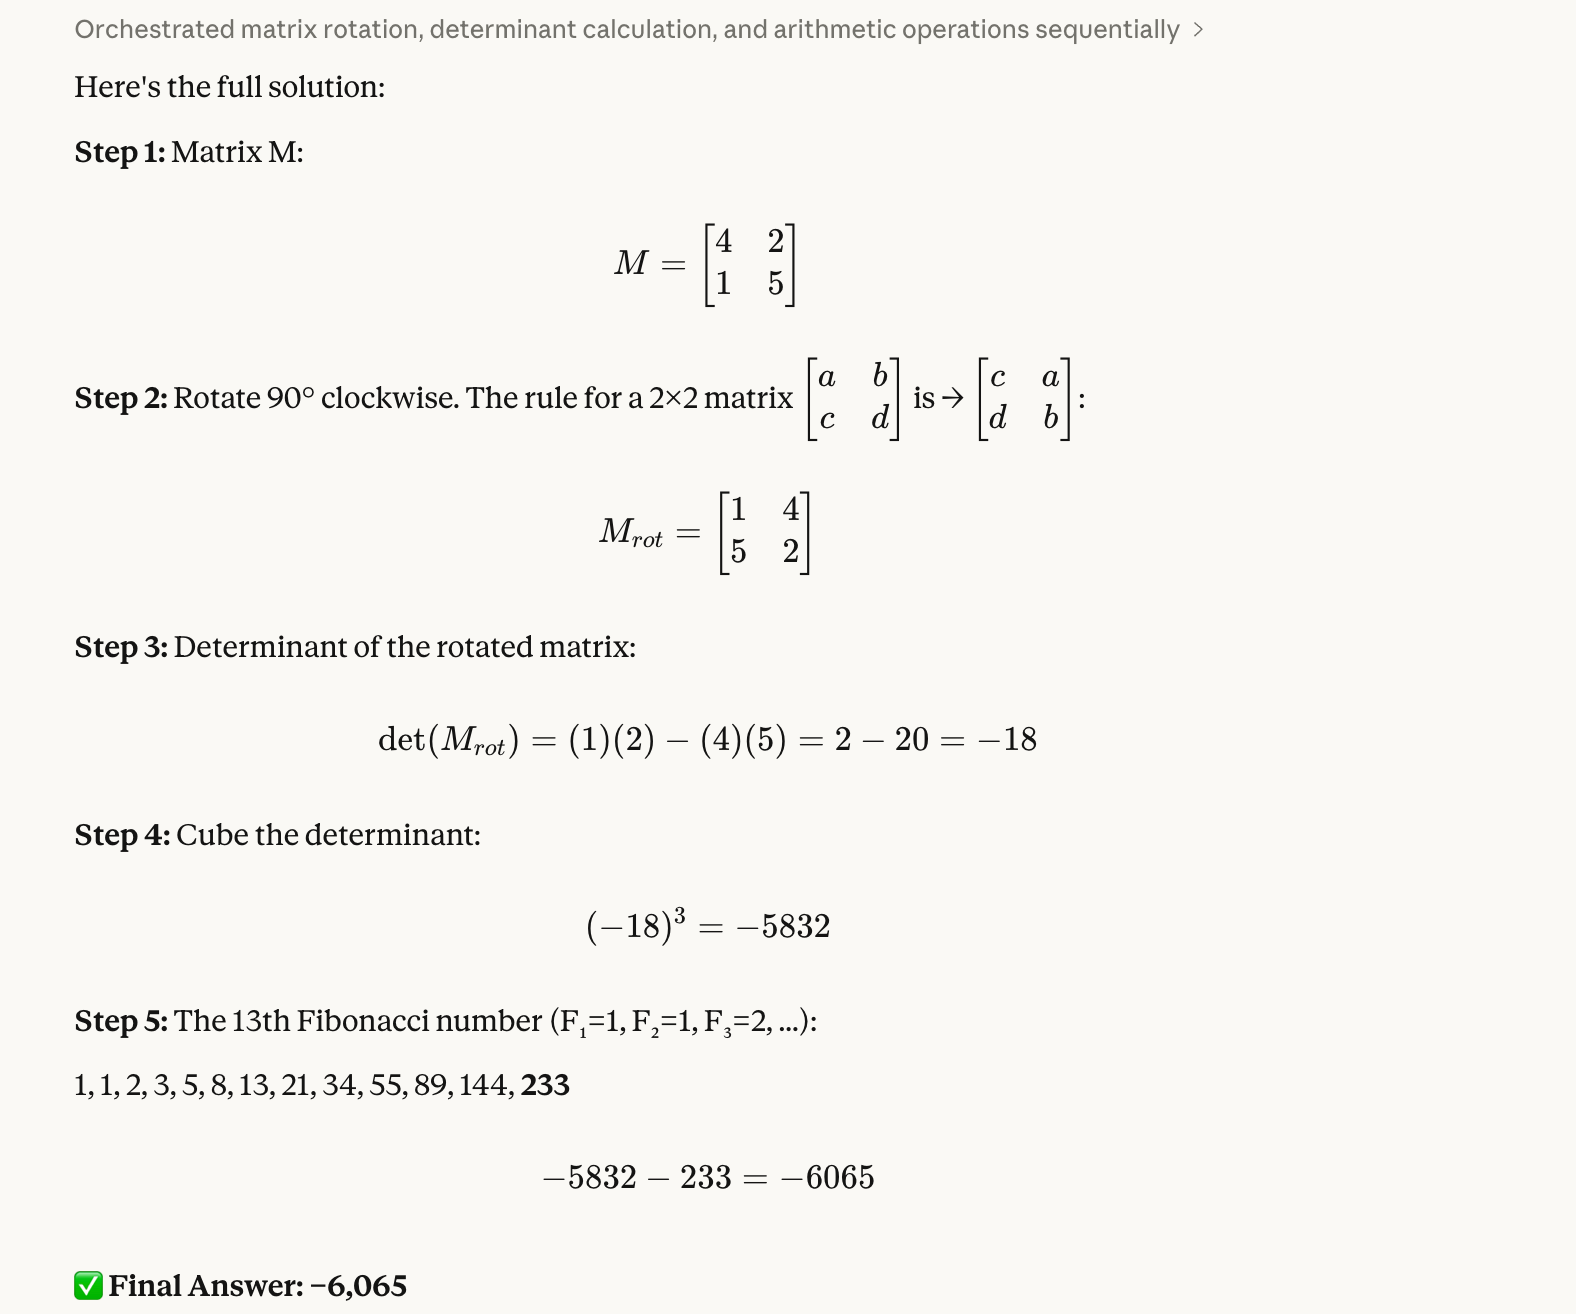
Die Verifikation war hier etwas aufwendiger. Die richtige Antwort ist -6.065. Die gedrehte Matrix ist [[1, 4], [5, 2]]; der Determinant ist -18, hoch 3 ergibt -5.832; abzüglich 233 sind es -6.065.
Wir mochten diesen Test, weil Modelle hier oft Elemente falsch vertauschen oder das Minuszeichen verlieren. Auch hier: Opus 4.6 fehlerfrei.
Im dritten Test gab es ein Constraint-Satisfaction-Problem mit Backtracking:
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
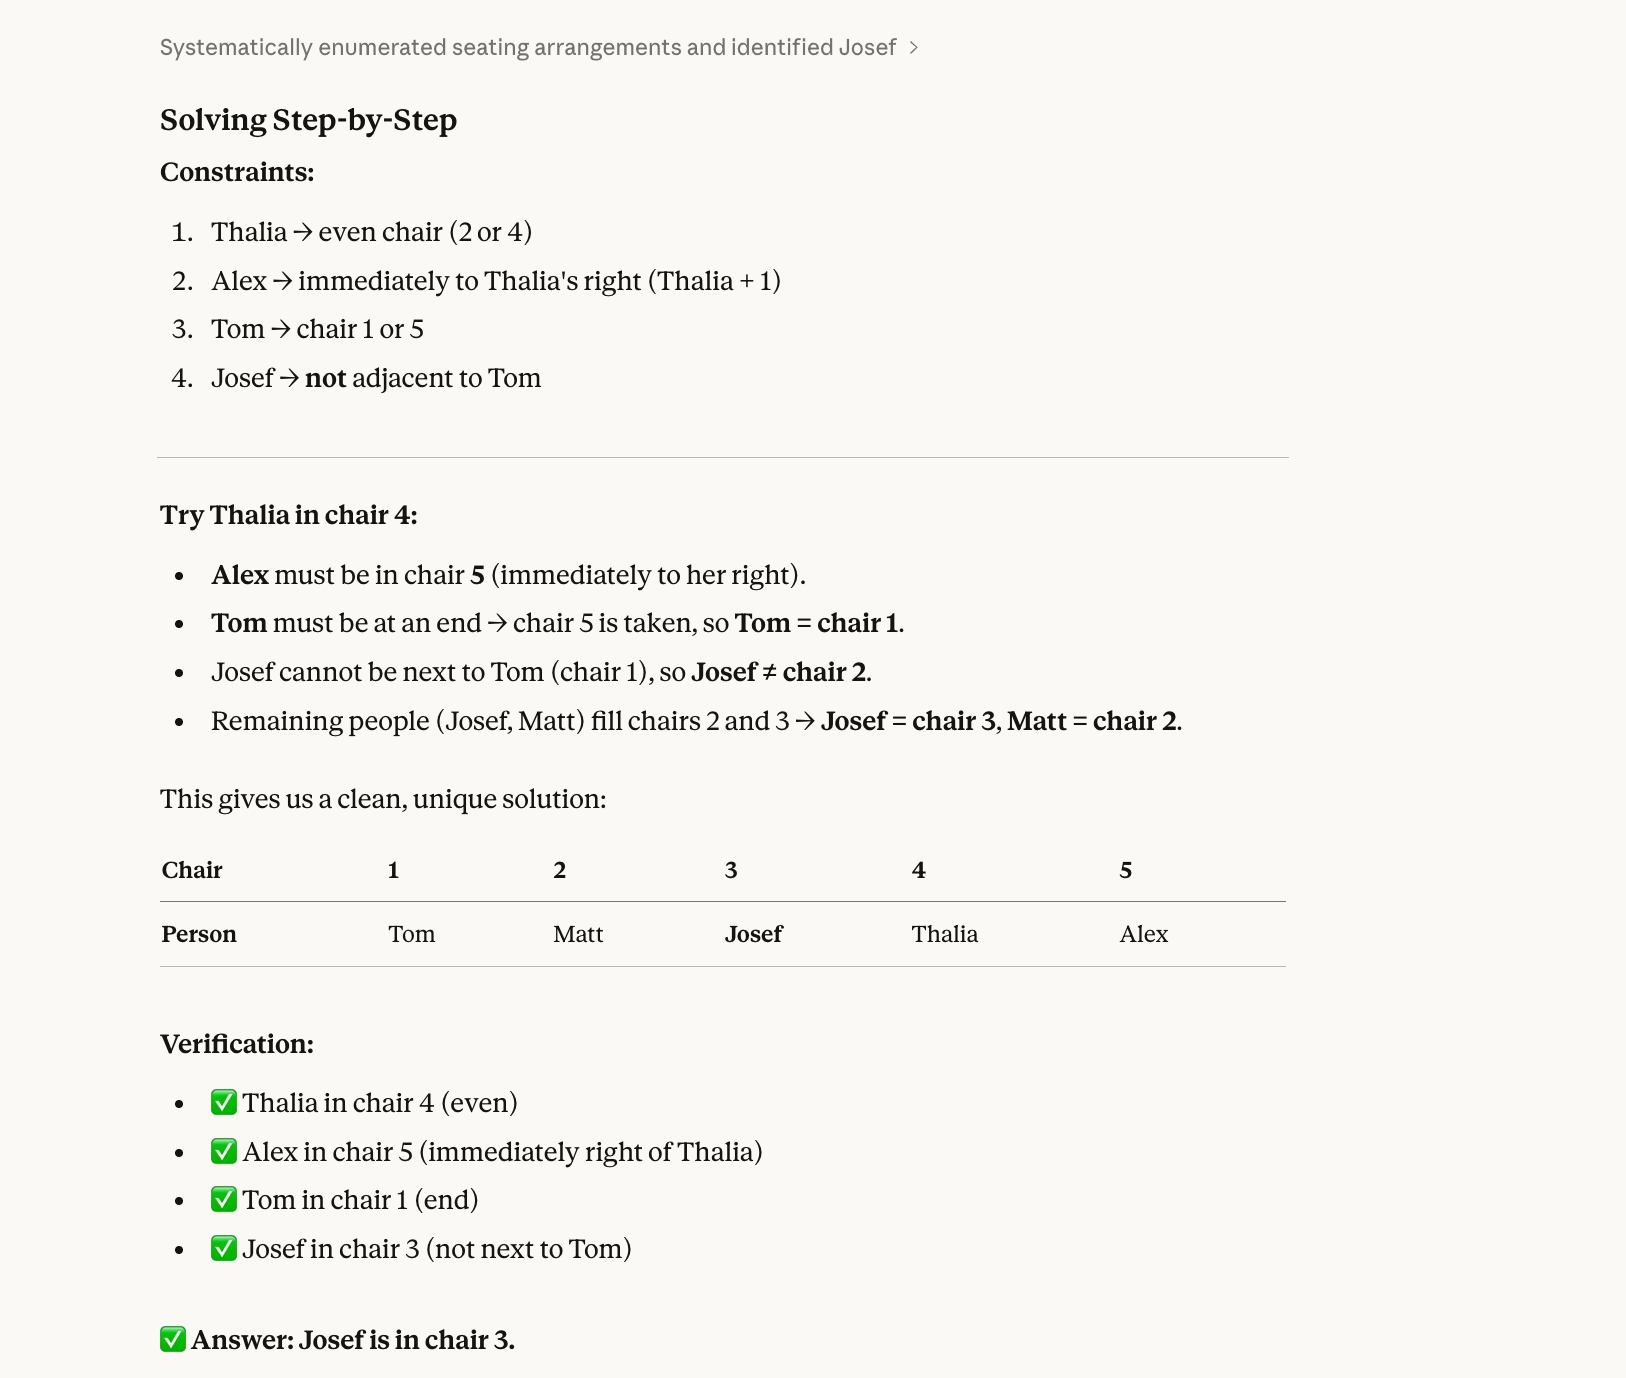
Die richtige Antwort ist Josef. (Alex-1, Matt-2, Josef-3, Thalia-4, Tom-5.) Mit etwas Geduld lässt sich das per Hand lösen.
Warum Modelle hier scheitern: Sie lösen oft sequentiell statt holistisch. Sie lesen „Thalia sitzt auf einem geraden Platz“, wählen Platz 2, prüfen aber nicht, ob diese Wahl mit allen übrigen Bedingungen vereinbar ist. Dann verhaken sie sich und backtracken nicht.
Opus 4.6 lag auch hier richtig:
Der vierte Test prüft räumliche Vorstellung und physikalische Intuition:
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
Zur Verifikation habe ich meine Armbanduhr tatsächlich gedreht.
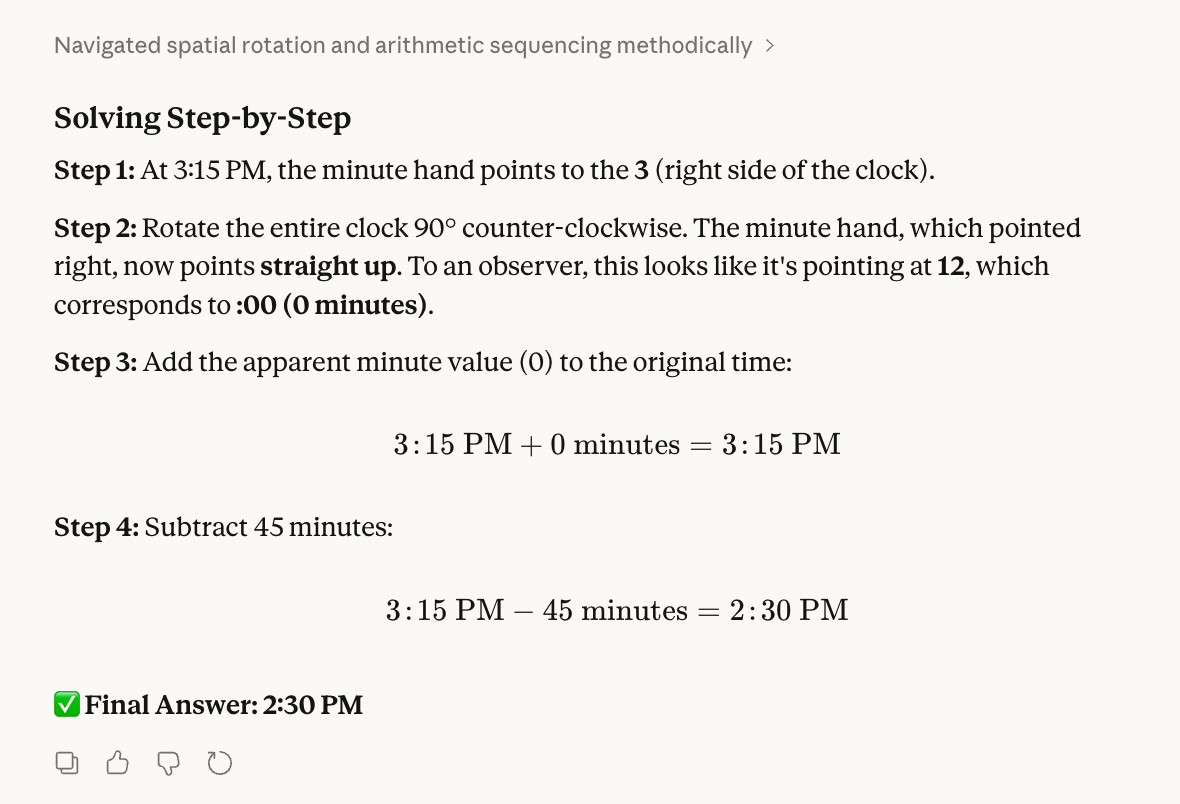
Die richtige Antwort ist 14:30. Um 3:15 zeigt der Minutenzeiger auf die „3“. Drehe ich die 12 nach links zum Fenster, wandert die „3“ dorthin, wo vorher die „12“ war. Ich addiere 0 zu 3:15, ziehe 45 Minuten ab und lande bei 14:30.
Wir vermuteten, dass Modelle das Drehen des Zifferblatts mit dem Bewegen des Zeigers verwechseln. Außerdem versuchen Modelle manchmal, eine 0 „zu korrigieren“.
Opus 4.6 löste auch dieses Problem korrekt:
Der fünfte Test kombiniert modulare Arithmetik mit Primzahlfilterung:
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
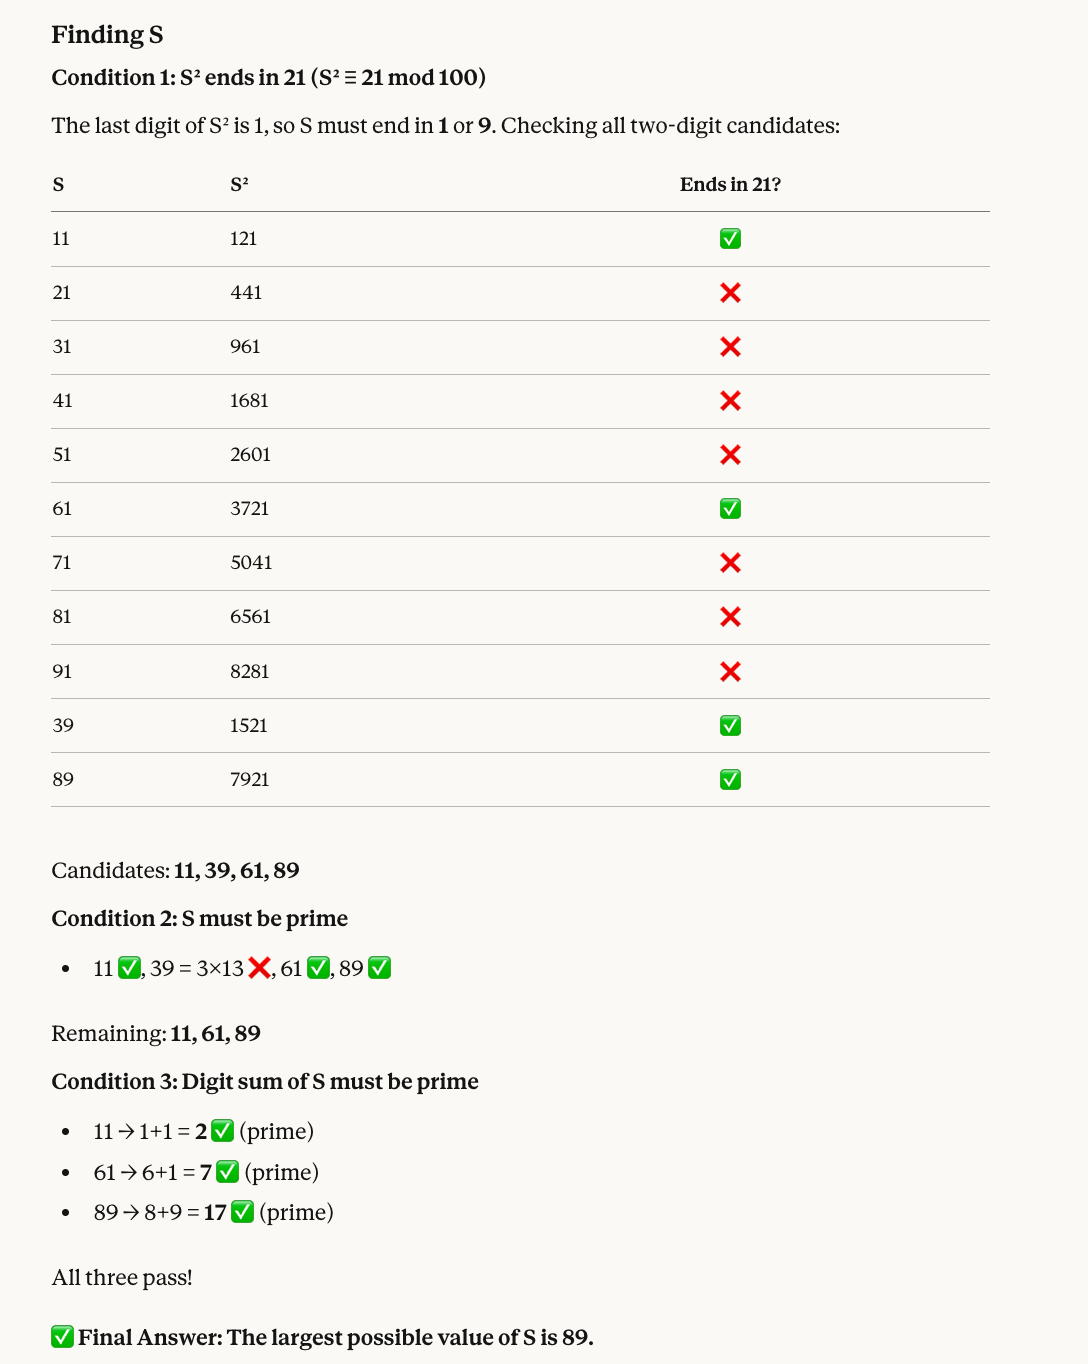
Darum ist 89 korrekt: Zahlen, deren Quadrat auf 21 endet, sind u. a. 11, 39, 61 und 89. 39 ist nicht prim, also bleiben 11, 61 und 89. Alle drei haben Primziffernsummen (2, 7 bzw. 17). Die größte ist 89.
Opus 4.6 traf erneut die richtige Antwort und lieferte dazu eine hilfreiche Visualisierung:
Der nächste Test verknüpft Fakultäten, String-Manipulation und Primzahlen:
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
So haben wir 425 verifiziert: 5! = 120; minus 1 ergibt 119; Ziffern umkehren ergibt 911. Mit R-Code (unten) sehen wir 152 Primzahlen zwischen 10 und 911 mit einer Summe von 64.598. Dann teilen und runden: 64.598 ÷ 152 ≈ 425.
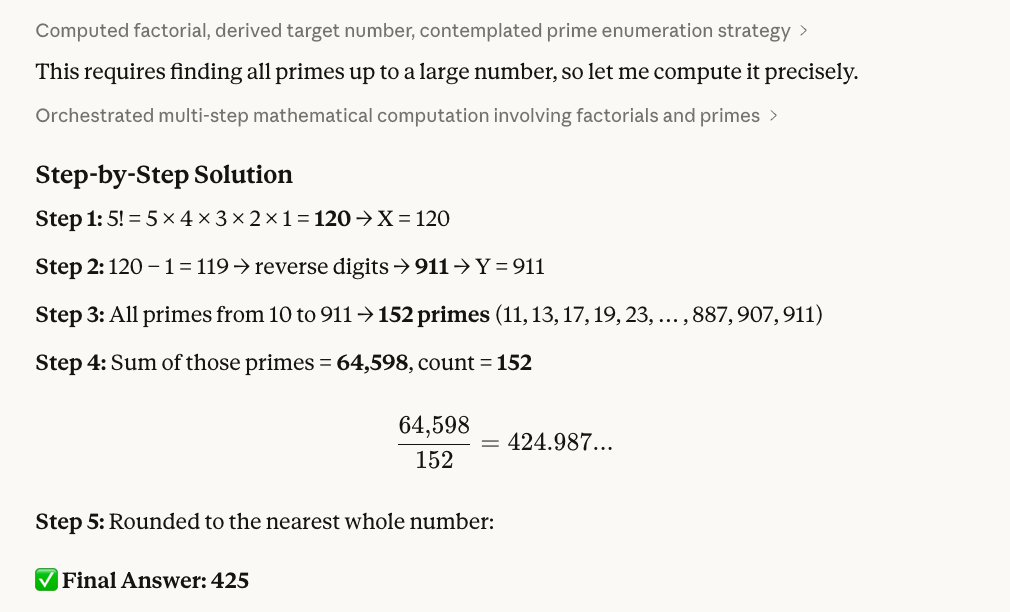
Hier das verwendete R-Skript:
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
cat("Step 5: Rounded =", round(avg), "\n")Der nächste Test zielt auf einen der großen Claims von Opus 4.6: Bugs im Code diagnostizieren. Modelle können Code oft Zeile für Zeile korrekt nachverfolgen, scheitern aber daran, den Trace mit der eigentlichen Ursache zu verbinden.
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
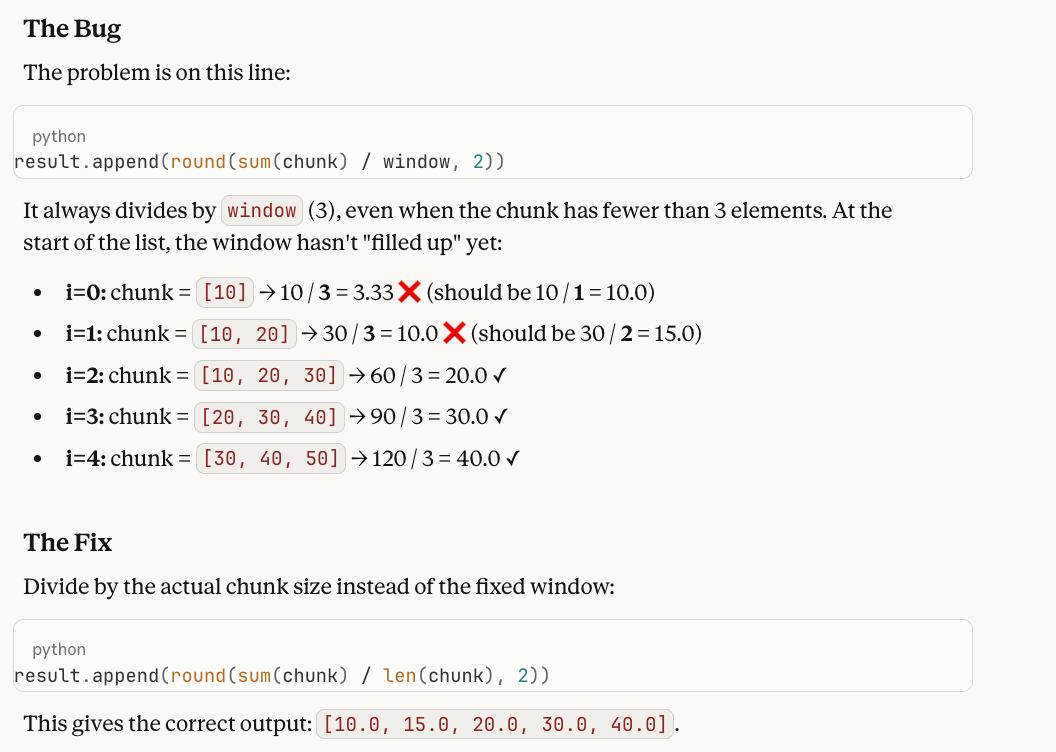
Die Ursache und warum der Test gut ist: Die Funktion teilt immer durch window (3), auch wenn die ersten „chunks“ weniger als 3 Elemente haben. Der fehlerhafte Output ist [3.33, 10.0, 20.0, 30.0, 40.0], korrekt wären für die ersten beiden Werte 10.0 und 15.0, da die Chunks nur 1 bzw. 2 Elemente enthalten. Der Fix: / window zu / len(chunk) ändern.
Dieser Test ist stark, weil Modelle die Schleife oft perfekt durchgehen, dann aber melden „Output sieht korrekt aus“ — sie sehen die Rechenschritte, erkennen aber nicht, dass das Teilen eines einzelnen Elements durch 3 falsch ist. Das Modell muss Intention (was ein gleitender Durchschnitt tun soll) und Implementierung (was der Code tatsächlich macht) parallel halten und die Lücke erkennen.
Der letzte Test kommt ohne Mathe aus, es geht um kontrafaktisches Denken.
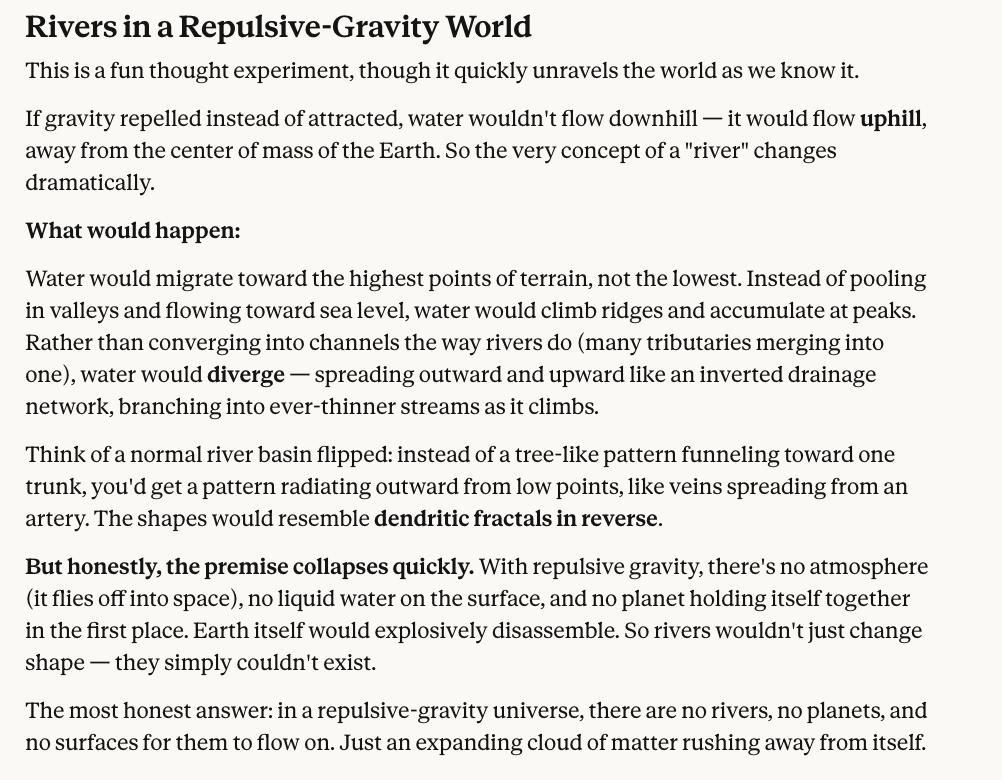
In a world where gravity repels objects instead of attracting them, what shape would rivers take?Zugegeben: Es gibt hier keine einzig richtige Antwort, und es ist schwer vorstellbar. Wir wollten sehen, ob das Modell die Implikationen sauber durchdenkt, und finden, dass Claude Opus 4.6 eine plausibel begründete Antwort liefert.
Unterm Strich: Opus 4.6 holte die volle Punktzahl – wenn auch mit einer subjektiven Frage, bei der du selbst urteilen kannst.
Opus 4.6 führt mindestens vier wichtige Benchmarks an:
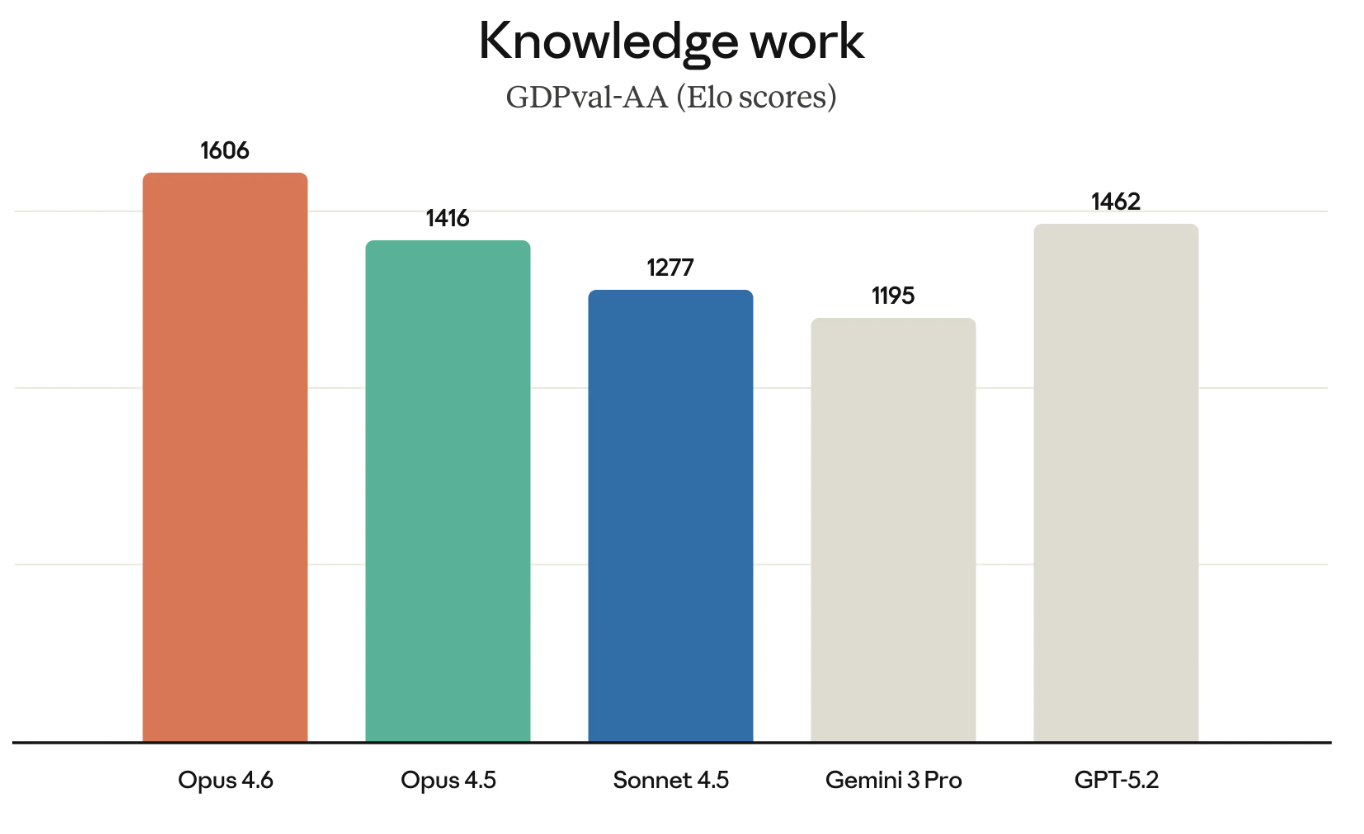
Terminal-Bench 2.0 prüft agentisches Coding; Humanity’s Last Exam testet komplexes Reasoning; GDPval-AA misst Leistung in wissensintensiver Arbeit; BrowseComp bewertet die Fähigkeit eines Modells, schwer auffindbare Informationen online zu recherchieren.
Claude-Modelle gelten zurecht als erstklassige Coder. Starten wir also mit den Ergebnissen des Terminal-Bench-2.0-Benchmarks.
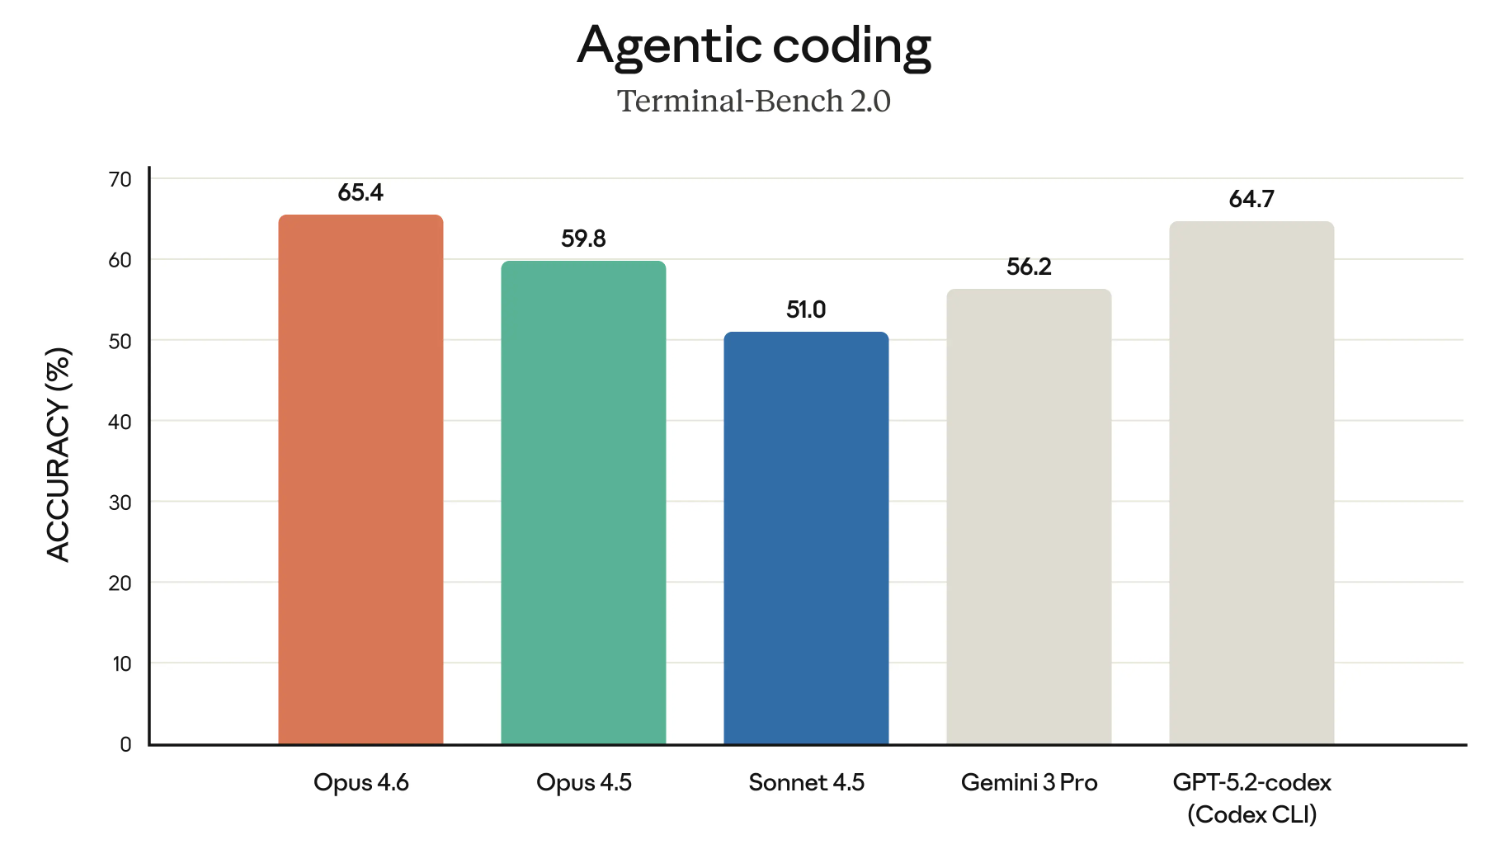
Wenn der obige Graph Opus 4.6 besonders im Verhältnis zu GPT-5.2-codex hervorhebt – das ist sicher Absicht. Anthropic fordert OpenAI aktuell in mehreren Bereichen direkt heraus und positioniert sich klar für den Enterprise-Einsatz.
Humanity’s Last Exam ist einer der bekanntesten Benchmarks und für viele von uns besonders relevant. Er misst die allgemeine Reasoning-Fähigkeit eines Modells.
Die folgende Grafik zeigt die Erfolgsquoten verschiedener Frontier-Modelle im HLE-Benchmark mit und ohne Tools. (Mit Tools bedeutet, dass das Modell externe Fähigkeiten wie Websuche oder Codeausführung nutzen durfte.)
Auch wenn das als zwei Diagramme übersichtlicher wäre, ist die Aussage eindeutig: Opus 4.6 führt sowohl „mit Tools“ als auch „ohne Tools“.
GDPval-AA (der Name verrät es) testet ökonomisch wertvolle Wissensarbeit – etwa Finanzmodellierung oder Research.
GDPval-AA und ähnliche Benchmarks gewinnen an Bedeutung, weil sie die Arbeit messen, für die Unternehmen tatsächlich bezahlen. Der Erfolg von Opus 4.6 bei GDPval-AA ist eine weitere direkte Herausforderung an die GPT-Modellreihe, da OpenAI und Anthropic um viele der gleichen Unternehmenskunden konkurrieren.
BrowseComp ist der letzte erwähnenswerte Benchmark im Release. Er misst, wie gut ein Modell schwer auffindbare Informationen im Netz ausfindig macht. Fun Fact: OpenAI hat BrowseComp ursprünglich entwickelt, um die Suchfähigkeiten der eigenen Modelle zu demonstrieren.
In einem recht spitzen Zug verlinkte Anthropic in diesem Release direkt auf OpenAIs Ankündigung vom April 2025 zur Entwicklung von BrowseComp – um zu unterstreichen, dass Opus 4.6 darin nun vorne liegt. Ein kleiner Seitenhieb mit OpenAIs eigenem Benchmark.
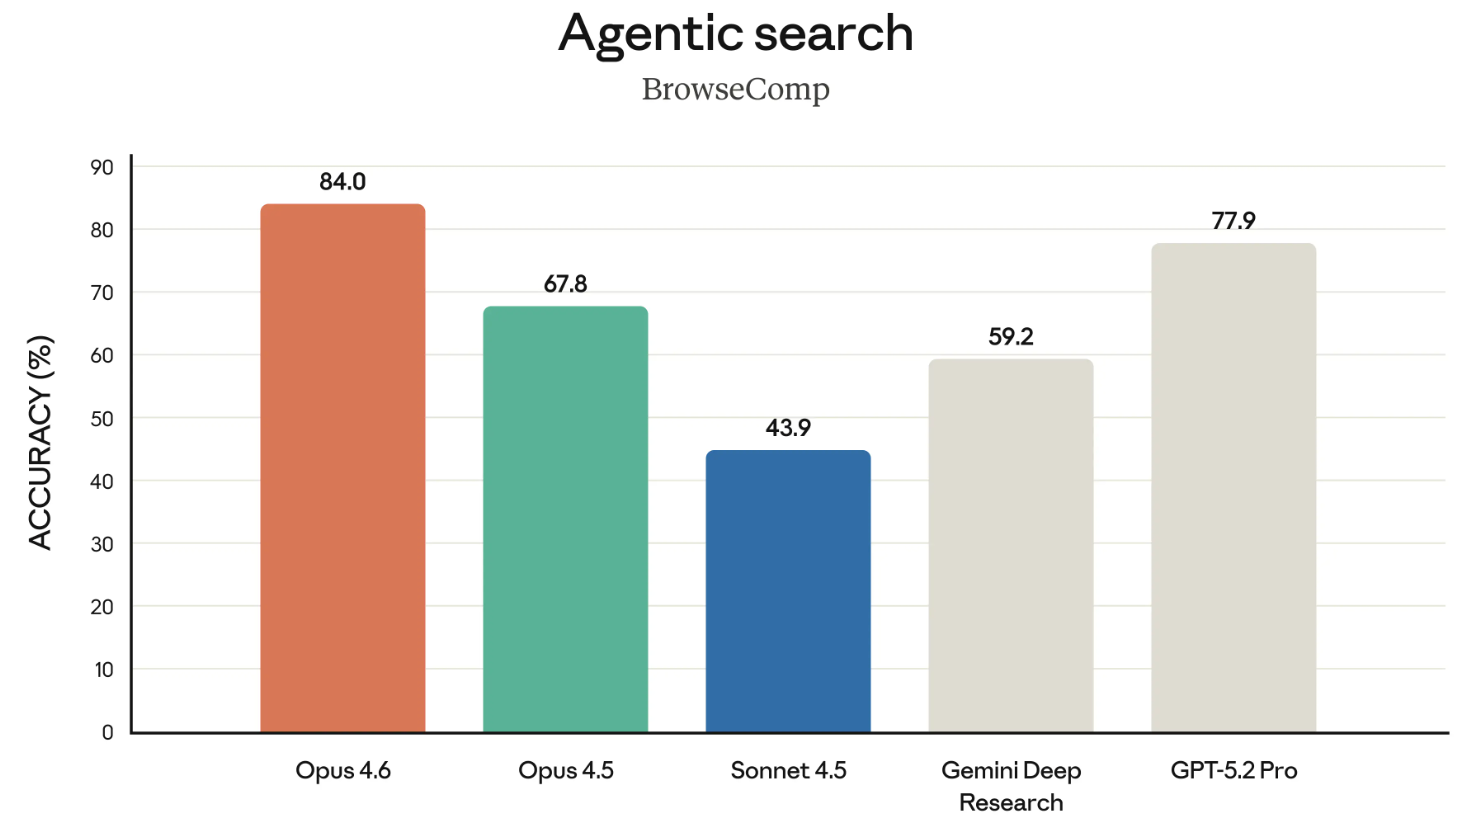
Opus 4.6 ist zum Zeitpunkt dieses Artikels breit verfügbar. Du brauchst jedoch ein Pro-Konto, um darauf zuzugreifen – das bringt weitere Vorteile, etwa Claude in Excel zu nutzen.
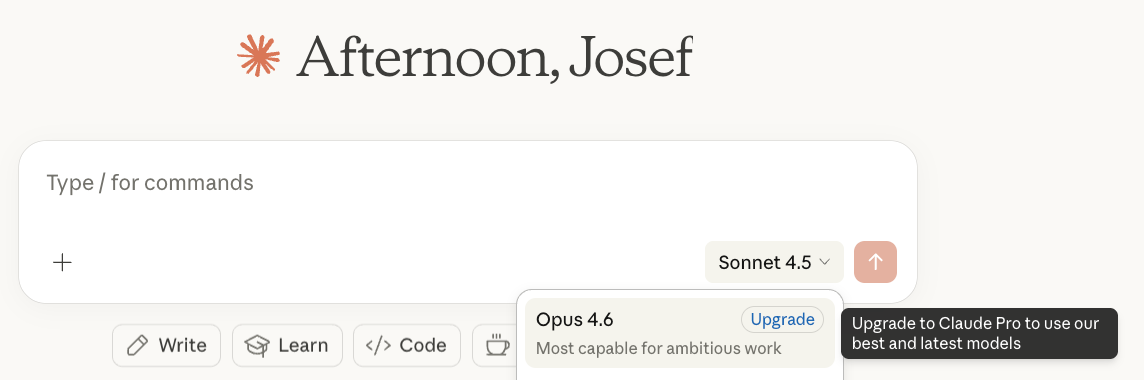
Wenn du entwickelst, nutze in der Claude API claude-opus-4-6. Die Preise sind unverändert: $5/$25 pro Million Tokens. Falls dich die zwei Zahlen irritieren: Die erste ist der Preis für eingehende Tokens (deine Prompts), die zweite für ausgehende Tokens (die Antworten).
Claude Opus 4.6 führt wichtige Benchmarks wie GPDVal-AA an, die messen, wie gut ein Modell wirtschaftlich relevante Aufgaben löst – genau das, was Großkunden interessiert. OpenAI dürfte das nervös machen, denn nur Stunden vor dem Opus-4.6-Release kündigte das Unternehmen OpenAI Frontier an – eine Enterprise-Plattform zum Bauen, Ausrollen und Managen von KI-Agenten in der Produktion.
Statt den Wettkampf in Benchmarks zu suchen, zeigt Frontier, dass OpenAI auf die Infrastruktur rund um die eigenen Modelle setzt: Agenten mit gemeinsamem Geschäftskontext, Berechtigungen und der Fähigkeit, über Zeit Feedback aufzunehmen und daraus zu lernen. Während es bei Benchmarks Rückstand geben mag, signalisiert OpenAI, dass seine Plattform Agenten im Unternehmensalltag wirklich nutzbar macht.
Ob das eine strategische Neuausrichtung ist oder ein stilles Eingeständnis, im Modellrennen zurückzufallen, musst du selbst bewerten.
Insgesamt sind wir beeindruckt von Anthropics Angebot mit Claude Opus 4.6 und freuen uns besonders auf Hands-on-Erfahrungen mit den Agententeams. Wenn du mehr über die Claude-Familie lernen willst, schau dir unbedingt den Kurs Introduction to Claude Models an.
Learn AI with DataCamp
Kurs
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Blog
Nathaniel Taylor-Leach
8 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Kurtis Pykes
15 Min.


