
Cours
Introduction aux modèles Claude
3 h
14.3K
Des rumeurs sur la prochaine sortie d'Anthropic bruissaient ces derniers jours. Beaucoup attendaient Claude Sonnet 5, mais la première sortie de l'année prend la forme de Claude Opus 4.6.
Avec une fenêtre de contexte d'1 million de tokens, une pensée adaptative, une compaction des conversations et une série de benchmarks en tête de classement, Claude Opus 4.6 améliore Opus 4.5. Comme l'exprime Anthropic, ils ont mis à niveau leur modèle le plus intelligent. En parallèle, Anthropic lance également des équipes d'agents dans Claude Code et Claude in PowerPoint.
Dans cet article, nous passons en revue tout ce qu'apporte Claude Opus 4.6 : ses nouvelles fonctionnalités, ses performances aux benchmarks, et nous le mettons à l'épreuve avec plusieurs exemples concrets.
Pour en savoir plus sur les dernières fonctionnalités de Claude, nous vous recommandons nos guides sur Claude Cowork et Claude Code, ainsi que notre tutoriel OpenClaw. Pour une comparaison avec d'autres concurrents, lisez nos guides Muse Spark vs Claude Opus 4.6 et GPT-5.4 vs Claude Opus 4.6.
Claude Opus 4.6 est le dernier grand modèle de langue d'Anthropic. Dans la lignée de Opus 4.5, il représente une mise à niveau majeure de la gamme de modèles dite « la plus intelligente » de l'entreprise.
Dans l'article d'annonce, Anthropic explique avoir renforcé l'accent sur le codage agentique, le raisonnement approfondi et l'auto-correction. Autrement dit, on passe d'une logique d'action à une action soutenue.
Opus 4.6 est conçu pour planifier plus finement, maintenir une meilleure cohérence sur la durée et détecter ses propres erreurs. Conséquence : Claude Opus 4.6 arrive en tête de plusieurs benchmarks, dont la meilleure note sur l'évaluation de codage Terminal-Bench 2.0, et devance tous les autres modèles de pointe sur Humanity’s Last Exam.
L'un des points qui m'a le plus marqué est l'amélioration de la fenêtre de contexte dans Claude Opus 4.6. Avec 1 million de tokens en bêta, le nouveau modèle se met au niveau de Gemini 3, ce qui lui permet de traiter plus d'informations sans perdre le fil du contexte.
Entre-temps, Anthropic a publié la version successeure d'Opus. Nous vous recommandons de lire notre guide Claude Opus 4.7 pour rester à jour.
Plusieurs nouvelles fonctionnalités notables font leur apparition dans Claude Opus 4.6, beaucoup étant orientées vers des workflows agentiques. Voici les points clés :
Les équipes d'agents améliorent les « sous-agents » que nous avions vus dans les versions précédentes de Claude. Elles permettent de lancer plusieurs instances de Claude, pleinement indépendantes, pouvant travailler en parallèle. Une session joue le rôle d'agent « lead » qui coordonne, tandis que les « coéquipiers » gèrent l'exécution.
Particularité intéressante : chaque membre de l'équipe dispose de sa propre fenêtre de contexte, favorisant une exécution plus approfondie. Chaque coéquipier peut également communiquer directement avec les autres membres de l'équipe.
Bien sûr, cette fonctionnalité a un revers : le coût. Comme chaque agent dispose de sa propre fenêtre de contexte, votre consommation de tokens peut grimper très vite. Anthropic recommande donc de les réserver aux scénarios les plus complexes.
Une fonctionnalité très pratique de Claude Opus 4.6 est la compaction du contexte. Cette amélioration de confort évite les problèmes lorsque vous exécutez de longs workflows qui saturent les fenêtres de contexte. Habituellement, passé un certain seuil, les performances se dégradent.
Avec la compaction des conversations, Claude Opus 4.6 détecte automatiquement quand un échange approche un seuil de tokens et résume la conversation existante en un bloc concis (un bloc de compaction).
Cette fonctionnalité permet de conserver l'essentiel de vos interactions tout en libérant de l'espace pour poursuivre votre travail. Si vous envisagez d'utiliser des agents orientés tâches devant tourner longtemps, cela peut les aider à rester alignés grâce à une mémoire nettement améliorée.
Deux fonctionnalités de Claude Opus 4.6 déterminent s'il doit recourir à une pensée « étendue » et à quel niveau d'effort.
La pensée adaptative permet au modèle d'évaluer la complexité de votre requête. Selon sa simplicité ou sa complexité, il décide d'activer ou non la pensée étendue. Plutôt qu'un réglage manuel du nombre de tokens utilisés, Claude ajuste son budget en fonction de chaque demande.
Le paramètre d'effort vous permet de définir à quel point Claude est enclin ou prudent dans sa consommation de tokens. En clair, vous équilibrez efficacité d'usage des tokens et profondeur des réponses.
Lorsque vous utilisez Claude Opus 4.6 via l'API, vous pouvez régler ces paramètres manuellement. Par exemple :
Nous avons récemment présenté Claude in Excel, en montrant comment le complément vous aide dans un volet latéral de votre feuille Excel. Au-delà des améliorations de cet outil, Anthropic a annoncé Claude in PowerPoint.
Cette intégration respecte vos masques de diapositive, polices et mises en page. Vous pouvez lui fournir un modèle d'entreprise et lui demander de construire une section précise, ou sélectionner une diapo et lui demander de transformer un texte dense en schéma natif éditable.
L'accent mis sur la génération d'objets PowerPoint éditables, et non de simples « images de slides », en fait un véritable outil de productivité, pas seulement un générateur d'idées.
Claude in PowerPoint est actuellement en aperçu de recherche pour les utilisateurs Max et Enterprise.
Une grande partie des promesses d'Opus 4.6 porte sur des tâches de code plus ardues et un raisonnement plus profond. Ces compétences reposent sur des fondamentaux : garder plusieurs contraintes en tête, raisonner en plusieurs étapes et détecter les erreurs.
Dans cet esprit, nous avons soumis Opus 4.6 à une série de défis de logique multiétapes, de maths et de codage. Notre objectif : mettre à nu certaines faiblesses connues et courantes des LLM : erreurs de calcul en cascade, raisonnement spatial (souvent problématique) et questions à contraintes. Nous avons également inclus une tâche de débogage, Anthropic ayant vanté les capacités d'Opus 4.6 en analyse des causes racines et autres sujets de débogage.
Notre premier test combine nombres premiers, hexadécimal et comptage :
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
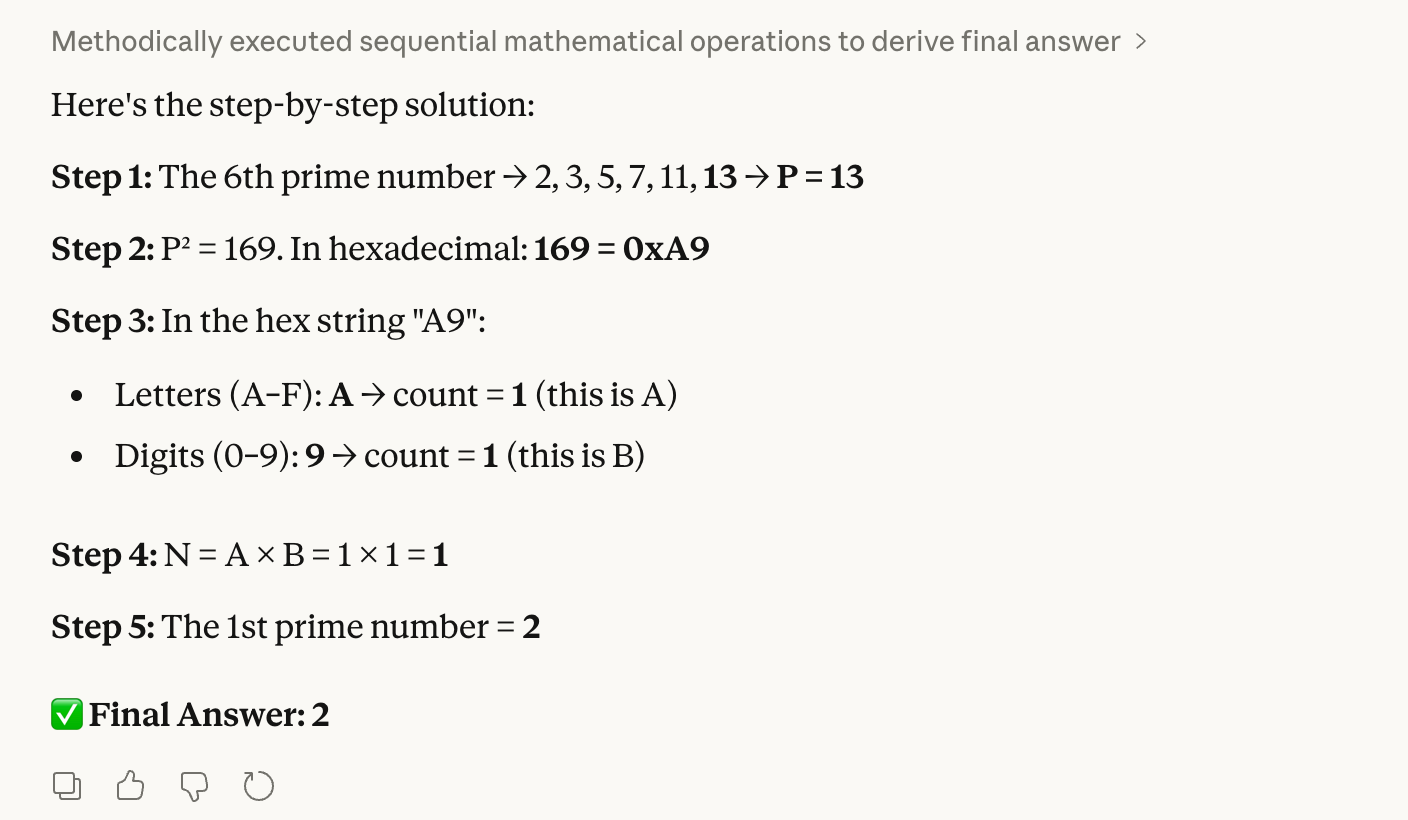
Cela paraît un peu complexe, mais c'est assez simple à vérifier pour nous, humains. La bonne réponse attendue est 2, car le 6e nombre premier est 13 ; 13 au carré vaut 169, soit « A9 » en hexadécimal. On y compte 1 lettre × 1 chiffre, soit 1, et le 1er nombre premier est 2.
La crainte est qu'un modèle se trompe dans la conversion hexadécimale, entrainant une chaîne d'erreurs jusqu'au résultat final. Comme vous le voyez, Opus 4.6 n'a eu aucun mal :
Notre deuxième test évalue le raisonnement spatial et la gestion des nombres négatifs :
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
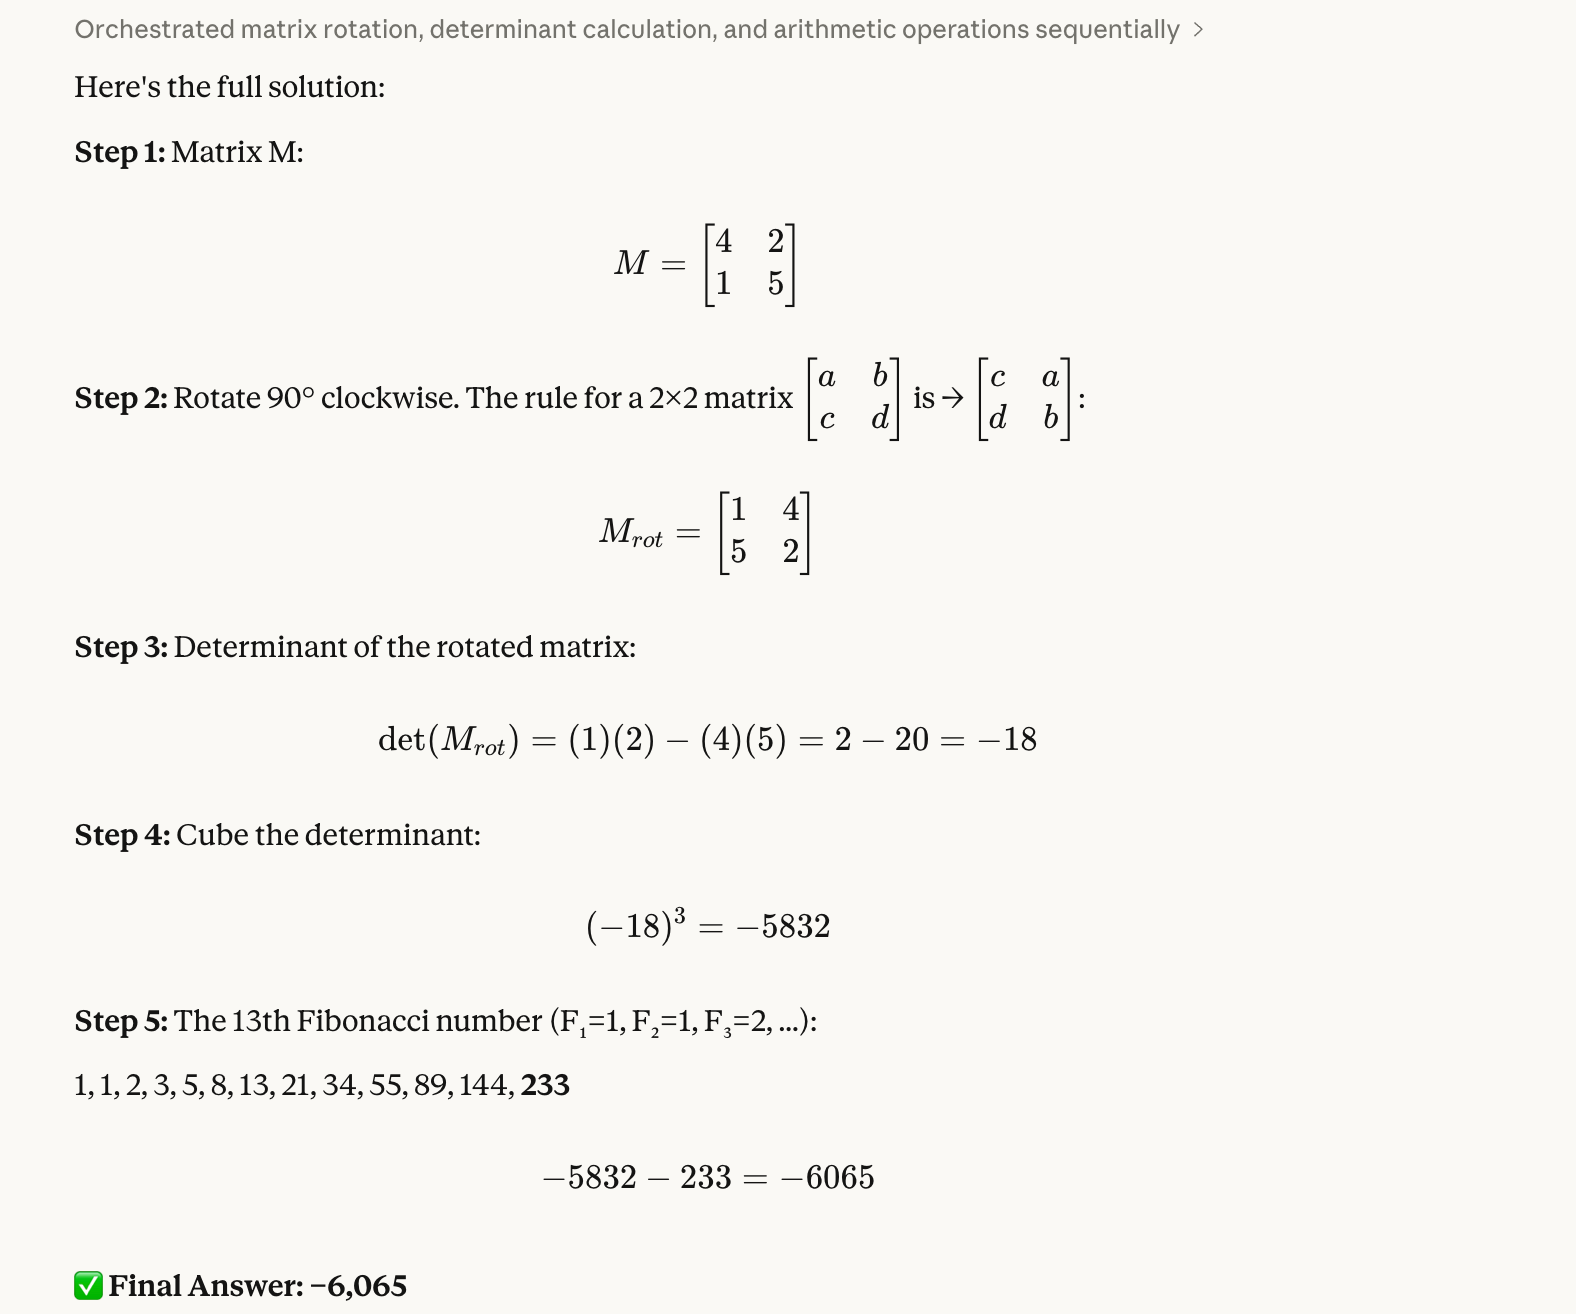
Celui-ci nous a demandé un peu plus de travail de vérification. La bonne réponse est -6 65. La matrice tournée est [[1, 4], [5, 2]] ; on calcule ensuite le déterminant avec Python, qui vaut -18, on le met au cube pour obtenir -5 832, puis on soustrait 233 pour arriver à -6 65.
Nous aimions ce test car les modèles inversent souvent mal des éléments de matrice ou perdent le signe négatif en route. Là encore, Opus 4.6 s'en sort sans accroc :
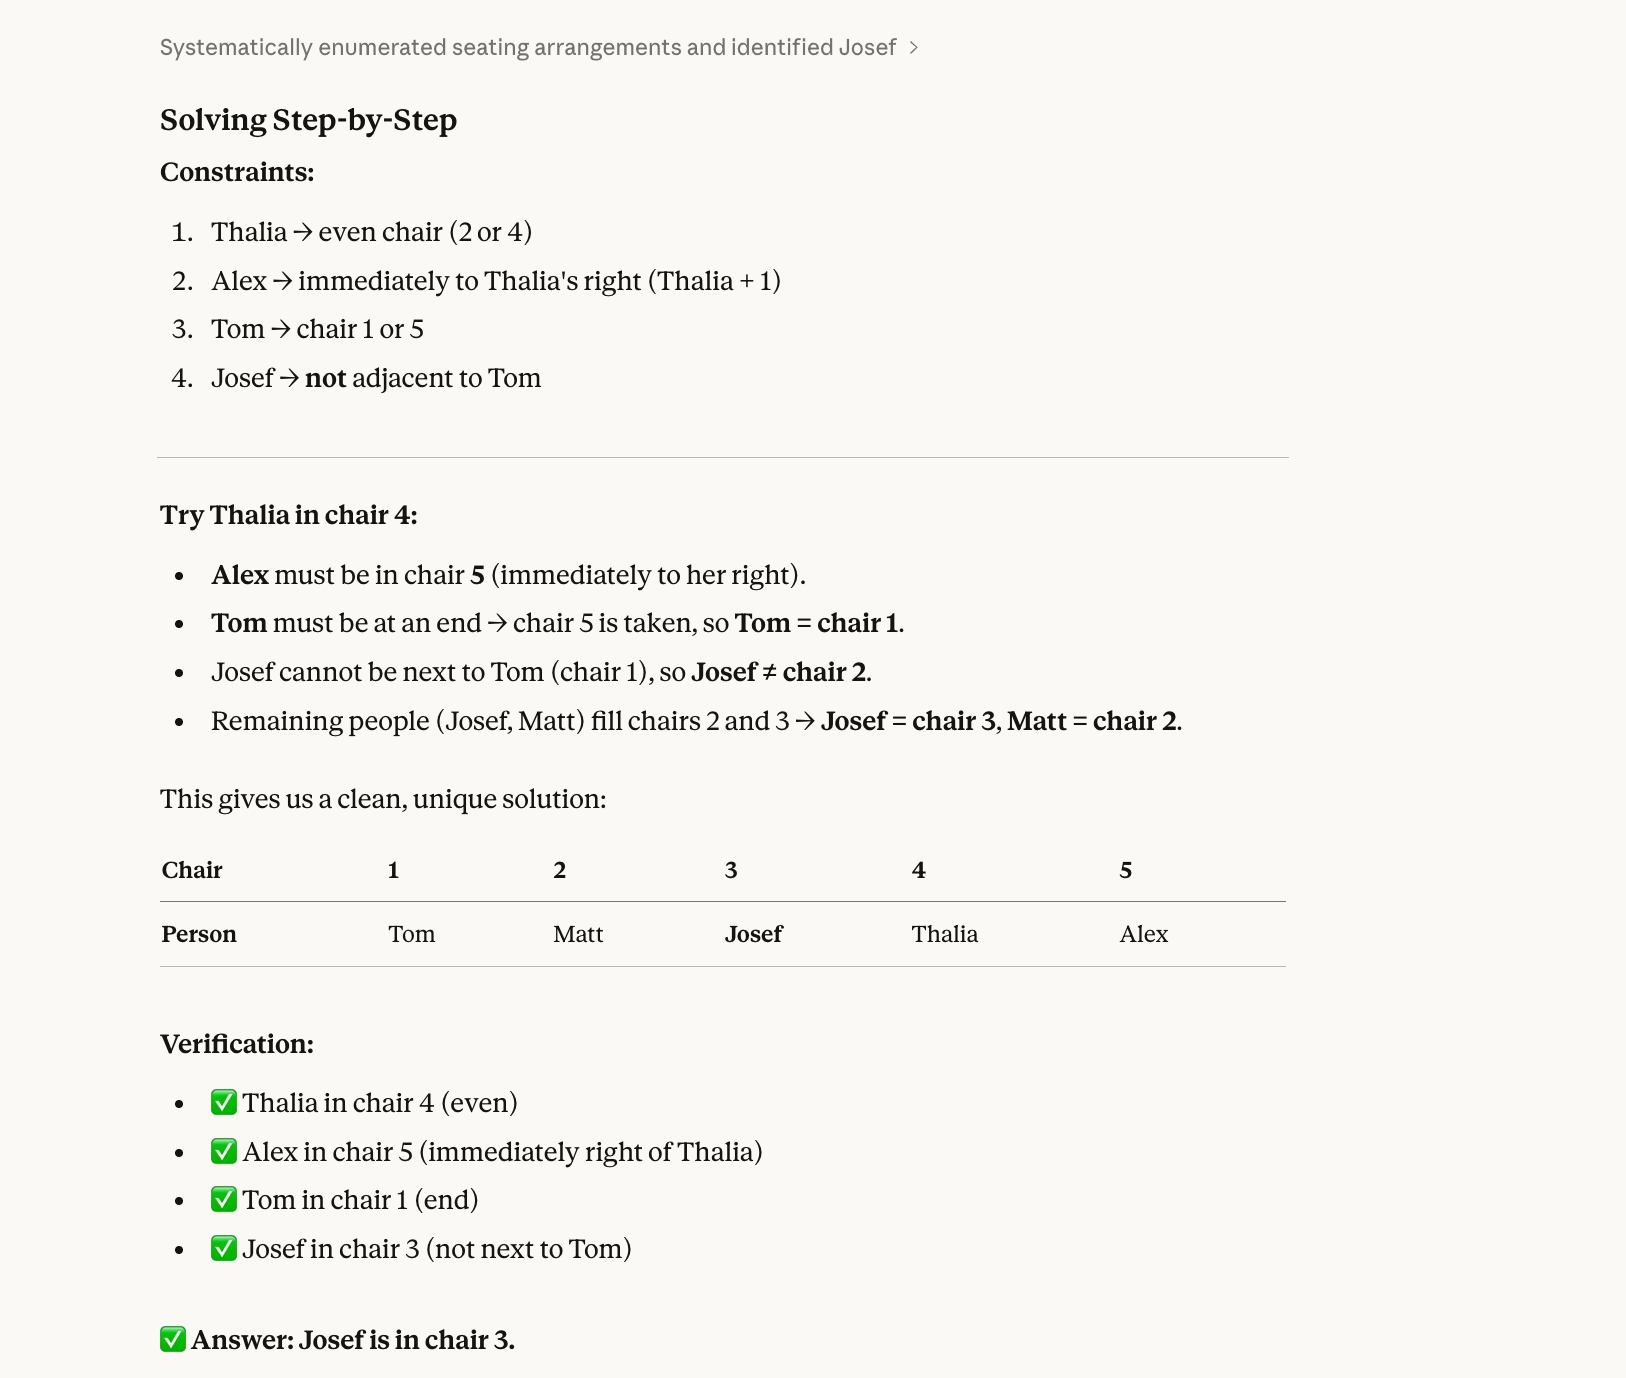
Pour le troisième test, nous avons proposé un problème à contraintes nécessitant du backtracking :
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
La bonne réponse est Josef. (Alex-1, Matt-2, Josef-3, Thalia-4, Tom-5.) On peut le déduire sur papier avec un peu d'effort.
Historiquement, les modèles résolvent ce type de question séquentiellement plutôt que globalement. Ils lisent « Thalia est sur une chaise paire » et en choisissent une (par exemple la 2) sans vérifier si ce choix respecte toutes les autres contraintes. Ils s'y engagent, remplissent, puis butent sur un conflit et ne reviennent pas tester Thalia en chaise 4.
Opus 4.6 a aussi réussi ce test :
Notre quatrième test évalue la visualisation spatiale et l'intuition physique :
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
Pour le vérifier, j'ai littéralement retiré ma montre et je l'ai tournée.
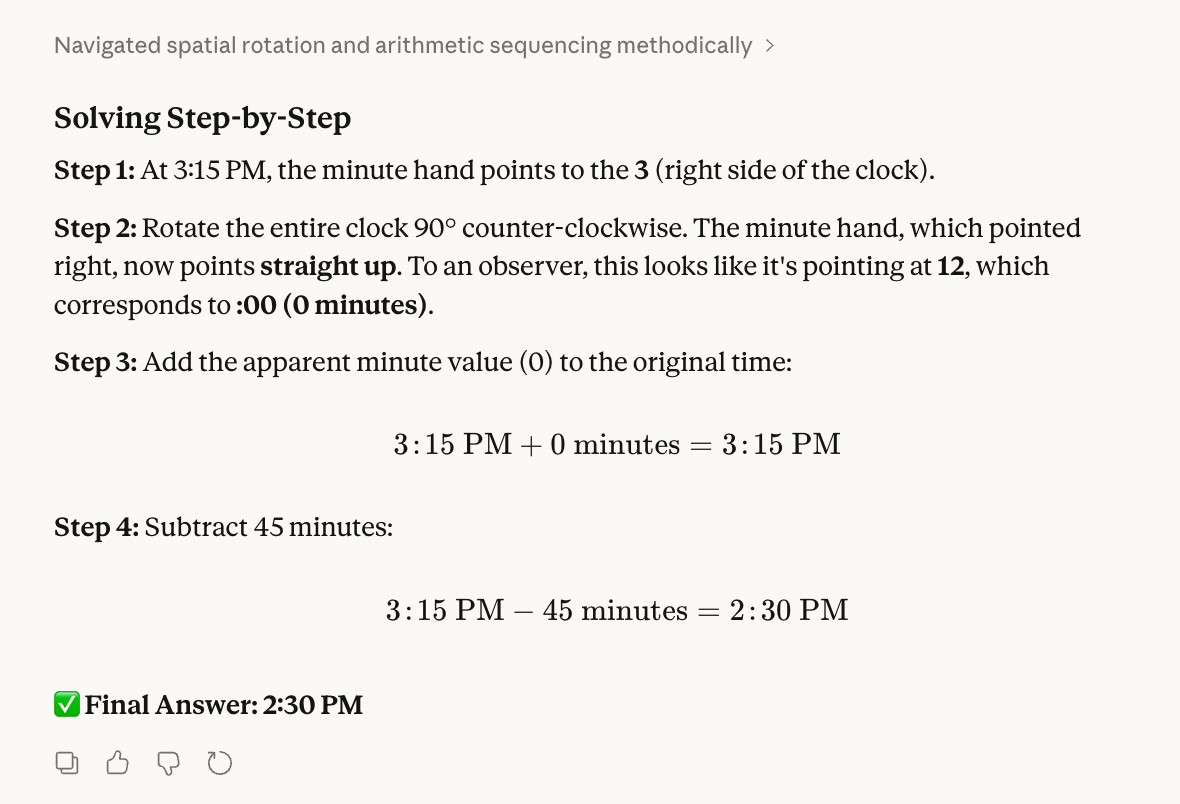
La bonne réponse est 14 h 30. À 15 h 15, l'aiguille des minutes pointe sur le « 3 ». Quand j'ai tourné le 12 vers la fenêtre sur ma gauche, le « 3 » s'est déplacé à la place du « 12 ». J'ai donc ajouté 0 à 15 h 15, retranché 45 minutes, et obtenu 14 h 30.
En conçevant ce test, nous pensions que les modèles confondraient la rotation du cadran avec le déplacement de l'aiguille. Nous avons aussi déjà vu des modèles « se méfier » d'un ajout de 0 et forcer un autre nombre.
Pourtant, Opus 4.6 a su résoudre l'énigme et donner la bonne réponse :
Notre cinquième test combine arithmétique modulaire et filtrage des nombres premiers :
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
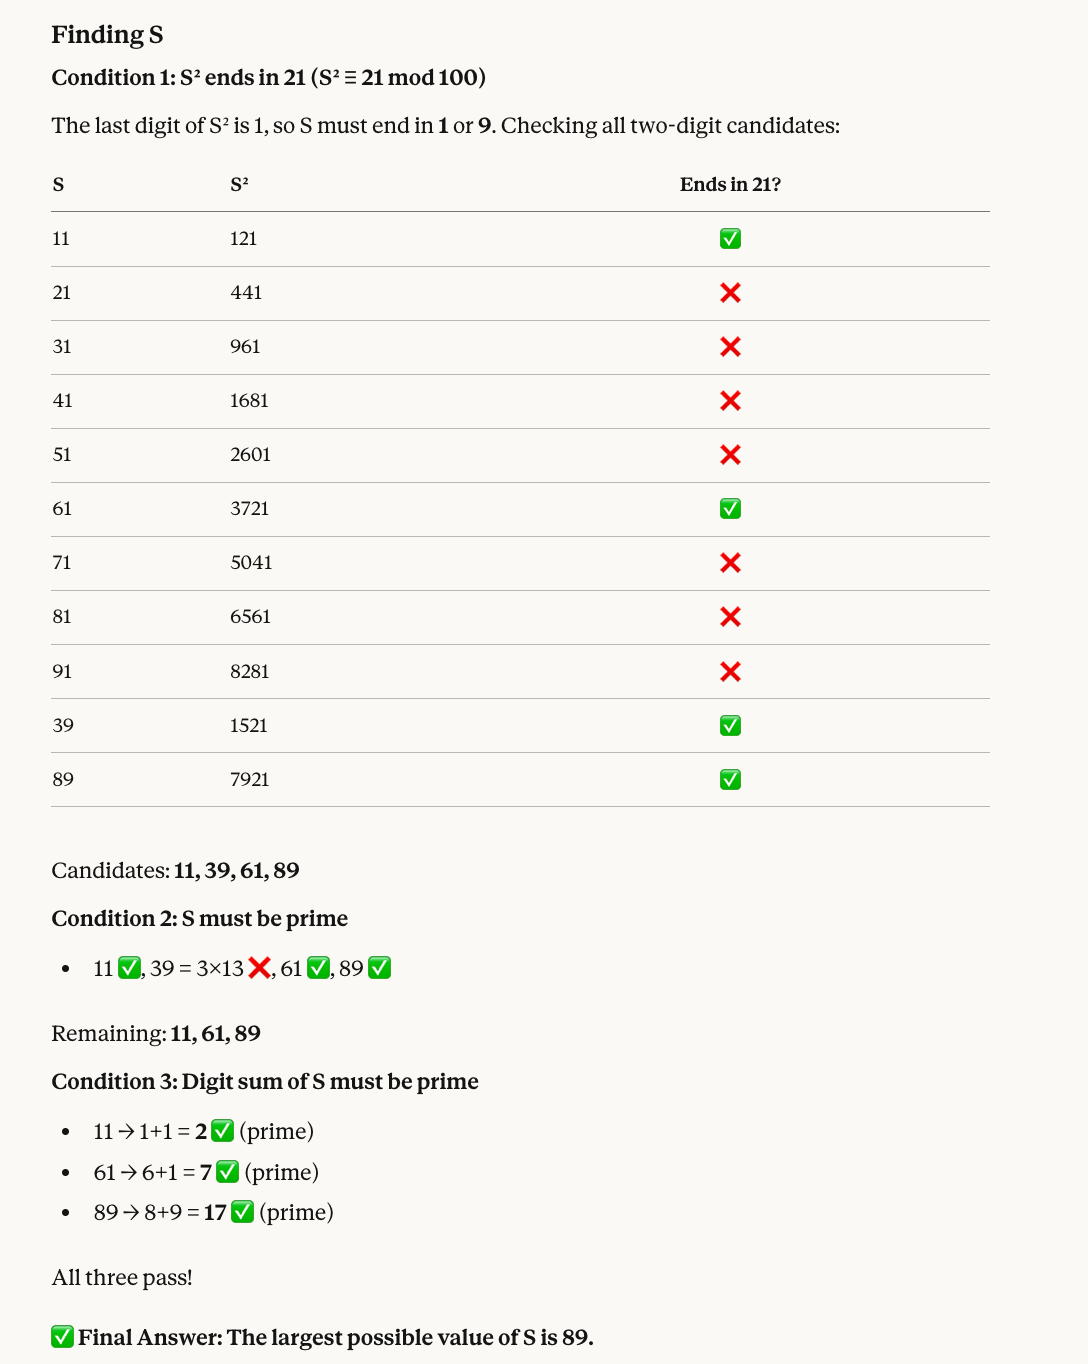
Voici pourquoi le nombre correct est 89 : les nombres dont le carré finit par 21 incluent 11, 39, 61 et 89. Parmi eux, 39 n'est pas premier, il reste donc 11, 61 et 89. Tous trois ont une somme de chiffres première (2, 7 et 17), le plus grand est donc 89.
Opus 4.6 a encore donné la bonne réponse, avec cette fois un visuel utile :
Le test suivant enchaîne factorielle, manipulation de chaînes et nombres premiers :
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
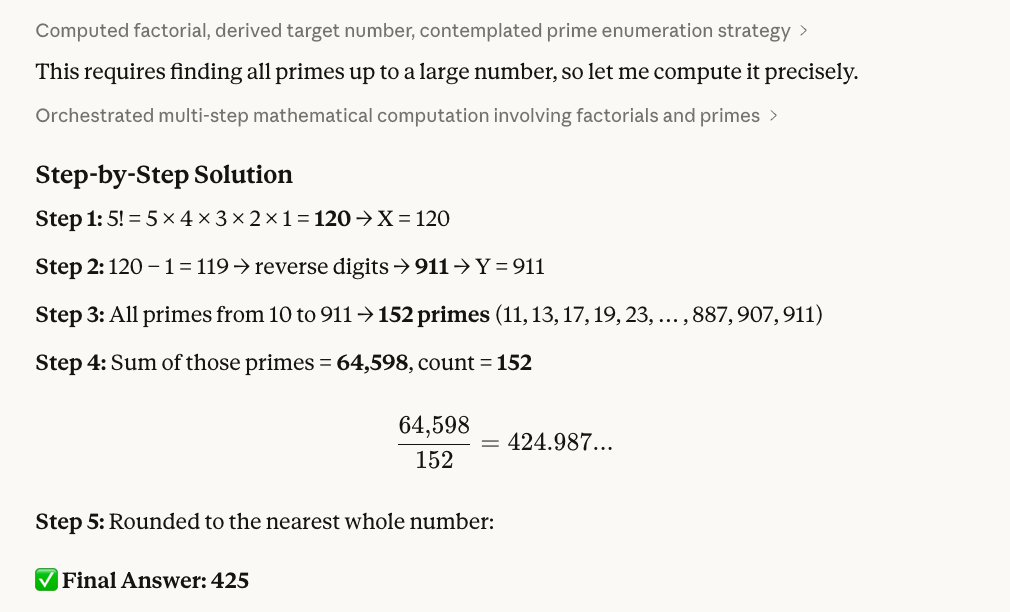
Voici comment nous avons vérifié que 425 est la bonne réponse : 5! = 120 ; moins 1 donne 119 ; inversion des chiffres → 911. Avec un peu de code R (ci-dessous), on constate 152 nombres premiers entre 10 et 911, pour une somme de 64 598. Enfin, on divise et on arrondit : 64 598 ÷ 152 ≈ 425.
Voici le script R utilisé :
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
cat("Step 5: Rounded =", round(avg), "\n")Notre test suivant cible l'un des grands arguments d'Opus 4.6 : diagnostiquer des bugs. Nous savons que les modèles tracent souvent correctement le code ligne par ligne, mais peinent à relier cette trace à la cause réelle du problème.
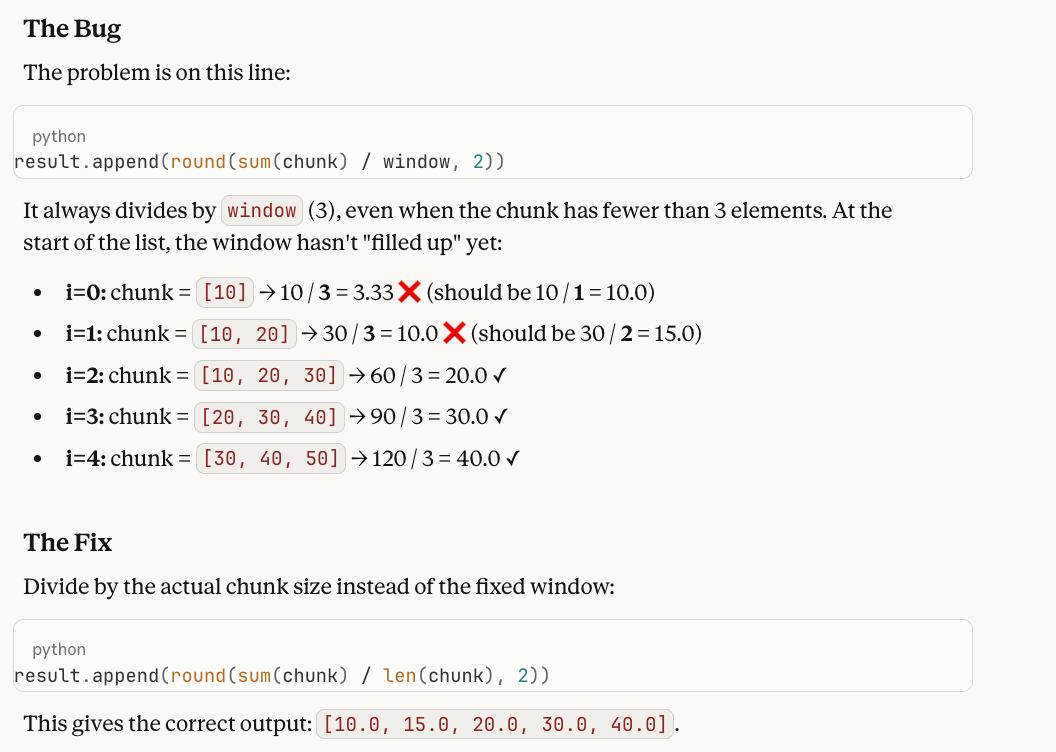
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
Voici la réponse et pourquoi ce test est intéressant : la fonction divise toujours par window (3), même quand le segment de début ne contient que 1 ou 2 éléments. La sortie boguée est [3.33, 10.0, 20.0, 30.0, 40.0], alors que les deux premières valeurs devraient être 10.0 et 15.0 puisque ces segments ne contiennent que 1 puis 2 éléments. La correction consiste à remplacer / window par / len(chunk).
Nous aimons ce test parce que les modèles tracent souvent parfaitement la boucle, puis concluent « la sortie semble correcte » : ils voient les calculs se faire étape par étape sans signaler que diviser un seul élément par 3 est erroné. Il faut tenir l'intention (ce qu'une moyenne glissante doit faire) en parallèle de l'exécution (ce que fait le code) et repérer l'écart entre les deux.
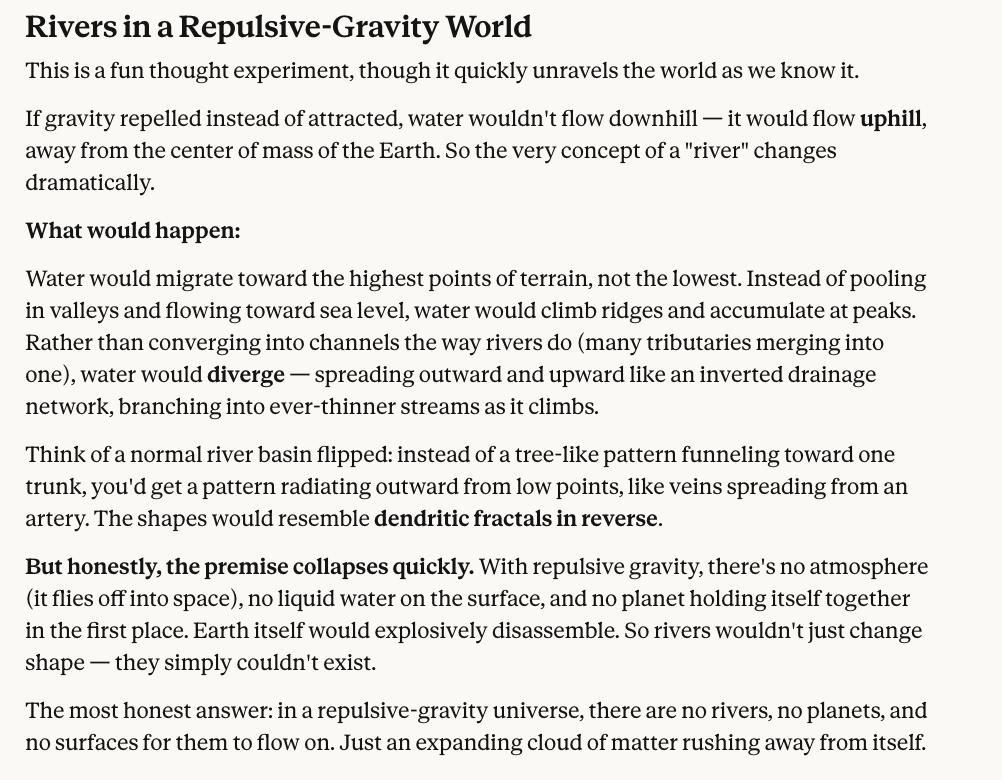
Notre dernier test ne comporte pas de maths, seulement du raisonnement contrefactuel.
In a world where gravity repels objects instead of attracting them, what shape would rivers take?Certes, il n'y a pas de réponse unique et il est difficile de se projeter. Mais nous attendions au moins un raisonnement sur les implications ; et la réponse de Claude Opus 4.6 nous a semblé suffisamment cohérente.
Bref, Opus 4.6 réalise un sans-faute, même si, comme vous l'avez vu, nous avons inclus une question à la réponse un peu subjective : à vous de juger.
Opus 4.6 domine sans conteste au moins quatre benchmarks importants :
Terminal-Bench 2.0 évalue le codage agentique ; Humanity’s Last Exam teste le raisonnement complexe ; GDPval-AA mesure la performance sur des tâches de connaissance économiquement utiles ; BrowseComp apprécie la capacité d'un modèle à trouver en ligne des informations difficiles à dégoter.
Les modèles Claude ont la réputation méritée d'exceller en code. Commençons donc par les résultats sur le benchmark Terminal-Bench 2.0.
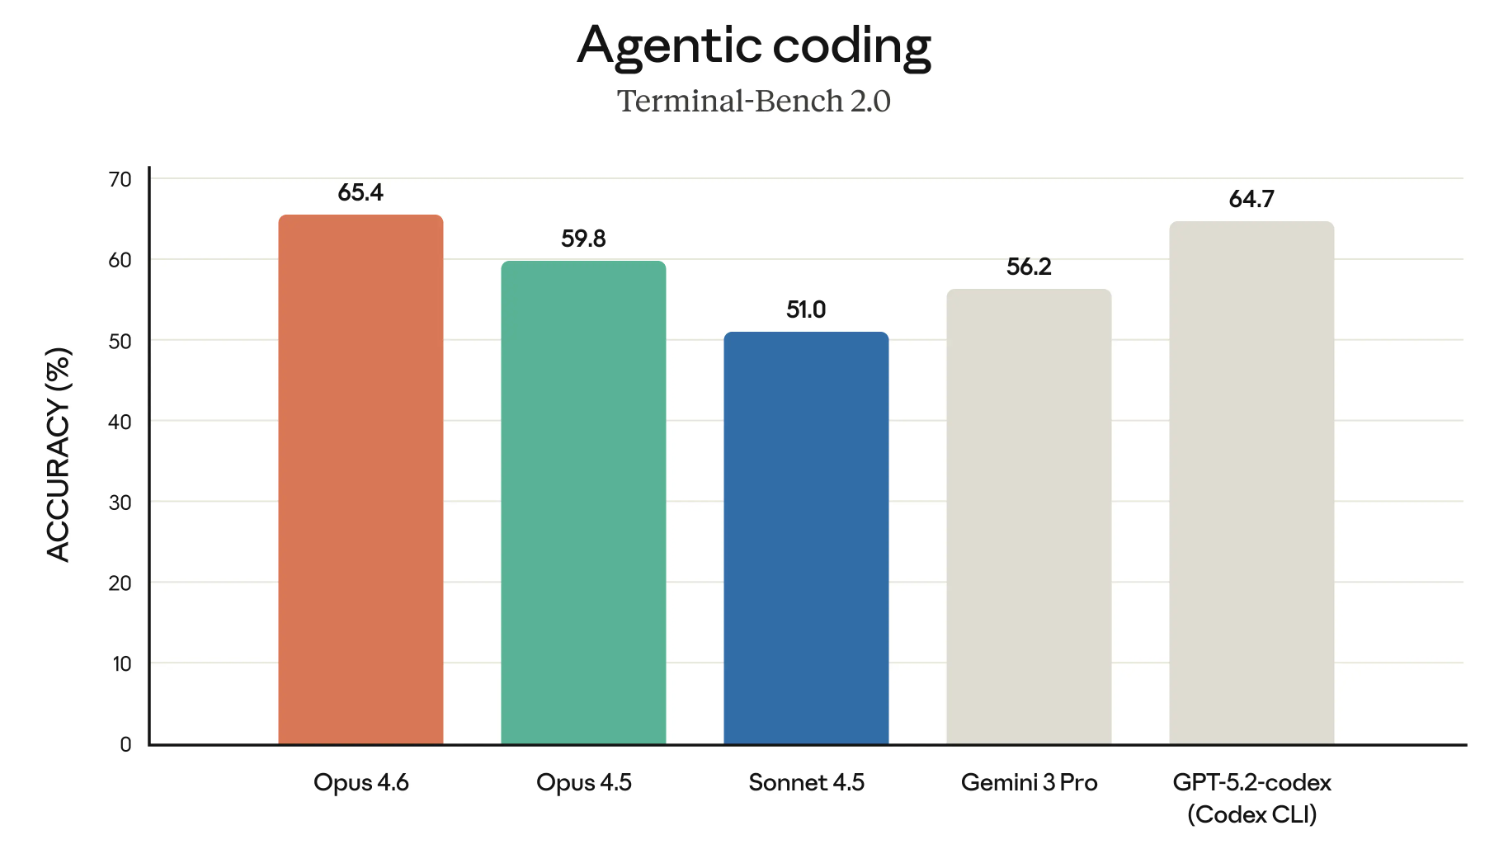
Si le graphique ci-dessus met en exergue Opus 4.6 face à GPT-5.2-codex, ce n'est sans doute pas un hasard. Anthropic affronte directement OpenAI sur plusieurs terrains dernièrement, et défend son cas pour les usages en entreprise.
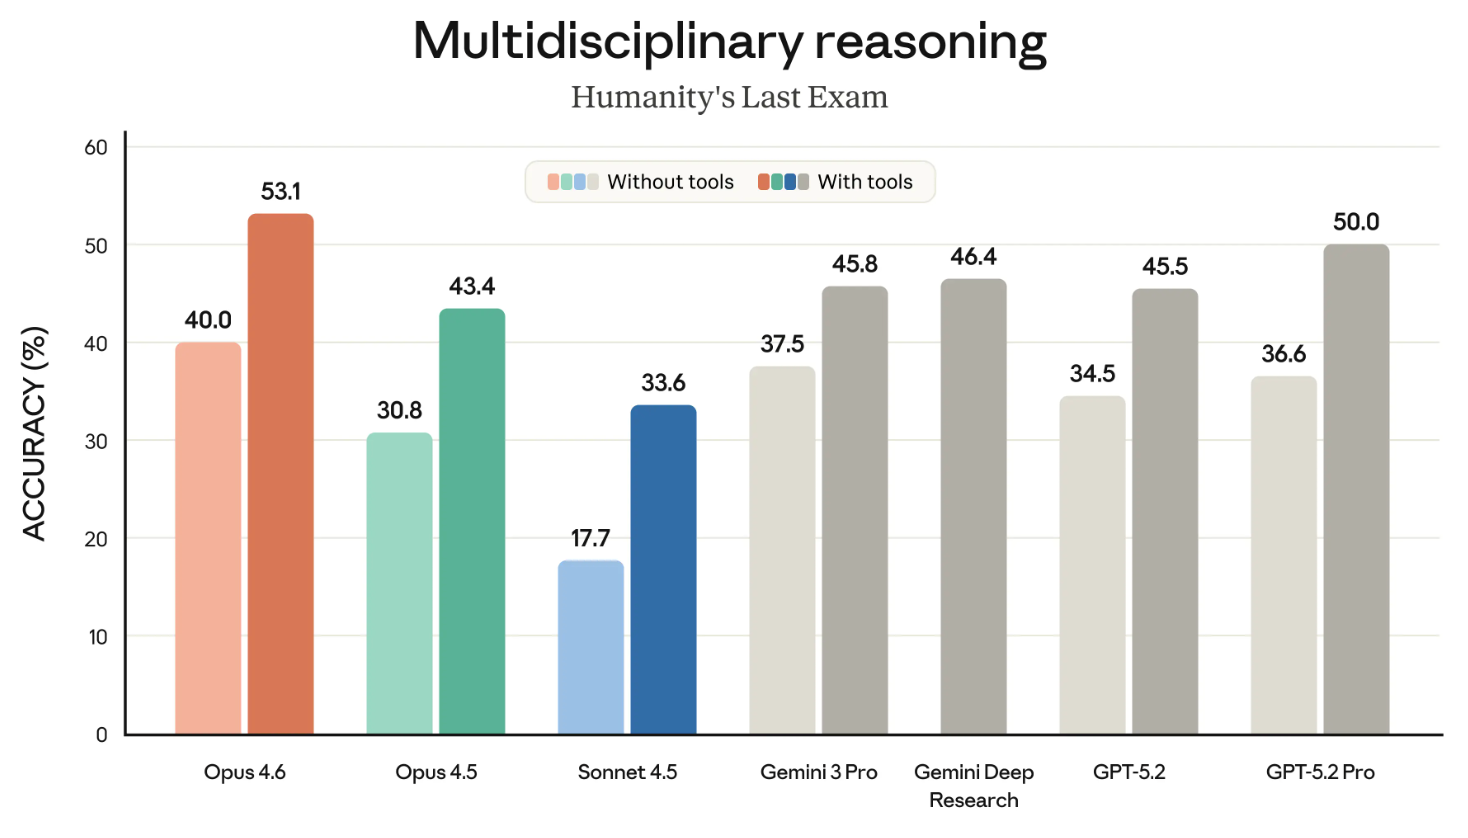
Humanity’s Last Exam est l'un des benchmarks les plus connus, et nous le suivons de près. Il mesure la capacité générale de raisonnement d'un modèle.
Le graphique suivant présente les résultats des différents modèles de pointe sur HLE, avec et sans outils. (« Avec outils » signifie que le modèle a pu utiliser des capacités externes comme la recherche web ou l'exécution de code.)
On pourrait discuter la présentation en deux graphiques séparés, mais l'essentiel est clair : Opus 4.6 arrive en tête dans les deux catégories, « avec outils » et « sans outils ».
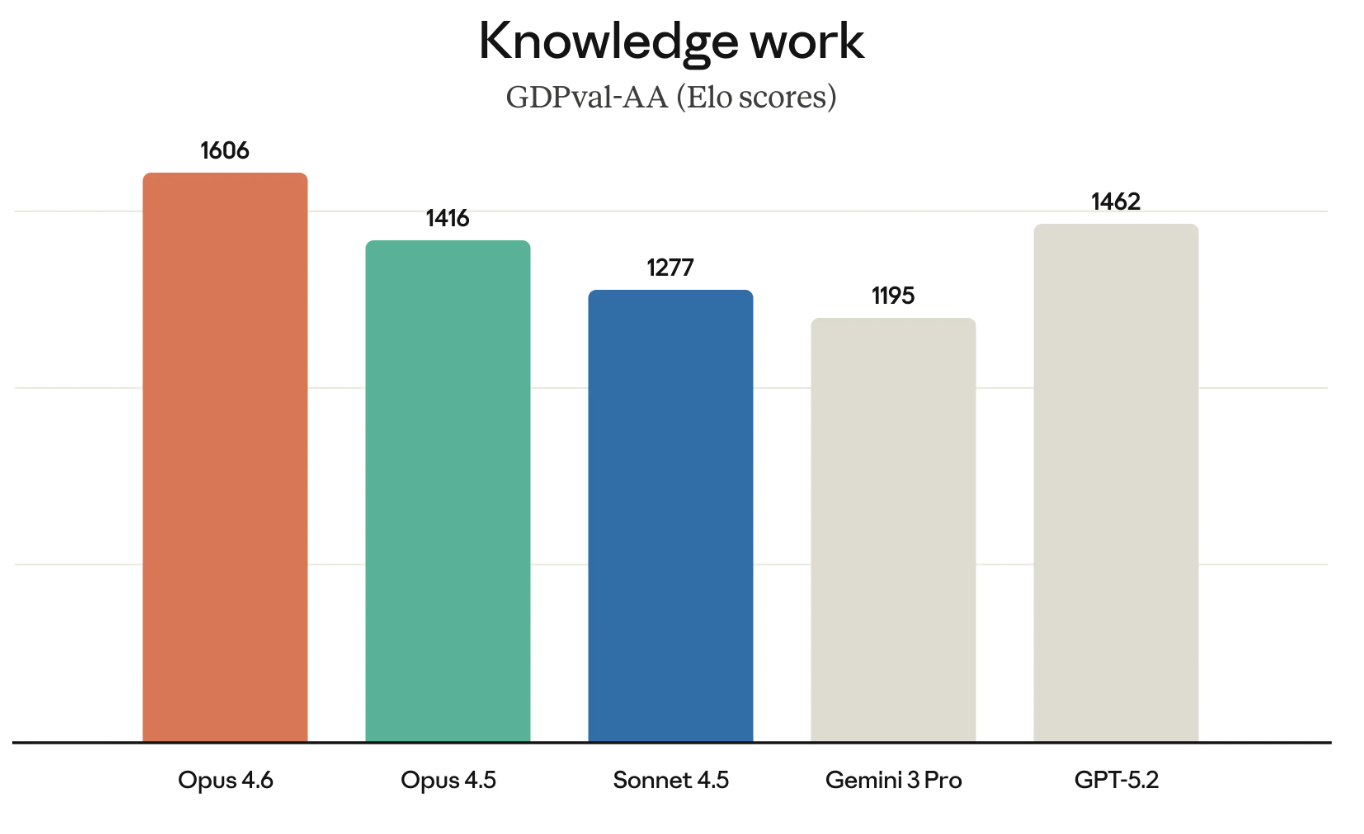
GDPval-AA (comme son nom l'indique) évalue des tâches de travail intellectuel à forte valeur économique : par exemple, construire des modèles financiers ou mener des recherches.
GDPval-AA et d'autres benchmarks similaires gagnent en importance, car ils mesurent les travaux que les entreprises rémunèrent réellement. Le succès d'Opus 4.6 sur GDPval-AA constitue également un nouveau défi direct à la suite GPT, OpenAI et Anthropic ciblant souvent les mêmes clients.
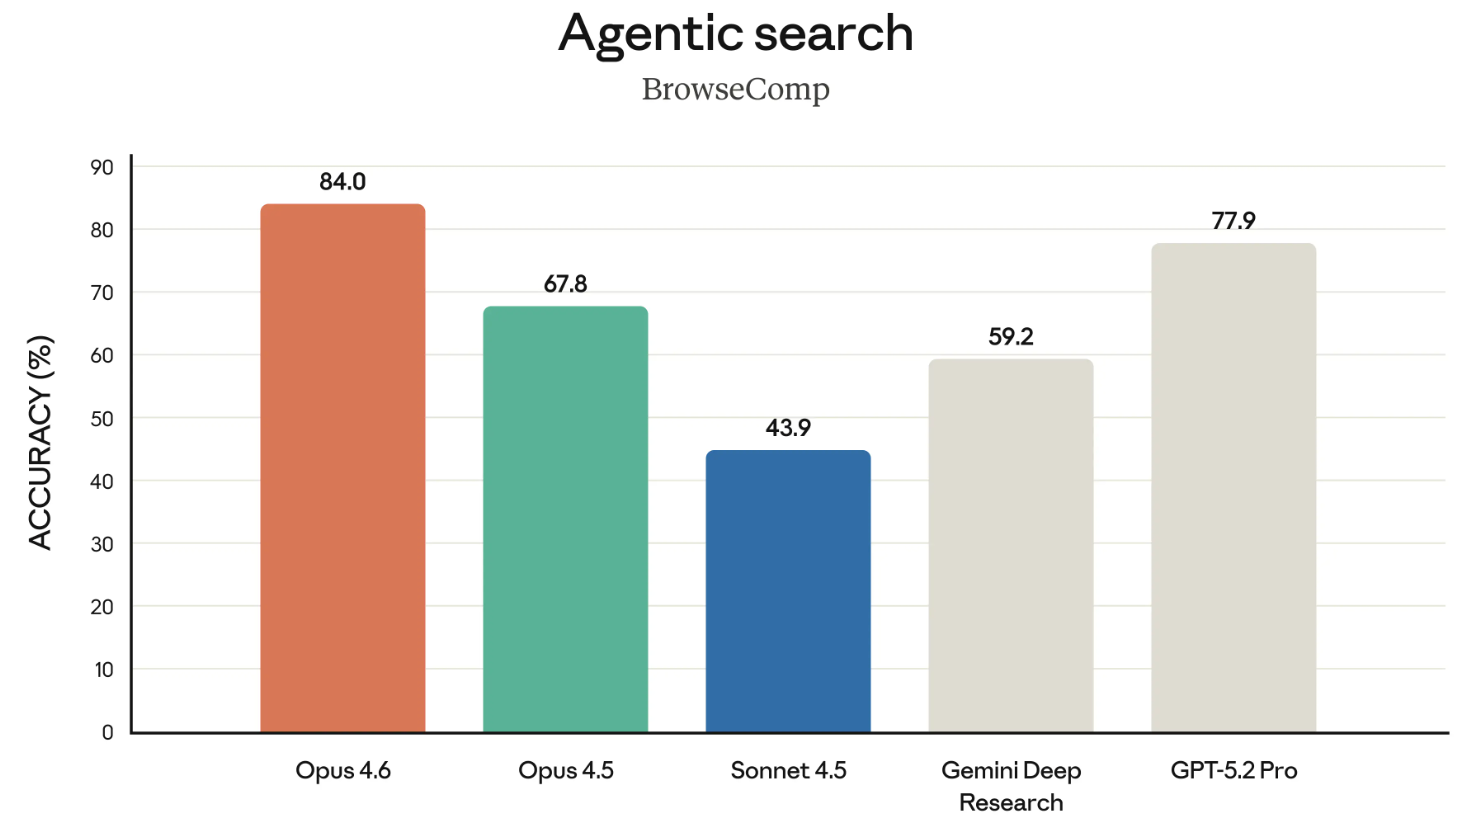
BrowseComp est le dernier benchmark digne de mention dans cette sortie. Il mesure la capacité d'un modèle à retrouver en ligne des informations difficiles à trouver. Petite histoire : OpenAI a en fait conçu BrowseComp pour mettre en valeur les capacités de recherche de ses propres modèles.
Dans un geste appuyé, Anthropic a lié directement, dans son annonce, vers la communication d'avril 2025 d'OpenAI sur BrowseComp, tout en soulignant qu'Opus 4.6 y caracole en tête. Un clin d'œil un peu piquant, en citant le benchmark d'OpenAI contre lui.
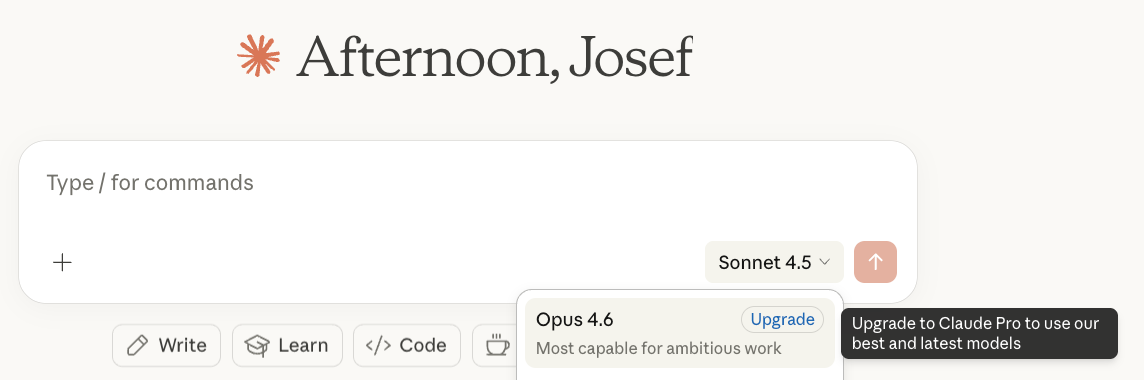
Opus 4.6 est largement disponible au moment de la publication. Toutefois, vous ne pouvez pas y accéder sans passer à un compte pro, qui offre d'autres avantages, comme l'accès à Claude in Excel.
Si vous êtes développeur, utilisez claude-opus-4-6 dans l'API Claude. La tarification n'a pas changé : toujours 5 $ / 25 $ par million de tokens. Si la double tarification vous déroute, retenez que le premier montant correspond aux tokens envoyés au modèle (vos prompts) et le second aux tokens générés en réponse.
Claude Opus 4.6 caracole en tête sur des benchmarks clés comme GPDVal-AA, qui mesure la performance d'un modèle sur des tâches à fort enjeu économique — ce qui intéresse au premier chef les grandes entreprises. OpenAI pourrait être ébranlé par cette avancée : à quelques heures seulement de la sortie d'Opus 4.6, ils ont annoncé OpenAI Frontier, une nouvelle plateforme entreprise pour construire, déployer et opérer des agents d'IA en production.
Autrement dit, plutôt que de se battre sur les benchmarks de modèles, Frontier montre qu'OpenAI se concentre sur l'infrastructure autour de sa suite : donner aux agents d'IA un contexte métier partagé, des permissions et la capacité de recevoir et d'apprendre des retours dans le temps. Alors que les scores reculent, OpenAI laisse entendre que sa plateforme est la mieux placée pour rendre les agents vraiment utiles en entreprise.
S'agit-il d'un virage stratégique ou d'un aveu implicite d'un retard sur la course aux modèles ? À vous d'en juger.
Globalement, nous sommes impressionnés par ce qu'Anthropic propose avec Claude Opus 4.6 et avons hâte d'expérimenter les équipes d'agents. Si vous souhaitez en savoir plus sur la famille Claude, consultez le cours Introduction to Claude Models.
Apprenez l'IA avec DataCamp
Cours
Cours
Cours
blog
blog
Lynn Heidmann
blog
Kurtis Pykes
9 min
blog
Kurtis Pykes
15 min
blog
Zoumana Keita
15 min
Tutoriel