Curso
Programación asistida por IA para desarrolladores
1 h 30 min
10.5K
Unsloth Studio ha recibido una gran actualización con Unsloth Desktop, que te permite ejecutar todo en local como una aplicación de escritorio. Es especialmente útil si no quieres perder tiempo instalando paquetes, configurando distintas herramientas o ejecutando comandos constantemente en la terminal.
Unsloth Desktop es, básicamente, una solución todo en uno para flujos de trabajo de IA en local. Puedes ejecutar y afinar LLMs, probar modelos de visión, generar imágenes y vídeos, entrenar modelos de imagen, trabajar con audio, usar herramientas de programación con IA, gestionar modelos y exponer una API local, todo desde la misma aplicación.
En esta guía, instalaremos Unsloth Desktop en Linux, ejecutaremos LLMs en local, lo conectaremos con OpenCode y usaremos un modelo local para crear un proyecto en Python. También exploraremos otras funciones y veremos hasta dónde puedes llegar en local con una sola aplicación.
Antes de instalar Unsloth Desktop, conviene comprobar rápidamente que tu GPU de NVIDIA se detecta y que CUDA funciona correctamente. Así evitarás problemas más adelante cuando empieces a ejecutar o afinar modelos en local.
Primero, abre la terminal y ejecuta:
nvidia-smi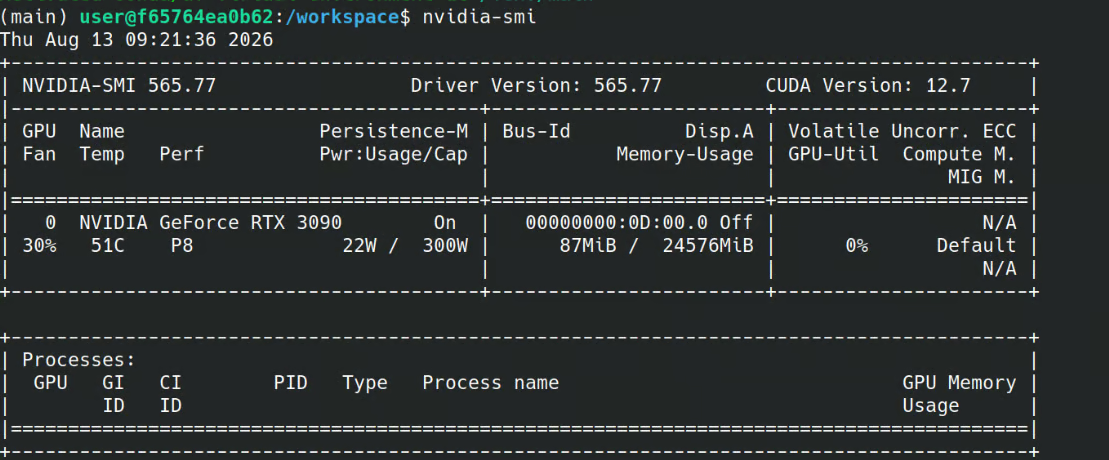
Debería mostrar tu GPU de NVIDIA, la versión del controlador, la memoria disponible de la GPU y la información de compatibilidad con CUDA.
A continuación, comprueba el compilador de CUDA instalado en tu sistema:
nvcc --versionDeberías ver una salida similar a esta:
nvcc: NVIDIA (R) Cuda compiler driver
Copyright (c) 2005-2025 NVIDIA Corporation
Built on Tue_May_27_02:21:03_PDT_2025
Cuda compilation tools, release 12.9, V12.9.86
Build cuda_12.9.r12.9/compiler.36037853_0
Si ambos comandos funcionan y tu GPU se detecta correctamente, tu sistema está listo para Unsloth Desktop.
Después, ve a la página oficial de Unsloth y descarga Unsloth Desktop. Asegúrate de elegir el paquete correcto para tu sistema operativo.
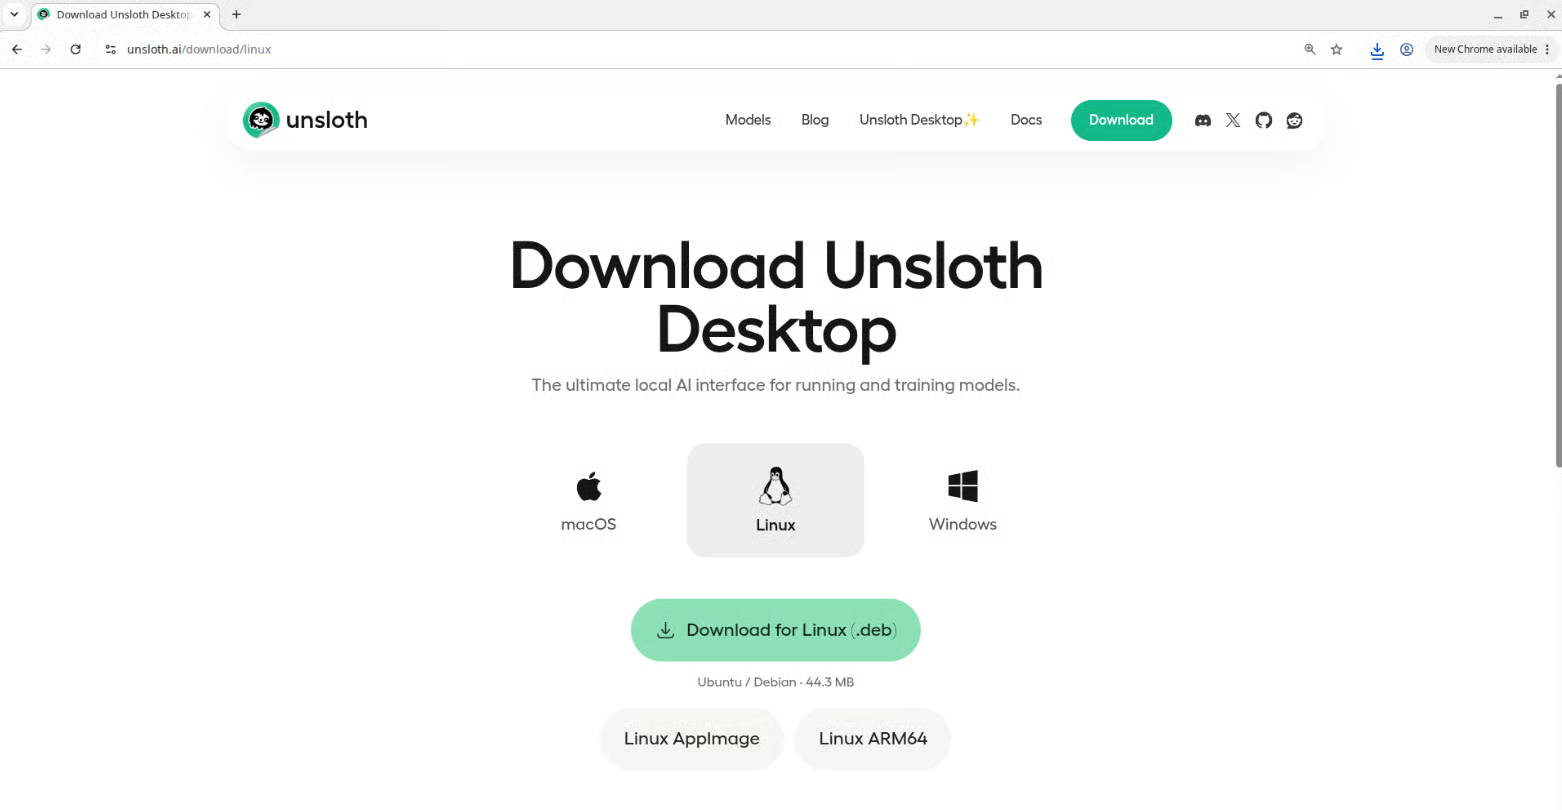
Fuente: Descargar Unsloth Desktop para Linux
Cuando termine la descarga, instala el paquete como cualquier otra aplicación de escritorio. En Linux, según tu distribución, puede ser un paquete .deb.
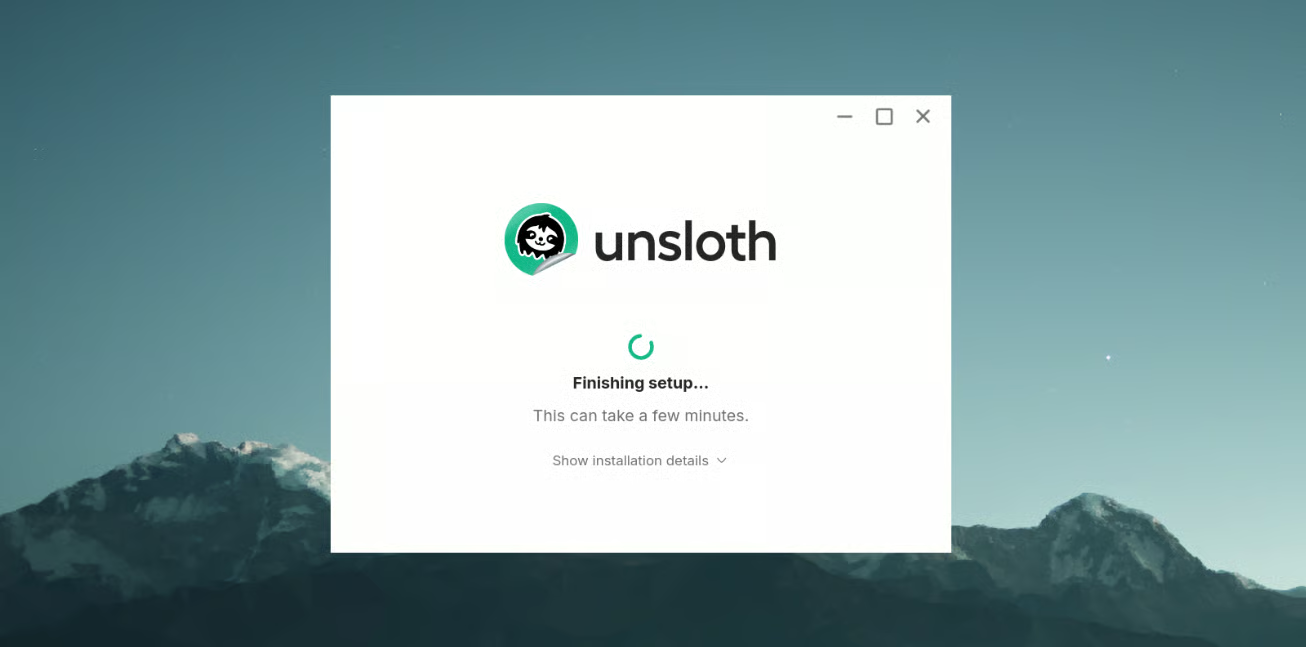
Una vez finalizada la instalación, inicia Unsloth Desktop. La aplicación debería detectar automáticamente tu hardware disponible y darte acceso a la interfaz principal.
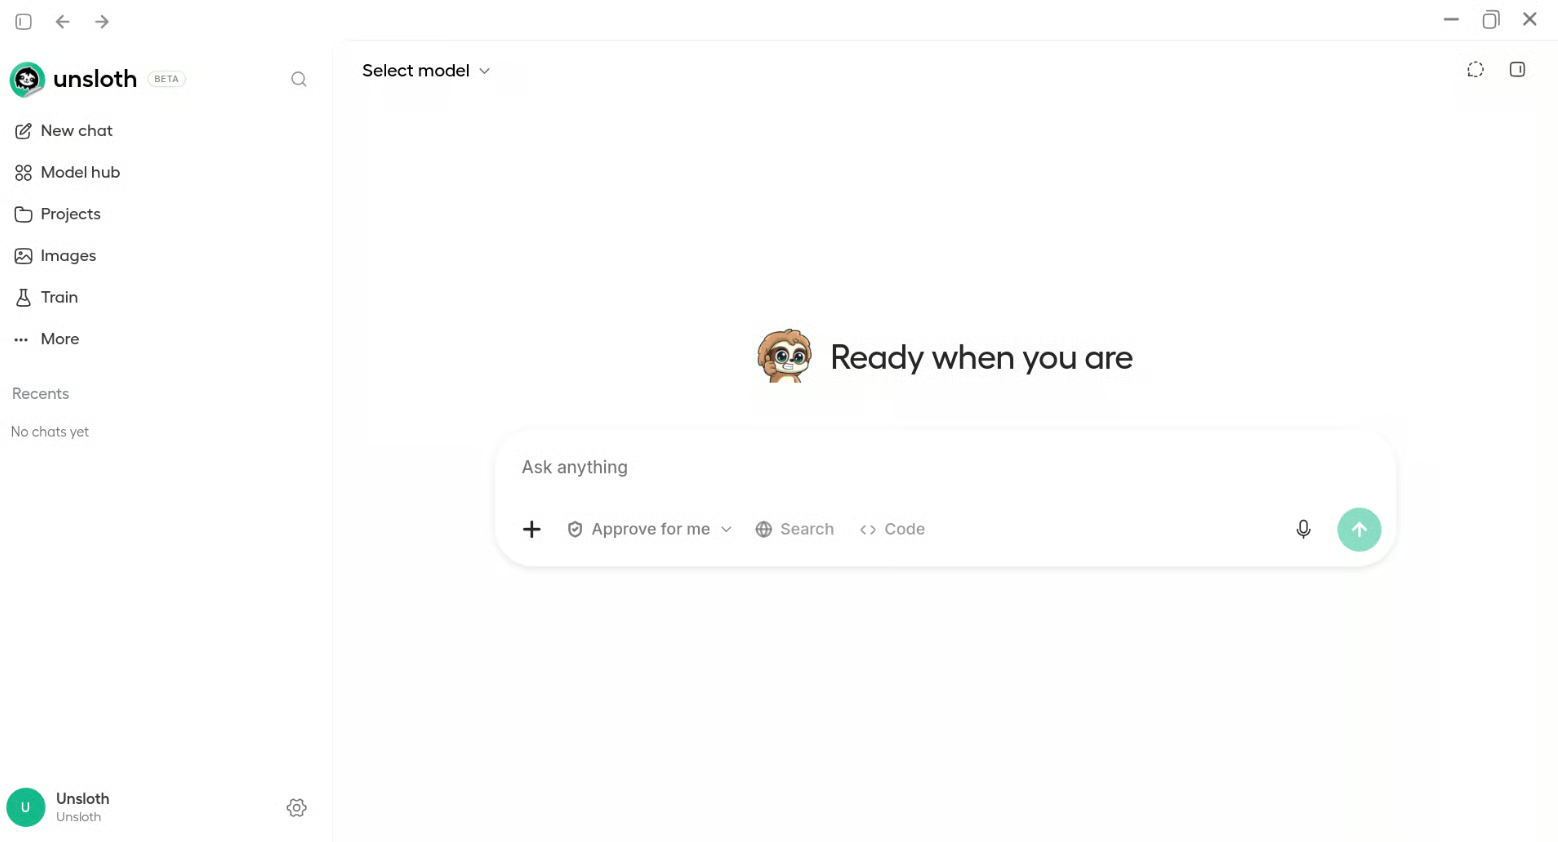
Desde aquí, puedes explorar y descargar modelos, ejecutar LLMs en local, afinar modelos, trabajar con imágenes y otras modalidades, gestionar tus modelos locales y acceder a las demás herramientas disponibles en Unsloth Desktop.
Abre el Model hub en Unsloth Desktop y busca el modelo que quieras ejecutar. Para esta prueba, utilicé uno de mis modelos pequeños favoritos:
empero-ai/Qwythos-9B-Claude-Mythos-5-1M-GGUF · Hugging Face
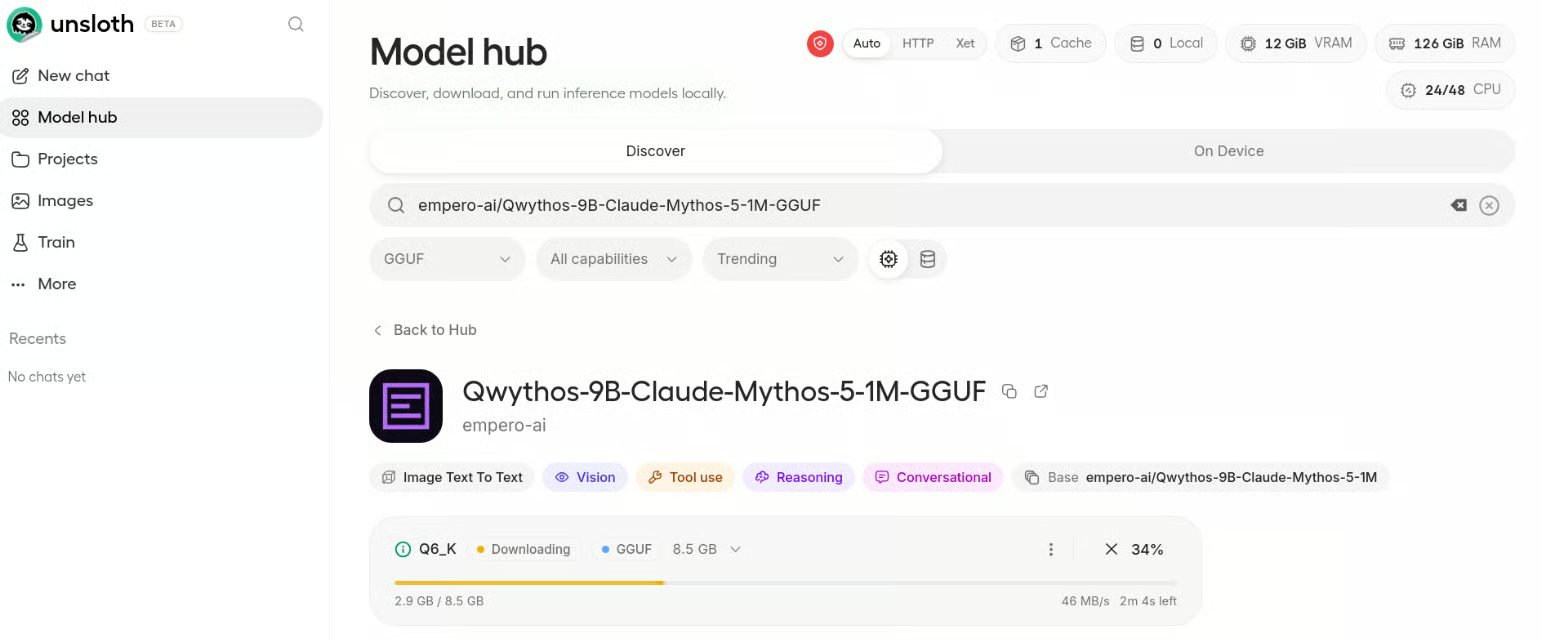
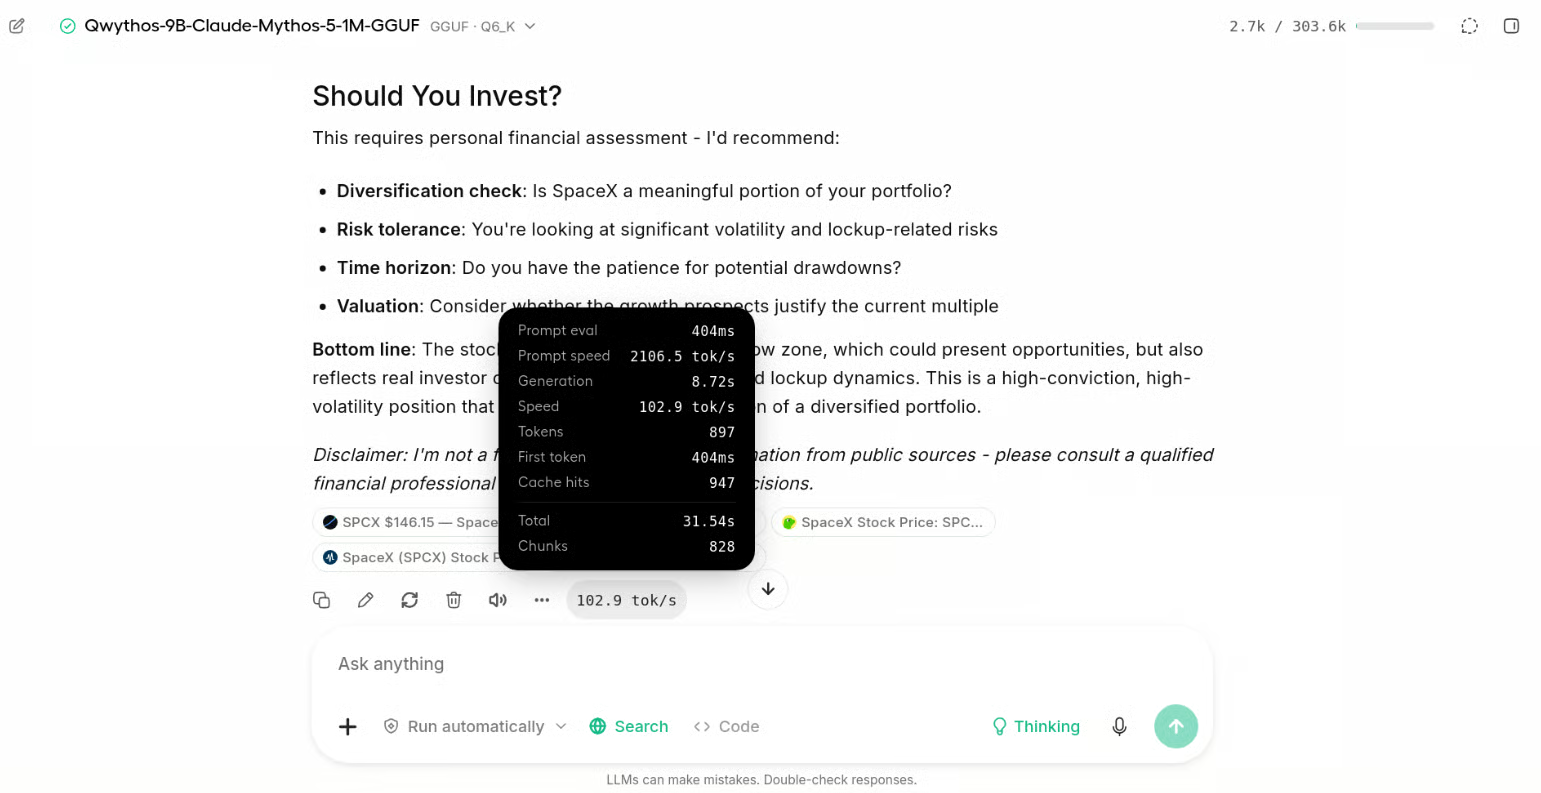
Tras descargar el modelo, puedes cargarlo y empezar a chatear con él directamente en Unsloth Desktop. En mi equipo, obtenía una media de 102 tokens por segundo, que subían hasta alrededor de 125 tokens por segundo en algunas consultas de programación.
También activé el acceso web y le hice preguntas sobre las últimas noticias del mercado bursátil. Esto hace que la experiencia de chat local sea mucho más útil cuando necesitas información más allá de lo que ya contiene el modelo.
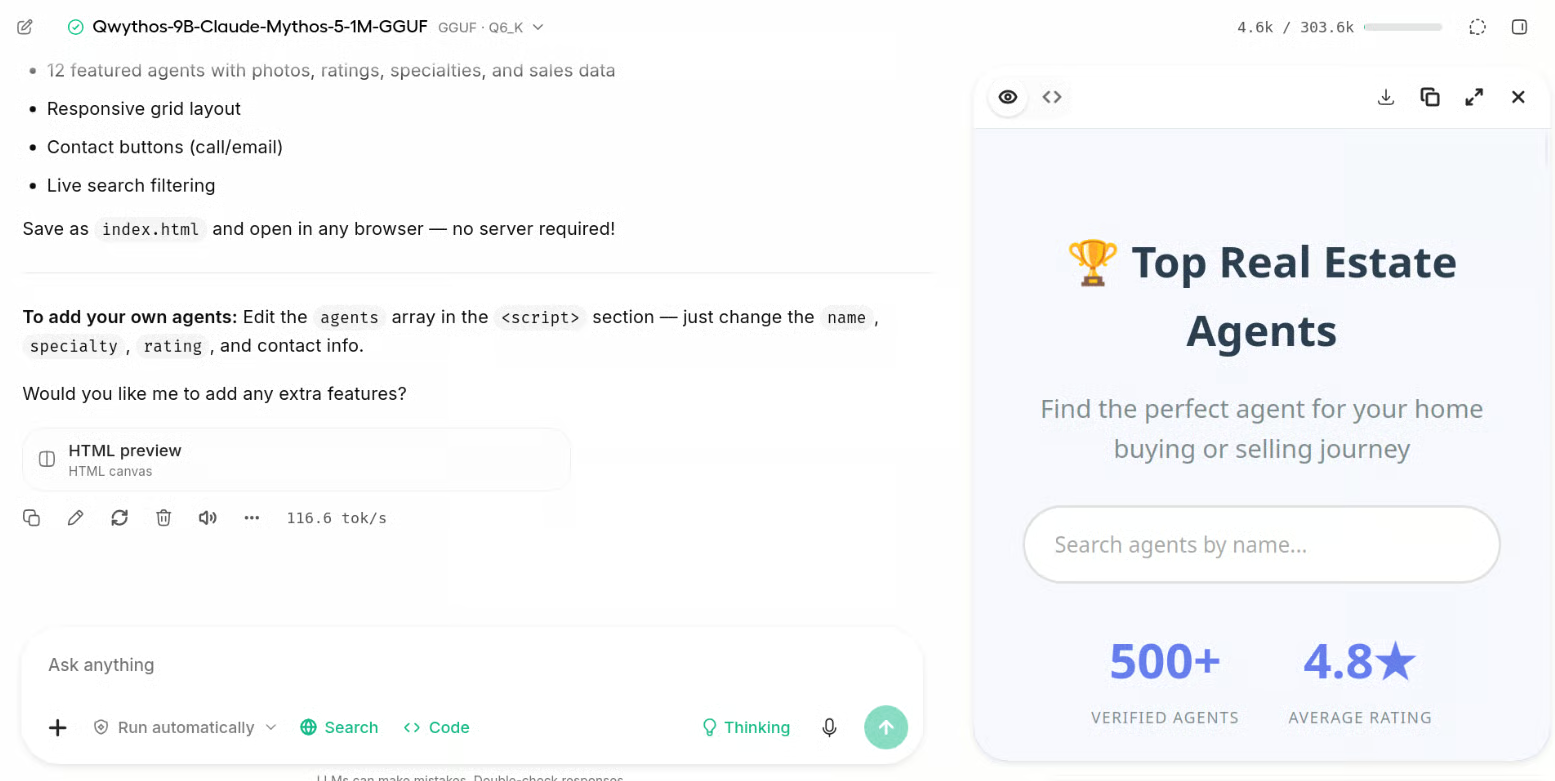
Luego quise ver si podía construir algo, no solo responder preguntas. Le pedí que creara una web y generó el código y mostró la web junto al chat, facilitando ver el resultado mientras seguía haciendo cambios.
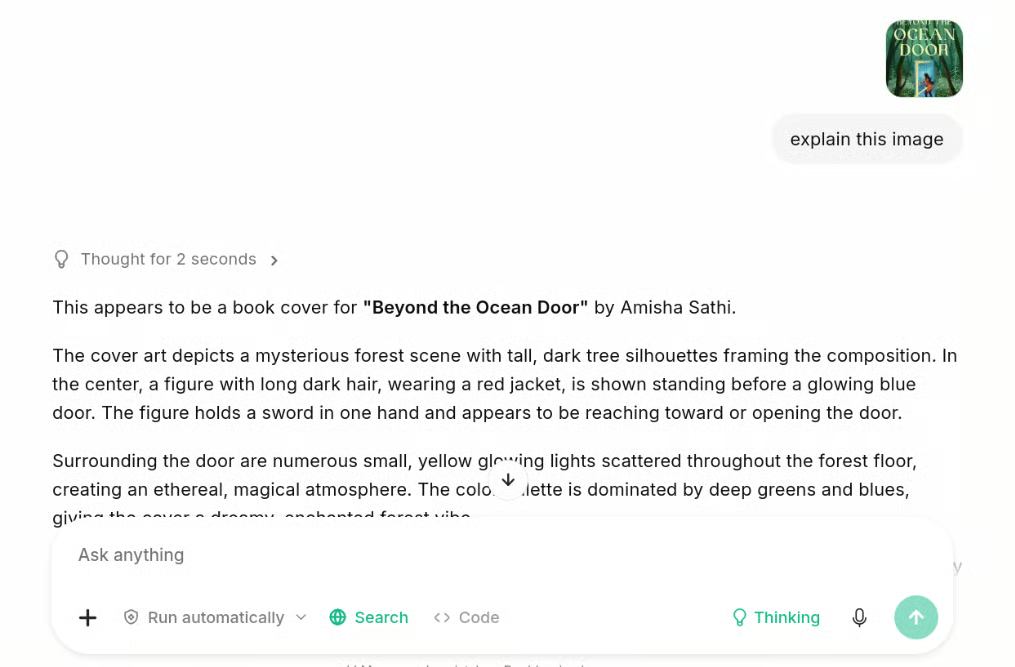
Unsloth Desktop también admite modelos visión-lenguaje, así que puedes subir una imagen directamente al chat y hacer preguntas sobre ella.
En mi prueba, el codificador de visión necesario se instaló automáticamente al descargar el modelo. Simplemente subí una imagen, hice una pregunta sobre ella y, en segundos, el modelo devolvió una respuesta muy precisa.
El soporte de visión es especialmente útil al trabajar con agentes de programación. Por ejemplo, puedes subir una captura de pantalla de una web y señalar un problema que quieras solucionar, mostrar al agente un diseño que quieras replicar o usar una interfaz existente como referencia visual mientras construyes tu propia aplicación.
Los modelos pequeños van genial para pruebas e incluso algo de programación con agentes. Pero si quieres un agente de código local serio que pueda manejar proyectos más grandes, necesitarás un modelo más potente que aun así quepa en la VRAM de tu GPU.
En mi caso, uso una RTX 3090 con 24 GB de VRAM, así que descargué la versión Q4 de Muse Glimmer 30B.
Abre la pestaña Models en Unsloth Desktop, busca el modelo y descarga la versión UD-Q4_K_XL. En unos minutos, el modelo debería estar descargado y cargado en tu sistema.
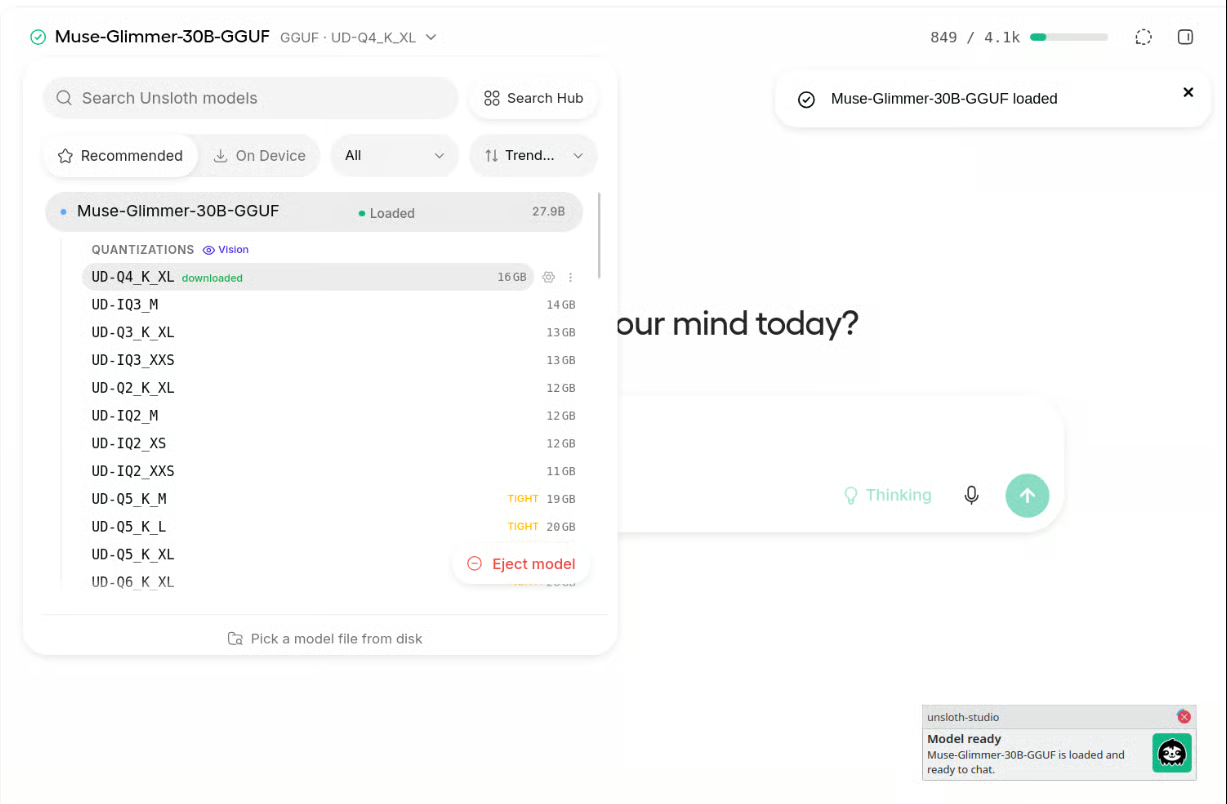
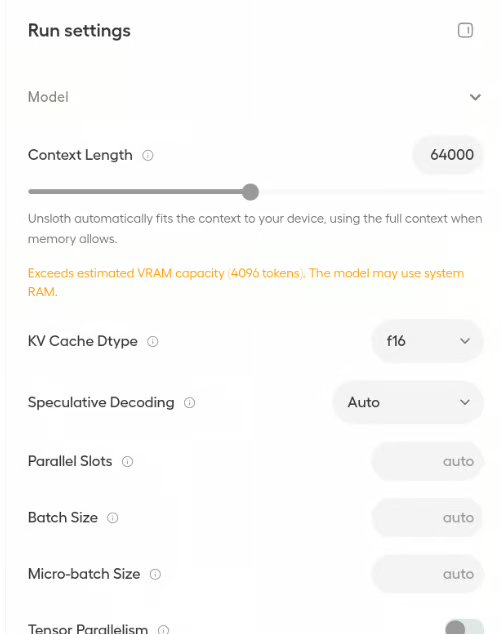
Por defecto, la ventana de contexto estaba en torno a 4K, demasiado pequeña para un agente de código que trabaja con varios archivos. Abre el panel derecho en Unsloth Desktop, cambia la longitud de contexto a 64K, baja y recarga el modelo.
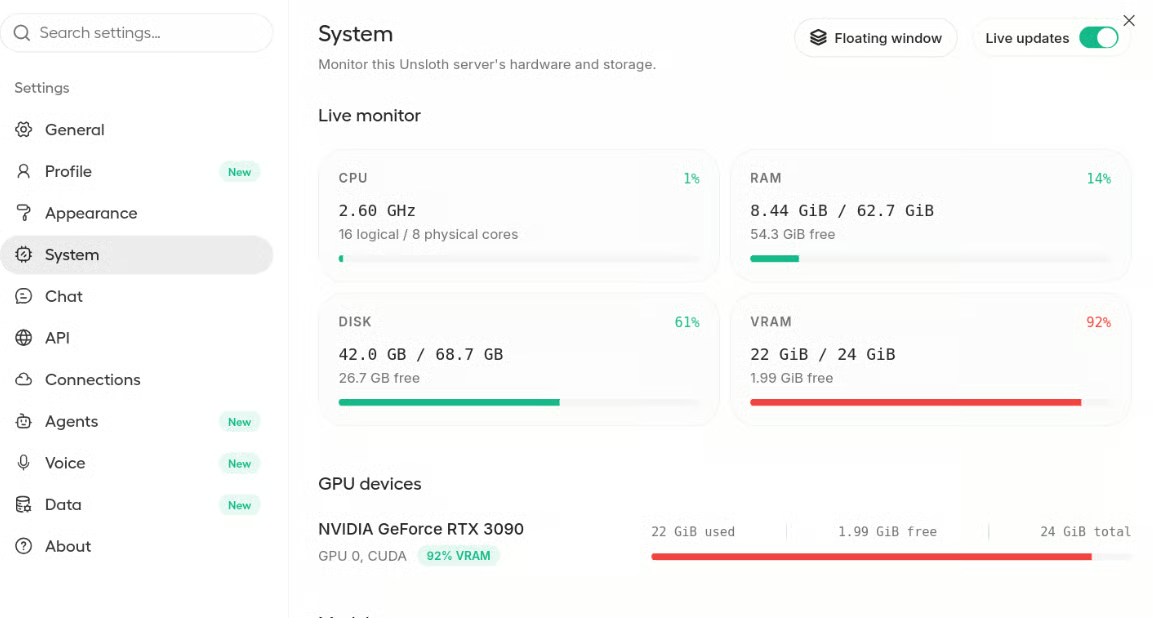
Cuando el modelo se recargue, ve a Settings → System para comprobar el uso de memoria de la GPU. En mi caso, el modelo usaba unos 22 GB de VRAM, dejando aproximadamente 2 GB disponibles para la caché KV. Fue suficiente para mis pruebas, aunque la memoria disponible dependerá de tu GPU y de la carga de trabajo.
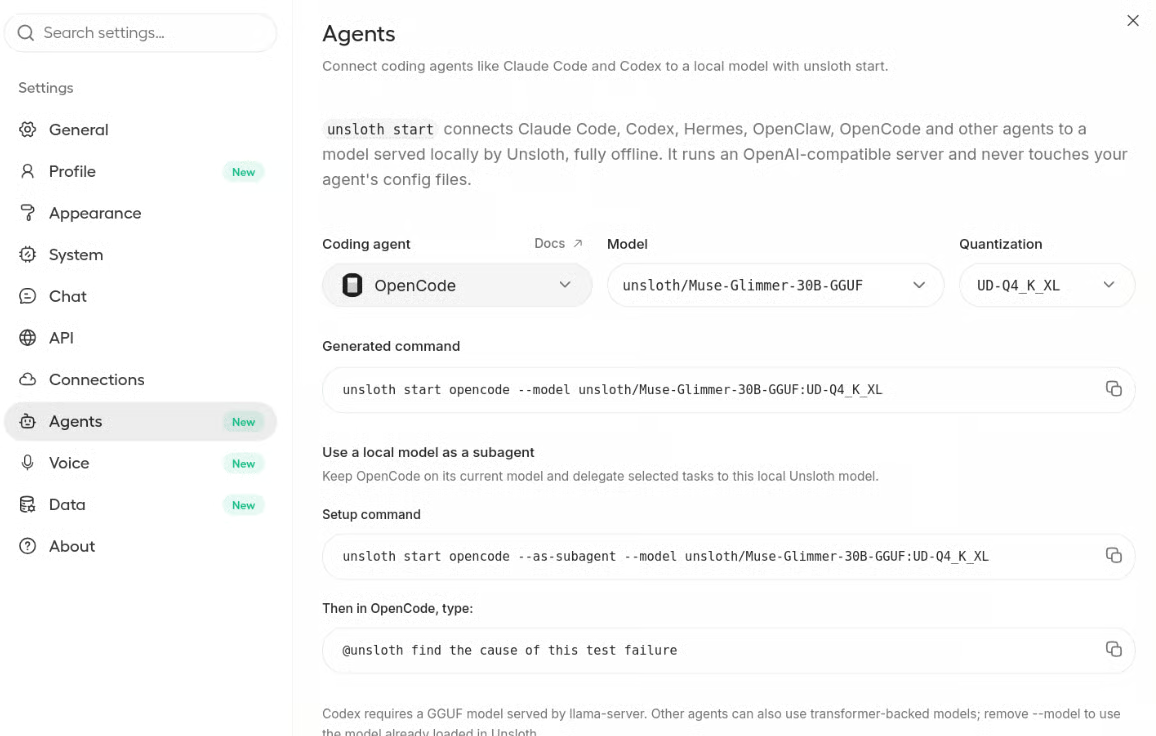
Después, abre Settings → Agents y selecciona OpenCode como agente de código. Unsloth Desktop generará automáticamente el comando que necesitas para lanzarlo.
Primero, crea un directorio de proyecto usando la terminal:
mkdir unsloth-project
cd unsloth-project
Luego, lanza OpenCode:
unsloth start opencode \
  --model unsloth/Muse-Glimmer-30B-GGUF:UD-Q4_K_XL \
  --context-length 64000
Asegúrate de incluir la longitud de contexto en el comando. Si no, OpenCode puede iniciarse con la ventana de contexto pequeña por defecto.
El comando instalará OpenCode si es necesario y luego iniciará su interfaz de terminal con tu modelo local de Unsloth listo para usar.
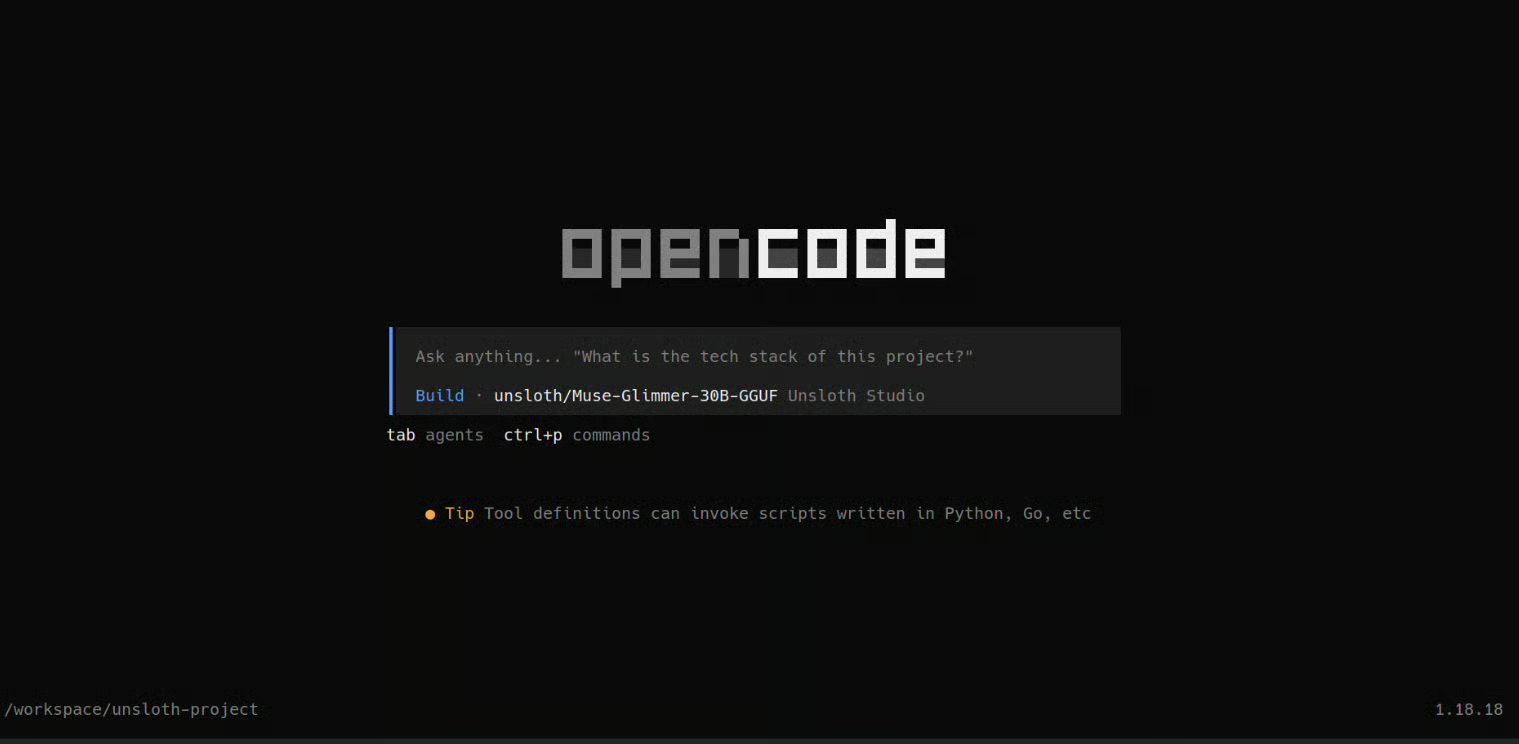
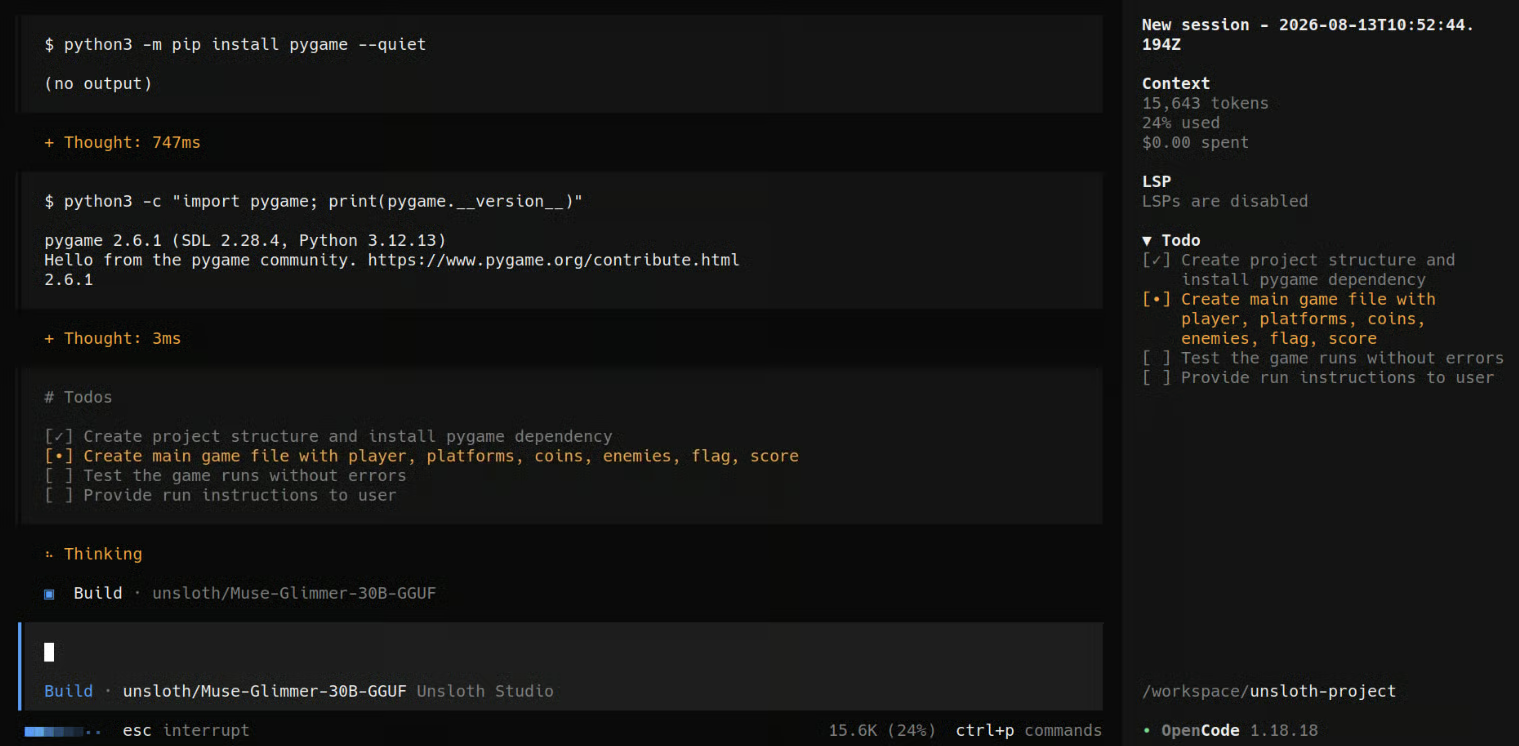
Ahora que todo está conectado, quise poner a prueba de verdad al agente de código local. En lugar de pedirle un pequeño fragmento, le pedí que construyera un juego tipo Mario en Python desde cero.
Usé este prompt:
Create a simple Mario-style 2D platform game in Python using Pygame.
Add left/right movement, jumping, platforms, coins, enemies, a score counter, and a finish flag.
Use simple built-in shapes instead of external assets. Create the files, install dependencies, test the game, and tell me how to run it.
OpenCode primero creó una lista de tareas y luego empezó a avanzar por el proyecto paso a paso. Creó los archivos, escribió la lógica del juego, gestionó las dependencias y, por último, me dio el comando para lanzarlo.
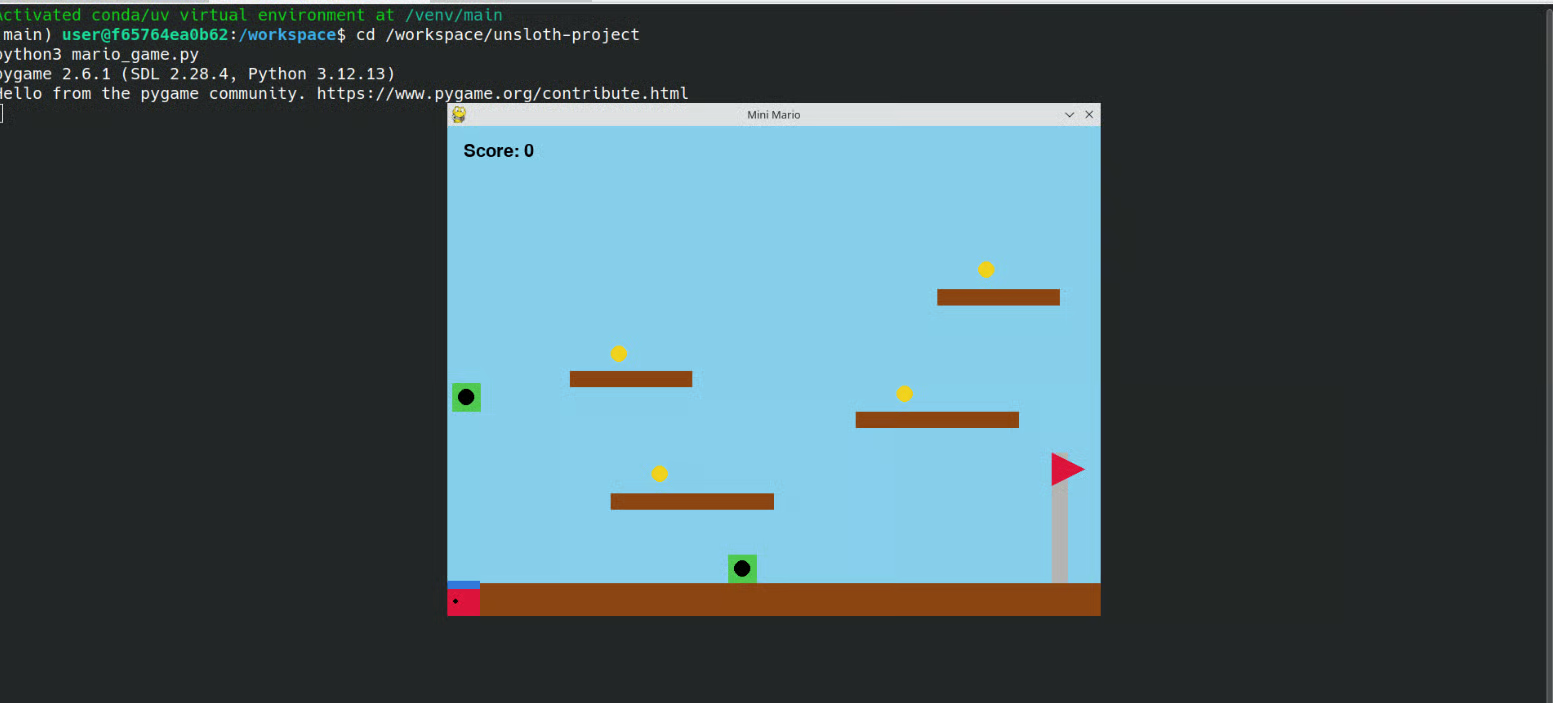
El juego final funcionó, aunque aún tenía algún bug. La versión Q4 de Muse Glimmer no rindió tan bien como esperaba para esta tarea de programación más grande, así que, si tienes suficiente VRAM, te recomiendo probar la versión Q8 para un mejor rendimiento en código.
Hasta ahora, hemos usado sobre todo Unsloth Desktop para ejecutar LLMs y agentes de código, pero puede hacer mucho más. La idea es tener la mayoría de tus flujos de trabajo de IA en local disponibles desde la misma aplicación, en lugar de montar una herramienta distinta para cada tarea.
Puedes afinar LLMs en local con métodos como LoRA y QLoRA. La interfaz de entrenamiento sin código facilita elegir el conjunto de datos, configurar los ajustes de entrenamiento, iniciar la ejecución y exportar el modelo final sin tener que montar tú toda la canalización.
Puedes descargar modelos de difusión compatibles y generar imágenes en local a partir de prompts de texto. También puedes subir una imagen existente, describir los cambios que quieres y usar los modelos compatibles para editarla.
Si quieres ir más allá de la generación de imágenes, también puedes entrenar LoRAs de imagen con tu propio conjunto de datos. Es útil para enseñar a un modelo un tema, personaje, producto o estilo visual concreto y luego usar esa LoRA en generaciones futuras.
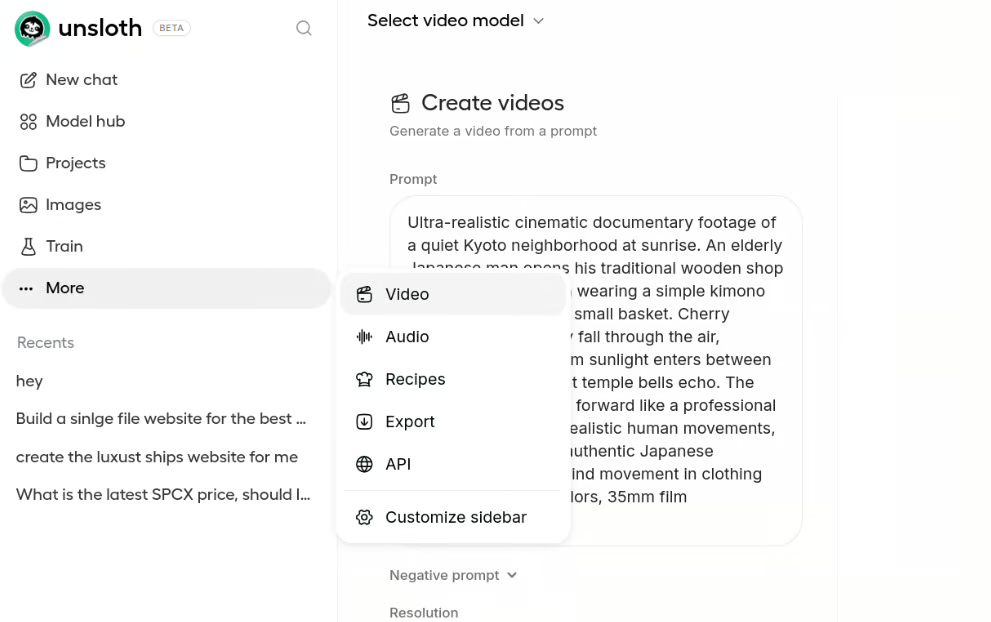
Unsloth Desktop también admite flujos de trabajo de generación de vídeo en local con modelos de difusión compatibles. Así puedes experimentar con imagen y vídeo desde la misma aplicación, sin montar un entorno aparte.
Puedes trabajar con modelos de speech-to-text, text-to-speech y otros modelos de audio compatibles. Esto te permite transcribir audio, generar voz y experimentar con distintos flujos de trabajo de audio con IA en local.
Las Data Recipes ayudan a convertir archivos como PDFs y CSVs en conjuntos de datos que puedes inspeccionar, editar y preparar para el entrenamiento. Es especialmente útil cuando tienes tus propios datos pero no quieres construir el dataset manualmente desde cero.
A medida que descargas más modelos y empiezas a entrenar los tuyos, gestionarlo todo puede volverse un caos. Unsloth Desktop te da un único lugar para gestionar modelos descargados, conjuntos de datos, adaptadores, ejecuciones de entrenamiento y otros activos locales.
Unsloth Studio admite oficialmente exportar modelos Safetensors/LoRA a GGUF y otros formatos. llama.cpp está explícitamente soportado para ejecutar modelos exportados.
Por último, Unsloth Desktop puede exponer tu modelo local mediante una API compatible con OpenAI. Así es fácil conectar tus modelos en ejecución local con otras aplicaciones, herramientas de programación o proyectos de IA sin depender de una API de modelo alojado.
Unsloth Desktop avanza en una dirección muy interesante. Tener LLMs, afinado, generación de imagen y vídeo, agentes de código, datasets y APIs locales en una sola aplicación de escritorio hace que la IA en local sea mucho más accesible, especialmente para quienes no quieren configurar cada herramienta a mano.
Dicho esto, aún se siente un poco verde en algunos bordes. En GPUs antiguas o sistemas con drivers de CUDA desactualizados, puede que tengas que resolver dependencias e instalar ciertas cosas manualmente en Linux o Windows. También me encontré con problemas en generación de imágenes, ajustes de contexto y agentes de código. Por ejemplo, si aumentas el contexto del modelo en Unsloth Desktop, puede que también tengas que establecer explícitamente la misma longitud de contexto al lanzar tu agente de código. Algunos flujos de generación de webs y estilo Canvas tampoco siempre se comportaron como esperaba.
Unsloth ha añadido un montón de funciones muy rápido, pero no todo se siente del todo estable aún. Espero que muchos de estos problemas mejoren a medida que Desktop se optimice y madure.
Por ahora, si mi objetivo principal es simplemente servir un LLM local para un agente de programación con IA u otra aplicación, sigo prefiriendo llama.cpp. Me da mucho más control sobre el modelo, el contexto, la descarga a GPU, el uso de memoria y otros ajustes de bajo nivel. Unsloth Desktop es mucho más fácil de usar, mientras que llama.cpp sigue siendo la mejor opción cuando quiero afinar la configuración y exprimir al máximo el rendimiento de mi hardware.
Los mejores cursos de DataCamp
Curso
Curso
Curso
blog
Bhavishya Pandit
8 min
blog
Abid Ali Awan
8 min
blog
Abid Ali Awan
10 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Moez Ali
12 min
Tutorial
Abid Ali Awan
12 min