Curso
Codificação com IA para Desenvolvedores
1 h 30 min
10.5K
O Unsloth Studio ganhou uma atualização importante com o Unsloth Desktop, que permite executar tudo localmente como um aplicativo para desktop. Isso é especialmente útil se você não quer perder tempo instalando pacotes, configurando ferramentas diferentes ou rodando comandos no terminal o tempo todo.
O Unsloth Desktop é basicamente uma solução tudo-em-um para fluxos de trabalho de IA locais. Você pode executar e ajustar LLMs, testar modelos de visão, gerar imagens e vídeos, treinar modelos de imagem, trabalhar com áudio, usar ferramentas de codificação com IA, gerenciar modelos e expor uma API local — tudo no mesmo aplicativo.
Neste guia, vamos instalar o Unsloth Desktop no Linux, rodar LLMs locais, conectá-lo ao OpenCode e usar um modelo local para construir um projeto em Python. Também vamos explorar outros recursos e ver até onde você consegue ir localmente usando um único aplicativo.
Antes de instalar o Unsloth Desktop, vale a pena checar rapidamente se a sua GPU NVIDIA foi detectada e se o CUDA está funcionando corretamente. Isso ajuda a evitar problemas quando você começar a rodar ou ajustar modelos localmente.
Primeiro, abra o terminal e rode:
nvidia-smi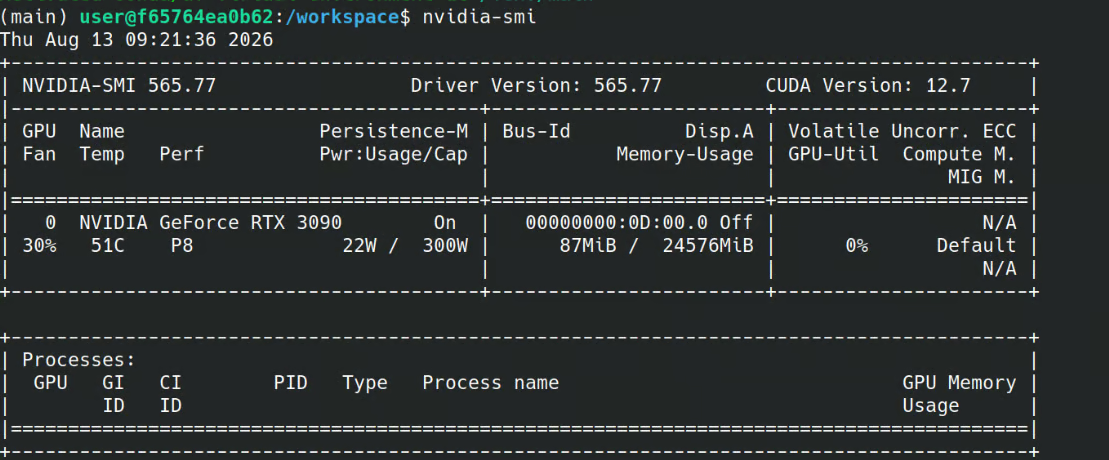
Isso deve exibir sua GPU NVIDIA, a versão do driver, a memória de GPU disponível e informações de compatibilidade do CUDA.
Em seguida, verifique o compilador CUDA instalado no seu sistema:
nvcc --versionVocê deve ver uma saída semelhante a esta:
nvcc: NVIDIA (R) Cuda compiler driver
Copyright (c) 2005-2025 NVIDIA Corporation
Built on Tue_May_27_02:21:03_PDT_2025
Cuda compilation tools, release 12.9, V12.9.86
Build cuda_12.9.r12.9/compiler.36037853_0
Se ambos os comandos funcionarem e sua GPU for detectada corretamente, seu sistema está pronto para o Unsloth Desktop.
Depois, acesse o site oficial da Unsloth e baixe o Unsloth Desktop. Certifique-se de selecionar o pacote correto para o seu sistema operacional.
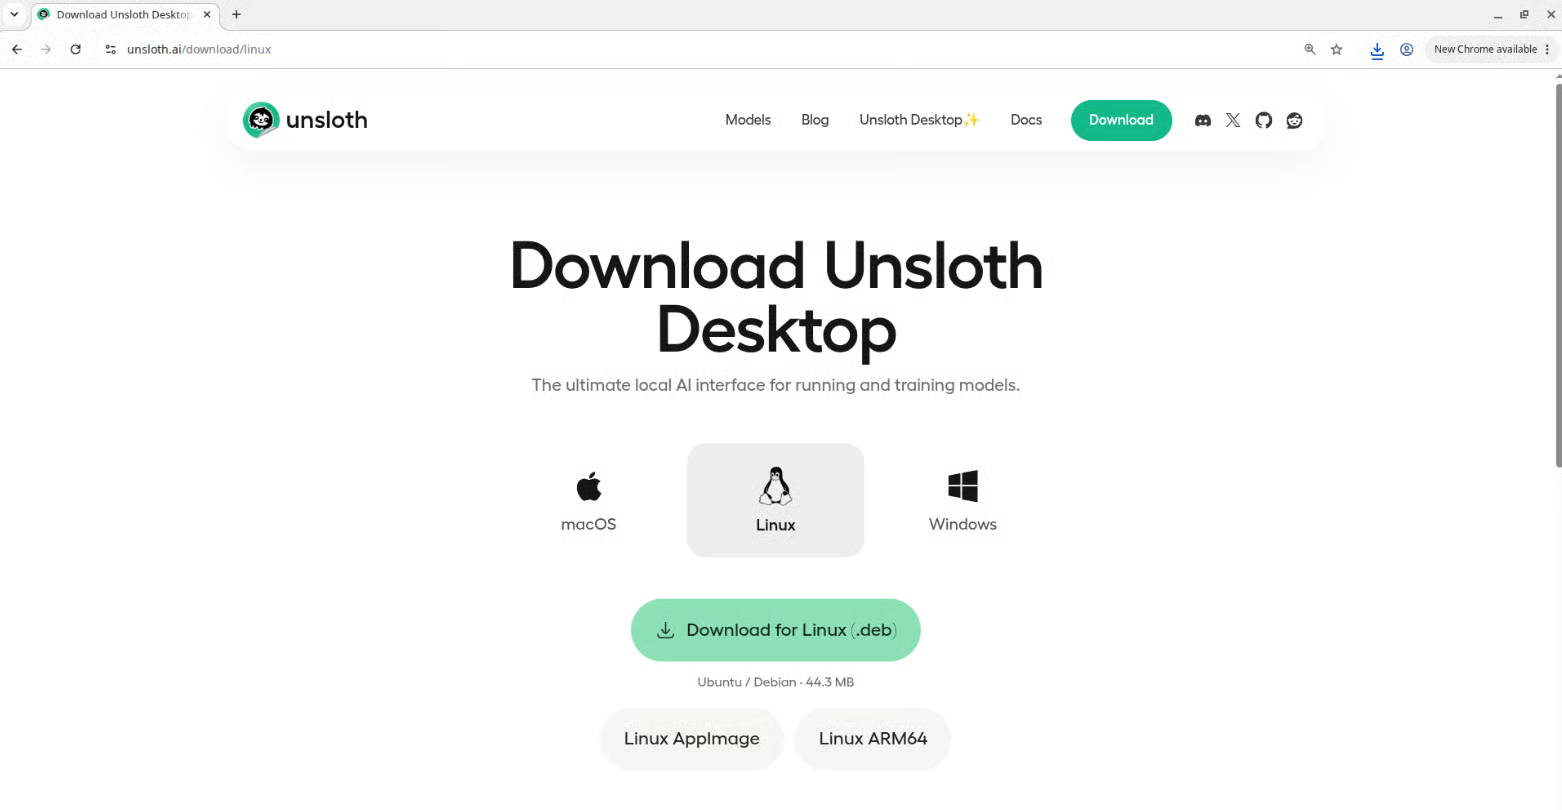
Fonte: baixe o Unsloth Desktop para Linux
Após concluir o download, instale o pacote como faria com qualquer outro aplicativo de desktop. No Linux, isso pode ser um pacote .deb, dependendo da sua distribuição.
Quando a instalação terminar, abra o Unsloth Desktop. O aplicativo deve detectar automaticamente seu hardware disponível e liberar o acesso à interface principal.
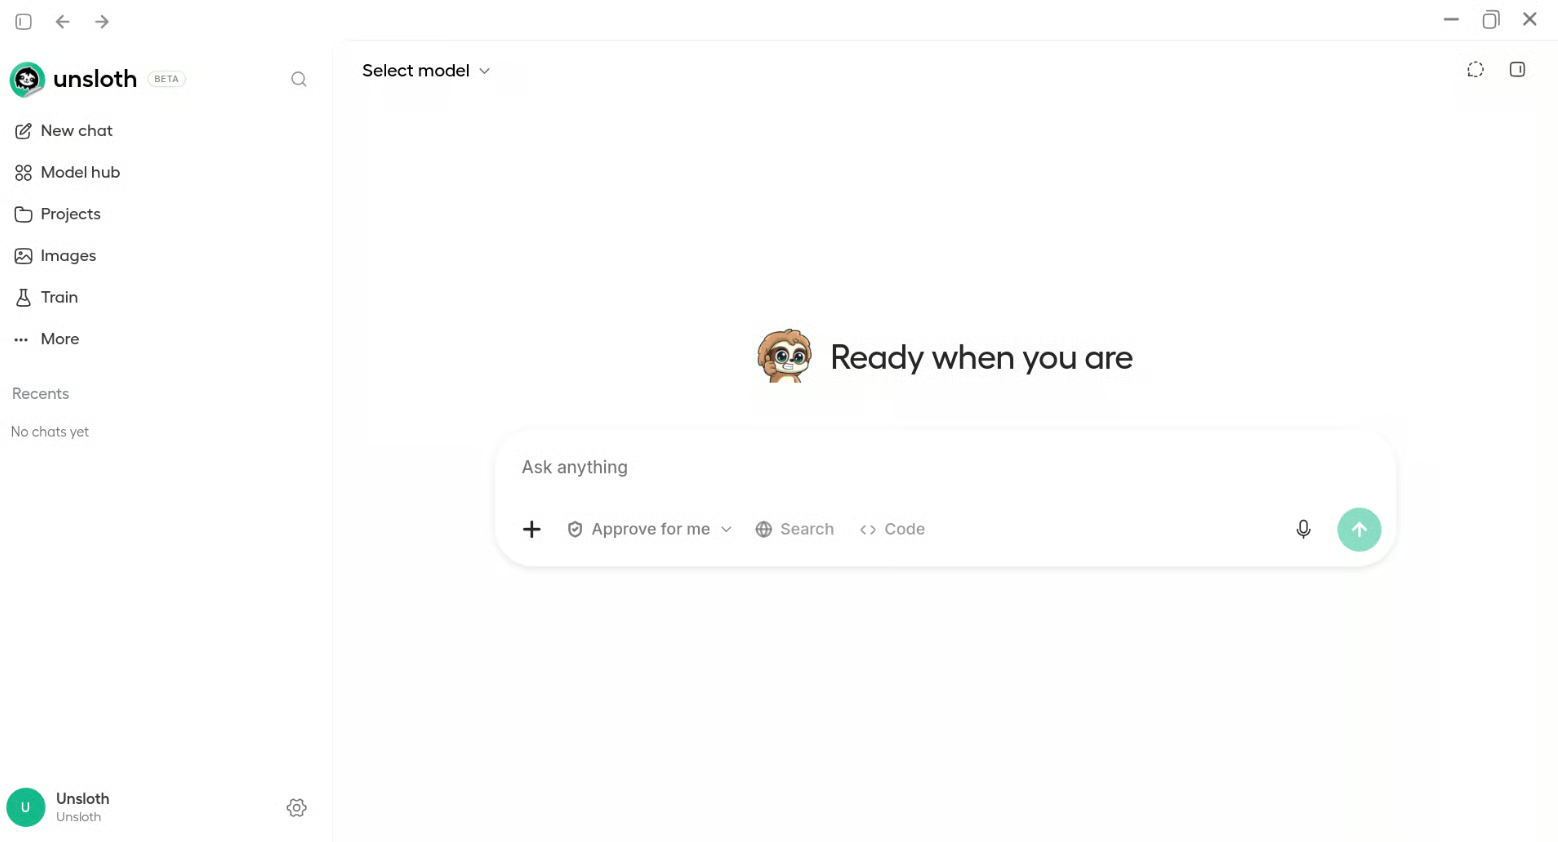
A partir daqui, você pode navegar e baixar modelos, rodar LLMs localmente, fazer fine-tuning, trabalhar com imagens e outras modalidades, gerenciar seus modelos locais e acessar as demais ferramentas do Unsloth Desktop.
Abra o Model hub no Unsloth Desktop e procure o modelo que você quer rodar. Para este teste, usei um dos meus modelos pequenos favoritos:
empero-ai/Qwythos-9B-Claude-Mythos-5-1M-GGUF · Hugging Face
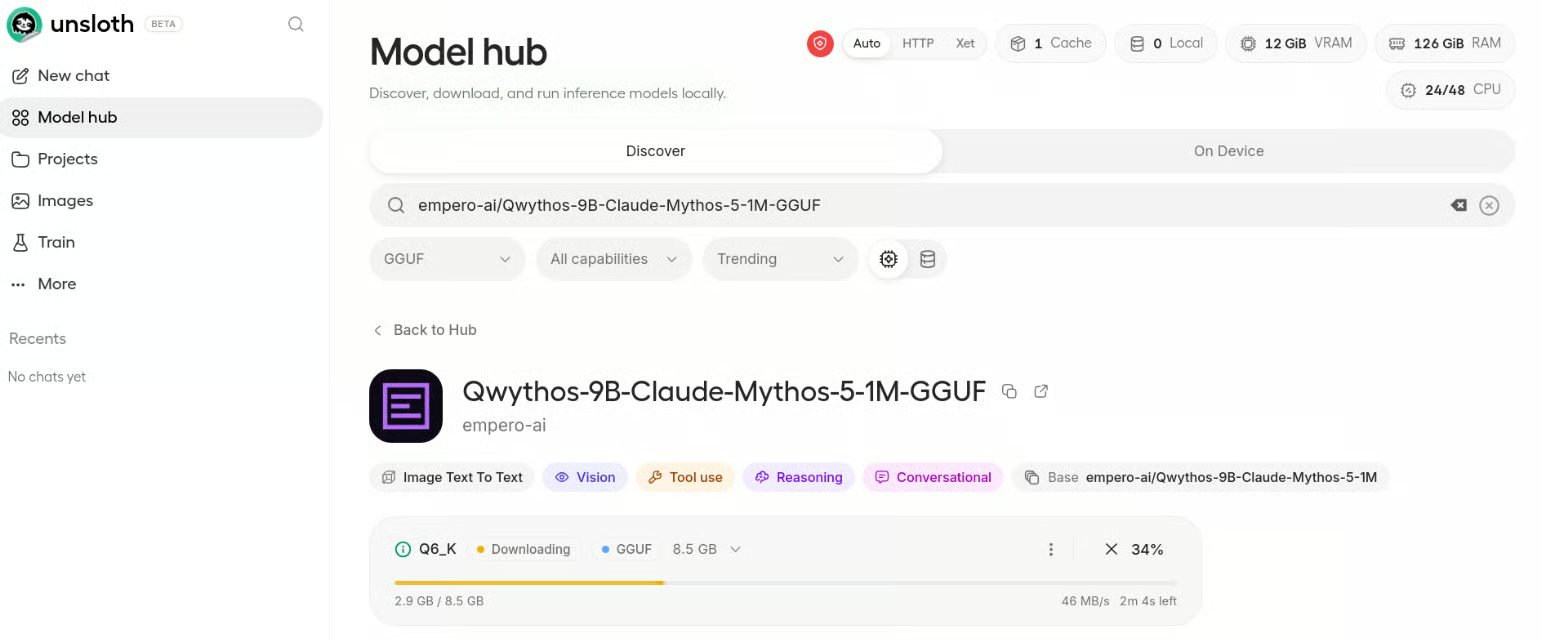
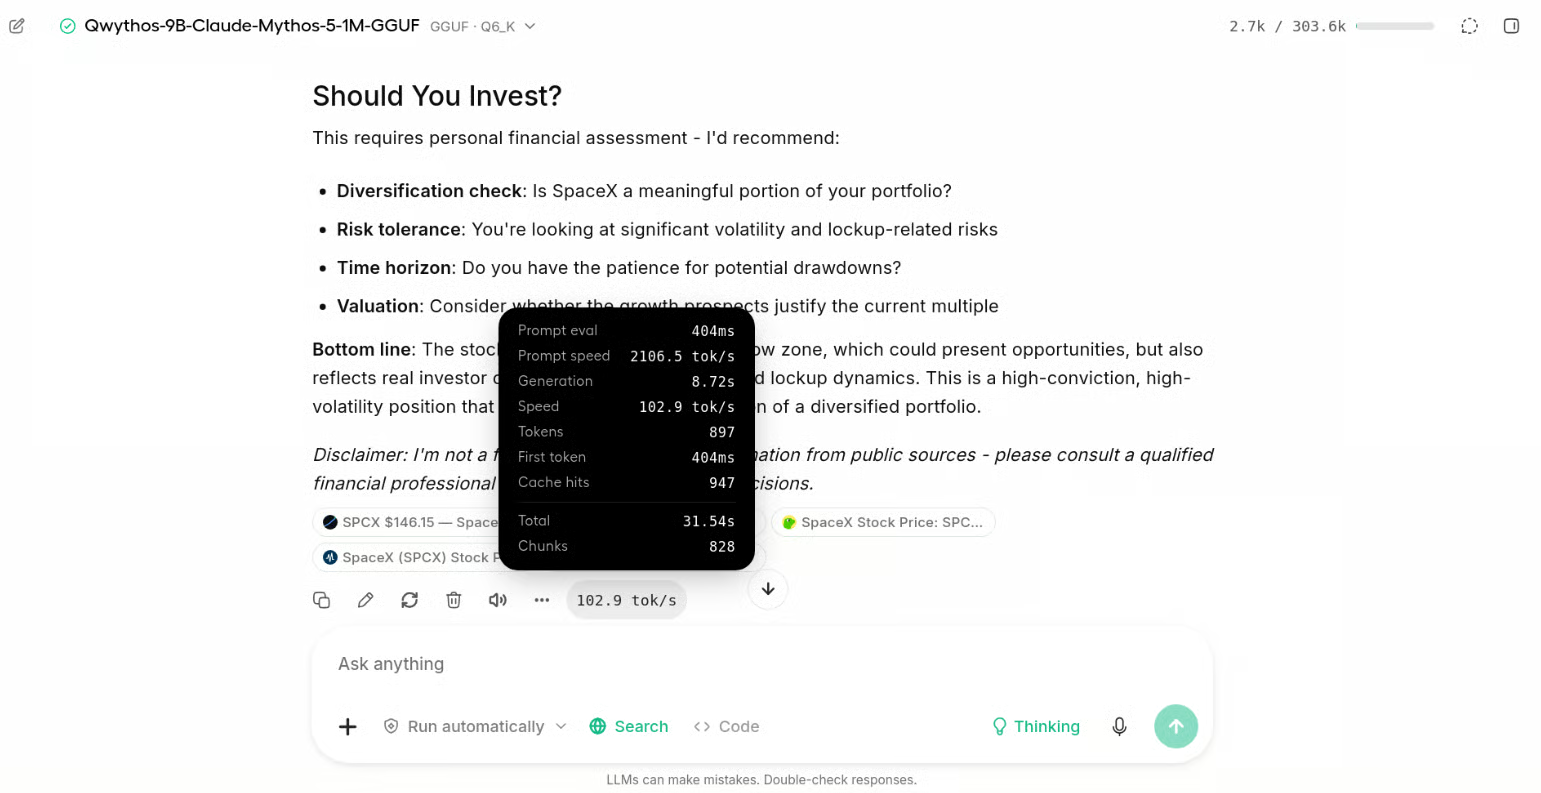
Depois de baixar o modelo, você pode carregá-lo e começar a conversar com ele direto no Unsloth Desktop. No meu sistema, obtive em média cerca de 102 tokens por segundo, chegando a aproximadamente 125 tokens por segundo em algumas perguntas relacionadas a código.
Também ativei o acesso à web e pedi ao modelo notícias mais recentes do mercado financeiro. Isso torna a experiência de chat local muito mais útil quando você precisa de informações além do que já está dentro do modelo.
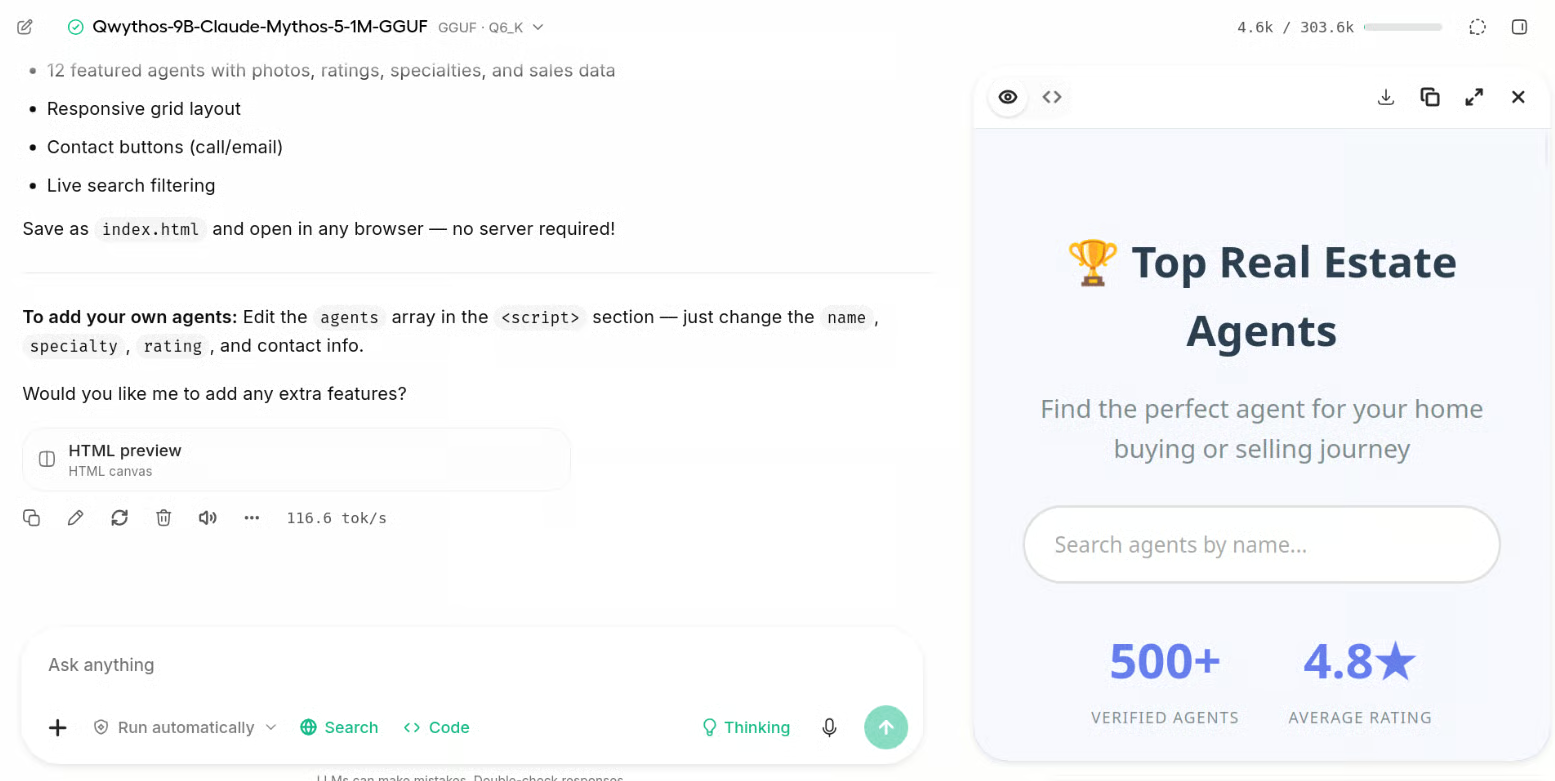
Depois, quis ver se ele conseguiria construir algo em vez de apenas responder perguntas. Pedi para criar um site e ele gerou o código e mostrou o site ao lado do chat, facilitando ver o resultado enquanto eu continuava fazendo ajustes.
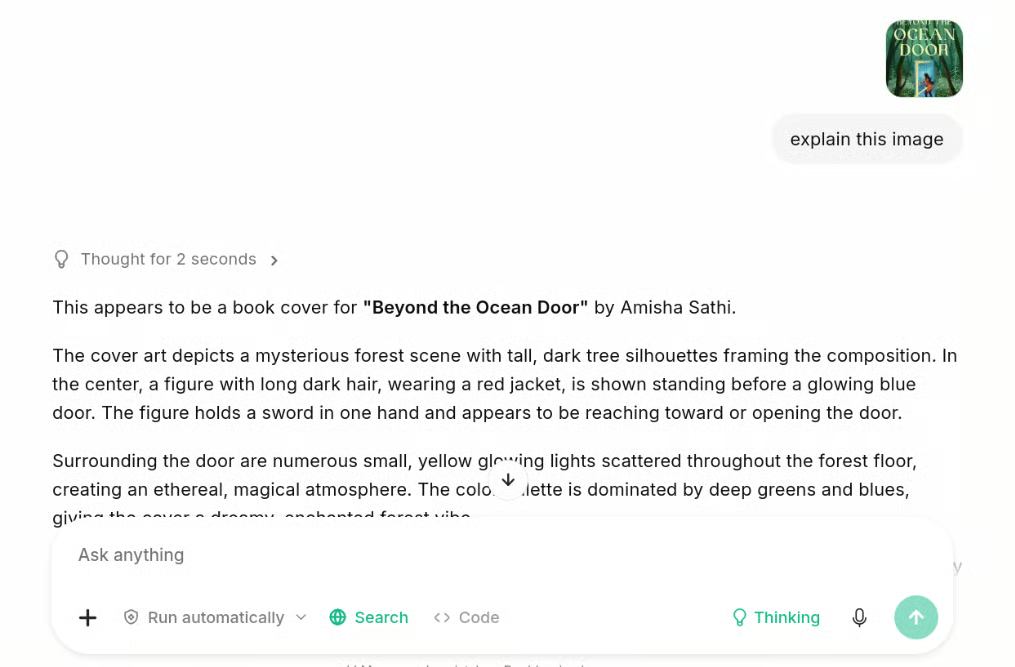
O Unsloth Desktop também é compatível com modelos visão-linguagem, então você pode enviar uma imagem direto no chat e fazer perguntas sobre ela.
No meu teste, o codificador de visão necessário foi instalado automaticamente quando baixei o modelo. Simplesmente enviei uma imagem, fiz uma pergunta sobre ela e, em segundos, o modelo retornou uma resposta bem precisa.
O suporte a visão é especialmente útil ao trabalhar com agentes de código. Por exemplo, você pode enviar a captura de tela de um site e indicar um problema a ser resolvido, mostrar ao agente um design para reproduzir ou usar uma interface existente como referência visual enquanto cria seu próprio aplicativo.
Modelos menores são ótimos para testes e até para uma codificação agentiva mais leve. Mas, se você quer um agente de código local realmente robusto para lidar com projetos maiores, vai precisar de um modelo mais forte que ainda caiba na VRAM da sua GPU.
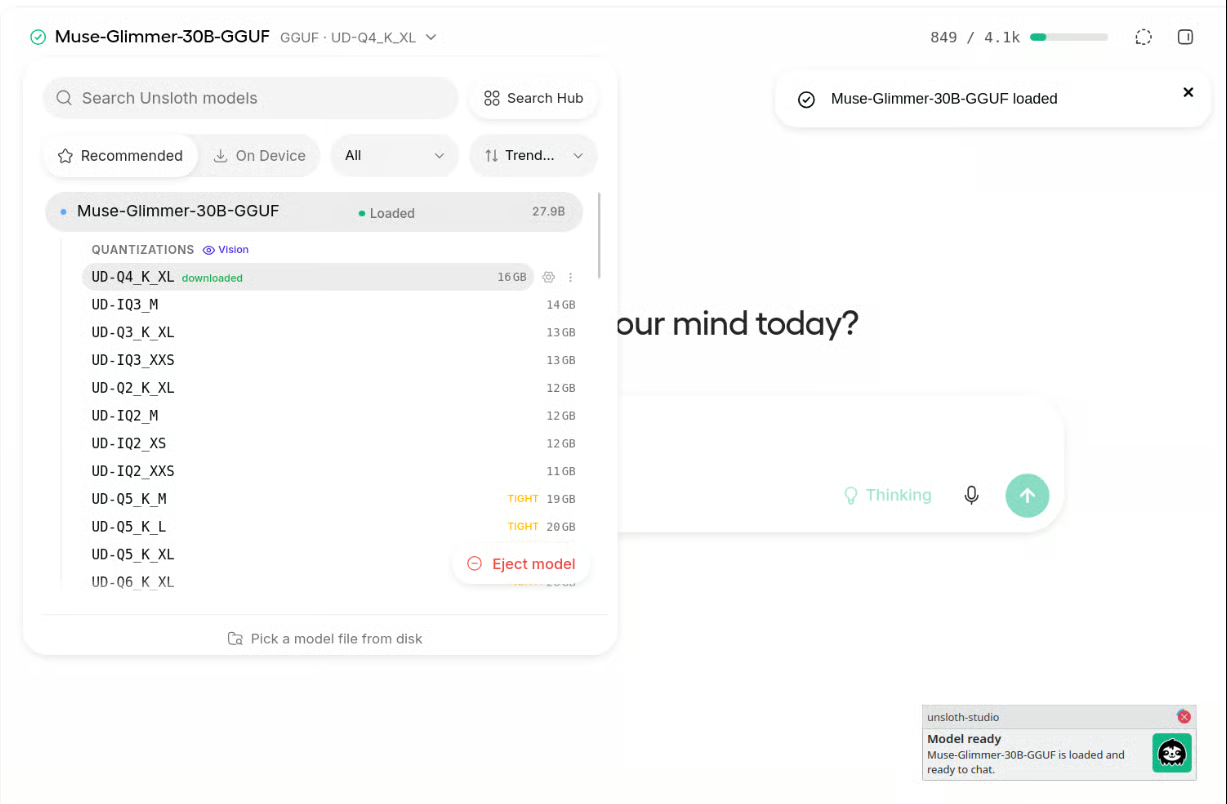
No meu caso, estou usando uma RTX 3090 com 24 GB de VRAM, então baixei a versão Q4 do Muse Glimmer 30B.
Abra a aba Models no Unsloth Desktop, procure pelo modelo e baixe a versão UD-Q4_K_XL. Em poucos minutos, o modelo deve estar baixado e carregado no seu sistema.
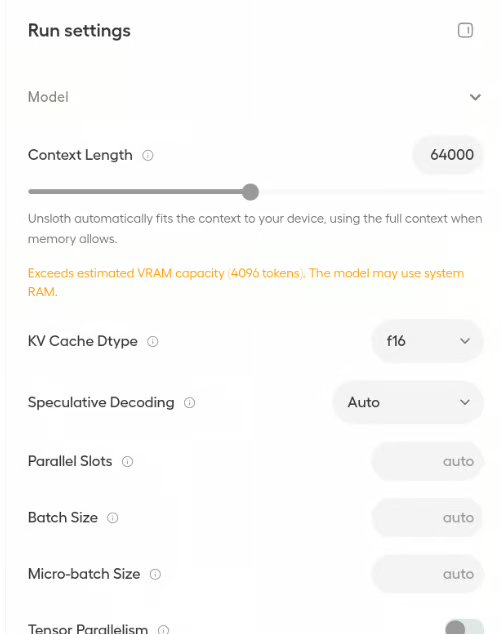
Por padrão, a janela de contexto estava em cerca de 4K, o que é pouco para um agente de código trabalhando em vários arquivos. Abra o painel à direita no Unsloth Desktop, mude o tamanho do contexto para 64K, role a tela e recarregue o modelo.
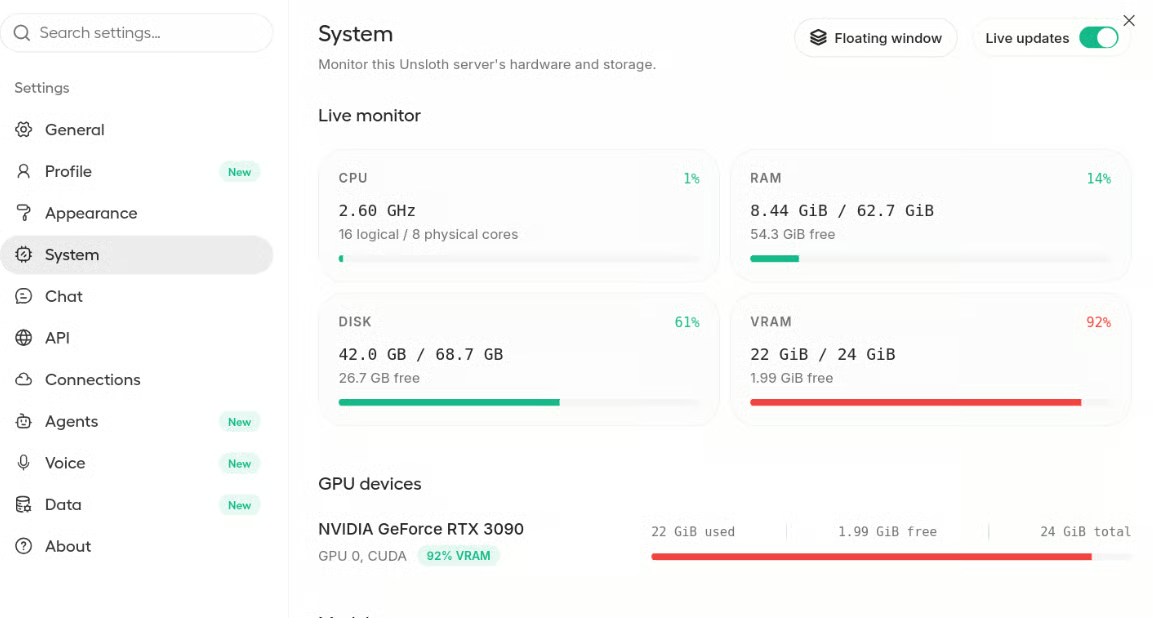
Depois que o modelo recarregar, vá em Settings → System para checar o uso de memória da GPU. No meu caso, o modelo usava cerca de 22 GB de VRAM, sobrando aproximadamente 2 GB para o KV cache. Isso foi suficiente para os meus testes, embora a memória disponível dependa da sua GPU e da carga de trabalho.
Depois, abra Settings → Agents e selecione o OpenCode como agente de código. O Unsloth Desktop vai gerar automaticamente o comando para você iniciar.
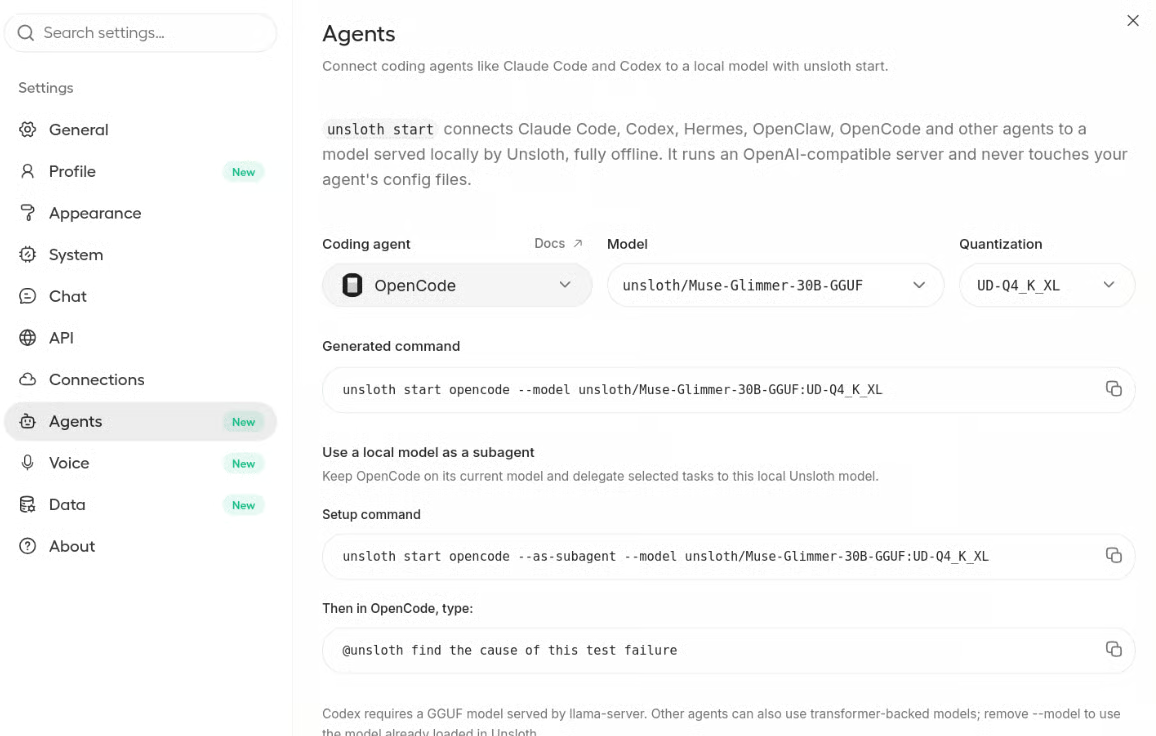
Primeiro, crie um diretório de projeto no terminal:
mkdir unsloth-project
cd unsloth-project
Depois, inicie o OpenCode:
unsloth start opencode \
  --model unsloth/Muse-Glimmer-30B-GGUF:UD-Q4_K_XL \
  --context-length 64000
Garanta que você inclua o tamanho de contexto no comando. Caso contrário, o OpenCode pode iniciar com a janela de contexto padrão, menor.
O comando vai instalar o OpenCode se necessário e então abrir sua interface de terminal com o modelo local do Unsloth pronto para uso.
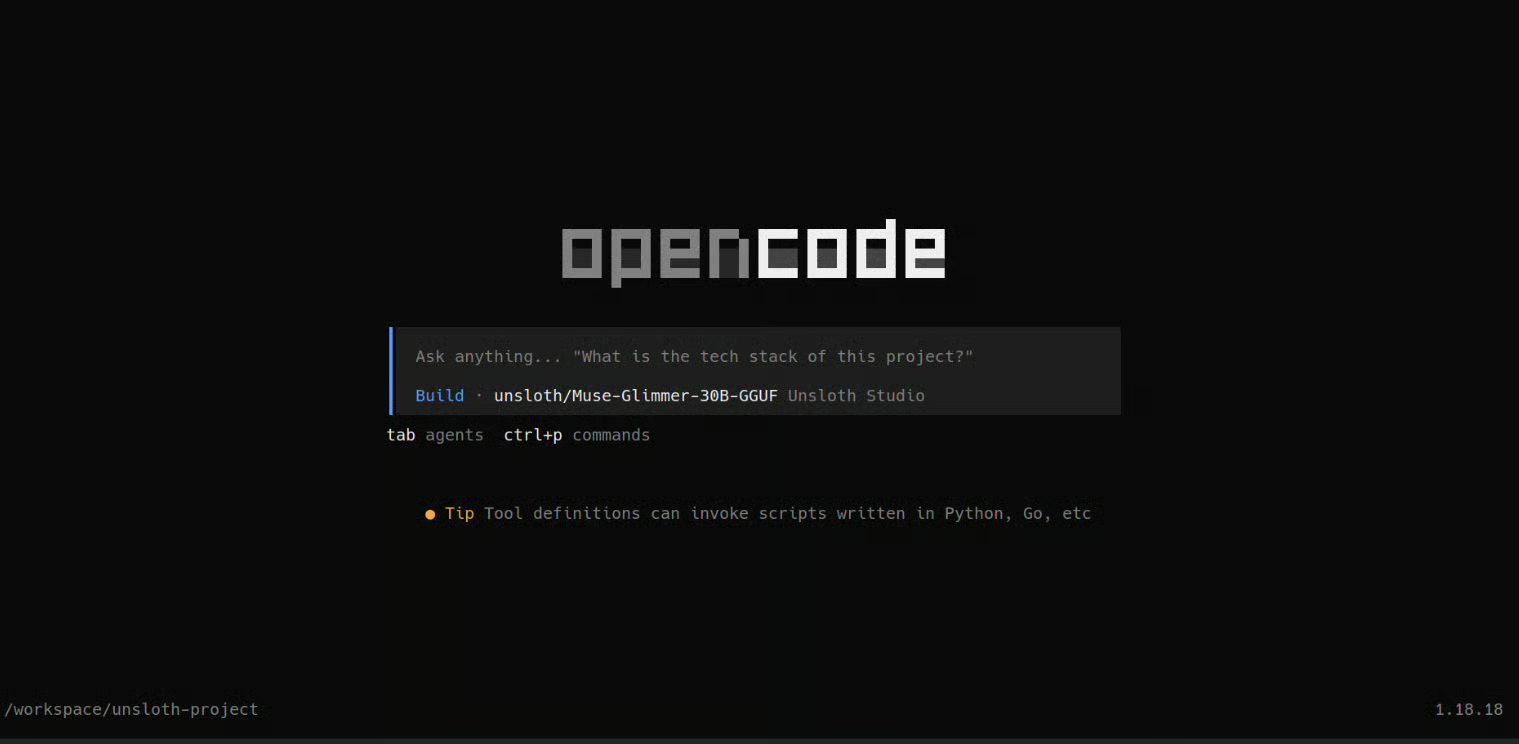
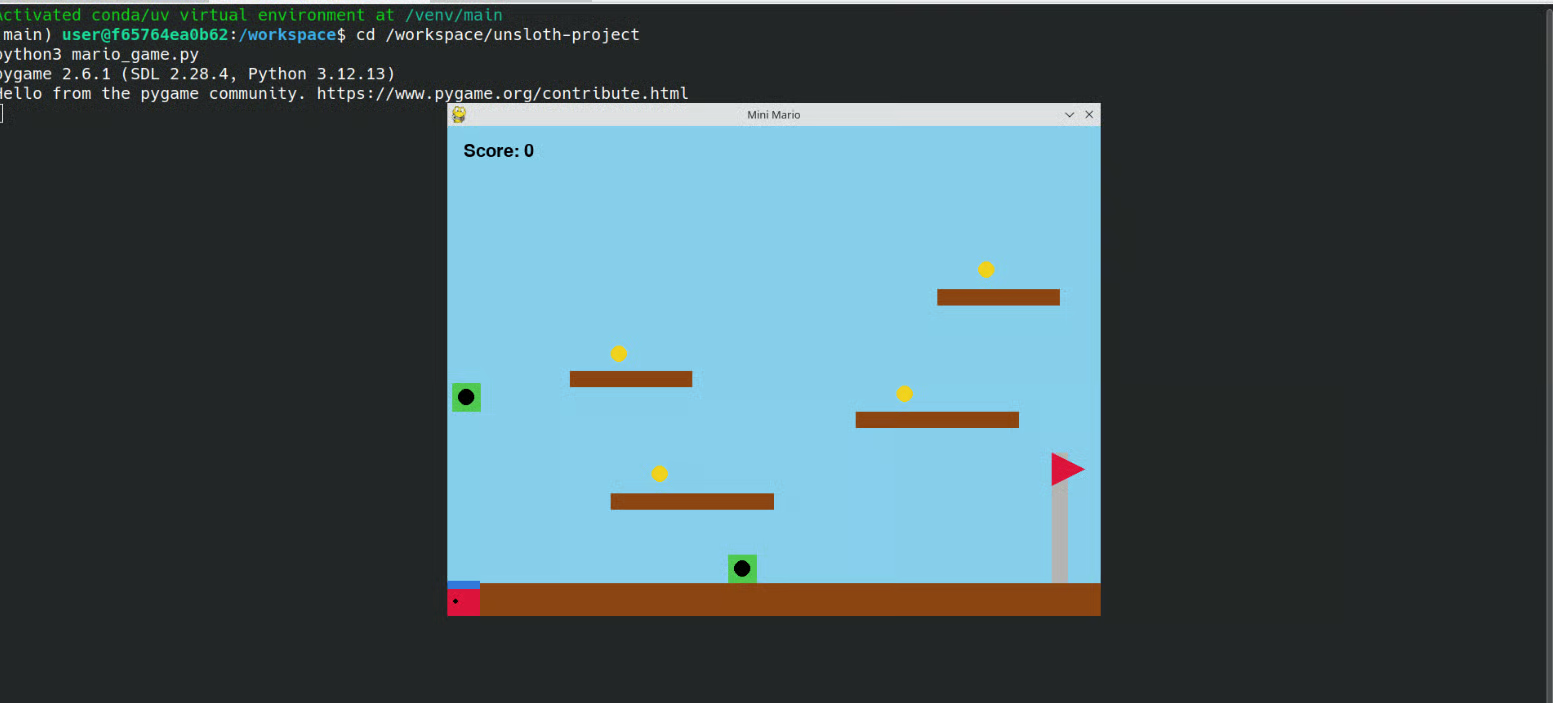
Agora que está tudo conectado, quis colocar o agente de código local à prova de verdade. Em vez de pedir um trecho pequeno de código, pedi para construir um jogo estilo Mario em Python do zero.
Usei este prompt:
Create a simple Mario-style 2D platform game in Python using Pygame.
Add left/right movement, jumping, platforms, coins, enemies, a score counter, and a finish flag.
Use simple built-in shapes instead of external assets. Create the files, install dependencies, test the game, and tell me how to run it.
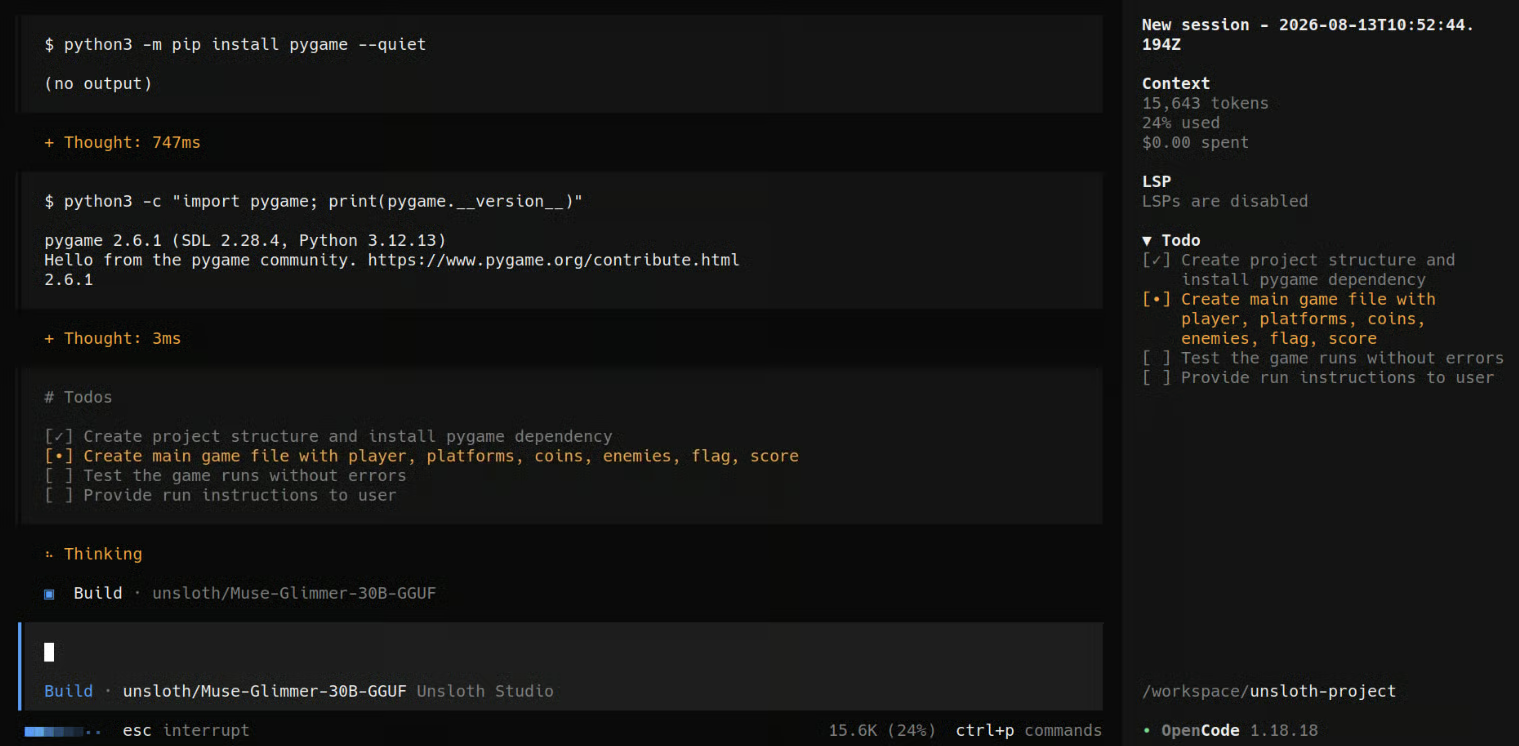
O OpenCode primeiro criou uma lista de tarefas e começou a percorrer o projeto passo a passo. Criou os arquivos, escreveu a lógica do jogo, tratou as dependências e por fim me deu o comando para iniciar o jogo.
O jogo final funcionou, embora ainda com alguns bugs. A versão Q4 do Muse Glimmer não rendeu tão bem quanto eu esperava para essa tarefa maior de codificação, então, se você tiver VRAM suficiente, recomendo testar a versão Q8 para um desempenho melhor em código.
Até aqui, usamos o Unsloth Desktop principalmente para rodar LLMs e agentes de código, mas ele faz muito mais. A ideia é ter a maior parte dos seus fluxos de trabalho de IA locais disponível no mesmo aplicativo, em vez de configurar uma ferramenta diferente para cada tarefa.
Você pode fazer fine-tuning de LLMs localmente usando métodos como LoRA e QLoRA. A interface de treino sem código facilita selecionar seu dataset, configurar o treinamento, iniciar a execução e exportar o modelo final sem precisar montar todo o pipeline por conta própria.
Você pode baixar modelos de difusão compatíveis e gerar imagens localmente a partir de prompts de texto. Também dá para enviar uma imagem existente, descrever as mudanças desejadas e usar os modelos suportados para editar imagens.
Se quiser ir além da geração de imagens, você também pode treinar LoRAs de imagem no seu próprio dataset. Isso é útil para ensinar um modelo sobre um tema, personagem, produto ou estilo visual específico e depois usar essa LoRA em gerações futuras.
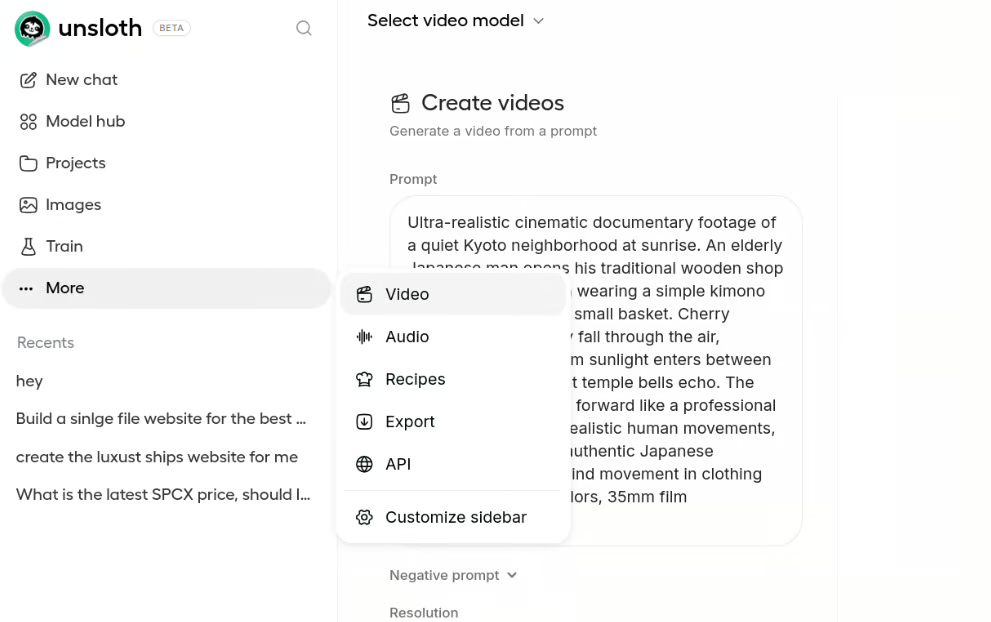
O Unsloth Desktop também suporta fluxos de geração de vídeo locais com modelos de difusão compatíveis. Assim, você pode experimentar geração de imagem e vídeo no mesmo aplicativo, sem precisar montar um ambiente separado.
Você pode trabalhar com modelos de speech-to-text, text-to-speech e outros modelos de áudio suportados. Isso permite transcrever áudio, gerar fala e experimentar diferentes fluxos de IA para áudio localmente.
As Data Recipes ajudam a transformar arquivos como PDFs e CSVs em datasets que você pode inspecionar, editar e preparar para treino. É especialmente útil quando você tem seus próprios dados, mas não quer montar o dataset manualmente do zero.
Conforme você baixa mais modelos e começa a treinar os seus, organizar tudo pode virar uma bagunça. O Unsloth Desktop oferece um único lugar para gerenciar modelos baixados, datasets, adapters, execuções de treino e outros recursos locais.
O Unsloth Studio oferece suporte oficial para exportar modelos Safetensors/LoRA para GGUF e outros formatos. O llama.cpp é explicitamente suportado para executar modelos exportados.
Por fim, o Unsloth Desktop pode expor seu modelo local por meio de uma API compatível com OpenAI. Isso facilita conectar seus modelos locais a outros aplicativos, ferramentas de código ou projetos de IA, sem depender de uma API hospedada.
O Unsloth Desktop está seguindo um caminho bem interessante. Ter LLMs, fine-tuning, geração de imagem e vídeo, agentes de código, datasets e APIs locais em um único aplicativo para desktop deixa a IA local muito mais acessível — principalmente para quem não quer configurar cada ferramenta manualmente.
Dito isso, ainda parece um pouco cru em alguns pontos. Em GPUs mais antigas ou com drivers CUDA desatualizados, você ainda pode precisar resolver dependências e instalar algumas coisas manualmente no Linux ou Windows. Também encontrei problemas com geração de imagens, configurações de contexto e agentes de código. Por exemplo, se você aumentar o contexto do modelo no Unsloth Desktop, talvez precise definir explicitamente o mesmo tamanho de contexto ao iniciar seu agente de código. Alguns fluxos de geração de sites e no estilo Canvas também nem sempre se comportaram como esperado.
A Unsloth adicionou muitos recursos em pouco tempo, mas nem tudo parece totalmente estável ainda. Espero que boa parte desses pontos melhore conforme o Desktop fique mais otimizado e maduro.
Por enquanto, se meu objetivo principal é apenas servir um LLM local para um agente de código com IA ou outro aplicativo, ainda prefiro o llama.cpp. Ele me dá muito mais controle sobre o modelo, contexto, offloading na GPU, uso de memória e outros ajustes de baixo nível. O Unsloth Desktop é bem mais fácil de usar, enquanto o llama.cpp continua sendo a melhor opção quando quero afinar a configuração e extrair o máximo de performance do meu hardware.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
8 min
blog
Bhavishya Pandit
8 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
8 min
Tutorial
Moez Ali
12 min
Tutorial