programa
Fundamentos de la IA
10 h
Desde el lanzamiento de ChatGPT, parece que cada pocos días aparece un nuevo modelo de lenguaje grande (LLM), junto con nuevas empresas especializadas en esta tecnología. Cada nuevo LLM se entrena para superar al anterior de varias formas. Por ejemplo, cada vez vemos más LLM orientados a mejorar un caso de uso concreto: modelos de chat, asistentes de programación o comprensión de contextos largos, entre otros.
Elegir el modelo adecuado para una nueva aplicación o proyecto basado en LLM puede resultar abrumador, por no hablar del reto de mantenerse al día con los últimos modelos y sus funciones.
En mi caso, esto a menudo me lleva a recurrir por defecto a ChatGPT o a modelos GPT mediante llamadas a API.
Aquí quiero profundizar en la amplia variedad de modelos disponibles y destacar las capacidades clave que conviene tener en cuenta al elegir el modelo adecuado según las características del proyecto.
Nos centraremos especialmente en los distintos métodos de interacción con estos modelos como una de las funciones clave a considerar al decidir entre todas las opciones disponibles.
El objetivo es que esta guía completa te sirva como chuleta y te ayude a orientarte entre la enorme oferta de LLM para tus tareas específicas.
Si eres nuevo en el mundo de los LLM, te recomiendo seguir el curso de AI Fundamentals y Large Language Models Concepts para familiarizarte con la terminología y los modelos básicos.
Acceder a LLM e integrarlos en una aplicación o proyecto impulsado por LLM puede hacerse de varias formas según las necesidades técnicas.
La forma más sencilla de interactuar con LLM es a través de interfaces conversacionales en el navegador. Es el caso de ChatGPT, donde la interfaz de usuario es simplemente un chat que te permite conversar con el modelo.
En general, estas interfaces permiten poco o ningún control o personalización del modelo por parte del usuario, pero son una forma fácil de probar modelos para tareas simples. ChatGPT de OpenAI y Gemini de Google ofrecen este tipo de interfaces:
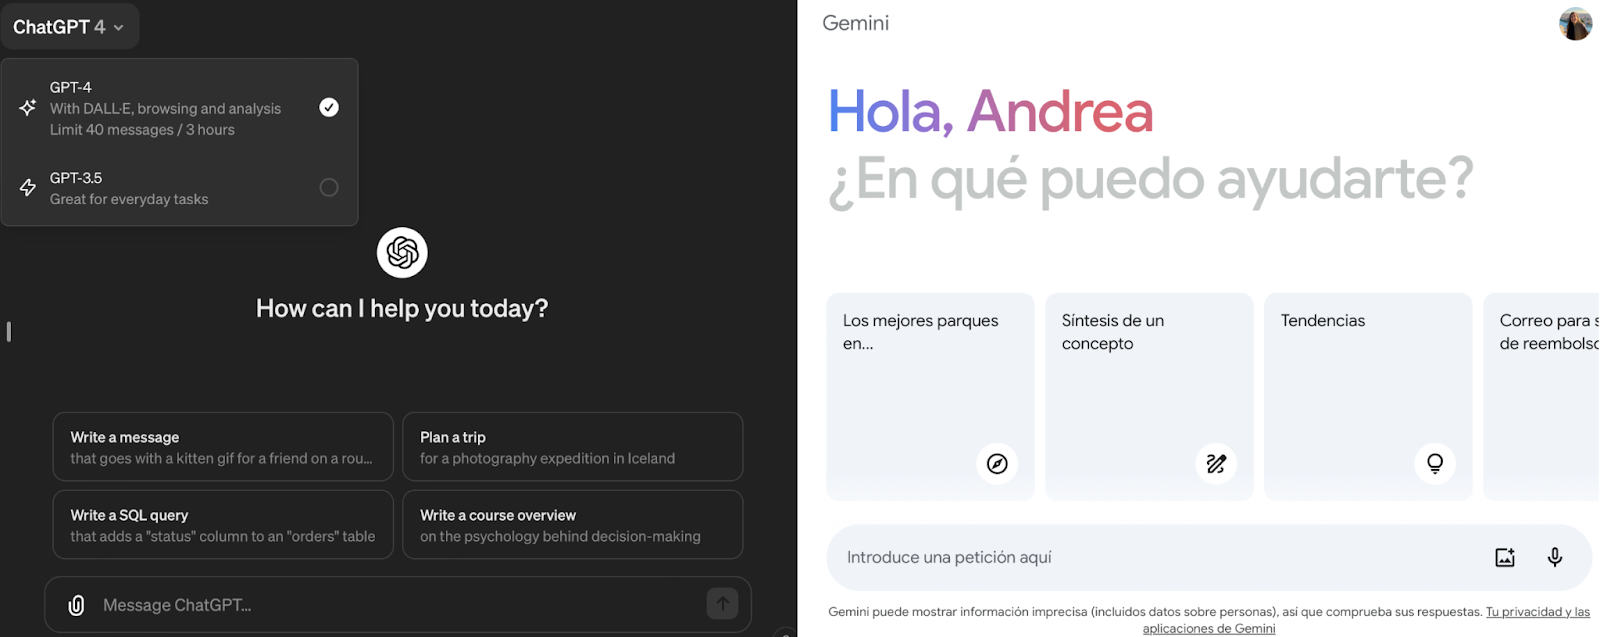
Capturas de las interfaces de chat de ChatGPT (izquierda) y Gemini (derecha).
A veces, algunos proveedores permiten cierto grado de personalización a través de interfaces de chat igual de sencillas. En el caso de OpenAI, la plataforma se llama «Playground».
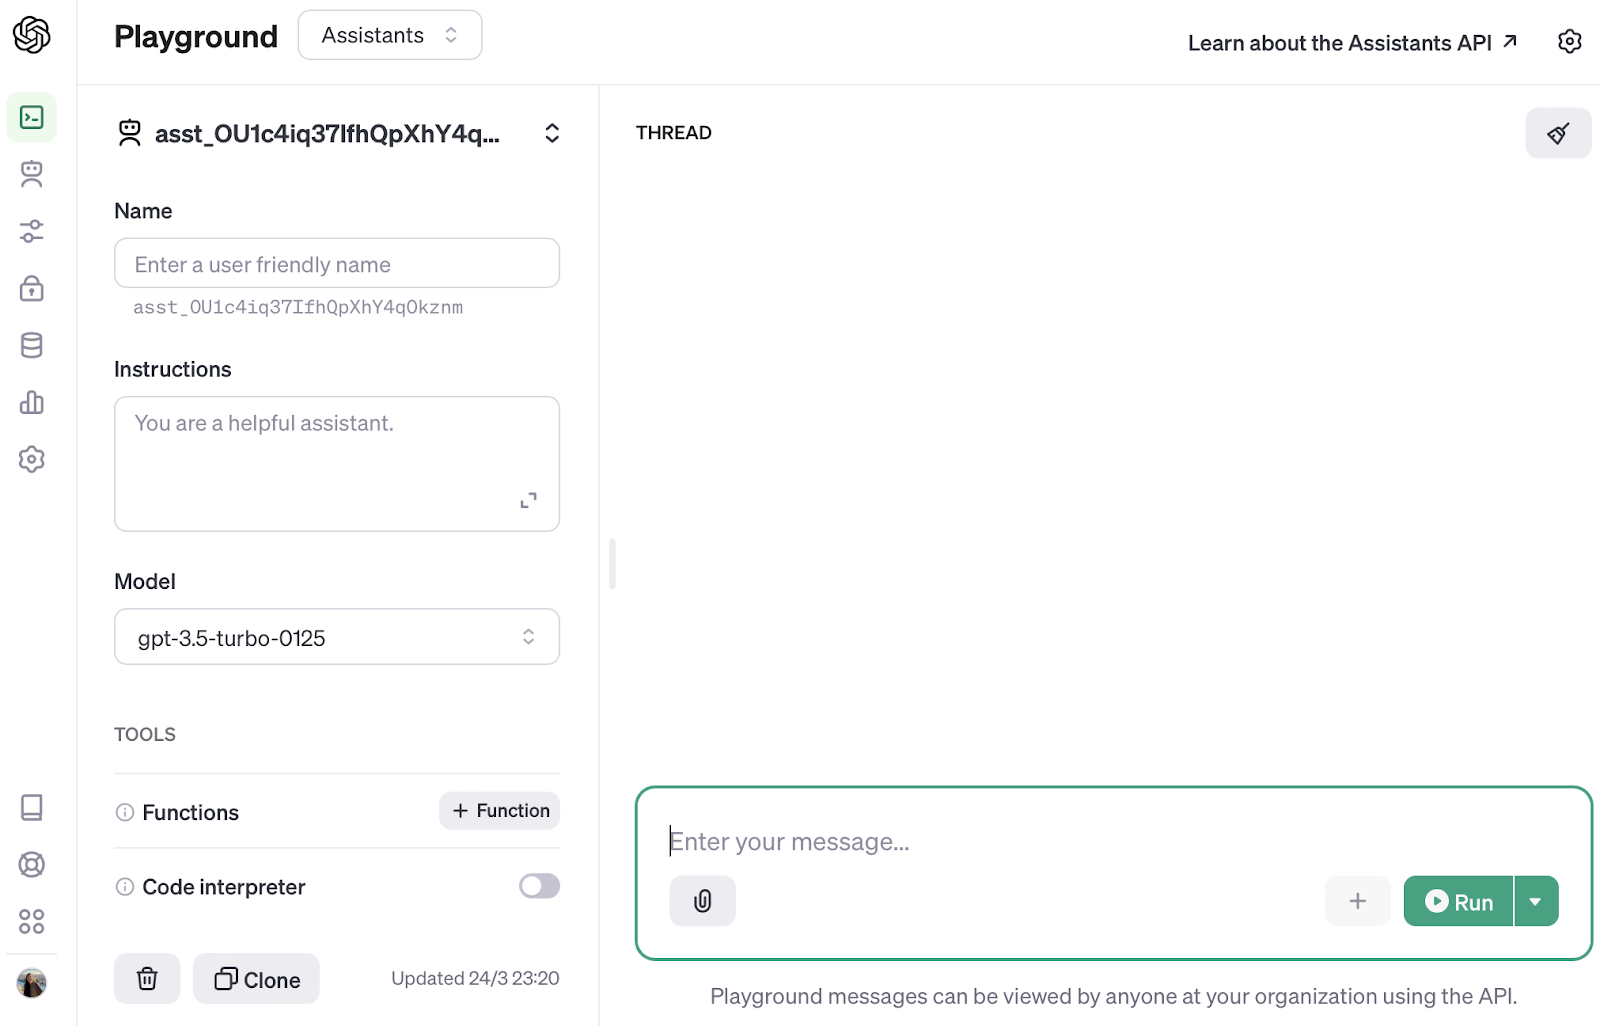
Captura de la interfaz de OpenAI Playground.
Los playgrounds nos permiten probar distintos modelos con un control limitado de la configuración. Así podemos explorar qué parámetros encajan con tu tarea. Aun así, como ya habrás comprobado, estos entornos o los chats no permiten incrustar la interacción con el LLM dentro de una aplicación o proyecto.
Una de las formas más populares de consultar LLM es a través de acceso por API. Este enfoque es especialmente ventajoso cuando no necesitamos personalizar mucho el modelo.
Las llamadas a la API pueden integrarse sin esfuerzo en nuestros scripts, sin necesidad de que montemos ni mantengamos infraestructura propia.
Sin embargo, la comodidad tiene un precio y, aunque dependes de servicios externos —una dependencia que siempre tendrás si prefieres no alojar el modelo ni gestionar su infraestructura—, los costes escalarán inevitablemente con el uso.
Con las llamadas a API, una buena práctica es implementar un pequeño wrapper alrededor de la llamada para interactuar con el modelo de forma modular. Para la API de OpenAI, que es la que más he usado, siempre utilizo el wrapper de la siguiente sección para que la selección del modelo sea transparente para el usuario.
Escribir un método estandarizado pero flexible para consultar modelos GPT a través de la API de OpenAI es muy útil si quieres interactuar con el modelo de forma fluida y con menos errores. Por eso suelo definir la llamada a GPT en una función wrapper al inicio del programa, garantizando que el uso del modelo sea transparente para la aplicación.
La librería openai (pip install openai) ya proporciona un endpoint ChatCompletion que nos permite invocar cualquier modelo GPT mediante el método .create.
El método .create tiene dos parámetros obligatorios:
gpt-4.Con estos dos parámetros, la llamada a GPT sería así:
prompt = "Hello world"
chat_completion = openai.ChatCompletion.create(model="gpt-3.5-turbo", messages=[{"role": "user", "content": prompt}])
Al llamar al modelo, recibiremos la respuesta en formato JSON:
{
 "choices": [
   {
     "finish_reason": "stop",
     "index": 0,
     "message": {
       "content": "Hello! How can I assist you today?",
       "role": "assistant"
     }
   }
 ],
 "created": 1692042919,
 "id": "chatcmpl-7nXwl0tywcTb91xeEuhpQbpRD6XLM",
 "model": "gpt-3.5-turbo-0613",
 "object": "chat.completion",
 "usage": {
   "completion_tokens": 9,
   "prompt_tokens": 9,
   "total_tokens": 18
 }
}
Por tanto, interesa devolver solo el texto de la finalización como retorno de la función. Si unimos todas las piezas, nuestra implementación del wrapper podría escribirse así:
def chatgpt_call(prompt, model="gpt-3.5-turbo"):
   response = openai.ChatCompletion.create(
       model=model,
       messages=[{"role": "user", "content": prompt}]
   )
   return response.choices[0].message["content"]
Si te interesan más detalles de esta implementación, el artículo ChatGPT API Calls: A Gentle Introduction entra más a fondo.
Por último, también conviene recordar que la mayoría de proveedores de API, incluido OpenAI, ofrecen algunas llamadas gratuitas al crear tu cuenta. Aun así, los créditos son limitados (normalmente menos de 20 $) y suelen tener una validez temporal (por lo general, un mes).
En cualquier caso, siempre es buena práctica envolver las llamadas al LLM en una función —o conjunto de funciones— para que el modelo sea transparente a la aplicación, independientemente del proveedor.
Alojar el modelo por tu cuenta implica descargar los pesos y ejecutarlo en máquinas locales o servidores privados.
Este enfoque es muy atractivo porque te da control total sobre la infraestructura del modelo, pero también supone un esfuerzo técnico considerablemente mayor.
Si te pica la curiosidad sobre los pasos para montar la infraestructura de un LLM, echa un vistazo al artículo LLMOps Essentials.
Ejecutar el modelo en local permite más personalización según nuestras necesidades. En este contexto, una de las opciones más populares para el autoalojamiento son los conocidos modelos LLaMa de Meta AI. Han publicado modelos ligeros que pueden ejecutarse en un portátil con solo 8 GB de RAM.
Poner en marcha LLaMa en tu portátil es bastante sencillo gracias a plataformas como Ollama.
Ollama ofrece una plataforma diseñada para ejecutar LLM como LLaMa 2 y Code LLaMa en local en tus dispositivos. Es compatible con macOS, Linux y Windows, y permite personalizar y crear tus propios modelos. Para más detalles, visita la web de Ollama.
Puedes descargar Ollama desde la página oficial, mientras que los pesos de los modelos se descargan directamente desde la terminal.
Instalemos primero Ollama accediendo a su página principal.
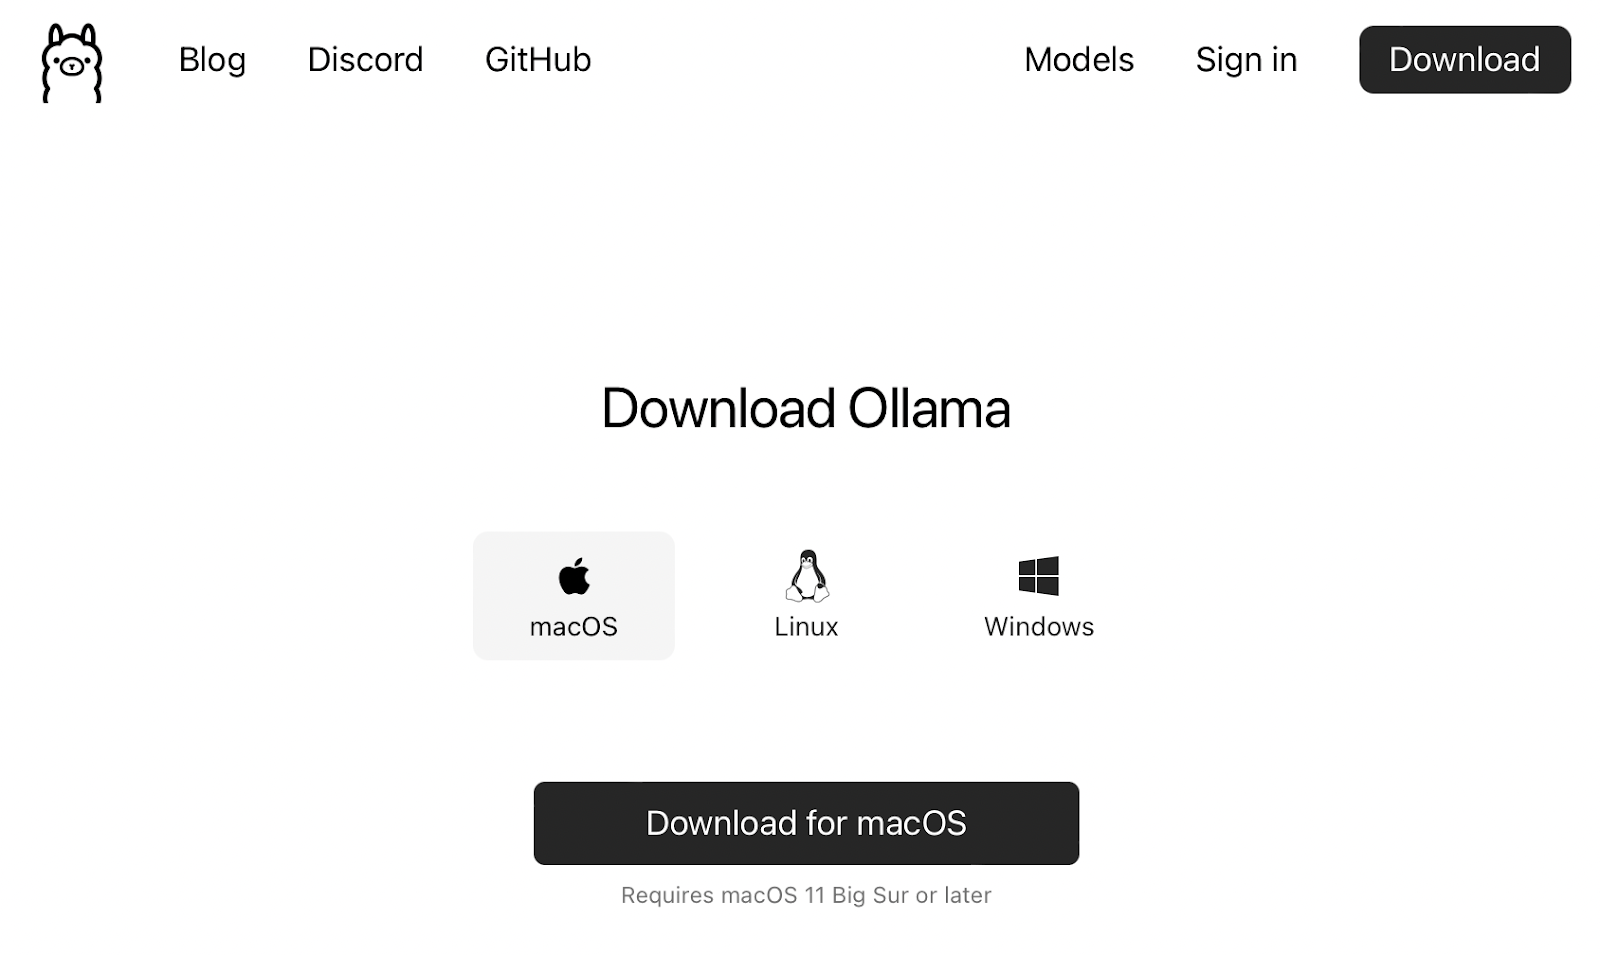 Captura de la página principal del sitio web de Ollama.
En este caso, Ollama es una utilidad de línea de comandos:
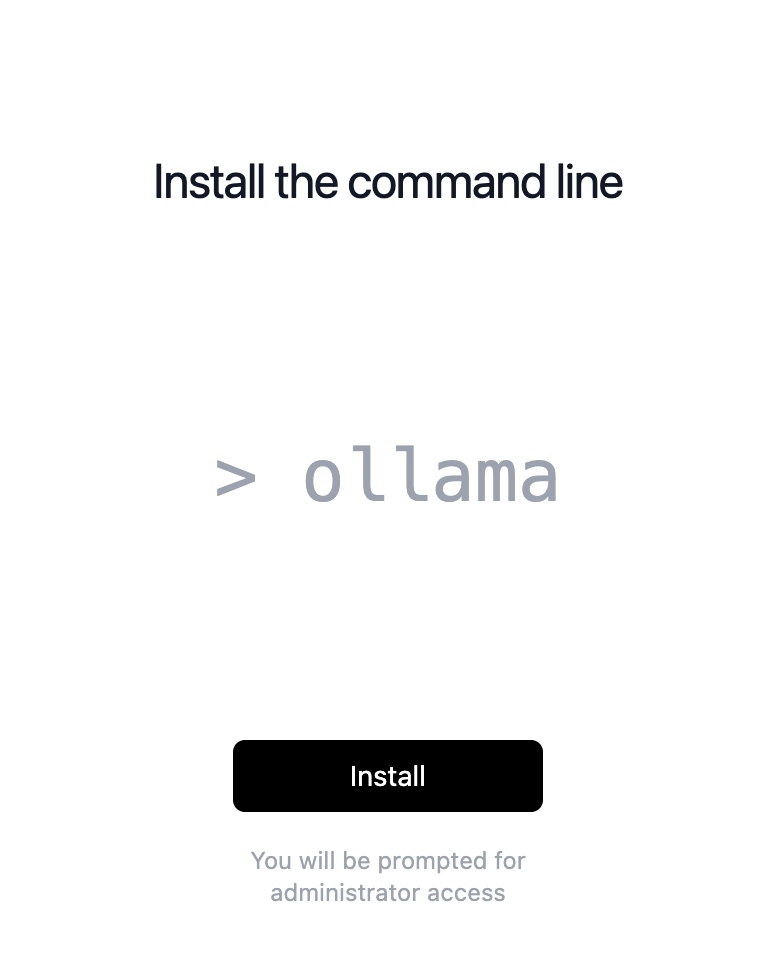
Captura de la instalación de la herramienta de línea de comandos de Ollama.
Una vez instalada la utilidad de línea de comandos, podemos iniciar el modelo con el comando ollama run <model name>. Si es la primera vez que ejecutas ese modelo en tu equipo, Ollama lo descargará por ti:
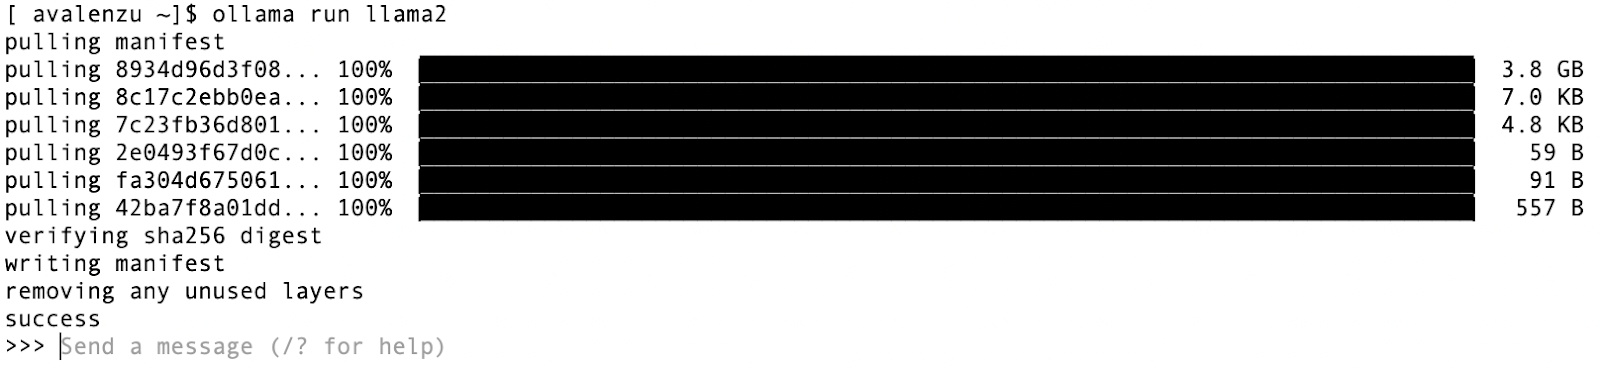
Primera ejecución del modelo LLaMa 2 con la CLI de Ollama. El modelo se descarga automáticamente en el primer uso.
A partir de ahí, hacer prompts y salir del modelo desde la terminal es muy sencillo:
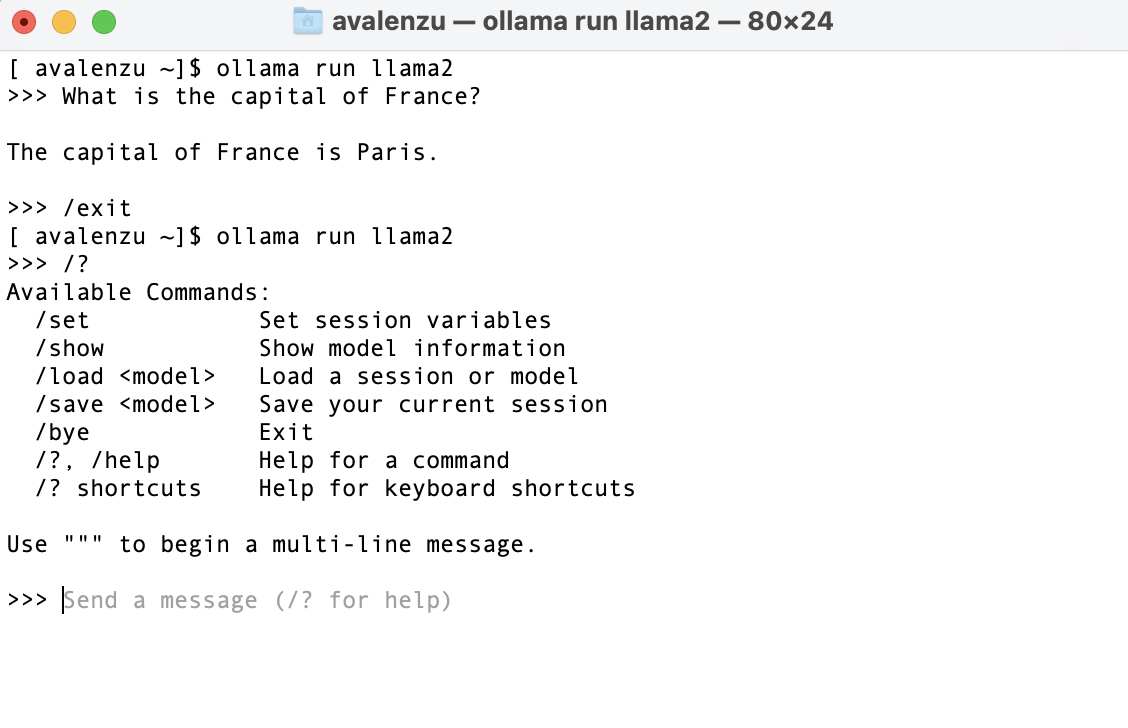
Interacción del usuario con el modelo mediante la CLI de Ollama.
Como se ve en la imagen, el modelo también ofrece un pequeño conjunto de comandos extra.
Ollama también es compatible con otros modelos, como el nuevo Mistral:
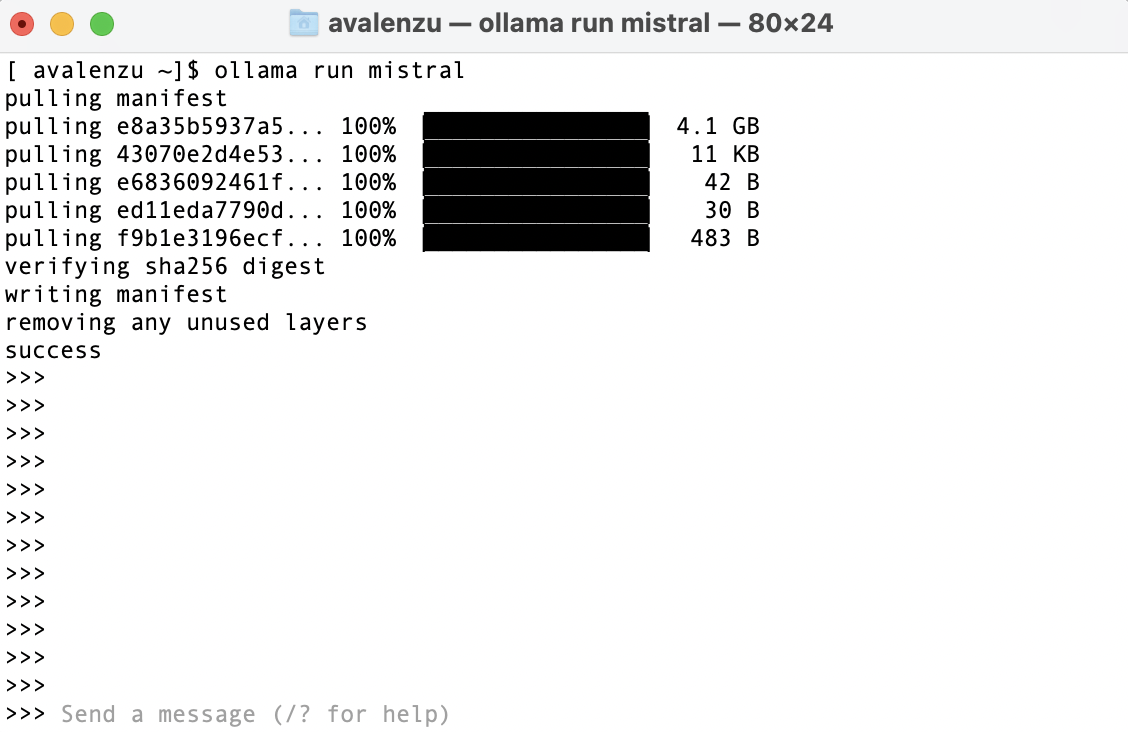
Primera ejecución del modelo Mistral con la CLI de Ollama. El modelo se descarga automáticamente en el primer uso.
De nuevo, el modelo está listo para usarse de inmediato con un solo comando.
Esta vía es ventajosa porque solo consume recursos de tu dispositivo. No obstante, conviene recordar que el rendimiento del modelo suele aumentar con el número de parámetros.
En consecuencia, cuantos más parámetros tenga un modelo, más recursos necesitará. Por tanto, los modelos grandes probablemente deban ejecutarse en servidores privados para aplicaciones autoalojadas.
Si quieres crear una aplicación a gran escala, ten en cuenta que Ollama también puede ejecutarse con Docker Desktop en Mac y dentro de contenedores Docker con aceleración por GPU en Linux.
Quizá te preguntes: ¿puedo integrar OLLAMA en mis scripts?
Efectivamente, alojar el modelo tú mismo no impide integrarlo en tus scripts de Python. Ollama también ofrece la posibilidad de interactuar con tu modelo autoalojado desde Python.
Las librerías de Python y JavaScript de Ollama permiten incorporar la inferencia del modelo en tus scripts.
Ollama no es la única opción si quieres alojar el modelo por tu cuenta. En general, los LLM suelen estar disponibles para descarga en múltiples plataformas de código abierto que además ofrecen soporte de comunidad.
Los LLM de código abierto suelen ser gratuitos para fines académicos y de investigación. Sin embargo, los términos para uso comercial pueden variar según la licencia específica de cada modelo. Ten siempre presente si estás experimentando con LLM o creando aplicaciones basadas en LLM para uso comercial.
¿Te apetece empezar hoy mismo tu camino desarrollando LLM? Entonces el curso Developing Large Language Models es para ti.
Alojar modelos potentes en local puede ser muy intensivo en recursos, por lo que usar servicios en la nube es una alternativa viable: te permite escalar recursos bajo demanda y contar con el soporte del proveedor.
Cabe destacar que nubes tradicionales como Azure ya ofrecen canalizaciones personalizadas para alojar LLM (como Mistral), de modo que no necesitamos implementar un alojamiento especializado.
Esto es una gran ventaja para desplegar aplicaciones dentro de tu organización, ya que muchas empresas ya tienen contratos con estos proveedores para servicios como el correo y soluciones cloud generales.
Optar por proveedores de terceros puede ofrecer un equilibrio entre no gestionar la infraestructura de alojamiento y tener cierto control sobre el modelo, en comparación con usar solo una API nativa.
Estos proveedores suelen ofrecer acceso por API, pero es importante tener en cuenta que los costes pueden aumentar notablemente con un uso intensivo, igual que al usar la API nativa de OpenAI.
La diferencia clave está en quién aloja. Los proveedores de terceros, y no los servicios nativos del LLM, alojan el modelo en su infraestructura y exponen el endpoint de API, a menudo ofreciendo varios modelos de distintas fuentes para una integración flexible.
Un proveedor popular de APIs de terceros es LLAMA API.
Página principal de la web de LLAMA API.
La API no es gratuita, pero puedes probarla ya que se conceden 5 $ en créditos gratis a cada cuenta nueva. Recuerda que esos créditos caducan al mes de emitirse.
Usar LLAMA API es muy directo. Una vez instalada (pip install llamaapi), podemos hacer una primera llamada de prueba así:
from llamaapi import LlamaAPI
import json

llama = LlamaAPI('<Insert API key here>')
prompt = "Which is the capital of France?"

api_request_json = {
  "model": "llama-13b-chat",
  "messages": [
    {"role": "system", "content": "You are a friendly chatbot."},
    {"role": "user", "content": prompt},
  ]
}

response = llama.run(api_request_json)
print(json.dumps(response.json(), indent=2))
Aun así, igual que con la API de OpenAI, es buena práctica encapsular la llamada en una función wrapper. Siguiendo el mismo enfoque que antes:
def llm_call(prompt, model="llama-13b-chat"):
    api_request_json = {
        "model": model,
        "messages": [
            {"role": "system", "content": "You are a friendly chatbot."},
            {"role": "user", "content": prompt},
        ]
    }
    response = llama.run(api_request_json)
    return response.json()["choices"][0]["message"]["content"]
Con esta implementación, obtendremos la respuesta del LLM como cadena simplemente llamando a llm_call():
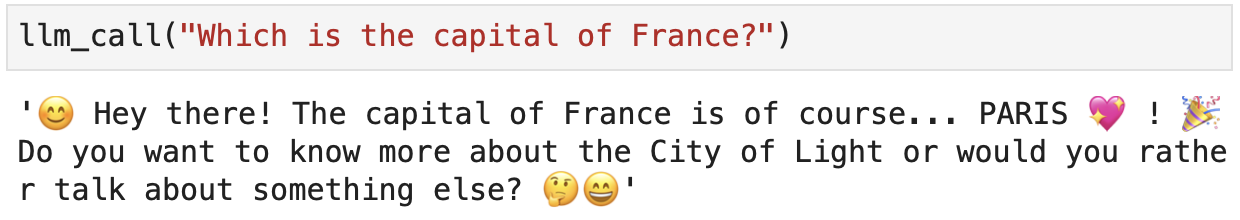
LLAMA API admite una variedad de modelos de última generación, no solo LLaMa de Meta. ¡En la siguiente sección veremos cuáles!
Por último, en el caso de LLAMA API, el coste depende del número de parámetros del modelo y parece ser constante entre modelos:
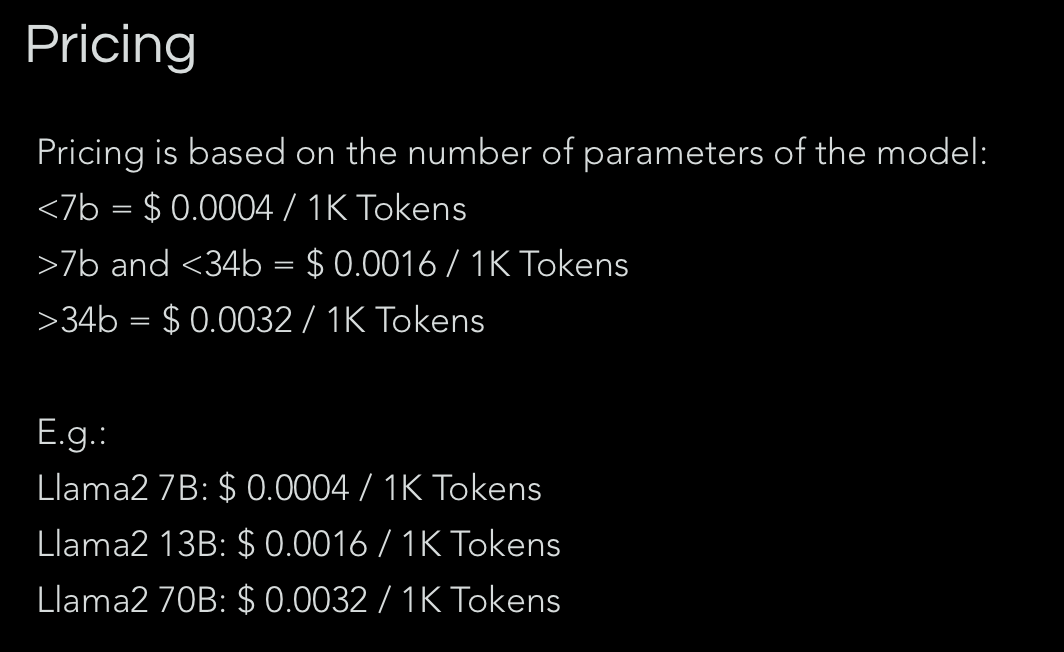
Precios de LLAMA API. Esta información solo está disponible tras crear una cuenta.
El proveedor de terceros más popular para LLM es Hugging Face. Hugging Face es conocido sobre todo por su librería transformers, la más popular en Python para procesamiento de lenguaje natural.
Hugging Face ofrece múltiples interfaces para acceder a LLM. Tiene una interfaz tipo playground muy sencilla llamada «Spaces»:

Captura del playground «Spaces» en Hugging Face.
También permite alojar modelos y desplegar endpoints, así como descargar los modelos para su uso en local.
Es importante tener en cuenta que Hugging Face es una especie de «sitio para desarrolladores», así que aunque encontrarás tutoriales para empezar, usar sus modelos para escalar una aplicación requiere conocimientos técnicos.
Si quieres saber más sobre Hugging Face, te recomiendo el artículo What is Hugging Face? The AI Community's Open-Source Oasis.
Otra herramienta complementaria que suelo usar para crear aplicaciones con LLM desde cero, junto con Hugging Face, es LangChain. El tutorial How to Build LLM Applications with LangChain ofrece una buena introducción práctica.
Hemos hablado de diferentes formas de acceder y ejecutar LLM, como los modelos GPT, LLaMa y Mistral. Sin embargo, hay muchos más modelos disponibles, incluidas varias variantes de los anteriores. En esta sección clasificaremos los principales modelos que existen hoy, enumerando sus características, precios y casos de uso.
OpenAI se ha hecho muy popular desde el lanzamiento de ChatGPT, hoy impulsado por GPT-3.5 o GPT-4 según tu suscripción. Para muchas tareas básicas, la diferencia entre GPT-3.5 y GPT-4 no es muy notable.
No obstante, GPT-4 muestra una capacidad muy superior en escenarios de razonamiento complejo frente a modelos anteriores.
Además, GPT-4 es un modelo multimodal que acepta entradas de texto o imagen y produce texto. También permite usar plugins para conectarse a fuentes externas. La navegación por Internet es un ejemplo de ello, como se ve con las búsquedas en Bing.
Hay tres variantes principales de GPT-4 accesibles a través de la API de OpenAI para clientes de pago:
|
Modelo |
Características |
Ventana de contexto |
API |
Local |
Precio por token |
Datos de entrenamiento |
|
GPT-4 |
Instantánea de gpt-4 del 13 de junio de 2023. Este endpoint recibe actualizaciones constantes. Optimizado para chat. |
8.192 tokens |
No |
$0,03 / 1.000 tokens (entrada) $0,06 / 1.000 tokens (salida) |
Dic 2023 |
|
|
GPT-4 Turbo |
Nombre de API: gpt-4-turbo-preview. Destaca en tareas como generación de código y pretende reducir casos de «pereza». |
128k tokens |
No |
$0,01 / 1.000 tokens (entrada) $0,03 / 1.000 tokens (salida) |
Dic 2023 |
|
|
GPT-4 Vision |
Nombre de API: gpt-4-vision-preview. GPT-4 con capacidad para entender imágenes, además del resto de funciones de GPT-4 Turbo. |
128k tokens |
No |
$0,01 / 1.000 tokens (entrada) $0,03 / 1.000 tokens (salida) |
Abr 2023 |
En general, conviene señalar que los modelos GPT, a diferencia de LLaMa, son de código cerrado. Esto significa que no podemos ejecutarlos en local ni desplegar nuestro propio endpoint.
Aun así, existe la posibilidad de personalizarlos usando la API de Fine-tuning de OpenAI. Además, no están disponibles a través de proveedores de terceros como Ollama, LLAMA API o Hugging Face.
En cuanto a OpenAI Playground, la información sobre el modelo subyacente no se muestra claramente, pero parece basarse en GPT-4 con DALL-E, navegación y capacidades de análisis.
Veamos también los modelos GPT-3 disponibles.
|
Modelo |
Características |
Ventana de contexto |
API |
Local |
Precio por token |
Datos de entrenamiento |
|
GPT-3.5 Turbo |
Nombre de API: gpt-3.5-turbo. Es el modelo principal de esta familia. Está optimizado para diálogo y muestra mayor precisión al responder en formatos solicitados. |
16.385 tokens |
No |
$0,0005 / 1.000 tokens (entrada) $0,0015 / 1.000 tokens (salida) |
Sep 2021 |
|
|
GPT-3.5 Turbo Instruct |
Nombre de API: gpt-3.5-turbo-instruct. Se centra en la precisión y la relevancia de las respuestas, alineándose estrechamente con las necesidades del usuario. |
4.096 tokens |
No |
$0,0015 / 1.000 tokens (entrada) $0,0020 / 1.000 tokens (salida) |
Sep 2021 |
El modelo GPT-3.5 Turbo Instruct de la tabla ha sido ajustado para seguir mejor las intenciones del usuario mediante Reinforcement Learning from Human Feedback (RLHF).
RLHF es una técnica en la que se integra feedback humano en el proceso de aprendizaje por refuerzo para guiar y mejorar los resultados del aprendizaje de los agentes de IA. Este enfoque permite desarrollar modelos más alineados con los valores y preferencias humanas incorporando juicios, correcciones o preferencias directamente en el ciclo de entrenamiento.
Por último, como vemos en la tabla, merece la pena señalar que usar cualquiera de los dos modelos GPT-3.5 es considerablemente más barato que GPT-4.
En este sentido, suelo recomendar comparar el rendimiento de cada modelo en un conjunto de ejemplos bien definidos para ver si GPT-3.5 es suficiente para la tarea y así ahorrar en inferencia.
Como hemos visto, los modelos LLaMa se pueden descargar y ejecutar gratis en local o emplearse como base para personalizaciones.
La familia LLaMa es amplia en tamaños y variantes, publicada por Meta AI:
|
Modelo |
Características |
Ventana de contexto |
API |
Local |
Variante |
Datos de entrenamiento |
|
LLaMa 2 |
Modelo base no conversacional para tareas de completado. |
4.096 tokens |
Sí |
Sí* |
7B 13B 70B |
Sep 2022 |
|
LLaMa 2 Chat |
LLaMa 2 base con instruction tuning para convertirlo en un modelo de chat que sigue la intención del usuario. |
4.096 tokens |
Sí |
Sí* |
7B 13B 70B |
Sep 2022 |
|
LLaMa 2 Guard |
Modelo de salvaguarda de entrada y salida entrenado para detectar contenido tóxico y dañino. |
4.096 tokens |
Sí** |
No |
7B |
Sep 2022* |
*Hugging Face también ofrece variantes de LLaMa, como los modelos base y chat. **Por ahora, LLaMa 2 Guard es accesible en el entorno cloud de Amazon SageMaker.
A diferencia de GPT, que integra capacidades de programación, LLaMa tiene modelos específicos para código con ventanas de contexto mayores de 16k tokens, logradas mediante ajuste fino para contexto largo.
|
Modelo |
Características |
Ventana de contexto |
API |
Local |
Variante |
Datos de entrenamiento |
|
Code LLaMa |
Modelo base no conversacional para autocompletar código, como GitHub Copilot. Es un LLaMa 2 con entrenamiento adicional en código y ajuste para contexto largo. |
16k |
No |
Sí |
7B 13B 34B |
Sep 2022* |
|
Code LLaMa - Instruct |
Derivado de modelos Instruct. Destaca en autocompletado y explicaciones sobre fragmentos de código. |
16k |
Sí |
Sí |
7B 13B 34B |
Sep 2022* |
|
Code LLaMa - Python |
Ajustado específicamente para el lenguaje de programación Python. |
16k |
No |
Sí |
34B |
Sep 2022* |
* La fecha oficial de corte de los datos de LLaMa es sep 2022. No obstante, los datos de ajuste son más recientes, de 2023, especialmente en variantes nuevas.
Google tiene una larga trayectoria desarrollando modelos de lenguaje grandes. Con la llegada de Gemini, Google inició su generación de LLM multimodales.
En la oferta de Google, Gemini destaca como su modelo insignia y es de código cerrado, al igual que ChatGPT. Sin embargo, recientemente lanzaron Gemma, una familia de modelos de código abierto derivados de Gemini, para facilitar el desarrollo de IA accesible.
En este artículo nos centraremos en Gemini y Gemma:
|
Modelo |
Características |
API |
Local |
Variantes |
|
Gemini |
Modelo de código cerrado para tareas de propósito general (generación de texto, traducción, preguntas y respuestas, código, etc.). |
Sí* |
No |
Ultra: resuelve tareas complejas. Pro: amplio rango de tareas. Escalable. Nano: uso eficiente en dispositivo. |
|
Gemma |
Tareas similares a Gemini, pero enfocadas a la integración en aplicaciones personalizadas e investigación. Es un modelo ligero. |
Sí**LLAMA API |
SíOllama |
2B 7B |
*Hay una API para Gemini con fines comerciales (no abierta a despliegues). Aun así, podemos probar el modelo en su interfaz Playground.
**No existe un endpoint nativo de Google, pero el modelo es accesible a través de Kaggle y Google Colab. Más información en la documentación oficial de Google.
En cuanto a las variantes, Gemini Ultra es multimodal y destaca en análisis complejos. Gemini Pro equilibra rendimiento y escalabilidad y sobresale en tareas de código y generación de texto. Por último, Gemini Nano prioriza la eficiencia en dispositivos, ejecutándose en móvil y edge sin grandes exigencias de recursos.
Sobre los modelos de Google, a fecha de redacción no hay mucha información pública sobre ventanas de contexto y fecha de corte de los datos de entrenamiento.
Mistral AI es una empresa francesa de IA fundada en abril de 2023 por exempleados de Meta y Google DeepMind. Se centra en desarrollar LLM de código abierto, destacando la importancia del software abierto frente a los modelos propietarios. La compañía ofrece modelos como Mistral 7B y Mixtral 8x7B con capacidades avanzadas de procesamiento del lenguaje.
|
Modelo |
Características |
Ventana de contexto |
API |
Local |
Precio por token |
Datos de entrenamiento |
|
Mistral |
Modelo de propósito general con 7B parámetros. Optimizado para inglés y tareas de generación de código. |
32k |
Sí* |
Sí |
$0,25 / 1M tokens (entrada y salida) |
Sep 2023 |
|
Mixtral |
Modelo de propósito general más potente. Fluido en inglés, francés, italiano, alemán y español, y muy competente en programación. Basado en una arquitectura dispersa Mixture-of-Experts de 7B parámetros. |
32k |
Sí* |
Sí |
$0,7 / 1M tokens (entrada y salida) |
Dic 2023 |
*Podemos interactuar con los modelos de Mistral AI usando su interfaz Playground llamada «La Plataforme».
**Hugging Face también ofrece un banco de pruebas para inferencia en tiempo real mediante su API para algunos modelos. Además, permite desplegar endpoints de pago para los modelos disponibles.
En el caso de Mixtral, la arquitectura «Mixture-of-Experts» permite dividir la capacidad total del modelo en distintos grupos especializados o «expertos». Cada experto está optimizado para determinados tipos de tareas o datos.
Al procesar una entrada, Mixtral activa dinámicamente solo los expertos relevantes, lo que le permite abordar tareas complejas de forma eficiente utilizando una fracción de sus parámetros por token. Este método potencia su rendimiento, haciéndolo muy competente en varios idiomas y tareas mientras optimiza los recursos computacionales. El nombre «Mixtral 8x7B» hace referencia a que utiliza 8 grupos distintos de «expertos».
Por último, Mistral AI también ofrece tres modelos comerciales: Mistral Small, Mistral Medium y Mistral Large. Si te interesa, puedes encontrar más información sobre los modelos y los precios en su documentación oficial.
Hasta ahora hemos visto múltiples modelos y variantes de las empresas más conocidas. Aun así, hay mucho más por explorar.
Quiero destacar los modelos Falcon del Technology Innovation Institute, disponibles tanto en Ollama como en LLAMA API. También el modelo Orca2 de Microsoft Research, especialmente bueno en razonamiento, disponible en Ollama y Hugging Face.
Puedes leer sobre otros modelos de código abierto en 8 Top Open-Source LLMs for 2024 and Their Uses.
En este artículo hemos comentado varios aspectos a tener en cuenta al seleccionar el mejor modelo de lenguaje grande para nuestra aplicación objetivo. Aunque la intención de esta guía es servir de chuleta, no existe una regla de oro para dar con el mejor modelo a la primera.
Por mi experiencia, definir cómo queremos interactuar con el LLM es un buen punto de partida, ya que ya reducirá el número de modelos —y variantes— disponibles.
El segundo aspecto es la tarea concreta que realizará el modelo: chatbot genérico, experto en resúmenes, asistente de programación, etc.
Aunque siempre podemos ajustar un modelo para nuestra tarea, hemos visto que existen variantes ya ajustadas para ciertos casos de uso que nos ahorrarán tiempo, recursos computacionales y experiencia técnica. Considerar la ventana de contexto necesaria para la aplicación también es clave para elegir el mejor modelo.
Por último, el precio siempre es un buen indicador de qué modelo utilizar. Lamentablemente, muchas veces el proyecto viene limitado por la inversión inicial y el coste de mantenimiento en el tiempo. En cuanto al precio, recuerda que el entrenamiento y el fine-tuning no son servicios gratuitos y además consumen bastante tiempo.
¡Continúa hoy tu viaje en IA!
programa
Curso
Curso
blog
Stanislav Karzhev
9 min
blog
Abid Ali Awan
13 min
blog
Abid Ali Awan
10 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
8 min
Tutorial
Moez Ali
12 min