Programa
Fundamentos da IA
10 h
Desde o lançamento do ChatGPT, parece que surge um novo Large Language Model (LLM) a cada poucos dias, junto com novas empresas especializadas nessa tecnologia. Cada novo LLM é treinado para superar o anterior de várias formas. Por exemplo, vemos com mais frequência LLMs ajustados para um caso de uso específico: modelos de chat, assistentes de código e compreensão de longos contextos, entre outros.
Escolher o modelo certo para uma nova aplicação ou projeto baseado em LLM pode ser uma tarefa desafiadora, sem falar no esforço para se manter atualizado com os modelos mais recentes e seus recursos.
No meu caso, isso muitas vezes me leva a recorrer ao uso do ChatGPT ou de modelos GPT via chamadas de API.
Aqui, quero explorar a ampla variedade de modelos disponíveis e destacar as principais capacidades que você deve considerar ao escolher o modelo adequado às características do seu projeto.
Vamos focar especialmente nos diferentes métodos de interação com esses modelos como um dos fatores-chave na escolha entre todas as opções disponíveis.
A ideia é que este guia completo funcione como um atalho, ajudando você a navegar pela enorme oferta de LLMs para as suas tarefas específicas.
Se você está começando agora no mundo dos LLMs, recomendo muito seguir o curso de AI Fundamentals e Large Language Models Concepts para se familiarizar com a terminologia básica e os modelos.
Acessar LLMs e integrá-los em uma aplicação ou projeto pode ser feito de várias formas, dependendo das necessidades técnicas.
A forma mais amigável para interfacear com LLMs é por meio de interfaces conversacionais no navegador. É o caso do ChatGPT, em que a interface do usuário é simplesmente um chat que permite interagir com o modelo.
Em geral, essas interfaces oferecem pouco ou nenhum controle ou personalização do modelo pelo usuário, mas são uma maneira fácil de testar modelos em tarefas simples. O ChatGPT da OpenAI e o Gemini do Google oferecem esse tipo de interface:
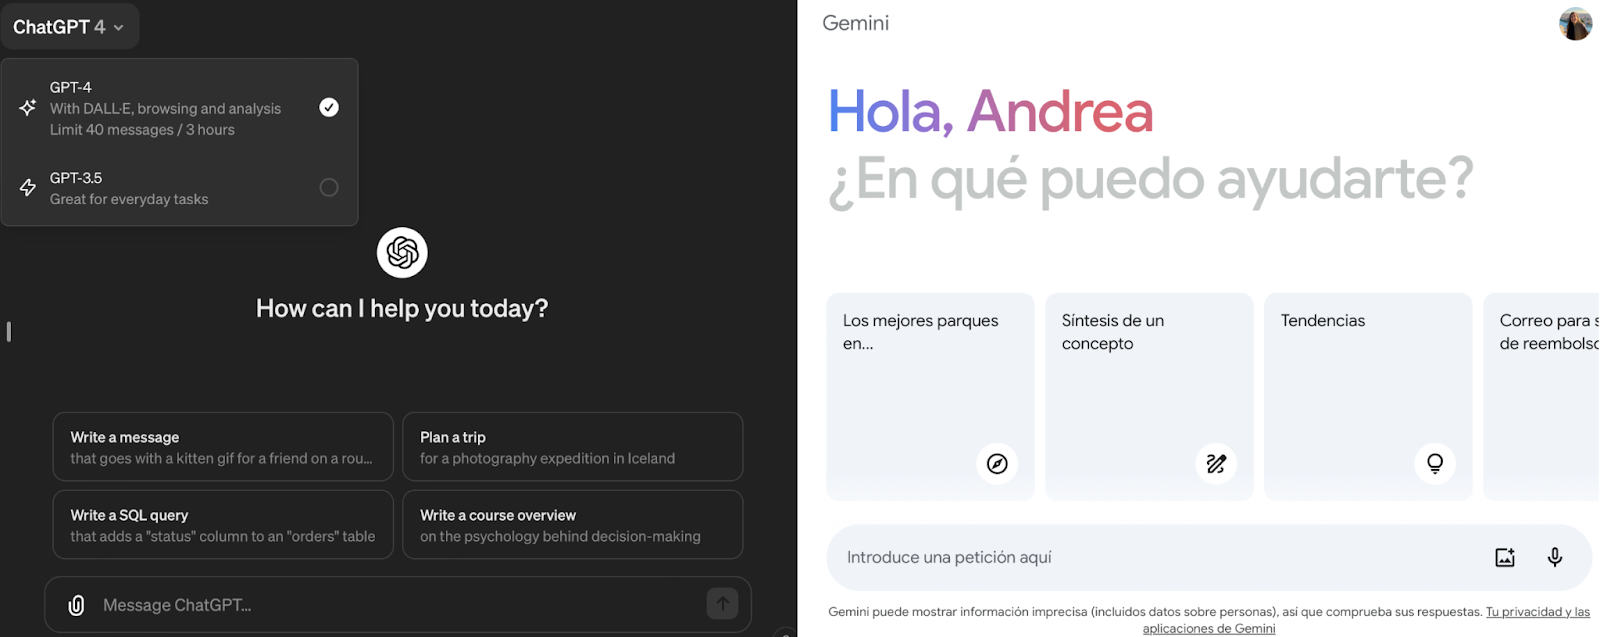
Captura de tela das interfaces de chat do ChatGPT (esquerda) e do Gemini (direita).
Alguns provedores também permitem certo nível de customização por interfaces de chat igualmente simples. No caso da OpenAI, a plataforma se chama “Playground”.
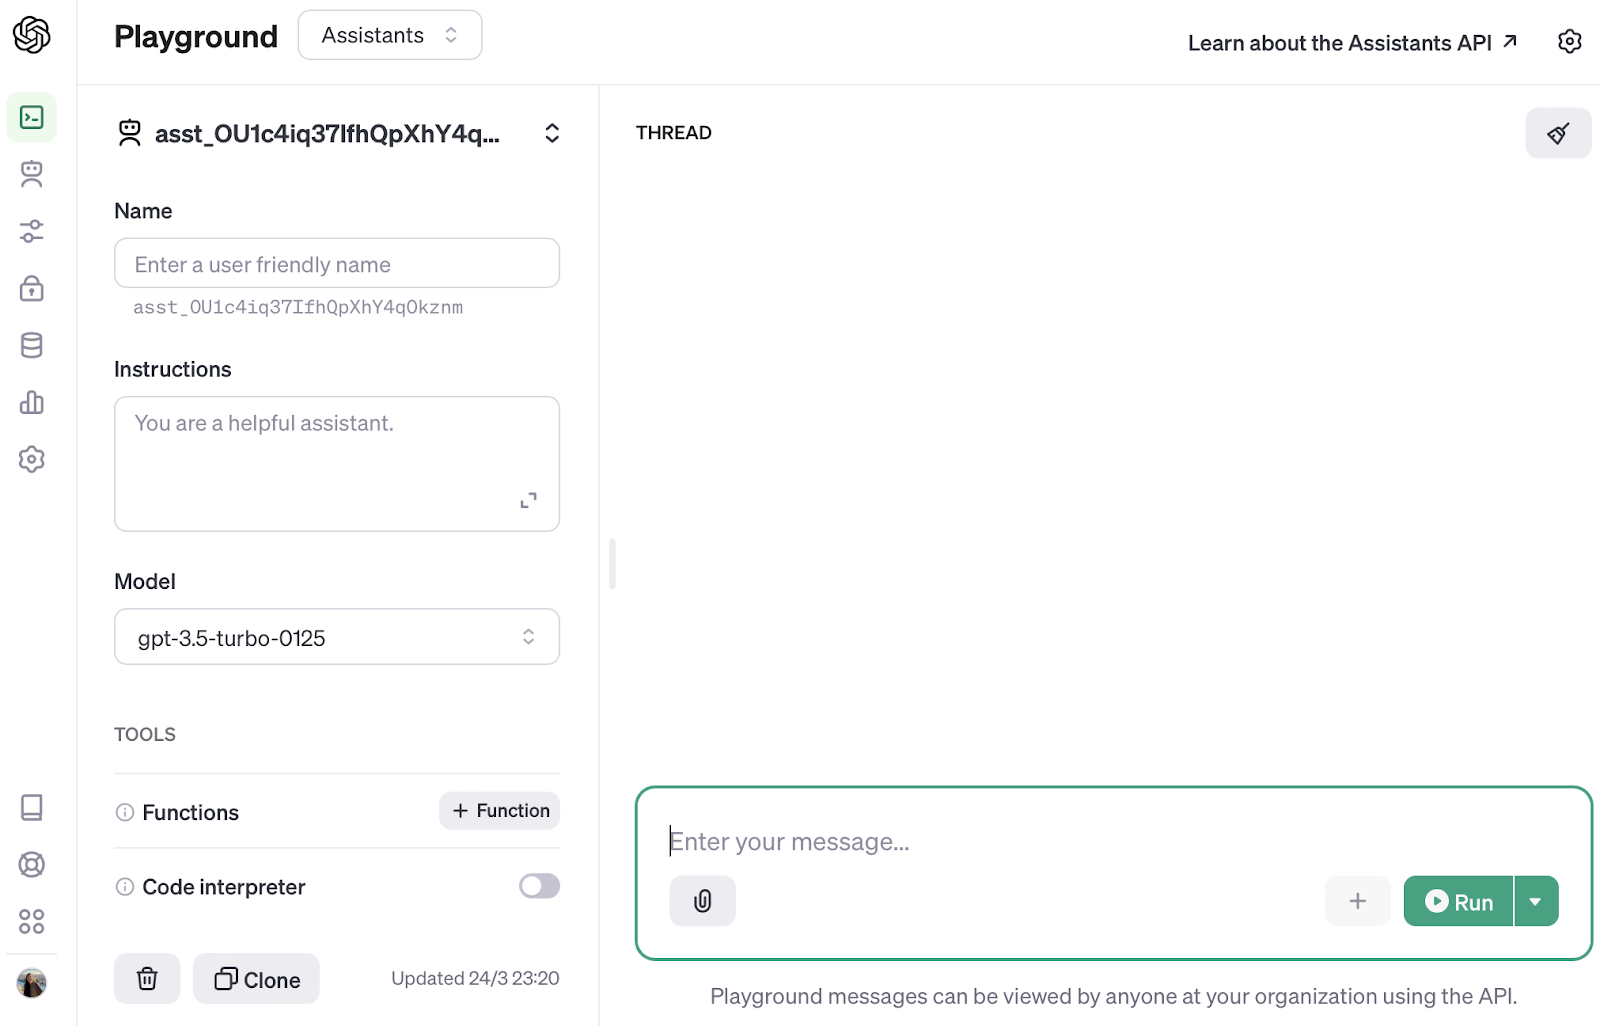
Captura de tela da interface do OpenAI Playground.
Interfaces de Playground permitem experimentar diferentes modelos com controle limitado de configurações. Assim, dá para explorar quais parâmetros são adequados à sua tarefa. Mesmo assim, como você provavelmente já percebeu, playgrounds ou interfaces de chat não permitem incorporar a interação com o LLM diretamente em uma aplicação ou projeto.
Uma das formas mais populares de consultar LLMs é via acesso por API. Essa abordagem é especialmente vantajosa quando não precisamos de personalizações avançadas do modelo.
Chamadas de API podem ser integradas aos seus scripts sem atrito, dispensando a necessidade de configurar e manter infraestrutura por conta própria.
Porém, conveniência tem custo e, apesar da dependência de serviços externos — uma dependência que você sempre terá se optar por não hospedar o modelo e gerenciar sua infraestrutura — os custos tendem a escalar com o uso.
No caso de chamadas de API, uma boa prática é implementar um simples wrapper em torno da chamada em si para se comunicar com o modelo de maneira modular. Para a API da OpenAI, que é a que mais usei até agora, sempre utilizo o wrapper da próxima seção, deixando a seleção do modelo transparente para o usuário.
Escrever um método padronizado e flexível para consultar modelos GPT pela API da OpenAI é muito útil se você quer interagir com o modelo de forma fluida e com menos propensão a erros. Por isso, costumo configurar a chamada ao GPT em uma função wrapper no início do programa, garantindo que o uso do modelo fique transparente para a aplicação.
A biblioteca openai (pip install openai) já oferece o endpoint ChatCompletion, que permite chamar qualquer modelo GPT usando o método .create.
O método .create tem dois parâmetros obrigatórios:
gpt-4.Com esses dois parâmetros, podemos escrever a chamada ao GPT assim:
prompt = "Hello world"
chat_completion = openai.ChatCompletion.create(model="gpt-3.5-turbo", messages=[{"role": "user", "content": prompt}])
Ao chamar o modelo, receberemos a conclusão em formato JSON:
{
 "choices": [
   {
     "finish_reason": "stop",
     "index": 0,
     "message": {
       "content": "Hello! How can I assist you today?",
       "role": "assistant"
     }
   }
 ],
 "created": 1692042919,
 "id": "chatcmpl-7nXwl0tywcTb91xeEuhpQbpRD6XLM",
 "model": "gpt-3.5-turbo-0613",
 "object": "chat.completion",
 "usage": {
   "completion_tokens": 9,
   "prompt_tokens": 9,
   "total_tokens": 18
 }
}
Logo, é interessante retornar apenas o texto da conclusão do modelo. Juntando tudo, nossa implementação de wrapper pode ser escrita assim:
def chatgpt_call(prompt, model="gpt-3.5-turbo"):
   response = openai.ChatCompletion.create(
       model=model,
       messages=[{"role": "user", "content": prompt}]
   )
   return response.choices[0].message["content"]
Se quiser mais detalhes sobre essa implementação, o artigo ChatGPT API Calls: A Gentle Introduction aprofunda o tema!
Por fim, vale notar que a maioria dos provedores de API, incluindo a OpenAI, oferece algumas chamadas gratuitas ao criar a conta. Ainda assim, os créditos são limitados (geralmente a menos de US$ 20) e normalmente valem por um período curto (geralmente um mês).
De qualquer forma, é sempre uma boa prática encapsular as chamadas de LLM em uma função — ou conjunto de funções — para que o modelo fique transparente para a aplicação, independentemente do provedor.
Hospedar o modelo por conta própria envolve baixar os pesos do modelo e executá-lo em máquinas locais ou servidores privados.
Essa abordagem é interessante por dar controle total sobre a infraestrutura do modelo, mas também eleva consideravelmente o esforço técnico.
Se você tem curiosidade sobre as etapas para operar a infraestrutura de um LLM, confira o artigo LLMOps Essentials!
Executar o modelo localmente permite customizações adicionais conforme nossas necessidades. Nesse contexto, uma das escolhas populares para auto-hospedagem é a conhecida família LLaMa, da Meta AI. Eles lançaram modelos leves que rodam em um laptop com apenas 8 GB de RAM.
Rodar o LLaMa no nosso laptop é relativamente simples, graças a plataformas como a Ollama.
A Ollama oferece uma plataforma para executar LLMs como o LLaMa 2 e o Code LLaMa localmente nos dispositivos. Há suporte para macOS, Linux e Windows, permitindo personalização e criação de modelos proprietários. Para mais detalhes, visite o site da Ollama.
O download da plataforma Ollama pode ser feito na página oficial, enquanto os pesos dos modelos podem ser obtidos diretamente pelo terminal.
Vamos instalar a Ollama começando pela página principal!
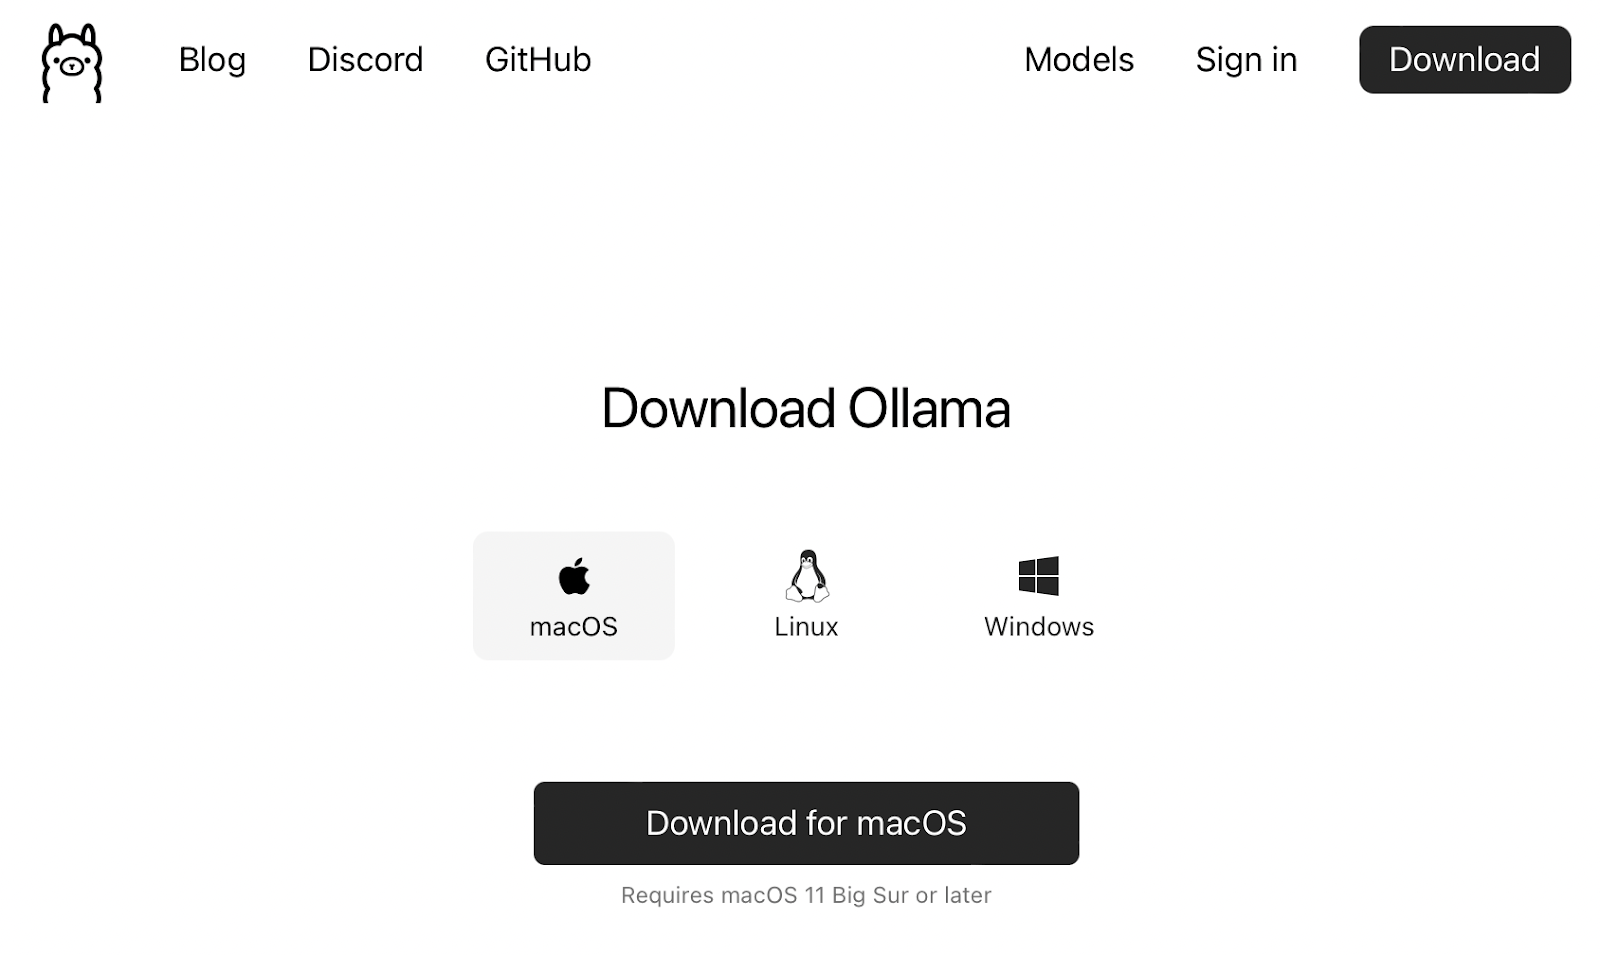 Captura de tela da página principal do site da Ollama.
Neste caso, a Ollama é uma ferramenta de linha de comando:
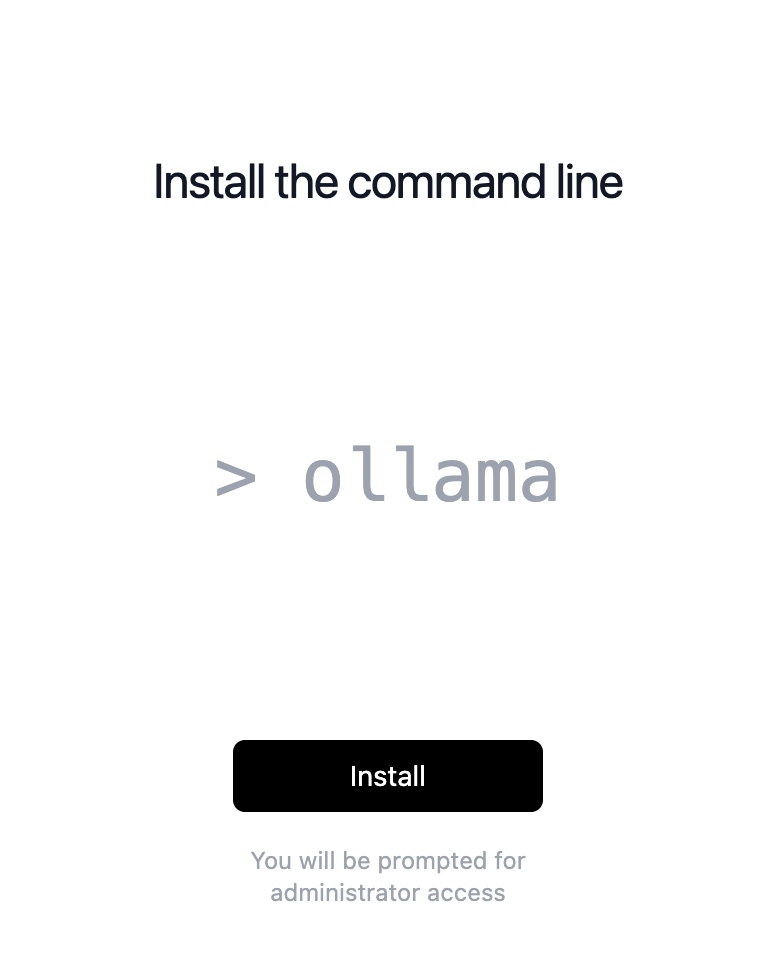
Captura de tela da instalação da ferramenta de linha de comando da Ollama.
Depois de instalada a ferramenta de linha de comando, podemos iniciar o modelo com o comando ollama run <model name>. Se for a primeira execução no dispositivo, a Ollama fará o pull do modelo automaticamente:
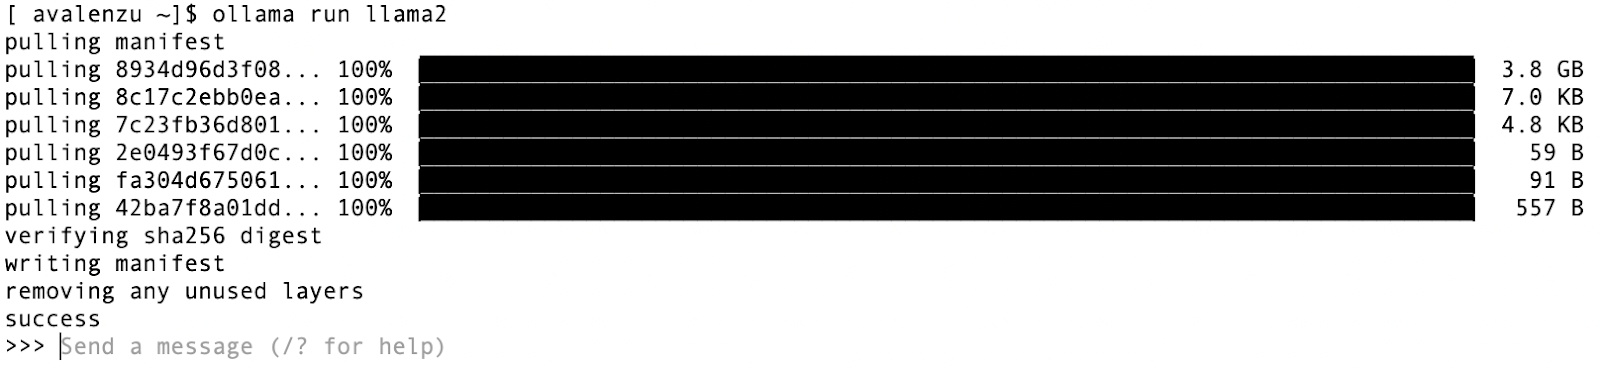
Captura de tela da primeira execução do modelo LLaMa 2 com a ferramenta de linha de comando da Ollama. O modelo é baixado automaticamente na primeira utilização.
A partir daí, enviar prompts e sair do modelo pelo terminal é bem direto:
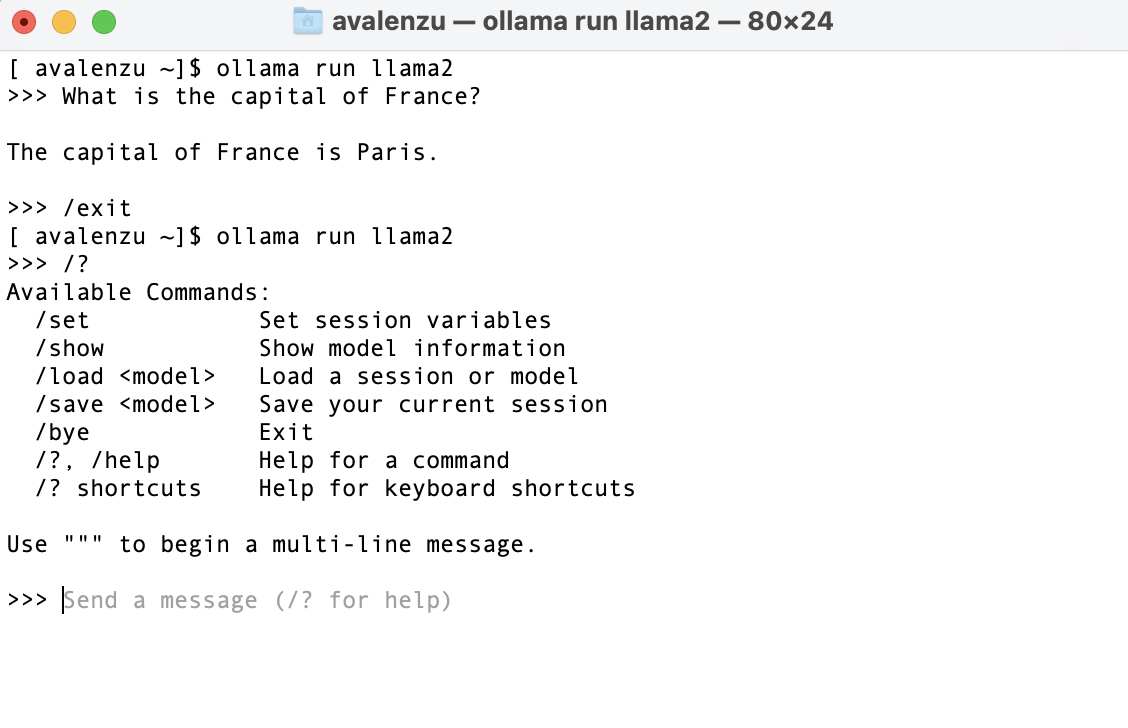
Captura de tela da interação do usuário com o modelo via linha de comando da Ollama.
Como dá para ver na imagem acima, o modelo também oferece um pequeno conjunto de comandos extras.
A Ollama também suporta outros modelos, como o novo Mistral:
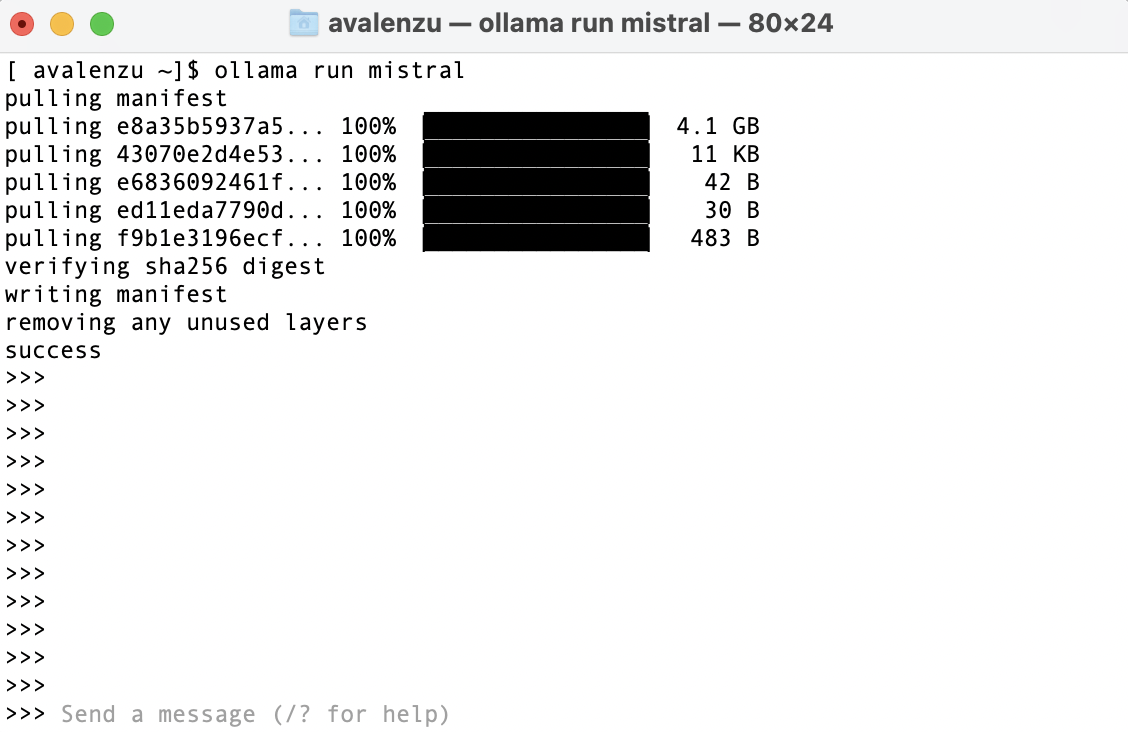
Captura de tela da primeira execução do modelo Mistral com a ferramenta de linha de comando da Ollama. O modelo é baixado automaticamente na primeira utilização.
Mais uma vez, o modelo já fica pronto para uso com um único comando!
Essa abordagem é vantajosa porque consome apenas os recursos do nosso dispositivo. No entanto, é importante lembrar que o desempenho do modelo geralmente aumenta com o número de parâmetros.
Consequentemente, quanto mais parâmetros um modelo tem, mais recursos ele exige. Portanto, modelos maiores provavelmente precisarão rodar em servidores privados para aplicações de LLM auto-hospedadas.
Se quisermos construir uma aplicação em grande escala, vale notar que a Ollama também pode rodar com Docker Desktop no Mac e dentro de contêineres Docker com aceleração de GPU no Linux.
Talvez você esteja se perguntando: dá para incorporar a OLLAMA nos meus scripts?
Sim, hospedar o modelo por conta própria não impede a integração com seus scripts em Python! A Ollama também permite interfacear com o modelo auto-hospedado via Python.
As bibliotecas de Python e JavaScript da Ollama permitem incorporar a inferência do modelo nos seus scripts.
A Ollama não é a única opção para hospedar modelos por conta própria. Em geral, LLMs costumam estar disponíveis para download em várias plataformas open source, que também oferecem suporte da comunidade.
LLMs de código aberto geralmente estão disponíveis sem custo para fins acadêmicos e de pesquisa. No entanto, os termos para uso comercial variam conforme a licença específica de cada modelo. Sempre verifique se você está apenas experimentando LLMs ou construindo aplicações baseadas em LLM para fins comerciais.
Quer começar hoje sua jornada em desenvolvimento de LLMs? Então o curso Developing Large Language Models é para você!
Hospedar modelos poderosos localmente pode exigir muitos recursos; por isso, usar serviços em nuvem é uma alternativa viável, possibilitando escalar os recursos sob demanda e contar com o suporte dos provedores.
Vale destacar que serviços de nuvem tradicionais, como o Azure, já oferecem pipelines personalizados para hospedar LLMs, como o Mistral, sem exigir que você implemente toda a hospedagem especializada.
Isso é uma grande vantagem para implantar aplicações dentro da sua organização, já que muitas empresas já têm contratos com esses provedores para e-mail e soluções de nuvem em geral.
Optar por provedores de terceiros pode oferecer um meio-termo entre não gerenciar a infraestrutura de hospedagem e ter algum controle sobre o modelo, em comparação com o uso apenas de uma API nativa.
Esses provedores normalmente oferecem acesso por API, mas é importante notar que os custos podem aumentar significativamente com uso intenso, de forma semelhante ao uso da API nativa da OpenAI.
A principal diferença está em quem hospeda. Provedores de terceiros, e não os serviços nativos dos LLMs, hospedam o modelo na sua própria infraestrutura e expõem o endpoint de API, muitas vezes oferecendo uma variedade de modelos de diferentes fontes para integrações mais flexíveis.
Um provedor de API de terceiros bastante conhecido é a LLAMA API.
Captura de tela da página principal do site da LLAMA API.
A API não é gratuita, mas você pode testar: novas contas recebem US$ 5 em créditos. Lembre-se de que esses créditos valem por apenas um mês após serem concedidos.
Usar a LLAMA API é bem simples. Depois de instalar (pip install llamaapi), podemos fazer uma primeira chamada de teste assim:
from llamaapi import LlamaAPI
import json

llama = LlamaAPI('<Insert API key here>')
prompt = "Which is the capital of France?"

api_request_json = {
  "model": "llama-13b-chat",
  "messages": [
    {"role": "system", "content": "You are a friendly chatbot."},
    {"role": "user", "content": prompt},
  ]
}

response = llama.run(api_request_json)
print(json.dumps(response.json(), indent=2))
Contudo, assim como na API da OpenAI, é uma boa prática encapsular a chamada de API em uma função wrapper. Seguindo a mesma lógica de antes:
def llm_call(prompt, model="llama-13b-chat"):
    api_request_json = {
        "model": model,
        "messages": [
            {"role": "system", "content": "You are a friendly chatbot."},
            {"role": "user", "content": prompt},
        ]
    }
    response = llama.run(api_request_json)
    return response.json()["choices"][0]["message"]["content"]
Com essa implementação, receberemos a resposta do LLM como string simplesmente chamando llm_call():
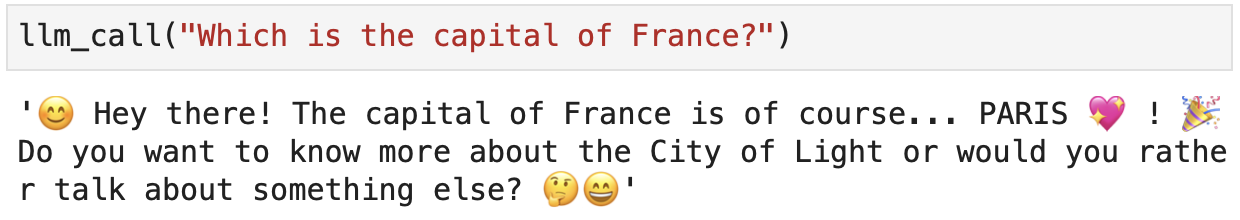
A LLAMA API suporta vários modelos de ponta, não apenas o LLaMa da Meta. Vamos ver na próxima seção quais modelos ela oferece suporte!
Por fim, no caso da LLAMA API, o custo da API depende do número de parâmetros do modelo e parece ser constante entre modelos:
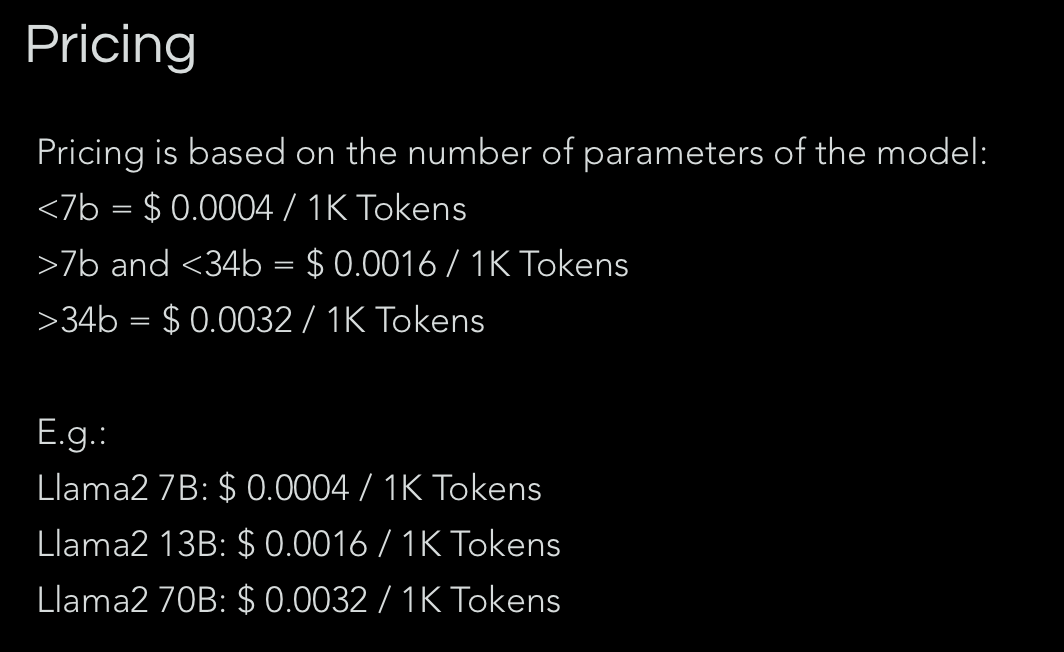
Captura de tela de preços da LLAMA API. Essa informação só fica disponível após a criação de uma conta.
O provedor de terceiros mais popular para LLMs é o Hugging Face. O Hugging Face é mais conhecido pela biblioteca transformers, a mais popular em Python para Processamento de Linguagem Natural.
O Hugging Face oferece múltiplas interfaces de acesso a LLMs. Ele tem uma interface amigável de playground chamada “Spaces”:

Captura de tela do playground “Spaces” no Hugging Face.
Também permite hospedagem de modelos e implantação de endpoints, além de download direto para uso local.
É importante lembrar que o Hugging Face é um tipo de “site para desenvolvedores”, então, embora você encontre tutoriais para começar, escalar uma aplicação com os modelos exige conhecimento técnico.
Se quiser aprender mais sobre o Hugging Face, recomendo o artigo What is Hugging Face? The AI Community's Open-Source Oasis.
Uma ferramenta complementar que costumo usar para construir aplicações com LLMs do zero, junto com o Hugging Face, é o LangChain. O tutorial How to Build LLM Applications with LangChain traz uma ótima introdução prática.
Falamos sobre diferentes formas de acessar e executar LLMs, como os modelos GPT, LLaMa e Mistral. Mas há muitos outros modelos disponíveis, incluindo várias variantes dos citados. Nesta seção, vamos classificar os principais modelos existentes hoje, listando suas características, preços e casos de uso.
Os modelos da OpenAI se tornaram muito populares desde o lançamento do ChatGPT, hoje baseado em GPT-3.5 ou GPT-4, dependendo da sua assinatura. Para muitas tarefas básicas, a diferença entre GPT-3.5 e GPT-4 não é tão significativa.
Porém, o GPT-4 mostra capacidade muito superior em cenários de raciocínio mais complexos em comparação com os modelos anteriores.
Além disso, o GPT-4 é multimodal, aceita entradas de texto ou imagem e gera saídas em texto. Ele também oferece a possibilidade de usar plugins para se conectar a fontes externas. Navegar na internet é um exemplo, como no uso de buscas do Bing.
Existem três variantes principais do GPT-4 acessíveis pela API da OpenAI para clientes pagantes:
|
Modelo |
Características |
Janela de contexto |
API |
Local |
Preço por token |
Dados de treino |
|
GPT-4 |
Instantâneo do gpt-4 de 13 de junho de 2023. Este endpoint recebe atualizações constantes. Otimizado para chat. |
8.192 tokens |
Não |
US$ 0,03 / 1K tokens (entrada) US$ 0,06 / 1K tokens (saída) |
dez 2023 |
|
|
GPT-4 Turbo |
Nome na API: gpt-4-turbo-preview. Excelente em tarefas como geração de código e projetado para reduzir casos de “preguiça”. |
128k tokens |
Não |
US$ 0,01 / 1K tokens (entrada) US$ 0,03 / 1K tokens (saída) |
dez 2023 |
|
|
GPT-4 Vision |
Nome na API: gpt-4-vision-preview. GPT-4 com capacidade de entender imagens, além de todos os recursos do GPT-4 Turbo. |
128k tokens |
Não |
US$ 0,01 / 1K tokens (entrada) US$ 0,03 / 1K tokens (saída) |
abr 2023 |
Em geral, é interessante notar que os modelos GPT, ao contrário dos LLaMa, são de código fechado. Isso significa que não podemos executá-los localmente nem implantar nosso próprio endpoint.
Ainda assim, há possibilidade de personalização usando a Fine-tuning API da OpenAI. Além disso, eles não são acessíveis por provedores de terceiros como Ollama, LLAMA API ou Hugging Face.
No caso do OpenAI Playground, as informações do modelo por trás não são exibidas claramente, mas parece ser baseado no GPT-4 com recursos de DALL-E, navegação e análise.
Vamos também dar uma olhada nos modelos GPT-3 disponíveis!
|
Modelo |
Características |
Janela de contexto |
API |
Local |
Preço por token |
Dados de treino |
|
GPT-3.5 Turbo |
Nome na API: gpt-3.5-turbo. É o principal modelo dessa família. Otimizado para diálogo e com maior precisão para responder em formatos solicitados. |
16.385 tokens |
Não |
US$ 0,0005 / 1K tokens (entrada) US$ 0,0015 / 1K tokens (saída) |
set 2021 |
|
|
GPT-3.5 Turbo Instruct |
Nome na API: gpt-3.5-turbo-instruct. Foco em precisão e relevância das respostas, alinhando-se de perto às necessidades do usuário. |
4.096 tokens |
Não |
US$ 0,0015 / 1K tokens (entrada) US$ 0,0020 / 1K tokens (saída) |
set 2021 |
O modelo GPT-3.5 Turbo Instruct apresentado na tabela foi ajustado para seguir melhor as intenções do usuário via Reinforcement Learning from Human Feedback (RLHF).
RLHF é uma técnica em que feedback humano é integrado ao processo de reinforcement learning para orientar e melhorar os resultados do aprendizado dos agentes de IA. Essa abordagem permite desenvolver modelos mais alinhados a valores e preferências humanas, incorporando julgamentos, correções ou preferências diretamente no ciclo de treino.
Por fim, como vemos na tabela, vale notar que o uso de qualquer um dos dois modelos GPT-3.5 é consideravelmente mais barato do que o GPT-4.
Nesse ponto, geralmente recomendo comparar o desempenho de cada modelo em um conjunto de exemplos bem definidos para ver se o GPT-3.5 dá conta da tarefa — assim você economiza na inferência.
Como vimos nas seções anteriores, os modelos LLaMa são gratuitos para download e execução local, além de permitirem construir customizações por cima.
Os LLaMa formam uma grande família de modelos abertos, com vários tamanhos e variantes, fornecida pela Meta AI:
|
Modelo |
Características |
Janela de contexto |
API |
Local |
Variante |
Dados de treino |
|
LLaMa 2 |
Modelo base não conversacional para tarefas de completion. |
4.096 tokens |
Sim |
Sim* |
7B 13B 70B |
set 2022 |
|
LLaMa 2 Chat |
LLaMa 2 base com instruction tuning para transformar completions simples em um modelo de chat que segue a intenção do usuário. |
4.096 tokens |
Sim |
Sim* |
7B 13B 70B |
set 2022 |
|
LLaMa 2 Guard |
Modelo de proteção de entrada/saída treinado para detectar conteúdo tóxico e prejudicial. |
4.096 tokens |
Sim** |
Não |
7B |
set 2022* |
*O Hugging Face também disponibiliza algumas variantes do LLaMa, como os modelos base e chat. **Por enquanto, o LLaMa 2 Guard está acessível no ambiente em nuvem do Amazon SageMaker.
Diferente dos GPT, que já têm capacidades de código integradas, os LLaMa possuem modelos dedicados para codificação, com janelas de contexto maiores de 16k tokens obtidas via fine-tuning para contexto longo.
|
Modelo |
Características |
Janela de contexto |
API |
Local |
Variante |
Dados de treino |
|
Code LLaMa |
Modelo base não conversacional para code completion, como o GitHub Copilot. Consiste em um LLaMa 2 com treino adicional em código e fine-tuning para contexto longo. |
16k |
Não |
Sim |
7B 13B 34B |
set 2022* |
|
Code LLaMa - Instruct |
Derivado de modelos Instruct. Excelente em completions e explicações de trechos de código. |
16k |
Sim |
Sim |
7B 13B 34B |
set 2022* |
|
Code LLaMa - Python |
Ajustado especificamente para a linguagem Python. |
16k |
Não |
Sim |
34B |
set 2022* |
* A data oficial de corte dos dados dos LLaMa é set 2022. No entanto, os dados de ajuste são mais recentes, de 2023, especialmente nas variantes novas.
O Google tem um longo histórico no desenvolvimento de LLMs. Com a introdução do modelo Gemini, o Google iniciou sua geração de LLMs multimodais.
No portfólio do Google, o Gemini surge como o modelo principal, sendo de código fechado, semelhante ao ChatGPT. Porém, recentemente eles lançaram o Gemma, que apresenta uma linha de modelos open source derivados do Gemini, facilitando o desenvolvimento acessível em IA.
Neste artigo, vamos focar tanto no Gemini quanto no Gemma:
|
Modelo |
Características |
API |
Local |
Variantes |
|
Gemini |
Modelo de código fechado para tarefas gerais (geração de texto, tradução, perguntas e respostas, código etc.). |
Sim* |
Não |
Ultra - Resolve tarefas complexas. Pro - Ampla gama de tarefas. Escalável. Nano - Eficiente em dispositivos. |
|
Gemma |
Tarefas similares ao Gemini, mas focado em integração em aplicações personalizadas e pesquisa. É um modelo leve. |
Sim**LLAMA API |
SimOllama |
2B 7B |
*Há uma API do Gemini para fins comerciais (não aberta a implantações próprias). Ainda assim, podemos testar o modelo via sua interface Playground.
**Não há endpoint nativo do Google, mas o modelo é acessível pelo Kaggle e pelo Google Colab. Mais informações na documentação oficial do Google.
Quanto às variantes do Gemini, o Gemini Ultra é multimodal e se destaca em análises complexas. O Gemini Pro equilibra desempenho e escalabilidade, com destaque em tarefas como geração de código e texto. Por fim, o Gemini Nano prioriza eficiência para uso em dispositivos, rodando em celulares e dispositivos de borda sem exigir muitos recursos.
Sobre os modelos do Google, há pouca informação pública sobre janelas de contexto e a data de corte dos dados de treino no momento da escrita.
Mistral AI é uma empresa francesa de IA fundada em abril de 2023 por ex-funcionários da Meta e do Google DeepMind. Ela foca no desenvolvimento de LLMs open source, enfatizando a importância de software aberto em resposta a modelos proprietários. A empresa oferece modelos como o Mistral 7B e o Mixtral 8x7B, com capacidades avançadas de processamento de linguagem.
|
Modelo |
Características |
Janela de contexto |
API |
Local |
Preço por token |
Dados de treino |
|
Mistral |
Modelo de propósito geral com 7B de parâmetros. Otimizado para inglês e geração de código. |
32k |
Sim* |
Sim |
US$ 0,25 / 1M tokens (entrada e saída) |
set 2023 |
|
Mixtral |
Modelo de propósito geral mais poderoso. Fluente em inglês, francês, italiano, alemão e espanhol, e muito forte em tarefas de código. Baseado em uma arquitetura esparsa Mixture-of-Experts de 7B parâmetros. |
32k |
Sim* |
Sim |
US$ 0,70 / 1M tokens (entrada e saída) |
dez 2023 |
*Podemos interagir com os modelos da Mistral AI usando o Playground chamado “La Plataforme”.
** O Hugging Face também oferece um ambiente de testes para inferência em tempo real usando sua API para alguns modelos. É igualmente um provedor de terceiros que permite implantar endpoints pagos para os modelos disponíveis.
Quanto ao Mixtral, a arquitetura “Mixture-of-Experts” permite que o modelo divida suas capacidades entre diferentes grupos especializados ou “experts”. Cada expert é otimizado para tipos específicos de tarefa ou dados.
Ao processar uma entrada, o Mixtral aciona dinamicamente apenas os experts relevantes, conseguindo lidar com tarefas complexas usando uma fração dos parâmetros totais por token. Isso melhora o desempenho e otimiza o uso computacional, tornando-o competente em vários idiomas e tarefas. O nome "Mixtral 8x7B" referencia justamente o uso de 8 grupos distintos de “experts”.
Por fim, a Mistral AI também oferece três modelos comerciais: Mistral Small, Mistral Medium e Mistral Large. Se tiver interesse, encontre mais informações sobre modelos e preços na documentação oficial.
Até aqui, vimos vários modelos e variantes das empresas mais famosas do setor. Mas há muito mais para explorar!
Destaco os modelos Falcon do Technology Innovation Institute, disponíveis tanto na Ollama quanto na LLAMA API. Há também o Orca2 da Microsoft Research, que se destaca especialmente em raciocínio, disponível na Ollama e no Hugging Face.
Você pode ler sobre outros modelos open source em 8 Top Open-Source LLMs for 2024 and Their Uses.
Neste artigo, discutimos vários pontos a considerar ao selecionar o melhor Large Language Model para sua aplicação-alvo. Embora o objetivo deste guia seja servir como um atalho, não existe uma regra de ouro que aponte de cara o melhor modelo.
Pela minha experiência, definir como você quer interagir com o LLM é um bom começo, pois isso já reduz o número de modelos — e variantes — a avaliar.
O segundo ponto é a tarefa objetiva que o modelo vai executar: chatbot genérico, especialista em sumarização, assistente de código etc.
Embora sempre possamos fazer fine-tuning para a tarefa desejada, vimos que já existem variantes ajustadas para certos casos de uso que poupam tempo, recursos computacionais e conhecimento técnico. Considerar a janela de contexto necessária para a aplicação também é crucial para escolher o melhor modelo.
Por fim, o preço sempre é um bom indicador de qual modelo usar. Muitas vezes, o projeto em si fica limitado pelo investimento inicial e pelo custo de manutenção ao longo do tempo. Em relação a custos, é importante lembrar que treino e fine-tuning são serviços pagos a considerar no desenvolvimento — e, na prática, demandam bastante tempo.
Continue sua jornada em IA hoje mesmo!
Programa
Curso
Curso
blog
Stanislav Karzhev
9 min
blog
Abid Ali Awan
13 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
8 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
8 min