Cursus
Principes fondamentaux de l'IA
10 h
Depuis le lancement de ChatGPT, on a l'impression qu'un nouveau grand modèle de langage (LLM) voit le jour tous les quelques jours, accompagné de nouvelles entreprises spécialisées dans cette technologie. Chaque nouveau LLM est entraîné pour surpasser le précédent sur différents aspects. Par exemple, on voit de plus en plus de LLM conçus pour un cas d'usage précis : modèles de chat, assistants de codage, compréhension de longs contextes, et bien d'autres.
Choisir le bon modèle pour une nouvelle application ou un nouveau projet basé sur un LLM peut s'avérer complexe, sans parler de la difficulté à rester à jour sur les derniers modèles et leurs fonctionnalités.
Dans mon cas, cela m'amène souvent à me rabattre par défaut sur ChatGPT ou sur les modèles GPT via des appels d'API.
Mon objectif ici est d'examiner la diversité des modèles disponibles et de mettre en avant les capacités clés à considérer pour choisir le bon modèle en fonction des caractéristiques du projet.
Nous allons notamment nous concentrer sur les différentes méthodes d'interaction avec ces modèles, l'une des fonctionnalités essentielles à prendre en compte pour trancher entre tous les modèles disponibles.
Le but est que ce guide complet serve d'aide‑mémoire, pour vous aider à naviguer dans la vaste sélection de LLM selon vos tâches.
Si vous découvrez l'univers des LLM, je vous recommande vivement de suivre les cours AI Fundamentals et Large Language Models Concepts afin de vous familiariser avec le vocabulaire et les modèles de base.
L'accès aux LLM et leur intégration dans une application ou un projet propulsé par des LLM peuvent se faire de plusieurs façons selon les besoins techniques.
L'approche la plus simple pour interagir avec des LLM consiste à utiliser des interfaces conversationnelles dans le navigateur. C'est le cas de ChatGPT, dont l'interface utilisateur est simplement une interface de chat qui vous permet d'interagir avec le modèle.
En général, ces interfaces offrent peu (voire pas) de contrôle ou de personnalisation du modèle par l'utilisateur, mais c'est un moyen facile de tester des modèles pour des tâches simples. ChatGPT d'OpenAI et Gemini de Google proposent ce type d'interfaces :
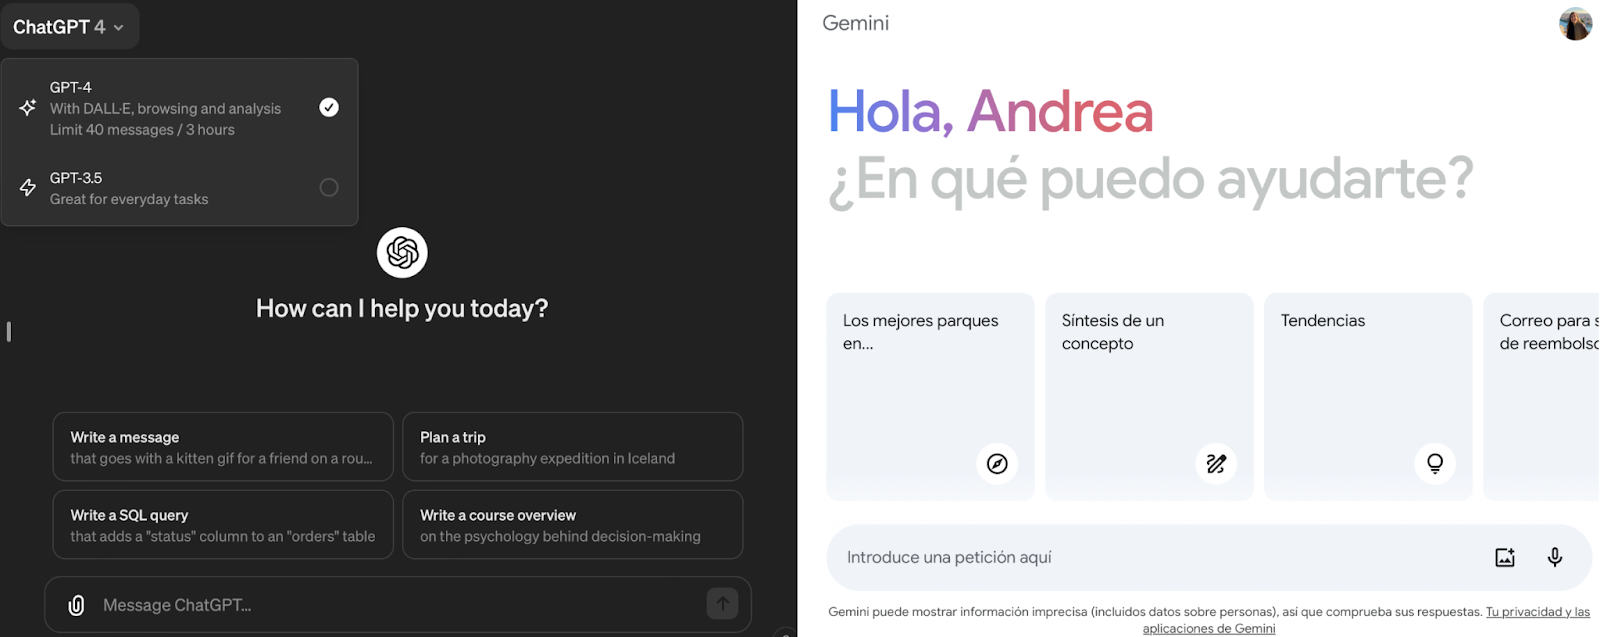
Capture d'écran des interfaces de chat de ChatGPT d'OpenAI (à gauche) et de Gemini de Google (à droite).
Parfois, certains fournisseurs permettent aussi un certain degré de personnalisation via des interfaces de chat tout aussi conviviales. Chez OpenAI, la plateforme s'appelle « Playground ».
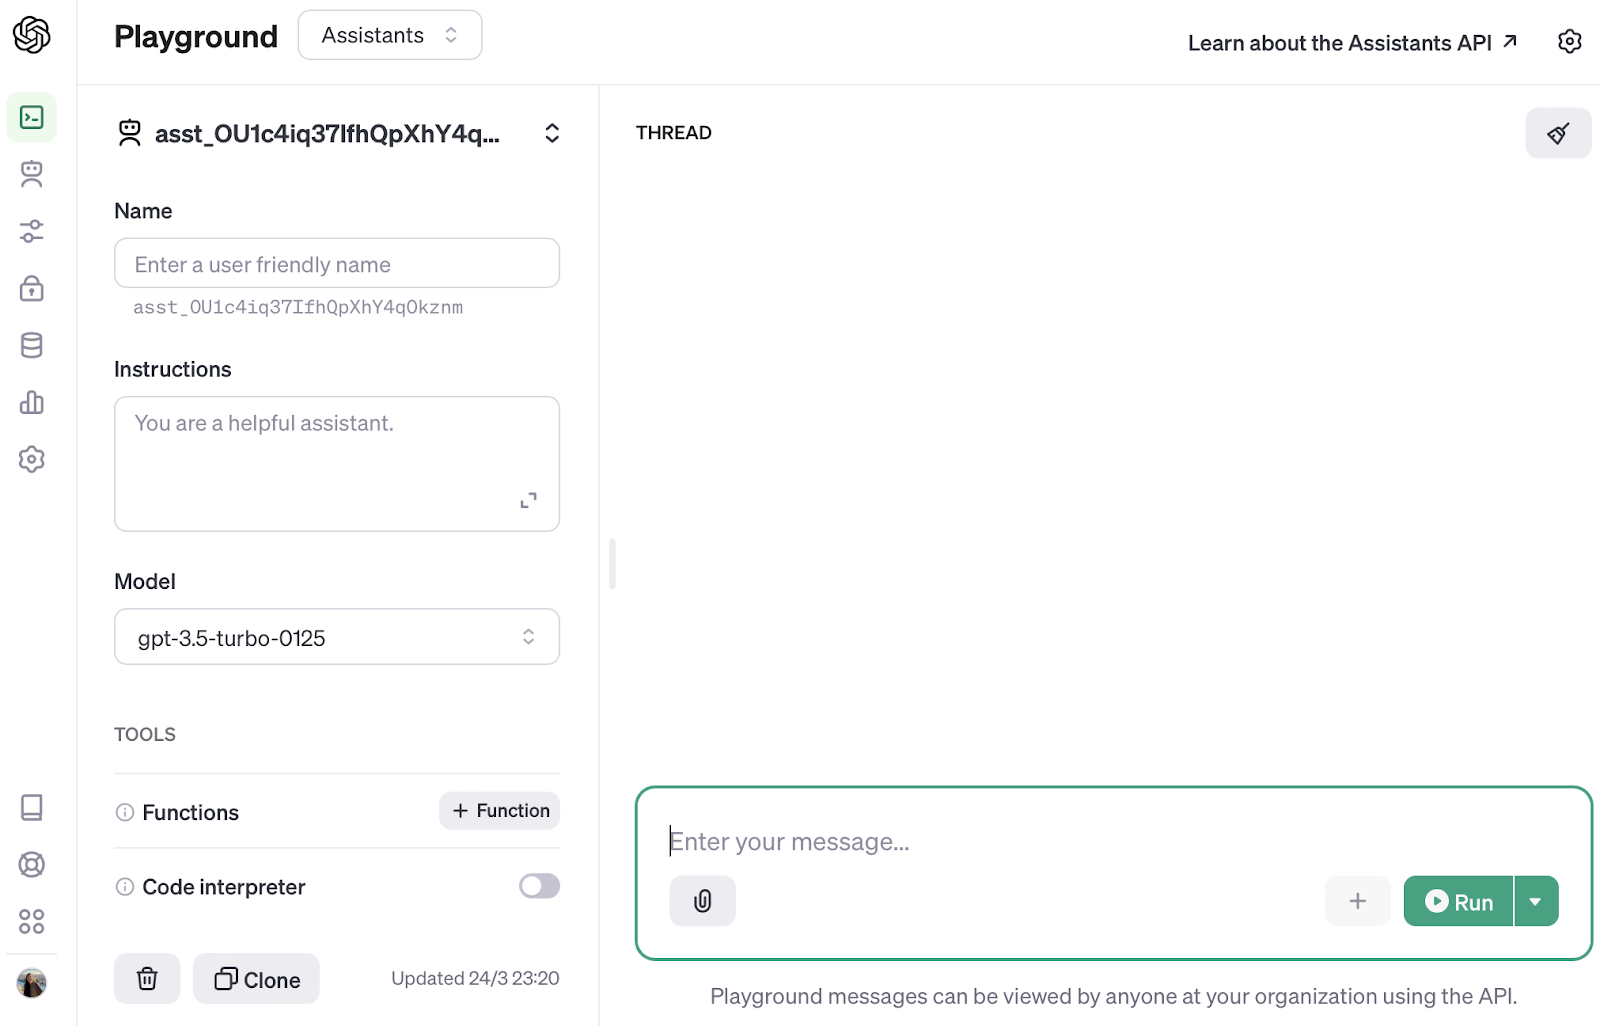
Capture d'écran de l'interface OpenAI Playground.
Les interfaces de type Playground permettent d'essayer différents modèles avec un contrôle limité des paramètres. On peut ainsi explorer quels réglages conviennent à votre tâche. Néanmoins, vous l'avez sans doute déjà constaté, les interfaces Playground ou de chat ne permettent pas d'embarquer l'interaction avec le LLM dans une application ou un projet.
L'un des moyens les plus populaires d'interroger des LLM passe par l'accès API. Cette approche est particulièrement avantageuse lorsque nous n'avons pas besoin d'une personnalisation poussée du modèle.
Les appels d'API s'intègrent sans effort à nos scripts, sans configuration ni maintenance d'infrastructure de notre côté.
Cependant, cette commodité a un coût : en déléguant à des services externes — une dépendance que vous conserverez si vous préférez ne pas héberger le modèle ni gérer son infrastructure — les coûts évolueront inévitablement avec l'usage.
Pour les appels API, une bonne pratique consiste à implémenter un simple « wrapper » autour de l'appel lui‑même afin d'interfacer le modèle de façon modulaire. Pour l'API OpenAI, que j'ai le plus utilisée jusqu'ici, j'opte toujours pour l'enveloppe présentée dans la section suivante afin que la sélection du modèle reste transparente pour l'utilisateur.
Écrire une méthode standardisée mais flexible pour interroger les modèles GPT via l'API OpenAI est très utile si vous souhaitez interfacer le modèle en douceur et réduire les erreurs. C'est pourquoi je place généralement l'appel GPT dans une fonction d'enrobage au début du programme, garantissant que l'utilisation du modèle est transparente pour l'application.
La bibliothèque openai (pip install openai) propose déjà un endpoint ChatCompletion qui permet d'appeler n'importe quel modèle GPT via la méthode .create.
La méthode .create a deux paramètres obligatoires :
gpt-4.Avec ces deux paramètres, on peut écrire l'appel GPT comme suit :
prompt = "Hello world"
chat_completion = openai.ChatCompletion.create(model="gpt-3.5-turbo", messages=[{"role": "user", "content": prompt}])
Lors de l'appel au modèle, nous obtenons une complétion au format JSON :
{
 "choices": [
   {
     "finish_reason": "stop",
     "index": 0,
     "message": {
       "content": "Hello! How can I assist you today?",
       "role": "assistant"
     }
   }
 ],
 "created": 1692042919,
 "id": "chatcmpl-7nXwl0tywcTb91xeEuhpQbpRD6XLM",
 "model": "gpt-3.5-turbo-0613",
 "object": "chat.completion",
 "usage": {
   "completion_tokens": 9,
   "prompt_tokens": 9,
   "total_tokens": 18
 }
}
Il est donc intéressant de ne renvoyer que le texte de la complétion comme valeur de retour de la fonction. En rassemblant toutes les pièces, notre wrapper peut s'écrire ainsi :
def chatgpt_call(prompt, model="gpt-3.5-turbo"):
   response = openai.ChatCompletion.create(
       model=model,
       messages=[{"role": "user", "content": prompt}]
   )
   return response.choices[0].message["content"]
Si cette implémentation vous intéresse, l'article ChatGPT API Calls : A Gentle Introduction entre davantage dans les détails !
Enfin, il convient de noter que la plupart des fournisseurs d'API, dont OpenAI, offrent quelques appels gratuits à la création du compte. Les crédits restent toutefois limités (généralement moins de 20 $) et valables sur une durée restreinte (souvent un mois).
Dans tous les cas, il est toujours recommandé d'encapsuler les appels LLM dans une fonction — ou un ensemble de fonctions — afin que le modèle soit transparent pour l'application, quel que soit le fournisseur.
Héberger le modèle vous‑même consiste à télécharger ses poids puis à l'exécuter sur des machines locales ou des serveurs privés.
Cette approche est séduisante car elle offre un contrôle total sur l'infrastructure du modèle, mais elle implique aussi un effort technique bien plus important.
Si vous êtes curieux des étapes nécessaires pour faire tourner l'infrastructure d'un LLM, consultez l'article LLMOps Essentials !
Exécuter le modèle en local permet une personnalisation poussée selon nos besoins. Dans ce cadre, l'une des options les plus populaires pour l'auto‑hébergement est la famille LLaMa de Meta AI. Meta a publié des modèles légers pouvant tourner sur un ordinateur portable avec seulement 8 Go de RAM.
L'exécution d'un modèle LLaMa sur un ordinateur portable est assez simple grâce à des plateformes comme Ollama.
Ollama propose une plateforme conçue pour exécuter localement des LLM comme LLaMa 2 et Code LLaMa sur nos appareils. Elle prend en charge macOS, Linux et Windows, et permet de personnaliser et créer vos propres modèles. Pour plus d'informations, consultez le site d'Ollama.
Le téléchargement d'Ollama se fait depuis la page officielle, tandis que les poids des modèles peuvent être récupérés directement via le terminal.
Commençons par installer Ollama en nous rendant sur sa page principale !
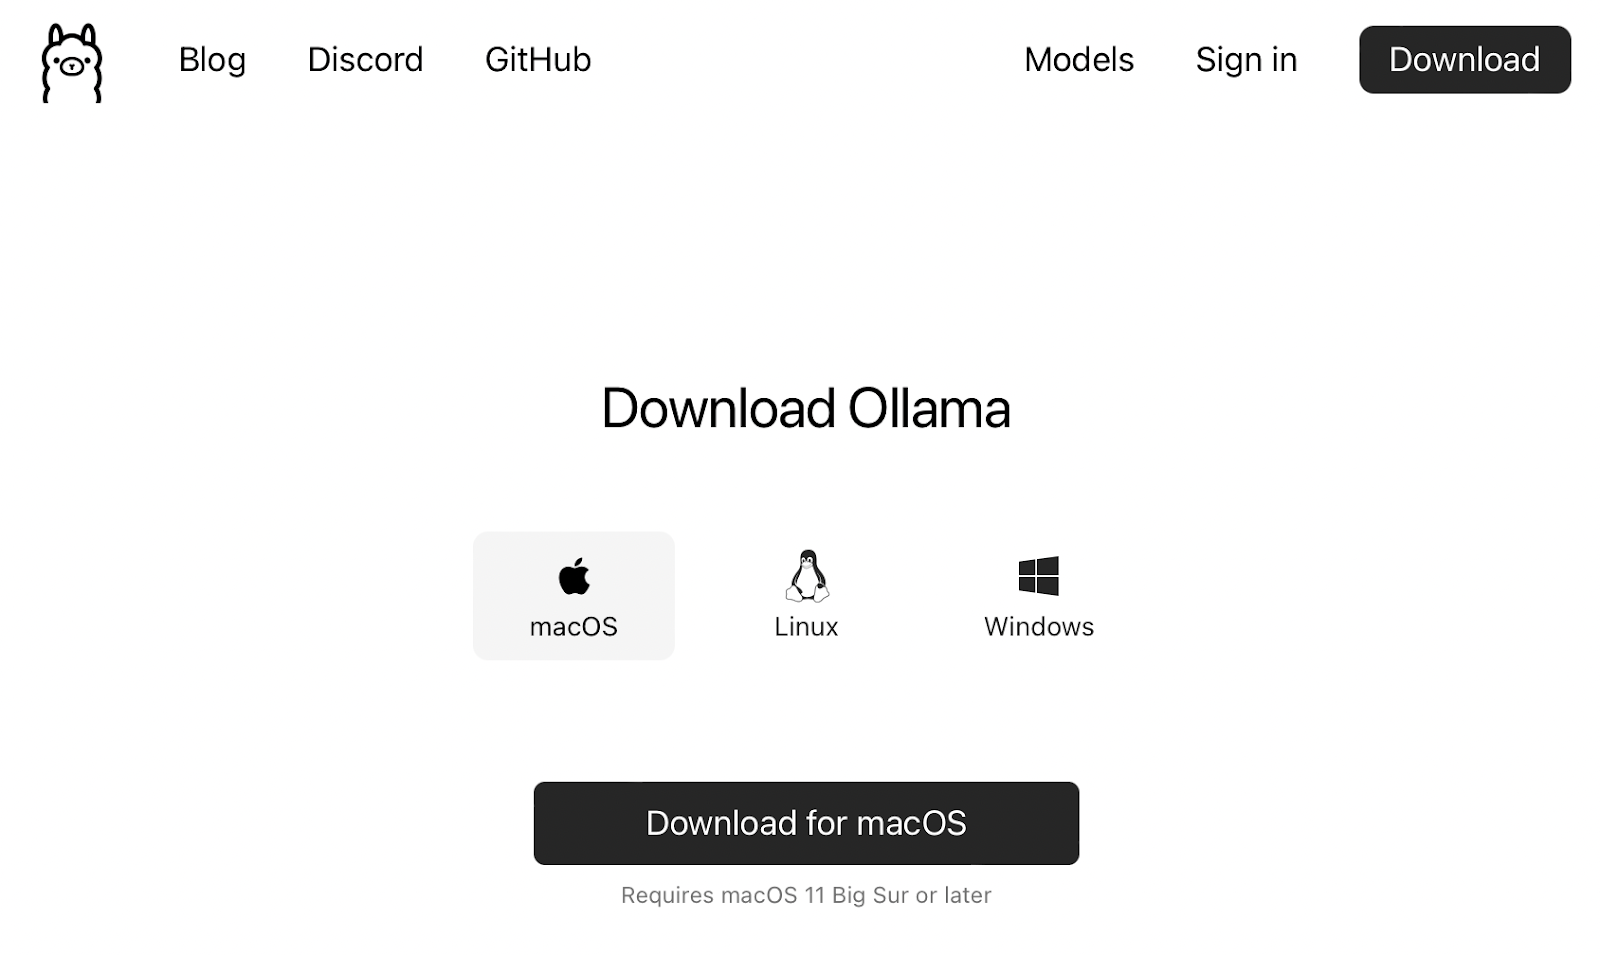 Capture d'écran de la page d'accueil du site d'Ollama.
Dans notre cas, Ollama est un utilitaire en ligne de commande :
Capture d'écran de l'installation de l'outil en ligne de commande Ollama.
Une fois l'utilitaire installé, nous pouvons lancer le modèle avec la commande ollama run <model name>. S'il s'agit du premier lancement sur l'appareil, Ollama téléchargera le modèle pour nous :
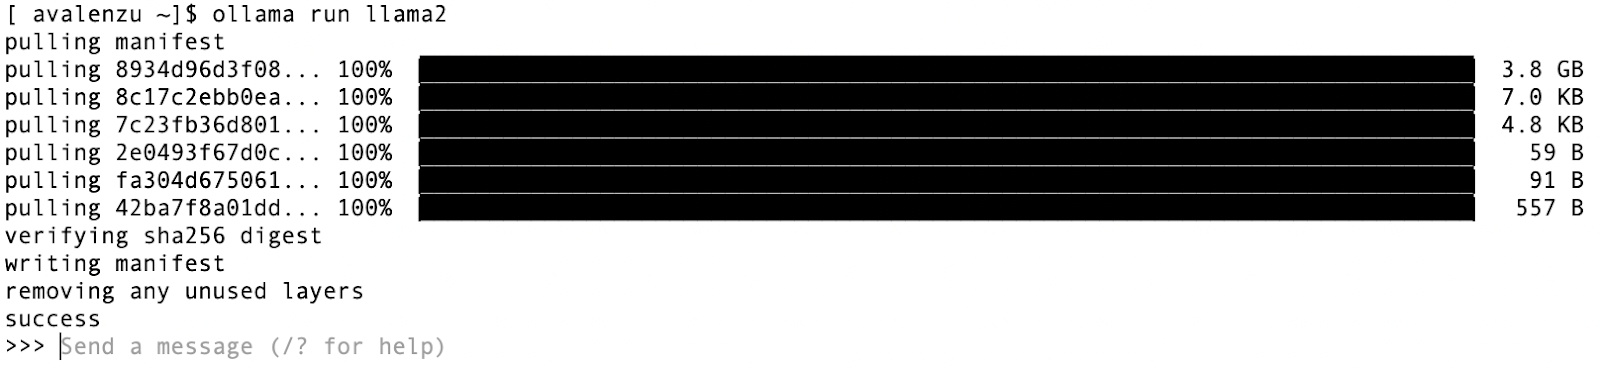
Capture d'écran du premier lancement du modèle LLaMa 2 avec l'outil en ligne de commande Ollama. Le modèle est automatiquement téléchargé lors du premier usage.
À partir de là, dialoguer avec le modèle et quitter depuis la ligne de commande est très simple :
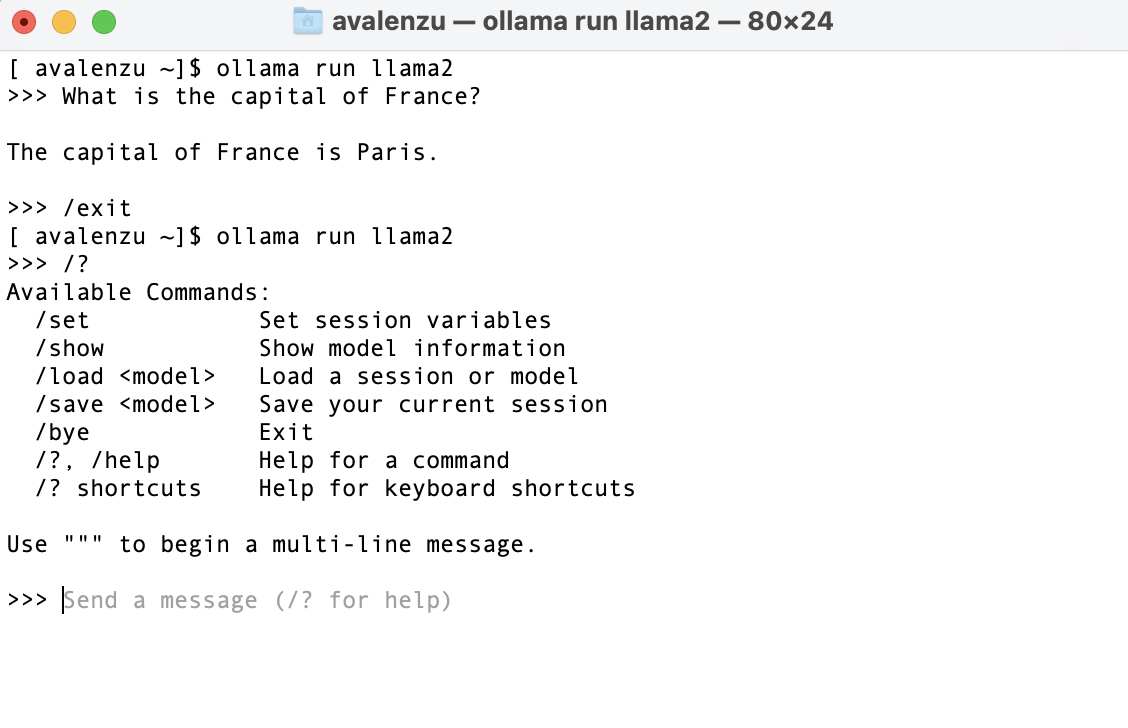
Capture d'écran de l'interaction avec le modèle via l'outil en ligne de commande Ollama.
Comme on le voit ci‑dessus, le modèle propose aussi un petit lot de commandes supplémentaires.
Ollama prend également en charge d'autres modèles, comme le nouveau Mistral :
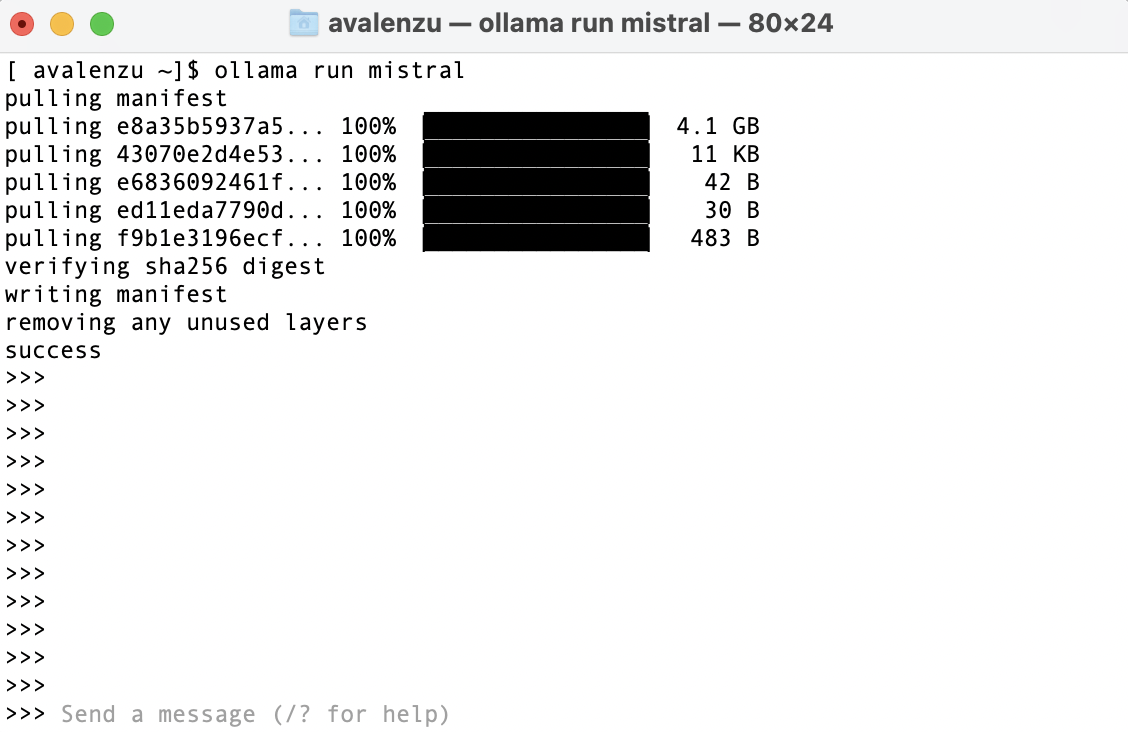
Capture d'écran du premier lancement du modèle Mistral avec l'outil en ligne de commande Ollama. Le modèle est automatiquement téléchargé lors du premier usage.
Le modèle est à nouveau prêt à l'emploi en une seule commande !
Cette approche a l'avantage de ne consommer que les ressources de notre appareil. Toutefois, il est important de garder à l'esprit que les performances d'un modèle augmentent généralement avec le nombre de paramètres.
Par conséquent, plus un modèle a de paramètres, plus il demandera de ressources. Les modèles plus volumineux devront donc probablement tourner sur des serveurs privés pour des applications LLM auto‑hébergées.
Si vous souhaitez construire une application à grande échelle, notez qu'Ollama peut aussi s'exécuter avec Docker Desktop sur Mac et dans des conteneurs Docker avec accélération GPU sous Linux.
Vous vous demandez peut‑être : puis‑je intégrer OLLAMA dans mes scripts ?
Tout à fait, héberger le modèle vous‑même n'empêche pas de l'intégrer à vos scripts Python ! Ollama offre aussi une interface Python pour interagir avec votre modèle auto‑hébergé.
Les bibliothèques Python et JavaScript d'Ollama permettent d'incorporer l'inférence du modèle dans nos scripts.
Ollama n'est pas notre seule option si nous souhaitons héberger nous‑mêmes le modèle. En général, les LLM sont souvent disponibles en téléchargement sur plusieurs plateformes open source qui offrent aussi un support communautaire.
Les LLM open source sont généralement disponibles gratuitement pour des usages académiques et de recherche. En revanche, les conditions d'utilisation commerciale varient selon la licence du modèle. Assurez‑vous de savoir si vous expérimentez des LLM ou si vous construisez des applications basées sur des LLM à des fins commerciales.
Envie de vous lancer dès aujourd'hui dans le développement de LLM ? Alors le cours Developing Large Language Models est fait pour vous !
Héberger des modèles puissants en local peut être très gourmand en ressources, c'est pourquoi les services cloud constituent une alternative intéressante, permettant d'ajuster les ressources à la demande et de bénéficier du support des fournisseurs cloud.
À noter que des services cloud traditionnels comme Azure proposent désormais des chaînes de déploiement dédiées pour héberger des LLM, tels que Mistral, évitant ainsi de mettre en place un hébergement spécialisé.
C'est un atout majeur pour déployer des applications au sein de votre organisation, beaucoup d'entreprises ayant déjà des contrats avec ces fournisseurs pour la messagerie et des solutions cloud générales.
Choisir des fournisseurs tiers peut offrir un équilibre entre l'absence de gestion d'infrastructure d'hébergement et un certain contrôle sur le modèle, par rapport à l'usage d'une API native simple.
Ces fournisseurs proposent généralement un accès API, mais il est important de noter que les coûts peuvent grimper fortement en cas d'usage intensif, comme avec l'API native d'OpenAI.
La différence clé réside dans l'entité d'hébergement. Ce sont les fournisseurs tiers, et non les services LLM natifs, qui hébergent le modèle sur leur infrastructure et exposent l'endpoint API, en proposant souvent une variété de modèles issus de différentes sources pour une intégration flexible.
Un fournisseur tiers populaire est l'LLAMA API.
Capture d'écran de la page d'accueil du site LLAMA API.
L'API n'est pas gratuite, mais vous pouvez l'essayer grâce à 5 $ de crédits offerts à toute nouvelle inscription. Gardez toutefois en tête que ces crédits n'ont une validité que d'un mois après émission.
L'utilisation de LLAMA API est très simple. Une fois installée (pip install llamaapi), nous pouvons faire un premier appel d'essai comme suit :
from llamaapi import LlamaAPI
import json

llama = LlamaAPI('<Insert API key here>')
prompt = "Which is the capital of France?"

api_request_json = {
  "model": "llama-13b-chat",
  "messages": [
    {"role": "system", "content": "You are a friendly chatbot."},
    {"role": "user", "content": prompt},
  ]
}

response = llama.run(api_request_json)
print(json.dumps(response.json(), indent=2))
Cependant, comme pour l'API OpenAI, il est recommandé d'encapsuler l'appel API dans une fonction. En suivant la même approche que précédemment :
def llm_call(prompt, model="llama-13b-chat"):
    api_request_json = {
        "model": model,
        "messages": [
            {"role": "system", "content": "You are a friendly chatbot."},
            {"role": "user", "content": prompt},
        ]
    }
    response = llama.run(api_request_json)
    return response.json()["choices"][0]["message"]["content"]
Avec cette implémentation, nous récupérons la chaîne de réponse du LLM en appelant simplement llm_call() :
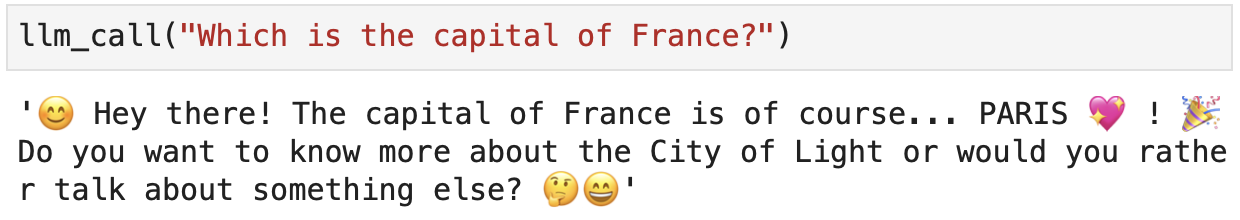
LLAMA API prend en charge une variété de modèles de pointe, pas seulement les LLaMa de Meta. Nous verrons dans la prochaine section quels modèles sont pris en charge !
Enfin, chez LLAMA API, le coût dépend du nombre de paramètres du modèle et semble constant d'un modèle à l'autre :
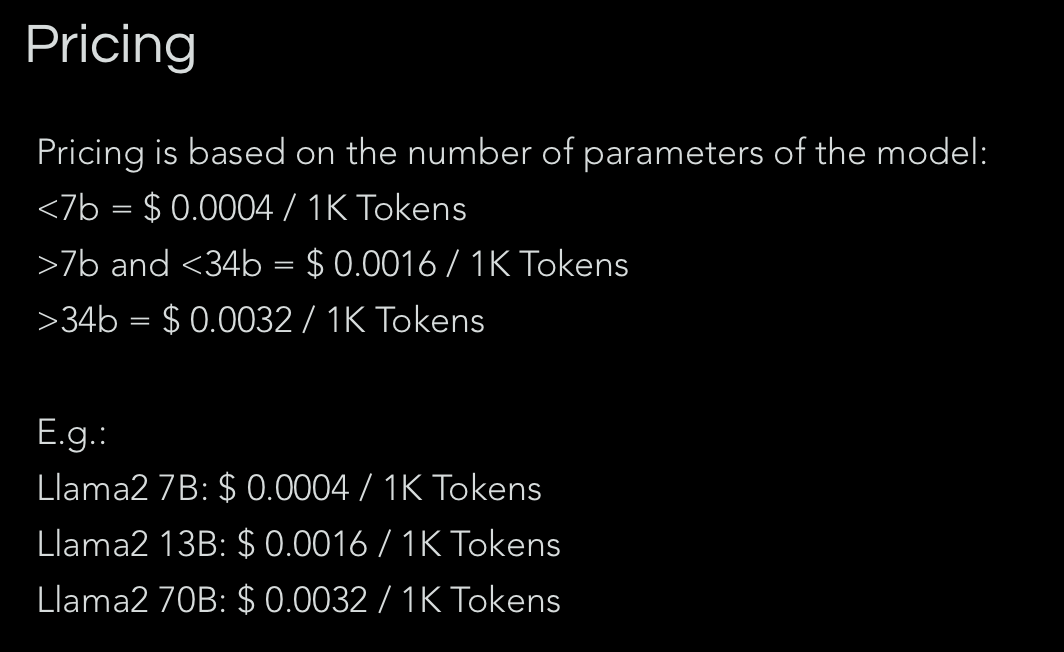
Capture d'écran des tarifs de LLAMA API. Cette information n'est visible qu'après création d'un compte.
Le fournisseur tiers le plus populaire pour les LLM est Hugging Face. Hugging Face est surtout connu pour sa bibliothèque transformers, la plus utilisée en Python pour le traitement du langage naturel.
Hugging Face propose plusieurs interfaces d'accès aux LLM. Il dispose d'une interface Playground conviviale appelée « Spaces » :

Capture d'écran du Playground « Spaces » de Hugging Face.
La plateforme permet aussi l'hébergement de modèles et le déploiement d'endpoints, ainsi que le téléchargement direct et l'utilisation locale des modèles.
Gardez à l'esprit que Hugging Face s'adresse avant tout aux développeurs : même s'il existe des tutoriels pour démarrer, faire passer vos modèles à l'échelle dans une application demande des compétences techniques.
Si vous souhaitez en savoir plus sur Hugging Face, je vous recommande vivement l'article What is Hugging Face? The AI Community's Open-Source Oasis.
Un outil complémentaire que j'utilise souvent pour construire des applications propulsées par des LLM, en conjonction avec Hugging Face, est LangChain. Le tutoriel How to Build LLM Applications with LangChain propose une bonne introduction pratique.
Nous avons abordé différentes méthodes d'accès et d'exécution des LLM, comme les modèles GPT, LLaMa et Mistral. Cependant, il existe de nombreux autres modèles, y compris diverses variantes de ceux déjà cités. Dans cette section, nous allons classer les principaux modèles existants, en listant leurs caractéristiques, leurs prix et leurs cas d'usage.
Les modèles d'OpenAI sont devenus très populaires depuis le lancement de ChatGPT, aujourd'hui propulsé par GPT‑3.5 ou GPT‑4 selon votre abonnement. Pour de nombreuses tâches de base, la différence entre GPT‑3.5 et GPT‑4 n'est pas déterminante.
En revanche, GPT‑4 se distingue nettement dans des scénarios de raisonnement complexe par rapport aux modèles précédents.
De plus, GPT‑4 est un modèle multimodal qui accepte des entrées texte ou image et produit du texte. Il offre aussi la possibilité d'utiliser des plugins pour s'interfacer avec des sources externes. La navigation sur Internet en est un exemple, via les recherches Bing.
Trois grandes variantes de GPT‑4 sont accessibles via l'API OpenAI pour les clients payants :
|
Modèle |
Caractéristiques |
Fenêtre de contexte |
API |
Local |
Tarification par token |
Données d'entraînement |
|
GPT‑4 |
Instantané de gpt‑4 au 13 juin 2023. C'est l'endpoint recevant des mises à jour régulières. Optimisé pour le chat. |
8 192 tokens |
Non |
0,03 $ / 1 K tokens (entrée) 0,06 $ / 1 K tokens (sortie) |
Déc. 2023 |
|
|
GPT‑4 Turbo |
Nom API : gpt‑4‑turb o‑preview. Excelle sur des tâches comme la génération de code et vise à réduire les cas de « laziness ». |
128k tokens |
Non |
0,01 $ / 1 K tokens (entrée) 0,03 $ / 1 K tokens (sortie) |
Déc. 2023 |
|
|
GPT‑4 Vision |
Nom API : gpt‑4‑vision‑preview. GPT‑4 avec capacité de compréhension d'images, en plus des fonctionnalités de GPT‑4 Turbo. |
128k tokens |
Non |
0,01 $ / 1 K tokens (entrée) 0,03 $ / 1 K tokens (sortie) |
Avr. 2023 |
De manière générale, il est intéressant de noter que les modèles GPT, contrairement aux LLaMa, sont propriétaires. Cela signifie que nous ne pouvons ni les exécuter en local, ni déployer notre propre endpoint.
Il existe néanmoins une possibilité de personnalisation via l'API de fine‑tuning d'OpenAI. De plus, ils ne sont pas accessibles via des fournisseurs tiers comme Ollama, LLAMA API ou Hugging Face.
Concernant OpenAI Playground, l'information sur le modèle sous‑jacent n'est pas affichée clairement, mais il semble basé sur GPT‑4 avec des capacités DALL‑E, navigation et analyse.
Jetons aussi un œil aux modèles GPT‑3 disponibles !
|
Modèle |
Caractéristiques |
Fenêtre de contexte |
API |
Local |
Tarification par token |
Données d'entraînement |
|
GPT‑3.5 Turbo |
Nom API : gpt‑3.5‑turbo. C'est le modèle phare de cette famille. Optimisé pour le dialogue, il est plus précis pour répondre dans les formats demandés. |
16 385 tokens |
Non |
0,0005 $ / 1 K tokens (entrée) 0,0015 $ / 1 K tokens (sortie) |
Sep. 2021 |
|
|
GPT‑3.5 Turbo Instruct |
Nom API : gpt‑3.5‑turbo‑instruct. Axé sur la précision et la pertinence des réponses, en phase avec les besoins de l'utilisateur. |
4 096 tokens |
Non |
0,0015 $ / 1 K tokens (entrée) 0,0020 $ / 1 K tokens (sortie) |
Sep. 2021 |
Le modèle GPT‑3.5 Turbo Instruct présenté dans le tableau a été ajusté pour mieux suivre les intentions de l'utilisateur via le Reinforcement Learning from Human Feedback (RLHF).
Le RLHF intègre des retours humains dans le processus d'apprentissage par renforcement pour guider et améliorer les résultats. Cette approche permet de développer des modèles plus alignés avec les valeurs et préférences humaines, en incorporant jugements, corrections ou préférences directement dans le cycle d'entraînement.
Enfin, comme on l'observe dans le tableau, l'usage des deux modèles GPT‑3.5 est nettement moins coûteux que celui de GPT‑4.
Sur ce point, je recommande généralement de comparer les performances de chaque modèle sur un jeu d'exemples bien définis afin de vérifier si GPT‑3.5 suffit pour la tâche, ce qui permet d'économiser sur l'inférence.
Comme nous l'avons vu précédemment, les modèles LLaMa sont téléchargeables gratuitement et exécutables en local, ou peuvent servir de base à des personnalisations.
Les LLaMa constituent en réalité une grande famille de modèles ouverts, de différentes tailles et variantes, fournie par Meta AI :
|
Modèle |
Caractéristiques |
Fenêtre de contexte |
API |
Local |
Variante |
Données d'entraînement |
|
LLaMa 2 |
Modèle de base non‑chat pour des tâches de complétion. |
4 096 tokens |
Oui |
Oui* |
7B 13B 70B |
Sep. 2022 |
|
LLaMa 2 Chat |
LLaMa 2 de base avec instruction tuning pour transformer la complétion en modèle de chat suivant l'intention utilisateur. |
4 096 tokens |
Oui |
Oui* |
7B 13B 70B |
Sep. 2022 |
|
LLaMa 2 Guard |
Modèle de protection entrée/sortie entraîné pour détecter contenus toxiques et nuisibles. |
4 096 tokens |
Oui** |
Non |
7B |
Sep. 2022* |
*Hugging Face propose également des variantes de LLaMa, comme les modèles de base et chat. **Pour l'instant, LLaMa 2 Guard est accessible dans l'environnement cloud d'Amazon SageMaker.
À la différence des modèles GPT qui intègrent des capacités de codage, les LLaMa disposent de modèles dédiés au code avec de plus grandes fenêtres de contexte de 16k tokens, obtenues via un fine‑tuning « long context ».
|
Modèle |
Caractéristiques |
Fenêtre de contexte |
API |
Local |
Variante |
Données d'entraînement |
|
Code LLaMa |
Modèle de base non‑chat pour la complétion de code, à la manière de GitHub Copilot. Il s'agit d'un modèle LLaMa 2 avec un entraînement supplémentaire sur du code et un fine‑tuning pour longs contextes. |
16k |
Non |
Oui |
7B 13B 34B |
Sep. 2022* |
|
Code LLaMa - Instruct |
Dérivé des modèles Instruct. Excelle dans la complétion et l'explication de morceaux de code. |
16k |
Oui |
Oui |
7B 13B 34B |
Sep. 2022* |
|
Code LLaMa - Python |
Ajusté spécifiquement pour le langage Python. |
16k |
Non |
Oui |
34B |
Sep. 2022* |
* La date de coupure officielle des modèles LLaMa est septembre 2022. Néanmoins, les données d'ajustement sont plus récentes (2023), en particulier pour les variantes récentes.
Google a une longue histoire dans le développement de grands modèles de langage. Avec l'introduction de Gemini, Google a inauguré sa génération de LLM multimodaux.
Dans l'offre de Google, Gemini s'impose comme le modèle phare, propriétaire, à l'instar de ChatGPT. Mais Google a récemment lancé Gemma, une suite de modèles open source dérivés de Gemini, afin de faciliter un développement de l'IA plus accessible.
Dans cet article, nous nous concentrerons sur Gemini et Gemma :
|
Modèle |
Caractéristiques |
API |
Local |
Variantes |
|
Gemini |
Modèle propriétaire pour des tâches génériques (génération de texte, traduction, questions‑réponses, code, etc.). |
Oui* |
Non |
Ultra – résolution de tâches complexes. Pro – large éventail de tâches. Scalabilité. Nano – usage efficace sur l'appareil. |
|
Gemma |
Tâches similaires à Gemini, mais pensée pour l'intégration dans des applications sur mesure et la recherche. Modèle léger. |
Oui**LLAMA API |
OuiOllama |
2B 7B |
*Il existe une API pour Gemini à des fins commerciales (pas d'instances déployables). On peut cependant tester le modèle via son interface Playground.
**Pas d'endpoint Google natif, mais le modèle est accessible via Kaggle et Google Colab. Plus d'informations dans la documentation officielle de Google.
Côté variantes, Gemini Ultra est un modèle multimodal qui excelle dans l'analyse complexe. Gemini Pro équilibre performance et passage à l'échelle, et se distingue pour la génération de code et de texte. Enfin, Gemini Nano mise sur l'efficacité pour un usage embarqué, sur mobile et en périphérie, sans fortes exigences de ressources.
Pour les modèles de Google, peu d'informations publiques sont disponibles sur les fenêtres de contexte et la date de coupure des données d'entraînement au moment d'écrire ces lignes.
Mistral AI est une entreprise française fondée en avril 2023 par d'anciens employés de Meta Platforms et Google DeepMind. Elle développe des LLM open source, en soulignant l'importance de l'open source face aux modèles propriétaires. L'entreprise propose des modèles comme Mistral 7B et Mixtral 8x7B, dotés de capacités avancées en traitement du langage.
|
Modèle |
Caractéristiques |
Fenêtre de contexte |
API |
Local |
Tarification par token |
Données d'entraînement |
|
Mistral |
Modèle généraliste de 7B paramètres. Optimisé pour l'anglais et la génération de code. |
32k |
Oui* |
Oui |
0,25 $ / 1 M tokens (entrée et sortie) |
Sep. 2023 |
|
Mixtral |
Modèle généraliste le plus performant. À l'aise en anglais, français, italien, allemand, espagnol, et très bon en code. Basé sur une architecture clairsemée Mixture‑of‑Experts avec 7B paramètres par expert. |
32k |
Oui* |
Oui |
0,7 $ / 1 M tokens (entrée et sortie) |
Déc. 2023 |
*On peut interagir avec les modèles de Mistral AI via leur interface Playground « La Plateforme ».
** Hugging Face propose également un banc d'essai pour l'inférence en temps réel via son API pour certains modèles. C'est aussi un fournisseur tiers qui permet de déployer des endpoints payants vers les modèles disponibles.
Concernant Mixtral, l'architecture « Mixture‑of‑Experts » permet au modèle de répartir ses capacités entre différents groupes spécialisés ou « experts ». Chaque expert est optimisé pour certains types de tâches ou de données.
Lors du traitement d'une entrée, Mixtral n'active dynamiquement que les experts pertinents, ce qui lui permet de gérer efficacement des tâches complexes en n'utilisant qu'une fraction de ses paramètres pour chaque token. Cette méthode améliore les performances, rendant Mixtral efficace sur de nombreuses langues et tâches tout en optimisant les ressources de calcul. Le nom « Mixtral 8x7B » fait référence au fait que le modèle utilise 8 groupes distincts d'« experts ».
Enfin, Mistral AI propose aussi trois modèles commerciaux : Mistral Small, Mistral Medium et Mistral Large. Vous trouverez plus d'informations sur les modèles et les tarifs dans la documentation officielle.
Jusqu'ici, nous avons vu de multiples modèles et variantes des acteurs les plus connus. Mais il reste beaucoup à explorer !
Je souhaite mettre en avant les modèles Falcon du Technology Innovation Institute, disponibles à la fois sur Ollama et via LLAMA API. Il y a aussi Orca2 de Microsoft Research, particulièrement performant en raisonnement, également disponible sur Ollama et Hugging Face.
Vous pouvez découvrir d'autres modèles open source disponibles dans 8 meilleurs LLM open source pour 2024 et leurs usages.
Dans cet article, nous avons passé en revue plusieurs aspects à considérer pour choisir le meilleur grand modèle de langage pour votre application cible. Même si ce guide se veut un pense‑bête, il n'existe pas de règle d'or pour identifier d'emblée le meilleur modèle.
D'après mon expérience, définir la manière dont nous souhaitons interfacer le LLM est un bon point de départ, car cela réduit déjà le nombre de modèles — et de variantes — à considérer.
Le deuxième aspect est la tâche visée par le modèle : chatbot générique, spécialiste du résumé, assistant de codage, etc.
S'il est toujours possible d'ajuster un modèle à la tâche souhaitée, nous avons vu qu'il existe déjà des variantes fine‑tunées pour certains cas d'usage qui nous feront gagner du temps, des ressources de calcul et de l'expertise technique. Prendre en compte la fenêtre de contexte nécessaire à l'application est également crucial pour sélectionner le meilleur modèle.
Enfin, le prix reste un bon indicateur pour trancher. Hélas, la plupart du temps, le projet est contraint par l'investissement initial et le coût de maintenance dans la durée. Côté coûts, n'oubliez pas que l'entraînement et le fine‑tuning sont des services payants à prévoir pendant le développement — et souvent très chronophages.
Poursuivez votre parcours en IA dès aujourd'hui !
Cursus
Cours
Cours