Lernpfad
Grundlagen der KI
10 Std.
Seit dem Start von ChatGPT scheint alle paar Tage ein neues Large Language Model (LLM) zu erscheinen – zusammen mit neuen Unternehmen, die sich auf diese Technologie spezialisieren. Jedes neue LLM wird darauf trainiert, seine Vorgänger in verschiedener Hinsicht zu übertreffen. So sehen wir immer häufiger LLMs, die auf einen bestimmten Anwendungsfall zugeschnitten sind: Chat-Modelle, Coding-Assistenten oder Modelle mit besonders langem Kontextverständnis, um nur einige zu nennen.
Das richtige Modell für eine neue LLM-basierte Anwendung oder ein Projekt auszuwählen, kann überwältigend sein – ganz zu schweigen von der Herausforderung, bei den neuesten Modellen und Funktionen auf dem Laufenden zu bleiben.
Ich greife in der Praxis deshalb oft standardmäßig zu ChatGPT oder GPT-Modellen per API-Aufruf.
Hier möchte ich die Vielfalt verfügbarer Modelle beleuchten und die wichtigsten Fähigkeiten hervorheben, die du je nach Projektprofil bei der Auswahl berücksichtigen solltest.
Wir konzentrieren uns dabei besonders auf die verschiedenen Arten der Interaktion mit diesen Modellen – ein zentrales Kriterium bei der Entscheidung zwischen den verfügbaren Optionen.
Das Ziel ist, dass dir dieser umfassende Leitfaden als Spickzettel dient und dir hilft, die große Auswahl an LLMs für deine konkreten Aufgaben einzuordnen.
Wenn du neu in der LLM-Welt bist, empfehle ich dir die Kurse AI Fundamentals und Large Language Models Concepts, um dich mit Grundbegriffen und Modellen vertraut zu machen.
Der Zugriff auf LLMs und die Einbindung in LLM-gestützte Anwendungen oder Projekte kann – je nach technischem Bedarf – auf verschiedene Arten erfolgen.
Der nutzerfreundlichste Weg sind konversationelle Oberflächen im Browser. So auch bei ChatGPT, wo die Benutzeroberfläche schlicht ein Chat ist, über den du mit dem Modell interagierst.
In der Regel bieten diese Oberflächen nur wenig oder gar keine Steuerung bzw. Anpassung des Modells, sind aber ein einfacher Weg, um Modelle für einfache Aufgaben auszuprobieren. ChatGPT von OpenAI und Googles Gemini stellen solche Interfaces bereit:
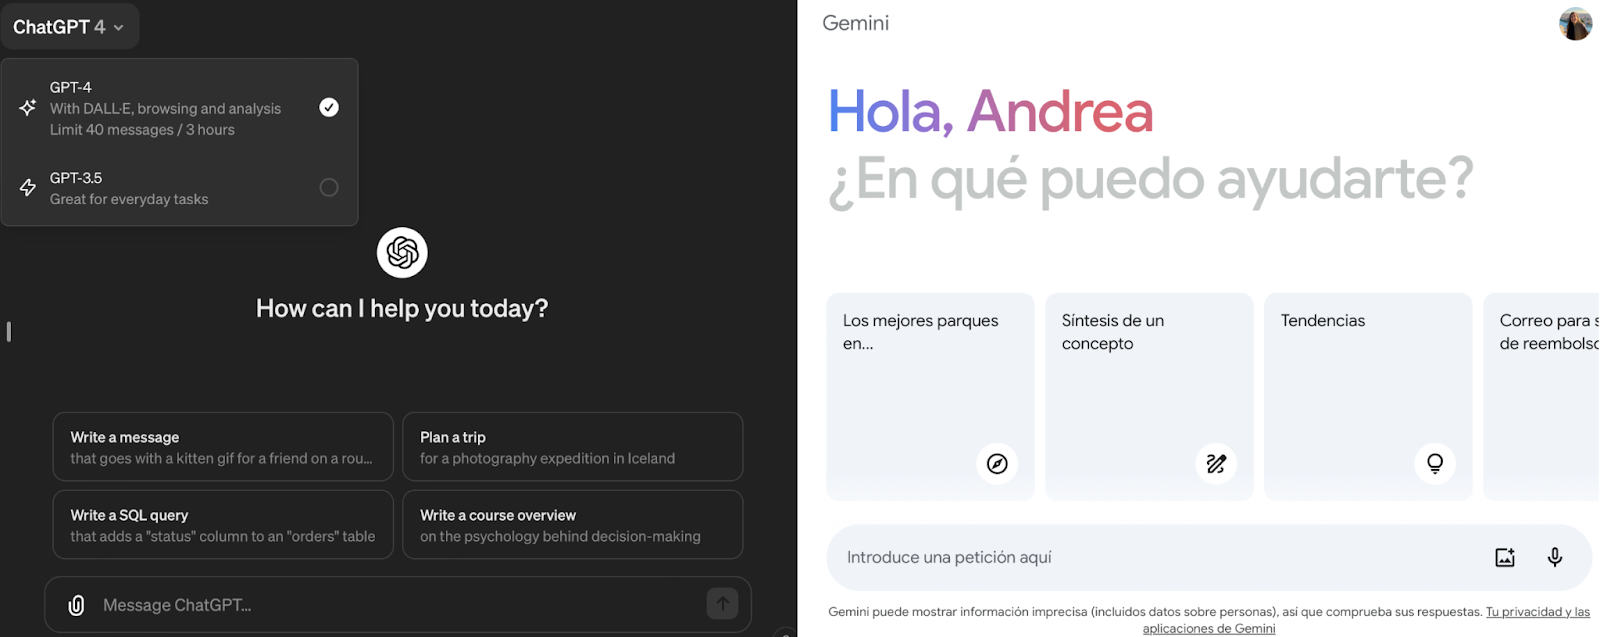
Screenshot der Chat-Oberflächen von OpenAI’s ChatGPT (links) und Google’s Gemini (rechts).
Manche Anbieter erlauben über ähnliche, benutzerfreundliche Chat-Oberflächen auch einen gewissen Grad an Anpassung. Bei OpenAI heißt die Plattform „Playground“.
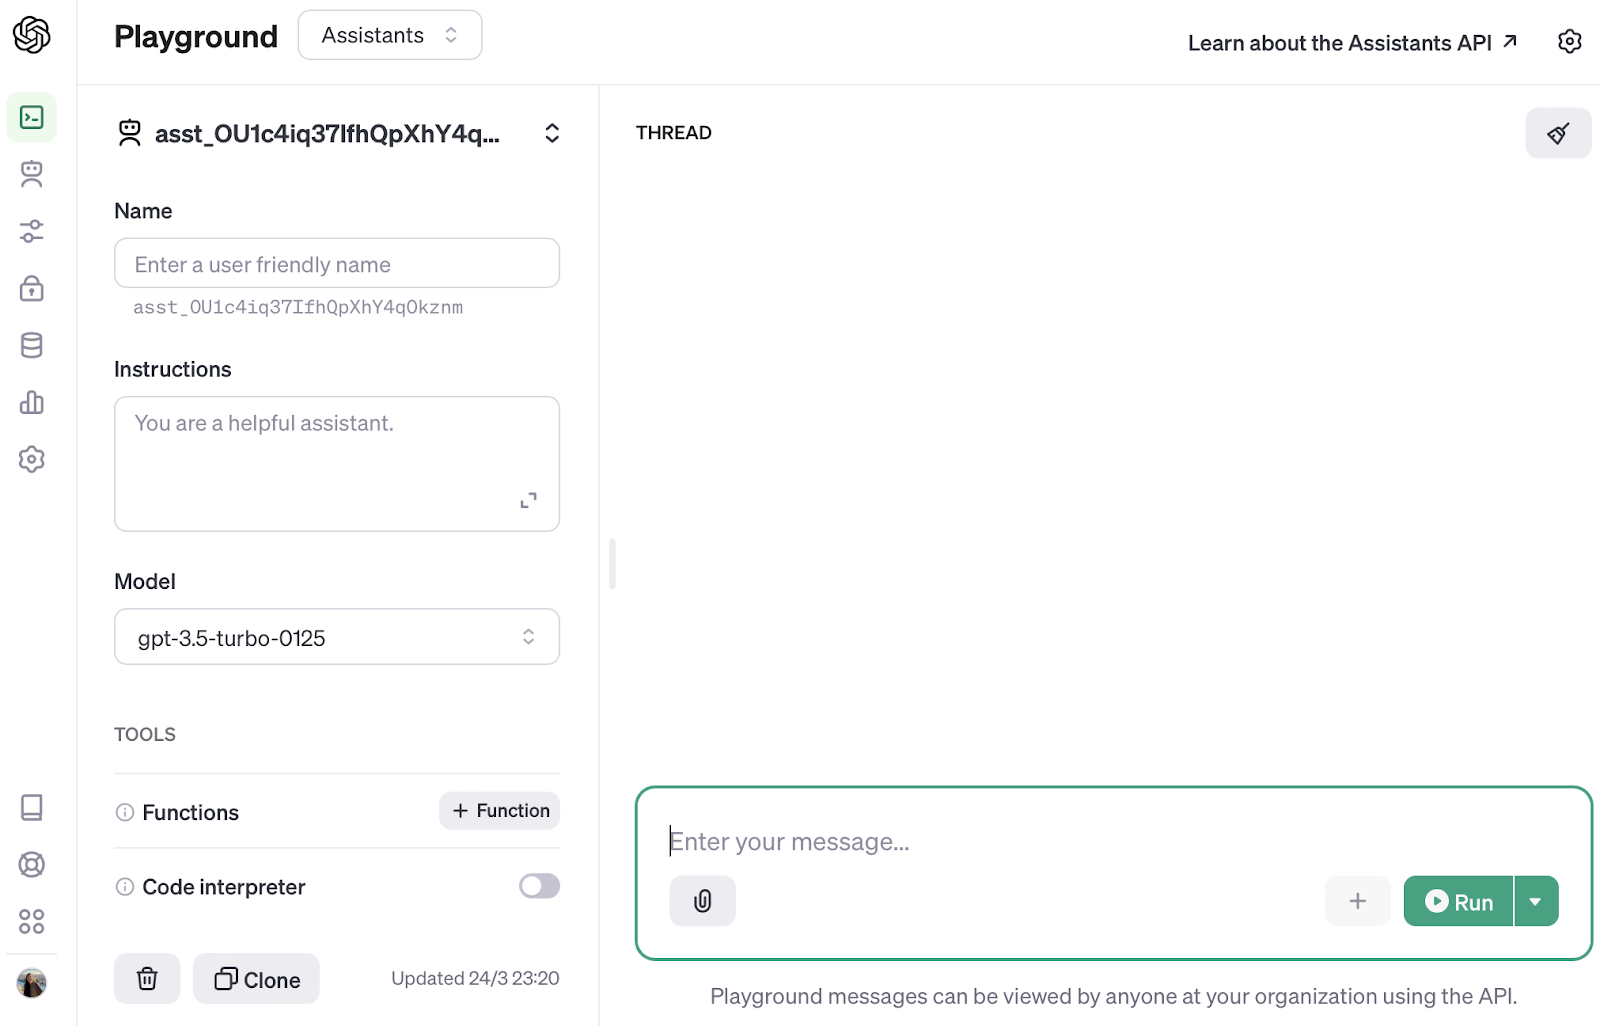
Screenshot der OpenAI-Playground-Oberfläche.
Playground-Oberflächen ermöglichen es, verschiedene Modelle mit begrenzter Kontrolle über die Einstellungen zu testen. So lässt sich erkunden, welche Parameter für deine Aufgabe passen. Wie du vermutlich schon gemerkt hast, erlauben Playgrounds oder Chats jedoch nicht, die Interaktion mit dem LLM direkt in eine Anwendung oder ein Projekt einzubetten.
Eine der beliebtesten Möglichkeiten, LLMs abzufragen, ist der Zugriff per API. Dieser Ansatz ist besonders vorteilhaft, wenn wir keine tiefgreifende Modellanpassung benötigen.
API-Aufrufe lassen sich nahtlos in unsere Skripte integrieren, ohne dass wir selbst Infrastruktur aufsetzen und betreiben müssen.
Die Bequemlichkeit hat allerdings ihren Preis. Und obwohl du dich auf einen externen Dienst verlässt – eine Abhängigkeit, die bleibt, solange du das Modell nicht selbst hostest und die nötige Infrastruktur betreibst –, steigen die Kosten unvermeidlich mit der Nutzung.
Bei API-Aufrufen ist es gute Praxis, einen einfachen Wrapper um den eigentlichen Call zu implementieren, um modular mit dem Modell zu interagieren. Für die OpenAI API, die ich bisher am häufigsten genutzt habe, verwende ich stets den Wrapper aus dem nächsten Abschnitt, sodass die Modellauswahl für die Nutzerseite transparent ist.
Eine standardisierte und zugleich flexible Methode zu schreiben, um GPT-Modelle über die OpenAI API abzufragen, ist sehr hilfreich, wenn du reibungslos und weniger fehleranfällig mit dem Modell arbeiten willst. Deshalb setze ich den GPT-Aufruf meist am Programmanfang als Wrapper-Funktion auf, damit die Modelnutzung für die Anwendung transparent bleibt.
Die Bibliothek openai (pip install openai) stellt bereits einen ChatCompletion-Endpunkt bereit, über den wir jedes beliebige GPT-Modell mit der Methode .create aufrufen können.
Die Methode .create hat zwei Pflichtparameter:
gpt-4.Mit diesen beiden Parametern können wir den GPT-Aufruf wie folgt schreiben:
prompt = "Hello world"
chat_completion = openai.ChatCompletion.create(model="gpt-3.5-turbo", messages=[{"role": "user", "content": prompt}])
Beim Aufruf erhalten wir die Completion als JSON zurück:
{
 "choices": [
   {
     "finish_reason": "stop",
     "index": 0,
     "message": {
       "content": "Hello! How can I assist you today?",
       "role": "assistant"
     }
   }
 ],
 "created": 1692042919,
 "id": "chatcmpl-7nXwl0tywcTb91xeEuhpQbpRD6XLM",
 "model": "gpt-3.5-turbo-0613",
 "object": "chat.completion",
 "usage": {
   "completion_tokens": 9,
   "prompt_tokens": 9,
   "total_tokens": 18
 }
}
Es ist daher sinnvoll, als Rückgabewert nur die eigentliche Modellantwort zu liefern. Setzen wir alle Bausteine zusammen, sieht unsere Wrapper-Implementierung so aus:
def chatgpt_call(prompt, model="gpt-3.5-turbo"):
   response = openai.ChatCompletion.create(
       model=model,
       messages=[{"role": "user", "content": prompt}]
   )
   return response.choices[0].message["content"]
Wenn dich weitere Details zur Implementierung interessieren, vertieft der Artikel ChatGPT API Calls: A Gentle Introduction das Thema.
Außerdem bieten die meisten API-Anbieter, einschließlich OpenAI, nach Kontoerstellung einige kostenlose Aufrufe an. Die Guthaben sind jedoch begrenzt (meist unter 20 $) und in der Regel zeitlich befristet (typischerweise ein Monat).
In jedem Fall ist es gute Praxis, LLM-Aufrufe in eine Funktion – oder eine Funktionssammlung – zu kapseln, damit das Modell für die Anwendung unabhängig vom Anbieter transparent bleibt.
Das eigene Hosting des Modells bedeutet, die Modellgewichte herunterzuladen und auf lokalen Maschinen oder privaten Servern auszuführen.
Dieser Ansatz ist attraktiv, weil er volle Kontrolle über die Modellingfrastruktur erlaubt, aber er bedeutet auch deutlich mehr technischen Aufwand.
Wenn du wissen möchtest, welche Schritte beim Betrieb der Infrastruktur für ein LLM anfallen, wirf einen Blick in den Artikel LLMOps Essentials!
Die lokale Ausführung ermöglicht weitergehende Anpassungen an unsere Bedürfnisse. Eine der beliebtesten Optionen für Self-Hosting sind die bekannten LLaMa-Modelle von Meta AI. Es gibt leichtgewichtige Varianten, die auf einem Laptop mit nur 8 GB RAM laufen.
Die Ausführung von LLaMa auf dem eigenen Laptop ist dank Plattformen wie Ollama ziemlich einfach.
Ollama bietet eine Plattform, um LLMs wie LLaMa 2 und Code LLaMa lokal auf unseren Geräten laufen zu lassen. Sie unterstützt macOS, Linux und Windows und ermöglicht die Anpassung sowie das Erstellen eigener Modelle. Mehr Infos gibt es auf Ollama’s Website.
Den Ollama-Downloader bekommst du über die offizielle Seite, die Modellgewichte lassen sich anschließend direkt über das Terminal ziehen.
Installieren wir also zuerst Ollama, indem wir zur Hauptseite navigieren!
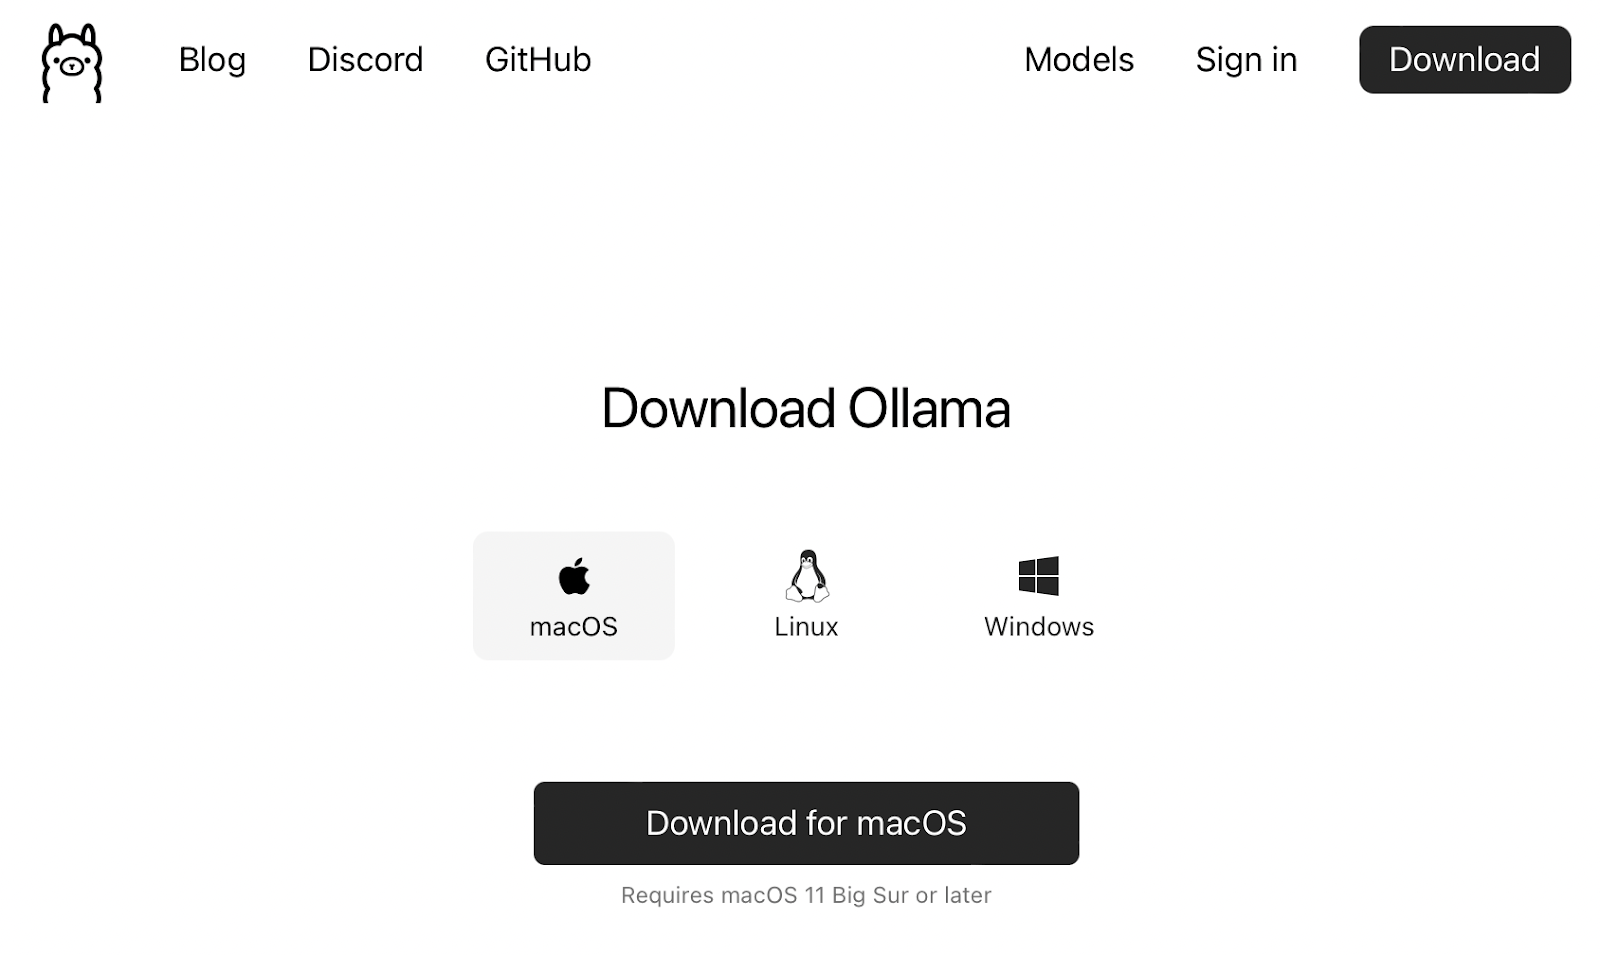 Screenshot der Startseite von Ollama’s Website.
Ollama ist in diesem Fall ein Kommandozeilen-Tool:
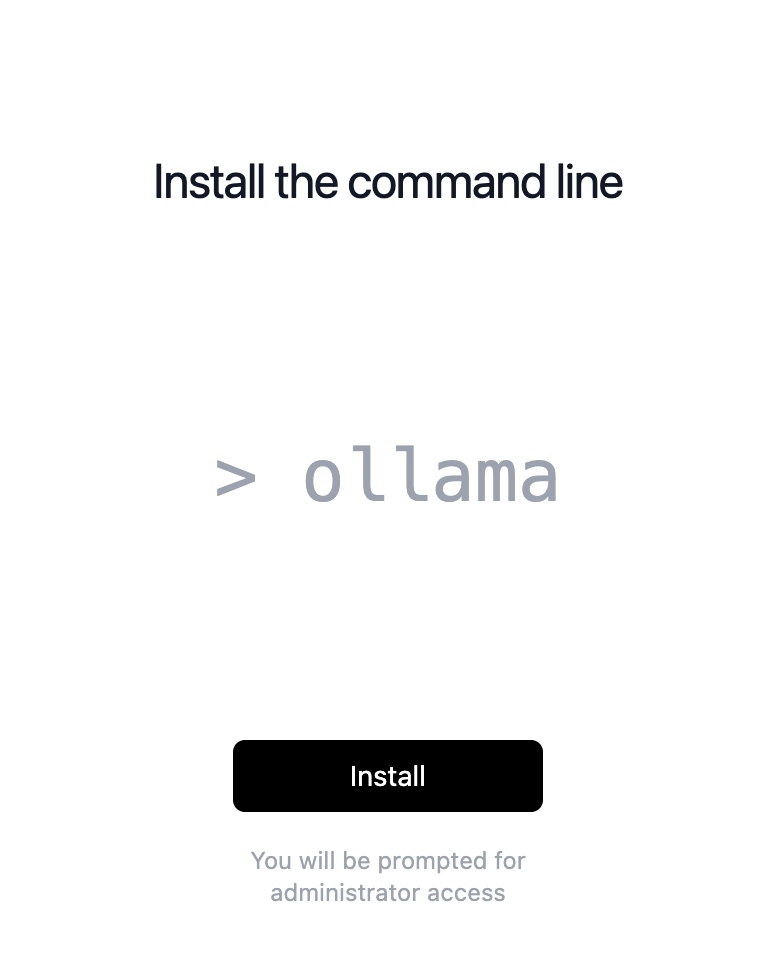
Screenshot der Installation des Ollama-CLI-Tools.
Sobald das CLI installiert ist, starten wir das Modell mit ollama run <model name>. Beim ersten Start auf dem Gerät lädt Ollama das Modell automatisch:
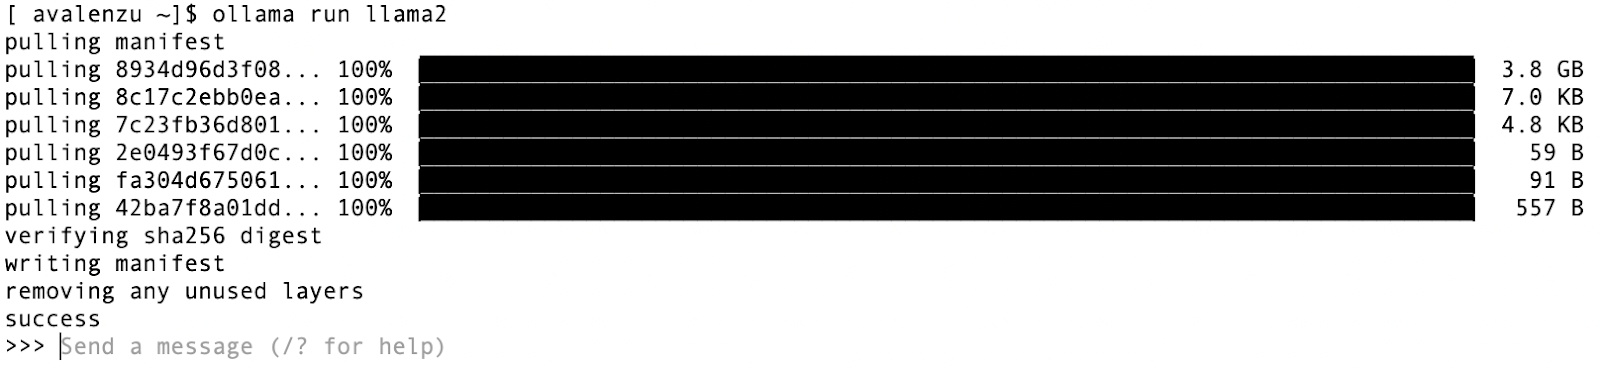
Screenshot des ersten Laufs von LLaMa 2 mit dem Ollama-CLI. Beim ersten Einsatz wird das Modell automatisch heruntergeladen.
Ab dann sind Prompten und Beenden des Modells direkt über die Kommandozeile sehr unkompliziert:
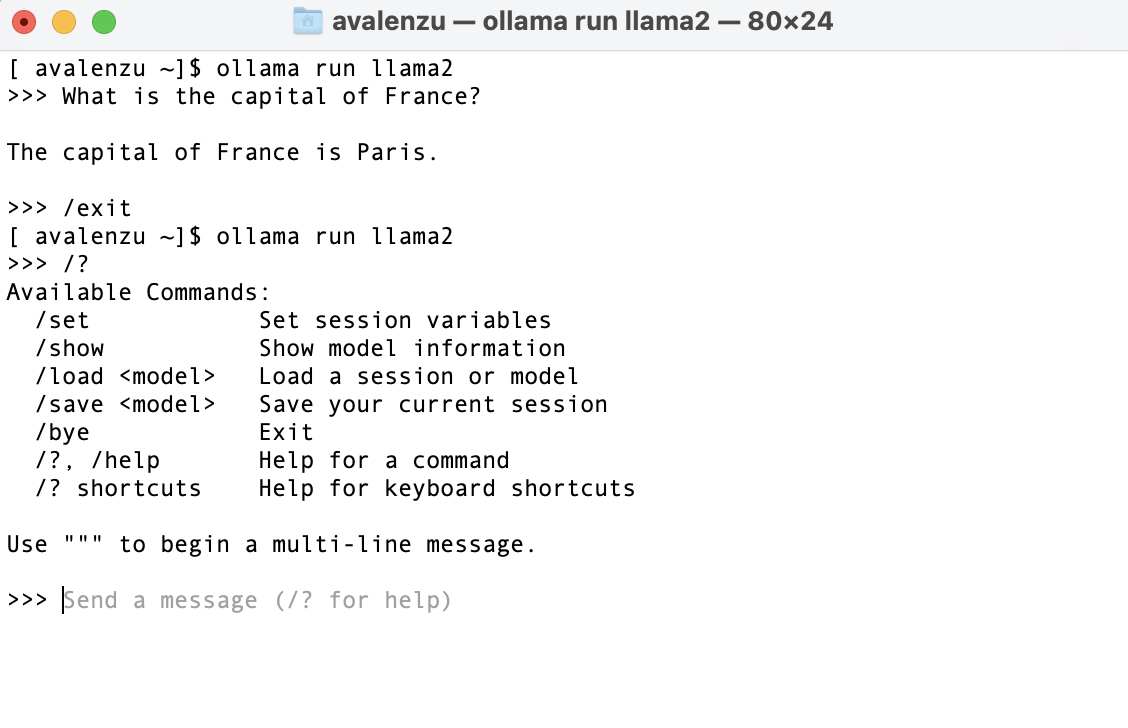
Screenshot der Nutzerinteraktion mit dem Modell über das Ollama-CLI.
Wie im Bild zu sehen, bietet das Modell auch eine kleine Auswahl zusätzlicher Befehle.
Ollama unterstützt zudem andere Modelle, etwa das neue Mistral:
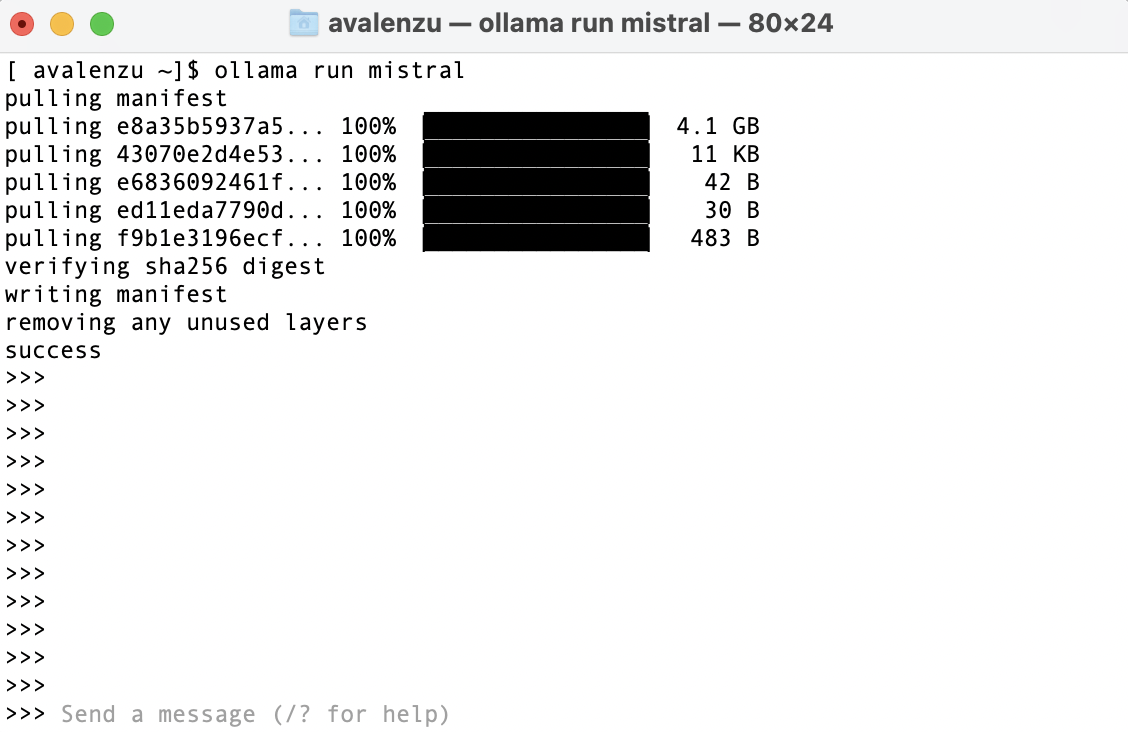
Screenshot des ersten Laufs des Mistral-Modells mit dem Ollama-CLI. Beim ersten Einsatz wird das Modell automatisch heruntergeladen.
Das Modell ist damit direkt einsatzbereit – mit nur einem Befehl!
Dieser Ansatz ist vorteilhaft, da er ausschließlich Ressourcen unseres Geräts nutzt. Allerdings gilt: Die Modellleistung steigt im Allgemeinen mit der Anzahl der Parameter.
Daraus folgt: Je mehr Parameter ein Modell hat, desto mehr Ressourcen benötigt es. Größere Modelle werden daher für Self-Hosted-LLM-Anwendungen eher auf privaten Servern laufen müssen.
Wenn du eine großskalige Anwendung bauen willst, lohnt sich der Hinweis, dass Ollama auch mit Docker Desktop auf dem Mac sowie in Docker-Containern mit GPU-Beschleunigung unter Linux laufen kann.
Vielleicht fragst du dich an dieser Stelle: Kann ich OLLAMA in meine Skripte einbinden?
Ja, das eigene Hosting schließt die Integration in deine Python-Skripte nicht aus! Ollama bietet auch die Möglichkeit, über Python mit deinem selbst gehosteten Modell zu interagieren.
Die Python- und JavaScript-Bibliotheken von Ollama erlauben es, die Inferenz des Modells in unsere Skripte einzubauen.
Ollama ist nicht die einzige Option, wenn wir das Modell selbst hosten möchten. Im Allgemeinen stehen LLMs auf mehreren Open-Source-Plattformen zum Download bereit – oft mit Community-Support.
Open-Source-LLMs sind in der Regel kostenfrei für akademische und Forschungszwecke verfügbar. Für die kommerzielle Nutzung können die Bedingungen je nach Lizenz variieren. Sei dir immer bewusst, ob du nur experimentierst oder LLM-basierte Anwendungen für kommerzielle Zwecke entwickelst.
Möchtest du heute mit der Entwicklung von LLMs starten? Dann ist der Kurs Developing Large Language Models genau richtig für dich!
Leistungsstarke Modelle lokal zu hosten, ist sehr ressourcenintensiv. Cloud-Services sind daher eine sinnvolle Alternative, da sie bedarfsgerecht skalierbare Ressourcen und Support der Cloud-Anbieter bieten.
Bemerkenswert ist, dass klassische Cloud-Dienste wie Azure inzwischen spezialisierte Pipelines zum Hosten von LLMs wie Mistral anbieten, sodass wir kein eigenes Spezial-Hosting aufsetzen müssen.
Das ist ein großer Vorteil beim Ausrollen von Anwendungen in deinem Unternehmen, da viele Firmen ohnehin Verträge mit diesen Anbietern für E-Mail- und allgemeine Cloud-Services haben.
Die Wahl von Drittanbietern kann einen Mittelweg bieten: keine eigene Hosting-Infrastruktur, aber mehr Kontrolle über das Modell als beim reinen nativen API-Service.
Diese Anbieter stellen in der Regel API-Zugriff bereit. Beachte jedoch, dass die Kosten bei intensiver Nutzung – ähnlich wie bei der nativen OpenAI API – deutlich steigen können.
Der Hauptunterschied liegt im Hoster. Nicht die nativen LLM-Services, sondern Drittanbieter hosten das Modell auf ihrer Infrastruktur und stellen einen API-Endpunkt bereit – oft mit einer Auswahl verschiedener Modelle aus unterschiedlichen Quellen für flexible Integrationen.
Ein beliebter Drittanbieter ist die LLAMA API.
Screenshot der Startseite der LLAMA API.
Die API ist nicht kostenlos, aber du kannst sie testen: Neue Accounts erhalten 5 $ Startguthaben. Denk daran, dass diese Credits nur einen Monat gültig sind.
Die Nutzung der LLAMA API ist sehr unkompliziert. Nach der Installation (pip install llamaapi) können wir einen ersten Testaufruf wie folgt durchführen:
from llamaapi import LlamaAPI
import json

llama = LlamaAPI('<Insert API key here>')
prompt = "Which is the capital of France?"

api_request_json = {
  "model": "llama-13b-chat",
  "messages": [
    {"role": "system", "content": "You are a friendly chatbot."},
    {"role": "user", "content": prompt},
  ]
}

response = llama.run(api_request_json)
print(json.dumps(response.json(), indent=2))
Wie bei der OpenAI API ist es auch hier gute Praxis, den API-Aufruf in eine Wrapper-Funktion zu kapseln. Nach demselben Muster wie zuvor:
def llm_call(prompt, model="llama-13b-chat"):
    api_request_json = {
        "model": model,
        "messages": [
            {"role": "system", "content": "You are a friendly chatbot."},
            {"role": "user", "content": prompt},
        ]
    }
    response = llama.run(api_request_json)
    return response.json()["choices"][0]["message"]["content"]
Mit dieser Implementierung erhalten wir die Antwort des LLM einfach durch Aufruf von llm_call() als String zurück:
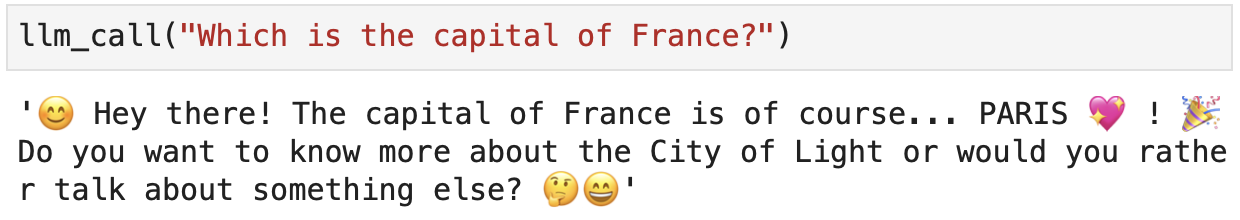
LLAMA API unterstützt eine Reihe aktueller Spitzenmodelle, nicht nur LLaMa von Meta. Welche Modelle genau unterstützt werden, sehen wir im nächsten Abschnitt!
Bei der LLAMA API hängen die Kosten von der Parameteranzahl des Modells ab und scheinen über die Modelle hinweg konstant gestaffelt zu sein:
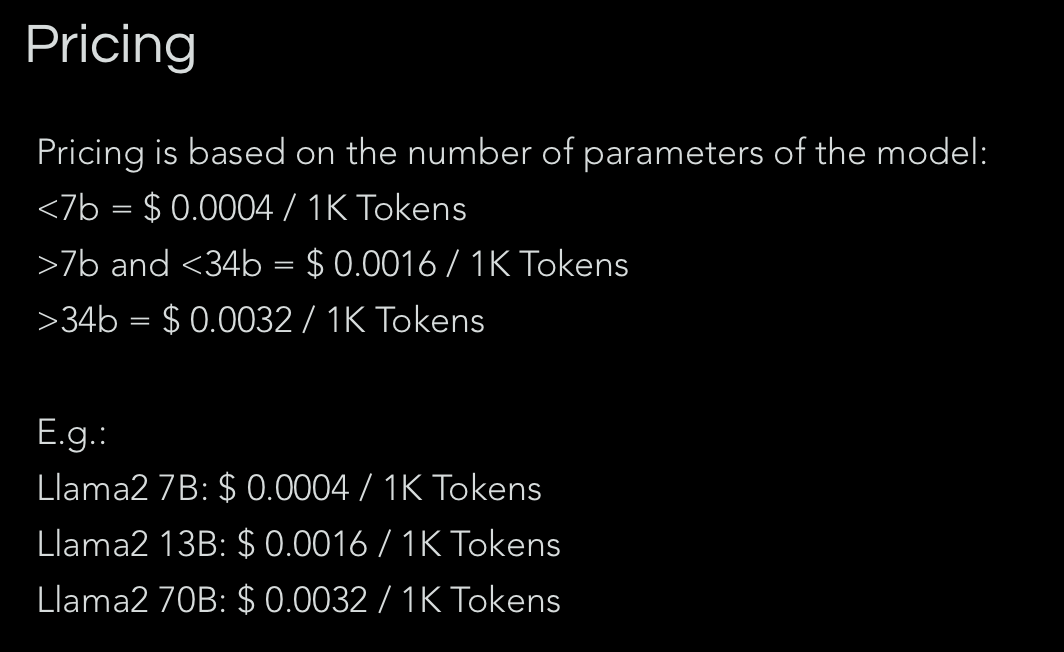
Screenshot der LLAMA-API-Preise. Diese Infos sind erst nach Kontoerstellung sichtbar.
Der bekannteste Drittanbieter für LLMs ist Hugging Face. Hugging Face ist vor allem für die transformers-Bibliothek bekannt – die populärste Python-Library für Natural Language Processing.
Hugging Face stellt mehrere Schnittstellen zum Zugriff auf LLMs bereit. Es gibt ein benutzerfreundliches Playground-Interface namens „Spaces“:

Screenshot des „Spaces“-Playgrounds bei Hugging Face.
Zudem sind Modellhosting und das Bereitstellen von Endpunkten möglich sowie der direkte Download zur lokalen Nutzung.
Wichtig: Hugging Face ist eine Art „Developer-Site“. Zwar findest du Einstiegs-Tutorials, aber um Modelle für produktive Anwendungen zu skalieren, brauchst du technisches Know-how.
Wenn du mehr über Hugging Face lernen möchtest, empfehle ich den Artikel What is Hugging Face? The AI Community's Open-Source Oasis.
Ein ergänzendes Tool, das ich häufig zusammen mit Hugging Face zum Aufbau LLM-gestützter Anwendungen von Grund auf nutze, ist LangChain. Eine gute praktische Einführung bietet das Tutorial How to Build LLM Applications with LangChain.
Wir haben verschiedene Wege besprochen, LLMs wie GPT, LLaMa und Mistral zu nutzen und zu betreiben. Es gibt jedoch viele weitere Modelle, einschließlich zahlreicher Varianten der genannten. In diesem Abschnitt ordnen wir die wichtigsten heute verfügbaren Modelle ein und listen ihre Eigenschaften, Preise und Einsatzgebiete.
OpenAI-Modelle sind seit dem Start von ChatGPT sehr populär – heute läuft ChatGPT je nach Abo auf GPT-3.5 oder GPT-4. Für viele Basistasks ist der Unterschied zwischen GPT-3.5 und GPT-4 gering.
Bei komplexem Reasoning zeigt GPT-4 jedoch deutlich höhere Leistungsfähigkeit als frühere Modelle.
Außerdem ist GPT-4 multimodal: Es akzeptiert Text- oder Bildeingaben und gibt Text aus. Zusätzlich lassen sich Plugins nutzen, um externe Quellen anzubinden – etwa fürs Browsen im Internet per Bing-Suche.
Über die OpenAI API stehen zahlenden Kundinnen und Kunden drei Hauptvarianten von GPT-4 zur Verfügung:
|
Modell |
Eigenschaften |
Kontextfenster |
API |
Lokal |
Token-Preis |
Trainingsdaten |
|
GPT-4 |
Snapshot von gpt-4 vom 13. Juni 2023. Dieser Endpunkt erhält laufend Updates. Für Chat optimiert. |
8.192 Tokens |
Nein |
$0,03 / 1K Tokens (Input) $0,06 / 1K Tokens (Output) |
Dez 2023 |
|
|
GPT-4 Turbo |
API-Name: gpt-4-turbo-preview. Hervorragend z. B. für Codegenerierung; soll Fälle von „Laziness“ reduzieren. |
128k Tokens |
Nein |
$0,01 / 1K Tokens (Input) $0,03 / 1K Tokens (Output) |
Dez 2023 |
|
|
GPT-4 Vision |
API-Name: gpt-4-vision-preview. GPT-4 mit Bildverständnis – zusätzlich zu allen GPT-4-Turbo-Fähigkeiten. |
128k Tokens |
Nein |
$0,01 / 1K Tokens (Input) $0,03 / 1K Tokens (Output) |
Apr 2023 |
Generell gilt: GPT-Modelle sind – anders als LLaMa – Closed Source. Wir können sie also weder lokal ausführen noch eigene Endpunkte deployen.
Es gibt jedoch Anpassungsmöglichkeiten über die OpenAI-Fine-tuning API. Außerdem sind sie nicht über Drittanbieter wie Ollama, LLAMA API oder Hugging Face zugänglich.
Im OpenAI Playground sind die zugrunde liegenden Modellinfos nicht klar ausgewiesen, es scheint aber auf einem GPT-4-Modell mit DALL·E-, Browsing- und Analysefunktionen zu basieren.
Schauen wir uns auch die verfügbaren GPT-3-Modelle an!
|
Modell |
Eigenschaften |
Kontextfenster |
API |
Lokal |
Token-Preis |
Trainingsdaten |
|
GPT-3.5 Turbo |
API-Name: gpt-3.5-turbo. Flaggschiff-Modell dieser Familie. Für Dialog optimiert; höhere Genauigkeit beim Antworten im gewünschten Format. |
16.385 Tokens |
Nein |
$0,0005 / 1K Tokens (Input) $0,0015 / 1K Tokens (Output) |
Sep 2021 |
|
|
GPT-3.5 Turbo Instruct |
API-Name: gpt-3.5-turbo-instruct. Fokussiert auf Genauigkeit und Relevanz der Antworten, eng an Nutzerbedürfnissen ausgerichtet. |
4.096 Tokens |
Nein |
$0,0015 / 1K Tokens (Input) $0,0020 / 1K Tokens (Output) |
Sep 2021 |
Das in der Tabelle aufgeführte GPT-3.5 Turbo Instruct wurde per Reinforcement Learning from Human Feedback (RLHF) darauf getrimmt, den Nutzerintentionen besser zu folgen.
RLHF integriert menschliches Feedback in den Reinforcement-Learning-Prozess, um die Lernergebnisse von KI-Agenten gezielt zu verbessern. So entstehen Modelle, die menschlichen Werten und Präferenzen besser entsprechen, indem Urteile, Korrekturen oder Vorlieben direkt in den Trainingszyklus einfließen.
Wie die Tabelle zeigt, ist die Nutzung beider GPT-3.5-Modelle deutlich günstiger als GPT-4.
Ich empfehle daher meist, die Leistung der Modelle an einem Satz gut definierter Beispiele zu vergleichen, um zu prüfen, ob GPT-3.5 für die aktuelle Aufgabe ausreicht – und so Inferenzkosten zu sparen.
Wie bereits erwähnt, lassen sich LLaMa-Modelle frei herunterladen und lokal ausführen – oder für eigene Anpassungen nutzen.
Die LLaMa-Familie von Meta AI umfasst eine große Bandbreite an offenen Modellen in verschiedenen Größen und Varianten:
|
Modell |
Eigenschaften |
Kontextfenster |
API |
Lokal |
Variante |
Trainingsdaten |
|
LLaMa 2 |
Basis-, kein Chat-Modell für Completion-Aufgaben. |
4.096 Tokens |
Ja |
Ja* |
7B 13B 70B |
Sep 2022 |
|
LLaMa 2 Chat |
Basis LLaMa 2 mit Instruction Tuning – aus einfachem Completion wird ein Chat-Modell, das Nutzerintentionen folgt. |
4.096 Tokens |
Ja |
Ja* |
7B 13B 70B |
Sep 2022 |
|
LLaMa 2 Guard |
Input-Output-Schutzmodell zum Erkennen toxischer und schädlicher Inhalte. |
4.096 Tokens |
Ja** |
Nein |
7B |
Sep 2022* |
*Hugging Face bietet ebenfalls Varianten von LLaMa an, z. B. das Basismodell und das Chat-Modell. **LLaMa 2 Guard ist derzeit in der Cloud-Umgebung von Amazon SageMaker verfügbar.
Anders als GPT-Modelle, die Coding-Fähigkeiten integriert haben, gibt es bei LLaMa dedizierte Modelle fürs Programmieren mit größeren Kontextfenstern von 16k Tokens, erreicht durch Long-Context-Fine-Tuning.
|
Modell |
Eigenschaften |
Kontextfenster |
API |
Lokal |
Variante |
Trainingsdaten |
|
Code LLaMa |
Basis-, kein Chat-Modell für Code-Completion-Aufgaben, ähnlich GitHub Copilot. Basiert auf LLaMa 2 mit zusätzlichem Training auf Code und Long-Context- Fine-Tuning. |
16k |
Nein |
Ja |
7B 13B 34B |
Sep 2022* |
|
Code LLaMa – Instruct |
Abgeleitet von Instruct-Modellen. Stark bei Code-Completion und Erklärungen zu Code. |
16k |
Ja |
Ja |
7B 13B 34B |
Sep 2022* |
|
Code LLaMa – Python |
Für die Programmiersprache Python feinabgestimmt. |
16k |
Nein |
Ja |
34B |
Sep 2022* |
* Offizieller Cutoff der LLaMa-Modelle ist Sep 2022. Tuning-Daten sind jedoch aktueller (2023), insbesondere bei neueren Varianten.
Google entwickelt seit Langem Large Language Models. Mit Gemini startete Google seine Generation multimodaler LLMs.
Im Google-Portfolio ist Gemini das Flaggschiff – Closed Source wie ChatGPT. Kürzlich erschien jedoch Gemma – eine Suite von Open-Source-Modellen, abgeleitet von Gemini, um den Einstieg in KI-Entwicklung zu erleichtern.
In diesem Artikel betrachten wir sowohl Gemini als auch Gemma:
|
Modell |
Eigenschaften |
API |
Lokal |
Varianten |
|
Gemini |
Closed-Source-Modell für allgemeine Aufgaben (Textgenerierung, Übersetzung, Q&A, Code usw.) |
Ja* |
Nein |
Ultra – Für komplexe Aufgaben. Pro – Breites Aufgabenspektrum. Skalierbar. Nano – Effizient für On-Device. |
|
Gemma |
Ähnliche Aufgaben wie Gemini, aber auf Integration in individuelle Anwendungen und Forschung ausgerichtet. Leichtgewichtig. |
Ja**LLAMA API |
JaOllama |
2B 7B |
*Es gibt eine API für Gemini für kommerzielle Zwecke (kein offenes Deployment). Über den Playground lässt sich das Modell dennoch ausprobieren.
**Es gibt keinen nativen Google-Endpunkt, aber das Modell ist über Kaggle und Google Colab zugänglich. Mehr dazu in der offiziellen Google-Dokumentation.
Zu den Varianten: Gemini Ultra ist multimodal und stark bei komplexer Analyse. Gemini Pro balanciert Leistung und Skalierbarkeit und überzeugt u. a. bei Code- und Textgenerierung. Gemini Nano ist auf effiziente On-Device-Nutzung fokussiert und läuft auf Mobil- und Edge-Geräten ohne großen Ressourcenbedarf.
Zu Googles Modellen sind zum Zeitpunkt des Schreibens nur wenige öffentliche Details zu Kontextfenstern und dem Cutoff der Trainingsdaten verfügbar.
Mistral AI ist ein französisches KI-Unternehmen, gegründet im April 2023 von ehemaligen Mitarbeitenden von Meta Platforms und Google DeepMind. Der Fokus liegt auf Open-Source-LLMs – als Gegenpol zu proprietären Modellen. Zu den Modellen gehören Mistral 7B und Mixtral 8x7B mit fortgeschrittenen Sprachfähigkeiten.
|
Modell |
Eigenschaften |
Kontext fenster |
API |
Lokal |
Token-Preis |
Trainingsdaten |
|
Mistral |
Allgemeines Modell mit 7B Parametern. Optimiert für Englisch und Codegenerierung. |
32k |
Ja* |
Ja |
$0,25 / 1M Tokens (Input und Output) |
Sep 2023 |
|
Mixtral |
Leistungsstärkstes Allzweckmodell. Fließend in Englisch, Französisch, Italienisch, Deutsch, Spanisch und stark bei Coding-Aufgaben. Basiert auf einer sparsamen Mixture-of-Experts-Architektur mit 7B-Parametern. |
32k |
Ja* |
Ja |
$0,7 / 1M Tokens (Input und Output) |
Dez 2023 |
*Mit den Modellen von Mistral AI können wir über den Playground „La Plataforme“ interagieren.
**Hugging Face bietet für einige Modelle auch eine Testumgebung für Echtzeit-Inferenz über die API. Außerdem lassen sich kostenpflichtige Endpunkte zu verfügbaren Modellen deployen.
Zur Mixtral-Architektur: Die „Mixture-of-Experts“ teilt die Gesamtfähigkeiten des Modells auf spezialisierte Gruppen („Experten“) auf. Jeder Experte ist auf bestimmte Aufgaben- oder Datentypen optimiert.
Bei der Verarbeitung eines Inputs aktiviert Mixtral dynamisch nur die relevanten Experten. So bearbeitet es komplexe Aufgaben effizient, indem pro Token nur ein Teil der gesamten Parameter genutzt wird. Das steigert die Leistung bei vielfältigen Sprachen und Aufgaben und optimiert den Rechenaufwand. Der Modellname „Mixtral 8x7B“ verweist darauf, dass 8 unterschiedliche Expertengruppen genutzt werden.
Mistral AI bietet zudem drei kommerzielle Modelle: Mistral Small, Mistral Medium und Mistral Large. Details zu Modellen und Preisen findest du in der offiziellen Doku.
Wir haben bisher mehrere Modelle und Varianten der bekanntesten Anbieter gesehen. Es gibt jedoch noch viel mehr zu entdecken!
Hervorheben möchte ich die Falcon-Modelle des Technology Innovation Institute, verfügbar in Ollama und bei der LLAMA API. Außerdem Microsoft Researchs Orca2, das besonders im Reasoning überzeugt – ebenfalls in Ollama und bei Hugging Face verfügbar.
Über weitere offene Modelle kannst du hier lesen: 8 Top Open-Source LLMs für 2024 und ihre Einsatzgebiete.
In diesem Artikel haben wir mehrere Aspekte diskutiert, die bei der Auswahl des besten Large Language Models für unsere Zielanwendung relevant sind. Auch wenn dieser Leitfaden als Spickzettel dienen soll, gibt es keine Patentlösung, die sofort zum besten Modell führt.
Nach meiner Erfahrung ist es ein guter Startpunkt, festzulegen, wie wir mit dem LLM interagieren wollen. Das reduziert bereits die Zahl der in Frage kommenden Modelle – und Varianten.
Als Zweites sollten wir die Zielaufgabe des Modells klären: generischer Chatbot, Zusammenfassungsprofi, Coding-Assistent usw.
Auch wenn wir ein Modell immer feinabstimmen können, haben wir gesehen, dass es bereits Varianten gibt, die für bestimmte Use Cases feinjustiert sind – das spart Zeit, Rechenressourcen und Spezialwissen. Ebenso entscheidend ist das benötigte Kontextfenster für die Anwendung.
Schließlich ist der Preis immer ein starkes Entscheidungskriterium. Oft begrenzen das Startbudget und die laufenden Kosten die Möglichkeiten eines Projekts. Bedenke dabei stets, dass Training und Fine-Tuning im Projektverlauf zusätzliche, nicht kostenlose Leistungen sind – und zudem zeitintensiv.
Setze deine KI-Reise heute fort!
Lernpfad
Kurs
Kurs