Curso
Trabajar con Hugging Face
2 h
38.2K
En el campo, cada vez más dinámico, de la inteligencia artificial (IA) y el aprendizaje automático (ML), la clasificación de imágenes destaca como una tarea fundamental que impulsa un amplio abanico de aplicaciones, desde sistemas de reconocimiento facial hasta diagnósticos médicos por imagen.
Entre las muchas herramientas y librerías disponibles para científicos de datos y profesionales de IA, Hugging Face se ha consolidado como un actor clave, especialmente para quienes trabajan con procesamiento del lenguaje natural (NLP) y, cada vez más, con tareas de visión por computador como la clasificación de imágenes.
Este artículo cubre lo esencial para usar Hugging Face en clasificación de imágenes: entender los fundamentos, preparar tus datos, entrenar el modelo, desplegarlo en el hub de Hugging Face y, por último, interactuar con el modelo desplegado a través de la API y la interfaz de Hugging Face.
Tanto si estás empezando como si ya tienes experiencia, esta guía te dará claves prácticas para aprovechar Hugging Face en tus proyectos de clasificación de imágenes.
En esta sección verás los conceptos básicos de la clasificación de imágenes y las ventajas de usar Hugging Face.
La clasificación de imágenes consiste en categorizar imágenes en una de varias clases predefinidas.
Esta tarea se resuelve con algoritmos que analizan el contenido visual de una imagen y predicen su categoría a partir de patrones aprendidos del conjunto de entrenamiento. Los modelos de deep learning, en particular las redes neuronales convolucionales (CNN), se han convertido en el enfoque estándar gracias a su capacidad para capturar patrones relevantes en datos de imagen.
Para profundizar en las CNN, nuestro artículo Introducción a las redes neuronales convolucionales (CNN) ofrece una guía completa para entender qué son, su impacto en el análisis de imágenes y estrategias clave para combatir el sobreajuste y lograr CNN robustas en aplicaciones de deep learning.
Además, el artículo Clasificación en machine learning: una introducción recorre paso a paso qué es la clasificación en ML, cómo se utiliza y algunos ejemplos de algoritmos de clasificación.
Hugging Face ofrece un ecosistema amplio para ML, con interfaces sencillas, un enorme repositorio de modelos preentrenados y documentación detallada.
Frente a otras plataformas, Hugging Face aporta varias ventajas para la clasificación de imágenes:
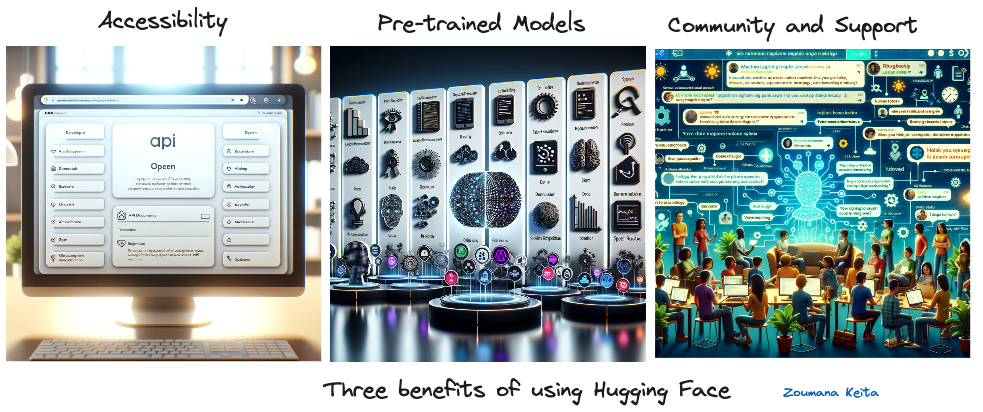
Tres ventajas de usar Hugging Face (imagen generada con GPT-4)
Además, Hugging Face facilita el despliegue de modelos en las principales nubes como AWS, Azure y Google Cloud Platform, junto con múltiples tipos de inferencia.
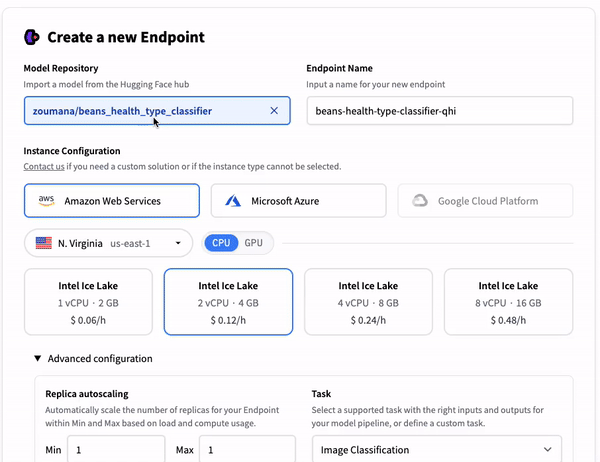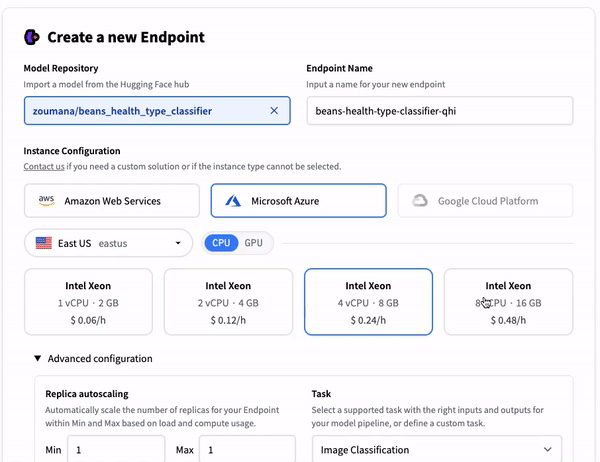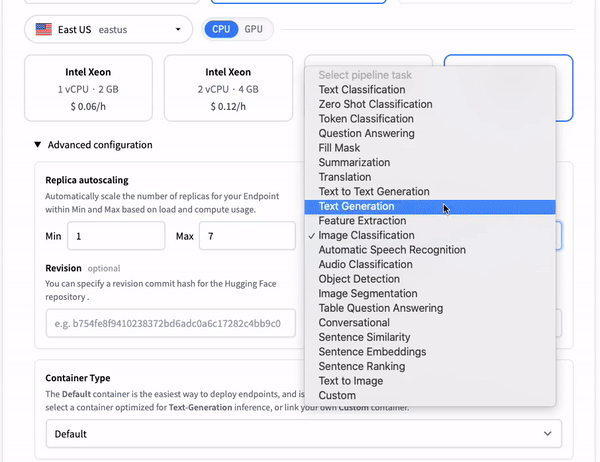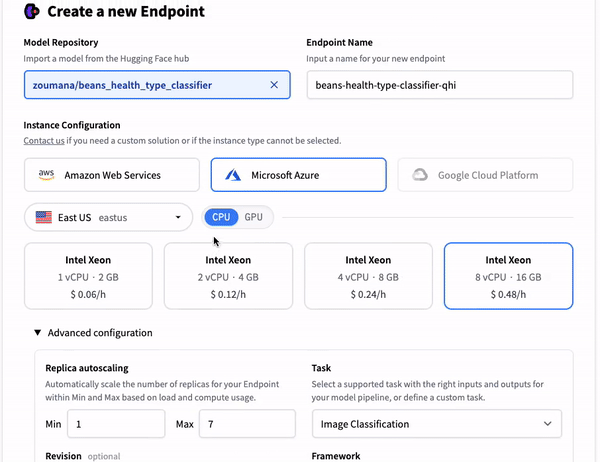
Opciones de despliegue de modelos en plataformas cloud
La tarea principal de este artículo es la clasificación de imágenes y, para el ejemplo, usaremos el conjunto de datos de beans de Hugging Face. Tras cargarlo, haremos algunas visualizaciones antes de entrar en el preprocesado para el entrenamiento.
El cuaderno con el código está disponible para seguirlo en Google Colab.
El código de este artículo se inspira en gran medida en la web oficial de Hugging Face.
Usaremos varias librerías, cada una con un rol específico. Algunas requieren instalación previa. Puedes instalarlas con el gestor de paquetes de Python "pip" así:
%%bash
pip -q install datasets
pip -q install transformers=='4.29.0'
pip -q install tensorflow=='2.15' # At least this tensorflow version is required to use the "evaluate module"
pip -q install evaluate
pip -q install --upgrade accelerate
Es importante reiniciar el kernel tras la instalación. Después, importa las librerías necesarias con las sentencias from e import:
import torch
import torchvision
import numpy as np
import evaluate
from datasets import load_dataset
from huggingface_hub import notebook_login
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
from transformers import DefaultDataCollator
from transformers import AutoImageProcessor
from torchvision.transforms import RandomResizedCrop, Compose, Normalize, ToTensor
from transformers import AutoModelForImageClassification, TrainingArguments, Trainer
import matplotlib.pyplot as pltCargar los datos desde Hugging Face es muy sencillo con la función load_dataset.
beans_train = load_dataset("beans", split="train")beans es el nombre del dataset utilizado.train corresponde al subconjunto de datos empleado.Una vez cargados, podemos consultar sus características simplemente imprimiendo el nombre de la variable anterior.
print(beans_train)Esto devuelve el siguiente resultado:
Dataset({
    features: ['image_file_path', 'image', 'labels'],
    num_rows: 1034
})
Hay un total de 1034 imágenes, y cada imagen tiene tres campos:
image_path: la ruta a la imagen.image: un objeto PIL de la imagen de la hoja de alubia.labels: la etiqueta de la imagen, que puede ser uno de los tres tipos siguientes:La siguiente función auxiliar facilita visualizar un número concreto de imágenes aleatorias y mostrar el tipo correcto junto con sus etiquetas (0, 1 y 2).
labels_names = {
   0: "angular_leaf_spot",
   1: "bean_rust",
   2: "healthy",
}

def display_random_images(dataset, num_images=4):

   num_rows = 2
   num_cols = np.ceil(num_images / num_rows).astype(int)

   plt.figure(figsize=(num_cols * 3, num_rows * 3))
   indices = np.random.choice(range(len(dataset)), size=num_images, replace=False)

   for i, idx in enumerate(indices, 1):
       idx = int(idx)
       image = dataset[idx]['image']
       label = dataset[idx]['labels']
       label_name = labels_names.get(label, "Unknown")

       plt.subplot(num_rows, num_cols, i)
       plt.imshow(image)
       plt.title(f"{label_name} ({label})")
       plt.axis('off')

   plt.tight_layout()
   plt.show()
En resumen, esta función, display_random_images, selecciona un subconjunto aleatorio de imágenes de un dataset y las muestra en una cuadrícula, con cada imagen etiquetada según su clase (por ejemplo, "angular_leaf_spot", "bean_rust", "healthy").
Distribuye dinámicamente las imágenes en dos filas y calcula el número de columnas en función del total a mostrar, evitando duplicados y acompañando cada imagen con su etiqueta nominal y numérica.
Podemos mostrar seis imágenes aleatorias usando la función así:
display_random_images(beans_train, num_images=6)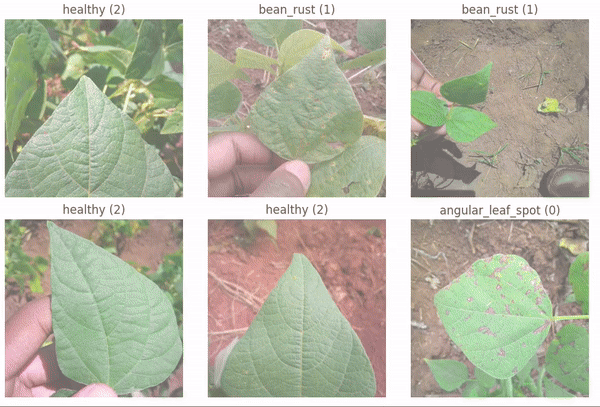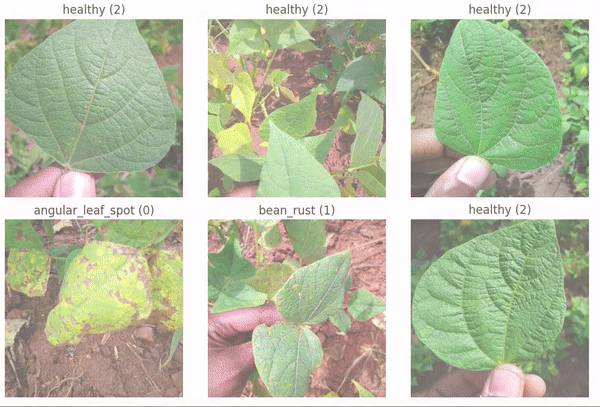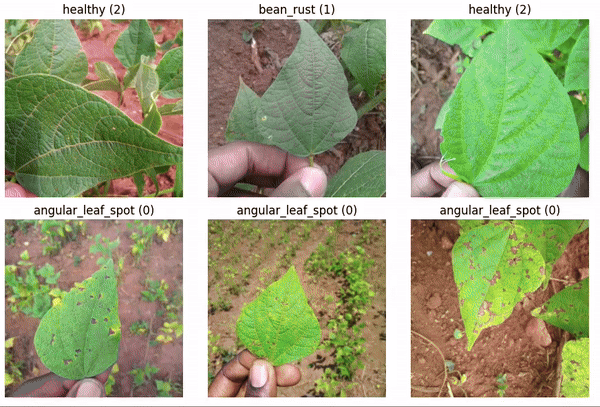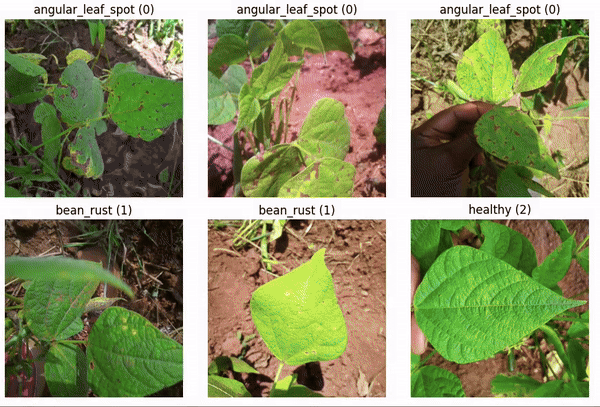
Seis imágenes aleatorias del dataset
Antes de entrenar el modelo, es importante realizar el preprocesado adecuado para que los datos se ajusten a los requisitos del modelo.
Primero, dividimos el dataset original en entrenamiento y validación, respectivamente 80% y 20%, usando la función train_test_split.
beans_train = beans_train.train_test_split(test_size=0.2)A continuación, creamos dos diccionarios: label2id e id2label. Son esenciales para convertir entre nombres de etiquetas legibles y sus identificadores numéricos.
Este proceso facilita tanto el entrenamiento como la interpretación de las predicciones del modelo final.
labels = beans_train["train"].features["labels"].names
label2id, id2label = dict(), dict()

for i, label in enumerate(labels):
   label2id[label] = str(i)
   id2label[str(i)] = label
El resultado de la variable id2label es el siguiente:
print(id2label){'0': 'angular_leaf_spot', '1': 'bean_rust', '2': 'healthy'}Nuestro clasificador se basa en el modelo preentrenado Vision Transformer (ViT) de Hugging Face.
Este modelo se presentó en el artículo An Image is Worth 16x16 words: Transformers for Image Recognition at Scale, marcando la primera aplicación exitosa de la arquitectura transformer al reconocimiento de imágenes, entrenado sobre ImageNet.
El siguiente código explica todos los pasos para cargar el modelo preentrenado, preprocesar los datos según sus requisitos y asegurar que las imágenes se transforman correctamente para el ajuste fino y la evaluación.
checkpoint = "google/vit-base-patch16-224-in21k"
image_processor = AutoImageProcessor.from_pretrained(checkpoint)

normalize = Normalize(mean=image_processor.image_mean,
                  	std=image_processor.image_std)

size = (
	image_processor.size["shortest_edge"]
	if "shortest_edge" in image_processor.size
	else (image_processor.size["height"], image_processor.size["width"])
)

_transforms = Compose([RandomResizedCrop(size), ToTensor(), normalize])

def transforms(examples):

	examples["pixel_values"] = [_transforms(img.convert("RGB")) for img in examples["image"]]
	del examples["image"]
	return examples

beans_transformed = beans_train.with_transform(transforms)

data_collator = DefaultDataCollator()
Qué está ocurriendo en el código anterior:
google/vit-base-patch16-224-in21k._transforms) que incluyen recorte aleatorio, conversión a tensor y normalización.beans_train con esa función, dejándolo listo para el entrenamiento.Tras estas preparaciones, la métrica de evaluación para medir el rendimiento del modelo es la accuracy, implementada con la siguiente función auxiliar.
accuracy = evaluate.load("accuracy")
def compute_metrics(eval_pred):
   predictions, labels = eval_pred
   predictions = np.argmax(predictions, axis=1)

   return accuracy.compute(predictions=predictions,
references=labels)Antes del proceso de entrenamiento, definimos el modelo aprovechando el preentrenado con la función .from_pretrained así:
model = AutoModelForImageClassification.from_pretrained(
   checkpoint,
   num_labels=len(labels),
   id2label=id2label,
   label2id=label2id,
)El siguiente paso es configurar e inicializar el entorno de entrenamiento.
La configuración incluye los hiperparámetros necesarios para entrenamiento, evaluación y optimización.
Antes, sin embargo, necesitamos iniciar sesión en nuestra cuenta de Hugging Face con nuestras credenciales, que puedes obtener así:
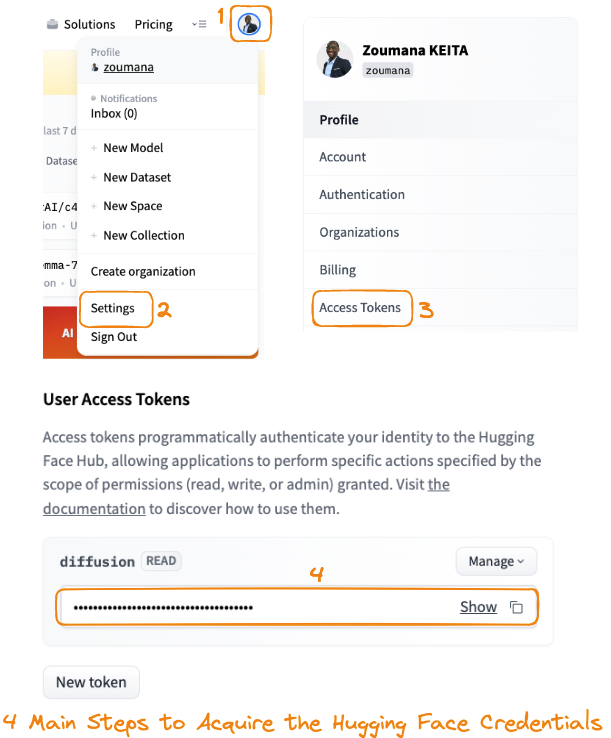
Pasos principales para obtener las credenciales de Hugging Face
Al iniciar sesión en Hugging Face, podrás subir y compartir tus modelos con la comunidad. A continuación, lanzamos la autenticación con la función notebook_login.
notebook_login()Cuando se te solicite, introduce el token de conexión copiado en el paso 4 de la guía anterior.
Tras iniciar sesión correctamente, debería aparecer el siguiente mensaje:
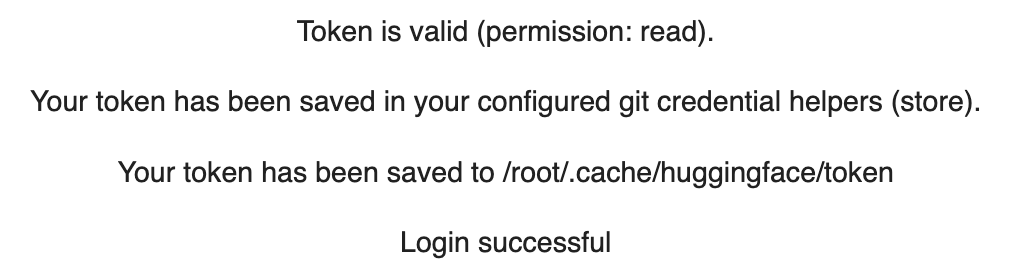
El código de configuración e inicialización es el siguiente:
training_args = TrainingArguments(
	output_dir="./beans_health_type_classifier",
	remove_unused_columns=False,
	evaluation_strategy="epoch",
	save_strategy="epoch",
	learning_rate=5e-5,
	per_device_train_batch_size=16,
	gradient_accumulation_steps=4,
	per_device_eval_batch_size=16,
	num_train_epochs=3,
	warmup_ratio=0.1,
	logging_steps=10,
	load_best_model_at_end=True,
	metric_for_best_model="accuracy"
)

trainer = Trainer(
	model=model,
	args=training_args,
	data_collator=data_collator,
	train_dataset=beans_transformed["train"],
	eval_dataset=beans_transformed["test"],
	tokenizer=image_processor,
	compute_metrics=compute_metrics,
)TrainingArguments se configuran con parámetros como el directorio de salida, la estrategia de evaluación y guardado por época, tasa de aprendizaje, tamaño de batch, pasos de acumulación de gradiente y otros ajustes para optimizar el entrenamiento y el rendimiento.Trainer con el modelo, los argumentos de entrenamiento, el data collator para el batching, los datasets de entrenamiento y evaluación, el procesador de imágenes para el preprocesado y una función para calcular métricas.Ahora llega la fase de entrenamiento, que se lanza con la función .train.
trainer.train()Este entrenamiento concreto arrojó las siguientes métricas:
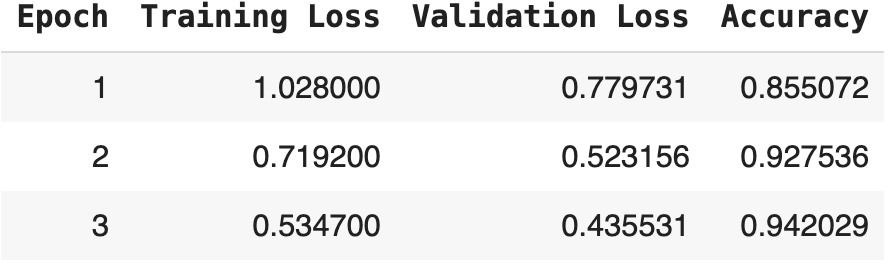
Resultado del entrenamiento del modelo durante tres épocas
La tabla muestra la progresión del entrenamiento a lo largo de tres épocas en el dataset de beans, con tres métricas clave: pérdida de entrenamiento, pérdida de validación y accuracy.
Al autenticarte por primera vez en el portal de Hugging Face, el modo de conexión era solo de lectura. Sin embargo, necesitamos credenciales de escritura para poder subir el modelo al hub de Hugging Face.
Después, vuelve a iniciar sesión con notebook_login usando las nuevas credenciales.
notebook_login()La subida del modelo se realiza con la función push_to_hub así:
trainer.model.push_to_hub("zoumana/beans_health_type_classifier")Esto enviará el modelo al hub, donde podrás ver sus propiedades principales.
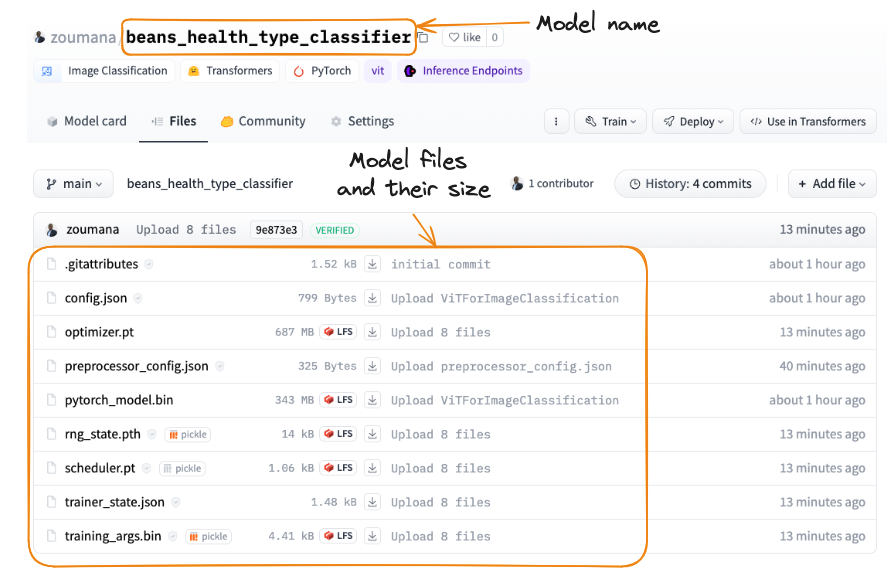
Modelo subido a Hugging Face
Una vez compartido, el modelo puede integrarse en aplicaciones mediante REST API, o los usuarios pueden utilizarlo directamente desde el portal de Hugging Face. Desarrolladores e investigadores también pueden cargarlo con la librería Transformers.
En esta sección, cubrimos tres formas principales de usar el modelo.
En el portal, puedes subir una imagen y obtener las predicciones del modelo, como se muestra en la siguiente animación.
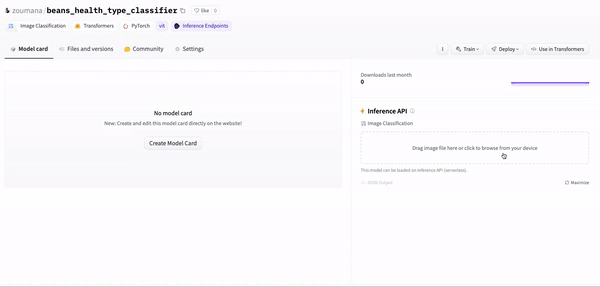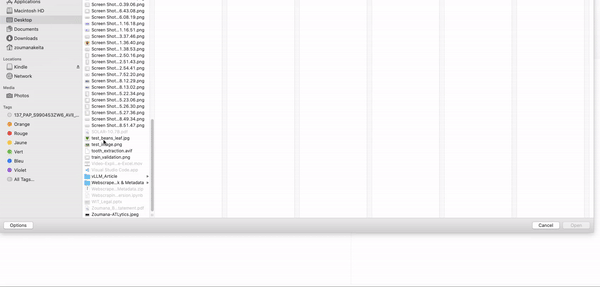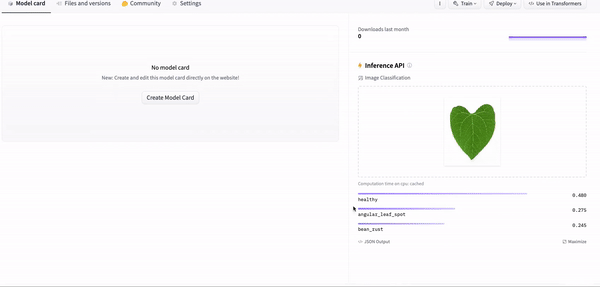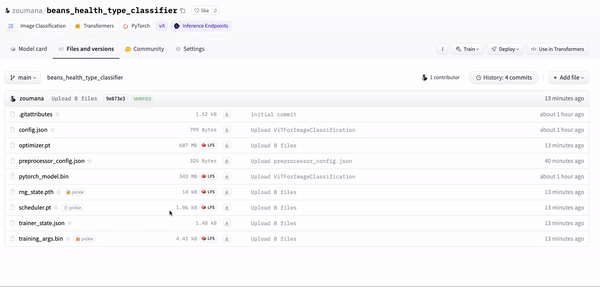
Usar el modelo desde el portal de Hugging Face
Al seleccionar el icono “Use in Transformers”, se genera automáticamente el código necesario, como sigue:
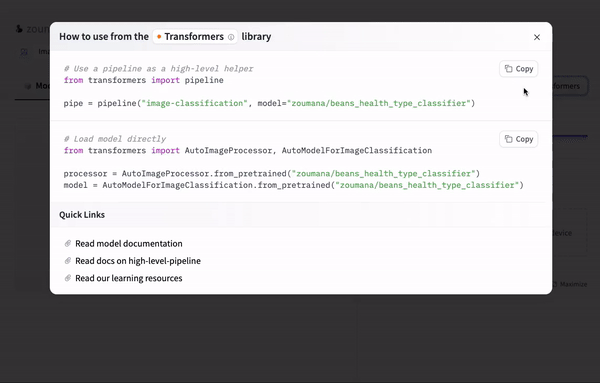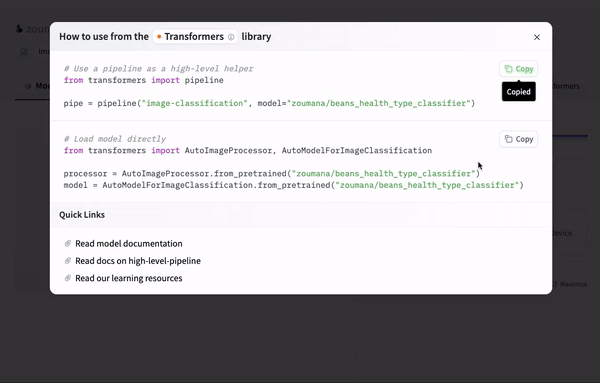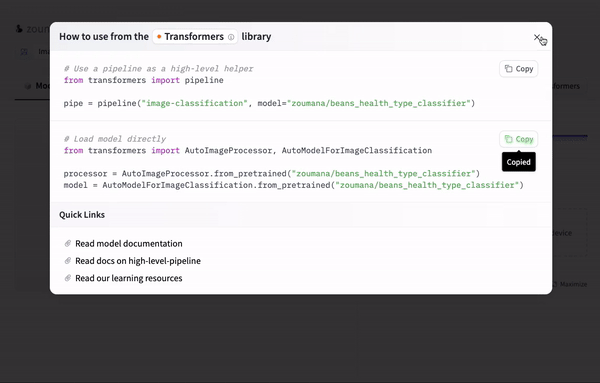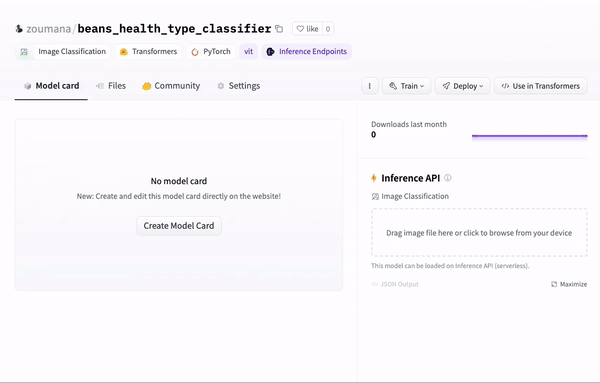
Usar el modelo con Transformers
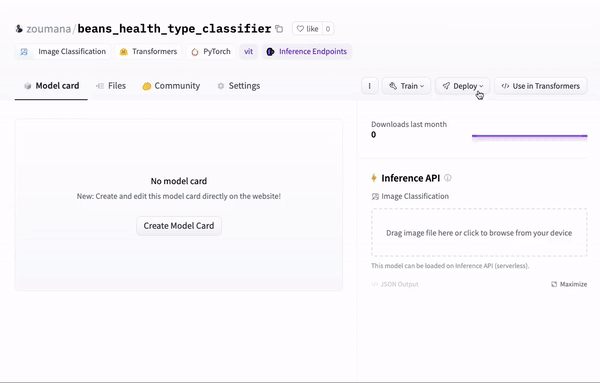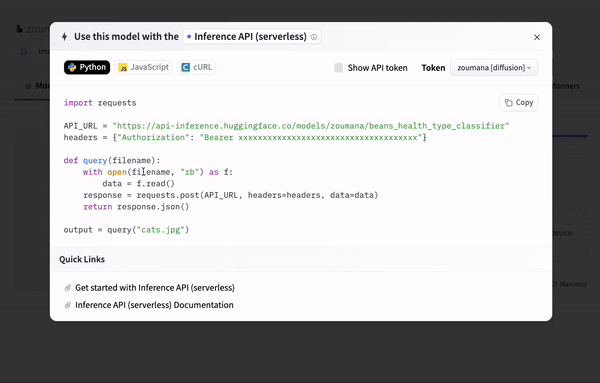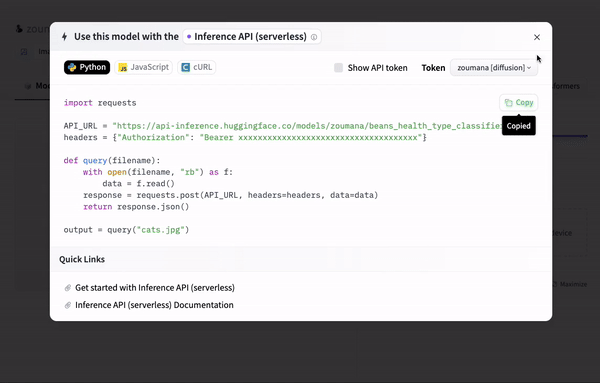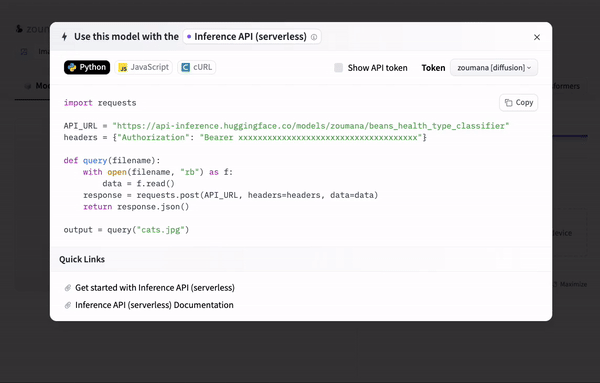
Por último, puedes usar el modelo como REST API con la cadena de conexión que proporciona el portal al hacer clic en “Deploy > Inference API (serverless)”.
Usar un endpoint de API
El snippet mostrado en la animación anterior es el mismo que verás abajo y sirve para hacer predicciones sobre una imagen dada.
La imagen utilizada es la misma que en el ejemplo del portal de Hugging Face.
Asegúrate de sustituir “xxx” por los valores reales.
import requests

API_URL = "https://api-inference.huggingface.co/models/zoumana/beans_health_type_classifier"
headers = {"Authorization": "Bearer xxxxxxxxxxxxxxxxx"}

def query(filename):
   with open(filename, "rb") as f:
       data = f.read()
   response = requests.post(API_URL, headers=headers, data=data)
   return response.json()
Después, obtenemos la respuesta del modelo usando la función query anterior.
output = query("./inference_images/test_beans_leaf.jpg")El resultado final es una respuesta JSON como la siguiente. La etiqueta predicha es la que tiene mayor probabilidad; en este caso, healthy, exactamente igual que en el portal de Hugging Face.
print(output)[
{'label': 'healthy', 'score': 0.4799719452857971},
{'label': 'angular_leaf_spot', 'score': 0.27489492297172546},
{'label': 'bean_rust', 'score': 0.2451331913471222}
]Este artículo te ha guiado paso a paso para abordar tareas de clasificación de imágenes con Hugging Face.
Empezamos con los fundamentos y vimos por qué Hugging Face es una gran opción gracias a su amplia colección de modelos y su comunidad.
Luego cubrimos cómo preparar las imágenes para el entrenamiento, asegurando que los datos cumplen los requisitos del ajuste fino.
Además, profundizamos en cómo ajustar un modelo con Hugging Face eligiendo el preentrenado adecuado, y explicamos cómo integrarlo en aplicaciones reales con tres estrategias principales.
Siempre hay más que explorar en IA, y cada paso abre nuevas posibilidades. Si quieres seguir aprendiendo sobre IA y ML, especialmente clasificación de imágenes y más, aquí tienes recursos recomendados:
Esta guía pretende ayudarte a arrancar tus propios proyectos de clasificación de imágenes con Hugging Face, tanto si eres principiante como si tienes un nivel intermedio o avanzado.
¡Empieza hoy tu camino en IA!
Curso
Curso
programa
blog
Zoumana Keita
14 min
blog
Abid Ali Awan
10 min
blog
Adel Nehme
15 min
Tutorial
Arunn Thevapalan
13 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Zoumana Keita
14 min