
Cours
Concepts d'IA générative
2 h
117.3K
Si vous avez déjà ressenti la frustration d'attendre la réponse de ChatGPT, vous allez adorer découvrir le moteur d'inférence LPU (Language Processing Unit) de Groq.
Avec Groq, vous obtenez des réponses à vos requêtes en un éclair, faisant passer les temps d'attente de 40 secondes à seulement 2 secondes.
Dans ce tutoriel, nous allons :
Si vous débutez avec les grands modèles de langage (LLM), nous vous recommandons le parcours de compétences Developing Large Language Models pour apprendre les bases du fine-tuning des LLM et construire votre propre modèle from scratch.
Le moteur d'inférence LPU (language processing unit) de Groq est un nouveau système de traitement conçu pour exécuter des tâches computationnelles intensives à composantes séquentielles, en particulier la génération de réponses pour les grands modèles de langage. Cette technologie transforme la façon dont nous traitons et générons du texte, avec des performances et une précision sans précédent.
Comparée aux architectures classiques CPU (processeur central) et GPU (processeur graphique), la LPU offre une capacité de calcul supérieure. Concrètement, le temps nécessaire pour prédire un mot est considérablement réduit, ce qui accélère fortement la génération de texte. En outre, la LPU atténue les goulets d'étranglement liés à la mémoire, une limite fréquente des GPU avec les LLM.
Groq a conçu la LPU pour répondre à des enjeux clés : densité de calcul, bande passante mémoire, faible latence et haut débit. Les gains de performance dépassent ceux des GPU et des TPU (tensor processing units). Par exemple, la LPU peut générer plus de 310 tokens par seconde et par utilisateur sur Llama-3 70B.
Pour en savoir plus sur l'architecture LPU, consultez l'article de référence Groq ISCA 2022 Paper.
À ce jour, l'accès aux LLM Groq se fait via groq.com, l'API Groq Cloud, le Groq Playground, et des plateformes tierces comme Poe.
Dans cette section, nous allons passer en revue les fonctionnalités et les modèles proposés par OpenAI et Groq Cloud. Nous testerons également la vitesse des appels API avec CURL et comparerons la conception des API.
L'API OpenAI propose un large éventail de fonctionnalités et de modèles. Elle offre :
L'API OpenAI est rapide et devient moins coûteuse au fil du temps.
Nous pouvons appeler le dernier modèle OpenAI via la commande suivante dans le terminal. L'API nécessite la clé API d'OpenAI, le nom du modèle et les messages contenant le prompt système et la requête utilisateur.
curl -X POST https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-4o",
    "messages": [
      {        "role": "system",
        "content": "You are a helpful assistant."
      },
      {
        "role": "user",
        "content": "How do I get better at programming?"
      }
    ]
  }'
La requête a pris 13 secondes.
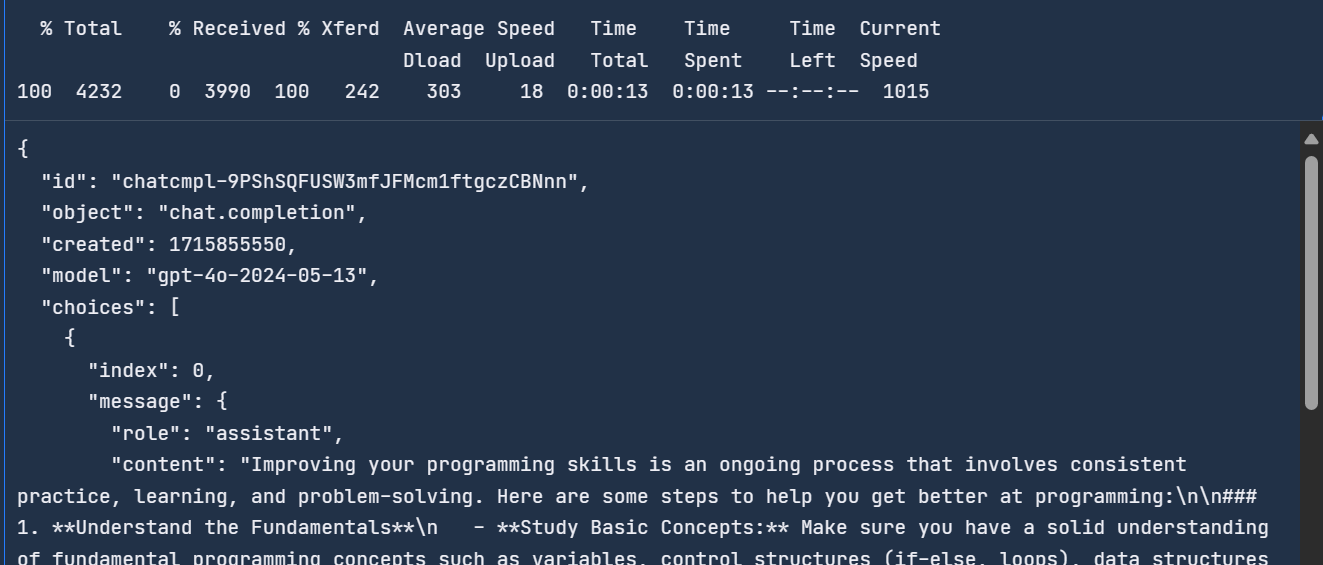
Pour en savoir plus sur l'API OpenAI et ses fonctionnalités, consultez ce guide pour débutants de l'API OpenAI : tutoriel pratique et bonnes pratiques.
Groq est un nouvel acteur de l'IA et propose pour l'instant un ensemble limité de fonctionnalités et de modèles. Il offre :
L'API Groq Cloud fournit un temps de réponse plus court que l'API OpenAI. Pour le vérifier, nous allons utiliser la commande CURL dans le terminal et envoyer le même message à l'API Groq.
L'API Groq est similaire à l'API OpenAI, la seule différence étant l'URL.
curl -X POST "https://api.groq.com/openai/v1/chat/completions" \
    -H "Authorization: Bearer $GROQ_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{"messages": [
     {
       "role": "system",
       "content": "You are a helpful assistant."
     },
     {        "role": "user",
       "content": "How do I get better at programming?"
     }
   ],
   "model": "llama3-70b-8192"}'
La réponse est arrivée en deux secondes, soit 6,5 fois plus vite que l'API OpenAI.
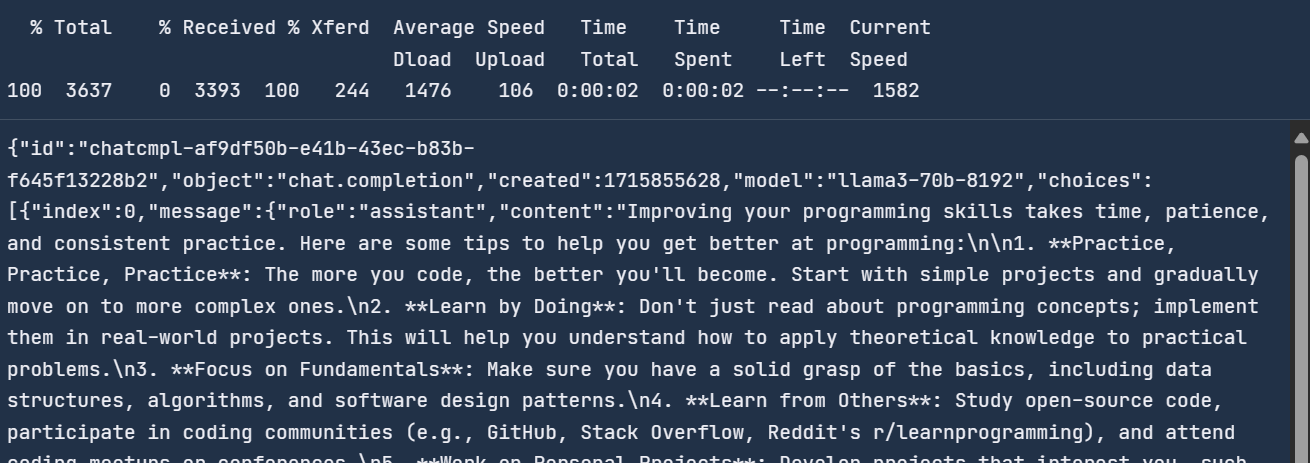
Avec Groq, vous bénéficiez d'une génération de réponses en temps réel, cruciale pour certaines applications.
Groq Cloud inclut un playground d'IA où vous pouvez tester l'ensemble des modèles et des API à utiliser pour créer des produits et applications d'IA.
Pour accéder à Groq Cloud, commencez par créer un compte via ce lien.
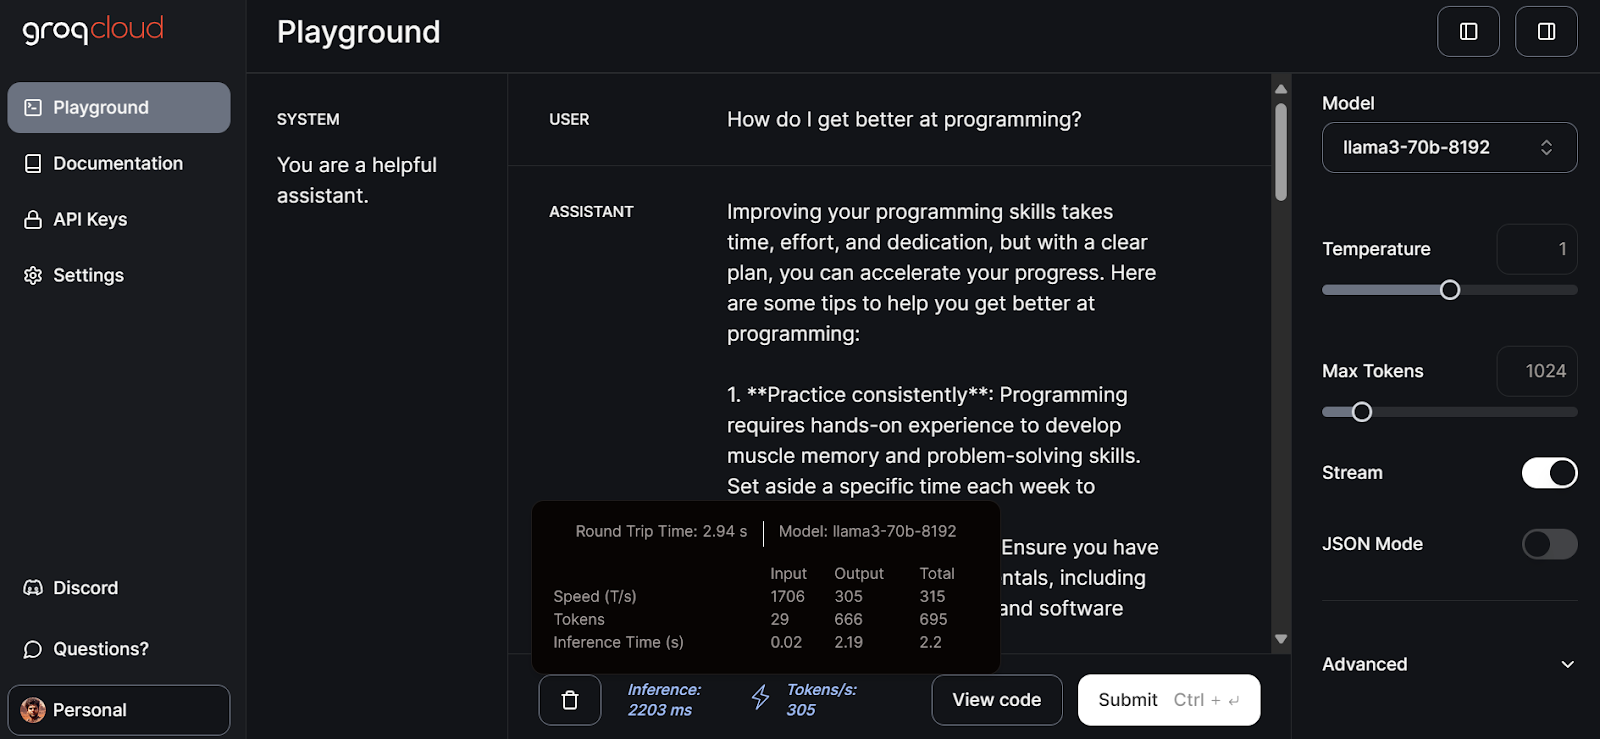
Ensuite, cliquez sur l'onglet Playground dans le panneau de gauche, sélectionnez le modèle llama3-70b-8192 et commencez à rédiger des prompts dans le champ USER.
La génération complète de la réponse a pris 2,94 secondes à une vitesse de 305 tokens par seconde. Des performances de pointe qu'on n'obtient pas avec ChatGPT.
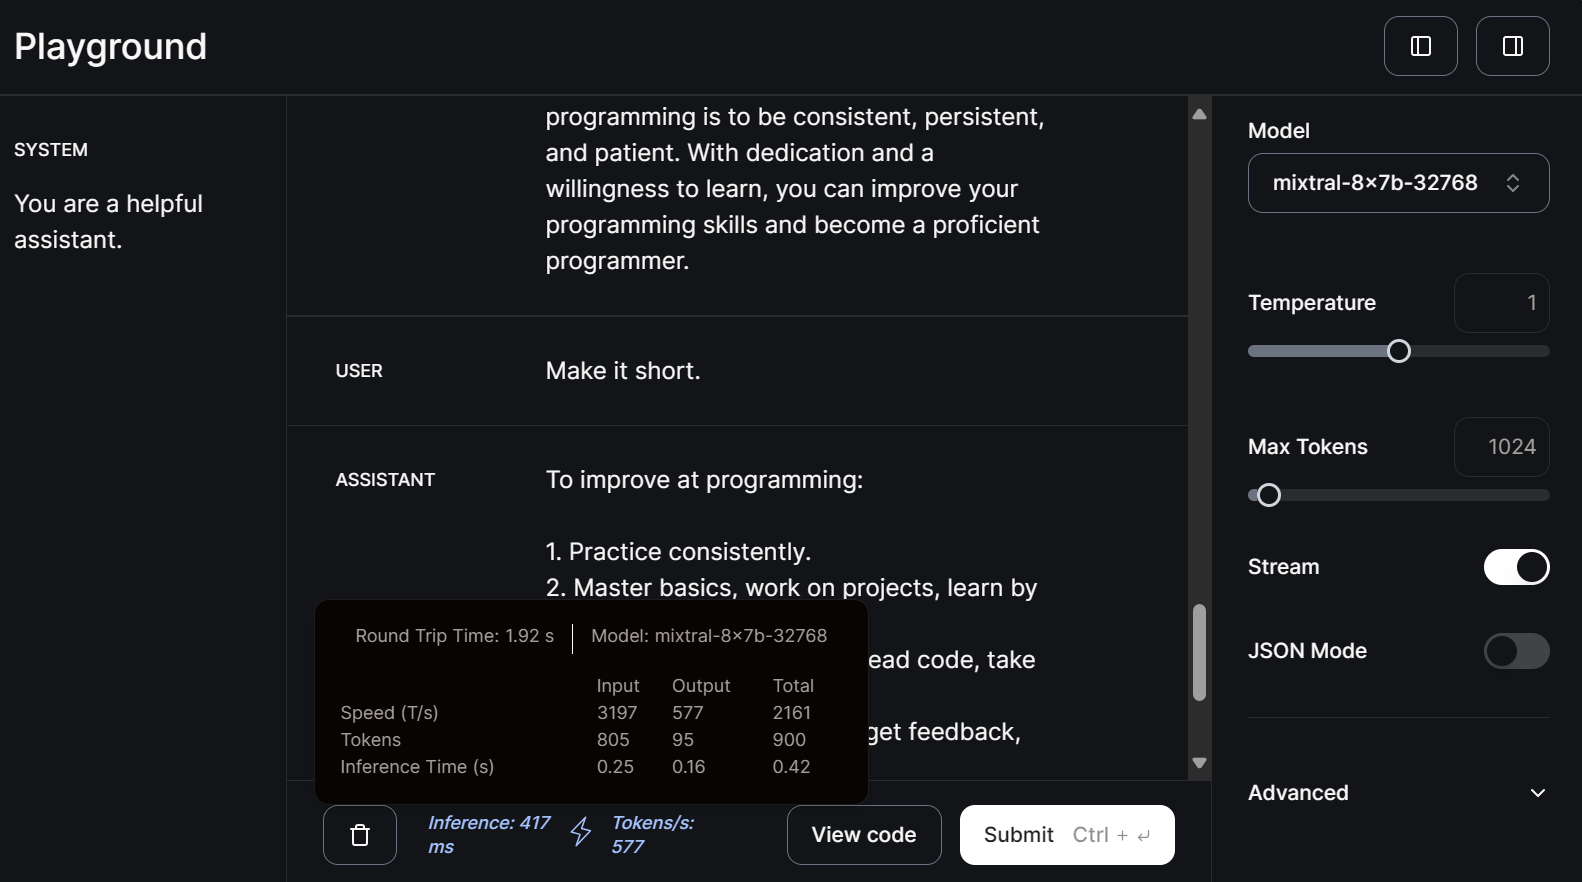
Sélectionnons maintenant le petit modèle mitral-8x7b-32768 et rédigons un prompt de relance.
Les modèles plus petits sont encore plus rapides, avec une vitesse d'environ 577 tokens par seconde.
Pour choisir le bon LLM selon votre cas d'usage, lisez ce tutoriel : LLM Classification : comment sélectionner le meilleur LLM pour votre application.
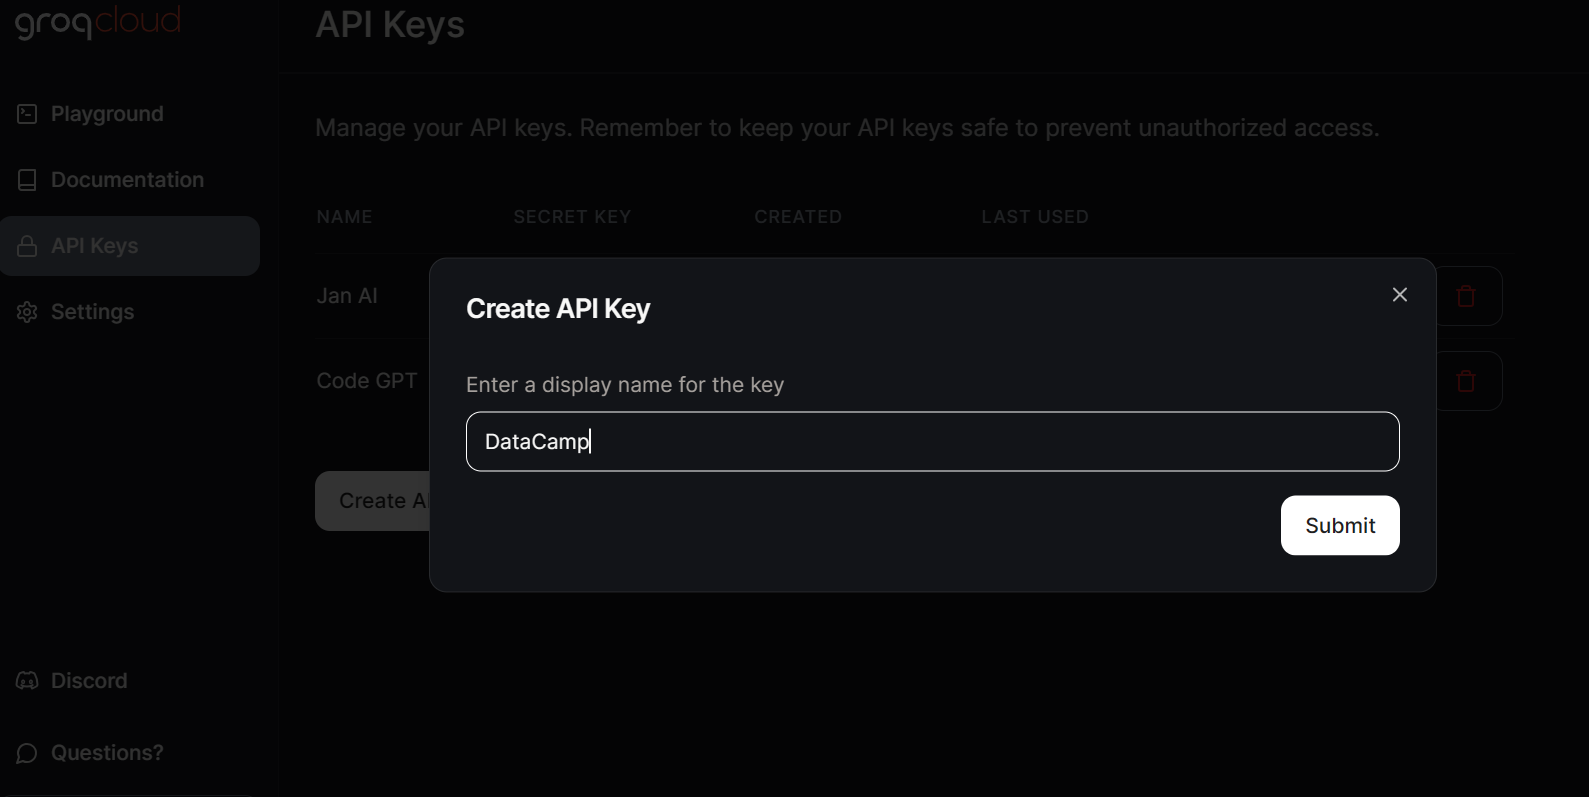
Pour utiliser les LLM Groq en local, générez une clé d'API en allant dans l'onglet API Keys et en cliquant sur Create API Key.
Jan AI permet d'utiliser des LLM en local — qu'ils soient open source ou propriétaires. Il prend en charge des fournisseurs de modèles comme OpenAI, Anthropic, Cohere, MistralAI et Groq.
Téléchargez et installez Jan AI depuis le site officiel, puis lancez l'application.
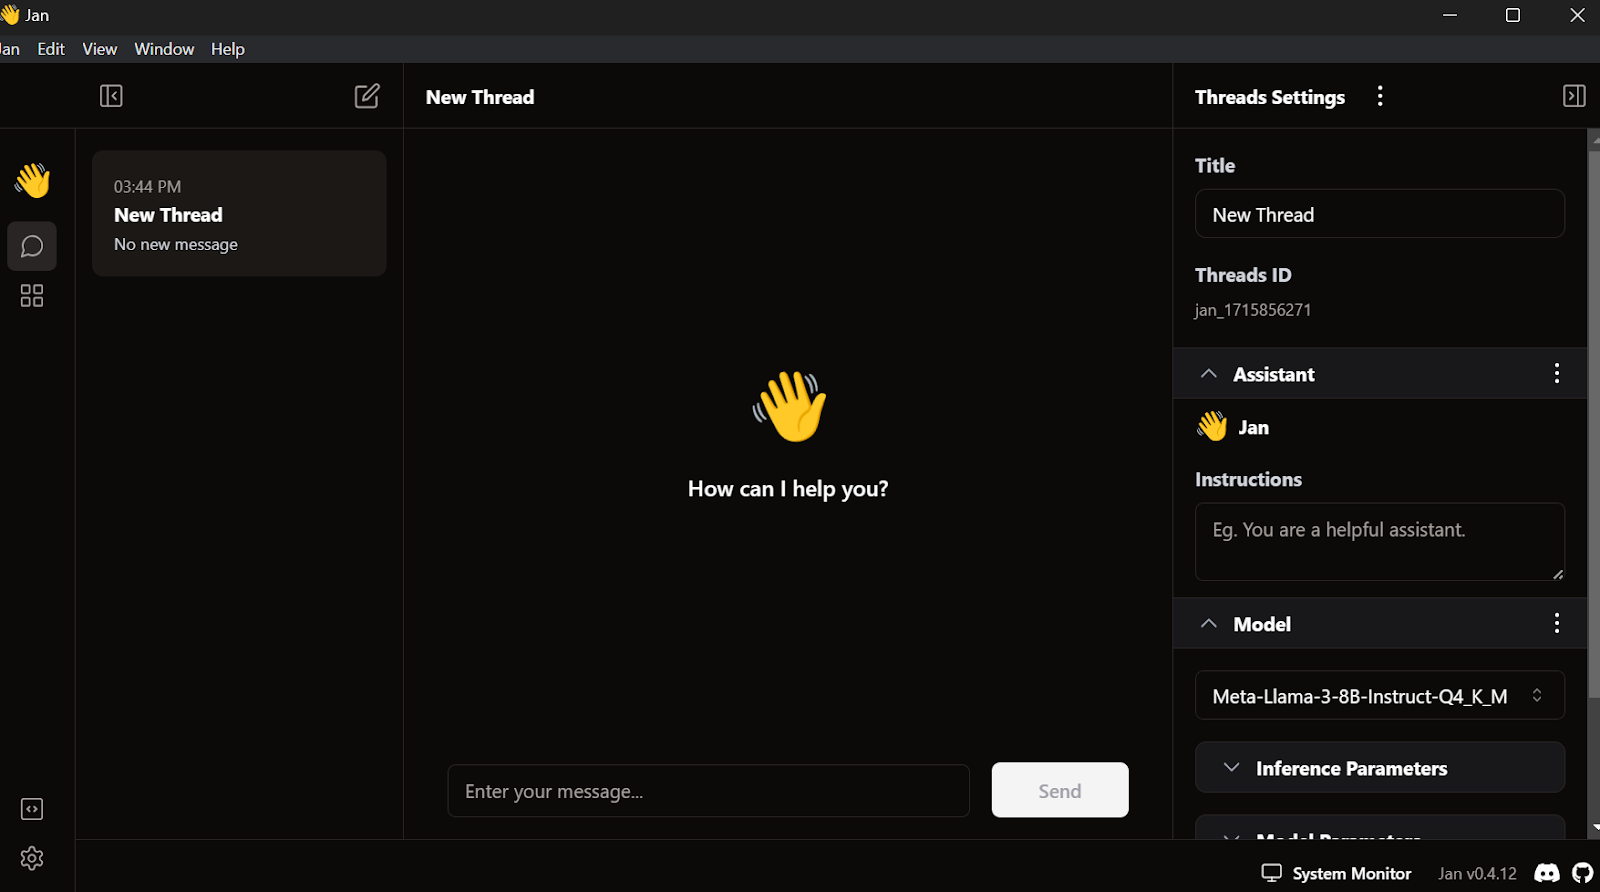
Allez dans les paramètres, sélectionnez l'onglet Groq Inference Engine et collez la clé d'API que vous venez de créer.
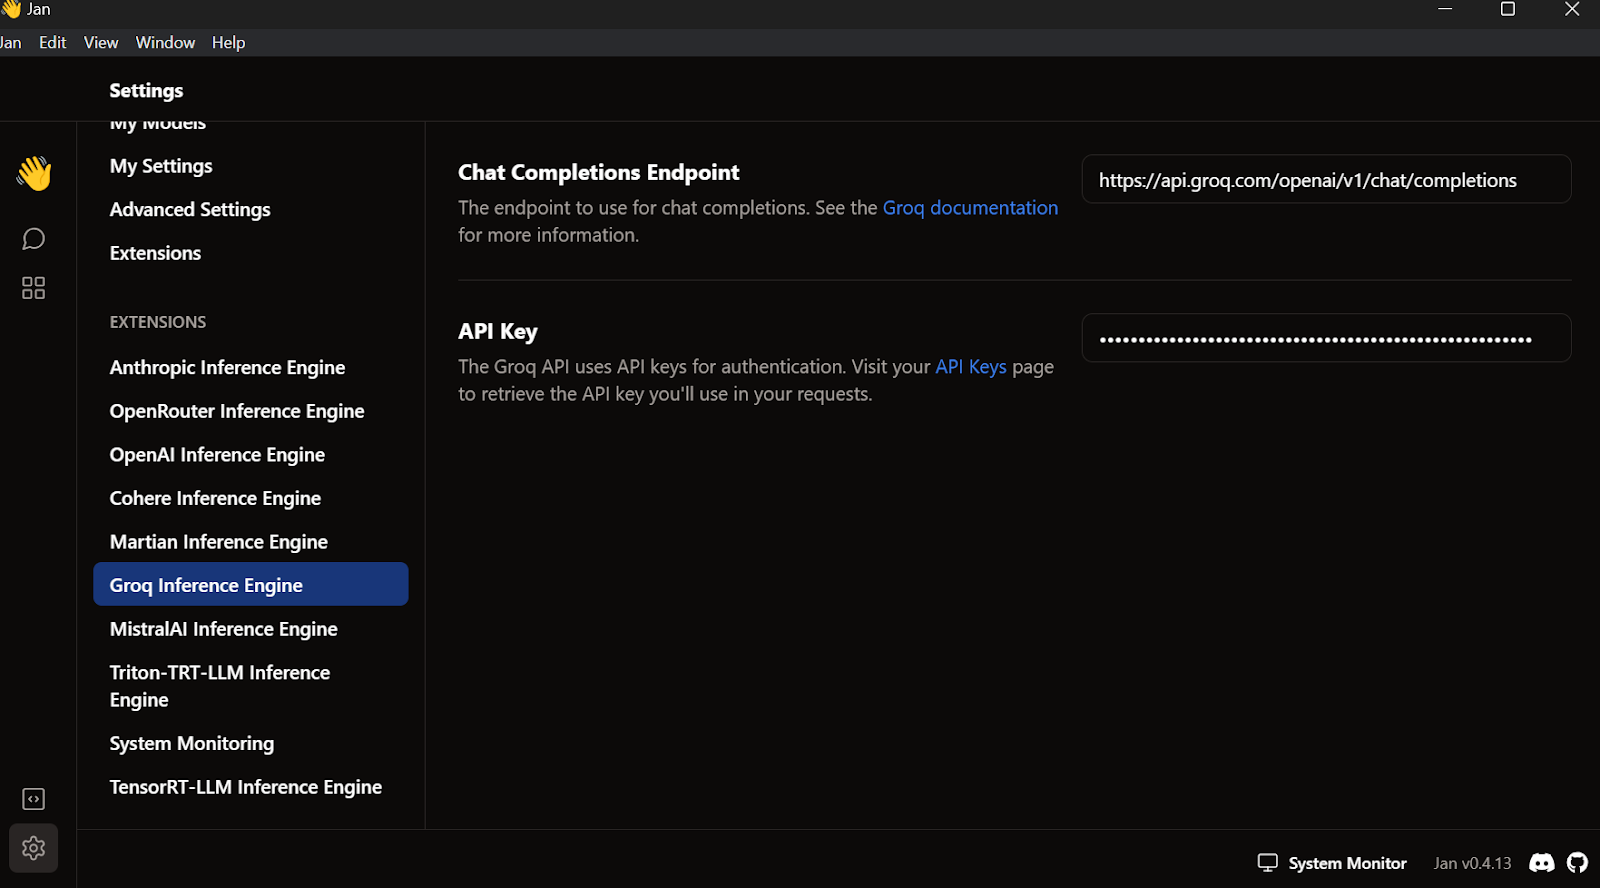
Quittez les paramètres, allez dans Thread et choisissez le modèle Groq Llama 3 70b.
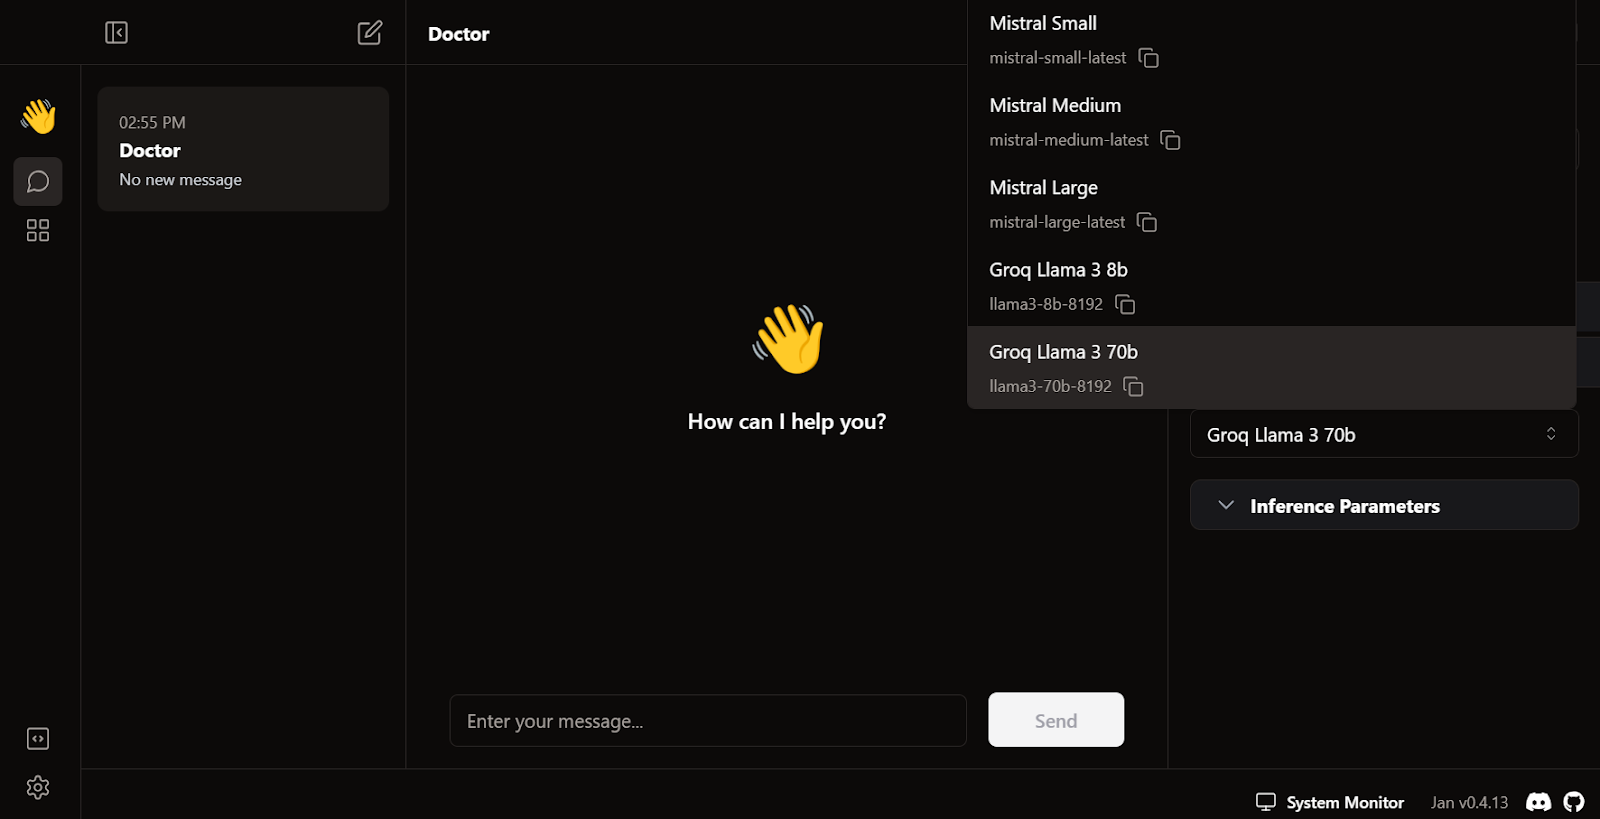
Saisissez une question ou un prompt pour générer la réponse en temps réel :
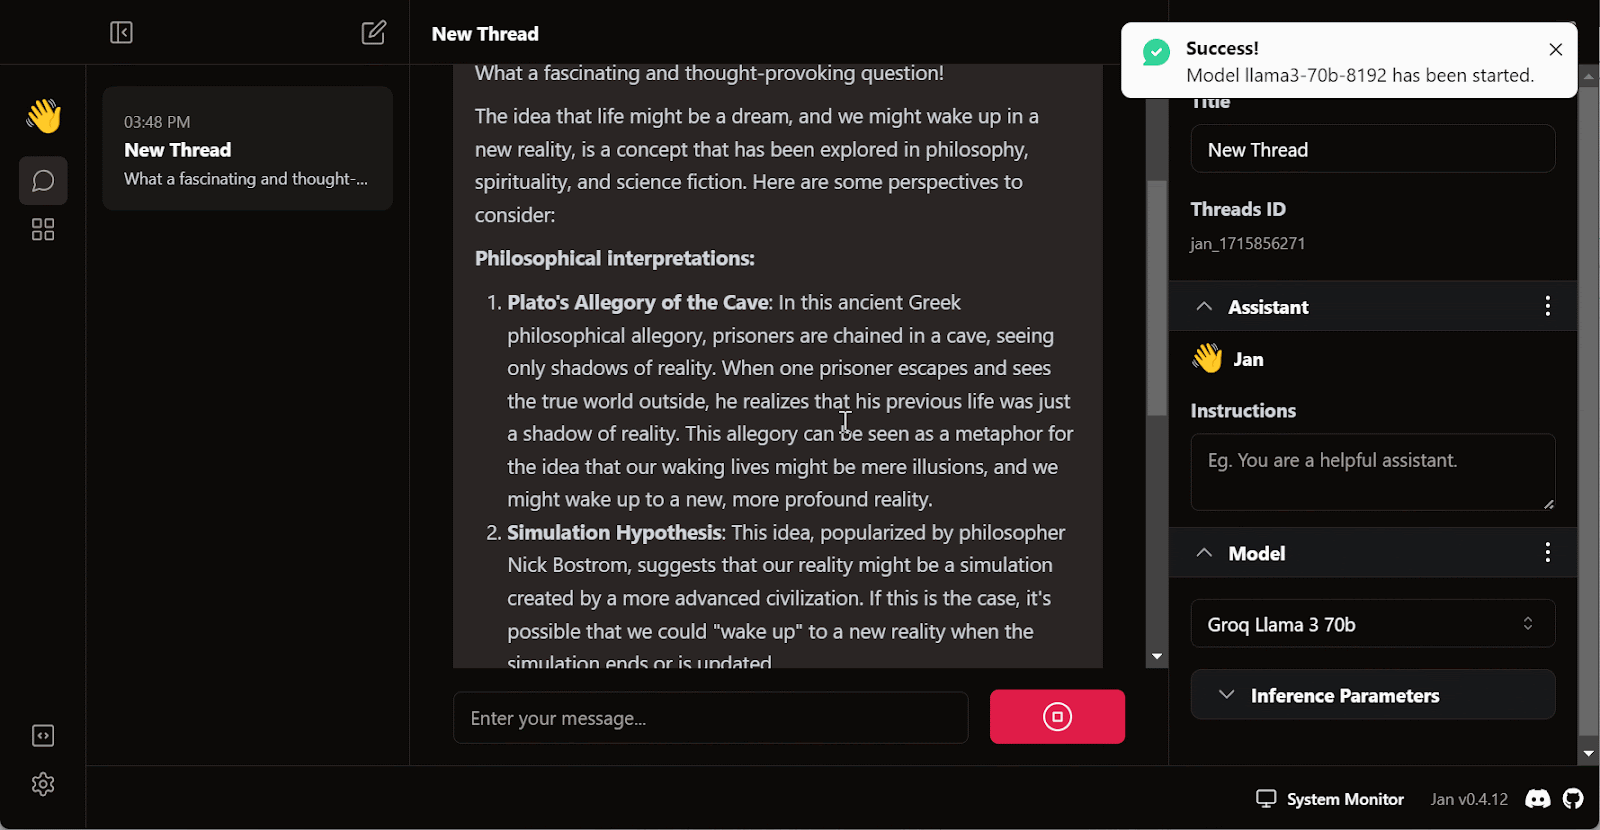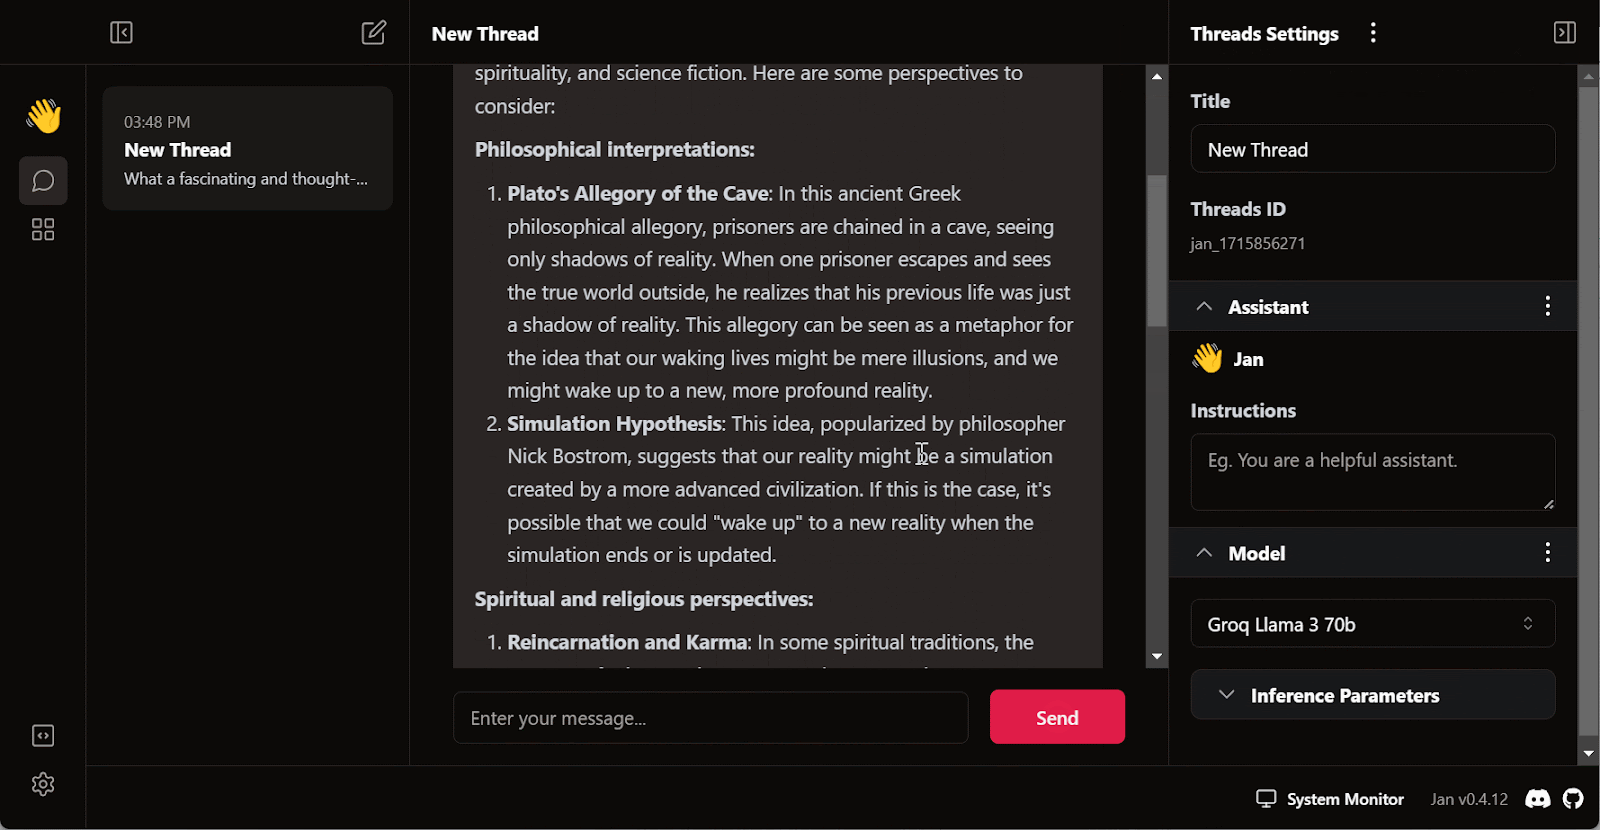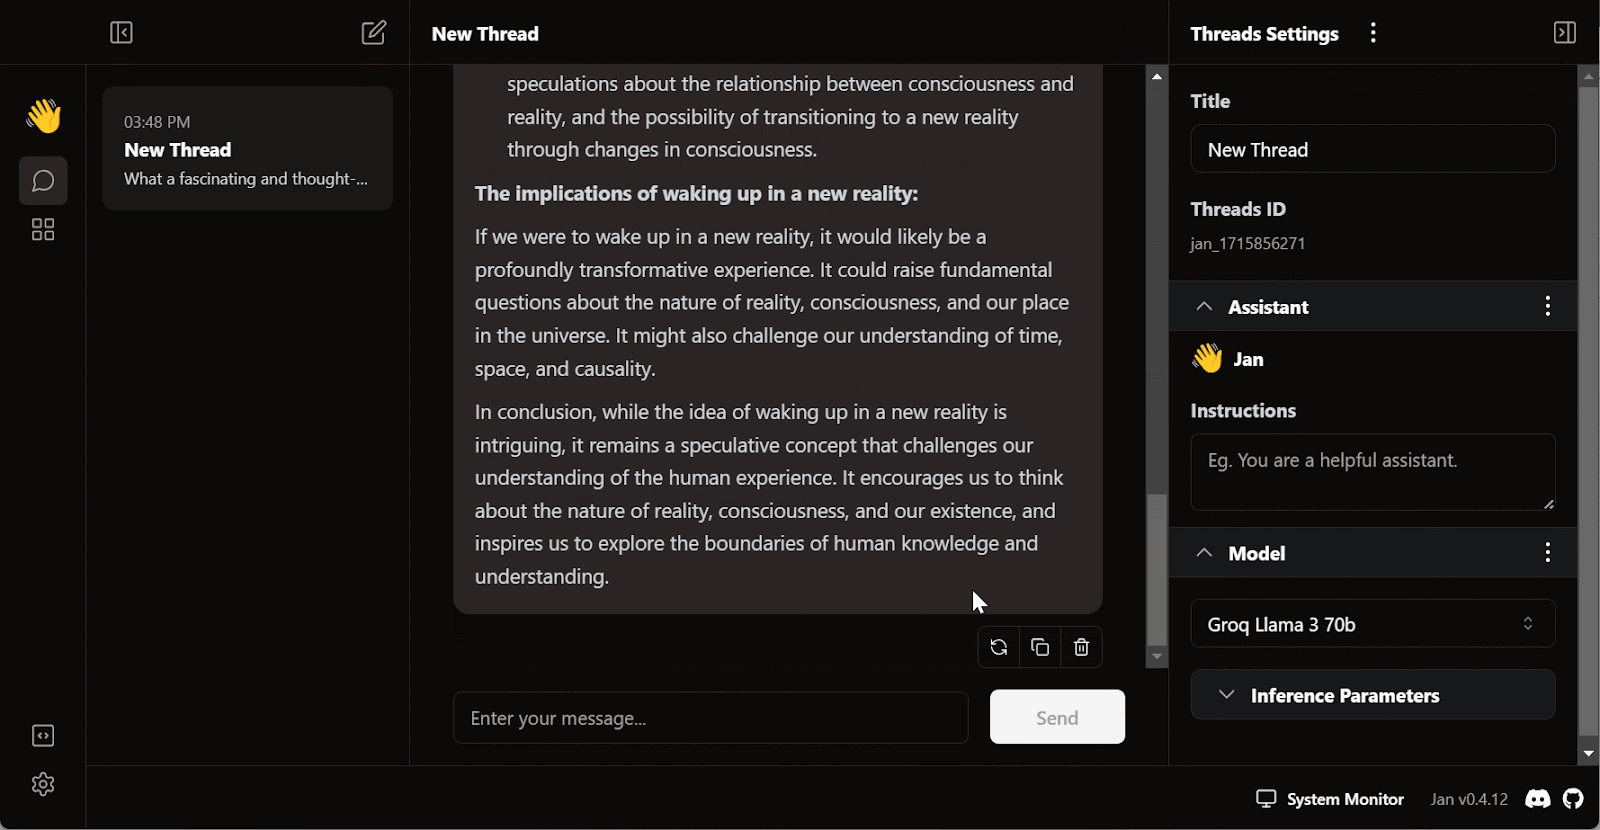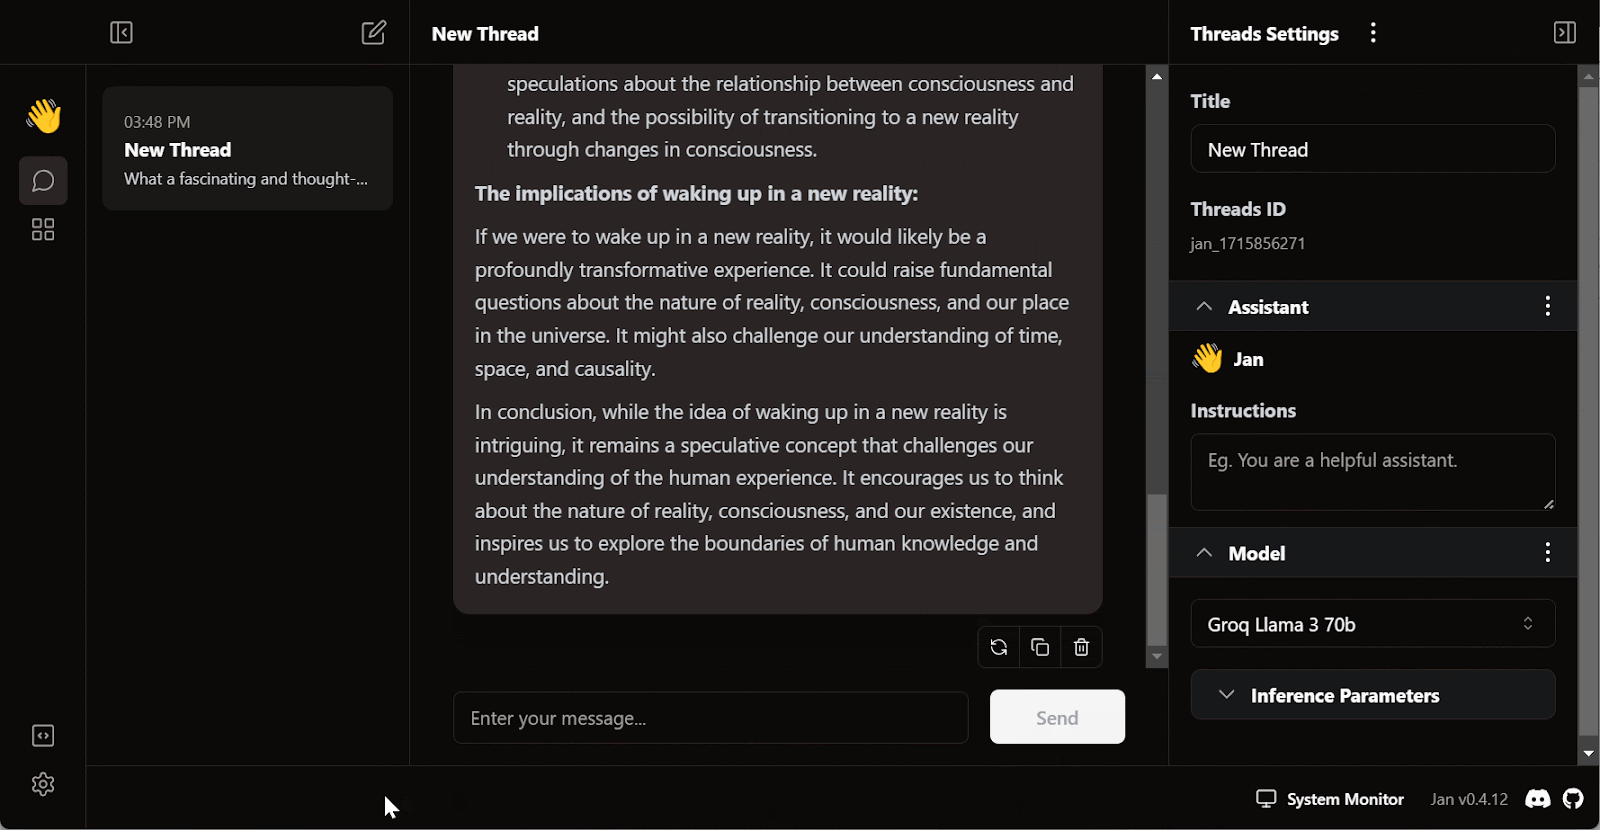
L'offre gratuite de Groq Cloud inclut certaines limites de débit. Par exemple, le plan llama3-70b-8192 autorise 30 requêtes par minute, 14 400 par jour et 6 000 tokens par minute. Ces limites sont généreuses, mais si vous comptez construire une véritable application d'IA avec l'API Groq, envisagez de passer à l'offre On Demand ou Enterprise.
Pour explorer des façons simples d'exécuter des LLM en local, lisez ce tutoriel sur l'exécution locale des LLM.
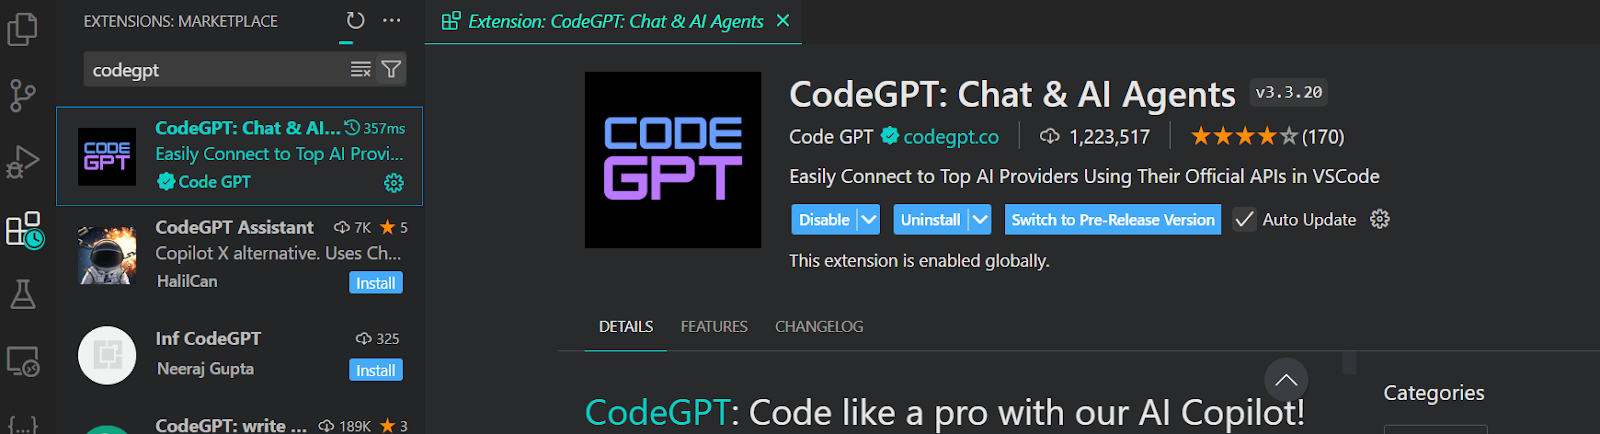
Au-delà d'un usage en chatbot, nous pouvons aussi intégrer l'API Groq à VSCode via l'extension CodeGPT. Elle devient alors un assistant de code IA ultra-rapide.
Pour accéder au modèle Groq dans VSCode, installez l'extension CodeGPT depuis la place de marché des extensions.
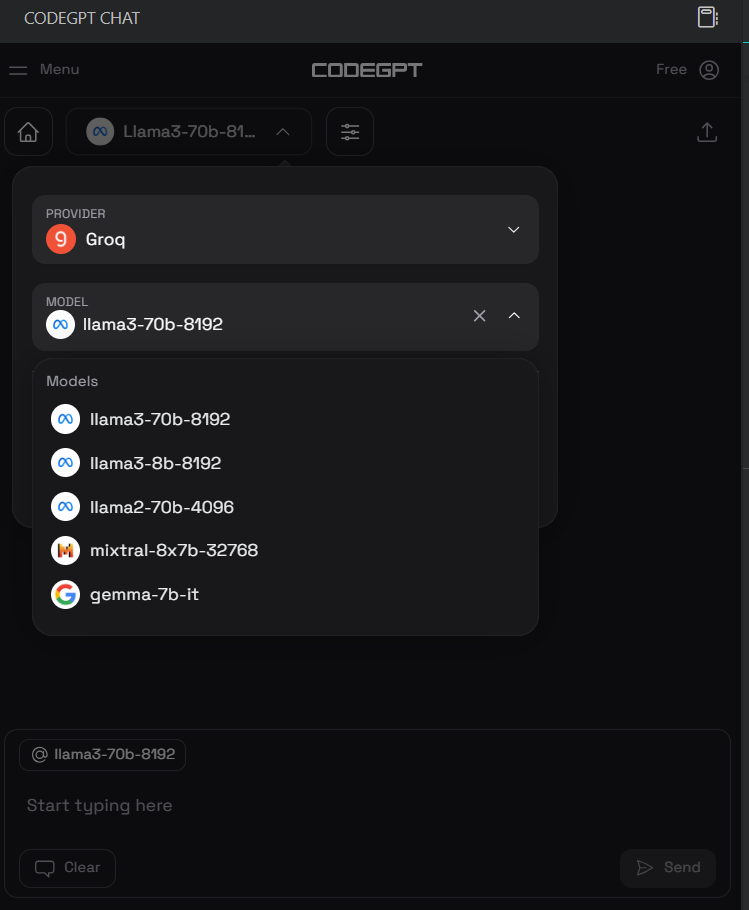
Une fois installée, configurez la clé d'API Groq en cliquant sur l'icône CodeGPT chat dans le panneau gauche et en sélectionnant le fournisseur et le modèle. Nous avons sélectionné Groq comme fournisseur et llama3-70b-8192 comme modèle.
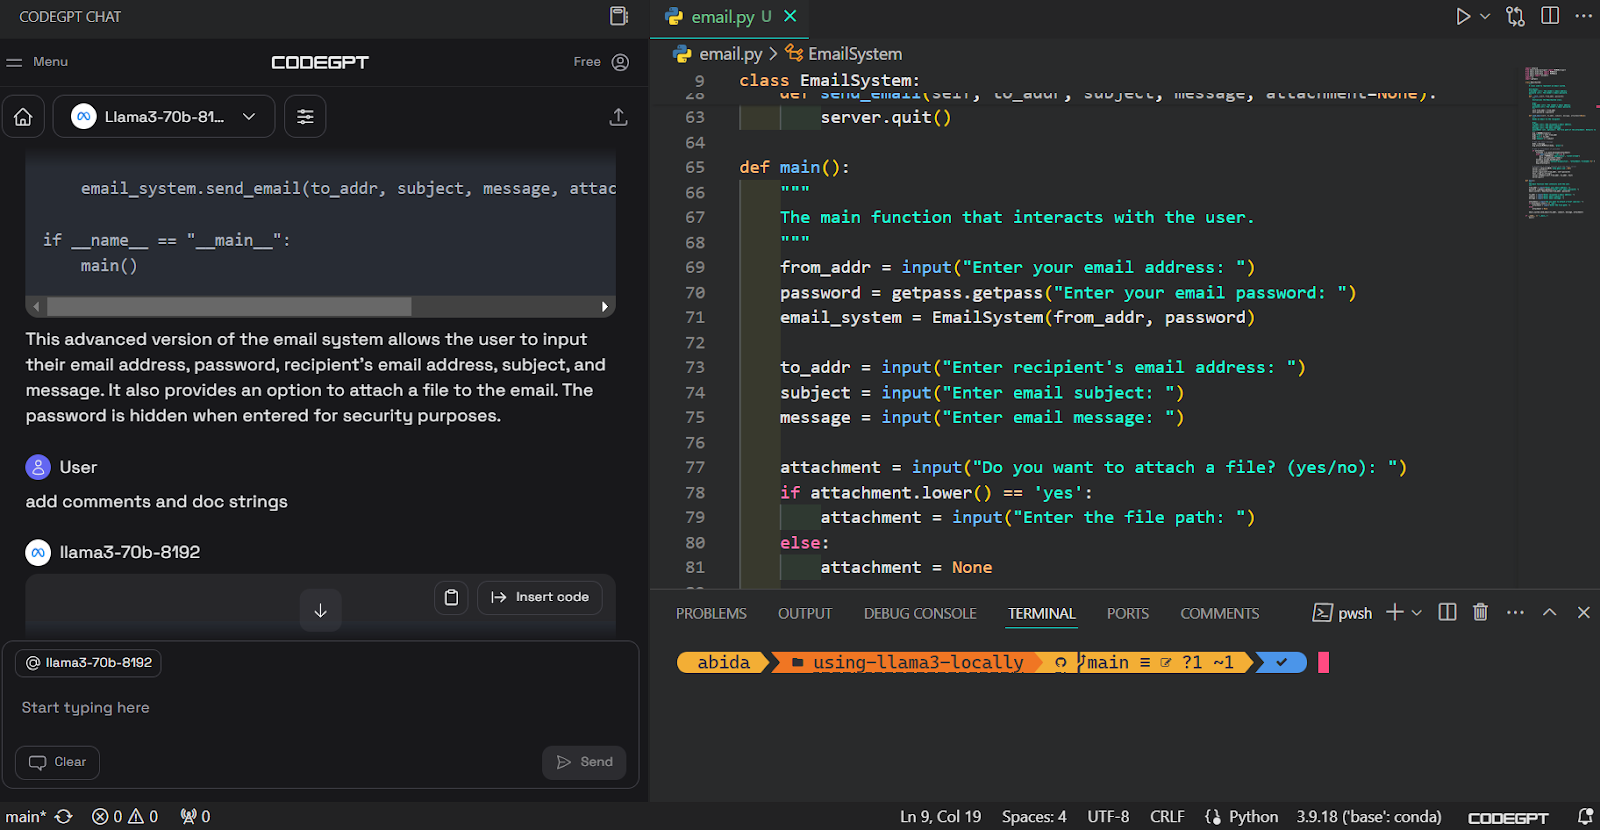
Ensuite, rédigez un prompt dans la zone de chat pour générer le code. Nous avons obtenu le code adéquat en quelques secondes et mis en place le système d'e-mails.
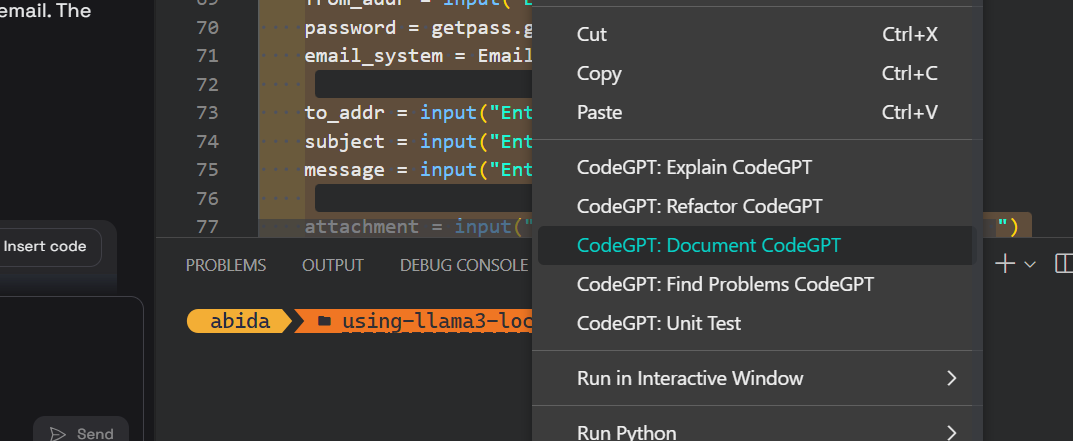
Vous pouvez ensuite documenter le code, le refactorer et créer des tests unitaires avec les commandes intégrées.
Pour en savoir plus sur VSCode, consultez ce tutoriel sur la configuration de VSCode pour Python.
Dans cette section, nous allons couvrir les bases de l'API Python de Groq et ses fonctionnalités clés, comme le streaming et l'async chat completion.
Pour ce guide, nous utilisons le DataLab de DataCamp. DataLab est un Jupyter Notebook en Cloud avec de nombreuses fonctionnalités pour coder, analyser des données et partager des insights.
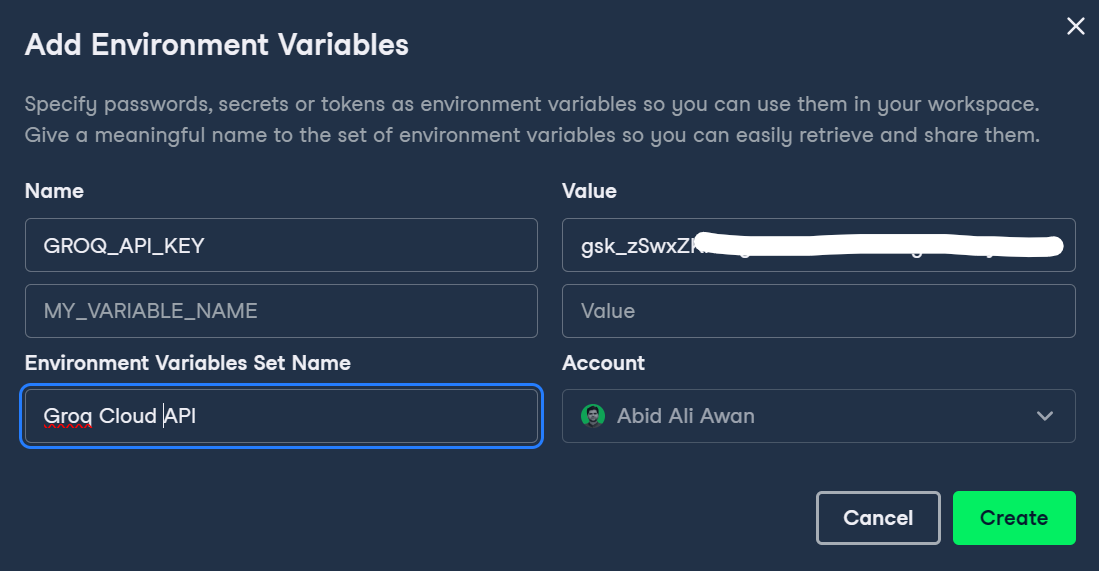
Commencez par définir la clé d'API Groq dans DataLab en cliquant sur le bouton Environment dans le panneau de gauche, puis ajoutez la variable d'environnement avec le bouton plus +.
Nommez la variable et collez la clé d'API Groq comme ci-dessous.
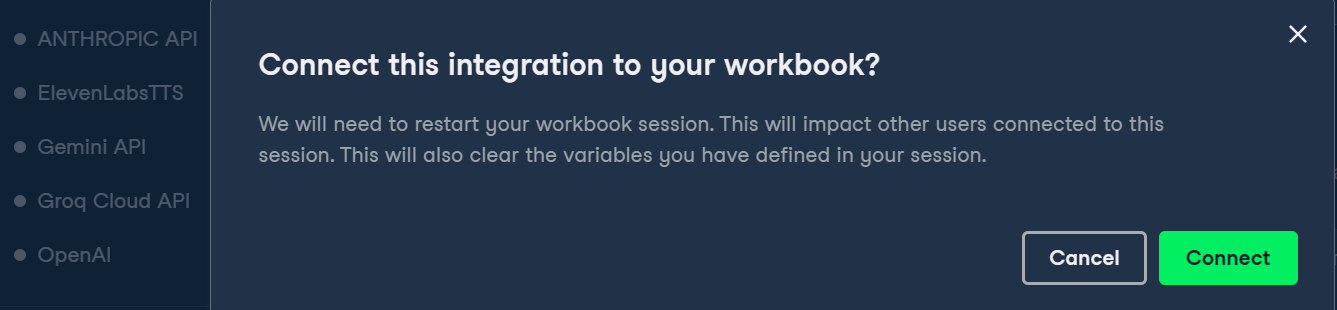
Activez ensuite la variable d'environnement en cliquant sur les trois points à côté de la variable Groq, puis sur Connect.
Enfin, installez le package Python Groq avec la commande pip.
%pip install groq -qSi vous avez déjà utilisé l'API Python d'OpenAI, vous retrouverez une structure de code similaire. Pour exécuter une chat completion :
import os
from groq import Groq
from IPython.display import display, Markdown

client = Groq(
   api_key=os.environ.get("GROQ_API_KEY"),
)

chat_completion = client.chat.completions.create(
   messages=[
       {"role": "system", "content": "You are a professional Data Scientist."},
       {"role": "user", "content": "Can you explain how the neural networks work?"},
   ],
   model="llama3-70b-8192",)

Markdown(chat_completion.choices[0].message.content)
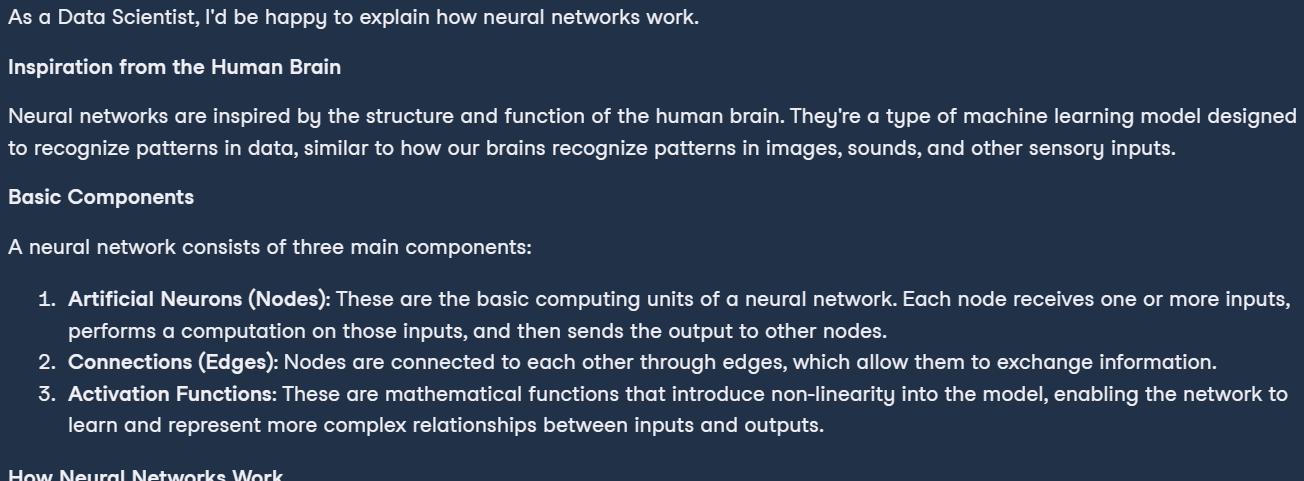
À l'arrivée, nous obtenons une explication parfaitement formatée de ce que sont les réseaux de neurones.
Le streaming dans les LLM consiste à traiter et générer le texte token par token, ce qui optimise l'utilisation de la mémoire et améliore la vitesse perçue de l'application d'IA.
Dans ces exemples, nous activons le streaming et personnalisons le modèle en ajustant des hyperparamètres comme temperature, max_tokens et top_p.
chat_streaming = client.chat.completions.create(
    messages=[
       {"role": "system", "content": "You are a monk from Thailand."},
       {"role": "user", "content": "Can you explain the meaning of life?"},
    ],
    model="llama3-70b-8192",
    temperature=0.3,
    max_tokens=360,
    top_p=1,
    stop=None,
    stream=True,
)

for chunk in chat_streaming:
    print(chunk.choices[0].delta.content, end="")
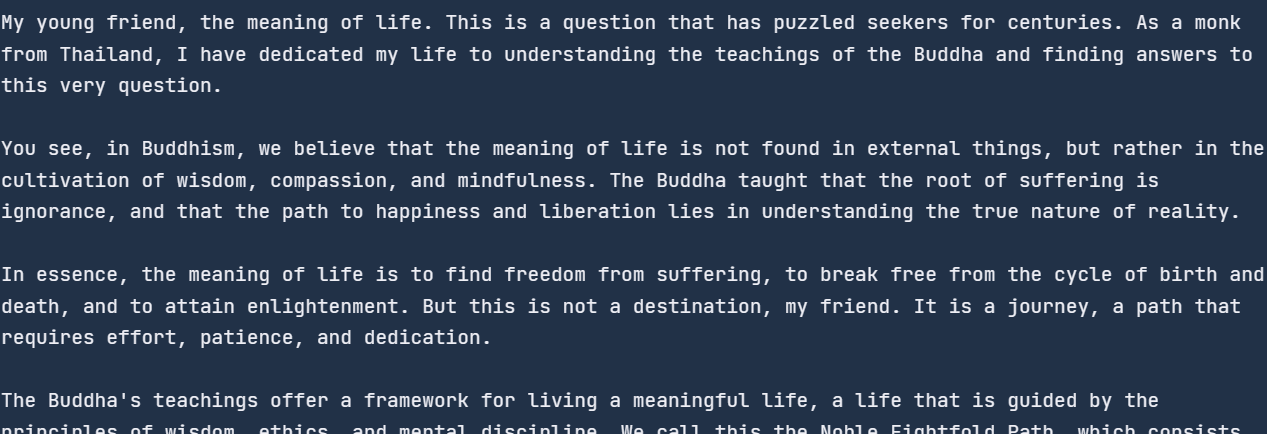
Résultat : la réponse commence à arriver dès l'exécution du code.
Les API asynchrones permettent de gérer plusieurs requêtes concurrentes sans blocage, le système traitant et répondant à chaque requête de manière indépendante. Cette approche est plus efficace et plus scalable, car elle gère un volume plus important de requêtes avec des temps de réponse plus courts.
Pour activer les appels API async, nous devons adapter la structure du code. Nous :
Remarque : le code ci-dessous fonctionne dans Jupyter Notebook, mais si vous l'exécutez dans un fichier Python, vous devrez probablement remplacer la dernière ligne par asyncio.run(main()).
import asyncio
from groq import AsyncGroq

client = AsyncGroq(

    api_key=os.environ.get("GROQ_API_KEY"),

)

async def main():

   chat_completion = await client.chat.completions.create(
       messages=[            {"role": "system", "content": "You are a psychiatrist helping young minds"},
                  {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
                ],
                model="llama3-70b-8192",
                temperature=0.3,
                max_tokens=360,
                top_p=1,
                stop=None,
                stream=False,
       )

       print(chat_completion.choices[0].message.content)

await main()  # for Python file use asyncio.run(main())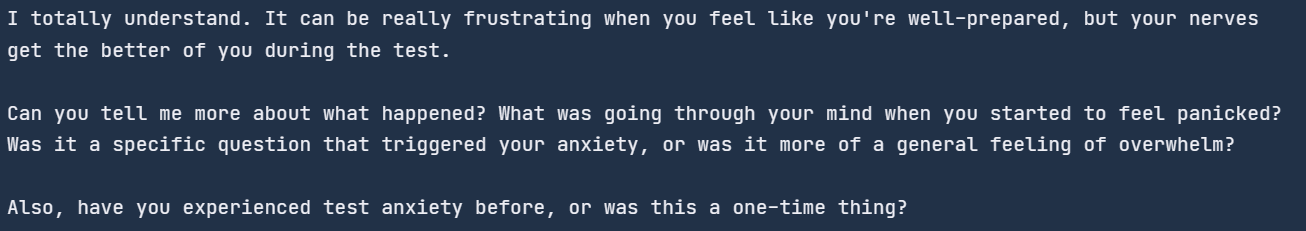
Nous pouvons aussi streamer l'API async en activant l'argument stream dans la fonction de chat completion et en adaptant l'affichage des résultats. Nous imprimons chaque chunk avec une boucle for en async.
import asyncio

from groq import AsyncGroq


client = AsyncGroq()

async def main():

    chat_streaming = await client.chat.completions.create(
        messages=[
           {"role": "system", "content": "You are a psychiatrist helping young minds"},
           {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
        ],
        model="llama3-70b-8192",
        temperature=0.3,
        max_tokens=360,
        top_p=1,
        stop=None,
        stream=True,
     )
     async for chunk in chat_streaming:
            print(chunk.choices[0].delta.content, end="")

await main()  # for Python file use asyncio.run(main())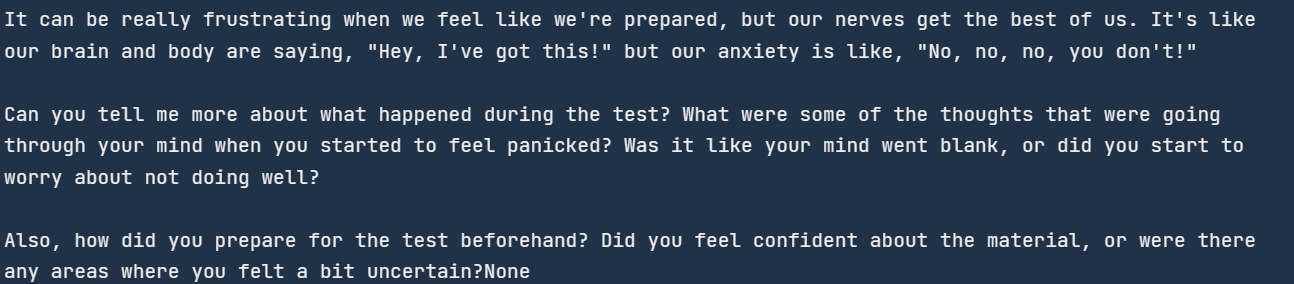
Si vous rencontrez des difficultés pour exécuter le code, consultez ce notebook DataLab : Groq Cloud API.
Dans ce guide, nous allons plus loin et apprenons à créer une application d'IA avec l'API Groq et LlamaIndex, un framework LLM. Nous allons construire une application qui charge le texte d'un PDF, le convertit en embeddings et l'enregistre dans un magasin vectoriel. Ensuite, nous transformerons ce magasin en retriever pour bâtir un moteur de chat RAG avec historique.
En bref, nous construisons une application ChatPDF contextuelle pour vous aider à comprendre un document beaucoup plus rapidement.
Pour apprendre à ingérer, gérer et rechercher des données privées ou métier en langage naturel, consultez ce tutoriel : LlamaIndex : un framework data pour les LLM.
Nous allons d'abord installer tous les packages Python nécessaires avec pip. Nous utilisons la commande magique %%capture pour supprimer les logs.
%%capture
%pip install llama-index
%pip install llama-index-llms-groq
%pip install llama-index-embeddings-huggingfaceNous allons créer le client LLM Groq via la fonction de llama_index. Le client LLM requiert un nom de modèle et la clé d'API.
from llama_index.llms.groq import Groq
import os

llm =
Groq(model="llama3-70b-8192",api_key=os.environ.get("GROQ_API_KEY"))Nous allons maintenant télécharger et charger le modèle d'embedding Hugging Face via l'API d'embeddings de LlamaIndex.
Dans notre cas, nous utilisons le modèle d'embedding le plus populaire sur Hugging Face, appelé mxbai-embed-large-v1.
from llama_index.embeddings.huggingface import HuggingFaceEmbedding

embed_model =
HuggingFaceEmbedding(model_name="mixedbread-ai/mxbai-embed-large-v1")LlamaIndex permet de définir des configurations globales, évitant d'avoir à passer les objets LLM ou embedding partout.
from llama_index.core import Settings

Settings.llm = llm
Settings.embed_model = embed_modelPour les données, nous utilisons l'article de blog 14 Essential Data Engineering Tools to Use in 2024 et le convertissons en PDF via la fonction d'impression.
Avec la fonction SimpleDirectoryReader, vous pouvez charger différents types de documents d'un dossier. Fournissez simplement le chemin du dossier et les extensions de fichiers requises.
from llama_index.core import SimpleDirectoryReader

de_tools_blog = SimpleDirectoryReader("./",required_exts=[".pdf", ".docx"]).load_data()VectorStoreIndex est le moyen le plus rapide de créer un magasin vectoriel en chargeant les documents et en construisant l'index. L'index peut ensuite alimenter des moteurs de requêtes, des retrievers et des pipelines de requêtes.
Ici, nous créons l'index en fournissant les documents au magasin vectoriel, qui convertit le texte en embeddings puis les stocke.
Ensuite, nous transformons l'index en moteur de requêtes pour réaliser un RAG (retrieval augmented generation) basique, qui combine récupération d'information et modèle d'IA pour générer une réponse contextuelle.
from llama_index.core import VectorStoreIndex

index = VectorStoreIndex.from_documents(de_tools_blog)
query_engine = index.as_query_engine(similarity_top_k=3)

response = query_engine.query("How many tools are there?")
print(response)
Nous allons maintenant créer un moteur de chat RAG avec historique. L'ajout de l'historique permet au moteur de mémoriser les messages de l'utilisateur et les réponses générées, afin de fournir des réponses contextuelles.
Pour construire cette application, nous créons un ChatMemoryBuffer de 3 900 tokens et le passons au moteur de chat avec le retriever et l'objet LLM.
Lorsque vous posez une question, le moteur utilise le document PDF et les messages précédents comme contexte pour répondre en conséquence.
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
   index.as_retriever(),
   memory=memory,
   llm=llm
)

response = chat_engine.chat(
   "What tools are suitable for data processing?"
)
print(str(response))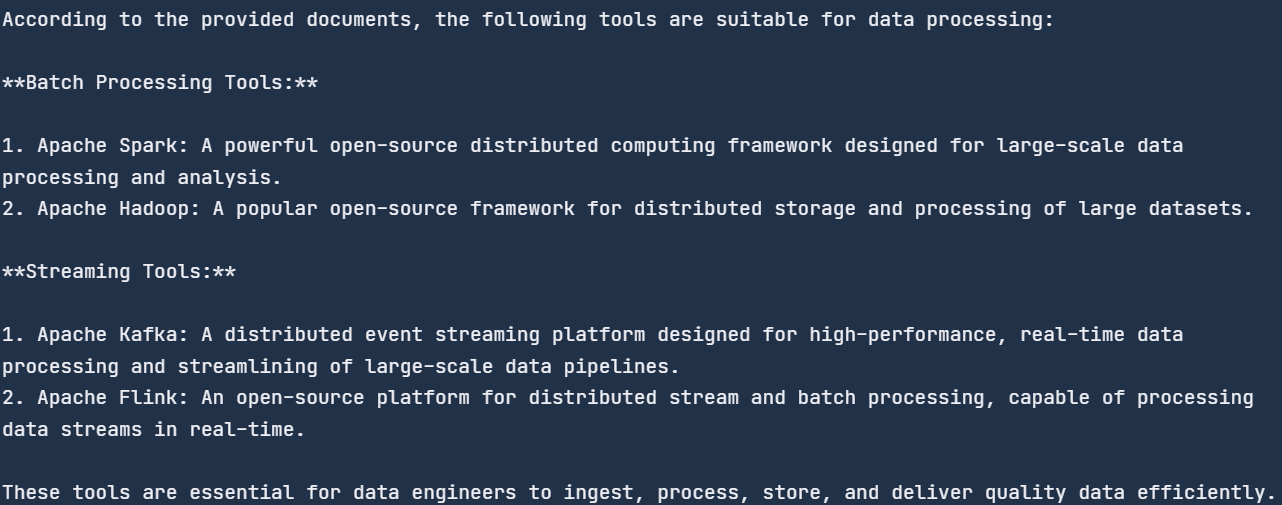
Nous avons posé une question générique ; le système a recherché dans le document les outils de traitement des données et nous a fourni la liste. Tous ces outils figurent dans l'article.
Posons une question de relance pour tester la mémoire du moteur de chat.
response = chat_engine.chat(
    "Can you create a diagram of a data pipeline using these tools?"
)
print(str(response))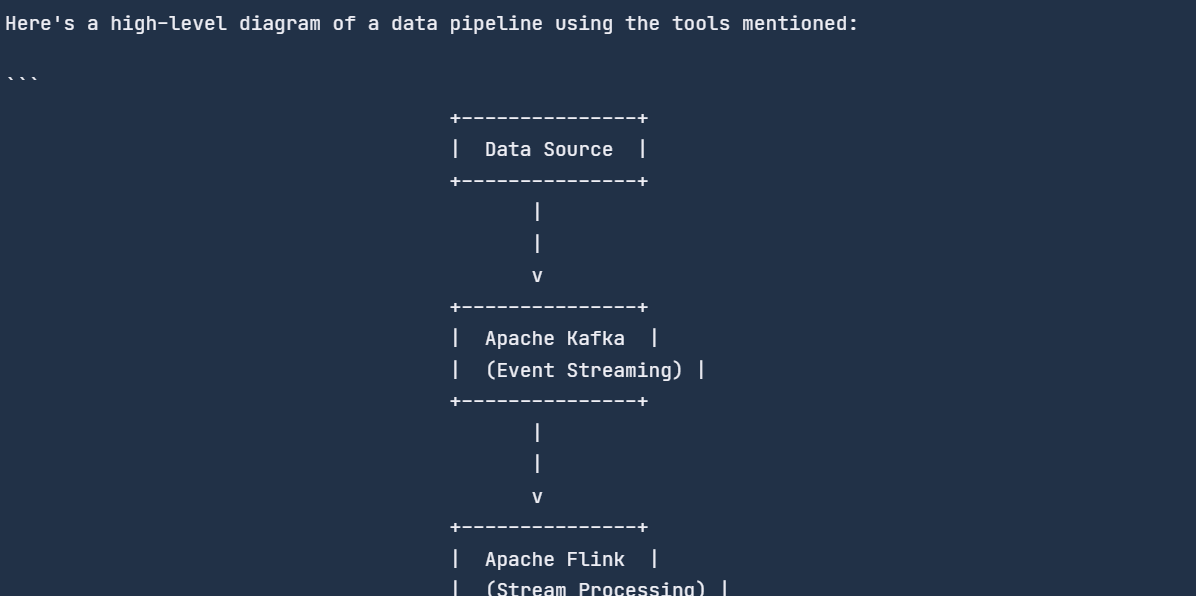
Le moteur a mémorisé la conversation précédente et a répondu en conséquence.
Tout le code utilisé est disponible dans ce notebook DataLab : Groq Cloud API — DataLab.
Le moteur d'inférence Groq LPU change la donne en IA. Tandis que des acteurs majeurs comme OpenAI et Google se concentrent sur la qualité des LLM, Groq rend ces modèles bien plus rapides. Bien que récent sur la scène IA, Groq s'impose déjà fortement dans la communauté.
Dans cet article, nous avons découvert le moteur d'inférence Groq LPU, exploré Groq Cloud et intégré l'API Groq dans VSCode et l'application Jan AI. Nous avons également parcouru le package Python Groq avec des exemples de code et appris à créer une application d'IA contextuelle capable d'exploiter l'historique de chat et des documents PDF.
La prochaine étape de votre parcours peut être le fine-tuning de LLM sur un jeu de données personnalisé. Découvrez comment faire dans ce tutoriel : Fine Tuning Google Gemma : améliorer les LLM avec des instructions personnalisées.
Apprenez avec DataCamp
Cours
Cours
Cours