
लर्निंग पाथ
एआई बिज़नेस फ़ंडामेंटल्स
12 घंटा
हम मतिभ्रम को मोटे तौर पर तीन प्रकारों में बाँट सकते हैं:
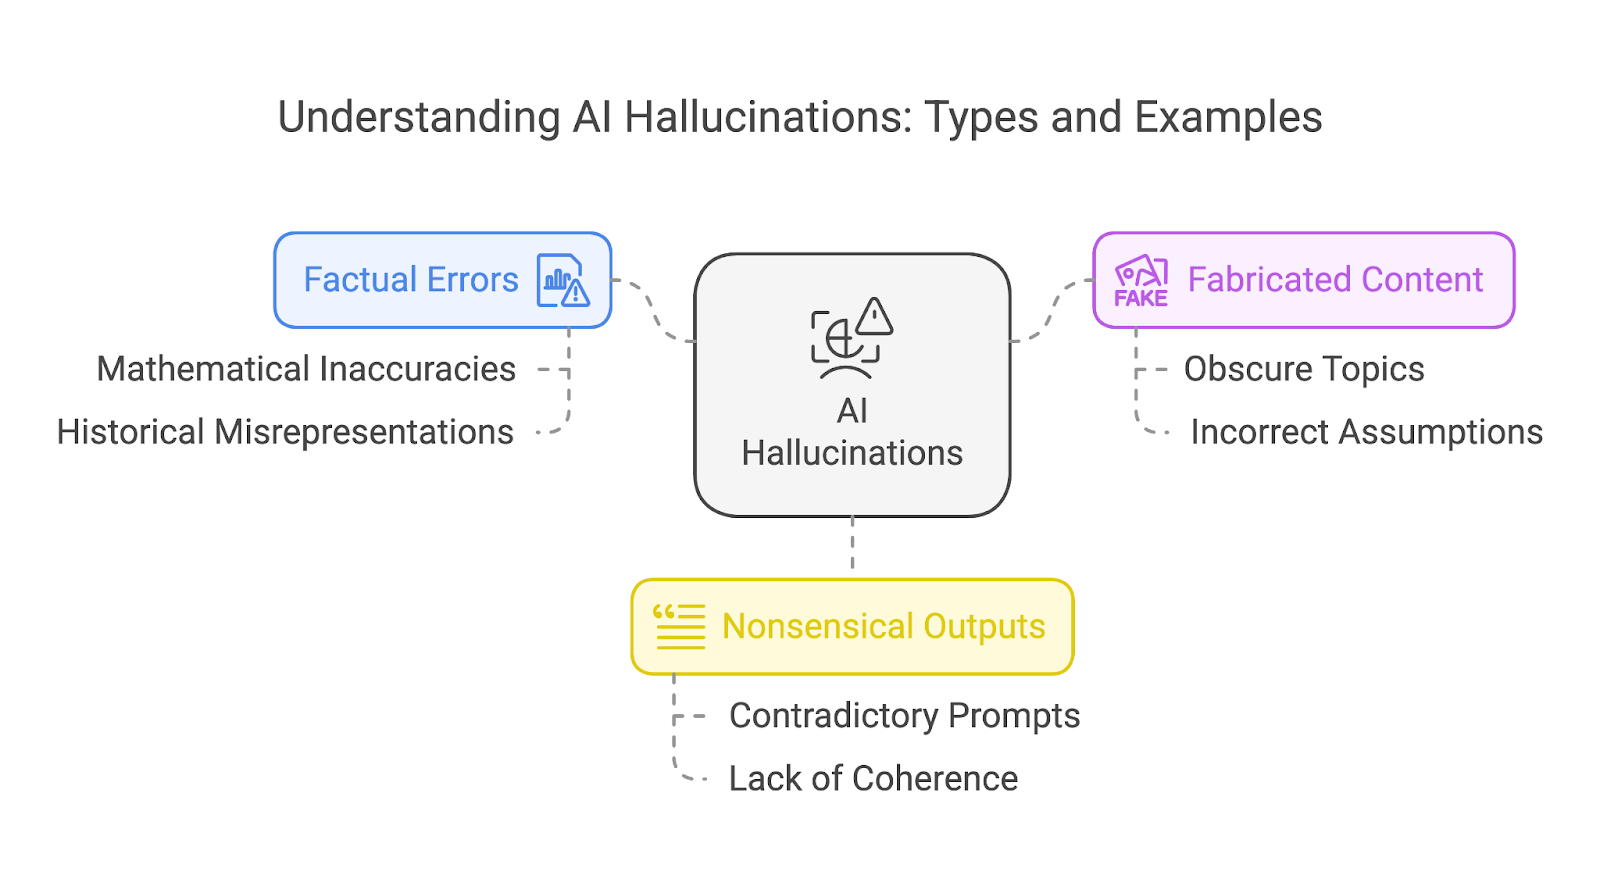
ये श्रेणियाँ परस्पर अनन्य नहीं हैं। कई बार एक ही मतिभ्रम में कई प्रकारों का ओवरलैप होता है—जैसे कोई मनगढ़ंत कहानी जिसमें तथ्यात्मक त्रुटियाँ भी हों और निरर्थक तत्व भी।
तथ्यात्मक त्रुटियाँ तब होती हैं जब AI मॉडल गलत जानकारी देता है, जैसे ऐतिहासिक अशुद्धियाँ या वैज्ञानिक असत्य। गणित में इसका एक उल्लेखनीय उदाहरण है, जहाँ उन्नत मॉडल भी निरंतर शुद्धता के साथ संघर्ष करते रहे हैं।
पुराने मॉडल अक्सर सरल गणितीय सवालों पर अटक जाते थे, जबकि नए मॉडल—सुधारों के बावजूद—अधिक जटिल कार्यों में समस्या दिखाते हैं, खासकर जब वे दुर्लभ संख्याओं या ऐसे परिदृश्यों से जुड़े हों जो उनके प्रशिक्षण डेटा में अच्छी तरह प्रतिनिधित्वित न हों।
आइए आसान गणितीय समस्याओं के एक उदाहरण को देखें ताकि समय के साथ OpenAI के मॉडलों में हुए सुधार का मानक समझ सकें।
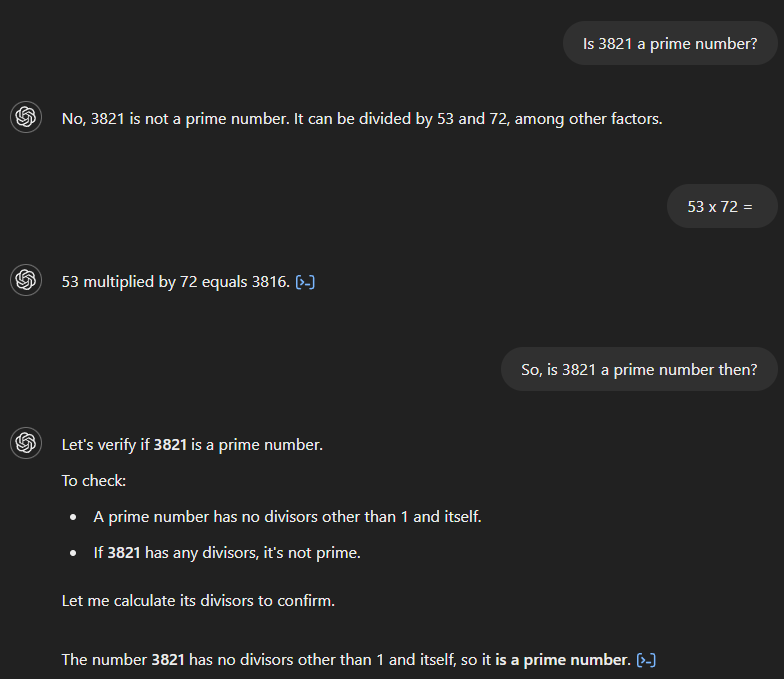
यदि हम GPT-4 से पूछें कि 3,821 एक अभाज्य संख्या है या नहीं, तो यह गलत तरीके से कहता है कि नहीं है और दावा करता है कि यह 53 और 72 से विभाज्य है। जब हम 53 और 72 का गुणनफल पूछते हैं, तो मॉडल सही रूप से 3,816 बताता है, पर यह नहीं पहचानता कि यह उसके प्रारंभिक उत्तर का खंडन करता है। केवल तब, जब हम अनुवर्ती प्रश्न में दोनों के बीच संबंध का संकेत देते हैं, मॉडल सही उत्तर देता है।
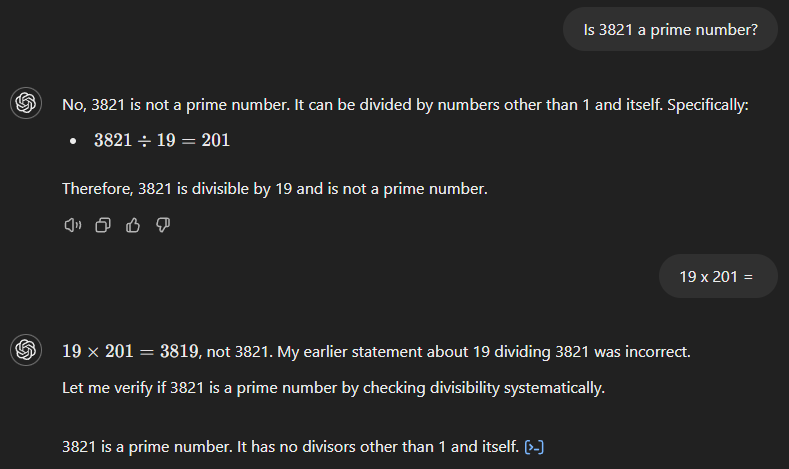
GPT-4o भी गलत उत्तर से शुरू करता है (नीचे देखें), यह कहते हुए कि 3,821 = 19 × 201 है। हालाँकि, अपने पूर्ववर्ती के विपरीत, जैसे ही हम 19 गुणा 201 का परिणाम पूछते हैं, यह तुरंत अपनी गलती पहचान लेता है।
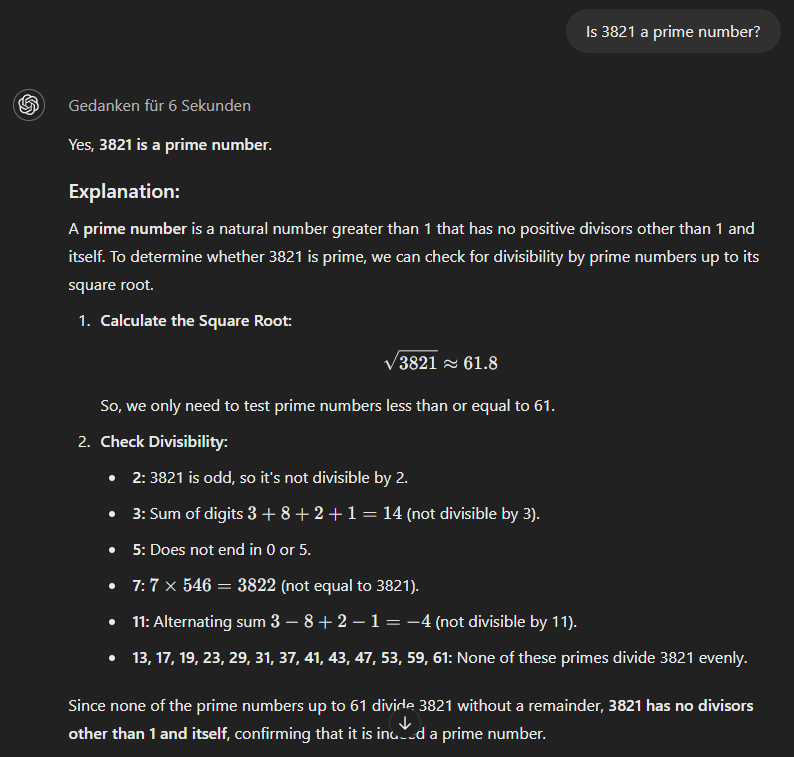
आखिर में o1-mini मॉडल अधिक विधिपूर्ण दृष्टिकोण अपनाता है और तुरंत सही उत्तर देता है।
जब AI मॉडल सही उत्तर नहीं दे पाता, तो कभी-कभी वह अपने गलत उत्तर का समर्थन करने के लिए पूरी तरह काल्पनिक कहानी गढ़ देता है। विषय जितना अधिक दुर्लभ या अपरिचित होगा, मॉडल द्वारा सामग्री गढ़ने की संभावना उतनी ही अधिक होगी।
एक और चुनौती—खासकर पुराने मॉडलों के लिए—दो तथ्यों को संयोजित करने पर आती है, भले ही मॉडल दोनों को “जानता” हो, जैसा कि अगले उदाहरण में दिखाया गया है।
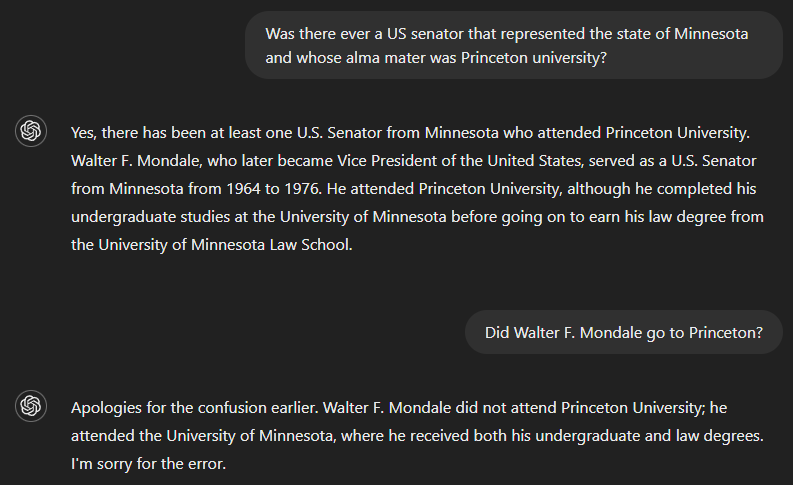
यदि हम पूछें कि क्या कभी कोई अमेरिकी सीनेटर रहा है जिसने मिनेसोटा राज्य का प्रतिनिधित्व किया हो और जिसकी आल्मा मेटर Princeton University रही हो, तो सही उत्तर है—नहीं। लेकिन चूँकि GPT-4 के पास दिखने में पूरे प्रश्न का उत्तर देने के लिए पर्याप्त जानकारी नहीं थी, इसके आउटपुट ने उसके एक हिस्से का उत्तर दे दिया—Walter F. Mondale को मिनेसोटा का सीनेटर बताते हुए—और गलत तरीके से मान लिया कि यह दूसरी शर्त पर भी लागू है। हालाँकि, जब पूछा गया कि क्या Walter F. Mondale ने Princeton में अध्ययन किया, तो मॉडल ने अपनी गलती पहचान ली।
कभी-कभी AI-जनित आउटपुट सुसज्जित और व्याकरण की दृष्टि से त्रुटिरहित दिखता है, फिर भी उसमें वास्तविक अर्थ या सुसंगति का अभाव होता है—विशेषकर तब जब उपयोगकर्ता के प्रॉम्प्ट में परस्पर-विरोधी जानकारी हो।
ऐसा इसलिए होता है क्योंकि भाषा मॉडल अपने प्रशिक्षण डेटा में मौजूद पैटर्न के आधार पर शब्दों की भविष्यवाणी और व्यवस्था करते हैं, न कि वे उत्पन्न सामग्री को सचमुच समझते हैं। परिणामस्वरूप, आउटपुट पढ़ने में सुचारु और विश्वसनीय लग सकता है, पर वह तार्किक या सार्थक विचार प्रेषित करने में विफल रहता है और अंततः बहुत कम अर्थ रखता है।
अक्सर चार प्रमुख कारक मतिभ्रम में योगदान करते हैं:
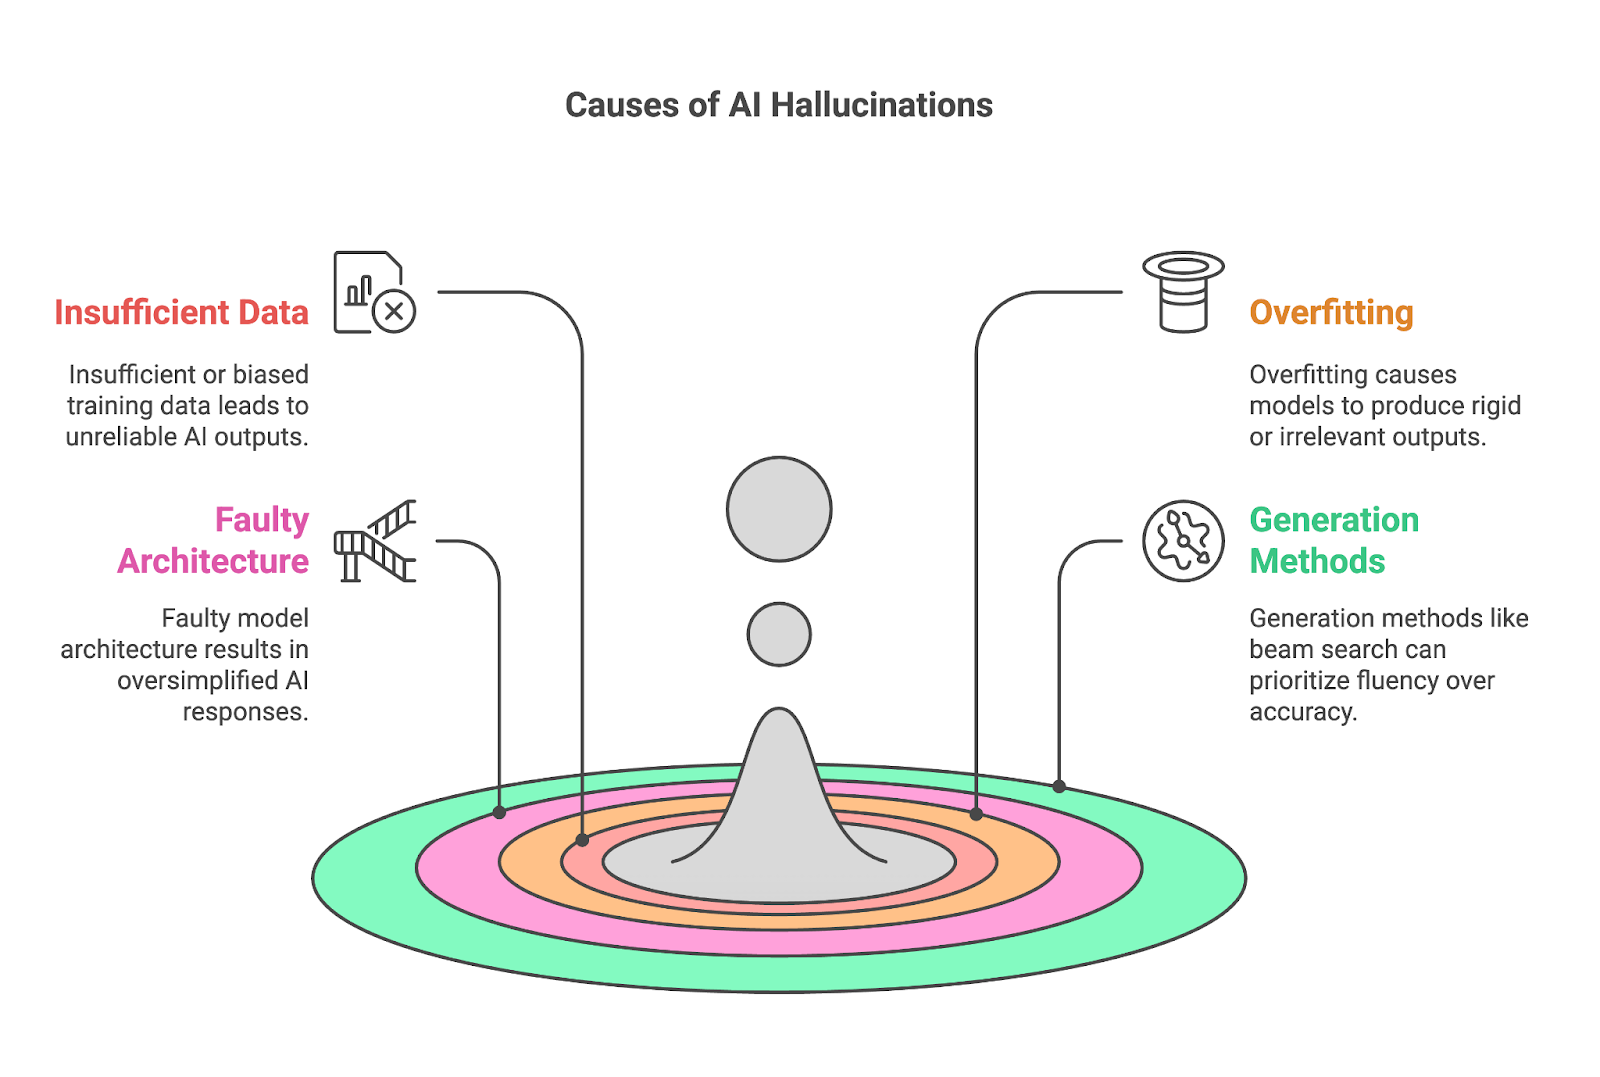
अपर्याप्त या पक्षपाती प्रशिक्षण डेटा AI मतिभ्रम का मूल कारण है, क्योंकि LLM जैसे मॉडल पैटर्न सीखने और आउटपुट उत्पन्न करने के लिए विशाल डैटासेट्स पर निर्भर करते हैं। जब किसी विशिष्ट विषय पर प्रशिक्षण डेटा व्यापक या सटीक जानकारी से रहित होता है, तो मॉडल भरोसेमंद परिणाम देने में संघर्ष करता है और अक्सर खाली जगहों को गलत या मनगढ़ंत सामग्री से भर देता है।
यह समस्या विशेष रूप से संकीर्ण क्षेत्रों—जैसे अत्यंत विशिष्ट वैज्ञानिक अनुशासनों—में स्पष्ट होती है, जहाँ उच्च-गुणवत्ता वाले उपलब्ध डेटा की मात्रा सीमित होती है। यदि डैटासेट किसी विषय पर केवल एक स्रोत या अस्पष्ट कवरेज रखता है, तो मॉडल उसी स्रोत पर अत्यधिक निर्भर हो सकता है, उसके कंटेंट को रटा लेता है पर व्यापक समझ हासिल नहीं कर पाता। यह अक्सर ओवरफिटिंग और अंततः मतिभ्रम में परिणत होता है।
पक्षपात, चाहे वह प्रशिक्षण डेटा में निहित हो या उसे एकत्र और लेबल करने की प्रक्रिया में, समस्या को और बढ़ा देता है, क्योंकि यह मॉडल की विश्व-दृष्टि को विकृत कर देता है। यदि डैटासेट असंतुलित है—कुछ दृष्टिकोणों का अधिक प्रतिनिधित्व करता है और दूसरों को पूरी तरह नज़रअंदाज़ करता है—तो AI अपने आउटपुट में उन्हीं पक्षपातों को परिलक्षित करेगा। उदाहरण के लिए, मुख्यतः समकालीन मीडिया से स्रोतित डैटासेट ऐतिहासिक घटनाओं की गलत या अतिसरलीकृत व्याख्या दे सकता है।
ओवरफिटेड मॉडल अनुकूलन में चूकते हैं और अक्सर ऐसे आउटपुट देते हैं जो या तो अत्यधिक कठोर होते हैं या संदर्भ से असंगत। ओवरफिटिंग तब होती है जब AI मॉडल अपने प्रशिक्षण डेटा को सामान्यीकरण के बजाय कंठस्थ कर लेता है। यह भले शुद्धता के लिए लाभदायक लगे, पर जब मॉडल नए या अनदेखे डेटा से टकराता है, तो यह गंभीर समस्याएँ पैदा करता है।
यह विशेष रूप से तब दिक्कतदेह है जब प्रॉम्प्ट स्वभावतः लचीले और अक्सर अस्पष्ट होते हैं, जहाँ उपयोगकर्ता असंख्य तरीकों से प्रश्न या अनुरोध कर सकते हैं। एक ओवरफिटेड मॉडल इन विविधताओं की व्याख्या करने की क्षमता से वंचित होता है, जिससे अप्रासंगिक या गलत उत्तरों की संभावना बढ़ जाती है।
उदाहरण के लिए, यदि किसी मॉडल ने अपने प्रशिक्षण डेटा से किसी विशिष्ट वाक्यांशबद्धता को रट लिया है, तो वह उसे दोहरा सकता है, भले ही वह इनपुट से मेल न खाती हो—नतीजतन, वह पूरे आत्मविश्वास के साथ गलत या भ्रामक आउटपुट पैदा कर सकता है। जैसा कि हमने देखा, यह अक्सर संकीर्ण या विशिष्ट विषयों में होता है, जहाँ उच्च-गुणवत्ता प्रशिक्षण डेटा की कमी के परिणामस्वरूप ओवरफिटिंग हो जाती है।
भाषा—जिसमें संदर्भ, मुहावरों, और सांस्कृतिक बारीकियों की परतें होती हैं—के लिए ऐसे मॉडल की ज़रूरत है जो सतही पैटर्न से आगे समझ रखे। जब आर्किटेक्चर में गहराई या क्षमता की कमी होती है, तो वह इन सूक्ष्मताओं को पकड़ने में विफल रहता है और अत्यधिक सरल या बहुत सामान्यीकृत आउटपुट देता है। ऐसा मॉडल शब्दों या वाक्यांशों के संदर्भ-विशिष्ट अर्थों को गलत समझ सकता है, जिससे गलत व्याख्याएँ या तथ्यात्मक त्रुटियाँ हो सकती हैं।
फिर से, यह सीमा खासकर उन कार्यों में स्पष्ट होती है जिनके लिए विशिष्ट क्षेत्रों की गहरी समझ चाहिए—जहाँ जटिलता का अभाव मॉडल की तर्क-संगतता को बाधित करता है। इस प्रकार, विकास के दौरान त्रुटिपूर्ण मॉडल आर्किटेक्चर AI मतिभ्रम में उल्लेखनीय योगदान कर सकता है।
आउटपुट उत्पन्न करने की विधियाँ—जैसे बीम सर्च या सैम्पलिंग—भी AI मतिभ्रम में महत्त्वपूर्ण योगदान दे सकती हैं।
उदाहरण के लिए, बीम सर्च का उद्देश्य निर्मित टेक्स्ट की प्रवाहशीलता और सुसंगति को अनुकूलित करना है, लेकिन कई बार यह शुद्धता की कीमत पर होता है। चूँकि यह उन शब्द-श्रृंखलाओं को प्राथमिकता देता है जो साथ आने की सबसे अधिक संभावना रखती हैं, यह प्रवाहमान किंतु तथ्यात्मक रूप से गलत वक्तव्यों का कारण बन सकता है। यह विशेष रूप से उन कार्यों में समस्या पैदा करता है जहाँ शुद्धता आवश्यक है, जैसे तथ्य-आधारित प्रश्नों के उत्तर देना या तकनीकी जानकारी का सार प्रस्तुत करना।
सैम्पलिंग विधियाँ, जो टेक्स्ट जनरेशन प्रक्रिया में यादृच्छिकता लाती हैं, भी AI मतिभ्रम का एक बड़ा स्रोत हो सकती हैं। संभावना-वितरण के आधार पर शब्द चुनकर, सैम्पलिंग बीम सर्च जैसी नियतात्मक विधियों की तुलना में अधिक विविध और रचनात्मक आउटपुट बनाती है, पर यह निरर्थक या मनगढ़ंत सामग्री का कारण भी बन सकती है।
जनरेटिव AI में प्रवाहशीलता, रचनात्मकता और विश्वसनीयता के बीच संतुलन नाजुक है। बीम सर्च जहाँ प्रवाह सुनिश्चित करता है, वहीं सैम्पलिंग विविधता लाती है—पर दोनों ही प्रकार-प्रकार के विश्वसनीय दिखने वाले मतिभ्रम के जोखिम को बढ़ाते हैं। खासकर उन संदर्भों में जहाँ शुद्धता और तथ्यात्मक सहीपन अत्यंत महत्वपूर्ण हैं—जैसे चिकित्सा या विधिक क्षेत्र—आउटपुट को विश्वसनीय स्रोतों से सत्यापित या ग्राउंड करने की व्यवस्थाएँ आवश्यक हैं, ताकि कार्य सही ढंग से संपन्न हों।
AI मतिभ्रम के प्रभाव व्यापक हो सकते हैं, खासकर जब जनरेटिव AI टूल्स को व्यवसाय, अकैडेमिया, और दैनिक जीवन के कई क्षेत्रों में तेजी से अपनाया गया है। इनके परिणाम विशेष रूप से उच्च-दांव वाले क्षेत्रों में चिंताजनक हैं, जहाँ अशुद्धियाँ या मनगढ़ंत जानकारी भरोसे को कमजोर कर सकती हैं, खराब निर्णयों का कारण बन सकती हैं, या उल्लेखनीय हानि पहुँचा सकती हैं। संभावित परिणामों में शामिल हैं:
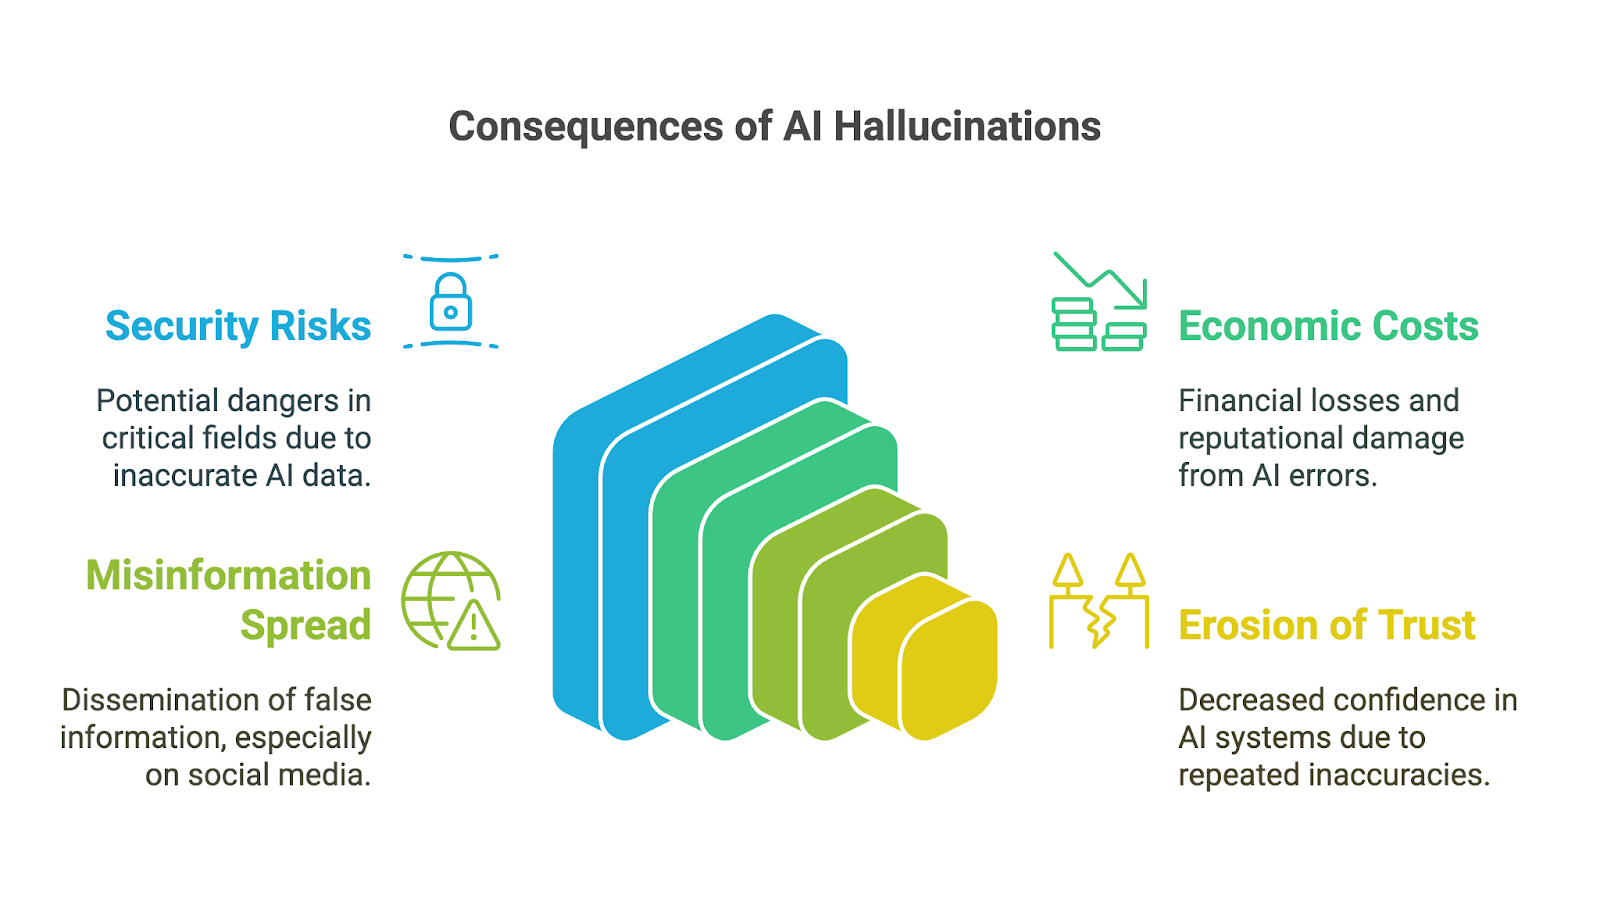
निर्णय-निर्माण के लिए परिणाम गंभीर हो सकते हैं—खासकर तब जब उपयोगकर्ता बिना जाँच-पड़ताल के AI-जनित आउटपुट पर निर्भर कर लेते हैं। वित्त, चिकित्सा या विधि जैसे क्षेत्रों में, छोटी-सी गलती या मनगढ़ंत विवरण भी दूरगामी प्रभावों वाले खराब निर्णयों का कारण बन सकते हैं। उदाहरण के लिए, गलत जानकारी वाला AI-जनित चिकित्सकीय निदान उचित उपचार में देरी करा सकता है। मनगढ़ंत डेटा वाली वित्तीय विश्लेषण रिपोर्ट महँगे त्रुटियों का कारण बन सकती है।
उच्च-दांव वाले अनुप्रयोगों में AI मतिभ्रम से जुड़े जोखिम किस प्रकार बढ़ जाते हैं, इसका एक और उदाहरण Google के शुरुआती चैटबॉट Bard (अब Gemini) में देखा जा सकता है। इसे विमान उतारने या स्कूबा डाइविंग जैसे महत्त्वपूर्ण विषयों पर खतरनाक सलाह देने के लिए आंतरिक आलोचना का सामना करना पड़ा। Bloomberg की रिपोर्ट के अनुसार, आंतरिक सुरक्षा टीमों ने सिस्टम को सार्वजनिक उपयोग के लिए अनुपयुक्त चिह्नित किया था, फिर भी कंपनी ने इसे लॉन्च कर दिया।
तात्कालिक जोखिमों से परे, AI मतिभ्रम व्यवसायों के लिए उल्लेखनीय आर्थिक और प्रतिष्ठागत लागतें भी ला सकता है। गलत आउटपुट संसाधनों की बर्बादी करते हैं—चाहे वह त्रुटियों की पुष्टि में लगने वाला समय हो या गलत अंतर्दृष्टियों पर कार्रवाई की कीमत। जो कंपनियाँ अविश्वसनीय AI टूल जारी करती हैं, वे प्रतिष्ठा को नुकसान, कानूनी देनदारियों और वित्तीय हानियों का जोखिम उठाती हैं—जैसा कि Google के $100 बिलियन के बाजार मूल्य में गिरावट के मामले में देखा गया, जब Bard ने एक प्रोमोशनल वीडियो में गलत जानकारी साझा की।
AI मतिभ्रम गलत और दुष्प्रचार के प्रसार में भी योगदान दे सकता है, खासकर सोशल मीडिया प्लेटफ़ॉर्मों के माध्यम से। जब जनरेटिव AI प्रवाहपूर्ण होने के कारण विश्वसनीय दिखने वाली गलत जानकारी उत्पन्न करता है, तो उपयोगकर्ता उसे सत्य मानकर जल्दी से बढ़ा सकते हैं। चूँकि जानकारी जनमत को आकार दे सकती है या नुकसान भड़का सकती है, इन टूल्स के डेवलपर्स और उपयोगकर्ताओं को अनजाने में झूठ के प्रसार को रोकने की जिम्मेदारी समझनी और स्वीकार करनी चाहिए।
अंततः, ऊपर उल्लिखित प्रभावों का समग्र परिणाम भरोसे का क्षरण हो सकता है। जब लोग गलत, निरर्थक, या भ्रामक आउटपुट देखते हैं, तो वे इन प्रणालियों की विश्वसनीयता पर सवाल उठाने लगते हैं—विशेषकर वहाँ जहाँ सटीक जानकारी अत्यावश्यक है। कुछ प्रमुख गलतियाँ AI तकनीकों की साख को नुकसान पहुँचा सकती हैं और उनके अपनाव एवं स्वीकार्यता को बाधित कर सकती हैं।
इसी अनुरूप, AI मतिभ्रम से जुड़ी सबसे बड़ी चुनौतियों में से एक है उपयोगकर्ता शिक्षा और अपेक्षाओं का प्रबंधन। कई उपयोगकर्ता—खासकर जो AI से कम परिचित हैं—अक्सर मान लेते हैं कि जनरेटिव टूल्स का आउटपुट पूरी तरह सटीक और भरोसेमंद होता है, क्योंकि वह सुसज्जित और आत्मविश्वासपूर्ण लगता है। इन टूल्स की सीमाओं के बारे में उपयोगकर्ताओं को शिक्षित करना आवश्यक है पर जटिल भी—क्योंकि इसके लिए AI की अपूर्णताओं के बारे में पारदर्शिता और उसकी संभावनाओं पर विश्वास, दोनों के बीच संतुलन कायम रखना पड़ता है।
इस खंड में, हम डेटा गुणवत्ता सुनिश्चित करने, मॉडल ट्यूनिंग, सत्यापन और सहयोग, तथा प्रॉम्प्ट ऑप्टिमाइज़ेशन के माध्यम से AI मतिभ्रम को कैसे कम किया जा सकता है, इसका अन्वेषण करेंगे।
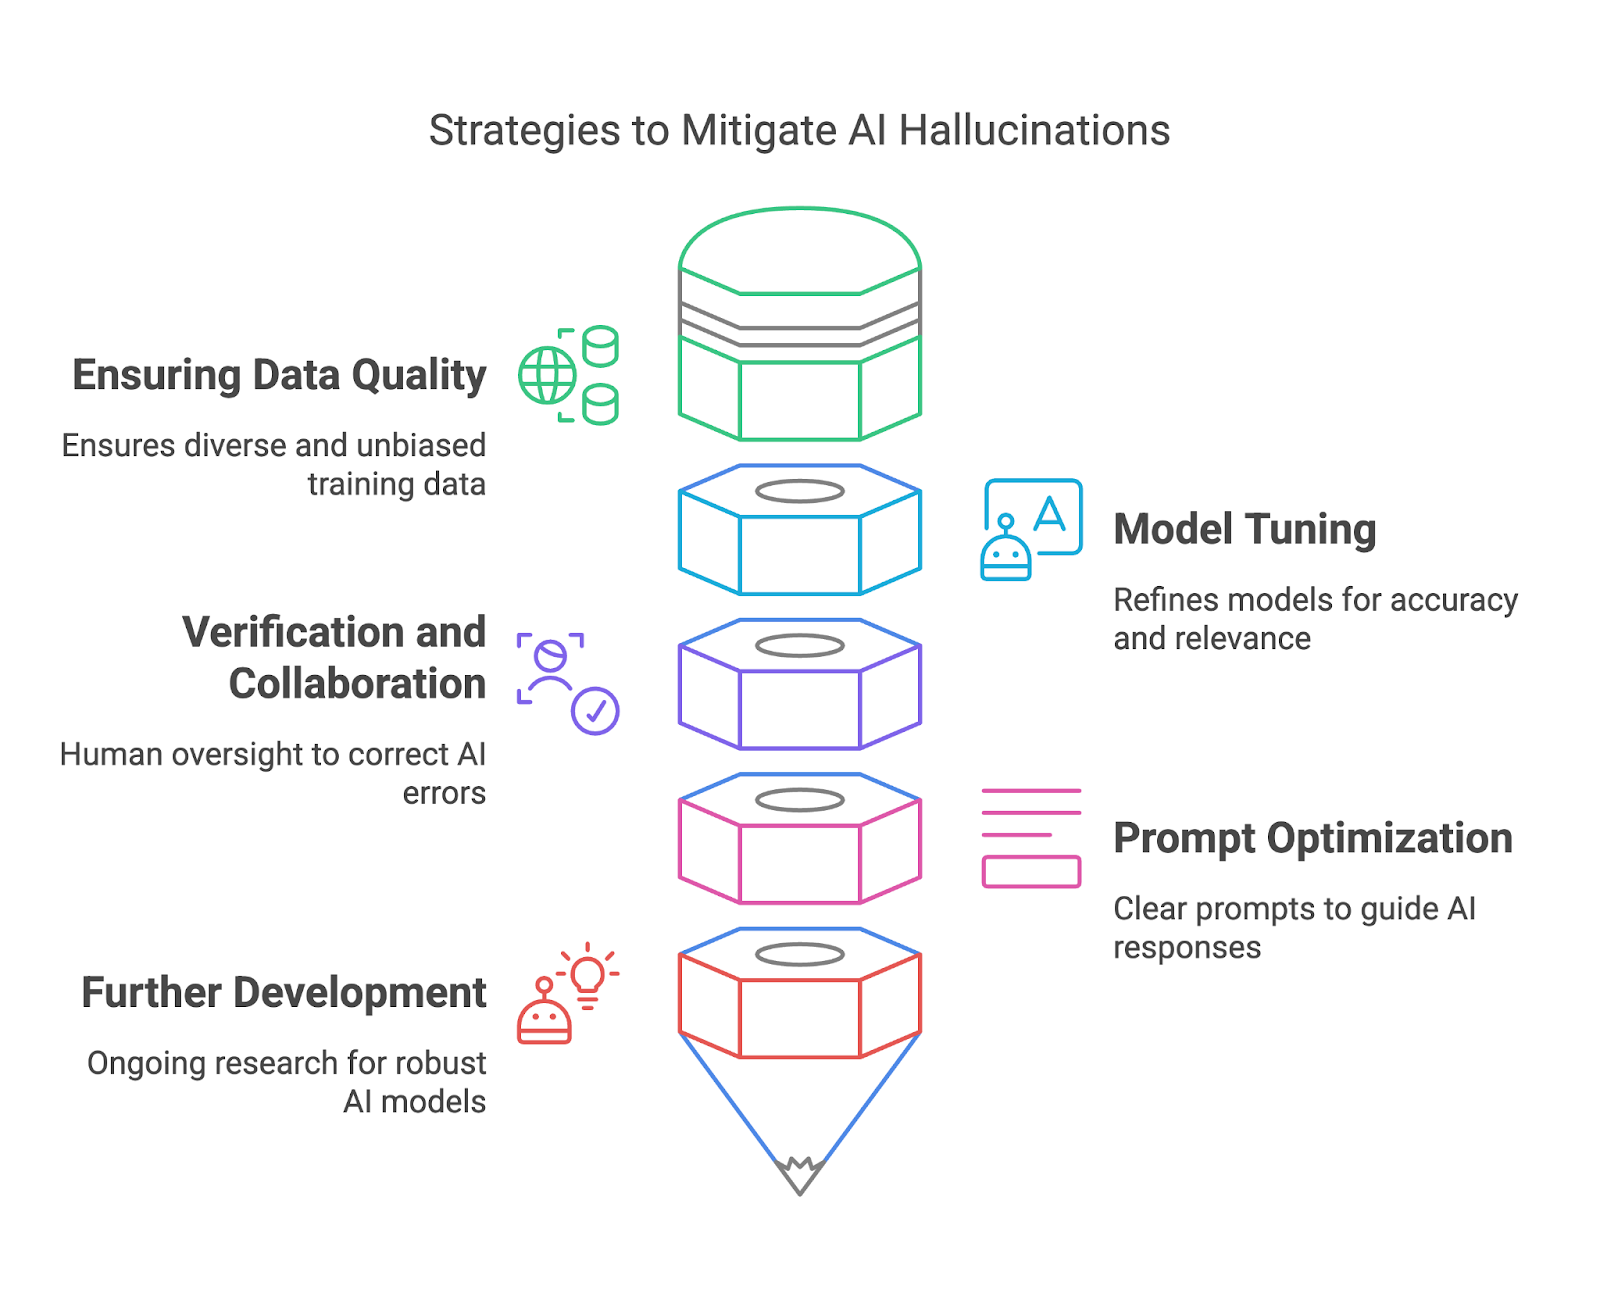
उच्च-गुणवत्ता प्रशिक्षण डेटा AI मतिभ्रम को कम करने के लिए मॉडल डिप्लॉयर्स के हाथ का सबसे प्रभावी तरीका है। यह सुनिश्चित करके कि प्रशिक्षण डैटासेट विविध, प्रतिनिधिक और प्रमुख पक्षपातों से मुक्त हों, डिप्लॉयर्स मॉडलों द्वारा तथ्यात्मक रूप से गलत या भ्रामक आउटपुट उत्पन्न होने के जोखिम को घटा सकते हैं। विविध डैटासेट मॉडल को व्यापक संदर्भों, भाषाओं और सांस्कृतिक बारीकियों को समझने में मदद करते हैं, जिससे वह अधिक सटीक और भरोसेमंद उत्तर दे पाता है।
इसे साधने के लिए, मॉडल डिप्लॉयर्स कड़ी डेटा क्यूरेशन प्रक्रियाएँ अपना सकते हैं—जैसे अविश्वसनीय स्रोतों को फ़िल्टर करना, डैटासेट्स को नियमित रूप से अद्यतन करना, और विशेषज्ञ-समीक्षित सामग्री को शामिल करना। डेटा ऑग्मेंटेशन और एक्टिव लर्निंग जैसी तकनीकें डैटासेट की गुणवत्ता बढ़ा सकती हैं—खामियों की पहचान करके और प्रासंगिक अतिरिक्त डेटा से उन्हें भरकर। साथ ही, डैटासेट निर्माण के दौरान पक्षपात का पता लगाने और सुधारने वाले टूल्स का उपयोग संतुलित प्रतिनिधित्व सुनिश्चित करने के लिए आवश्यक है।
फाइन-ट्यूनिंग और मॉडलों का परिष्कार, मतिभ्रम को कम करने और समग्र विश्वसनीयता सुधारने के लिए अनिवार्य हैं। ये प्रक्रियाएँ मॉडल के व्यवहार को उपयोगकर्ता अपेक्षाओं के अनुरूप ढालती हैं, अशुद्धियों को घटाती हैं, और आउटपुट की प्रासंगिकता बढ़ाती हैं। फाइन-ट्यूनिंग विशेष रूप से किसी सामान्य-उद्देश्य मॉडल को विशिष्ट उपयोग मामलों के अनुरूप ढालने में उपयोगी है, ताकि वह विशेष संदर्भों में अप्रासंगिक या गलत उत्तर दिए बिना अच्छा प्रदर्शन करे।
कई टूल्स और विधियाँ मॉडल परिष्कार को अधिक प्रभावी बनाती हैं। मानव फीडबैक से सुदृढीकरण शिक्षण (RLHF) एक शक्तिशाली दृष्टिकोण है, जो मॉडलों को वांछित परिणामों के अनुरूप व्यवहार सीखने हेतु उपयोगकर्ता-प्रदत्त फीडबैक से सीखने देता है।
पैरामीटर ट्यूनिंग का उपयोग मॉडल की आउटपुट शैली समायोजित करने के लिए भी किया जा सकता है—जैसे तथ्यात्मक विश्वसनीयता के लिए उत्तरों को अधिक सतर्क बनाना या खुले-अंत कार्यों के लिए अधिक रचनात्मक बनाना। ड्रॉपआउट, रेग्युलराइजेशन और अर्ली-स्टॉपिंग जैसी तकनीकें प्रशिक्षण के दौरान ओवरफिटिंग से लड़ने में मदद करती हैं, ताकि मॉडल डेटा रटने के बजाय अच्छी तरह सामान्यीकृत हो।
AI-जनित आउटपुट को विश्वसनीय स्रोतों या स्थापित ज्ञान के साथ सत्यापित करके, मानव समीक्षक त्रुटियाँ पकड़ सकते हैं, अशुद्धियों को सुधार सकते हैं, और संभावित हानिकारक परिणामों को रोक सकते हैं।
एकीकृत तथ्य-जाँच प्रणालियाँ, जैसे OpenAI के वेब-ब्राउज़िंग प्लगइन्स, वास्तविक समय में विश्वसनीय डाटाबेस से जनित आउटपुट का क्रॉस-रेफरेंस करके मतिभ्रम को कम करने में मदद करती हैं। ये टूल्स सुनिश्चित करते हैं कि AI के उत्तर भरोसेमंद जानकारी पर आधारित हों—जिससे वे शिक्षा या अनुसंधान जैसे तथ्य-संवेदनशील क्षेत्रों के लिए विशेष रूप से उपयोगी बनते हैं।
वर्कफ़्लो में मानवीय समीक्षा को शामिल करना एक अतिरिक्त जाँच-परत उपलब्ध कराता है—खासकर चिकित्सा या विधि जैसे उच्च-दांव अनुप्रयोगों में, जहाँ त्रुटियों के गंभीर परिणाम हो सकते हैं।
एंड-यूज़र्स की ओर से, सावधानीपूर्वक प्रॉम्प्ट डिज़ाइन AI मतिभ्रम को कम करने में महत्त्वपूर्ण भूमिका निभाता है। एक अस्पष्ट प्रॉम्प्ट मतिभ्रमित या अप्रासंगिक उत्तर की ओर ले जा सकता है, जबकि स्पष्ट और विशिष्ट प्रॉम्प्ट मॉडल को अर्थपूर्ण परिणाम उत्पन्न करने का बेहतर ढाँचा देता है।
आउटपुट की विश्वसनीयता बढ़ाने के लिए हम कई प्रॉम्प्ट इंजीनियरिंग तकनीकों का उपयोग कर सकते हैं। उदाहरण के लिए, जटिल कार्यों को छोटे, अधिक प्रबंधनीय चरणों में तोड़ना AI पर संज्ञानात्मक बोझ घटाता है और त्रुटि की संभावना कम करता है। अधिक जानने के लिए, आप प्रॉम्प्ट ऑप्टिमाइज़ेशन तकनीकों पर यह ब्लॉग पढ़ सकते हैं।
अंत में, AI समुदाय में चल रहे शोध का उद्देश्य अधिक मज़बूत और विश्वसनीय AI मॉडल विकसित करना है ताकि मतिभ्रम घटे। Explainable AI (XAI) AI आउटपुट के पीछे के तर्क को उजागर करके पारदर्शिता प्रदान करता है, जिससे उपयोगकर्ता उनकी वैधता का आकलन कर सकते हैं।
Retrieval-Augmented Generation (RAG) प्रणालियाँ, जो जनरेटिव AI को बाहरी ज्ञान स्रोतों के साथ जोड़ती हैं, सत्यापित और अद्यतन डेटा में उत्तरों को एंकर करके मतिभ्रम को कम करती हैं।
जहाँ AI मतिभ्रम महत्वपूर्ण चुनौतियाँ पेश करता है, वहीं यह जनरेटिव AI प्रणालियों को सुधारने और परिष्कृत करने के अवसर भी देता है। उनके कारणों, प्रभावों और शमन रणनीतियों को समझकर, मॉडल डिप्लॉयर्स और उपयोगकर्ता—दोनों—त्रुटियों को न्यूनतम करने और विश्वसनीयता को अधिकतम करने के लिए सक्रिय कदम उठा सकते हैं।
इन कोर्स के साथ AI सीखें!
लर्निंग पाथ
कोर्स
लर्निंग पाथ