चाहे आप अपने पोर्टफोलियो में कोई डेटा प्रोजेक्ट जोड़ रहे हों या एक भुगतानशुदा डेटा वैज्ञानिक के रूप में अपना पहला प्रोजेक्ट शुरू कर रहे हों, आपका पहला काम होगा एक उपयुक्त डेटा सेट खोजना। तो, डेटा सेट क्या है, और ये आपको कहाँ मिलते हैं?
डेटा हर जगह है, लेकिन आपकी विशिष्ट जिज्ञासाओं के जवाब के लिए विश्वसनीय और सुलभ सूचना स्रोत खोजना जितना लगता है, उससे कहीं अधिक मुश्किल हो सकता है। फिर भी, हर बेहतरीन डेटा प्रोजेक्ट की शुरुआत एक अच्छे डेटा सेट को खोजने से होती है। इस ट्यूटोरियल में, हम संक्षेप में देखेंगे कि कौन-कौन से प्रकार के डेटा सेट उपलब्ध हैं, उन्हें कैसे खोजें, और मिल जाने के बाद उनके साथ क्या करें।
डेटा सेट्स क्या होते हैं?
डेटा सेट मूलतः सूचनाओं का एक संग्रह है। आमतौर पर यह सूचना किसी न किसी तरह व्यवस्थित होती है, हालाँकि संभव है कि यह आपके संदर्भ में तुरंत उपयोगी न हो और उसे इस्तेमाल योग्य बनाने के लिए आपको कुछ काम करना पड़े।
डेटा के कई प्रकार हैं, जो अलग-अलग तरीकों से संगठित हो सकते हैं। सामान्य डेटा सेट प्रकारों में शामिल हैं:
- टैबुलर डेटा, जिसे तालिकाओं में व्यवस्थित किया जाता है, जैसे स्प्रेडशीट्स
- रिलेशनल डेटा, जो तालिकाओं का एक समूह होता है जो आपसी संबंधों के माध्यम से जुड़े होते हैं
- टाइम-सीरीज़ डेटा, जो कालानुक्रमिक क्रम में व्यवस्थित होता है।
अन्य डेटा सेट्स में छवियों, पाठ दस्तावेजों, या ऑडियो या वीडियो रिकॉर्डिंग्स के संग्रह शामिल हो सकते हैं।
मुझे डेटा सेट्स कहाँ मिल सकते हैं?
काम करने के लिए विश्वसनीय डेटा सेट्स की तलाश करना समय लेने वाला कार्य हो सकता है। बहुत से डेटा सेट निःशुल्क उपलब्ध हैं, हालाँकि कई सशुल्क या स्वामित्वाधिकार वाले भी होते हैं।
अपने प्रोजेक्ट के लिए आवश्यक डेटा पाना पेवॉल्स, कानूनी मुद्दों, बौद्धिक संपदा अधिकारों से जटिल हो सकता है या कुछ मामलों में, जो सटीक डेटा आप खोज रहे हैं, वह मौजूद ही न हो।
ऐसे मामलों में, आपको उपलब्ध डेटा के साथ क्या किया जा सकता है, इस पर रचनात्मक होना पड़ेगा, या आपको अपना डेटा स्वयं एकत्र करना पड़ सकता है (जो अपने आप में एक पूरा प्रोजेक्ट हो सकता है)। डेटा संग्रह पर कुछ विचारों के लिए यह Python के साथ वेब स्क्रैपिंग कोर्स, यह डेटा साइंस समझें कोर्स, या यह बिजनेस के लिए डेटा साइंस कोर्स देखें।
DataCamp के पास विभिन्न विषयों पर क्यूरेटेड डेटा सेट्स का संग्रह आसानी से उपलब्ध है। खासकर तब यह एक बेहतरीन जगह है जब आप नहीं जानते कि शुरुआत कहाँ से करें।
अन्य अच्छे स्रोतों में सरकारी वेबसाइट्स, गैर-लाभकारी संगठनों की वेबसाइट्स, विश्वविद्यालय और पुस्तकालय शामिल हैं। नीचे दिलचस्प डेटा सेट्स खोजने के लिए कई अच्छे संसाधनों की एक तालिका दी गई है।
|
डेटा सेट का स्रोत
|
वेब लिंक
|
|
DataCamp
|
https://www.datacamp.com/workspace/datasets
|
|
Google Dataset Search
|
https://datasetsearch.research.google.com/
|
|
Data.gov
|
https://data.gov/
|
|
Datahub
|
https://www.datahub.io/search
|
|
UCI Machine Learning Repository
|
https://archive.ics.uci.edu/
|
|
Kaggle
|
https://www.kaggle.com/datasets
|
|
Library of Congress
|
https://guides.loc.gov/datasets
|
|
US Census Bureau
|
https://www.census.gov/data/datasets.html
|
|
Federal Trade Commission
|
https://www.ftc.gov/policy-notices/open-government/data-sets
|
|
World Health Organization
|
https://www.who.int/data/sets
|
|
Centers for Disease Control and Prevention
|
https://open.cdc.gov/data.html
|
|
National Institutes for Health
|
https://www.ncbi.nlm.nih.gov/datasets/
|
किसी डेटा स्रोत को चुनते समय उसकी गुणवत्ता और विश्वसनीयता का आकलन करना एक अहम कदम है। सबसे बढ़कर, आपको यह सत्यापित करना चाहिए कि आपका डेटा स्रोत प्रतिष्ठित है। DataCamp के प्रत्येक डेटा सेट में स्रोत सामग्री का लिंक दिया होता है, जिससे इसकी प्रामाणिकता जाँचना आसान हो जाता है।
अन्य डेटा स्रोतों के साथ, विश्वसनीयता सुनिश्चित करने के लिए आपको थोड़ा और गहराई से जाँच करनी पड़ सकती है। जिन कारकों पर विचार करना चाहिए, उनमें शामिल हैं: डेटा कैसे एकत्र किया गया, डेटा किन आबादियों का प्रतिनिधित्व करता है, और संग्रह प्रक्रिया में कोई पक्षपात तो नहीं था।
डेटा सेट चुनते समय एक और पहलू यह है कि डेटा को उपयोगी प्रारूप में लाने के लिए कितनी सफाई और संरूपण (wrangling) की आवश्यकता होगी। अधिक क्यूरेटेड डेटा सेट चुनना आपका समय बचा सकता है। हालाँकि, अक्सर ऐसे अव्यवस्थित डेटा का उपयोग करना अपरिहार्य होता है जिसमें फ़ील्ड्स का फ़ॉर्मेट एक जैसा करना, गुम मानों को संभालना और डुप्लिकेट डेटा हटाना जैसे कार्यों में काफ़ी मेहनत लगती है।
इन समस्याओं से निपटने में यह डेटा क्लीनिंग ट्यूटोरियल आपकी मदद करेगा।
डेटा सेट संरचनाओं का अन्वेषण
डेटा सेट के हिस्सों का वर्णन करने के लिए कुछ मानक शब्दावली प्रचलित है, जिन्हें जानना उपयोगी रहता है।
टैबुलर डेटा सेट्स पंक्तियों और स्तंभों से बने होते हैं। सामान्यतः, हर पंक्ति एकल रिकॉर्ड होती है, और हर स्तंभ उस रिकॉर्ड का कोई गुण या चर दर्शाता है।
पंक्ति और स्तंभ के प्रतिच्छेद पर स्थित हर डेटा सेल में एक मान होता है। एक इंडेक्स हर रिकॉर्ड को अलग संख्या देता है। हेडर, या हर स्तंभ की पहली पंक्ति, सामान्यतः उस गुण या स्तंभ का नाम होता है। रिलेशनल डेटाबेस में, अलग-अलग तालिकाएँ संबंधों के माध्यम से जुड़ी हो सकती हैं।
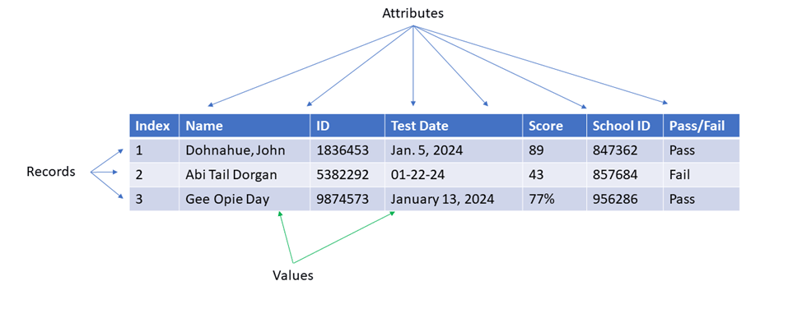
जब आप कोई डेटा सेट पहली बार प्राप्त करते हैं, तो उसे जाँचना और इन मुख्य विशेषताओं की पहचान करना महत्वपूर्ण होता है। डेटा सेट देखने के कई तरीके हैं, जिनमें उसे Python, SQL, R या Matlab में लोड करना और विशिष्ट पंक्तियाँ प्रदर्शित करवाना शामिल है।
फ़ाइल के प्रकार और आकार के अनुसार, आप उसे सीधे Microsoft Excel या Google Sheets में खोलकर भी देख सकते हैं। ध्यान रखें कि यदि आपका डेटा सेट बहुत बड़ा है, तो पूरे डेटा सेट को एक साथ लोड करना बहुत मेमोरी लेगा, इसलिए आपको उसे हिस्सों में देखकर काम करना पड़ सकता है।
डेटा सेट्स की सफाई और तैयारी
अक्सर, अपने प्रोजेक्ट के लिए डेटा सेट मिल जाने के बाद अगला कदम उसे इस्तेमाल योग्य प्रारूप में लाने के लिए काफ़ी सफाई और तैयारी करना होता है। DataCamp जैसे प्लेटफ़ॉर्म पर मिलने वाले क्यूरेटेड डेटा सेट चुनने से आवश्यक सफाई का दायरा सीमित हो सकता है।
फिर भी, अपनी आवश्यकताओं के अनुरूप डेटा सेट को ढालना संभवतः पड़ेगा। यह विशेष रूप से तब सही है जब आप अपने प्रोजेक्ट के लिए कई स्रोतों से डेटा ला रहे हों।
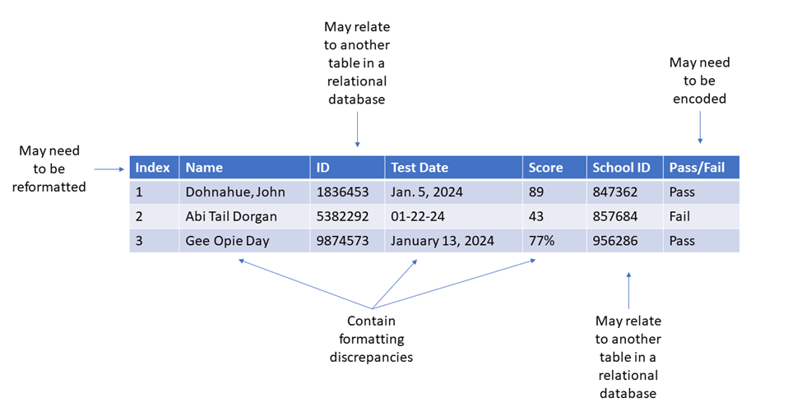
डेटा सेट्स की सफाई और तैयारी करते समय, आपको जिन सामान्य कार्यों की ज़रूरत पड़ सकती है, उनमें शामिल हैं:
- अपने विश्लेषण से असंबंधित डेटा को हटाना
- डुप्लिकेट डेटा प्रविष्टियों की पहचान और उन्हें हटाना
- टाइपो, अपूर्ण कैपिटलाइज़ेशन, या असंगत नामकरण पद्धतियों को ठीक करना
- गुम डेटा को हटाना या उसका अनुमानित मान भरना
- श्रेणीबद्ध डेटा को संख्यात्मक प्रारूप में एन्कोड करना
- डेटा को एकसमान प्रारूप में रूपांतरित करना
- अपने डेटा सेट में सुसंगतता और शुद्धता सुनिश्चित करना
और जानकारी के लिए ये कोर्स देखें: Python में डेटा क्लीनिंग या SQL सर्वर डेटाबेसेज़ में डेटा क्लीनिंग।
एक्सप्लोरेटरी डेटा एनालिसिस
एक्सप्लोरेटरी डेटा एनालिसिस आपको अपने डेटा सेट को भली-भाँति समझने में मदद करता है—किसी भी जटिल विश्लेषण में जाने से पहले का अहम कदम। कई जूनियर डेटा प्रोफेशनल्स यह महत्वपूर्ण चरण छोड़ देते हैं और उसका खामियाज़ा भुगतते हैं।
मैं दृढ़ता से सलाह देता/देती हूँ कि किसी भी मॉडलिंग, मशीन लर्निंग, या अन्य जटिल विश्लेषण में जाने से पहले आप अपने डेटा सेट पर कई तरह के खोजपूर्ण विश्लेषण करें।
यह चरण आपको अपने डेटा सेट में किसी भी विचित्रता, असंगति, या समस्या को पकड़ने में मदद करेगा। यह आगे के लिए उपयुक्त विश्लेषण चुनने में मार्गदर्शन देगा और किसी भी असामान्य परिणाम का पता लगाने व उन्हें सुधारने में सहायक होगा।
यह खोजपूर्ण चरण वर्णनात्मक आँकड़ों से लेकर सरल विज़ुअलाइज़ेशन्स तक कई रूप ले सकता है। अधिकांश टैबुलर डेटा सेट्स के लिए, औसत, माध्यिका और मानक विचलन जैसे सार आँकड़े, साथ ही सरल स्कैटर प्लॉट्स या बार चार्ट्स, आपके डेटा के पैटर्न और व्यवहार की सूझबूझ भरी झलक दे सकते हैं।
मैं आपको प्रोत्साहित करता/करती हूँ कि अपने डेटा सेट में यथासंभव अधिक से अधिक चरों का प्लॉट बनाएँ। भले ही यह चरण आपके अंतिम डैशबोर्ड, रिपोर्ट, या एप्लिकेशन तक न पहुँचे, यह प्रक्रिया में आपका मार्गदर्शन करेगा। और जानें: Python में एक्सप्लोरेटरी डेटा एनालिसिस या R में एक्सप्लोरेटरी डेटा एनालिसिस।
अपनी डेटा कहानी प्रदर्शित करना
हर डेटा प्रोजेक्ट का अंतिम लक्ष्य अपनी खोजों को इच्छुक पक्षों के सामने प्रस्तुत करना है। चाहे आपके श्रोता बिज़नेस स्टेकहोल्डर हों, संभावित नियोक्ता हों, या डेटा सहयोगी—यह ज़रूरी है कि आपकी अंतर्दृष्टियाँ स्पष्ट और आसानी से समझ में आने वाली हों।
कभी-कभी एक साधारण ग्राफ़ और एक वर्णनात्मक शीर्षक ही काफ़ी होता है। अन्य बार, अधिक विस्तृत डैशबोर्ड की ज़रूरत हो सकती है। जो भी चुनें, सुनिश्चित करें कि आपकी व्याख्या आपके डेटा सेट के प्रति ईमानदार हो।
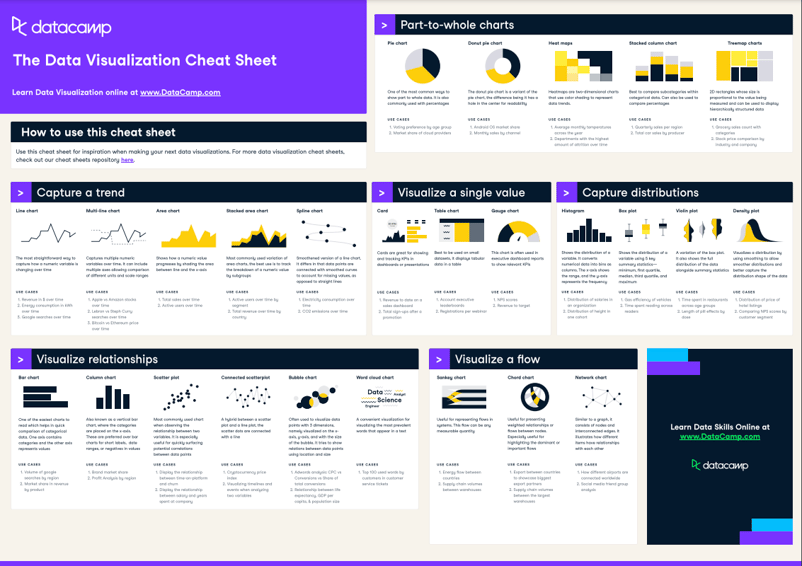
हमारा डेटा विज़ुअलाइज़ेशन चीट शीट आपको अपने डेटा सेट्स प्रदर्शित करने का सर्वोत्तम तरीका चुनने में मदद कर सकता है।
उद्देश्य यह होना चाहिए कि आप अपने श्रोताओं को ईमानदारी से बताएं कि आपका डेटा सेट क्या दर्शाता है और यह आपके सवालों का जवाब कैसे देता है। इस आवश्यक डेटा कौशल में दक्ष होने के लिए डेटा स्टोरीटेलिंग स्किल ट्रैक देखें।
DataCamp आपका डेटा पोर्टफोलियो प्रदर्शित करने के लिए एक बेहतरीन मंच है। डेटा पोर्टफोलियो होस्ट करने के अन्य लोकप्रिय विकल्पों में GitHub रिपॉज़िटरी या एक प्रोफेशनल वेबपेज शामिल हैं। जहाँ भी आप अपना प्रोजेक्ट होस्ट करें, सुनिश्चित करें कि वह आपके लक्षित श्रोता वर्ग के लिए आसानी से सुलभ हो।
निष्कर्ष
सूचना, डेटा साइंस के केंद्र में होती है। डेटा सेट्स सूचना को एक जगह समेटते हैं, जिससे रुझानों की पहचान, पूर्वानुमान, और मानवता को आगे बढ़ाने में मदद मिलती है। विश्लेषण के लिए डेटा सेट्स खोजना शुरू में कठिन लग सकता है, लेकिन कुछ शुरुआती ठिकानों का पता होना बहुत फर्क डालता है। DataCamp द्वारा चुने गए दिलचस्प डेटा सेट्स देखें और जानें कि आपको क्या प्रेरित करता है!


चाहे आप अपने पोर्टफोलियो में कोई डेटा प्रोजेक्ट जोड़ रहे हों या एक भुगतानशुदा डेटा वैज्ञानिक के रूप में अपना पहला प्रोजेक्ट शुरू कर रहे हों, आपका पहला काम होगा एक उपयुक्त डेटा सेट खोजना। तो, डेटा सेट क्या है, और ये आपको कहाँ मिलते हैं?
डेटा हर जगह है, लेकिन आपकी विशिष्ट जिज्ञासाओं के जवाब के लिए विश्वसनीय और सुलभ सूचना स्रोत खोजना जितना लगता है, उससे कहीं अधिक मुश्किल हो सकता है। फिर भी, हर बेहतरीन डेटा प्रोजेक्ट की शुरुआत एक अच्छे डेटा सेट को खोजने से होती है। इस ट्यूटोरियल में, हम संक्षेप में देखेंगे कि कौन-कौन से प्रकार के डेटा सेट उपलब्ध हैं, उन्हें कैसे खोजें, और मिल जाने के बाद उनके साथ क्या करें।
डेटा सेट्स क्या होते हैं?
डेटा सेट मूलतः सूचनाओं का एक संग्रह है। आमतौर पर यह सूचना किसी न किसी तरह व्यवस्थित होती है, हालाँकि संभव है कि यह आपके संदर्भ में तुरंत उपयोगी न हो और उसे इस्तेमाल योग्य बनाने के लिए आपको कुछ काम करना पड़े।
डेटा के कई प्रकार हैं, जो अलग-अलग तरीकों से संगठित हो सकते हैं। सामान्य डेटा सेट प्रकारों में शामिल हैं:
अन्य डेटा सेट्स में छवियों, पाठ दस्तावेजों, या ऑडियो या वीडियो रिकॉर्डिंग्स के संग्रह शामिल हो सकते हैं।
मुझे डेटा सेट्स कहाँ मिल सकते हैं?
काम करने के लिए विश्वसनीय डेटा सेट्स की तलाश करना समय लेने वाला कार्य हो सकता है। बहुत से डेटा सेट निःशुल्क उपलब्ध हैं, हालाँकि कई सशुल्क या स्वामित्वाधिकार वाले भी होते हैं।
अपने प्रोजेक्ट के लिए आवश्यक डेटा पाना पेवॉल्स, कानूनी मुद्दों, बौद्धिक संपदा अधिकारों से जटिल हो सकता है या कुछ मामलों में, जो सटीक डेटा आप खोज रहे हैं, वह मौजूद ही न हो।
ऐसे मामलों में, आपको उपलब्ध डेटा के साथ क्या किया जा सकता है, इस पर रचनात्मक होना पड़ेगा, या आपको अपना डेटा स्वयं एकत्र करना पड़ सकता है (जो अपने आप में एक पूरा प्रोजेक्ट हो सकता है)। डेटा संग्रह पर कुछ विचारों के लिए यह Python के साथ वेब स्क्रैपिंग कोर्स, यह डेटा साइंस समझें कोर्स, या यह बिजनेस के लिए डेटा साइंस कोर्स देखें।
DataCamp के पास विभिन्न विषयों पर क्यूरेटेड डेटा सेट्स का संग्रह आसानी से उपलब्ध है। खासकर तब यह एक बेहतरीन जगह है जब आप नहीं जानते कि शुरुआत कहाँ से करें।
अन्य अच्छे स्रोतों में सरकारी वेबसाइट्स, गैर-लाभकारी संगठनों की वेबसाइट्स, विश्वविद्यालय और पुस्तकालय शामिल हैं। नीचे दिलचस्प डेटा सेट्स खोजने के लिए कई अच्छे संसाधनों की एक तालिका दी गई है।
डेटा सेट का स्रोत
वेब लिंक
DataCamp
https://www.datacamp.com/workspace/datasets
Google Dataset Search
https://datasetsearch.research.google.com/
Data.gov
https://data.gov/
Datahub
https://www.datahub.io/search
UCI Machine Learning Repository
https://archive.ics.uci.edu/
Kaggle
https://www.kaggle.com/datasets
Library of Congress
https://guides.loc.gov/datasets
US Census Bureau
https://www.census.gov/data/datasets.html
Federal Trade Commission
https://www.ftc.gov/policy-notices/open-government/data-sets
World Health Organization
https://www.who.int/data/sets
Centers for Disease Control and Prevention
https://open.cdc.gov/data.html
National Institutes for Health
https://www.ncbi.nlm.nih.gov/datasets/
किसी डेटा स्रोत को चुनते समय उसकी गुणवत्ता और विश्वसनीयता का आकलन करना एक अहम कदम है। सबसे बढ़कर, आपको यह सत्यापित करना चाहिए कि आपका डेटा स्रोत प्रतिष्ठित है। DataCamp के प्रत्येक डेटा सेट में स्रोत सामग्री का लिंक दिया होता है, जिससे इसकी प्रामाणिकता जाँचना आसान हो जाता है।
अन्य डेटा स्रोतों के साथ, विश्वसनीयता सुनिश्चित करने के लिए आपको थोड़ा और गहराई से जाँच करनी पड़ सकती है। जिन कारकों पर विचार करना चाहिए, उनमें शामिल हैं: डेटा कैसे एकत्र किया गया, डेटा किन आबादियों का प्रतिनिधित्व करता है, और संग्रह प्रक्रिया में कोई पक्षपात तो नहीं था।
डेटा सेट चुनते समय एक और पहलू यह है कि डेटा को उपयोगी प्रारूप में लाने के लिए कितनी सफाई और संरूपण (wrangling) की आवश्यकता होगी। अधिक क्यूरेटेड डेटा सेट चुनना आपका समय बचा सकता है। हालाँकि, अक्सर ऐसे अव्यवस्थित डेटा का उपयोग करना अपरिहार्य होता है जिसमें फ़ील्ड्स का फ़ॉर्मेट एक जैसा करना, गुम मानों को संभालना और डुप्लिकेट डेटा हटाना जैसे कार्यों में काफ़ी मेहनत लगती है।
इन समस्याओं से निपटने में यह डेटा क्लीनिंग ट्यूटोरियल आपकी मदद करेगा।
डेटा सेट संरचनाओं का अन्वेषण
डेटा सेट के हिस्सों का वर्णन करने के लिए कुछ मानक शब्दावली प्रचलित है, जिन्हें जानना उपयोगी रहता है।
टैबुलर डेटा सेट्स पंक्तियों और स्तंभों से बने होते हैं। सामान्यतः, हर पंक्ति एकल रिकॉर्ड होती है, और हर स्तंभ उस रिकॉर्ड का कोई गुण या चर दर्शाता है।
पंक्ति और स्तंभ के प्रतिच्छेद पर स्थित हर डेटा सेल में एक मान होता है। एक इंडेक्स हर रिकॉर्ड को अलग संख्या देता है। हेडर, या हर स्तंभ की पहली पंक्ति, सामान्यतः उस गुण या स्तंभ का नाम होता है। रिलेशनल डेटाबेस में, अलग-अलग तालिकाएँ संबंधों के माध्यम से जुड़ी हो सकती हैं।
जब आप कोई डेटा सेट पहली बार प्राप्त करते हैं, तो उसे जाँचना और इन मुख्य विशेषताओं की पहचान करना महत्वपूर्ण होता है। डेटा सेट देखने के कई तरीके हैं, जिनमें उसे Python, SQL, R या Matlab में लोड करना और विशिष्ट पंक्तियाँ प्रदर्शित करवाना शामिल है।
फ़ाइल के प्रकार और आकार के अनुसार, आप उसे सीधे Microsoft Excel या Google Sheets में खोलकर भी देख सकते हैं। ध्यान रखें कि यदि आपका डेटा सेट बहुत बड़ा है, तो पूरे डेटा सेट को एक साथ लोड करना बहुत मेमोरी लेगा, इसलिए आपको उसे हिस्सों में देखकर काम करना पड़ सकता है।
डेटा सेट्स की सफाई और तैयारी
अक्सर, अपने प्रोजेक्ट के लिए डेटा सेट मिल जाने के बाद अगला कदम उसे इस्तेमाल योग्य प्रारूप में लाने के लिए काफ़ी सफाई और तैयारी करना होता है। DataCamp जैसे प्लेटफ़ॉर्म पर मिलने वाले क्यूरेटेड डेटा सेट चुनने से आवश्यक सफाई का दायरा सीमित हो सकता है।
फिर भी, अपनी आवश्यकताओं के अनुरूप डेटा सेट को ढालना संभवतः पड़ेगा। यह विशेष रूप से तब सही है जब आप अपने प्रोजेक्ट के लिए कई स्रोतों से डेटा ला रहे हों।
डेटा सेट्स की सफाई और तैयारी करते समय, आपको जिन सामान्य कार्यों की ज़रूरत पड़ सकती है, उनमें शामिल हैं:
और जानकारी के लिए ये कोर्स देखें: Python में डेटा क्लीनिंग या SQL सर्वर डेटाबेसेज़ में डेटा क्लीनिंग।
एक्सप्लोरेटरी डेटा एनालिसिस
एक्सप्लोरेटरी डेटा एनालिसिस आपको अपने डेटा सेट को भली-भाँति समझने में मदद करता है—किसी भी जटिल विश्लेषण में जाने से पहले का अहम कदम। कई जूनियर डेटा प्रोफेशनल्स यह महत्वपूर्ण चरण छोड़ देते हैं और उसका खामियाज़ा भुगतते हैं।
मैं दृढ़ता से सलाह देता/देती हूँ कि किसी भी मॉडलिंग, मशीन लर्निंग, या अन्य जटिल विश्लेषण में जाने से पहले आप अपने डेटा सेट पर कई तरह के खोजपूर्ण विश्लेषण करें।
यह चरण आपको अपने डेटा सेट में किसी भी विचित्रता, असंगति, या समस्या को पकड़ने में मदद करेगा। यह आगे के लिए उपयुक्त विश्लेषण चुनने में मार्गदर्शन देगा और किसी भी असामान्य परिणाम का पता लगाने व उन्हें सुधारने में सहायक होगा।
यह खोजपूर्ण चरण वर्णनात्मक आँकड़ों से लेकर सरल विज़ुअलाइज़ेशन्स तक कई रूप ले सकता है। अधिकांश टैबुलर डेटा सेट्स के लिए, औसत, माध्यिका और मानक विचलन जैसे सार आँकड़े, साथ ही सरल स्कैटर प्लॉट्स या बार चार्ट्स, आपके डेटा के पैटर्न और व्यवहार की सूझबूझ भरी झलक दे सकते हैं।
मैं आपको प्रोत्साहित करता/करती हूँ कि अपने डेटा सेट में यथासंभव अधिक से अधिक चरों का प्लॉट बनाएँ। भले ही यह चरण आपके अंतिम डैशबोर्ड, रिपोर्ट, या एप्लिकेशन तक न पहुँचे, यह प्रक्रिया में आपका मार्गदर्शन करेगा। और जानें: Python में एक्सप्लोरेटरी डेटा एनालिसिस या R में एक्सप्लोरेटरी डेटा एनालिसिस।
अपनी डेटा कहानी प्रदर्शित करना
हर डेटा प्रोजेक्ट का अंतिम लक्ष्य अपनी खोजों को इच्छुक पक्षों के सामने प्रस्तुत करना है। चाहे आपके श्रोता बिज़नेस स्टेकहोल्डर हों, संभावित नियोक्ता हों, या डेटा सहयोगी—यह ज़रूरी है कि आपकी अंतर्दृष्टियाँ स्पष्ट और आसानी से समझ में आने वाली हों।
कभी-कभी एक साधारण ग्राफ़ और एक वर्णनात्मक शीर्षक ही काफ़ी होता है। अन्य बार, अधिक विस्तृत डैशबोर्ड की ज़रूरत हो सकती है। जो भी चुनें, सुनिश्चित करें कि आपकी व्याख्या आपके डेटा सेट के प्रति ईमानदार हो।
हमारा डेटा विज़ुअलाइज़ेशन चीट शीट आपको अपने डेटा सेट्स प्रदर्शित करने का सर्वोत्तम तरीका चुनने में मदद कर सकता है।
उद्देश्य यह होना चाहिए कि आप अपने श्रोताओं को ईमानदारी से बताएं कि आपका डेटा सेट क्या दर्शाता है और यह आपके सवालों का जवाब कैसे देता है। इस आवश्यक डेटा कौशल में दक्ष होने के लिए डेटा स्टोरीटेलिंग स्किल ट्रैक देखें।
DataCamp आपका डेटा पोर्टफोलियो प्रदर्शित करने के लिए एक बेहतरीन मंच है। डेटा पोर्टफोलियो होस्ट करने के अन्य लोकप्रिय विकल्पों में GitHub रिपॉज़िटरी या एक प्रोफेशनल वेबपेज शामिल हैं। जहाँ भी आप अपना प्रोजेक्ट होस्ट करें, सुनिश्चित करें कि वह आपके लक्षित श्रोता वर्ग के लिए आसानी से सुलभ हो।
निष्कर्ष
सूचना, डेटा साइंस के केंद्र में होती है। डेटा सेट्स सूचना को एक जगह समेटते हैं, जिससे रुझानों की पहचान, पूर्वानुमान, और मानवता को आगे बढ़ाने में मदद मिलती है। विश्लेषण के लिए डेटा सेट्स खोजना शुरू में कठिन लग सकता है, लेकिन कुछ शुरुआती ठिकानों का पता होना बहुत फर्क डालता है। DataCamp द्वारा चुने गए दिलचस्प डेटा सेट्स देखें और जानें कि आपको क्या प्रेरित करता है!