Programa
Analista de datos asociado en SQL
39 h
Practica y programa tu progreso.
Continuar Con GoogleTanto si quieres añadir un proyecto de datos a tu portfolio como si vas a empezar tu primer proyecto como científico de datos en activo, tu primera tarea será encontrar un conjunto de datos adecuado. Entonces, ¿qué es un conjunto de datos y dónde puedes encontrarlo?
Los datos están por todas partes, pero dar con una fuente de información fiable y accesible que responda a las preguntas concretas que te planteas puede ser mucho más difícil de lo que parece. Todo gran proyecto de datos empieza por encontrar un buen conjunto de datos. En este tutorial, veremos brevemente qué tipos de conjuntos de datos existen, cómo dar con ellos y qué hacer una vez los tengas.
Un conjunto de datos no es más que una colección de información. Por lo general, esa información está organizada de alguna forma, aunque puede que no esté organizada de una manera inmediatamente útil para tu contexto y tengas que trabajar un poco para dejarla lista para usar.
Existen varios tipos de datos que pueden organizarse de maneras distintas. Algunos tipos comunes de conjuntos de datos son:
Otros conjuntos de datos pueden incluir colecciones de imágenes, documentos de texto o grabaciones de audio y vídeo.
Buscar conjuntos de datos fiables con los que trabajar puede llevar tiempo. Hay muchos conjuntos gratuitos disponibles, aunque otros son de pago o incluso propietarios.
Encontrar los datos que necesitas para empezar tu proyecto puede complicarse por muros de pago, cuestiones legales, derechos de propiedad intelectual o, en algunos casos, porque los datos exactos que buscas sencillamente no existen.
En estos últimos casos, quizá tengas que ser creativo con lo que puedes hacer con los datos disponibles o incluso recopilar tus propios datos (lo que puede ser un proyecto en sí mismo). Échale un vistazo a este curso de web scraping con Python, a este curso de introducción a data science o a este curso de data science para negocios para inspirarte en la recogida de datos.
DataCamp cuenta con una colección de conjuntos de datos seleccionados y fácilmente accesibles sobre distintos temas. Es un gran punto de partida, sobre todo si no tienes claro por dónde empezar.
Otros buenos lugares son las webs de administraciones públicas, organizaciones sin ánimo de lucro, universidades y bibliotecas. A continuación tienes una tabla con varios recursos excelentes para encontrar conjuntos de datos interesantes.
|
Fuente de conjuntos de datos |
Enlace web |
|
DataCamp |
https://www.datacamp.com/workspace/datasets |
|
Google Dataset Search |
https://datasetsearch.research.google.com/ |
|
Data.gov |
https://data.gov/ |
|
Datahub |
https://www.datahub.io/search |
|
UCI Machine Learning Repository |
https://archive.ics.uci.edu/ |
|
Kaggle |
https://www.kaggle.com/datasets |
|
Library of Congress |
https://guides.loc.gov/datasets |
|
US Census Bureau |
https://www.census.gov/data/datasets.html |
|
Federal Trade Commission |
https://www.ftc.gov/policy-notices/open-government/data-sets |
|
World Health Organization |
https://www.who.int/data/sets |
|
Centers for Disease Control and Prevention |
https://open.cdc.gov/data.html |
|
National Institutes for Health |
https://www.ncbi.nlm.nih.gov/datasets/ |
Un paso crucial al elegir una fuente de datos es evaluar su calidad y fiabilidad. Lo más importante es verificar que la fuente sea de confianza. Cada uno de los conjuntos de datos de DataCamp incluye un enlace a la fuente original para que puedas comprobar fácilmente su autenticidad.
Con otras fuentes quizá tengas que investigar un poco más para asegurarte de que usas datos fiables. Entre los factores de fiabilidad a considerar están cómo se recogieron los datos, qué poblaciones representan y si hubo sesgos en el proceso de recopilación.
Otro aspecto a tener en cuenta al elegir un conjunto de datos es cuánto trabajo de limpieza y preparación hará falta para dejarlo en un formato utilizable. Elegir un conjunto de datos más curado puede ahorrarte tiempo. Sin embargo, a menudo es inevitable trabajar con datos más desordenados que requieren un esfuerzo considerable para unificar formatos, tratar valores ausentes y eliminar duplicados.
Este tutorial de limpieza de datos te ayudará a abordar algunos de estos problemas.
Exploración de la estructura de los conjuntos de datos
Hay cierta terminología estándar para describir las partes de un conjunto de datos que conviene conocer.
Los conjuntos de datos tabulares se componen de filas y columnas. Normalmente, cada fila es un registro y cada columna indica un atributo o variable de ese registro.
Cada celda de datos en la intersección de una fila y una columna contiene un valor. Un índice asigna a cada registro un número individual. La cabecera, o primera fila de cada columna, suele ser el nombre del atributo o de la columna. En una base de datos relacional, las tablas pueden estar conectadas mediante relaciones.
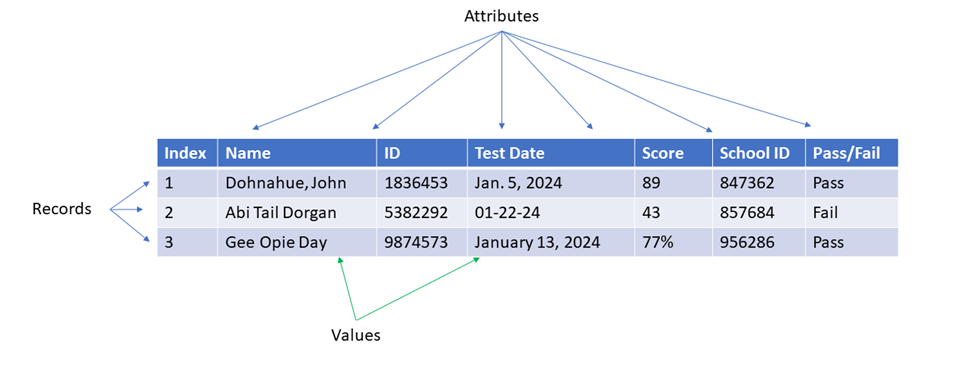
Cuando consigas un conjunto de datos por primera vez, es importante examinarlo e identificar algunas de estas características clave. Hay muchas opciones para visualizar tu conjunto de datos, como cargarlo en Python, SQL, R o Matlab y mostrar filas concretas.
Según el tipo y el tamaño del archivo, puede que incluso puedas abrirlo directamente en Microsoft Excel o Google Sheets y verlo allí. Ten en cuenta que, si tu conjunto de datos es muy grande, cargarlo entero consumirá mucha memoria, por lo que quizá debas verlo por partes.
A menudo, tras conseguir un conjunto de datos para tu proyecto, el siguiente paso será dedicar bastante tiempo a limpiar y prepararlo para dejarlo en un formato utilizable. Elegir un conjunto de datos curado, como los que encontrarás en DataCamp, reduce el trabajo de limpieza necesario.
Aun así, probablemente tendrás que adaptar el conjunto a tus necesidades. Esto es especialmente cierto si estás combinando datos de varias fuentes para tu proyecto.
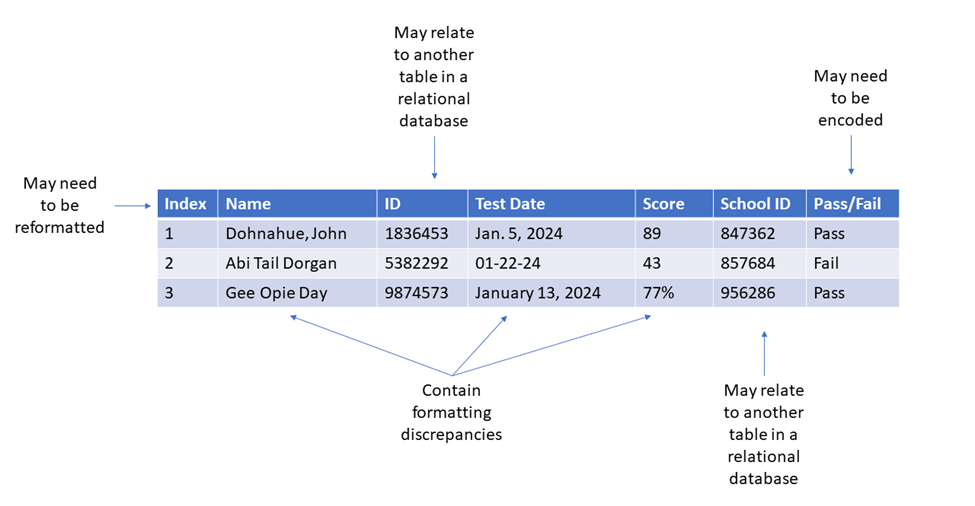
Al limpiar y preparar tus conjuntos de datos, algunas tareas habituales que puede que tengas que realizar incluyen:
Consulta estos cursos para saber más sobre limpieza de datos en Python o limpieza de datos en bases de datos SQL Server.
El análisis exploratorio de datos te ayuda a comprender de verdad tu conjunto, un paso crucial antes de lanzarte a análisis más complejos. Muchos profesionales junior de datos se saltan este paso crítico para su desgracia.
Te recomiendo encarecidamente que realices varios análisis exploratorios sobre tu conjunto de datos antes de meterte con modelado, machine learning u otros análisis más complejos.
Este paso te permitirá detectar rarezas, incoherencias o problemas en tu conjunto de datos. También te orientará hacia un análisis adecuado más adelante y te ayudará a detectar y corregir resultados anómalos.
La fase exploratoria debe adoptar varias formas, desde estadísticas descriptivas hasta visualizaciones sencillas. Para la mayoría de conjuntos tabulares, las estadísticas resumen, como la media, la mediana y la desviación estándar, junto con diagramas de dispersión o gráficos de barras simples, pueden darte una visión clara de los patrones y el comportamiento de tus datos.
Te animo a que dediques tiempo a representar tantas variables de tu conjunto de datos como sea razonable. Aunque esta fase quizá no aparezca en el dashboard, informe o aplicación finales que tengas en mente para tu proyecto, te guiará durante el proceso. Aprende más sobre análisis exploratorio de datos en Python o análisis exploratorio de datos en R.
El objetivo de todo proyecto de datos es presentar tus hallazgos a las partes interesadas. Ya sea que tu audiencia sean personas de negocio, un posible empleador o colegas de datos, es importante que tus insights sean claros y fáciles de interpretar.
A veces basta con un gráfico sencillo con un título descriptivo. En otras ocasiones, necesitarás un dashboard más elaborado. Elijas lo que elijas, asegúrate de que tu interpretación sea fiel a tu conjunto de datos.
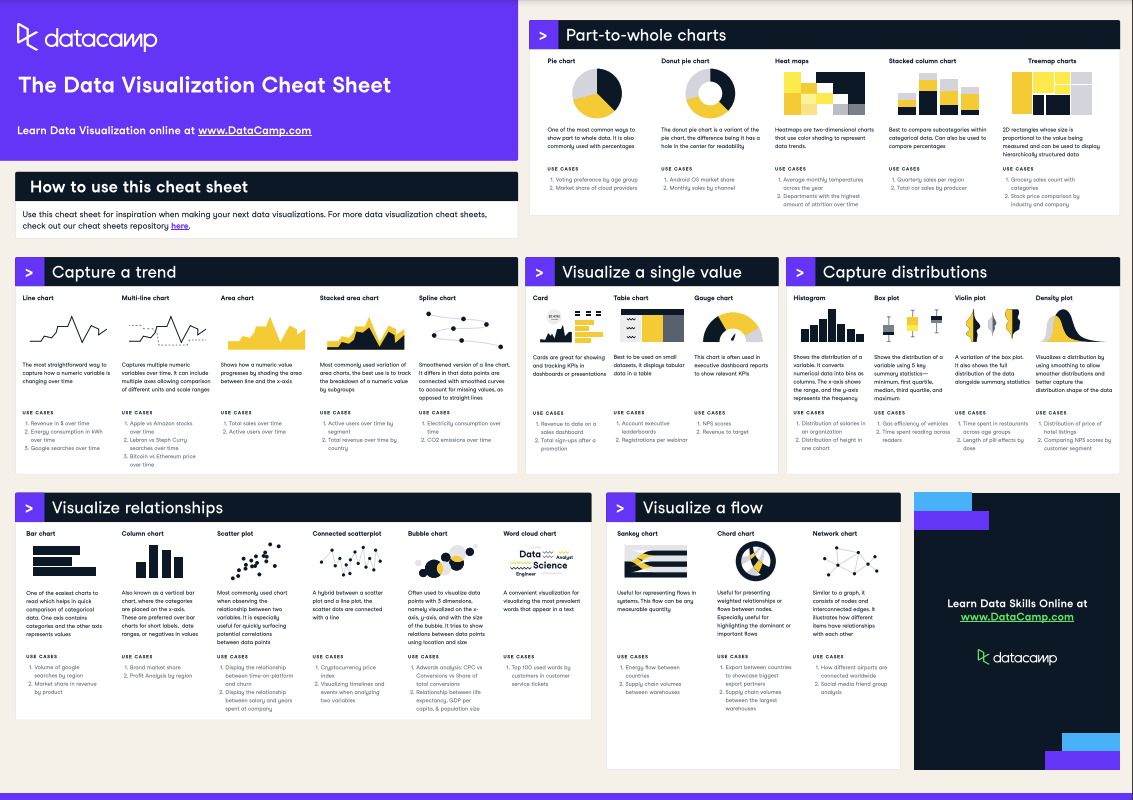
Nuestra chuleta de visualización de datos puede ayudarte a elegir la mejor forma de mostrar tus conjuntos de datos.
Tu meta debe ser transmitir con honestidad qué representa el conjunto de datos y cómo responde a tus preguntas. Explora el itinerario de aprendizaje de data storytelling para dominar esta habilidad esencial.
DataCamp es un gran lugar para mostrar tu portfolio de datos. Otras opciones populares para alojarlo son un repositorio en GitHub o una página web profesional. Dondequiera que alojes tu proyecto, asegúrate de que tu audiencia objetivo pueda acceder a él fácilmente.
La información está en el núcleo de la ciencia de datos. Los conjuntos de datos reúnen información en un solo lugar, lo que permite identificar tendencias, hacer predicciones y seguir impulsando el progreso. Encontrar conjuntos de datos para analizar puede parecer abrumador al principio, pero conocer algunos buenos sitios donde buscar marca la diferencia. Echa un vistazo a la selección de conjuntos de datos interesantes de DataCamp y deja que te inspiren.
¡Empieza hoy tu viaje en datos!
Programa
Programa
Practica y programa tu progreso.
Continuar Con Googleblog
Tim Lu
12 min
blog
Matt Crabtree
10 min
blog
Abid Ali Awan
13 min
blog
Javier Canales Luna
14 min
blog
Artur Sannikov
12 min
Tutorial
DataCamp Team
13 min