
Leerpad
Medewerker data-analist in SQL
39 uur
Of je nu een dataproject aan je portfolio toevoegt of met je eerste project als betaalde data scientist begint, je eerste taak is het vinden van een geschikte dataset. Dus, wat is een dataset en waar vind je die?
Data is overal, maar een betrouwbare en toegankelijke bron van informatie vinden om de specifieke vragen die jij wilt beantwoorden te tackelen, kan lastiger zijn dan het lijkt. Toch begint elk goed dataproject met het vinden van een goede dataset. In deze tutorial bespreken we kort welke soorten datasets er zijn, hoe je ze vindt en wat je ermee doet zodra je ze hebt.
Een dataset is simpelweg een verzameling informatie. Meestal is die informatie op een bepaalde manier georganiseerd, al is dat misschien niet direct bruikbaar voor jouw context en moet je er zelf wat werk in steken om het bruikbaar te maken.
Er zijn verschillende typen data die op uiteenlopende manieren kunnen zijn georganiseerd. Veelvoorkomende soorten datasets zijn:
Andere datasets kunnen verzamelingen beelden, tekstdocumenten of audio- en video-opnamen bevatten.
Zoeken naar betrouwbare datasets om mee te werken kan tijdrovend zijn. Er zijn veel gratis datasets beschikbaar, maar er zijn er ook die betaald of zelfs propriëtair zijn.
Het vinden van de data die je nodig hebt om je project te starten kan worden bemoeilijkt door betaalmuren, juridische kwesties, IE-rechten of, in sommige gevallen, doordat de exacte data die je zoekt simpelweg niet bestaat.
In die laatste gevallen moet je misschien creatief omgaan met wat je met de beschikbare data kunt doen, of zelfs je eigen data verzamelen (wat op zichzelf al een heel project kan zijn). Bekijk deze cursus webscraping met Python, deze cursus data science begrijpen of deze cursus data science voor business voor ideeën over dataverzameling.
DataCamp heeft een eenvoudig toegankelijke verzameling zorgvuldig geselecteerde datasets over allerlei onderwerpen. Dit is een goede plek om te beginnen, zeker als je nog niet weet waar je moet zoeken.
Andere goede plekken zijn websites van de overheid, non-profitorganisaties, universiteiten en bibliotheken. Hieronder staat een tabel met enkele uitstekende bronnen om interessante datasets te vinden.
|
Bron van datasets |
Weblink |
|
DataCamp |
https://www.datacamp.com/workspace/datasets |
|
Google Dataset Search |
https://datasetsearch.research.google.com/ |
|
Data.gov |
https://data.gov/ |
|
Datahub |
https://www.datahub.io/search |
|
UCI Machine Learning Repository |
https://archive.ics.uci.edu/ |
|
Kaggle |
https://www.kaggle.com/datasets |
|
Library of Congress |
https://guides.loc.gov/datasets |
|
US Census Bureau |
https://www.census.gov/data/datasets.html |
|
Federal Trade Commission |
https://www.ftc.gov/policy-notices/open-government/data-sets |
|
World Health Organization |
https://www.who.int/data/sets |
|
Centers for Disease Control and Prevention |
https://open.cdc.gov/data.html |
|
National Institutes for Health |
https://www.ncbi.nlm.nih.gov/datasets/ |
Een cruciale stap bij het kiezen van een databron is het beoordelen van de kwaliteit en betrouwbaarheid. Het belangrijkste is dat je verifieert of je databron gezaghebbend is. Elk van DataCamp’s datasets heeft een link naar het bronmateriaal, zodat je de authenticiteit eenvoudig kunt controleren.
Bij andere databronnen moet je mogelijk wat dieper graven om zeker te weten dat je betrouwbare data gebruikt. Betrouwbaarheidsfactoren om te overwegen zijn onder andere hoe de data is verzameld, welke populaties door de data worden vertegenwoordigd en of er vooroordelen in het verzamelproces zaten.
Een andere factor bij het kiezen van een dataset is hoeveel schoonmaak- en voorbereidingswerk nodig is om de data in een bruikbaar formaat te krijgen. Een meer gecureerde dataset kiezen kan je tijd besparen. Toch is het vaak onvermijdelijk om met rommeliger data te werken, waarvoor aanzienlijk werk nodig is om velden in hetzelfde formaat te krijgen, ontbrekende waarden aan te pakken en dubbele data te verwijderen.
Deze dataschoonmaak-tutorial helpt je om enkele van deze problemen aan te pakken.
Datastructuren verkennen
Er is wat standaardterminologie voor de onderdelen van een dataset die handig is om te kennen.
Tabulaire datasets bestaan uit rijen en kolommen. Meestal is elke rij één record en staat elke kolom voor een attribuut of variabele van dat record.
Elke datacel op het snijpunt van een rij en kolom bevat één waarde. Een index geeft elk record een uniek nummer. De header, ofwel de eerste rij van elke kolom, is doorgaans de naam van het attribuut of de kolom. In een relationele database kunnen individuele tabellen met relaties aan elkaar gekoppeld zijn.
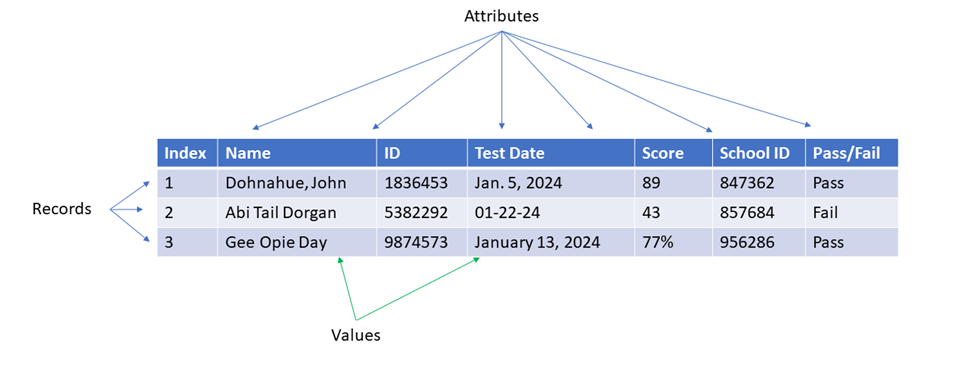
Als je een dataset voor het eerst binnenhaalt, is het belangrijk om die te bekijken en enkele van deze kernkenmerken te identificeren. Er zijn veel opties om je dataset te bekijken, waaronder laden in Python, SQL, R of Matlab en specifieke rijen laten weergeven.
Afhankelijk van het bestandstype en de -grootte kun je het misschien zelfs direct openen in Microsoft Excel of Google Spreadsheets en het daar bekijken. Houd er rekening mee dat als je dataset erg groot is, het in één keer laden veel geheugen kost, dus moet je het mogelijk in stukken bekijken.
Vaak is de volgende stap, nadat je een dataset voor je project hebt bemachtigd, veel schoonmaak- en voorbereidingswerk om de data in een bruikbaar formaat te krijgen. Een gecureerde dataset kiezen, zoals je op DataCamp vindt, beperkt de hoeveelheid schoonmaakwerk.
Toch zul je de dataset waarschijnlijk nog moeten aanpassen aan jouw behoeften. Dat geldt zeker als je data uit meerdere bronnen samenbrengt voor je project.
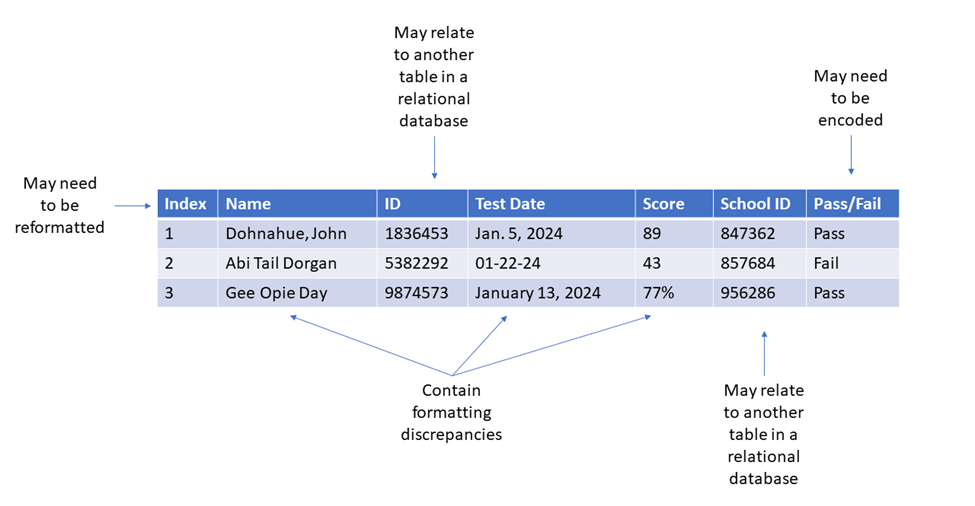
Bij het opschonen en voorbereiden van je datasets zijn dit enkele veelvoorkomende taken:
Bekijk deze cursussen voor meer informatie over data opschonen in Python of data opschonen in SQL Server-databases.
Exploratieve data-analyse helpt je je dataset echt te begrijpen, een cruciale stap voordat je in complexere analyses duikt. Veel beginnende dataprofessionals slaan deze stap over, met alle gevolgen van dien.
Ik raad je sterk aan om meerdere exploratieve analyses op je dataset uit te voeren voordat je aan modelleren, machine learning of andere complexere analyses begint.
Deze stap helpt je om eigenaardigheden, inconsistenties of problemen in je dataset op te sporen. Het stuurt je later richting een passende analyse en helpt je om afwijkende resultaten te detecteren en te corrigeren.
De exploratieve stap kan meerdere vormen aannemen, van beschrijvende statistiek tot eenvoudige visualisaties. Voor de meeste tabulaire datasets kunnen samenvattende statistieken, zoals het gemiddelde, de mediaan en de standaarddeviatie, samen met simpele spreidingsdiagrammen of staafdiagrammen je een inzichtelijke blik geven op de patronen en het gedrag van je data.
Ik moedig je aan de tijd te nemen om zoveel mogelijk variabelen in je dataset te plotten als redelijk is. Hoewel deze stap misschien niet in het uiteindelijke dashboard, rapport of de applicatie belandt die je als eindpunt van je project voor ogen hebt, helpt het je wel in je proces. Leer meer over exploratieve data-analyse in Python of exploratieve data-analyse in R.
Het einddoel van elk dataproject is om je bevindingen te presenteren aan geïnteresseerden. Of je publiek nu een zakelijke stakeholder, een potentiële werkgever of een datacollega is, het is belangrijk dat je inzichten duidelijk en eenvoudig te interpreteren zijn.
Soms is een eenvoudige grafiek met een beschrijvende titel al genoeg. In andere gevallen heb je een uitgebreider dashboard nodig. Wat je ook kiest, zorg ervoor dat je interpretatie trouw blijft aan je dataset.
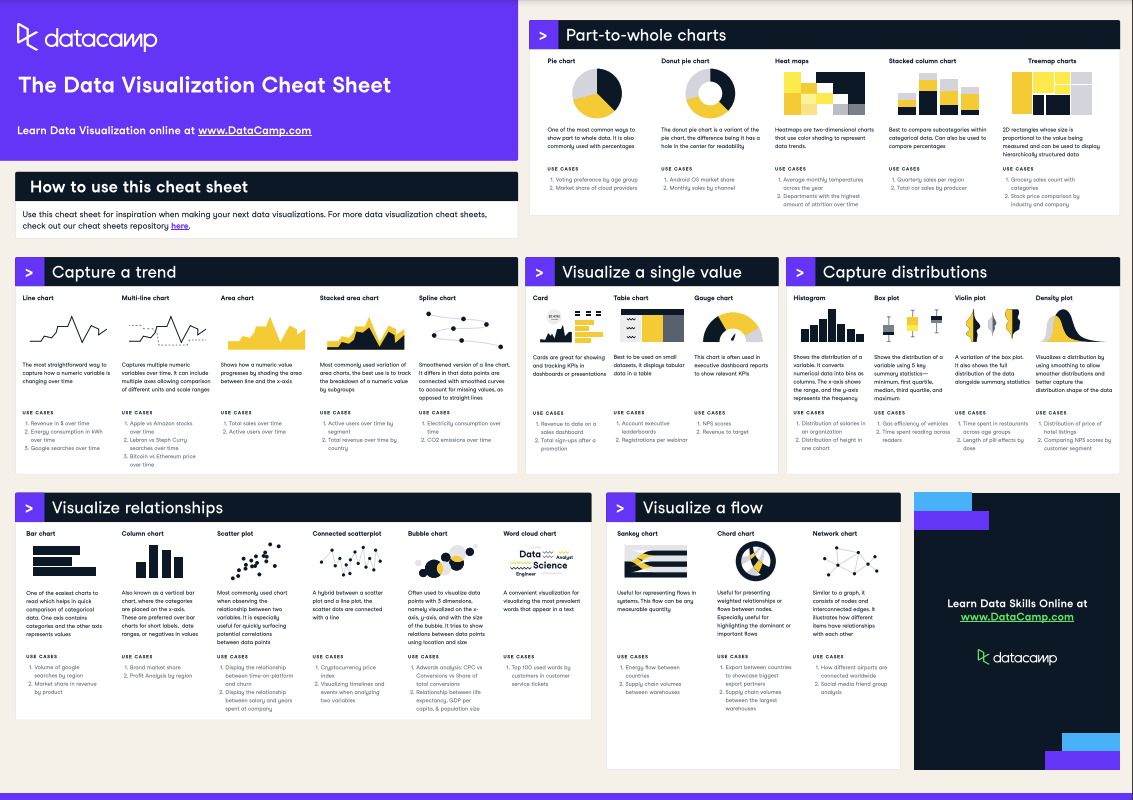
Ons spiekbriefje voor datavisualisatie helpt je de beste manier te kiezen om je datasets te presenteren.
Het doel moet zijn om je publiek eerlijk over te brengen wat de dataset vertegenwoordigt en hoe die je vragen beantwoordt. Bekijk de skill track data storytelling om deze essentiële datavaardigheid onder de knie te krijgen.
DataCamp is een geweldig podium om je dataportfolio te presenteren. Andere populaire opties om een dataportfolio te hosten zijn een GitHub-repository of een professionele webpagina. Waar je je project ook host, zorg ervoor dat het gemakkelijk toegankelijk is voor je beoogde publiek.
Informatie staat centraal in data science. Datasets bundelen informatie op één plek, waardoor je trends kunt ontdekken, voorspellingen kunt doen en de mensheid vooruit kunt helpen. Datasets vinden om te analyseren kan in het begin overweldigend lijken. Maar weten waar je kunt beginnen met zoeken, maakt een wereld van verschil. Bekijk de selectie van interessante datasets van DataCamp en laat je inspireren!
Begin vandaag nog aan je datareis!
Leerpad
Leerpad
Cursus
blog
Adel Nehme
15 min

