

गड़बड़ संख्याओं की समस्याएँ और उनसे निपटना
अब देखते हैं वे सामान्य समस्याएँ जो आपको गड़बड़ डेटा (ऊपर बताए गए प्रकारों के संदर्भ में) साफ किए बिना सामना करनी पड़ सकती हैं।
1. डेटा एग्रीगेशन
मान लीजिए किसी संख्यात्मक कॉलम में null प्रविष्टियाँ हैं और आप उस कॉलम पर सार-सांख्यिकी (जैसे औसत, अधिकतम, न्यूनतम) निकाल रहे हैं। इस स्थिति में परिणाम सटीक रूप से व्यक्त नहीं होंगे। फिर से Pima Indian Diabetes डेटासेट को लें जिसमें अवैध शून्य प्रविष्टियाँ हैं। यदि आप पहले बताए गए कॉलमों पर सार-सांख्यिकी निकालें, तो क्या आपको सही परिणाम मिलेंगे? क्या परिणाम त्रुटिपूर्ण नहीं होंगे? तो, इसे कैसे संबोधित करें? कई तरीके हैं:
- Removing the entries containing missing/null values (not recommended)
- Imputing the null entries with a numeric value (typically with mean or median of the respective column)अब इन समस्याओं और null मानों से निपटने के दूसरे विकल्प पर हाथों-हाथ अभ्यास करते हैं।
निम्न PostgreSQL टेबल entries पर विचार करें:
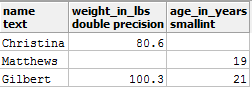
आप ऊपर की तालिका में दो null प्रविष्टियाँ देख सकते हैं। मान लीजिए आप इस टेबल से औसत वज़न निकालना चाहते हैं और आपने यह क्वेरी चलाई:
select avg(weight_in_lbs) as average_weight_in_lbs from entries;
आउटपुट 90.45 मिला। क्या यह सही है? तो, क्या किया जा सकता है? आइए COALESCE() फ़ंक्शन की मदद से इस औसत मान से null प्रविष्टियों को भरते हैं।
पहले COALESCE() से मिसिंग मान भरते हैं (ध्यान रखें कि COALESCE() मूल टेबल के मान नहीं बदलता, यह बदले हुए मानों के साथ केवल एक अस्थायी व्यू लौटाता है):
select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries;
आपको ऐसा आउटपुट मिलना चाहिए:
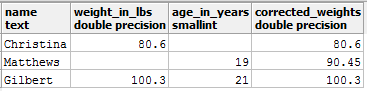
अब आप फिर से AVG() लगा सकते हैं:
select avg(corrected_weights) from
(select *, COALESCE(weight_in_lbs, 90.45) as corrected_weights from entries) as subquery;
यह पहले की तुलना में कहीं अधिक सटीक परिणाम है। अब देखते हैं एक और समस्या जो कॉलम डेटा-टाइप मिसमैच होने पर हो सकती है।
2. टेबल जॉइन्स
मान लीजिए आप student_metadata और department_details नाम की निम्न तालिकाओं पर काम कर रहे हैं:
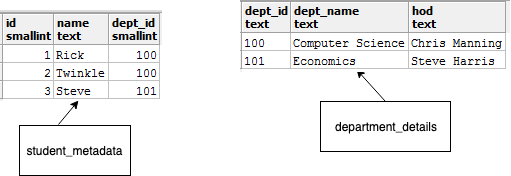
आप देखते हैं कि student_mtadata टेबल में dept_id integer टाइप का है, जबकि department_details टेबल में यह text टाइप में है। अब मान लें, आप इन दोनों टेबल को जोड़कर ऐसा रिपोर्ट बनाना चाहते हैं जिसमें ये कॉलम हों:
- id
- name
- dept_name
इसके लिए आप यह क्वेरी चलाते हैं:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = d.dept_id;
तब आपको यह त्रुटि मिलेगी:
ERROR: operator does not exist: smallint = text
यह एक शानदार इन्फोग्राफिक है जो इस समस्या को दर्शाता है (DataCamp के Reporting in SQL कोर्स से):
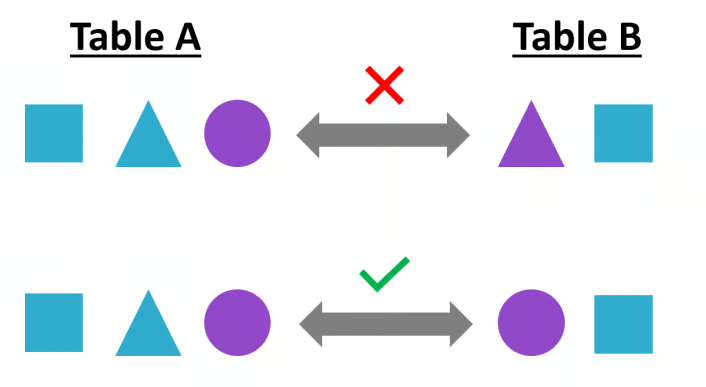
यह इसलिए हो रहा है क्योंकि दोनों टेबल को जोड़ते समय डेटा-टाइप मेल नहीं खा रहे हैं। यहाँ आप department_details टेबल के dept_id कॉलम को टेबल जॉइन करते समय integer में CAST कर सकते हैं। ऐसे करें:
select id, name, dept_name from
student_metadata s join department_details d
on s.dept_id = cast(d.dept_id as smallint);
और आपको मनचाहा रिपोर्ट मिल जाएगा:
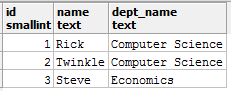
अब देखते हैं कि स्ट्रिंग्स किस तरह गड़बड़ रूप में हो सकती हैं, उनकी समस्याएँ क्या हैं और उनसे कैसे निपटें।
गड़बड़ स्ट्रिंग्स और उनकी सफाई
स्ट्रिंग मान भी बहुत सामान्य हैं। इस सेक्शन की शुरुआत करते हैं student_details नामक तालिका से लिए गए dept_name (विभाग नाम) कॉलम के मान देखकर:
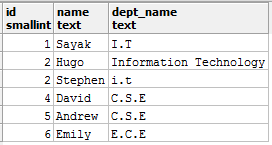
ऊपर जैसे स्ट्रिंग मान कई अप्रत्याशित समस्याएँ पैदा कर सकते हैं। I.T, Information Technology, और i.t सभी का मतलब एक ही विभाग है, यानी Information Technology—और मान लें विनिर्देशन दस्तावेज़ के अनुसार मान केवल I.T के रूप में होने चाहिए। अब, मान लें आप I.T. विभाग के विद्यार्थियों की संख्या गिनना चाहते हैं और यह क्वेरी चलाते हैं:
select dept_name, count(dept_name) as student_count
from student_details
group by dept_name;
और आपको यह मिलता है:
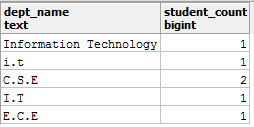
क्या यह सटीक रिपोर्ट है?—नहीं! तो, इसे कैसे संबोधित करें?
पहले समस्या को थोड़ी विस्तार से पहचानते हैं:
- आपके पास
Information Technologyएक मान है जिसेI.Tमें बदला जाना चाहिए और - आपके पास
i.tदूसरा मान है जिसेI.Tमें बदला जाना चाहिए।
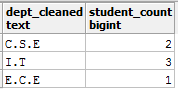
पहले मामले में आप Information Technology मान को I.T से REPLACE कर सकते हैं, और दूसरे मामले में, अक्षरों को UPPER केस में बदल सकते हैं। आप इसे एक ही क्वेरी में कर सकते हैं, हालांकि ऐसी समस्याओं को चरणबद्ध ढंग से हल करना बेहतर माना जाता है। समस्या को सुलझाने के लिए क्वेरी यह है:
select upper(replace(dept_name, 'Information Technology', 'I.T')) as dept_cleaned,
count(dept_name) as student_count
from student_details
group by dept_cleaned;
और रिपोर्ट:
PostgreSQL की स्ट्रिंग फ़ंक्शन्स के बारे में और पढ़ें यहाँ।
अब देखते हैं कुछ उदाहरण जहाँ date मान गड़बड़ हो सकते हैं और आप उन्हें कैसे साफ कर सकते हैं।
गड़बड़ तारीखें और उनकी सफाई
मान लीजिए आप employees नाम की तालिका पर काम कर रहे हैं जिसमें birthdate नाम का एक कॉलम है, लेकिन वह उपयुक्त date टाइप में नहीं है। अब, आप DATE समर्पित फ़ंक्शन्स जैसे DATE_PART() के साथ क्वेरी चलाना चाहते हैं। जब तक आप birthdate कॉलम को date टाइप में CAST नहीं करते, आप ऐसा नहीं कर पाएँगे। इसे क्रिया में देखते हैं।
मान लें कि birthdate का फ़ॉर्मैट YYYY-MM-DD है।
employees टेबल इस प्रकार दिखती है:
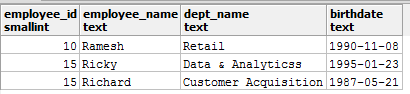
अब आप जन्मतिथियों से महीने निकालने के लिए निम्न क्वेरी चलाते हैं:
select date_part('month', birthdate) from employees;
और आपको तुरंत यह त्रुटि मिलती है:
ERROR: function date_part(unknown, text) does not exist
त्रुटि के साथ, आपको एक अच्छा संकेत भी मिलता है:
HINT: No function matches the given name and argument types. You might need to add explicit type casts.
संकेत का पालन करते हैं और birthdate को उपयुक्त date टाइप में CAST करके फिर DATE_PART() लगाते हैं:
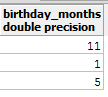
select date_part('month', CAST(birthdate AS date)) as birthday_months from employees;
आपको यह परिणाम मिलना चाहिए:
अब इस ट्यूटोरियल के पूर्व-समापन खंड की ओर बढ़ते हैं, जहाँ आप डेटा डुप्लीकेशन के प्रभाव और उनसे कैसे निपटें, यह देखेंगे।
डेटा डुप्लीकेशन: कारण, प्रभाव, और समाधान
इस खंड में, आप डेटा डुप्लीकेशन के कुछ सामान्य कारणों का अध्ययन करेंगे। आप उनके प्रभाव और उन्हें रोकने के कुछ तरीके भी देखेंगे। निम्न दो तालिकाओं band_details और some_festival_record पर विचार करें:
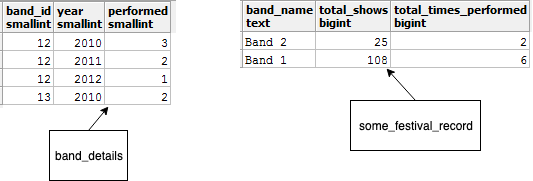
band_details तालिका संगीत बैंड्स के बारे में जानकारी देती है—इसमें उनके आइडेंटिफ़ायर, नाम और उन्होंने दिए कुल शो की संख्या है। दूसरी ओर, some_festival_record तालिका एक काल्पनिक म्यूज़िक फेस्टिवल को दर्शाती है और वहाँ प्रदर्शन करने वाले बैंड्स के रिकॉर्ड रखती है।
अब मान लें कि आप ऐसा रिपोर्ट बनाना चाहते हैं जिसमें बैंड के नाम, उनके शो काउंट, और फेस्टिवल में प्रदर्शन करने की कुल बार की संख्या शामिल हो। यहाँ INNER जॉइन की ज़रूरत है। आप यह क्वेरी चलाते हैं:
select band_name, sum(total_show_count) as total_shows, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name;
और क्वेरी यह उत्पाद देती है:
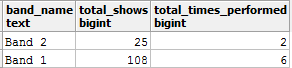
क्या आपको नहीं लगता कि यहाँ total_shows के मान त्रुटिपूर्ण हैं? क्योंकि band_details तालिका से आपको पता है कि Band_1 ने कुल 36 शो दिए हैं। फिर यहाँ क्या गड़बड़ हुई? डुप्लीकेट्स!
दोनों तालिकाओं को जोड़ते समय, आपने गलती से total_show_count कॉलम को एग्रीगेट कर दिया, जिससे मध्यवर्ती जॉइन परिणामों में डेटा डुप्लीकेशन हो गया। यदि आप एग्रीगेशन हटा दें और क्वेरी को तदनुसार संशोधित करें, तो आपको इच्छित परिणाम मिलेंगे:
select band_name, total_show_count, sum(performed) as total_times_performed
from band_details b join some_festival_record s
on b.id = s.band_id
group by band_name, total_show_count;
अब आपको अपेक्षित परिणाम मिलते हैं:
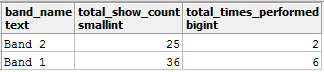
डेटा डुप्लीकेशन रोकने का एक और तरीका है—अपने JOIN क्लॉज़ में एक और फ़ील्ड जोड़ें ताकि टेबल सख्त शर्तों पर जुड़ें।
आप इन तालिकाओं और दिखाए गए मानों को जनरेट करने के लिए यह .SQL फ़ाइल उपयोग कर सकते हैं।
आगे बढ़ना
इस ट्यूटोरियल को पढ़ने के लिए धन्यवाद। इस ट्यूटोरियल ने आपको डेटा विश्लेषण पाइपलाइन के सबसे महत्वपूर्ण चरणों में से एक—डेटा सफाई—से परिचित कराया। आपने गड़बड़ डेटा के अलग-अलग रूप देखे और उनसे निपटने के तरीके सीखे। हालाँकि, अधिक जटिल डेटा-सफाई समस्याओं से निपटने के लिए और भी उन्नत तकनीकें हैं, और यदि आप उस दिशा में आगे बढ़ना चाहते हैं, तो निम्न कुछ उत्कृष्ट DataCamp कोर्स हैं जिन्हें आप ले सकते हैं:
अपने विचार Comments सेक्शन में बेझिझक साझा करें।
वास्तविक दुनिया का डेटा लगभग हमेशा बिखरा हुआ होता है। एक डेटा साइंटिस्ट, डेटा विश्लेषक या डेवलपर के रूप में, यदि आपको डेटा के बारे में तथ्य खोजने हैं, तो यह सुनिश्चित करना जरूरी है कि डेटा इतना सुव्यवस्थित हो कि उस पर काम किया जा सके। दरअसल, टाइडी डेटा की एक सुव्यवस्थित परिभाषा है, और आप इसके बारे में अधिक संसाधन इस विकी पेज पर देख सकते हैं।
इस ट्यूटोरियल में, आप SQL में सबसे सामान्य डेटा-सफाई तकनीकों का अभ्यास करेंगे। आप अपना खुद का डमी डेटासेट बनाएंगे, लेकिन ये तकनीकें वास्तविक (सारणीबद्ध) डेटा पर भी लागू होती हैं। बहुत कुछ कवर करना है। शुरू करते हैं!
ध्यान दें कि आपको पहले से PostgreSQL (वह RDBMS जिसका उपयोग आप इस ट्यूटोरियल में करेंगे) में बेसिक SQL क्वेरी लिखना आना चाहिए। यदि आपको अवधारणाएँ दोहरानी हैं, तो निम्न संसाधन उपयोगी हो सकते हैं:
विभिन्न डेटा टाइप, उनकी गड़बड़ मान, और समाधान
सारणीबद्ध डेटा में सबसे सामान्य डेटा टाइप हैं
string,numericयाdate-time। इन सभी टाइप में आपको गड़बड़ मान मिल सकते हैं। अब हम प्रत्येक टाइप को लेते हैं और उनके गड़बड़ मानों के उदाहरण देखते हैं। शुरुआत करते हैंnumericटाइप से।गड़बड़ संख्याएँ
संख्याएँ कई तरीकों से गड़बड़ रूप में हो सकती हैं। यहाँ आप सबसे सामान्य समस्याओं से परिचित होंगे:
अनचाहा टाइप/टाइप मिसमैच: मान लीजिए जिस डेटासेट पर आप काम कर रहे हैं उसमें
ageनाम का एक कॉलम है। आप देखते हैं कि उस कॉलम में मौजूद मानfloatटाइप के हैं—जैसे 23.0, 45.0, 34.0 इत्यादि। इस स्थिति में, आपकोageकॉलम काfloatटाइप होना नहीं चाहिए। है न?Null मान: यह ऊपर बताए गए सभी डेटा टाइप के साथ आम है, यहाँ null मान का मतलब मात्र यह है कि मान उपलब्ध नहीं हैं/खाली हैं। हालांकि, null मान अन्य रूपों में भी उपस्थित हो सकते हैं। उदाहरण के लिए Pima Indian Diabetes डेटासेट लें। इस डेटासेट में
Plasma glucose concentration,Diastolic blood pressureजैसे कॉलम के लिए शून्य मान हैं, जो व्यावहारिक रूप से अवैध हैं। यदि आप इन अवैध प्रविष्टियों का ध्यान रखे बिना डेटासेट पर कोई सांख्यिकीय विश्लेषण करते हैं, तो आपका विश्लेषण सटीक नहीं होगा।अब देखते हैं कि इन मुद्दों से कौन-सी समस्याएँ खड़ी होती हैं और उनसे कैसे निपटा जाए।