
Cursus
Analyste de données associé en SQL
39 h
Que vous souhaitiez enrichir votre portfolio avec un projet data ou que vous débutiez votre premier projet en tant que data scientist, votre première tâche sera de trouver un jeu de données adapté. Alors, qu’est-ce qu’un jeu de données et où le dénicher ?
Les données sont partout, mais trouver une source d’information fiable et accessible pour répondre aux questions précises que vous vous posez peut s’avérer bien plus difficile qu’il n’y paraît. Or, tout grand projet data commence par un bon jeu de données. Dans ce tutoriel, nous passerons en revue les types de jeux de données existants, comment les trouver et quoi en faire une fois entre vos mains.
Un jeu de données est tout simplement un ensemble d’informations. En général, ces informations sont organisées d’une certaine manière, même si cette organisation n’est pas forcément immédiatement utile à votre cas d’usage et nécessite un peu de travail de votre part pour être exploitable.
Plusieurs types de données peuvent être structurés de différentes façons. Parmi les jeux de données les plus courants :
D’autres jeux de données peuvent regrouper des images, des documents texte, ou encore des enregistrements audio ou vidéo.
Chercher des jeux de données fiables peut prendre du temps. Il en existe beaucoup en libre accès, mais d’autres sont payants, voire propriétaires.
L’accès aux données dont vous avez besoin pour démarrer votre projet peut être compliqué par des paywalls, des questions juridiques, des droits de propriété intellectuelle ou, dans certains cas, il se peut que les données exactes que vous recherchez n’existent tout simplement pas.
Dans ces cas, il faudra faire preuve de créativité avec les données disponibles, voire collecter vos propres données (ce qui peut constituer un projet à part entière). Consultez ce cours de web scraping avec Python, ce cours pour comprendre la data science, ou ce cours de data science pour le business pour des idées de collecte de données.
DataCamp propose une collection de jeux de données sélectionnés et faciles d’accès sur de nombreux sujets. C’est un excellent point de départ, surtout si vous ne savez pas par où commencer.
D’autres sources de qualité incluent les sites des gouvernements, des organisations à but non lucratif, des universités et des bibliothèques. Vous trouverez ci-dessous un tableau recensant plusieurs très bonnes ressources pour dénicher des jeux de données intéressants.
|
Source de jeux de données |
Lien web |
|
DataCamp |
https://www.datacamp.com/workspace/datasets |
|
Google Dataset Search |
https://datasetsearch.research.google.com/ |
|
Data.gov |
https://data.gov/ |
|
Datahub |
https://www.datahub.io/search |
|
UCI Machine Learning Repository |
https://archive.ics.uci.edu/ |
|
Kaggle |
https://www.kaggle.com/datasets |
|
Library of Congress |
https://guides.loc.gov/datasets |
|
US Census Bureau |
https://www.census.gov/data/datasets.html |
|
Federal Trade Commission |
https://www.ftc.gov/policy-notices/open-government/data-sets |
|
World Health Organization |
https://www.who.int/data/sets |
|
Centers for Disease Control and Prevention |
https://open.cdc.gov/data.html |
|
National Institutes for Health |
https://www.ncbi.nlm.nih.gov/datasets/ |
Une étape essentielle dans le choix d’une source de données consiste à évaluer sa qualité et sa fiabilité. Avant tout, vérifiez le sérieux de la source. Chacun des jeux de données de DataCamp renvoie vers la source d’origine, ce qui vous permet d’en vérifier facilement l’authenticité.
Pour d’autres sources, il faudra parfois creuser davantage afin de garantir la fiabilité des données. Parmi les critères à considérer : la méthode de collecte, les populations représentées et les biais éventuels introduits lors de la collecte.
Un autre point à prendre en compte est l’ampleur du nettoyage et de la préparation nécessaires pour rendre les données exploitables. Choisir un jeu de données plus « curaté » peut vous faire gagner du temps. Mais il est souvent inévitable de travailler avec des données plus « brutes » qui exigent des efforts importants pour homogénéiser les formats, traiter les valeurs manquantes et supprimer les doublons.
Ce tutoriel de nettoyage des données vous aidera à traiter certains de ces problèmes.
Explorer la structure des jeux de données
Une terminologie standard décrit les différentes parties d’un jeu de données : il est utile de la connaître.
Les jeux de données tabulaires sont composés de lignes et de colonnes. En général, chaque ligne correspond à un enregistrement et chaque colonne représente un attribut ou une variable de cet enregistrement.
Chaque cellule, à l’intersection d’une ligne et d’une colonne, contient une valeur. Un index attribue un numéro unique à chaque enregistrement. L’en-tête, ou première ligne de chaque colonne, indique généralement le nom de l’attribut ou de la colonne. Dans une base de données relationnelle, des relations peuvent relier les tables entre elles.
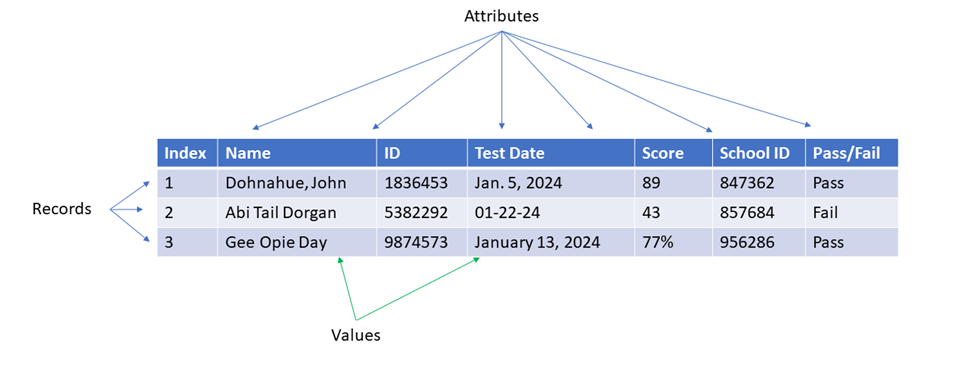
Lorsque vous obtenez un jeu de données, prenez le temps de l’examiner et d’en identifier les caractéristiques clés. Vous pouvez visualiser vos données de multiples façons, notamment en les chargeant dans Python, SQL, R ou Matlab, puis en affichant des lignes ciblées.
Selon le type et la taille du fichier, vous pourrez même l’ouvrir directement dans Microsoft Excel ou Google Sheets. Gardez à l’esprit que si votre jeu de données est volumineux, le charger en une fois consommera beaucoup de mémoire : privilégiez alors un affichage par lots.
Souvent, une fois le jeu de données en main, l’étape suivante consiste à le nettoyer et à le préparer pour le rendre exploitable. Opter pour un jeu de données sélectionné, comme ceux proposés par DataCamp, limite la charge de nettoyage.
Toutefois, vous devrez probablement encore l’adapter à vos besoins, en particulier si vous combinez des données issues de plusieurs sources.
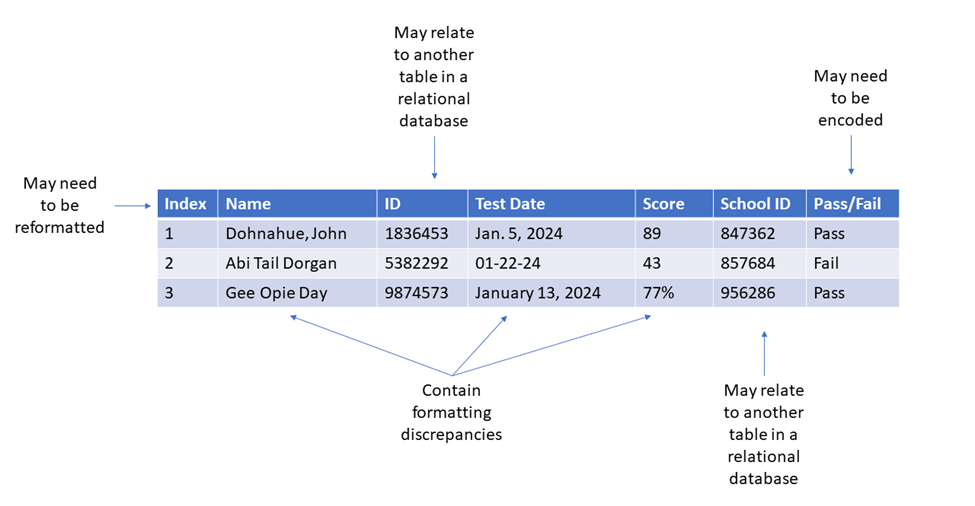
Lors du nettoyage et de la préparation, les tâches courantes incluent :
Consultez ces cours pour en savoir plus sur le nettoyage des données en Python ou le nettoyage des données dans les bases SQL Server.
L’analyse exploratoire vous aide à vraiment comprendre votre jeu de données : une étape cruciale avant toute analyse avancée. Beaucoup de juniors la négligent à leurs dépens.
Nous vous recommandons vivement de réaliser plusieurs analyses exploratoires avant de vous lancer dans la modélisation, l’apprentissage automatique ou toute autre approche plus complexe.
Cette étape vous permettra de repérer les anomalies, incohérences ou problèmes potentiels. Elle guidera également le choix d’une analyse pertinente et vous aidera à détecter puis corriger des résultats aberrants.
L’exploration doit prendre plusieurs formes, des statistiques descriptives aux visualisations simples. Pour la plupart des jeux tabulaires, des statistiques de synthèse comme la moyenne, la médiane et l’écart-type, associées à quelques nuages de points ou histogrammes/diagrammes en barres, offrent un aperçu éclairant des tendances et comportements de vos données.
Prenez le temps de représenter autant de variables qu’il est raisonnable de le faire. Même si ces visualisations ne figurent pas dans le tableau de bord, le rapport ou l’application finale, elles guideront votre démarche. Pour aller plus loin : analyse exploratoire des données en Python ou analyse exploratoire des données en R.
La finalité de tout projet data est de présenter vos résultats aux parties prenantes. Qu’il s’agisse d’un décideur métier, d’un employeur potentiel ou d’un pair, vos insights doivent être clairs et faciles à interpréter.
Parfois, un simple graphique avec un titre explicite suffit. D’autres fois, un tableau de bord plus élaboré s’impose. Quel que soit votre choix, veillez à ce que votre interprétation reste fidèle au jeu de données.
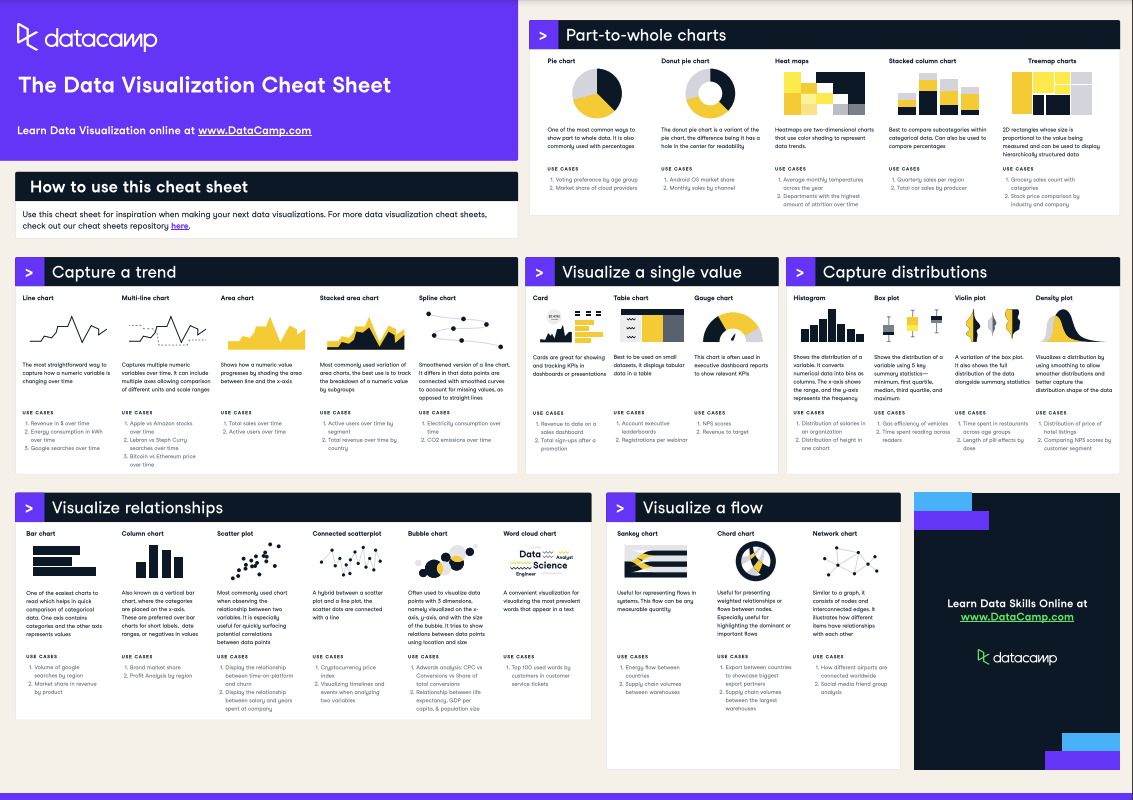
Notre aide-mémoire de visualisation des données vous aide à choisir la meilleure façon de mettre en scène vos jeux de données.
L’objectif est de transmettre honnêtement à votre audience ce que représente le jeu de données et comment il répond à vos questions. Consultez le parcours de compétences data storytelling pour maîtriser cette compétence essentielle.
DataCamp est un excellent endroit pour mettre en valeur votre portfolio data. Autres options prisées : un référentiel GitHub ou un site professionnel. Où que vous l’hébergiez, assurez-vous que votre projet soit facilement accessible à votre audience cible.
L’information est au cœur de la data science. Les jeux de données rassemblent l’information en un seul endroit, rendant possible l’identification de tendances, la réalisation de prédictions et, in fine, le progrès. Trouver des jeux de données à analyser peut sembler intimidant au départ. Mais connaître quelques bons points de départ change tout. Parcourez la sélection de jeux de données intéressants de DataCamp et laissez-vous inspirer !
Commencez votre aventure data dès aujourd’hui !
Cursus
Cursus
Cours