
Lernpfad
Assoziierter Datenanalyst in SQL
39 Std.
Egal, ob du ein Datenprojekt für dein Portfolio planst oder deinen ersten Auftrag als bezahlte:r Data Scientist beginnst: Als Erstes brauchst du einen geeigneten Datensatz. Doch was genau ist ein Datensatz – und wo findest du ihn?
Daten gibt es überall, aber eine seriöse, leicht zugängliche Quelle für genau die Fragen zu finden, die du beantworten willst, ist oft schwieriger als gedacht. Jedes starke Datenprojekt startet jedoch mit einem guten Datensatz. In diesem Tutorial schauen wir uns kurz an, welche Arten von Datensätzen es gibt, wie du sie findest und was du damit machst, sobald du sie hast.
Ein Datensatz ist schlicht eine Sammlung von Informationen. In der Regel sind diese Informationen in irgendeiner Form organisiert. Allerdings ist die Struktur nicht immer direkt für deinen Kontext hilfreich – dann ist etwas Vorarbeit nötig, um sie nutzbar zu machen.
Es gibt verschiedene Datentypen, die unterschiedlich organisiert sein können. Häufige Arten von Datensätzen sind:
Andere Datensätze können Sammlungen von Bildern, Textdokumenten oder Audio- bzw. Videoaufnahmen enthalten.
Nach zuverlässigen Datensätzen zu suchen, kann viel Zeit kosten. Es gibt viele frei verfügbare Datensätze, andere sind kostenpflichtig oder sogar proprietär.
Paywalls, rechtliche Fragen, IP-Rechte oder schlicht die Tatsache, dass genau die benötigten Daten noch gar nicht existieren, können die Suche zusätzlich erschweren.
In solchen Fällen brauchst du Kreativität: Entweder holst du aus verfügbaren Daten das Beste heraus oder du erhebst eigene Daten (was schnell selbst zum Projekt wird). Schau dir dazu diesen Kurs zu Web Scraping mit Python, diesen Kurs zum Verständnis von Data Science oder diesen Kurs zu Data Science für Business an, um Ideen für die Datenerhebung zu bekommen.
DataCamp stellt eine leicht zugängliche Sammlung kuratierter Datensätze zu verschiedensten Themen bereit. Das ist ein guter Startpunkt, besonders wenn du noch nicht weißt, wo du beginnen sollst.
Weitere gute Anlaufstellen sind Regierungswebsites, Websites von Non-Profit-Organisationen, Universitäten und Bibliotheken. Unten findest du eine Tabelle mit hilfreichen Quellen für interessante Datensätze.
|
Quelle für Datensätze |
Weblink |
|
DataCamp |
https://www.datacamp.com/workspace/datasets |
|
Google Dataset Search |
https://datasetsearch.research.google.com/ |
|
Data.gov |
https://data.gov/ |
|
Datahub |
https://www.datahub.io/search |
|
UCI Machine Learning Repository |
https://archive.ics.uci.edu/ |
|
Kaggle |
https://www.kaggle.com/datasets |
|
Library of Congress |
https://guides.loc.gov/datasets |
|
US Census Bureau |
https://www.census.gov/data/datasets.html |
|
Federal Trade Commission |
https://www.ftc.gov/policy-notices/open-government/data-sets |
|
World Health Organization |
https://www.who.int/data/sets |
|
Centers for Disease Control and Prevention |
https://open.cdc.gov/data.html |
|
National Institutes for Health |
https://www.ncbi.nlm.nih.gov/datasets/ |
Ein entscheidender Schritt bei der Wahl einer Datenquelle ist die Prüfung von Qualität und Zuverlässigkeit. Vor allem solltest du sicherstellen, dass die Quelle seriös ist. Jeder DataCamp-Datensatz verlinkt auf das Ursprungsmaterial, sodass du die Echtheit leicht prüfen kannst.
Bei anderen Quellen ist oft etwas mehr Recherche notwendig, um die Verlässlichkeit zu beurteilen. Wichtige Kriterien sind, wie die Daten erhoben wurden, welche Populationen vertreten sind und ob es Verzerrungen im Erhebungsprozess gab.
Ebenfalls wichtig: Wie viel Bereinigung und Aufbereitung ist nötig, um die Daten in ein nutzbares Format zu bringen? Ein kuratierter Datensatz kann viel Zeit sparen. Oft kommst du aber um „unordentliche“ Daten nicht herum – dann musst du Formate vereinheitlichen, fehlende Werte behandeln und Duplikate entfernen.
Dieses Tutorial zur Datenbereinigung hilft dir, solche Aufgaben zu meistern.
Strukturen von Datensätzen erkunden
Es gibt einige gängige Begriffe für Bestandteile eines Datensatzes, die du kennen solltest.
Tabellarische Datensätze bestehen aus Zeilen und Spalten. In der Regel entspricht jede Zeile einem Datensatz, jede Spalte einem Attribut bzw. einer Variable dieses Datensatzes.
Jede Datenzelle am Schnittpunkt von Zeile und Spalte enthält genau einen Wert. Ein Index gibt jedem Datensatz eine eindeutige Nummer. Der Header, also die erste Zeile einer Spalte, enthält normalerweise den Namen des Attributs bzw. der Spalte. In einer relationalen Datenbank können einzelne Tabellen über Relationen verknüpft sein.
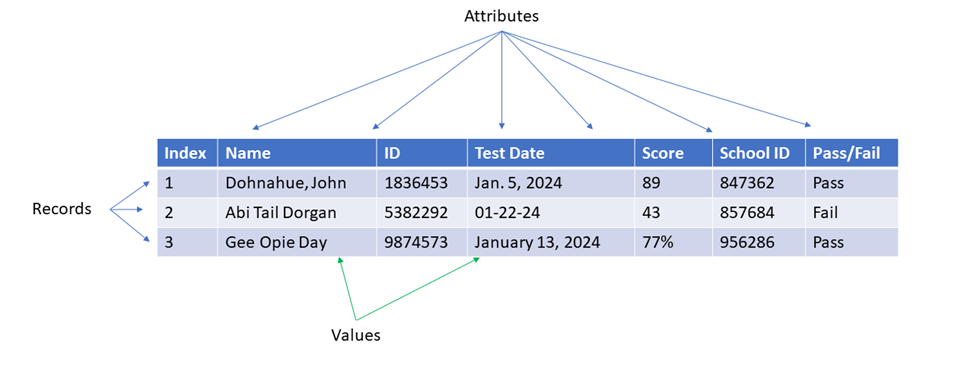
Wenn du einen Datensatz zum ersten Mal öffnest, solltest du ihn untersuchen und diese Schlüsseleigenschaften identifizieren. Es gibt viele Möglichkeiten, dir den Datensatz anzuschauen, zum Beispiel indem du ihn in Python, SQL, R oder Matlab lädst und gezielt Zeilen anzeigen lässt.
Je nach Dateityp und -größe kannst du ihn auch direkt in Microsoft Excel oder Google Sheets öffnen. Beachte: Sehr große Datensätze brauchen viel Speicher, wenn du sie komplett lädst – arbeite dann lieber in Teilstücken.
Nach der Beschaffung eines Datensatzes folgt meist viel Bereinigung und Vorbereitung, um ihn in ein nutzbares Format zu bringen. Kuratierte Datensätze, wie du sie bei DataCamp findest, reduzieren den Aufwand.
Trotzdem wirst du den Datensatz häufig an deine Bedürfnisse anpassen müssen – besonders, wenn du Daten aus mehreren Quellen kombinierst.
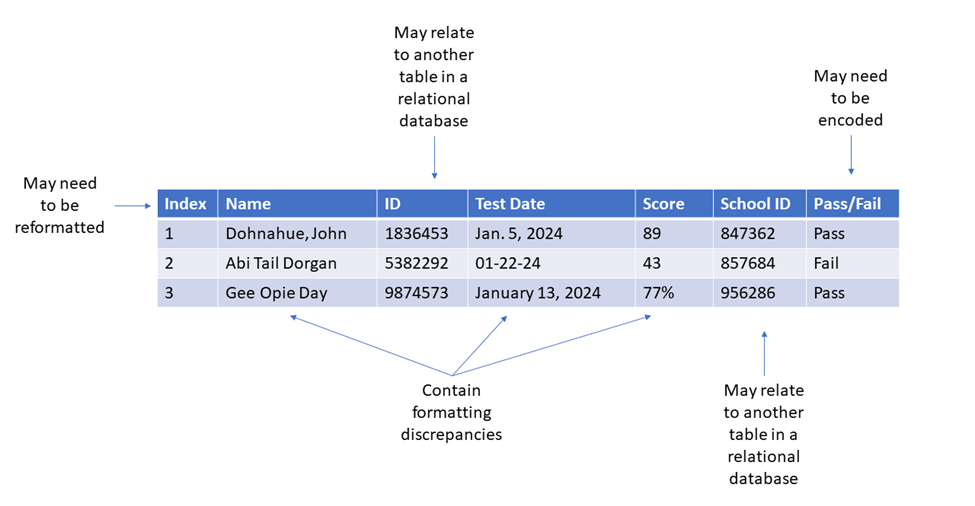
Typische Aufgaben bei der Bereinigung und Vorbereitung sind:
Mehr dazu findest du in den Kursen Datenbereinigung in Python und Datenbereinigung in SQL Server-Datenbanken.
Explorative Datenanalyse hilft dir, deinen Datensatz wirklich zu verstehen – ein unverzichtbarer Schritt, bevor du dich in komplexere Analysen stürst. Viele Junior-Data-Profis überspringen ihn und bereuen es später.
Ich rate dir dringend, mehrere explorative Analysen durchzuführen, bevor du mit Modellierung, Machine Learning oder anderen komplexen Verfahren startest.
So entdeckst du Auffälligkeiten, Inkonsistenzen oder Probleme im Datensatz. Außerdem findest du dadurch später leichter die passende Analysemethode und erkennst sowie korrigierst anomale Ergebnisse.
Die Exploration sollte verschiedene Formen annehmen – von deskriptiven Statistiken bis zu einfachen Visualisierungen. Bei tabellarischen Datensätzen liefern Kennzahlen wie Mittelwert, Median und Standardabweichung sowie einfache Scatterplots oder Balkendiagramme wertvolle Einblicke in Muster und Verhalten deiner Daten.
Ich ermutige dich, so viele Variablen wie sinnvoll zu visualisieren. Auch wenn diese Schritte nicht im finalen Dashboard, Bericht oder der Anwendung landen, führen sie dich sicher durch den Prozess. Lerne mehr über explorative Datenanalyse in Python oder in R.
Am Ende jedes Datenprojekts steht die Präsentation deiner Ergebnisse. Ob geschäftliche Stakeholder, potenzielle Arbeitgeber:innen oder Data-Kolleg:innen – deine Insights müssen klar und leicht verständlich sein.
Manchmal reicht ein einfaches Diagramm mit aussagekräftigem Titel. In anderen Fällen braucht es ein umfangreicheres Dashboard. Wichtig ist, dass deine Interpretation zum Datensatz passt.
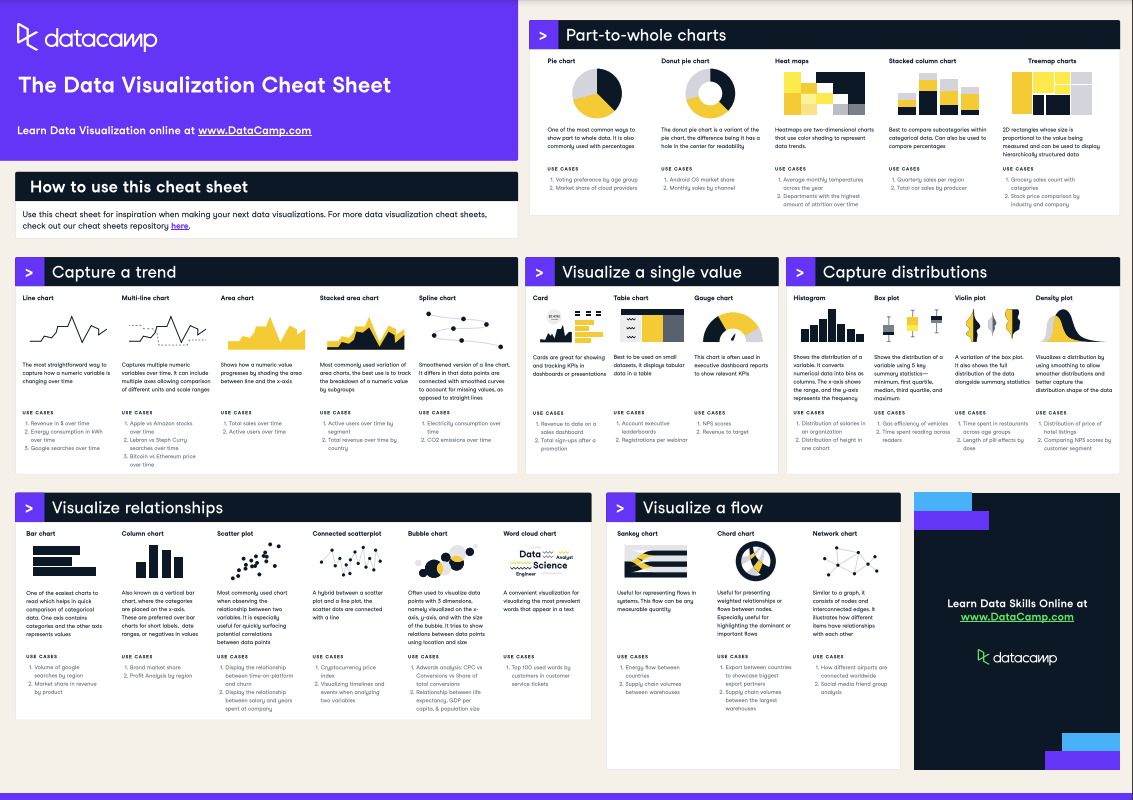
Unser Spickzettel zur Datenvisualisierung hilft dir, die passende Darstellung für deine Datensätze zu wählen.
Ziel ist es, deinem Publikum ehrlich zu vermitteln, was der Datensatz abbildet und wie er deine Fragen beantwortet. Im Skill-Lernpfad Data Storytelling meisterst du diese Kernkompetenz.
DataCamp ist ein idealer Ort, um dein Datenportfolio zu präsentieren. Weitere beliebte Optionen sind ein GitHub-Repository oder eine professionelle Website. Wo auch immer du dein Projekt hostest – sorge dafür, dass deine Zielgruppe es leicht findet.
Information ist der Kern von Data Science. Datensätze bündeln Informationen an einem Ort und machen es möglich, Trends zu erkennen, Vorhersagen zu treffen und Fortschritt zu gestalten. Die Suche nach Datensätzen kann anfangs einschüchternd wirken. Aber mit ein paar guten Startpunkten wird es deutlich einfacher. Stöbere in DataCamps Auswahl an interessanten Datensätzen und lass dich inspirieren!
Starte heute deine Data Journey!
Lernpfad
Lernpfad
Kurs
Blog
Nathaniel Taylor-Leach
4 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Javier Canales Luna
11 Min.
Tutorial
Sejal Jaiswal
9 Min.







