
Lộ trình
Chuyên viên phân tích dữ liệu trong SQL
39 giờ
Dù bạn đang thêm một dự án dữ liệu vào danh mục của mình hay bắt đầu dự án đầu tiên với vai trò nhà khoa học dữ liệu được trả lương, nhiệm vụ đầu tiên của bạn sẽ là tìm một bộ dữ liệu phù hợp. Vậy bộ dữ liệu là gì và bạn tìm chúng ở đâu?
Dữ liệu ở khắp mọi nơi, nhưng việc tìm một nguồn thông tin uy tín, dễ tiếp cận để trả lời những câu hỏi cụ thể mà bạn đang quan tâm có thể khó hơn tưởng tượng. Tuy vậy, mọi dự án dữ liệu tuyệt vời đều bắt đầu bằng việc tìm được một bộ dữ liệu tốt. Trong hướng dẫn này, chúng ta sẽ điểm qua ngắn gọn các loại bộ dữ liệu hiện có, cách tìm chúng và nên làm gì sau khi có được.
Bộ dữ liệu đơn giản là một tập hợp thông tin. Thông thường, thông tin này được tổ chức theo một cách nào đó, dù có thể bạn sẽ thấy nó không được sắp xếp theo cách hữu ích ngay cho ngữ cảnh của bạn và sẽ cần bạn xử lý đôi chút để có thể sử dụng.
Có nhiều loại dữ liệu có thể được tổ chức theo những cách khác nhau. Các loại bộ dữ liệu phổ biến bao gồm:
Các bộ dữ liệu khác có thể là tập hợp hình ảnh, tài liệu văn bản hoặc bản ghi âm thanh hay video.
Tìm kiếm các bộ dữ liệu đáng tin cậy để làm việc có thể tốn nhiều thời gian. Có rất nhiều bộ dữ liệu miễn phí, mặc dù cũng có nhiều bộ dữ liệu trả phí hoặc thậm chí là độc quyền.
Việc tìm dữ liệu bạn cần để bắt đầu dự án có thể phức tạp bởi tường phí, vấn đề pháp lý, quyền sở hữu trí tuệ, hoặc trong một số trường hợp, chính xác dữ liệu bạn muốn có thể còn chưa tồn tại.
Trong những trường hợp sau, bạn có thể cần sáng tạo hơn với dữ liệu mình có, hoặc thậm chí phải tự thu thập dữ liệu (điều này có thể là một dự án riêng). Hãy xem khóa học web scraping với Python, khóa tìm hiểu khoa học dữ liệu, hoặc khóa khoa học dữ liệu cho kinh doanh để lấy ý tưởng về thu thập dữ liệu.
DataCamp có một bộ sưu tập bộ dữ liệu được tuyển chọn sẵn, dễ truy cập, bao phủ nhiều chủ đề. Đây có thể là nơi tuyệt vời để bắt đầu, nhất là khi bạn chưa biết nên bắt đầu từ đâu.
Những địa chỉ hữu ích khác gồm các trang web của cơ quan chính phủ, tổ chức phi lợi nhuận, trường đại học và thư viện. Dưới đây là một bảng gồm một số nguồn tuyệt vời để tìm các bộ dữ liệu thú vị.
|
Nguồn bộ dữ liệu |
Liên kết web |
|
DataCamp |
https://www.datacamp.com/workspace/datasets |
|
Google Dataset Search |
https://datasetsearch.research.google.com/ |
|
Data.gov |
https://data.gov/ |
|
Datahub |
https://www.datahub.io/search |
|
UCI Machine Learning Repository |
https://archive.ics.uci.edu/ |
|
Kaggle |
https://www.kaggle.com/datasets |
|
Thư viện Quốc hội Hoa Kỳ |
https://guides.loc.gov/datasets |
|
Cục Điều tra Dân số Hoa Kỳ |
https://www.census.gov/data/datasets.html |
|
Ủy ban Thương mại Liên bang |
https://www.ftc.gov/policy-notices/open-government/data-sets |
|
Tổ chức Y tế Thế giới |
https://www.who.int/data/sets |
|
Trung tâm Kiểm soát và Phòng ngừa Dịch bệnh |
https://open.cdc.gov/data.html |
|
Viện Y tế Quốc gia Hoa Kỳ |
https://www.ncbi.nlm.nih.gov/datasets/ |
Bước quan trọng khi chọn nguồn dữ liệu là đánh giá chất lượng và độ tin cậy của nó. Trước hết, bạn cần xác minh nguồn dữ liệu có đáng tin cậy hay không. Mỗi bộ dữ liệu của DataCamp đều có liên kết tới tài liệu nguồn, cho phép bạn dễ dàng xác thực tính xác thực.
Với các nguồn dữ liệu khác, bạn có thể cần tìm hiểu kỹ hơn để đảm bảo đang sử dụng dữ liệu tin cậy. Những yếu tố về độ tin cậy bạn nên cân nhắc bao gồm cách dữ liệu được thu thập, các nhóm dân số nào được đại diện trong dữ liệu, và liệu có thiên lệch nào trong quá trình thu thập hay không.
Một yếu tố khác cần cân nhắc khi chọn bộ dữ liệu là mức độ làm sạch và xử lý cần thiết để đưa dữ liệu về định dạng sử dụng được. Chọn một bộ dữ liệu đã được tuyển chọn có thể giúp bạn tiết kiệm thời gian. Tuy nhiên, việc dùng dữ liệu lộn xộn hơn thường là khó tránh, đòi hỏi nỗ lực đáng kể để đảm bảo các trường có cùng định dạng, xử lý giá trị thiếu và loại bỏ dữ liệu trùng lặp.
Hướng dẫn làm sạch dữ liệu này sẽ giúp bạn giải quyết một số vấn đề trên.
Khám phá cấu trúc bộ dữ liệu
Có một số thuật ngữ tiêu chuẩn mô tả các phần của một bộ dữ liệu mà bạn nên biết.
Các bộ dữ liệu dạng bảng gồm các hàng và cột. Thông thường, mỗi hàng là một bản ghi, và mỗi cột biểu thị một thuộc tính hay biến của bản ghi đó.
Mỗi ô dữ liệu tại giao điểm của một hàng và một cột chứa một giá trị. Chỉ mục gán cho mỗi bản ghi một số riêng. Phần tiêu đề, tức hàng đầu tiên của mỗi cột, thường là tên thuộc tính hay tên cột. Trong cơ sở dữ liệu quan hệ, các bảng riêng lẻ có thể được kết nối bởi các quan hệ.
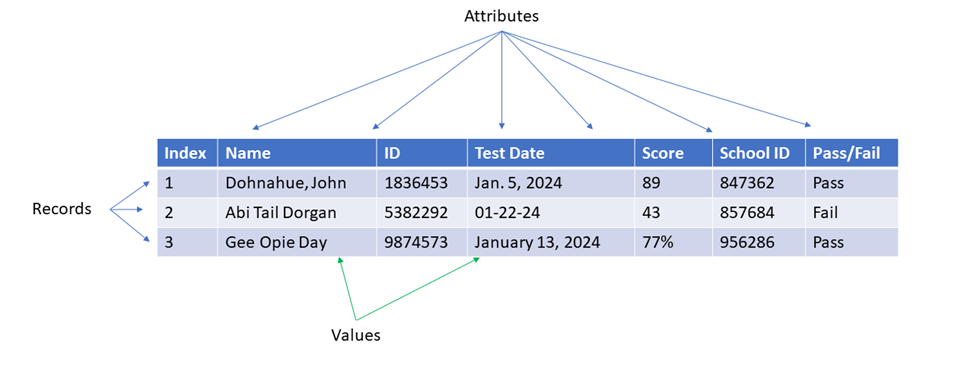
Khi lần đầu nhận một bộ dữ liệu, điều quan trọng là kiểm tra và xác định một số đặc điểm then chốt này. Có nhiều cách để xem bộ dữ liệu của bạn, bao gồm nạp vào Python, SQL, R hoặc Matlab và gọi hiển thị các hàng cụ thể.
Tùy theo loại tệp và kích thước, bạn thậm chí có thể mở trực tiếp trong Microsoft Excel hoặc Google Sheets để xem. Hãy nhớ rằng nếu bộ dữ liệu rất lớn, nạp toàn bộ cùng lúc sẽ tốn nhiều bộ nhớ, vì vậy bạn có thể cần xem theo từng phần.
Thường thì, sau khi có bộ dữ liệu cho dự án, bước tiếp theo sẽ là rất nhiều công việc làm sạch và chuẩn bị để đưa dữ liệu về định dạng sử dụng được. Chọn một bộ dữ liệu đã được tuyển chọn, như trên DataCamp, sẽ giúp giảm lượng công việc làm sạch cần thiết.
Tuy nhiên, bạn vẫn có khả năng phải điều chỉnh bộ dữ liệu để đáp ứng nhu cầu. Điều này đặc biệt đúng nếu bạn đang lấy dữ liệu từ nhiều nguồn cho dự án.
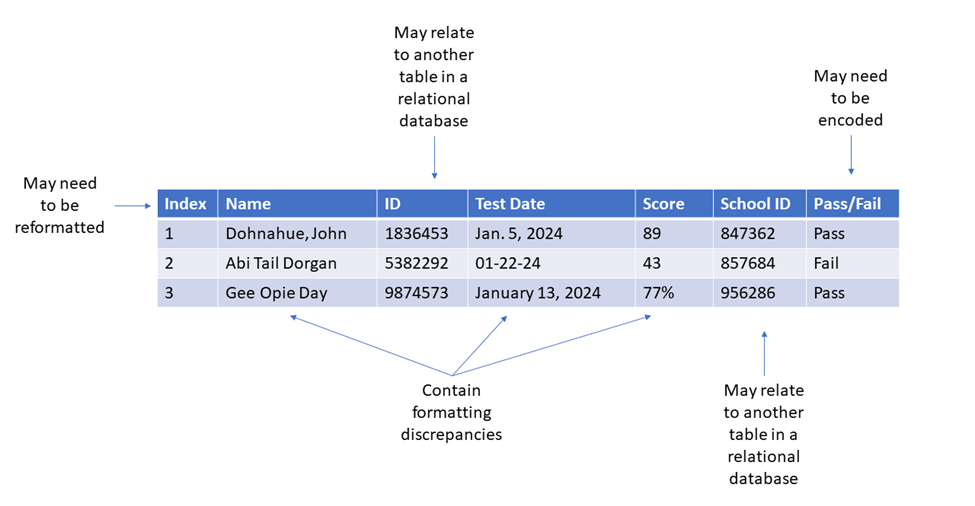
Khi làm sạch và chuẩn bị bộ dữ liệu, một số tác vụ phổ biến bạn có thể cần thực hiện gồm:
Xem thêm các khóa học về làm sạch dữ liệu bằng Python hoặc làm sạch dữ liệu trong cơ sở dữ liệu SQL Server.
Phân tích khám phá dữ liệu giúp bạn thật sự hiểu bộ dữ liệu của mình, một bước then chốt trước khi đi sâu vào các phân tích phức tạp hơn. Nhiều người mới vào nghề dữ liệu bỏ qua bước quan trọng này và phải trả giá.
Tôi khuyên bạn nên thực hiện một số phân tích khám phá trên bộ dữ liệu trước khi tiến hành bất kỳ mô hình hóa, học máy hay phân tích phức tạp nào khác.
Bước này sẽ giúp bạn phát hiện các điểm bất thường, không nhất quán hoặc vấn đề trong bộ dữ liệu. Nó sẽ định hướng bạn tới phương pháp phân tích phù hợp hơn về sau và giúp phát hiện, chỉnh sửa các kết quả bất thường.
Bước khám phá này nên có nhiều hình thức, từ thống kê mô tả đến trực quan hóa đơn giản. Với hầu hết các bộ dữ liệu dạng bảng, các thống kê tóm tắt như trung bình, trung vị, độ lệch chuẩn, cùng với một số biểu đồ phân tán hoặc biểu đồ cột đơn giản có thể cho bạn một cái nhìn sâu sắc về các mẫu và hành vi của dữ liệu.
Tôi khuyến khích bạn dành thời gian vẽ càng nhiều biến trong bộ dữ liệu càng tốt trong phạm vi hợp lý. Dù bước này có thể không xuất hiện trong bảng điều khiển, báo cáo hay ứng dụng cuối cùng của dự án, nó sẽ dẫn dắt bạn trong quá trình thực hiện. Tìm hiểu thêm về phân tích khám phá dữ liệu bằng Python hoặc phân tích khám phá dữ liệu bằng R.
Mục tiêu cuối cùng của mọi dự án dữ liệu là trình bày phát hiện của bạn cho những người quan tâm. Dù khán giả của bạn là bên liên quan trong doanh nghiệp, nhà tuyển dụng tiềm năng hay đồng nghiệp dữ liệu, điều quan trọng là các insight của bạn phải rõ ràng và dễ diễn giải.
Đôi khi, một biểu đồ đơn giản với tiêu đề mô tả là đủ. Những lúc khác, bạn có thể cần một bảng điều khiển phức tạp hơn. Dù bạn chọn gì, hãy đảm bảo rằng diễn giải của bạn trung thực với bộ dữ liệu.
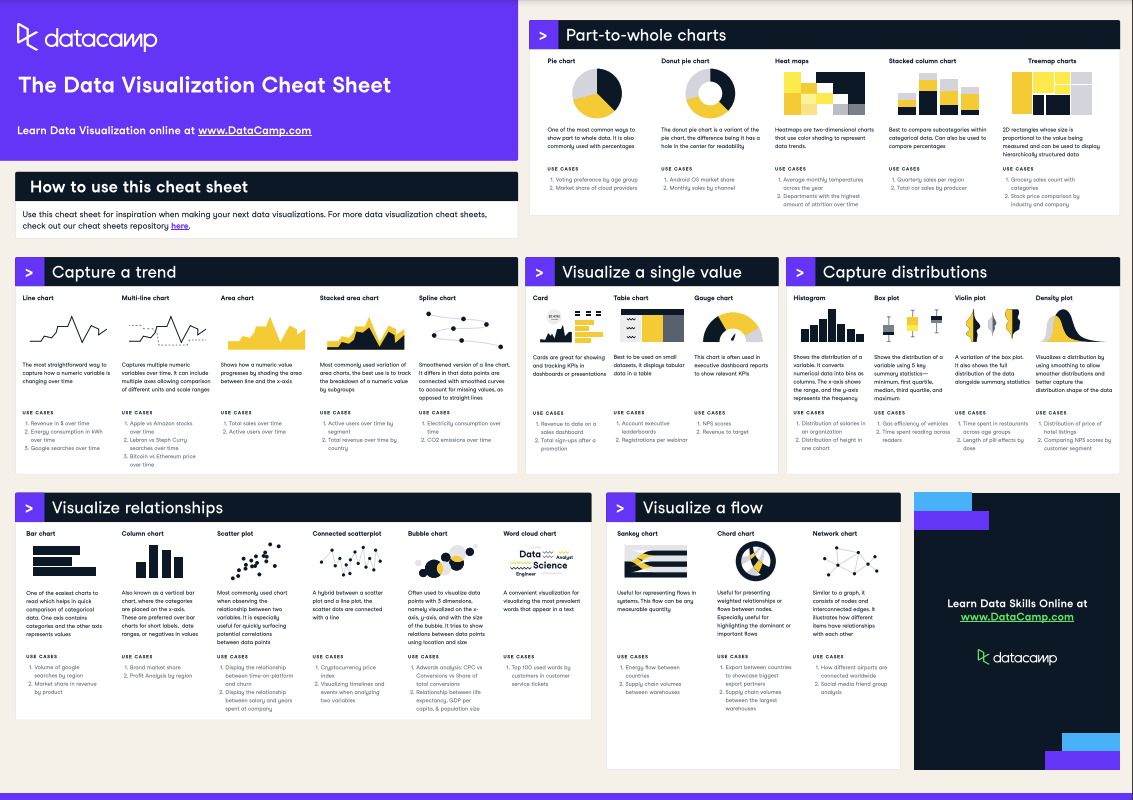
Tờ gian lận trực quan hóa dữ liệu của chúng tôi có thể giúp bạn chọn cách tốt nhất để trình bày các bộ dữ liệu.
Mục tiêu nên là truyền đạt trung thực cho khán giả của bạn bộ dữ liệu đại diện cho điều gì và nó trả lời câu hỏi của bạn như thế nào. Xem lộ trình kỹ năng kể chuyện bằng dữ liệu để thành thạo kỹ năng thiết yếu này.
DataCamp là địa chỉ tuyệt vời để trình bày danh mục dữ liệu của bạn. Những lựa chọn phổ biến khác để lưu trữ danh mục dữ liệu gồm một kho GitHub hoặc một trang web chuyên nghiệp. Dù bạn lưu trữ dự án ở đâu, hãy đảm bảo rằng nó dễ dàng truy cập với khán giả mục tiêu.
Thông tin là cốt lõi của khoa học dữ liệu. Các bộ dữ liệu tập hợp thông tin ở một nơi, giúp xác định xu hướng, đưa ra dự đoán và thúc đẩy nhân loại tiến lên. Tìm các bộ dữ liệu để phân tích có thể ban đầu khiến bạn e ngại. Nhưng biết một vài nơi để bắt đầu tìm kiếm có thể tạo nên khác biệt lớn. Hãy xem tuyển chọn các bộ dữ liệu thú vị của DataCamp và tìm cảm hứng cho bạn!
Bắt đầu hành trình dữ liệu của bạn ngay hôm nay!
Lộ trình
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
