course
Google ADK के साथ AI एजेंट बनाना
1 घंटा
7.5K
आवाज इस महीने की बड़ी जंग है। Artificial Analysis के Speech to Speech Index पर OpenAI का GPT-Live-1 Astra और SpaceXAI का Grok Voice Think Fast 2.0 शीर्ष पर 0.2 अंकों के अंतर से बैठे थे, और OpenAI ने सितंबर की शुरुआत में GPT-6 Astra जारी किया। 15 सितंबर को, Google ने दो नए स्पीच-टू-स्पीच मॉडल पेश किए: Gemini 3.8 Live और Gemini 3.8 Live Extended Thinking।
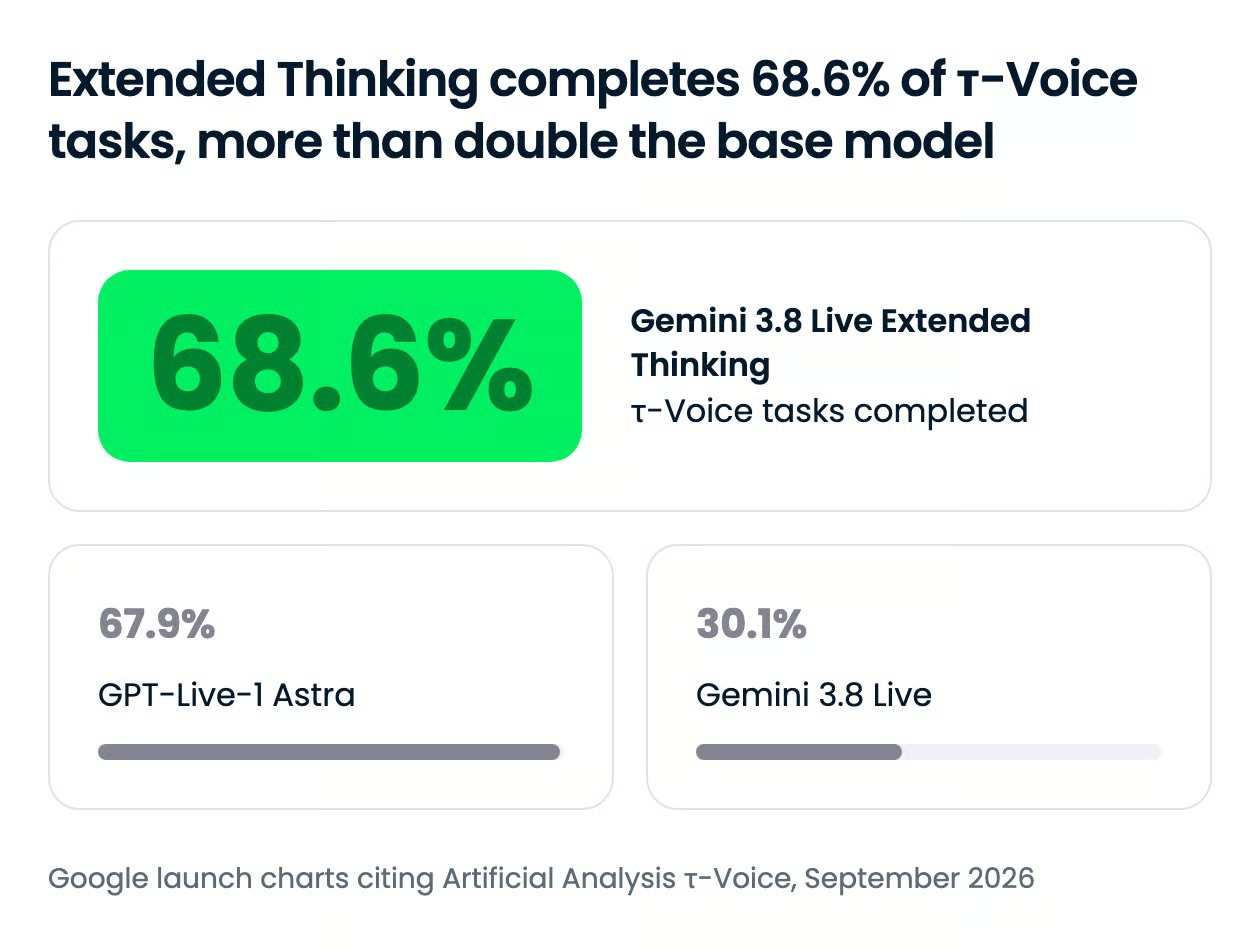
Extended Thinking उस इंडेक्स में 82.6 के स्कोर के साथ नंबर 1 पर है और τ-Voice एजेंटिक बेंचमार्क पर 68.6% से आगे है। बेस 3.8 Live मॉडल सस्ता है: Artificial Analysis के कॉस्ट टेस्ट में यह एक घंटे के इनपुट ऑडियो को $0.84 में प्रोसेस करता है, जो Google के चार्ट में सबसे कम है। दोनों आज Gemini API में आम तौर पर उपलब्ध हैं और अपने पूर्ववर्ती Gemini 3.1 Flash Live के समान कीमत पर हैं।
इस लेख में, मैं Gemini 3.8 Live की नई बातों को कवर करूंगा—फीचर्स, बेंचमार्क, दोनों वेरिएंट्स का फर्क, और रनिंग कॉस्ट। आप हमारे गाइड भी देख सकते हैं: Gemini Live API से शुरुआत कैसे करें और GPT-Live-1 के साथ वॉयस असिस्टेंट कैसे बनाएं।
Gemini 3.8 Live Google का नैटिव स्पीच-टू-स्पीच मॉडल है जो रीयल-टाइम वॉयस एजेंट्स के लिए है, 15 सितंबर, 2026 को इसके उच्च-रीजनिंग साथी Gemini 3.8 Live Extended Thinking के साथ जारी हुआ। दोनों Gemini Live API पर WebSocket कनेक्शन के जरिए चलते हैं, इनपुट में ऑडियो, वीडियो, इमेज और टेक्स्ट लेते हैं, और आउटपुट में ऑडियो लौटाते हैं। Google 3.8 Live को लो-लेटेंसी डायलॉग के लिए डिफॉल्ट और Extended Thinking को जटिल, मल्टी-स्टेप टास्क्स के लिए चयन के रूप में रखता है।
Gemini 3.1 Flash Live से पीढ़ीगत बदलाव इस बात में है कि मॉडल बोलने के अलावा अन्य काम कैसे संभालता है। अब टूल और API कॉल डिफॉल्ट रूप से बैकग्राउंड में चलती हैं, जबकि मॉडल बातचीत जारी रखता है, और Extended Thinking इसमें कॉन्फिगरेबल बैकग्राउंड रीजनिंग जोड़ता है। Google इस जोड़ी को अपने पिछले लाइव मॉडलों से एक स्टेप-चेंज और उन कैस्केडेड पाइपलाइनों के विकल्प के रूप में बताता है जो स्पीच-टू-टेक्स्ट, एक LLM, और टेक्स्ट-टू-स्पीच को चेन करती हैं।
Google नए मॉडलों के लिए पाँच क्षमताएँ सूचीबद्ध करता है, और वॉयस एजेंट बनाने वाले किसी भी व्यक्ति के लिए सबसे महत्वपूर्ण वे दो हैं जो संवाद लूप बदलती हैं: असिंक्रोनस टूल कॉल्स और बैकग्राउंड रीजनिंग।
दोनों मॉडल फंक्शन कॉल्स और API अनुरोधों को बैकग्राउंड में निष्पादित करते हैं, जबकि उपयोगकर्ता को ऑडियो स्ट्रीम करते रहते हैं। Gemini 3.8 Live पर, असिंक्रोनस एक्जीक्यूशन अब फंक्शन-कॉलिंग का डिफॉल्ट मोड है। आप अभी भी किसी टूल डिक्लेरेशन पर behavior: BLOCKING सेट करके पुराने सिंक्रोनस व्यवहार को मजबूर कर सकते हैं, और मॉडल SILENT, WHEN_IDLE, और INTERRUPTED विकल्पों के साथ फंक्शन शेड्यूलिंग सपोर्ट करता है, जो तय करते हैं कि परिणाम कब बोला जाए।
Extended Thinking इससे आगे जाता है: यह नॉन-ब्लॉकिंग टूल्स की मांग करता है और यदि आप ब्लॉकिंग टूल घोषित करते हैं तो हार्ड एरर लौटाता है। व्यावहारिक असर यह है कि बुकिंग बदलने का अनुरोध करने वाला कॉलर तुरंत स्वीकृति सुनता है, फिर प्रोग्रेस अपडेट, फिर परिणाम—उस सन्नाटे के बजाय जो कैस्केडेड पाइपलाइन API का इंतज़ार करते हुए पैदा करती है। Gemini 3.1 Flash Live पर, फंक्शन कॉलिंग केवल सीक्वेंशियल थी, और मॉडल तब तक जवाब देना शुरू नहीं करता था जब तक आप टूल का परिणाम वापस न भेज दें।
Gemini 3.8 Live Extended Thinking एक साथ तर्क करता है और बोलता है। Google के डॉक्स बताते हैं कि मॉडल आरंभ में "Let me check that" जैसे मौखिक संकेत देता है ताकि प्रॉम्प्ट की पुष्टि हो, फिर मल्टी-स्टेप बैकग्राउंड काम पूरा होने तक प्रोग्रेस का वर्णन करता है। आप गहराई को thinking_level से नियंत्रित करते हैं, जिसे low, medium, या high पर सेट किया जा सकता है; 3.1 Flash Live पर मौजूद MINIMAL स्तर हटा दिया गया है।
यह प्रोटोकॉल बदलता है, और मेरे विचार में यह रिलीज़ का सबसे महत्वपूर्ण माइग्रेशन विवरण है। क्योंकि मॉडल एक ही अनुरोध के दौरान कई बार बोल सकता है, turnComplete: true का अर्थ अब यह नहीं कि वह निष्क्रिय है।
आपके क्लाइंट को नया interaction_status फ़ील्ड देखना होगा, जो रीजनिंग या टूल चलने के दौरान IN_PROGRESS और पूरे कार्य के समाप्त होने पर IDLE रिपोर्ट करता है। इसे छोड़ दें, और आपका UI मॉडल के अभी कार्यरत रहते हुए ही वापस "listening" पर आ जाएगा।
Gemini 3.8 Live संवाद को लाइव विजुअल इनपुट में ग्राउंड करता है, वीडियो फ़्रेम्स को लगभग रीयल-टाइम में प्रोसेस करता है ताकि एजेंट उपयोगकर्ता जो देख रहा है उसके साथ-साथ जो वह कहता है, उस पर प्रतिक्रिया दे सके। Google के डेमो में एक लाइव शतरंज खेल और एक कर्मचारी ऑनबोर्डिंग वॉकथ्रू शामिल हैं जहाँ मॉडल स्क्रीन पर मौजूद चीज़ों के बारे में प्रश्नों का उत्तर देता है।
लेकिन वीडियो मुफ़्त नहीं है। अब टर्न कवरेज डिफॉल्ट रूप से ऑडियो एक्टिविटी के साथ सभी वीडियो फ़्रेम्स मॉडल को भेजता है, इसलिए यदि आपके ऐप को विज़न की ज़रूरत नहीं है, तो संदर्भ बजट और लागत दोनों के लिए फ़्रेम्स केवल तभी भेजें जब वे उपयोगी हों। ऑडियो-प्लस-वीडियो सेशंस 2 मिनट पर सीमित हैं, उसके बाद उन्हें बढ़ाने के लिए सेशन मैनेजमेंट चाहिए, जबकि केवल-ऑडियो सेशंस 15 मिनट तक चल सकते हैं।
Google इसे "अल्फ़ान्यूमेरिक प्रिसीजन" कहता है: कन्फर्मेशन कोड्स, क्लेम नंबर और तकनीकी आइडेंटिफ़ायर्स जैसे स्ट्रिंग्स को, जिन्हें ज़ोर से बोला जाता है, सटीकता से पार्स करना। जिसने भी सपोर्ट या लॉजिस्टिक्स के लिए वॉयस एजेंट बनाया है, वह जानता है कि यहीं कैस्केडेड स्टैक्स फिसलते हैं, क्योंकि चेन की शुरुआत में हुई स्पीच-टू-टेक्स्ट गलती नीचे की ओर सुधर नहीं सकती। पूरा उच्चारण संदर्भ में सुनने वाला नैटिव स्पीच मॉडल यहाँ संरचनात्मक बढ़त रखता है।
Gemini 3.8 Live बातचीत के दौरान 97 समर्थित भाषाओं का पता लगाता है और उनके बीच स्विच करता है, जिसे Google उच्चारण-संगति कहता है। दोनों मॉडल इन्क्रीमेंटल कंटेंट अपडेट्स भी सपोर्ट करते हैं: आप किसी भी समय सेशन में स्ट्रक्चर्ड डेटा भेज सकते हैं, स्पष्ट user या model रोल के साथ, और मॉडल उसे लाइव ऑडियो के साथ मर्ज कर देता है। इसी तरह आप किसी चलती कॉल में कस्टमर रिकॉर्ड या ऑर्डर स्टेटस फीड कर सकते हैं, बिना फ़्लो तोड़े।
दो छोटे बदलाव मौजूदा कोड को प्रभावित करते हैं। Proactive audio, जहाँ मॉडल तय कर सकता है कि उस स्पीच का जवाब न दे जो उसके लिए निर्देशित नहीं है, अब स्थायी रूप से ऑन है, और इसे false सेट करने पर एरर मिलता है। Affective dialogue को API से पूरी तरह हटा दिया गया है, इसलिए कोई भी enable_affective_dialog कॉन्फ़िगरेशन हटाना होगा।
Extended Thinking Google द्वारा प्रकाशित हर क्वालिटी और एजेंटिक बोर्ड में आगे है, लेकिन OpenAI के GPT-Live-1 Astra पर मामूली बढ़त के साथ, जबकि बेस 3.8 Live मॉडल लागत में बड़े अंतर से जीतता है पर एजेंटिक टास्क्स में हारता है।
नीचे दिया गया इंडेक्स, τ-Voice, Big Bench Audio और कॉस्ट डेटा सभी Artificial Analysis की सार्वजनिक लीडरबोर्ड पर हैं, इसलिए ये विक्रेता-रिपोर्टेड नहीं बल्कि स्वतंत्र रूप से मापे गए हैं। τ³-Banking के आंकड़े Google के लॉन्च चार्ट से (Sierra का हवाला देते हुए) आते हैं, इसलिए जब तक Sierra का बोर्ड वही नहीं दिखाता, उस पंक्ति को विक्रेता-रिपोर्टेड मानें।
Gemini 3.8 Live Extended Thinking, Sierra के τ-Voice बेंचमार्क पर आगे है, जो मापता है कि वॉयस एजेंट टूल्स के साथ मल्टी-स्टेप टास्क्स कितनी अच्छी तरह पूरा करता है, जैसा कि Artificial Analysis ने मापा। GPT-Live-1 Astra क़रीब है, बाकी मुकाबला पीछे छूटता है:
जो संख्या मुझे चौंकाती है, वह यह कि τ-Voice पर बेस मॉडल का स्कोर उसके अपने पूर्ववर्ती से नीचे है। Google साफ़ कहता है कि 3.8 Live जटिल वर्कफ़्लोज़ के बजाय स्केल और लागत दक्षता के लिए बना है, लेकिन दोनों वेरिएंट्स के बीच 38 से अधिक अंकों का अंतर बताता है कि टियर का चुनाव बारीकी का मामला नहीं है। यदि आपका एजेंट टूल्स को चेन करता है, तो बेस मॉडल गलत डिफॉल्ट है।
Sierra के τ³-Banking लीडरबोर्ड पर, जो बैंकिंग वर्कफ़्लोज़ पर आधारित एक कठिन कस्टमर-सर्विस बेंचमार्क है, Extended Thinking 35.1% स्कोर करता है, जबकि GPT-Live-1 Astra 32.0%, SpaceXAI के Grok Voice Think Fast 2.0 को 16.5%, Gemini 3.1 Flash Live को 11.3%, और GPT-Realtime 2 को 10.3% मिलते हैं। उस बोर्ड पर हर मॉडल ज़्यादातर समय विफल होता है, जो बताता है कि वॉयस एजेंट्स अभी बिना निगरानी वाले बैंकिंग काम से कितने दूर हैं, लेकिन पिछले Gemini जेनरेशन पर तिगुना होना एक वास्तविक कदम है।
Speech to Speech Index पर Extended Thinking भी प्रतिस्पर्धा से थोड़ा आगे है:
OpenAI पर 1.1 अंक की बढ़त, बढ़त तो है—पर मैं किसी खरीद निर्णय को केवल इस पर आधारित नहीं करूँगा।
बोले गए इनपुट पर शुद्ध तर्क के लिए, Google Extended Thinking के लिए Big Bench Audio पर 97.7% रिपोर्ट करता है। Google यह भी रिपोर्ट करता है कि दोनों मॉडल ServiceNow के EVA-Bench पर वॉयस एजेंट्स के लिए Pareto फ्रंटियर को आगे बढ़ाते हैं, शुद्धता और बातचीत की गुणवत्ता में संतुलन रखते हुए—हालाँकि वह रन Live API पर Gemini Enterprise Agent Platform के जरिए किया गया था, न कि पब्लिक API पर।
यह वह चार्ट है जिसे Google सबसे ज़्यादा दिखाना चाहता है। Artificial Analysis के कॉस्ट टेस्ट (Big Bench Audio सबसेट) में, Gemini 3.8 Live एक घंटे के इनपुट ऑडियो को $0.84 में प्रोसेस करता है।
उसी घंटे के लिए Extended Thinking की लागत $3.50 है, Grok Voice Think Fast 2.0 की $4.80, और GPT-Live-1 Astra की $5.83। Gemini 3.1 Flash Live 1.50 और $1.75 पर बैठा था, थिंकिंग लेवल पर निर्भर।
दोनों Gemini बार्स को साथ देखें, तो प्रोडक्ट स्ट्रेटेजी साफ़ है। बेस मॉडल बोर्ड पर हर चीज़ से बड़े अंतर से सस्ता है, और क्वालिटी में OpenAI की टक्कर लेने वाला रीजनिंग मॉडल भी प्रति घंटे इनपुट पर 40% कम कीमत का है। ध्यान दें कि रीजनिंग मॉडल ऊँचे थिंकिंग लेवल पर ज़्यादा टोकन जलाता है, इसलिए एक ही प्राइस टेबल शेयर करने के बावजूद इसकी लागत अपने सिब्लिंग से लगभग 4 गुना है।
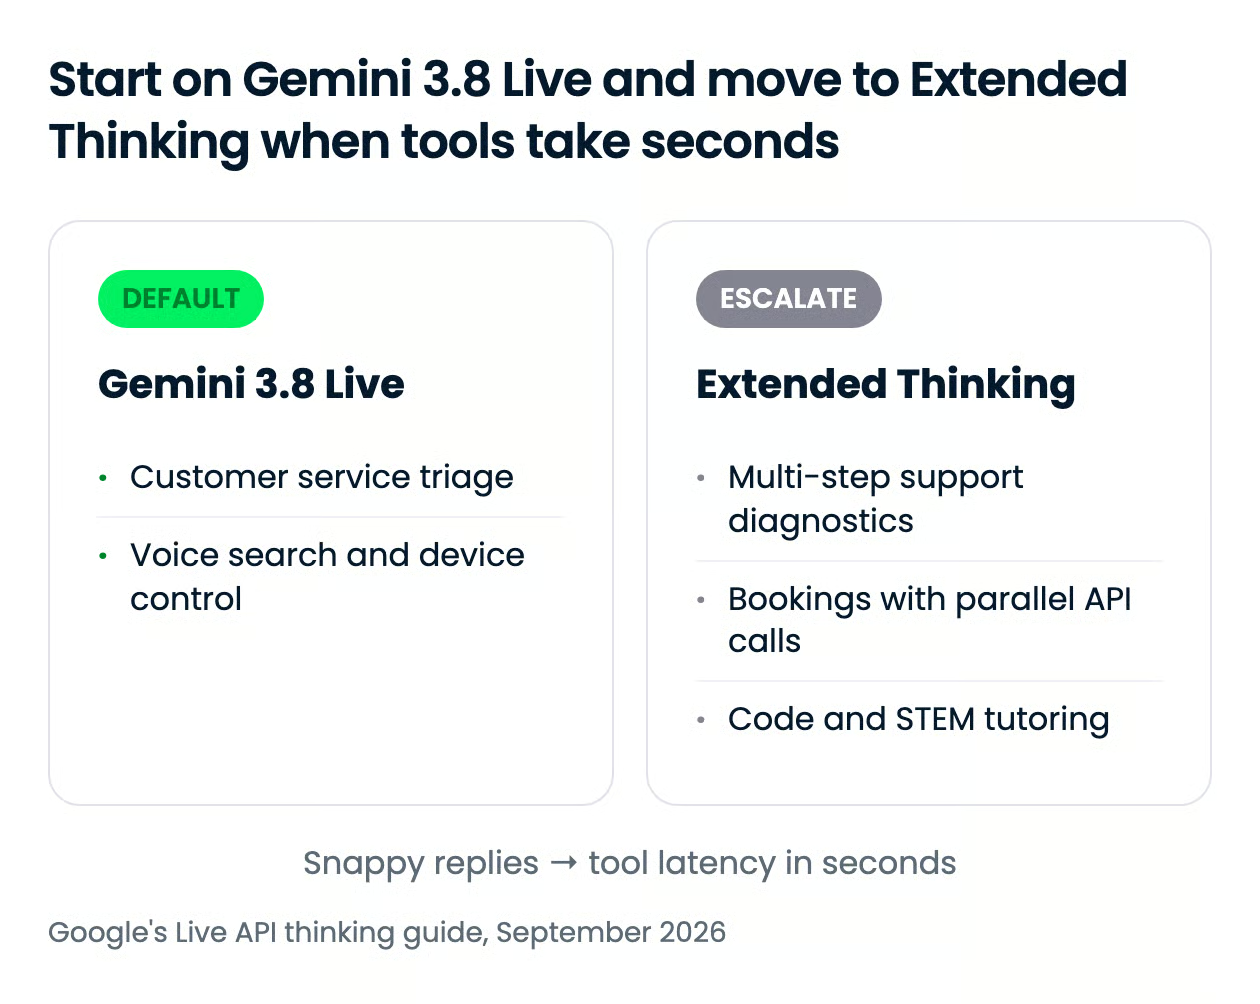
अधिकांश वॉयस एजेंट्स के लिए Gemini 3.8 Live सही डिफॉल्ट है, और Extended Thinking तभी अपनी उच्च टोकन खपत के लायक है जब एजेंट को योजना बनानी हो, तुलना करनी हो, या धीमे टूल्स का इंतज़ार करना हो। Google का अपना दिशानिर्देश रेखा टूल विलंबता पर खींचता है: यदि आपके फंक्शंस मिलीसेकंड्स में लौटते हैं, तो बेस मॉडल पर रहें।
दोनों वेरिएंट्स एक ही प्राइस टेबल (जिसे मैं नीचे कवर करूँगा), 131,072 इनपुट और 65,536 आउटपुट टोकन सीमाएँ, और वही WebSocket एंडपॉइंट साझा करते हैं। जो उन्हें अलग करता है, वह रीजनिंग आर्किटेक्चर है।
Gemini 3.8 Live इंटरलीव्ड रीजनिंग का उपयोग करता है, एक फिक्स्ड लेटेंसी प्रोफ़ाइल के साथ, और कोई thinking_level सेटिंग नहीं। Extended Thinking low, medium, और high बैकग्राउंड रीजनिंग एक्सपोज़ करता है, काम करते समय बातचीत के फिलर्स स्ट्रीम करता है, और असिंक्रोनस टूल्स की मांग करता है। यही थिंकिंग लेवल्स रिलीज़ में एकमात्र एफर्ट कंट्रोल हैं।
| उपयोग का मामला | चयन | क्यों |
|---|---|---|
| कस्टमर सर्विस ट्रायेज, वॉयस सर्च, भाषा अभ्यास | Gemini 3.8 Live | तुरंत टर्न-टेकिंग गहराई से अधिक मायने रखती है, और हर यूज़र टर्न पर एक उत्तर पर्याप्त है |
| स्मार्ट-डिवाइस कंट्रोल, सेंसर वैल्यू पढ़ना | Gemini 3.8 Live | टूल्स मिलीसेकंड्स में लौटते हैं, इसलिए छुपाने लायक कुछ नहीं |
| लॉग्स, एरर कोड्स, और कॉन्फ़िग चेक्स में टेक्निकल सपोर्ट | Extended Thinking | मल्टी-स्टेप डायग्नोसिस को उच्चारणों के बीच बैकग्राउंड रीजनिंग चाहिए |
| फ्लाइट्स और होटलों को समानांतर में क्वेरी करने वाले ट्रैवल/बुकिंग एजेंट्स | Extended Thinking | सन्नाटे की जगह बोले गए प्रोग्रेस अपडेट्स के साथ समानांतर असिंक कॉल्स |
| STEM और कोड ट्यूटरिंग | Extended Thinking | मॉडल व्याख्या बोलने से पहले फ़ॉर्मूले वेरिफ़ाई करता है या कोड डीबग करता है |
एक और बात: क्लाइंट जटिलता। Extended Thinking पर जाना आपके स्टेट हैंडलिंग को interaction_status के इर्द-गिर्द फिर से लिखने का मतलब है, इसलिए यदि आपके पास 3.1 Flash Live का काम करता ऐप है, तो बेस मॉडल ड्रॉप-इन अपग्रेड है, और रीजनिंग मॉडल एक छोटा रिफ़ैक्टर।
दोनों मॉडल Gemini 3.1 Flash Live Preview प्राइस टेबल साझा करते हैं, इसलिए अपग्रेड मुफ़्त है। पेड टियर पर, ऑडियो इनपुट की कीमत 1 मिलियन टोकन्स पर $3.00 है, जिसे Google लगभग $0.005 प्रति मिनट मानता है, और ऑडियो आउटपुट की कीमत 1 मिलियन टोकन्स पर $12.00 है, यानी लगभग $0.018 प्रति मिनट। थिंकिंग टोकन्स आउटपुट रेट पर बिल होते हैं, और यही Extended Thinking की अधिक रनिंग कॉस्ट का कारण है।
| मोडैलिटी | पेड टियर, प्रति 1M टोकन्स | प्रति-मिनट अनुमान |
|---|---|---|
| टेक्स्ट इनपुट | $0.75 | n/a |
| ऑडियो इनपुट | $3.00 | $0.005/मिनट |
| इमेज और वीडियो इनपुट | $1.00 | $0.002/मिनट |
| टेक्स्ट आउटपुट | $4.50 | n/a |
| ऑडियो आउटपुट (थिंकिंग टोकन्स सहित) | $12.00 | $0.018/मिनट |
फ़्री टियर दोनों मॉडलों को बिना शुल्क कवर करता है, सामान्य शर्त के साथ कि Google फ़्री-टियर डेटा का उपयोग अपने प्रोडक्ट्स को बेहतर बनाने के लिए करता है; पेड-टियर डेटा का वैसा उपयोग नहीं होता।
Google Search के साथ ग्राउंडिंग दोनों टियर्स पर सपोर्टेड है, प्रति माह 5,000 मुफ़्त सर्च रिक्वेस्ट्स (सभी Gemini 3.x मॉडलों में साझा) और उसके बाद प्रति 1,000 रिक्वेस्ट्स $14। Google ने इन मॉडलों के लिए विशिष्ट रेट लिमिट्स प्रकाशित नहीं किए हैं, इसलिए लॉन्च की योजना से पहले अपने टियर के लिए Gemini API रेट-लिमिट्स पेज देखें।
उपलब्धता तीन तरह से बंटी है:
दोनों मॉडलों से निकलने वाले हर ऑडियो आउटपुट पर SynthID वॉटरमार्क होता है, और Google का मॉडल कार्ड सीमाएँ साफ़-साफ़ बताता है: मॉडल अब भी हैलुसिनेट कर सकते हैं, जेलब्रेक प्रतिरोध अब भी बेहतर किया जा रहा है, और कभी-कभार धीमापन या टाइमआउट हो सकते हैं। ग्राहकों के सामने कोई भी मॉडल रखने से पहले ये चेतावनियाँ पढ़ने लायक हैं।
मॉडल IDs हैं gemini-3.8-live और gemini-3.8-live-extended-thinking, दोनों स्थिर स्ट्रिंग्स हैं—कोई प्रीव्यू सुफ़िक्स नहीं।
आप उन्हें Gemini Live API के जरिए google-genai SDK (Python या JavaScript) से, रॉ WebSockets से, या Google AI Studio के Stream व्यू में इंटरैक्टिव तौर पर एक्सेस कर सकते हैं। Google, Agora, Fishjam, LiveKit, LangChain, Pipecat, Vercel, और Vision Agents को इंटीग्रेशन पार्टनर्स के रूप में सूचीबद्ध करता है जो मीडिया-स्ट्रीमिंग लेयर संभालते हैं, और यदि आप पहले से ADK पर बना रहे हैं तो Agent Development Kit की स्ट्रीमिंग पथ भी है।
नीचे दिया गया मिनिमल Python सेशन एक कनेक्शन खोलता है, एक टेक्स्ट टर्न भेजता है, और आउटपुट ट्रांस्क्रिप्ट ऑन करता है ताकि आप पढ़ सकें कि मॉडल ने क्या कहा:
import asyncio
from google import genai

client = genai.Client()
config = {"response_modalities": ["AUDIO"], "output_audio_transcription": {}}

async def main():
    async with client.aio.live.connect(model="gemini-3.8-live", config=config) as session:
        await session.send_client_content(
            turns={"role": "user", "parts": [{"text": "Read back the claim number 7Q-4418-B."}]},
            turn_complete=True,
        )
        async for response in session.receive():
            if response.server_content and response.server_content.output_transcription:
                print(response.server_content.output_transcription.text)

asyncio.run(main())
यदि आप gemini-3.1-flash-live-preview से माइग्रेट कर रहे हैं, तो मॉडल स्ट्रिंग बदलें और अपने सेटअप से कोई भी thinking_level या thinking_config हटा दें; बाकी टर्न लाइफ़साइकल समान है। Live API डिफ़ॉल्ट रूप से सर्वर-टू-सर्वर है, इसलिए ब्राउज़र और मोबाइल क्लाइंट्स को इफेमेरल टोकन्स चाहिए।
ऑडियो कैप्चर, प्लेबैक, और सेशन मैनेजमेंट का पूरा वॉकथ्रू देखने के लिए हमारा Gemini Live API ट्यूटोरियल देखें, और इसी परिवार के टेक्स्ट-साइड के लिए हमारा Gemini 3.8 Flash API ट्यूटोरियल Python में थिंकिंग लेवल्स और फंक्शन कॉलिंग कवर करता है।
Google कच्ची क्वालिटी से ज़्यादा कीमत पर बयान दे रहा है। GPT-Live-1 Astra पर Extended Thinking की बढ़त हर बोर्ड पर एक-दो अंकों की है, लेकिन Gemini 3.8 Live का $0.84 प्रति घंटे इनपुट ऑडियो, OpenAI के मॉडल से लगभग 7 गुना कम है—और यही संख्या तय करती है कि प्रोडक्शन वॉयस ट्रैफ़िक कहाँ जाएगा।
मेरा मत: यदि आप Gemini 3.1 Flash Live पर कुछ भी चलाते हैं, तो इसी हफ्ते अपग्रेड करें—कीमत समान है और केवल असिंक टूल कॉलिंग ही इसके लायक है। यदि आप OpenAI के रीयलटाइम स्टैक पर हैं, तो बेस मॉडल ट्रायेज और सर्च फ़्लोज़ के लिए ट्रायल के काबिल है, और जहाँ आपके टूल्स को सेकंड्स लगते हैं वहाँ Extended Thinking भी। बेस मॉडल का τ-Voice पर 30.1% ही वह कारण है कि उसे किसी भी एजेंटिक काम के लिए न चुनें।
यदि आप वॉयस एजेंट के टूल-कॉलिंग पक्ष को ठीक से बनाना चाहते हैं, तो मैं हमारा Building AI Agents with Google ADK कोर्स सुझाता हूँ, जो Gemini को टूल्स, गार्डरेल्स, और डेलीगेशन के साथ एक कस्टमर-सपोर्ट एजेंट में वायर करता है।
DataCamp के साथ Agentic AI सीखें!
course
course
course