
Mixture of Experts (MoE) क्या है?
एक AI मॉडल को विशेषज्ञों की टीम की तरह समझें, जहाँ हर किसी की अपनी विशिष्ट विशेषज्ञता होती है। Mixture of Experts (MoE) मॉडल इसी सिद्धांत पर काम करता है—यह जटिल कार्य को छोटे, विशिष्ट नेटवर्क्स, जिन्हें “एक्सपर्ट्स” कहा जाता है, में बाँट देता है।
हर एक्सपर्ट समस्या के किसी खास पहलू पर ध्यान देता है, जिससे मॉडल काम को अधिक कुशलता और सटीकता से संभाल पाता है। यह वैसे ही है जैसे चिकित्सकीय समस्या के लिए डॉक्टर, कार की दिक्कत के लिए मैकेनिक, और खाना बनाने के लिए शेफ—हर कोई वही संभालता है जिसमें वह निपुण है।
मिलकर काम करने से ये विशेषज्ञ एक अकेले जनरलिस्ट की तुलना में व्यापक समस्याओं को अधिक प्रभावी ढंग से हल कर सकते हैं।
आइए नीचे दिए गए आरेख को देखें—हम इसे थोड़ी देर में समझाएँगे।
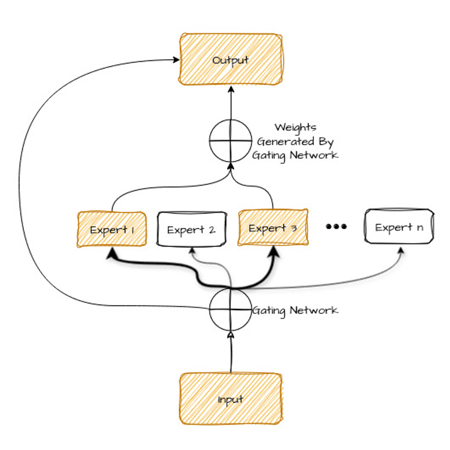
आइए इस आरेख के घटकों को समझें:
- इनपुट: यह वह समस्या या डेटा है जिसे आप AI से संभालना चाहते हैं।
- एक्सपर्ट्स: ये छोटे AI मॉडल होते हैं, जिनमें से हर एक को समग्र समस्या के किसी विशेष हिस्से में बहुत अच्छा बनने के लिए प्रशिक्षित किया जाता है। इन्हें अपनी टीम के अलग-अलग विशेषज्ञों की तरह समझें।
- गेटिंग नेटवर्क: यह एक मैनेजर की तरह है जो तय करता है कि समस्या के किस हिस्से के लिए कौन-सा एक्सपर्ट सबसे उपयुक्त है। यह इनपुट को देखता है और तय करता है कि किसे क्या काम करना चाहिए।
- आउटपुट: यह अंतिम उत्तर या समाधान है जो एक्सपर्ट्स के काम करने के बाद AI मॉडल उत्पन्न करता है।
MoE के उपयोग के फायदे हैं:
- दक्षता: केवल वही एक्सपर्ट्स उपयोग में आते हैं जो समस्या के किसी विशेष हिस्से में अच्छे हैं, जिससे समय और कम्प्यूटिंग शक्ति की बचत होती है।
- लचीलापन: आप आसानी से और एक्सपर्ट जोड़ सकते हैं या उनकी विशेषज्ञता बदल सकते हैं, जिससे सिस्टम अलग-अलग समस्याओं के अनुरूप ढल जाता है।
- बेहतर परिणाम: क्योंकि हर एक्सपर्ट वही करता है जिसमें वह माहिर है, समग्र समाधान प्रायः अधिक सटीक और भरोसेमंद होता है।
आइए एक्सपर्ट नेटवर्क्स और गेटिंग नेटवर्क्स को थोड़ा विस्तार से समझते हैं।
एक्सपर्ट नेटवर्क्स
MoE मॉडल में "एक्सपर्ट नेटवर्क्स" को विशेषज्ञों की टीम समझें। एक ही AI मॉडल से सब कुछ करवाने के बजाय, प्रत्येक एक्सपर्ट किसी खास प्रकार के कार्य या डेटा पर केंद्रित रहता है।
MoE मॉडल में ये एक्सपर्ट्स अलग-अलग न्यूरल नेटवर्क्स की तरह होते हैं, जिनमें से हर एक को अलग डेटासेट्स या कार्यों पर प्रशिक्षित किया जाता है।
उन्हें स्पार्स रूप में डिज़ाइन किया जाता है, यानी इनपुट की प्रकृति के अनुसार किसी भी समय केवल कुछ ही सक्रिय रहते हैं। इससे सिस्टम पर बोझ नहीं पड़ता और सबसे प्रासंगिक एक्सपर्ट्स ही समस्या पर काम करते हैं।
लेकिन मॉडल को कैसे पता चलता है कि किन एक्सपर्ट्स को चुनना है? यहीं गेटिंग नेटवर्क काम में आता है।
गेटिंग नेटवर्क्स
गेटिंग नेटवर्क (राउटर) एक अन्य प्रकार का न्यूरल नेटवर्क है, जो इनपुट डेटा (जैसे अनुवाद की जाने वाली पंक्ति) का विश्लेषण करना सीखता है और तय करता है कि उसे संभालने के लिए कौन-से एक्सपर्ट्स सबसे उपयुक्त हैं।
यह इनपुट की विशेषताओं के आधार पर प्रत्येक एक्सपर्ट को एक "वजन" या महत्व स्कोर सौंपकर ऐसा करता है। उच्चतम वेट वाले एक्सपर्ट्स को फिर डेटा प्रोसेस करने के लिए चुना जाता है।
गेटिंग नेटवर्क द्वारा सही एक्सपर्ट्स चुनने के कई तरीके होते हैं (जिन्हें "राउटिंग एल्गोरिद्म" कहा जाता है)। कुछ सामान्य तरीके हैं:
- टॉप-k राउटिंग: यह सबसे सरल तरीका है। गेटिंग नेटवर्क उच्चतम संबद्धता स्कोर वाले शीर्ष 'k' एक्सपर्ट्स को चुनता है और इनपुट डेटा उन्हें भेज देता है।
- एक्सपर्ट चॉइस राउटिंग: इस तरीके में डेटा एक्सपर्ट्स को नहीं चुनता, बल्कि एक्सपर्ट्स तय करते हैं कि वे किस डेटा को सबसे अच्छी तरह संभाल सकते हैं। यह रणनीति सर्वोत्तम लोड बैलेंसिंग पाने का लक्ष्य रखती है और डेटा-से-एक्सपर्ट मैपिंग का विविध तरीका देती है।
- स्पार्स राउटिंग: यह दृष्टिकोण प्रत्येक डेटा के लिए केवल कुछ एक्सपर्ट्स को सक्रिय करता है, जिससे एक स्पार्स नेटवर्क बनता है। स्पार्स राउटिंग में घनी (डेंस) राउटिंग की तुलना में कम कम्प्यूटेशन लगता है, जहाँ हर डेटा के लिए सभी एक्सपर्ट्स सक्रिय रहते हैं।
पूर्वानुमान बनाने की प्रक्रिया के दौरान, मॉडल एक्सपर्ट्स के आउटपुट्स को उसी प्रक्रिया का पालन करते हुए जोड़ता है जिसका उपयोग उसने एक्सपर्ट्स को कार्य सौंपने में किया था। एक ही कार्य के लिए, समस्या की जटिलता और विविधता के आधार पर, एक से अधिक एक्सपर्ट्स की आवश्यकता पड़ सकती है।
अब समझते हैं कि MoE कैसे काम करता है।
Mixture of Experts (MoE) कैसे काम करता है
MoE दो चरणों में संचालित होता है:
- ट्रेनिंग चरण
- इन्फेरेंस चरण
ट्रेनिंग चरण
अन्य मशीन लर्निंग मॉडलों की तरह, MoE एक डेटासेट पर प्रशिक्षण से शुरू होता है। हालाँकि, प्रशिक्षण पूरी मॉडल पर लागू नहीं होता, बल्कि इसके घटकों पर अलग-अलग किया जाता है।
एक्सपर्ट ट्रेनिंग
MoE फ्रेमवर्क के प्रत्येक घटक को डेटा या कार्यों के किसी विशिष्ट उपसमुच्चय पर प्रशिक्षित किया जाता है। उद्देश्य यह है कि हर घटक व्यापक समस्या के किसी खास पहलू पर केंद्रित हो सके।
यह फोकस प्रत्येक घटक को उसके सौंपे गए कार्य से संबंधित डेटा देकर हासिल किया जाता है। उदाहरण के लिए, भाषा प्रसंस्करण कार्य में, एक घटक सिंटैक्स पर तो दूसरा सेमांटिक्स पर ध्यान दे सकता है।
हर घटक का प्रशिक्षण मानक न्यूरल नेटवर्क प्रशिक्षण प्रक्रिया का अनुसरण करता है, जहाँ मॉडल अपने विशिष्ट डेटा उपसमुच्चय के लिए लॉस फ़ंक्शन को न्यूनतम करना सीखता है।
गेटिंग नेटवर्क ट्रेनिंग
गेटिंग नेटवर्क का कार्य किसी दिए गए इनपुट के लिए सबसे उपयुक्त एक्सपर्ट का चयन करना सीखना है।
गेटिंग नेटवर्क के प्रशिक्षण के दौरान, इसे एक्सपर्ट नेटवर्क्स के साथ-साथ प्रशिक्षित किया जाता है। इसे एक्सपर्ट्स के समान इनपुट मिलता है और यह एक्सपर्ट्स पर एक प्रायिकता वितरण की भविष्यवाणी करना सीखता है। यह वितरण बताता है कि मौजूदा इनपुट को संभालने के लिए कौन-सा एक्सपर्ट सबसे उपयुक्त है।
आम तौर पर गेटिंग नेटवर्क को ऐसे ऑप्टिमाइज़ेशन तरीकों से प्रशिक्षित किया जाता है जो गेटिंग नेटवर्क की सटीकता और चुने गए एक्सपर्ट्स के प्रदर्शन—दोनों को शामिल करते हैं।
जॉइंट ट्रेनिंग
जॉइंट ट्रेनिंग चरण में, पूरा MoE सिस्टम, जिसमें एक्सपर्ट मॉडल्स और गेटिंग नेटवर्क—दोनों शामिल हैं, साथ में प्रशिक्षित किए जाते हैं।
यह रणनीति सुनिश्चित करती है कि गेटिंग नेटवर्क और एक्सपर्ट्स तालमेल में काम करने के लिए अनुकूलित हों। जॉइंट ट्रेनिंग में लॉस फ़ंक्शन, व्यक्तिगत एक्सपर्ट्स और गेटिंग नेटवर्क—दोनों के लॉस को मिलाकर बनता है, जिससे सहयोगात्मक ऑप्टिमाइज़ेशन को बढ़ावा मिलता है।
संयुक्त लॉस के ग्रेडिएंट्स को फिर गेटिंग नेटवर्क और एक्सपर्ट मॉडलों—दोनों के माध्यम से प्रवाहित किया जाता है, जिससे ऐसे अपडेट्स होते हैं जो MoE सिस्टम के समग्र प्रदर्शन में सुधार लाते हैं।
इन्फेरेंस चरण
इन्फेरेंस में गेटिंग नेटवर्क्स से प्राप्त संदर्भ को एक्सपर्ट्स के आउटपुट्स के साथ मिलाकर आउटपुट जनरेट करना शामिल है। MoE में, इस प्रक्रिया को इन्फेरेंस लागत कम रखने के लिए डिज़ाइन किया जाता है।
इनपुट राउटिंग
MoE के संदर्भ में, गेटिंग नेटवर्क की भूमिका यह तय करने में अहम है कि किसी विशिष्ट इनपुट को किन मॉडलों द्वारा प्रोसेस किया जाना चाहिए।
इनपुट प्राप्त होते ही, गेटिंग नेटवर्क उसका आकलन करता है और सभी मॉडलों के बीच एक प्रायिकता वितरण बनाता है। यह वितरण फिर इनपुट को सबसे उपयुक्त मॉडलों तक भेजता है, प्रशिक्षण चरण के दौरान सीखे गए पैटर्न का लाभ उठाते हुए। इससे हर कार्य पर सही विशेषज्ञता लागू होती है, और निर्णय-प्रक्रिया अनुकूलित होती है।
एक्सपर्ट चयन
प्रत्येक इनपुट को प्रोसेस करने के लिए केवल कुछ चुनिंदा मॉडल—आमतौर पर एक या कुछ—चुने जाते हैं। यह चयन गेटिंग नेटवर्क द्वारा सौंपे गए प्रायिकताओं से निर्धारित होता है।
प्रत्येक इनपुट के लिए सीमित संख्या में मॉडलों का चयन कम्प्यूटेशनल संसाधनों के कुशल उपयोग में मदद करता है, जबकि MoE फ्रेमवर्क में निहित विशिष्ट ज्ञान का लाभ भी देता है।
गेटिंग नेटवर्क से प्राप्त आउटपुट सुनिश्चित करता है कि चुने गए मॉडल इनपुट को संभालने के लिए सबसे उपयुक्त हैं, जिससे सिस्टम की समग्र दक्षता और प्रदर्शन बेहतर होता है।
आउटपुट संयोजन
इन्फेरेंस प्रक्रिया का अंतिम चरण चुने गए मॉडलों के आउटपुट्स को मिलाना होता है।
यह मिलान अक्सर वेटेड एवरेजिंग के माध्यम से किया जाता है, जहाँ वेट्स गेटिंग नेटवर्क द्वारा सौंपे गए प्रायिकताओं को दर्शाते हैं। कुछ स्थितियों में, वोटिंग या लर्न्ड-कॉम्बिनेशन जैसी वैकल्पिक विधियाँ भी एक्सपर्ट आउटपुट्स को जोड़ने के लिए अपनाई जा सकती हैं। उद्देश्य चुने गए मॉडलों की विविध अंतर्दृष्टियों को एकीकृत और सटीक अंतिम भविष्यवाणी में समेटना है, ताकि MoE आर्किटेक्चर की ताकतों का लाभ उठाया जा सके।
तकनीक के तेज़ी से विकास के साथ, बड़े मॉडलों को संभालने के लिए तेज, कुशल और अनुकूलित तकनीकों की आवश्यकता बढ़ रही है। इस संदर्भ में MoE एक आशाजनक समाधान के रूप में उभर रहा है। MoE और क्या लाभ देता है?
Mixture of Experts (MoE) के लाभ
Mixture of Experts (MoE) आर्किटेक्चर कई फायदे प्रदान करता है:
- प्रदर्शन: किसी दिए गए कार्य के लिए केवल प्रासंगिक एक्सपर्ट्स को चुनिंदा रूप से सक्रिय करने से MoE मॉडल अनावश्यक कम्प्यूटेशन से बचते हैं, जिससे गति बढ़ती है और संसाधन खपत घटती है।
- लचीलापन: एक्सपर्ट्स की विविध क्षमताएँ MoE मॉडलों को अत्यंत लचीला बनाती हैं। विशेषीकृत क्षमताओं वाले एक्सपर्ट्स को बुलाकर, MoE मॉडल अधिक व्यापक कार्यों में सफल हो सकता है।
- फॉल्ट टॉलरेंस: MoE का "डिवाइड एंड कॉन्कर" दृष्टिकोण, जहाँ कार्य अलग-अलग निष्पादित होते हैं, मॉडल की विफलताओं के प्रति सहनशीलता बढ़ाता है। यदि कोई एक एक्सपर्ट समस्या में पड़ता है, तो जरूरी नहीं कि पूरे मॉडल की कार्यक्षमता प्रभावित हो।
- स्केलेबिलिटी: जटिल समस्याओं को छोटे, अधिक प्रबंधनीय कार्यों में तोड़ना MoE मॉडलों को बढ़ती जटिल इनपुट्स को संभालने में मदद करता है।
Mixture of Experts (MoE) के अनुप्रयोग
पिछले 30 वर्षों से MoE मौजूद होने के कारण, यह मशीन लर्निंग के विभिन्न क्षेत्रों में व्यापक रूप से प्रयुक्त तकनीक है।
नेचुरल लैंग्वेज प्रोसेसिंग (NLP)
MoE बेहतर दक्षता, तेज़ प्री-ट्रेनिंग और प्रतिस्पर्धी इन्फेरेंस स्पीड के साथ बड़े मॉडलों के प्रशिक्षण के लिए एक अनूठा दृष्टिकोण देता है।
पारंपरिक डेंस मॉडलों में, सभी इनपुट्स के लिए सभी पैरामीटर्स उपयोग होते हैं। स्पार्सिटी इसके विपरीत, इनपुट के आधार पर केवल सिस्टम के कुछ हिस्सों को चलाने की अनुमति देती है, जिससे कम्प्यूटेशन में उल्लेखनीय कमी आती है।
एक उदाहरण Microsoft का ट्रांसलेशन API, Z-code है। Z-code में MoE आर्किटेक्चर अत्यधिक पैमाने के मॉडल पैरामीटर्स को सपोर्ट करता है जबकि कम्प्यूट को स्थिर रखता है।
कंप्यूटर विज़न
Google के V-MoEs, जो Vision Transformers (ViT) पर आधारित स्पार्स आर्किटेक्चर है, कंप्यूटर विज़न कार्यों में MoE की प्रभावशीलता को दर्शाते हैं।
छवियों को छोटे पैच में विभाजित करके और उन्हें गेटिंग/राउटिंग लेयर को भेजकर, V-MoEs प्रत्येक पैच के लिए सबसे उपयुक्त एक्सपर्ट्स को गतिशील रूप से चुन सकते हैं, और इस प्रकार सटीकता और दक्षता दोनों का अनुकूलन करते हैं।
इस दृष्टिकोण का एक उल्लेखनीय लाभ इसका लचीलापन है। आप प्रति टोकन चुने जाने वाले एक्सपर्ट्स की संख्या घटाकर समय और कम्प्यूट की बचत कर सकते हैं—वह भी मॉडल वेट्स पर किसी और प्रशिक्षण के बिना।
रिकमेंडेशन सिस्टम्स
MoE का सफल उपयोग रिकमेंडेशन सिस्टम्स में भी हुआ है। उदाहरण के लिए, Google के शोधकर्ताओं ने YouTube वीडियो रिकमेंडेशन के लिए MMoE (Multi-Gate Mixture of Experts) आधारित रैंकिंग सिस्टम का प्रस्ताव रखा है।
वे अपने टास्क उद्देश्य को दो श्रेणियों में समूहित करते हैं: एंगेजमेंट और सैटिस्फैक्शन। रिट्रीवल स्टेप से मिले कैंडिडेट वीडियो की सूची को देखते हुए, उनका रैंकिंग सिस्टम कैंडिडेट, यूज़र और कॉन्टेक्स्ट फीचर्स का उपयोग करके उपयोगकर्ता व्यवहार की इन दोनों श्रेणियों से संबद्ध प्रायिकताओं की भविष्यवाणी करना सीखता है।
ध्यान देने वाली एक बात यह है कि उन्होंने इनपुट पर सीधे MoE लेयर लागू नहीं की, क्योंकि इनपुट की उच्च विमीयता मॉडल प्रशिक्षण और सर्विंग लागत को काफी बढ़ा देती।
MoE का उद्योग में कई अनुप्रयोगों के लिए बड़े पैमाने पर अपनाया जाना देखा गया है। इसकी लर्निंग प्रक्रिया कार्य को उपयुक्त उप-कार्यों में विभाजित करती है, जिनमें से प्रत्येक को एक बहुत सरल एक्सपर्ट नेटवर्क द्वारा हल किया जा सकता है। यह क्षमता समानांतर रूप से प्रशिक्षण और तेज़ इन्फेरेंस में बदल जाती है, जिससे MoE बड़े पैमाने के सिस्टम्स के लिए आकर्षक बनता है।
Mixture of Experts (MoE): चुनौतियाँ
उच्च थ्रूपुट वाले, अनेक मशीनों से जुड़े परिदृश्यों में एक्सपर्ट्स विशेष रूप से लाभकारी होते हैं। एक निश्चित प्री-ट्रेनिंग कम्प्यूट बजट को देखते हुए, स्पार्स मॉडल अधिक कुशल हो सकता है।
हालाँकि, स्पार्स मॉडलों को निष्पादन के दौरान पर्याप्त मेमोरी की ज़रूरत होती है, क्योंकि सभी एक्सपर्ट्स को मेमोरी में रखना पड़ता है। कम VRAM वाले सिस्टम्स में यह एक बड़ी सीमा हो सकती है, जहाँ ऐसे मॉडल संघर्ष कर सकते हैं।
आइए MoE की अन्य सीमाओं का पता लगाएँ।
ट्रेनिंग की जटिलता
MoE मॉडलों को प्रशिक्षित करना एकल मॉडल के प्रशिक्षण से अधिक जटिल होता है। कारण यह हैं:
- समन्वय: आपको गेटिंग नेटवर्क से सीखवाना होता है कि वह इनपुट्स को सही एक्सपर्ट्स तक रूट करे, जबकि प्रत्येक एक्सपर्ट डेटा के अलग-अलग हिस्सों में विशेषज्ञ बनता है। इस संतुलन को साधना कठिन हो सकता है।
- ऑप्टिमाइज़ेशन: जॉइंट ट्रेनिंग में प्रयुक्त लॉस फ़ंक्शन को एक्सपर्ट्स और गेटिंग नेटवर्क—दोनों के प्रदर्शन में संतुलन बनाना पड़ता है, जिससे ऑप्टिमाइज़ेशन प्रक्रिया जटिल हो जाती है।
- हाइपरपैरामीटर ट्यूनिंग: MoE मॉडलों में अधिक हाइपरपैरामीटर्स होते हैं, जैसे एक्सपर्ट्स की संख्या और गेटिंग नेटवर्क की आर्किटेक्चर। इनका ट्यून करना समयसाध्य और जटिल हो सकता है।
इन्फेरेंस दक्षता
MoE मॉडलों में इन्फेरेंस कुछ कारणों से कम दक्ष हो सकता है:
- गेटिंग नेटवर्क: प्रत्येक इनपुट के लिए सही एक्सपर्ट्स तय करने हेतु गेटिंग नेटवर्क चलाना पड़ता है। यह अतिरिक्त कम्प्यूटेशन जोड़ता है।
- एक्सपर्ट चयन और सक्रियण: यद्यपि प्रत्येक इनपुट के लिए केवल कुछ एक्सपर्ट्स ही सक्रिय होते हैं, फिर भी उन्हें चुनना और सक्रिय करना ओवरहेड जोड़ता है, जिससे इन्फेरेंस समय बढ़ सकता है।
- पैरेललिज़्म: कई एक्सपर्ट्स को समानांतर चलाना चुनौतीपूर्ण हो सकता है, खासकर सीमित कम्प्यूट संसाधनों वाले वातावरण में। प्रभावी पैरेललिज़्म के लिए उन्नत शेड्यूलिंग और संसाधन प्रबंधन की आवश्यकता होती है।
बढ़ा हुआ मॉडल आकार
एकाधिक एक्सपर्ट्स होने के कारण MoE मॉडल एकल मॉडलों की तुलना में बड़े होते हैं:
- स्टोरेज आवश्यकताएँ: कई एक्सपर्ट नेटवर्क्स और गेटिंग नेटवर्क को संग्रहीत करना कुल स्टोरेज जरूरतें बढ़ा देता है, जो स्टोरेज-सीमित वातावरण में बाधा बन सकता है।
- मेमोरी उपयोग: प्रशिक्षण और इन्फेरेंस में अधिक मेमोरी लगती है क्योंकि कई मॉडलों को एक साथ मेमोरी में लोड और बनाए रखना पड़ता है। संसाधन-सीमित सेटिंग्स में यह समस्या पैदा कर सकता है।
- डिप्लॉयमेंट चुनौतियाँ: आकार और जटिलता के कारण MoE मॉडलों को डिप्लॉय करना कठिन होता है। विभिन्न प्लेटफॉर्म्स, जिनमें एज डिवाइसेस भी शामिल हैं, पर कुशल डिप्लॉयमेंट के लिए अतिरिक्त ऑप्टिमाइज़ेशन और इंजीनियरिंग प्रयासों की ज़रूरत हो सकती है।
निष्कर्ष
इस लेख में, हमने Mixture of Experts (MoE) तकनीक का अध्ययन किया—जो जटिल कार्यों और विविध डेटा को संभालने के लिए न्यूरल नेटवर्क्स को स्केल करने का एक उन्नत दृष्टिकोण है। MoE कई विशिष्ट एक्सपर्ट्स और एक गेटिंग नेटवर्क का उपयोग करके इनपुट्स को प्रभावी ढंग से रूट करता है।
हमने MoE के मूल घटकों—एक्सपर्ट नेटवर्क्स और गेटिंग नेटवर्क—को कवर किया, और इसके प्रशिक्षण तथा इन्फेरेंस प्रक्रियाओं पर चर्चा की।
बेहतर प्रदर्शन, स्केलेबिलिटी और अनुकूलनशीलता जैसे लाभों पर प्रकाश डाला गया, साथ ही नेचुरल लैंग्वेज प्रोसेसिंग, कंप्यूटर विज़न और रिकमेंडेशन सिस्टम्स में अनुप्रयोगों का उल्लेख किया गया।
ट्रेनिंग की जटिलता और मॉडल आकार जैसी चुनौतियों के बावजूद, MoE AI क्षमताओं को आगे बढ़ाने का एक आशाजनक तरीका पेश करता है।

सीनियर GenAI इंजीनियर और कंटेंट क्रिएटर, जिन्होंने GenAI और डेटा साइंस पर ज्ञान साझा करके 2 करोड़ व्यूज़ हासिल किए हैं।
बड़े लार्ज लैंग्वेज मॉडल्स (LLMs) को प्रशिक्षित करना अक्सर भारी कम्प्यूटेशनल संसाधनों की मांग करता है, जो कई संगठनों और शोधकर्ताओं के लिए बाधा बन सकता है।
यह चुनौती mixture of experts (MoE) तकनीक दूर करती है, जो बड़े मॉडलों को छोटे, विशिष्ट नेटवर्क्स में विभाजित करती है।
MoE की अवधारणा 1991 के शोधपत्र Adaptive Mixture of Local Experts से आई। तब से, MoE का उपयोग मल्टी-ट्रिलियन पैरामीटर वाले मॉडलों में हुआ है, जैसे 1.6 ट्रिलियन पैरामीटर वाले ओपन-सोर्स Switch Transformers।
इस लेख में, मैं MoE का गहन विश्लेषण प्रस्तुत करूंगा, जिसमें इसके उपयोग, लाभ और चुनौतियाँ शामिल हैं।