शब्दों के बीच संबंध
प्रत्येक वेक्टर एक विशिष्ट परिचायक जैसा है जो शब्द के अर्थ के साथ-साथ उसके अन्य शब्दों से संबंधों को भी समेटे रहता है। समान परिभाषा वाले शब्द अक्सर इस संख्यात्मक स्पेस में एक-दूसरे के करीब होते हैं, ठीक मानचित्र पर पास-पास बिंदुओं की तरह। यह नज़दीकी शब्दों के अर्थ-संबंधों को उजागर करती है।
निम्न 3D स्कैटर प्लॉट शब्दों के लिए वेक्टर एम्बेडिंग्स की अवधारणा को दर्शाता है। स्पेस का प्रत्येक बिंदु एक शब्द को दर्शाता है, जिसकी स्थिति उसके वेक्टर एम्बेडिंग द्वारा निर्धारित होती है। साथ सिमटे नीले बिंदु जानवर-संबंधी शब्दों (“Cat,” “Dog,” “Pet,” “Animal”) को दिखाते हैं, जबकि लाल बिंदु वाहन-संबंधी शब्दों (“Car,” “Vehicle”) को। बिंदुओं की निकटता अर्थगत समानता दर्शाती है—संबंधित अर्थ वाले शब्द इस वेक्टर स्पेस में एक-दूसरे के निकट स्थित होते हैं।
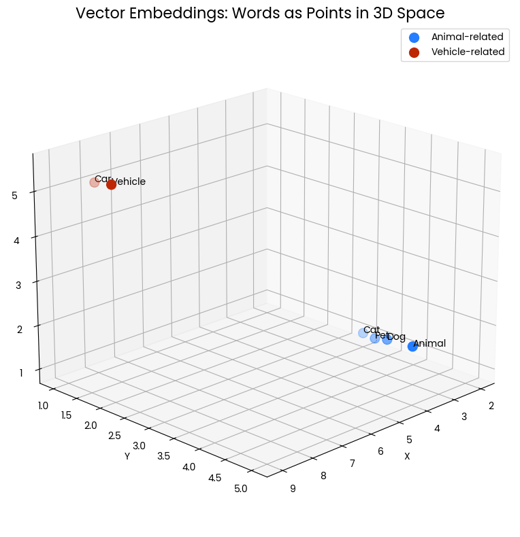
आकृति 1: 3-आयामी स्पेस में शब्दों के दो समूह। निकटता अर्थगत समानता को दर्शाती है।
उदाहरण के तौर पर, “Cat” और “Dog” एक-दूसरे के पास हैं, जो सामान्य पालतू जानवरों के रूप में उनकी साझा विशेषताओं को दर्शाता है। इसी तरह, “Car” और “Vehicle” पास हैं, जो उनके संबंधित अर्थों को दिखाता है। जबकि जानवरों का समूह वाहनों के समूह से काफ़ी दूर है, यह दर्शाने के लिए कि ये अवधारणा-समूह अर्थ की दृष्टि से भिन्न हैं।
यह स्थानिक निरूपण हमें दृश्य रूप से समझने देता है कि वेक्टर एम्बेडिंग्स शब्दों के संबंधों को कैसे पकड़ती और प्रस्तुत करती हैं। यह भाषाई अर्थ को ज्यामितीय संबंधों में बदल देता है जिन्हें गणितीय रूप से मापा और विश्लेषित किया जा सकता है।
वेक्टर एम्बेडिंग्स अर्थ को कैसे पकड़ती हैं
वेक्टर एम्बेडिंग्स विशेष रूप से नेचुरल लैंग्वेज प्रोसेसिंग (NLP) में आम हैं, जहाँ ध्यान व्यक्तिगत शब्दों के निरूपण पर होता है। ये संख्यात्मक निरूपण मनमाने ढंग से नहीं दिए जाते—इन्हें विशाल मात्रा के पाठ-डेटा से सीखा जाता है। देखें यह कैसे काम करता है।
Word2Vec के साथ नेचुरल लैंग्वेज प्रोसेसिंग
शब्दों को वेक्टर सौंपने की NLP तकनीकों में से एक Word2Vec है। यह एक मशीन लर्निंग मॉडल है जो बड़े पाठ-कोर्पस में संदर्भ के आधार पर शब्दों को जोड़ना सीखता है। आप इसे ऐसा भाषा मॉडल मान सकते हैं जो आसपास के शब्दों के आधार पर किसी शब्द की भविष्यवाणी करने की कोशिश करता है।
ऐसा करते हुए, यह अप्रत्यक्ष रूप से शब्दों के बीच संबंध सीखता है, अर्थगत और व्याकरणिक जानकारी को पकड़ता है। ये सीखे गए संबंध फिर संख्यात्मक वेक्टरों में एन्कोड कर दिए जाते हैं, जिन्हें विभिन्न NLP कार्यों में उपयोग किया जा सकता है। अंततः, जो शब्द अक्सर साथ आते हैं या समान संदर्भों में दिखाई देते हैं, उनकी एम्बेडिंग स्पेस में वेक्टर एक-दूसरे के क़रीब होते हैं।
Word2Vec शब्द-संबंधों को पकड़ने के लिए दो मुख्य आर्किटेक्चर अपनाता है: Continuous Bag-of-Words (CBOW) और Skip-gram।
|
आर्किटेक्चर |
प्रक्रिया |
संगणकीय दक्षता |
पकड़े गए संबंध |
बार-बार आने वाले शब्दों के प्रति संवेदनशीलता |
|
CBOW |
आसपास के संदर्भ-शब्दों के आधार पर लक्ष्य शब्द की भविष्यवाणी करता है |
तेज़ प्रशिक्षण |
व्याकरणिक (सिंटैक्टिक) संबंधों को बेहतर पकड़ता है |
अधिक बार आने वाले शब्दों के प्रति अधिक संवेदनशील |
|
Skip-gram |
लक्ष्य शब्द के आधार पर आसपास के संदर्भ-शब्दों की भविष्यवाणी करता है |
धीमा प्रशिक्षण |
अर्थगत (सेमांटिक) संबंधों को बेहतर पकड़ता है |
बार-बार आने वाले शब्दों के प्रति कम संवेदनशील |
Skip-gram का प्रशिक्षण CBOW से धीमा हो सकता है, लेकिन इसका जनरेटिव दृष्टिकोण आम तौर पर अधिक सटीक एम्बेडिंग्स देता है, खासकर दुर्लभ शब्दों के लिए।
एक उदाहरण देखें: एक विशाल पाठ-कोर्पस की कल्पना कीजिए। Word2Vec एक निश्चित विंडो में शब्दों के सह-अवस्थिति का विश्लेषण करता है। जैसे, वाक्य "The king and queen ruled the kingdom." में "king" और "queen" छोटी विंडो में साथ आते हैं। Word2Vec इस सह-अवस्थिति जानकारी को पकड़ता है।
असंख्य वाक्यों पर यह एल्गोरिद्म सांख्यिकीय मॉडल बनाता है। यह सीखता है कि "king" और "queen" जैसे शब्द अक्सर समान संदर्भों में आते हैं और इस जानकारी को संख्यात्मक वेक्टरों में एन्कोड कर देता है। नतीजतन, "king" और "queen" के वेक्टर एम्बेडिंग स्पेस में एक-दूसरे के और "apple" के वेक्टर से अधिक पास होंगे, जो शायद ही उसी संदर्भ में आता है।
वेक्टर स्पेस में यह निकटता "king" और "queen" के बीच अर्थगत समानता को दर्शाती है, जो भाषाई संबंधों को पकड़ने में Word2Vec की शक्ति दिखाती है।
वेक्टर एम्बेडिंग्स क्यों शक्तिशाली हैं
अब जब हम जान चुके हैं कि वेक्टर एम्बेडिंग्स क्या हैं और वे अर्थ कैसे पकड़ती हैं, तो एक कदम आगे बढ़ें और देखें कि वे किन कार्यों को संभव बनाती हैं।
जैसा कि हमने देखा, वेक्टर एम्बेडिंग्स अर्थगत समानता को मात्राबद्ध करने में उत्कृष्ट हैं। शब्द-वेक्टरों के बीच दूरी मापकर, हम तय कर सकते हैं कि अर्थ के स्तर पर शब्द कितने संबंधित हैं।
यह क्षमता समानार्थक और विलोम शब्द ढूँढने जैसे कार्यों को सशक्त बनाती है। समान परिभाषा वाले शब्दों के वेक्टर साथ-साथ समूहित होते हैं, जबकि विलोम शब्द कई आयाम साझा करते हुए भी उनके फर्क बताने वाले प्रमुख आयामों में काफ़ी दूर होते हैं।
यह जादू जटिल भाषाई पहेलियाँ सुलझाने तक फैला है। वेक्टर एम्बेडिंग्स हमें शब्द-वेक्टरों पर अंकगणितीय क्रियाएँ करने देती हैं, जिससे छिपे संबंध खुलते हैं। उदाहरण के लिए, "king का queen से वही संबंध है जो man का woman से"—इसे "king" के वेक्टर से "man" का वेक्टर घटाकर और "woman" में जोड़कर हल किया जा सकता है। परिणामी वेक्टर "queen" के वेक्टर के बहुत क़रीब आता है, जो भाषाई पैटर्न पकड़ने में एम्बेडिंग्स की शक्ति दिखाता है।
वाक्य एम्बेडिंग्स
एम्बेडिंग्स की बहुमुखी प्रतिभा केवल शब्द-स्तर तक सीमित नहीं है। वाक्य एम्बेडिंग्स पूरे वाक्यों के समग्र अर्थ को पकड़ती हैं। वाक्यों को सघन वेक्टरों के रूप में निरूपित करके, हम अलग-अलग पाठों के बीच अर्थगत समानता माप सकते हैं।
जैसे शब्द एम्बेडिंग्स उच्च-आयामी स्पेस में बिंदु होती हैं, वैसे ही वाक्य एम्बेडिंग्स भी वेक्टर होती हैं। हालांकि, वाक्य-स्तरीय जटिलता के कारण वे आमतौर पर अधिक आयाम वाली होती हैं। हम इन वेक्टरों पर गणितीय क्रियाएँ कर अर्थगत समानता माप सकते हैं, जिससे सूचना पुनर्प्राप्ति, पाठ वर्गीकरण और भावना विश्लेषण जैसे अधिक जटिल कार्य संभव होते हैं।
एक सरल तरीका है वाक्य के सभी शब्दों की एम्बेडिंग्स का औसत लेना। भले सरल हो, यह अक्सर एक अच्छा बेसलाइन देता है। अधिक जटिल अर्थगत और व्याकरणिक जानकारी पकड़ने के लिए, रिकरेंट न्यूरल नेटवर्क (RNNs) और ट्रांसफॉर्मर-आधारित मॉडल अपनाए जाते हैं:
|
आर्किटेक्चर |
प्रोसेसिंग |
संदर्भात्मक समझ |
संगणकीय दक्षता |
|
RNNs |
अनुक्रमिक |
स्थानीय संदर्भ पर फोकस |
लंबे क्रमों के लिए कम दक्ष |
|
ट्रांसफॉर्मर-आधारित मॉडल |
समानांतर |
दीर्घ-सीमा निर्भरताएँ पकड़ सकते हैं |
काफी दक्ष, लंबे क्रमों के लिए भी |
काफ़ी समय तक RNNs प्रमुख आर्किटेक्चर रहे, पर ट्रांसफॉर्मर्स ने कई NLP कार्यों, जिनमें वाक्य एम्बेडिंग निर्माण भी शामिल है, में प्रदर्शन और दक्षता के मामले में उन्हें पीछे छोड़ दिया है।
फिर भी, जहाँ अनुक्रमिक प्रोसेसिंग अहम है, वहाँ RNNs की अब भी उपयोगिता है। इसके अलावा, कई प्री-ट्रेंड वाक्य एम्बेडिंग मॉडल उपलब्ध हैं जो टेक्स्ट संक्षेपण, ज्ञान-आधारित प्रश्नोत्तर या नेम्ड एंटिटी रिकग्निशन (NER) जैसे विभिन्न कार्यों के लिए तुरंत समाधान देते हैं।
पाठ से आगे
वेक्टर एम्बेडिंग्स केवल पाठ तक सीमित नहीं हैं। निम्नलिखित अनुप्रयोग विभिन्न क्षेत्रों में एम्बेडिंग्स के व्यापक प्रभाव को रेखांकित करते हैं:
- छवियों को संख्यात्मक निरूपणों में बदला जा सकता है, जिससे इमेज सर्च, ऑब्जेक्ट रिकग्निशन और इमेज जनरेशन संभव होती है।
- प्रोडक्ट एम्बेडिंग्स ई-कॉमर्स में व्यक्तिगत सिफारिशें आसान बनाती हैं, उपयोगकर्ता की पसंद और खरीद-इतिहास के आधार पर समान उत्पाद खोजती हैं।
- ऑडियो डेटा को एम्बेडिंग्स में बदला जा सकता है, जिससे संगीत खोज और वाक् पहचान में क्रांति आती है।
- Tाइम-सीरीज़ डेटा, जैसे शेयर कीमतें या सेंसर रीडिंग्स, को एम्बेडिंग्स में बदलकर छिपे पैटर्न खोजे जा सकते हैं और सटीक भविष्यवाणियाँ की जा सकती हैं।
- ग्राफ डेटा, जैसे सोशल नेटवर्क या नॉलेज बेस, को वेक्टरों के रूप में निरूपित कर जटिल संबंधों का विश्लेषण और मूल्यवान अंतर्दृष्टियाँ निकाली जा सकती हैं।
- दस्तावेज़ों को एम्बेडिंग्स में बदलकर कुशल सर्च इंजन और बुद्धिमान दस्तावेज़-संगठन संचालित किए जा सकते हैं।
- कोड स्निपेट्स को एम्बेडिंग्स के रूप में निरूपित किया जा सकता है, जिससे उन्नत कोड सर्च और अनुशंसा प्रणालियाँ संभव होती हैं।
वेक्टर एम्बेडिंग्स के व्यावहारिक उपयोग
अब जब हमने देख लिया है कि वेक्टर एम्बेडिंग्स कैसे काम करती हैं और किस तरह के डेटा को संभाल सकती हैं, तो हम विशिष्ट उपयोग-मामले देख सकते हैं। सबसे प्रसिद्ध उदाहरणों में से एक से शुरू करें: लार्ज लैंग्वेज मॉडल्स (LLMs)।
ChatGPT , Claud या Google Gemini जैसे LLMs बड़े पैमाने पर वेक्टर एम्बेडिंग्स पर निर्भर रहते हैं। ये मॉडल शब्दों, वाक्यांशों और यहाँ तक कि पूरे वाक्यों को उच्च-आयामी स्पेस में सघन वेक्टरों के रूप में निरूपित करना सीखते हैं। मूल रूप से, वेक्टर एम्बेडिंग्स भाषा मॉडलों को शब्दों और उनके संबंधों की अर्थगत समझ देती हैं, जो उनकी प्रभावशाली क्षमताओं की रीढ़ है।
पाठ का संख्यात्मक निरूपण LLMs को मानव-सदृश पाठ समझने और जनरेट करने में सक्षम बनाता है, जिससे अनुवाद, संक्षेपण और प्रश्नोत्तर जैसे कार्य संभव होते हैं। इससे कंटेंट निर्माण और ग्राहक सेवा से लेकर शिक्षा और अनुसंधान तक अनेक क्षेत्रों में अनुप्रयोगों के द्वार खुलते हैं।
LLMs से आगे
वेक्टर एम्बेडिंग्स पारंपरिक सर्च इंजनों के लिए एक वैकल्पिक दृष्टिकोण भी प्रदान कर सकती हैं, जो प्रायः कीवर्ड-मैचिंग पर निर्भर होते हैं। खोज-प्रश्नों और वेब पेजों दोनों को एम्बेडिंग्स के रूप में निरूपित करके, सर्च इंजन प्रश्नों और लक्षित पृष्ठों के पीछे की अर्थगत मंशा को समझ सकते हैं। इससे वे सटीक कीवर्ड-मिलान से परे प्रासंगिक पृष्ठों की पहचान कर अधिक सटीक और सूचनाप्रद परिणाम दे पाते हैं।
वेक्टर एम्बेडिंग्स की एक और ताकत असामान्य डेटा बिंदुओं या पैटर्न की पहचान में है। एल्गोरिद्म वेक्टरों के रूप में निरूपित डेटा बिंदुओं के बीच दूरी की गणना कर उन बिंदुओं को चिह्नित कर सकते हैं जो सामान्य से काफ़ी दूर हैं। यह तकनीक धोखाधड़ी पहचान, नेटवर्क सुरक्षा और औद्योगिक प्रक्रिया निगरानी में उपयोगी है।
वेक्टर एम्बेडिंग्स भाषा-अंतराल पाटने में भी अहम भूमिका निभाती हैं। हमारे "king" और "queen" वाले उदाहरण की तरह, शब्दों के अर्थगत और व्याकरणिक संबंधों का वेक्टर-आधारित निरूपण भाषाओं के पार भी पकड़ा जा सकता है। तदनुसार, लक्ष्य भाषा में वेक्टर समानता के आधार पर संबंधित शब्द या वाक्यांश ढूँढना संभव होता है, जिससे DeepL जैसी मशीन अनुवाद प्रणालियाँ अधिक सटीक और प्रवाहपूर्ण अनुवाद बना पाती हैं।
अंततः, वेक्टर एम्बेडिंग्स प्रभावी अनुशंसा प्रणालियाँ बनाने में सहायक हैं। उपयोगकर्ताओं और आइटमों को एम्बेडिंग्स के रूप में निरूपित करके, अनुशंसा प्रणालियाँ वेक्टर की निकटता के आधार पर समान उपयोगकर्ता या आइटम पहचान सकती हैं। इससे उत्पादों, फ़िल्मों, संगीत और अन्य कंटेंट के लिए वैयक्तिकृत सिफारिशें संभव होती हैं। उदाहरण के लिए, जो उपयोगकर्ता किसी दी गई फ़िल्म जैसी फ़िल्मों का आनंद लेते हैं, वे संभवतः उन अन्य फ़िल्मों को भी पसंद करेंगे जिनकी एम्बेडिंग्स समान हों।
निष्कर्ष
जैसा कि आप देख सकते हैं, वेक्टर एम्बेडिंग्स एक अत्यंत शक्तिशाली साधन के रूप में उभरी हैं। जटिल डेटा को ऐसे स्वरूप में बदलकर जिसे मशीन लर्निंग एल्गोरिद्म आसानी से समझते हैं, ये विभिन्न क्षेत्रों में असीमित संभावनाएँ खोलती हैं।
इस लेख से मुख्य निष्कर्ष:
- वेक्टर एम्बेडिंग्स डेटा के लिए डिजिटल फिंगरप्रिंट की तरह काम करती हैं, शब्दों, छवियों और यहाँ तक कि ध्वनियों को संख्यात्मक निरूपणों में बदलती हैं।
- ये निरूपण डेटा बिंदुओं के बीच अर्थगत संबंधों को पकड़ते हैं, जिससे समान आइटम ढूँढना या छिपे पैटर्न उजागर करना संभव होता है।
- Word2Vec जैसी तकनीकें विशाल पाठ-डेटा का उपयोग कर शब्द-संबंध सीखती हैं और उन्हें वेक्टरों में एन्कोड करती हैं।
- ये वेक्टर न केवल LLMs को शक्ति देते हैं, बल्कि अधिक सटीक सर्च परिणाम, अनुवाद और धोखाधड़ी-पहचान एल्गोरिद्म भी सक्षम बनाते हैं।
- वेक्टर एम्बेडिंग्स की ठोस समझ NLP, कंप्यूटर विज़न और अनुशंसा प्रणालियों जैसे क्षेत्रों की खोज के लिए सशक्त आधार बनाती है।
आप इन संसाधनों से वेक्टर एम्बेडिंग्स के बारे में और सीख सकते हैं:
कल्पना कीजिए कि आप कंप्यूटर को सेब और संतरे में फर्क सिखा रहे हैं। हमारे लिए यह आसान है, पर केवल संख्याएँ समझने के लिए बने एक मशीन के लिए यह जटिल चुनौती है।
यहीं पर वेक्टर एम्बेडिंग्स काम आती हैं। ये गणितीय तरकीबें शब्दों, छवियों और अन्य डेटा को ऐसे संख्यात्मक निरूपणों में बदल देती हैं जिन्हें कंप्यूटर आसानी से समझ और संसाधित कर सकें।
वेक्टर एम्बेडिंग्स जानकारी की दुनिया को संख्यात्मक स्पेस में मैप करके संभावनाओं का एक विशाल ब्रह्मांड खोलती हैं।
वेक्टर एम्बेडिंग्स क्या हैं?
वेक्टर एम्बेडिंग्स शब्दों या अन्य डेटा-इकाइयों के लिए डिजिटल फिंगरप्रिंट जैसी होती हैं। अक्षरों या छवियों के बजाय, ये संख्याओं का उपयोग करती हैं जो वेक्टर नामक एक विशेष संरचना में व्यवस्थित होती हैं—यानी मानों की क्रमबद्ध सूची।
हर वेक्टर को बहु-आयामी स्पेस में एक बिंदु समझिए, जहाँ उसकी स्थिति उस शब्द या डेटा के बारे में महत्वपूर्ण जानकारी समेटे रहती है।
आपने गणित में वेक्टर को दिशा और परिमाण वाले तीरों के रूप में पढ़ा होगा। वेक्टर एम्बेडिंग्स इस बुनियादी विचार को साझा करती हैं, लेकिन ये अनगिनत आयामों वाले स्पेस में काम करती हैं।
यह अत्यधिक आयामिकता मानवीय भाषा की सूक्ष्मताओं—जैसे लहजा, संदर्भ और व्याकरणिक गुण—को पकड़ने के लिए आवश्यक है। सोचिए एक वेक्टर जो न केवल "happy" और "sad" में फर्क करे, बल्कि "ecstatic," "content," या "melancholic" जैसे सूक्ष्म अंतर भी दर्शाए।
वेक्टर एम्बेडिंग्स जटिल डेटा को मशीन लर्निंग एल्गोरिद्म के अनुकूल स्वरूप में बदलने की एक मूल्यवान तकनीक हैं। उच्च-आयामी और श्रेणीबद्ध डेटा को निम्न-आयामी, सतत निरूपणों में बदलकर, एम्बेडिंग्स मॉडल के प्रदर्शन और संगणकीय दक्षता को बढ़ाती हैं, जबकि मूलभूत डेटा पैटर्न सुरक्षित रखती हैं।
यह दिखाने के लिए कि बहु-आयामी वेक्टर स्पेस कैसे परिभाषित हो सकता है, यहाँ आठ उदाहरणात्मक आयामों और उनके मान-सीमा की एक तालिका दी गई है:
फीचर
विवरण
सीमा
Concreteness
किसी शब्द का कितना ठोस या अमूर्त होना
0 से 1
Emotional valence
शब्द से जुड़ी सकारात्मकता या नकारात्मकता
-1 से 1
Frequency
बड़े पाठ-कोर्पस में शब्द कितनी बार आता है
0 से 1
Length
शब्द में वर्णों की संख्या
0 से 1
Part of speech
संज्ञा, क्रिया, विशेषण, अन्य के लिए वन-हॉट एन्कोडेड मानों का सेट
4x [0,1]
Formality
शब्द से जुड़ी औपचारिकता का स्तर
0 से 1
Specificity
शब्द कितना विशिष्ट या सामान्य है
0 से 1
Sensory association
इंद्रियगत अनुभवों से शब्द का संबंध किस हद तक है
0 से 1
उदाहरण के लिए, "cat" शब्द का वेक्टर कुछ ऐसा हो सकता है: [0.9, 0.2, 0.7, 0.3, 1, 0, 0, 0, 0.4, 0.8, 0.9] और "freedom" का: [0.1, 0.8, 0.6, 0.7, 1, 0, 0, 0, 0.7, 0.3, 0.2]।