
Last chance! 50% off DataCamp Premium
Sale ends in
ट्रांसफर लर्निंग एक तकनीक है जो मशीनों को किसी पहले कार्य से अर्जित ज्ञान का उपयोग दूसरे कार्य के बारे में सामान्यीकरण सुधारने के लिए करने देती है। यह ChatGPT और Google Gemini जैसे मॉडलों के विकास के पीछे एक बुनियादी अवधारणा है, और लंबे दस्तावेजों का सार निकालना, जटिल निबंध लिखना, यात्राएँ योजनाबद्ध करना, या यहाँ तक कि कविताएँ और गीत लिखना जैसे कई महत्वपूर्ण और उपयोगी कार्यों में सहायक है।
इस मार्गदर्शिका में, हम ट्रांसफर लर्निंग को गहराई से समझेंगे। हम इसकी परिभाषा, डीप लर्निंग और आधुनिक जेनेरेटिव AI मॉडलों के लिए इसकी प्रासंगिकता, और इस तकनीक की चुनौतियों व सीमाओं पर चर्चा करेंगे। हम आगे सीखने के लिए कुछ संसाधन भी सुझाएँगे। क्या आप तैयार हैं? चलिए शुरू करते हैं।
ट्रांसफर लर्निंग एक तकनीक है जहाँ किसी विशेष कार्य के लिए विकसित मॉडल को दूसरे कार्य के लिए प्रारंभिक बिंदु के रूप में पुन: उपयोग किया जाता है। दूसरे शब्दों में, आप किसी प्री-ट्रेंड मशीन लर्निंग मॉडल के घटकों को नए, लेकिन संबंधित, उद्देश्यों वाले मॉडलों में फिर से लागू करते हैं।
यह अवधारणा मनुष्यों द्वारा नई कौशल सीखने के तरीके के समान है। उदाहरण लेते हैं: मान लीजिए आप एक कुशल गिटार वादक हैं और यूकुलेले सीखने का निर्णय लेते हैं। गिटार का आपका पूर्व अनुभव आपके सीखने की प्रक्रिया को तेज करेगा। ऐसा इसलिए क्योंकि गिटार बजाने के लिए आवश्यक कई कौशल और ज्ञान—जैसे फिंगर पोजीशन, स्ट्रमिंग पैटर्न, फ़्रेटबोर्ड की समझ, म्यूज़िक थ्योरी, और रिदम—यूकुलेले बजाने में भी लागू होते हैं।
AI में, ट्रांसफर लर्निंग आपको पूर्व प्रशिक्षण का लाभ उठाकर नए, संबंधित समस्याओं को अधिक कुशलता से हल करने देती है, जिससे समय और संगणन संसाधन दोनों की बचत होती है।
न्यूरल नेटवर्क विकसित करते समय ट्रांसफर लर्निंग तकनीकों को अपनाने के कई ठोस कारण हैं, जिनमें शामिल हैं:
आइए तीन अवधारणाएँ देखें जो ट्रांसफर लर्निंग से संबंधित हैं: मल्टी-टास्क लर्निंग, फीचर एक्सट्रैक्शन, और फाइन-ट्यूनिंग।
मल्टी-टास्क लर्निंग में, एक ही मॉडल को एक साथ कई कार्य करने के लिए प्रशिक्षित किया जाता है। मॉडल में शुरुआती साझा लेयर्स होती हैं जो डेटा को सामान्य तरीके से प्रोसेस करती हैं, और उसके बाद प्रत्येक विशिष्ट कार्य के लिए अलग-अलग लेयर्स होती हैं। इससे मॉडल ऐसे सामान्य फीचर्स सीखता है जो सभी कार्यों के लिए उपयोगी होते हैं, साथ ही कार्य-विशिष्ट ऐसे फीचर्स भी सीखता है जो अधिक विशिष्ट होते हैं।
यह पैरेडाइम आधुनिक LLMs में व्यापक रूप से उपयोग होता है। सभी विवरण जानने के लिए हमारा Introduction to LLMs Course देखें।
फीचर एक्सट्रैक्शन में किसी प्री-ट्रेंड मॉडल का उपयोग करके डेटा से अर्थपूर्ण फीचर्स या निरूपण निकालना शामिल है। फिर इन फीचर्स को किसी विशिष्ट उद्देश्य पर केंद्रित नए मॉडल के इनपुट के रूप में उपयोग किया जाता है।
फीचर-आधारित ट्रांसफर लर्निंग, न्यूरल नेटवर्क की डेटा से फीचर्स निकालने की विशिष्ट क्षमताओं का लाभ उठाती है। फीचर एक्सट्रैक्शन के साथ, मॉडल इस तरह कहें तो यह "समझ" जाता है कि उदाहरण के लिए, किसी छवि को वर्गीकृत करने के लिए इनपुट का कौन-सा भाग महत्वपूर्ण है। व्यावहारिक रूप से इसका अर्थ है कि जब किसी मॉडल को नए कार्य पर लागू किया जाता है, तो केवल मॉडल की वे प्री-ट्रेंड प्रारंभिक और मध्यवर्ती लेयर्स लागू की जाती हैं जिनमें अधिक सामान्यीकृत होने योग्य ज्ञान होता है।
फाइन-ट्यूनिंग, फीचर एक्सट्रैक्शन से आगे बढ़ती है और आमतौर पर तब उपयोग होती है जब दोनों कार्य निकट से संबंधित न हों। इसमें किसी प्री-ट्रेंड मॉडल को लेकर उसे डोमेन-विशिष्ट डेटासेट पर आगे प्रशिक्षित करना शामिल है।
अधिकांश LLM मॉडल आज वैश्विक स्तर पर बहुत अच्छा प्रदर्शन करते हैं, लेकिन अक्सर विशिष्ट, कार्य-उन्मुख समस्याओं में चूक जाते हैं। फाइन-ट्यूनिंग मॉडल को विशिष्ट कार्यों के लिए बेहतर प्रदर्शन हेतु अनुकूलित करती है, जिससे वह वास्तविक दुनिया के अनुप्रयोगों में अधिक प्रभावी और बहुमुखी बनता है। यदि आप फाइन-ट्यूनिंग के बारे में और जानना चाहते हैं, तो हमारा Introductory Guide to fine-tuning LLMs देखें।
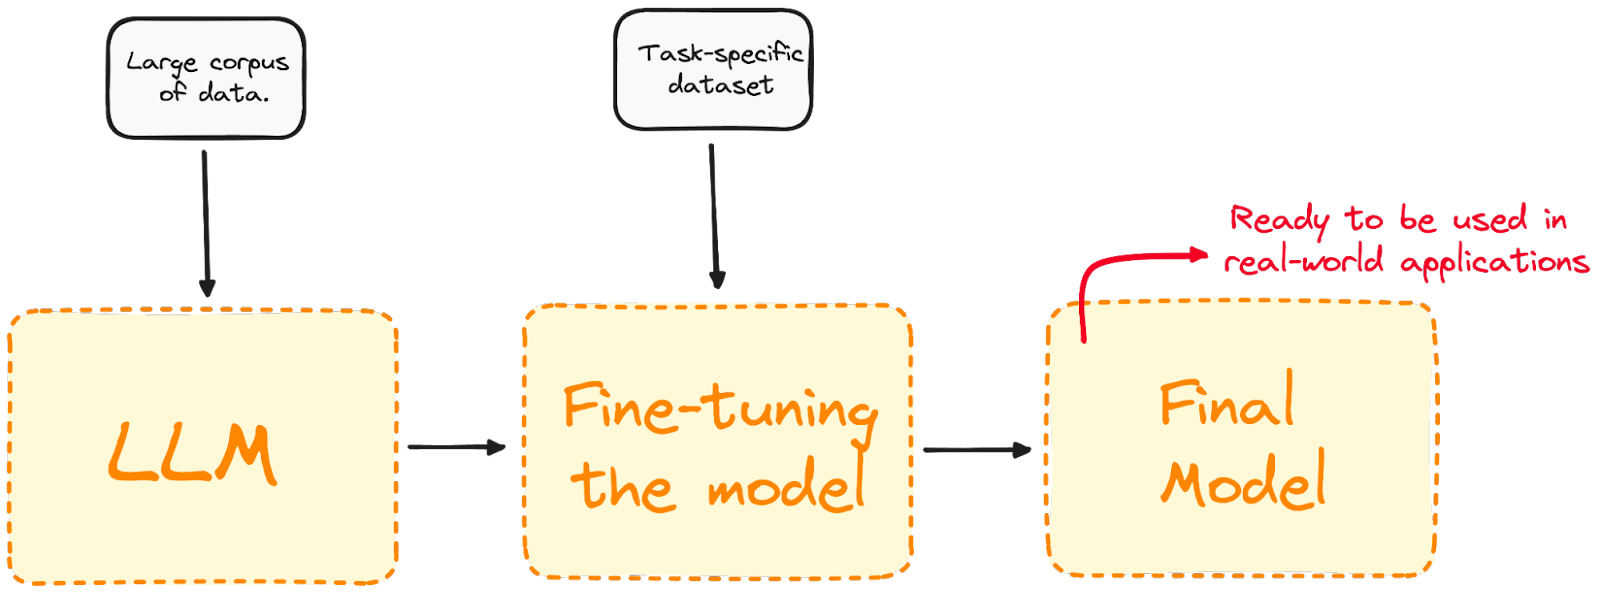 फाइन-ट्यूनिंग प्रक्रिया का दृश्यांकन। [DataCamp]
ट्रांसफर लर्निंग कई डेटा साइंस कार्यों के लिए एक सामान्य तकनीक है, जिनमें कंप्यूटर विज़न और नेचुरल लैंग्वेज प्रोसेसिंग शामिल हैं।
कंप्यूटर विज़न वह क्षेत्र है जहाँ ट्रांसफर लर्निंग विशेष रूप से फलदायी रही है। इस क्षेत्र में विकसित न्यूरल नेटवर्क को ऑब्जेक्ट डिटेक्शन और इमेज क्लासिफिकेशन जैसे कार्यों के लिए विशाल मात्रा में डेटा की आवश्यकता होती है।
कंप्यूटर विज़न में, न्यूरल नेटवर्क की शुरुआती लेयर्स छवियों में किनारों का पता लगाती हैं, जबकि मध्य लेयर्स आकार और आकृतियाँ पहचानती हैं। अंतिम लेयर्स को विशिष्ट कार्यों के अनुसार ढाला जाता है। ट्रांसफर लर्निंग हमें केवल अंतिम लेयर्स को फिर से प्रशिक्षित करके नए मॉडल बनाने देती है, जबकि शुरुआती और मध्य लेयर्स के वेट्स और बायस अपरिवर्तित रखे जाते हैं। ट्रांसफर लर्निंग की बदौलत, ऐसे नए मॉडल बनाना संभव है जो केवल नेटवर्क की अंतिम लेयर्स को फिर से प्रशिक्षित करते हैं, जबकि पहली और मध्यवर्ती लेयर्स के वेट्स और बायस यथावत रहते हैं।
आज, कंप्यूटर विज़न में कई प्री-ट्रेंड, सार्वजनिक न्यूरल नेटवर्क उपलब्ध हैं, उदाहरण के लिए:
NLP, AI की वह शाखा है जो प्राकृतिक भाषा के माध्यम से कंप्यूटर और मनुष्यों के बीच अंतःक्रिया पर केंद्रित है। उद्देश्य यह है कि कंप्यूटर को प्राकृतिक भाषा डेटा—टेक्स्ट या ऑडियो—की बड़ी मात्रा को प्रोसेस और विश्लेषित करने के लिए प्रोग्राम किया जाए।
NLP मॉडल विकसित करने में ट्रांसफर लर्निंग एक अहम भूमिका निभाती है। यह ऐसे प्री-ट्रेंड भाषा मॉडलों का उपयोग करने देती है जो सामान्य भाषा समझ या अनुवाद के लिए प्रयुक्त हुए हैं, और फिर उन्हें विशिष्ट NLP समस्याओं, जैसे सेंटिमेंट एनालिसिस या भाषा अनुवाद, के लिए फाइन-ट्यून किया जाता है। NLP के अनुप्रयोग लगभग असीम हैं और इनमें वॉयस असिस्टेंट और स्पीच रिकग्निशन शामिल हैं।
ट्रांसफर लर्निंग कुछ सबसे लोकप्रिय NLP मॉडलों के पीछे है, जिनमें शामिल हैं:
मूल रूप से, ट्रांसफर लर्निंग दक्षता बढ़ाने का एक डिज़ाइन दृष्टिकोण है। शून्य से मॉडल प्रशिक्षित करने के बजाय—जो विशेषकर अत्याधुनिक जेनेरेटिव AI मॉडलों के मामले में अपार संसाधन, धन, और समय माँगता है—ट्रांसफर लर्निंग पूर्व अर्जित ज्ञान का लाभ लेकर मॉडलों को नए कार्यों में अधिक तेज़ी और प्रभावी ढंग से सीखने देती है।
जब किसी दूसरे कार्य के लिए उपलब्ध डेटा कम हो, तो ट्रांसफर लर्निंग चमकती है। किसी प्री-ट्रेंड मॉडल के ज्ञान का उपयोग करके, यह ओवरफिटिंग रोकने और समग्र सटीकता बढ़ाने में मदद कर सकती है। हालांकि, ट्रांसफर लर्निंग अचूक नहीं है और इसमें ऐसी सीमाएँ व संभावित मुश्किलें हैं जिन्हें सावधानी से संबोधित करना चाहिए। ट्रांसफर लर्निंग की कुछ आम चुनौतियाँ हैं:
ट्रांसफर लर्निंग, न्यूरल नेटवर्क्स की दक्षता और क्षमता बढ़ाने का एक महत्वपूर्ण डिज़ाइन दृष्टिकोण है। यह कहना उचित होगा कि उपलब्ध कई ट्रांसफर लर्निंग तकनीकों के बिना मौजूदा AI क्रांति संभव नहीं होती।
यदि आप ट्रांसफर लर्निंग की बारीकियों के बारे में अधिक जानना चाहते हैं, तो DataCamp आपकी मदद के लिए है। आज ही शुरुआत करने के लिए हमारे LLMs और न्यूरल नेटवर्क्स पर समर्पित सामग्री देखें।
DataCamp के साथ सीखें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
