लर्निंग पाथ
मशीन लर्निंग फंडामेंटल्स में Python
16 घंटा
डेटा साइंस का निरंतर बढ़ता हुआ क्षेत्र डेटा पर टिका है, लेकिन बड़े, लेबलयुक्त डेटासेट जुटाना मॉडल विकास प्रक्रिया में एक बड़ी बाधा बन सकता है। यही वह जगह है जहाँ फ्यू-शॉट लर्निंग सामने आती है—एक क्रांतिकारी तरीका, जो हमें कुछ ही उदाहरणों से मूल्यवान अंतर्दृष्टि निकालने में सक्षम बनाता है।
पारंपरिक सुपरवाइज्ड लर्निंग विधियों के विपरीत, जिन्हें भारी मात्रा में डेटा चाहिए, फ्यू-शॉट लर्निंग मॉडल्स को तेज़ी से सीखने और अनुकूलित होने की शक्ति देती है—विशेषकर उन क्षेत्रों में जहाँ डेटा दुर्लभ, एकत्र करना महंगा, या प्रकृति में संवेदनशील होता है।
यह लेख फ्यू-शॉट लर्निंग का व्यापक परिचय देता है—इसके महत्व, कार्य-तंत्र, और विभिन्न उद्योगों में इसके विविध उपयोगों पर प्रकाश डालते हुए।
फ्यू-शॉट लर्निंग (FSL) मशीन लर्निंग का एक उपक्षेत्र है, जहाँ मॉडल बहुत कम प्रशिक्षण उदाहरणों के आधार पर पैटर्न पहचानना और पूर्वानुमान लगाना सीखते हैं। यह पारंपरिक सुपरवाइज्ड लर्निंग से भिन्न है, जिसमें प्रभावी प्रशिक्षण के लिए प्रायः बहुत अधिक लेबलयुक्त डेटा चाहिए होता है।
FSL रटना (memorization) की बजाय सामान्यीकरण पर ज़ोर देता है। शुरुआती महत्वपूर्ण कार्यों में से एक था “Language Models are Few Shot Learners” (Tom B. Brown और सहलेखक), जिसने व्यापक फाइन-ट्यूनिंग की आवश्यकता को चुनौती दी।
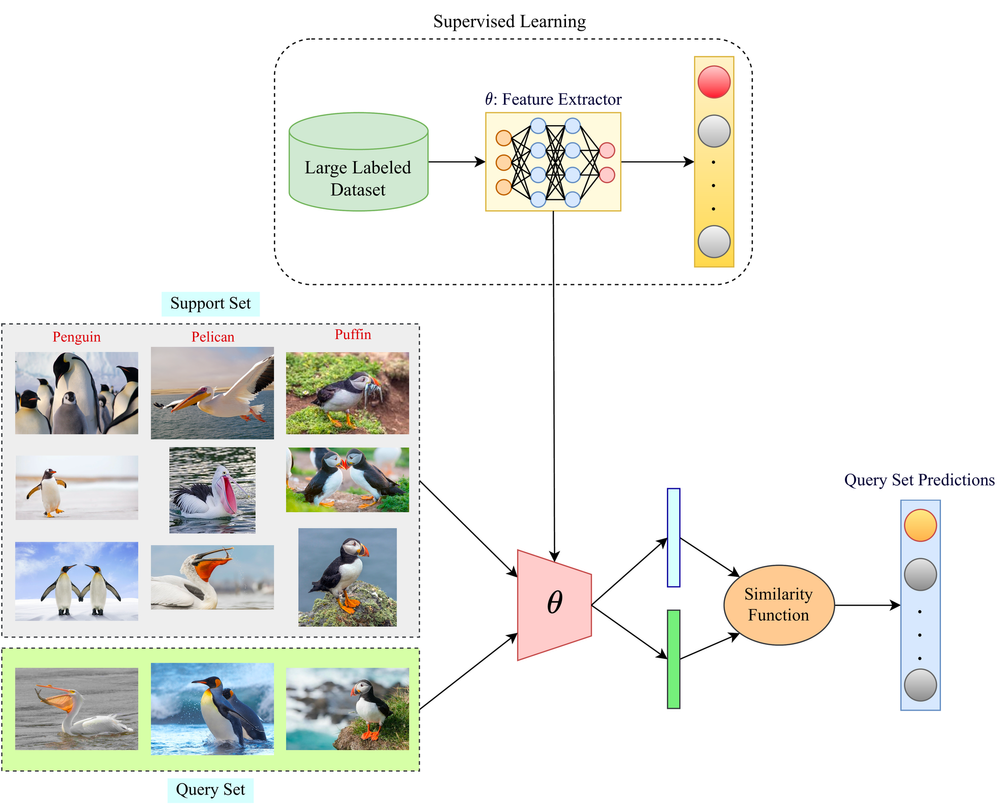
एक आरेख जो सुपरवाइज्ड लर्निंग और फ्यू-शॉट लर्निंग के दृष्टिकोणों का अंतर दिखाता है। सुपरवाइज्ड लर्निंग खंड में एक बड़ा लेबलयुक्त डेटासेट फीचर एक्सट्रैक्टर मॉडल को प्रशिक्षित करने के लिए उपयोग होता दिखता है, जबकि फ्यू-शॉट लर्निंग खंड में कुछ उदाहरणों के छोटे सपोर्ट सेट और समानता फ़ंक्शन से क्वेरी सेट पर भविष्यवाणी करते हुए दिखाया गया है। स्रोत: Paperspace
एक बच्चे के अलग-अलग जानवरों को पहचानना सीखने के बारे में सोचें। कुत्तों, बिल्लियों और पक्षियों के कुछ ही उदाहरणों से, वह जल्दी से इन्हें पहचानना और अलग करना सीख लेता है—भले ही बाद में वे नस्लें या प्रजातियाँ हों जिन्हें उसने पहले न देखा हो।
सीमित डेटा से सामान्यीकरण करने की यह क्षमता मानव बुद्धिमत्ता की पहचान है—और ठीक यही फ्यू-शॉट लर्निंग हासिल करना चाहती है।
कुंजी यह है कि किसी श्रेणी को परिभाषित करने वाली अंतर्निहित संरचना और विशेषताओं को पहचानना।
मानव सीमित अनुभवों से आवश्यक जानकारी निकालने और उसे नई परिस्थितियों में लागू करने की सहज क्षमता रखते हैं। फ्यू-शॉट लर्निंग मॉडल भी पूर्व अनुभवों से डेटा की अंतर्निहित संरचना की सामान्य समझ सीखकर इसी का अनुकरण करने का प्रयास करते हैं।
इसके बाद इसी ज्ञान का उपयोग करते हुए वे न्यूनतम अतिरिक्त जानकारी के साथ नए कार्यों में तेज़ी से अनुकूलित हो जाते हैं—ठीक वैसे ही जैसे बच्चा, कुत्तों के बारे में अपने मौजूदा ज्ञान के आधार पर किसी नई नस्ल को पहचान लेता है।
FSL डेवलपर को डेटा संग्रह की बजाय मॉडल विकास पर ध्यान केंद्रित करने में मदद करती है। सीमित डेटा से सीखने की क्षमता कई लाभ देती है:
फ्यू-शॉट लर्निंग व्यापक n-शॉट लर्निंग के दायरे में आती है, जिसमें दिए गए उदाहरणों की संख्या के आधार पर अलग-अलग तकनीकें शामिल होती हैं:
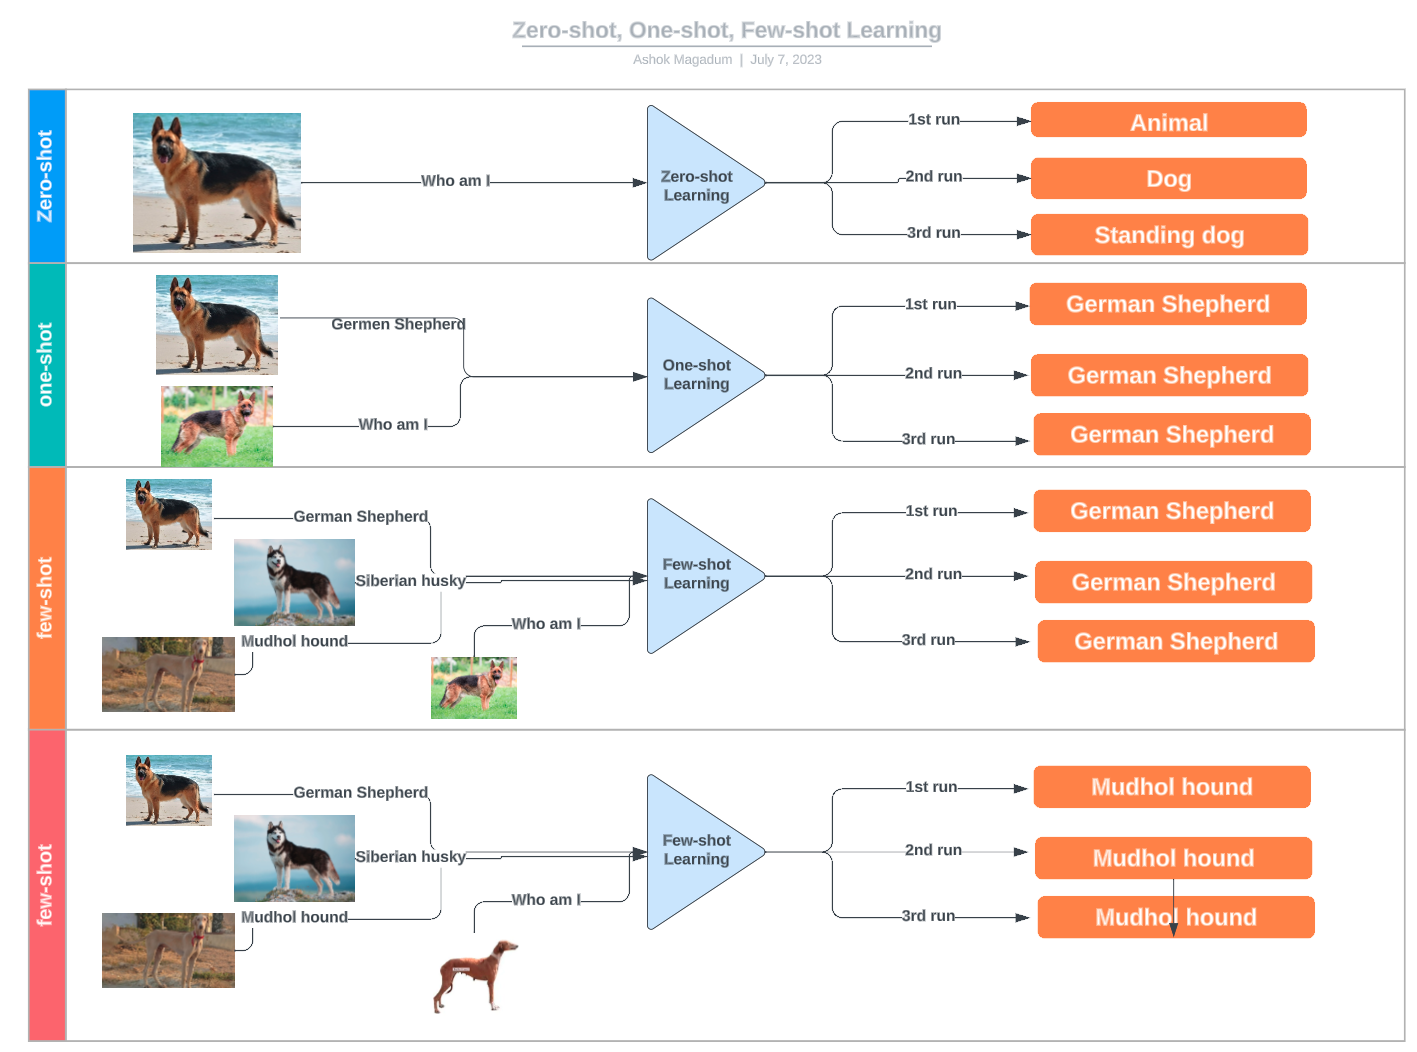
कुत्तों की नस्ल वर्गीकरण के उदाहरणों के साथ ज़ीरो-शॉट, वन-शॉट और फ्यू-शॉट लर्निंग के अंतर को दर्शाता आरेख। स्रोत: LinkedIn
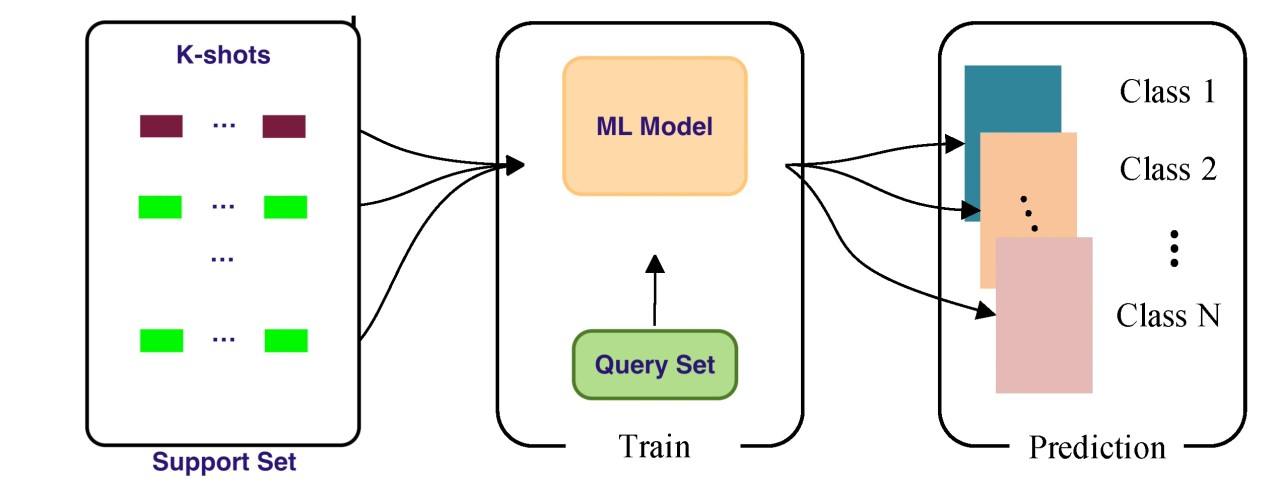
फ्यू-शॉट लर्निंग प्रक्रिया को दर्शाता आरेख। इसमें कई क्लासों के k-शॉट उदाहरणों वाला सपोर्ट सेट, क्वेरी सेट पर प्रशिक्षित एक मशीन लर्निंग मॉडल, और अलग-अलग क्लासों के नए डेटा उदाहरणों के लिए मॉडल की भविष्यवाणी दिखाई गई है। स्रोत: LinkedIn
पारंपरिक सुपरवाइज्ड लर्निंग, जो व्यापक प्रशिक्षण डेटासेट पर निर्भर करती है, के विपरीत, फ्यू-शॉट लर्निंग मॉडल पूर्व ज्ञान और सीखने के अनुभवों का सहारा लेकर न्यूनतम अतिरिक्त डेटा के साथ नए कार्यों में तेज़ी से ढल जाते हैं। किसी अवधारणा को परिभाषित करने वाली अंतर्निहित संरचना और प्रमुख विशेषताओं को पहचानकर, ये मॉडल प्रभावी ढंग से सामान्यीकरण कर पाते हैं और कुछ उदाहरणों से ही नए मामलों पर सटीक भविष्यवाणी कर लेते हैं।
इसके बाद यही ज्ञान समानता फ़ंक्शन के माध्यम से नए कार्यों में तेज़ अनुकूलन हेतु लागू होता है, जो क्वेरी और सपोर्ट सेट की क्लासों का न्यूनतम अतिरिक्त जानकारी के साथ मैपिंग कर सकता है।
संदर्भ के लिए, यहाँ क्वेरी सेट पुराने और नए—दोनों प्रकार की श्रेणियों से आए नमूनों को दर्शाता है, जिन पर मॉडल सामान्यीकरण करता है और प्रदर्शन का मूल्यांकन करता है। इसके विपरीत, सपोर्ट सेट डेटा की प्रत्येक नई श्रेणी से कुछ लेबलयुक्त नमूनों से बना होता है, जिनका उपयोग मॉडल के पैरामीटर अद्यतन करने में किया जाता है:
MAML एक सामान्य मॉडल आरंभिककरण सीखता है जिसे कुछ ही ग्रेडिएंट स्टेप्स से विशिष्ट कार्यों के लिए फाइन-ट्यून किया जा सकता है। यह एक बहुमुखी और शक्तिशाली मेटा-लर्निंग दृष्टिकोण है, जो मॉडलों को नए कार्यों में असाधारण दक्षता से अनुकूल होने में सक्षम बनाता है।
इसकी ताकत ऐसे आरंभिक मान सीखने में है जो नए कार्य पर केवल कुछ ग्रेडिएंट डीसेंट स्टेप्स के माध्यम से तेज़ सीखने में सहायक हों।
यह गुण मॉडल को "आसानी से फाइन-ट्यून होने योग्य" बना देता है, जिससे वह न्यूनतम डेटा के साथ भी नए कार्यों की बारीकियों को जल्दी समझ लेता है।
MAML उस सिद्धांत पर काम करता है कि ऐसे आरंभिक पैरामीटर्स θ सीखे जाएँ जो कार्य में होने वाले परिवर्तन के प्रति अत्यधिक संवेदनशील हों। यह संवेदनशीलता सुनिश्चित करती है कि पैरामीटर्स में छोटे-छोटे समायोजन, जब उस लॉस के ग्रेडिएंट की दिशा में किए जाएँ, तो कार्य-वितरण p(T) से लिए किसी भी कार्य के लॉस फ़ंक्शन में सार्थक सुधार ला सकें।
यहाँ MAML एल्गोरिद्म का संक्षिप्त विवरण है:
मेट्रिक लर्निंग का ध्यान ऐसी दूरी फ़ंक्शन सीखने पर होता है जो डेटा बिंदुओं के बीच समानता को मापे। यह d(x, x') नामक दूरी फ़ंक्शन सीखता है, जो x और x' के बीच समानता का आकलन करता है। इससे मॉडल कुछ ज्ञात उदाहरणों से तुलना करके नए डेटा बिंदुओं का वर्गीकरण कर पाते हैं।
ट्रांसफर लर्निंग किसी स्रोत कार्य से अर्जित ज्ञान का उपयोग संबंधित लक्ष्य कार्य पर प्रदर्शन सुधारने के लिए करती है।
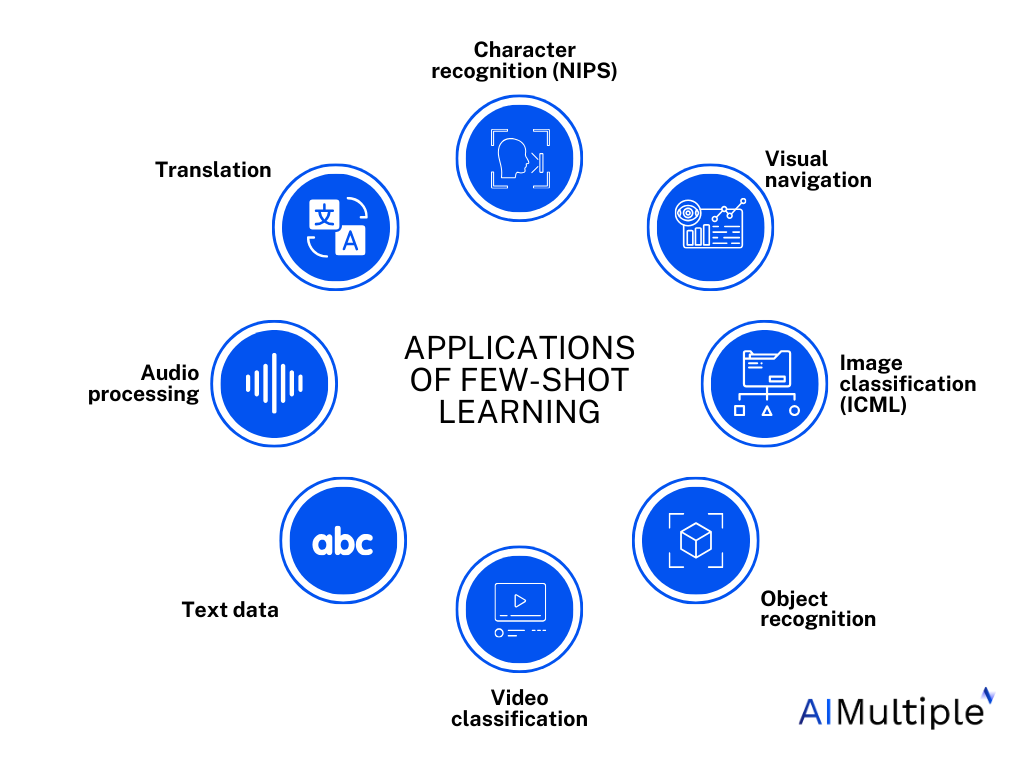
विभिन्न क्षेत्रों में FSL के अनुप्रयोगों का सारांश। स्रोत: AI Multiple Research
फ्यू-शॉट लर्निंग के अनुप्रयोग व्यापक और दूरगामी हैं—कंप्यूटर विज़न, प्राकृतिक भाषा संसाधन, रोबोटिक्स और स्वास्थ्य सेवा जैसे विविध क्षेत्रों तक फैले हुए। उदाहरण के लिए, कंप्यूटर विज़न में, फ्यू-शॉट लर्निंग केवल कुछ प्रशिक्षण उदाहरणों से ही दुर्लभ वस्तुओं को पहचानने या मेडिकल इमेजिंग में सूक्ष्म पैटर्न पकड़ने में सक्षम बनाती है।
नेचुरल लैंग्वेज प्रोसेसिंग में, फ्यू-शॉट लर्निंग ऐसे व्यक्तिगत भाषा मॉडल का मार्ग प्रशस्त कर सकती है जो किसी व्यक्ति की विशिष्ट लेखन शैली या बोली की नकल कर सकें—कंटेंट निर्माण और संचार में बदलाव लाते हुए। इसके अलावा, यह कम-संसाधन भाषाओं के संरक्षण और अनुवाद के लिए अत्यधिक संभावनाएँ रखती है, जिससे अधिक सांस्कृतिक समझ और समावेशन को बढ़ावा मिलता है।
शायद सबसे रूपांतरकारी अनुप्रयोग दवा खोज और स्वास्थ्य सेवा में नज़र आता है। नैदानिक परीक्षणों या दुर्लभ रोग मामलों के सीमित डेटा पर मॉडलों को प्रशिक्षित करके, फ्यू-शॉट लर्निंग जीवनरक्षक उपचारों के विकास को तेज़ कर सकती है और अधिक सटीक निदान संभव बना सकती है—अंततः रोगियों के परिणामों में सुधार लाते हुए।
अपार संभावनाओं के बावजूद, फ्यू-शॉट लर्निंग चुनौतियों से मुक्त नहीं है। प्रमुख बाधाओं में से एक है ओवरफिटिंग का जोखिम—जहाँ मॉडल सीमित प्रशिक्षण डेटा पर अत्यधिक विशिष्ट हो जाते हैं और नए उदाहरणों पर प्रभावी सामान्यीकरण नहीं कर पाते। इसके अलावा, उपयुक्त समानता माप या दूरी फ़ंक्शन का चयन सटीक प्रदर्शन के लिए अत्यंत महत्वपूर्ण होता है, और कार्य की अस्पष्टता या शोरयुक्त डेटा मॉडल की प्रभावशीलता को और प्रभावित कर सकते हैं।
हालाँकि, इन चुनौतियों ने इस क्षेत्र में अनुसंधान और नवाचार को और गति दी है। मेटा-लर्निंग, मेट्रिक लर्निंग और ट्रांसफर लर्निंग जैसे दृष्टिकोण FSL क्षमताएँ बढ़ाने के आशाजनक तरीक़े बनकर उभरे हैं। मॉडल-अज्ञेय मेटा-लर्निंग (MAML) और प्रोटोटाइपिकल नेटवर्क जैसी तकनीकों ने न्यूनतम डेटा के साथ नए कार्यों में तीव्र अनुकूलन में उल्लेखनीय सफलता दिखाई है।
जैसे-जैसे यह क्षेत्र विकसित होता जाएगा, हम और भी परिष्कृत और मज़बूत फ्यू-शॉट लर्निंग विधियों की अपेक्षा कर सकते हैं—जो सीमित डेटा के साथ सम्भवताओं की सीमाएँ आगे बढ़ाएँगी। अंततः, फ्यू-शॉट लर्निंग की सच्ची शक्ति AI का लोकतांत्रीकरण करने में है—उसे उन डोमेन्स और अनुप्रयोगों तक सुलभ बनाना जो अब तक डेटा की कमी से बाधित थे—और डेटा-कुशल, अनुकूलनीय एवं समावेशी कृत्रिम बुद्धिमत्ता के नए युग का मार्ग प्रशस्त करना।
फ्यू-शॉट लर्निंग मशीन लर्निंग के क्षेत्र में एक महत्वपूर्ण प्रगति का प्रतिनिधित्व करती है, जो हमें सीमित डेटा से भी अंतर्दृष्टियाँ निकालने में सक्षम बनाती है। विभिन्न दृष्टिकोणों और अनुप्रयोगों को समझकर, जूनियर डेटा प्रैक्टिशनर्स इस शक्तिशाली उपकरण का उपयोग विविध डोमेन्स में वास्तविक दुनिया की समस्याओं को सुलझाने में कर सकते हैं।
जैसे-जैसे शोध आगे बढ़ेगा, हम और अधिक अभिनव एवं कुशल फ्यू-शॉट लर्निंग तकनीकों के उभरने की उम्मीद कर सकते हैं—जो डेटा साइंस की सीमाओं को और आगे ले जाएँगी।
यदि आप अन्य मशीन लर्निंग अवधारणाओं में दक्ष होना चाहते हैं, तो हमारा Machine Learning Scientist with Python करियर ट्रैक देखें।
DataCamp के साथ सीखना जारी रखें
लर्निंग पाथ
कोर्स
लर्निंग पाथ