
Kursus
Konsep Data Warehousing
4 jam
53.2K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleData ingestion berarti mengumpulkan data dari berbagai sumber dan memuatnya ke tujuan. Banyak alat data ingestion di pasar yang dapat mengotomatisasi dan menyederhanakan proses ini untuk Anda.
Setelah riset dan pengujian yang cermat, saya telah menyusun daftar 20 alat data ingestion teratas. Masing-masing alat ini menawarkan fitur unik, baik Anda memerlukan pemrosesan real-time, ingestion batch, atau dukungan untuk beragam sumber data.
Mari telusuri alat-alatnya dan jelajahi kapabilitas serta kasus penggunaan idealnya!
Apache Kafka adalah mesin terdistribusi open-source yang dikenal dengan throughput tinggi dan latensi rendah. Kafka menyertakan Kafka Connect, sebuah kerangka kerja untuk mengintegrasikan Kafka dengan basis data eksternal, sistem berkas, dan key-value store.
Apache Kafka mengikuti arsitektur producer-consumer. Producer data mengirim data ke topik Kafka, yang bertindak seperti perantara, menyusun data yang diterima secara logis dalam partisinya. Terakhir, consumer mengakses data yang diperlukan dari topik Kafka tersebut.
Mengapa Apache Kafka untuk data ingestion?
Bagi pembaca yang tertarik pada data ingestion real-time, lihat Introduction to Apache Kafka untuk mempelajari cara memproses data streaming secara efisien.
Apache NiFi dibuat untuk mengotomatisasi aliran data antar sistem. Tidak seperti Kafka, NiFi menyediakan antarmuka intuitif untuk merancang, menerapkan, dan memantau aliran data.
Alat ini menggunakan processor untuk data ingestion. Processor di NiFi menangani berbagai fungsi seperti mengekstrak, memublikasikan, mentransformasi, atau merutekan data. Misalnya, processor bawaan seperti InvokeHTTP menarik data dari REST API, dan GetKafka mengambil pesan dari topik Kafka.
Setelah processor mulai melakukan ingestion data, FlowFile dibuat untuk setiap unit data. FlowFile ini berisi metadata beserta data aktual dan dirutekan ke tujuan masing-masing berdasarkan aturan yang ditentukan.
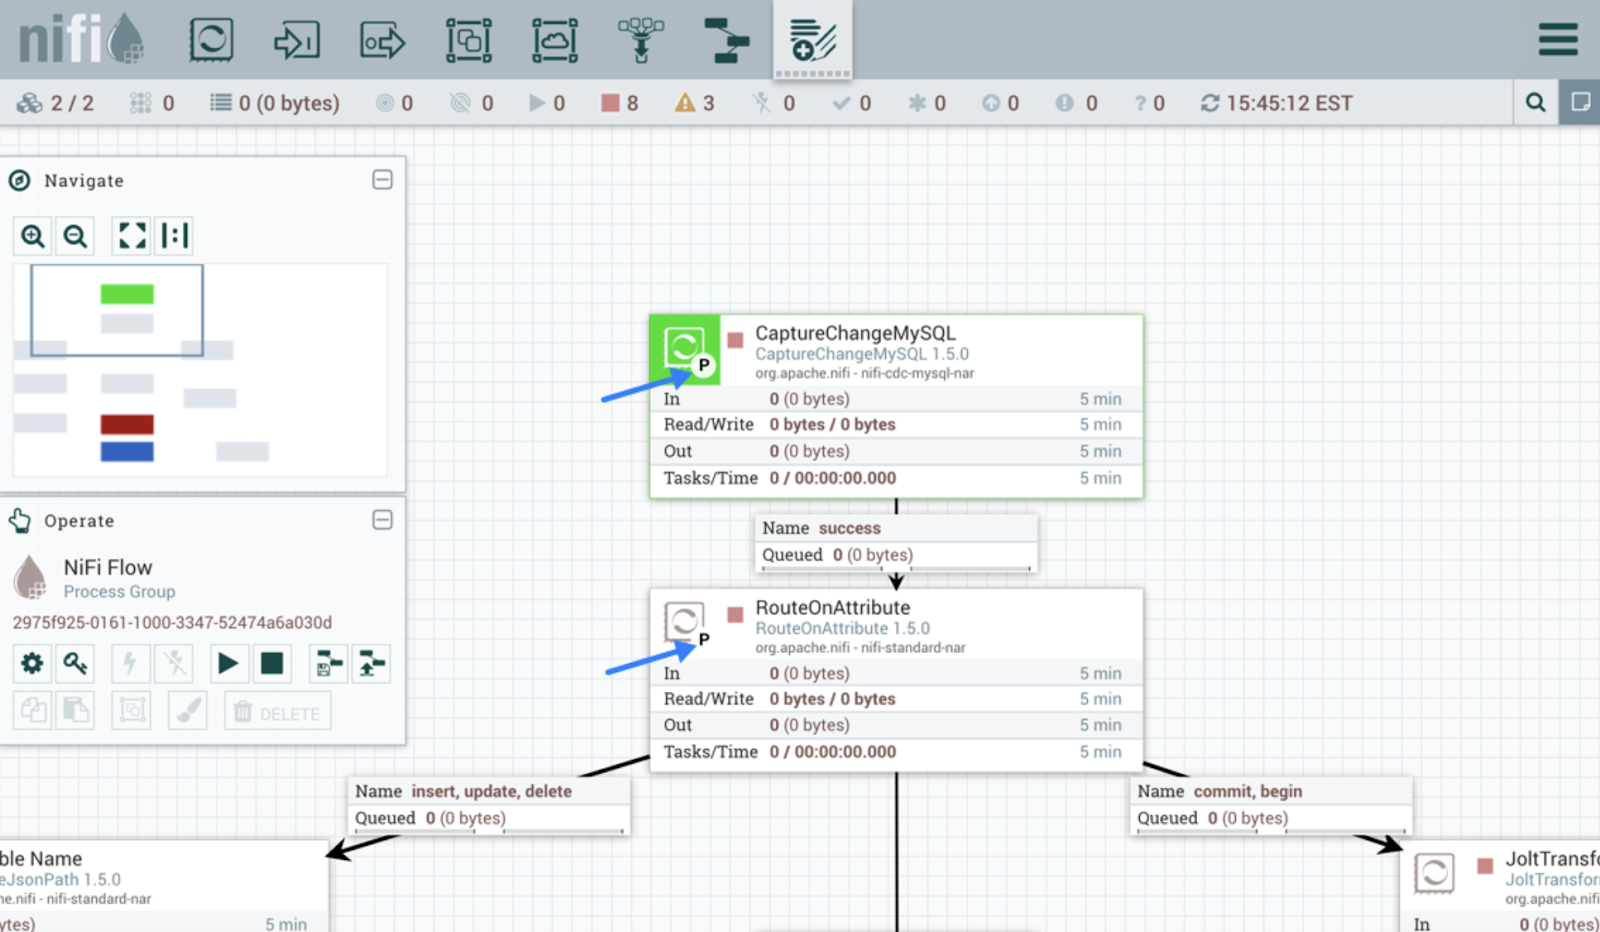
Antarmuka pengguna Apache NiFi. Sumber gambar: Panduan pengguna Apache NiFi.
AWS Glue adalah layanan integrasi data serverless dari Amazon. Layanan ini menemukan, mentransformasi, dan memuat data ke tujuan untuk analitik atau kasus penggunaan ML. Platform ini menawarkan GUI yang ramah pengguna dan lingkungan pengembangan seperti Jupyter notebook.
Crawler dan job ETL adalah dua komponen utama di AWS Glue. Crawler memindai sumber data untuk mendeteksi skema dan menambahkan metadata ke katalog. Job ETL kemudian dapat dengan mudah menemukan sumber data dan strukturnya menggunakan informasi katalog.
AWS Glue menyediakan beberapa cara untuk membuat dan menjalankan pipeline. Misalnya, job ETL dapat ditulis dalam Python atau Scala untuk mentransformasi dan memuat data. Bagi non-coder, Glue Studio menawarkan antarmuka intuitif untuk membuat alur kerja tanpa perlu menulis kode.
Jika Anda menjajaki solusi ETL serverless, lihat tutorial AWS Glue ini untuk panduan langsung membangun pipeline data yang dapat diskalakan.
Dataflow adalah layanan Google Cloud yang sepenuhnya dikelola untuk pemrosesan stream dan batch. Layanan ini dapat menangani pipeline data sederhana, seperti memindahkan data antar sistem pada interval terjadwal, maupun pipeline real-time tingkat lanjut.
Selain itu, alat ini sangat dapat diskalakan dan mendukung transisi mulus dari pemrosesan batch ke stream saat diperlukan.
Google Dataflow dibangun di atas Apache Beam. Jadi Anda dapat membuat kode pipeline ingestion menggunakan SDK Beam. Selain itu, alat ini menawarkan templat alur kerja pradefinisi untuk membuat pipeline secara instan. Pengembang juga dapat membuat templat khusus dan membuatnya tersedia bagi pengguna non-teknis untuk diterapkan sesuai permintaan.
Azure Data Factory (ADF) adalah layanan cloud Microsoft untuk melakukan ingestion data dari banyak sumber. Layanan ini dirancang untuk membuat, menjadwalkan, dan mengorkestrasi alur kerja guna mengotomatisasi proses.
ADF sendiri tidak menyimpan data apa pun. ADF mendukung pergerakan data antar sistem dan memprosesnya melalui sumber daya komputasi di server jarak jauh.
Platform ini memiliki lebih dari 90 konektor bawaan untuk menautkan berbagai sumber data, termasuk penyimpanan data on-premise, REST API, dan server cloud. Kemudian, komponen ‘copy activity’ menyalin data dari sumber ke sink.
Jika Anda sudah menggunakan layanan Microsoft untuk operasi data lainnya, Azure Data Factory adalah solusi terpadu untuk kebutuhan data ingestion Anda. Tutorial Azure Data Factory kami memandu Anda menyiapkan alur kerja data ingestion di Azure.
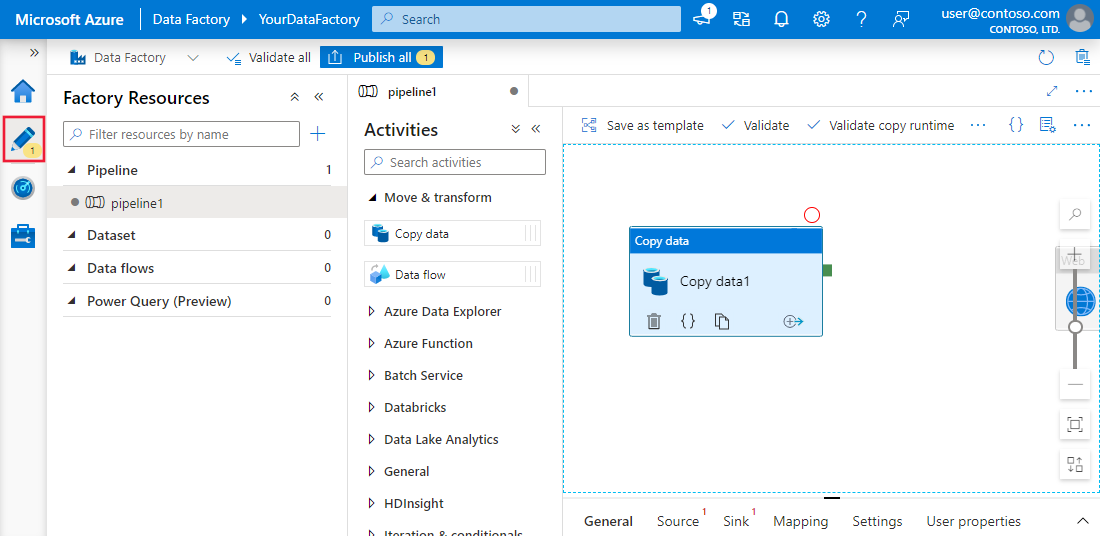
Pengalaman antarmuka pengguna Azure Data Factory dan Synapse Analytics. Sumber gambar: Microsoft Learn
Talend adalah platform integrasi data end-to-end open-source. Platform ini memudahkan pembangunan alur kerja data ingestion, menawarkan komponen drag-and-drop untuk menghubungkan berbagai sumber dan tujuan.
Talend dikenal dalam memindahkan data antar sistem sambil mempertahankan kualitas. Kumpulan alat kualitas datanya yang tangguh memastikan keakuratan data selama ingestion. Selain itu, kapabilitas pemantauan bawaan memungkinkan kepatuhan terhadap aturan keamanan dan tata kelola data.
Fivetran adalah platform integrasi data populer yang mengotomatisasi tugas ELT. Platform ini menyajikan data tanpa gangguan dengan secara otomatis menyesuaikan perubahan format data. Fitur ini juga membantu menjaga akurasi data melalui pemetaan skema selama ingestion.
Keuntungan utama alat seperti Fivetran adalah tanpa perawatan. Manajemen skema dan pemantauan otomatisnya memungkinkan pipeline yang memelihara diri sendiri.
Selain itu, alat ini menyertakan kapabilitas CDC (change data capture), memastikan tujuan tetap mutakhir secara real-time.
Bagi yang belum familiar, CDC mengacu pada proses mengidentifikasi pembaruan terbaru pada basis data dan mencerminkannya di tujuan secara real-time.
Airbyte adalah alat data ingestion open-source lainnya dalam daftar ini. Airbyte merupakan platform integrasi data paling populer, dan lebih dari 3000 perusahaan menggunakannya.
Dengan lebih dari 300 konektor siap pakai, Airbyte menawarkan dukungan paling luas untuk berbagai koneksi sumber dan tujuan. Selain itu, karena bersifat open-source, Anda dapat menelusuri kode konektor ini dan menyesuaikannya. Jika kasus penggunaan Anda belum tercakup, Anda dapat menulis konektor sumber sendiri.
Airbyte memerlukan keahlian teknis untuk menyiapkan dan memelihara pipeline, terutama konektor khusus. Namun, Airbyte memiliki paket berbayar dengan layanan terkelola sepenuhnya dan dukungan khusus.
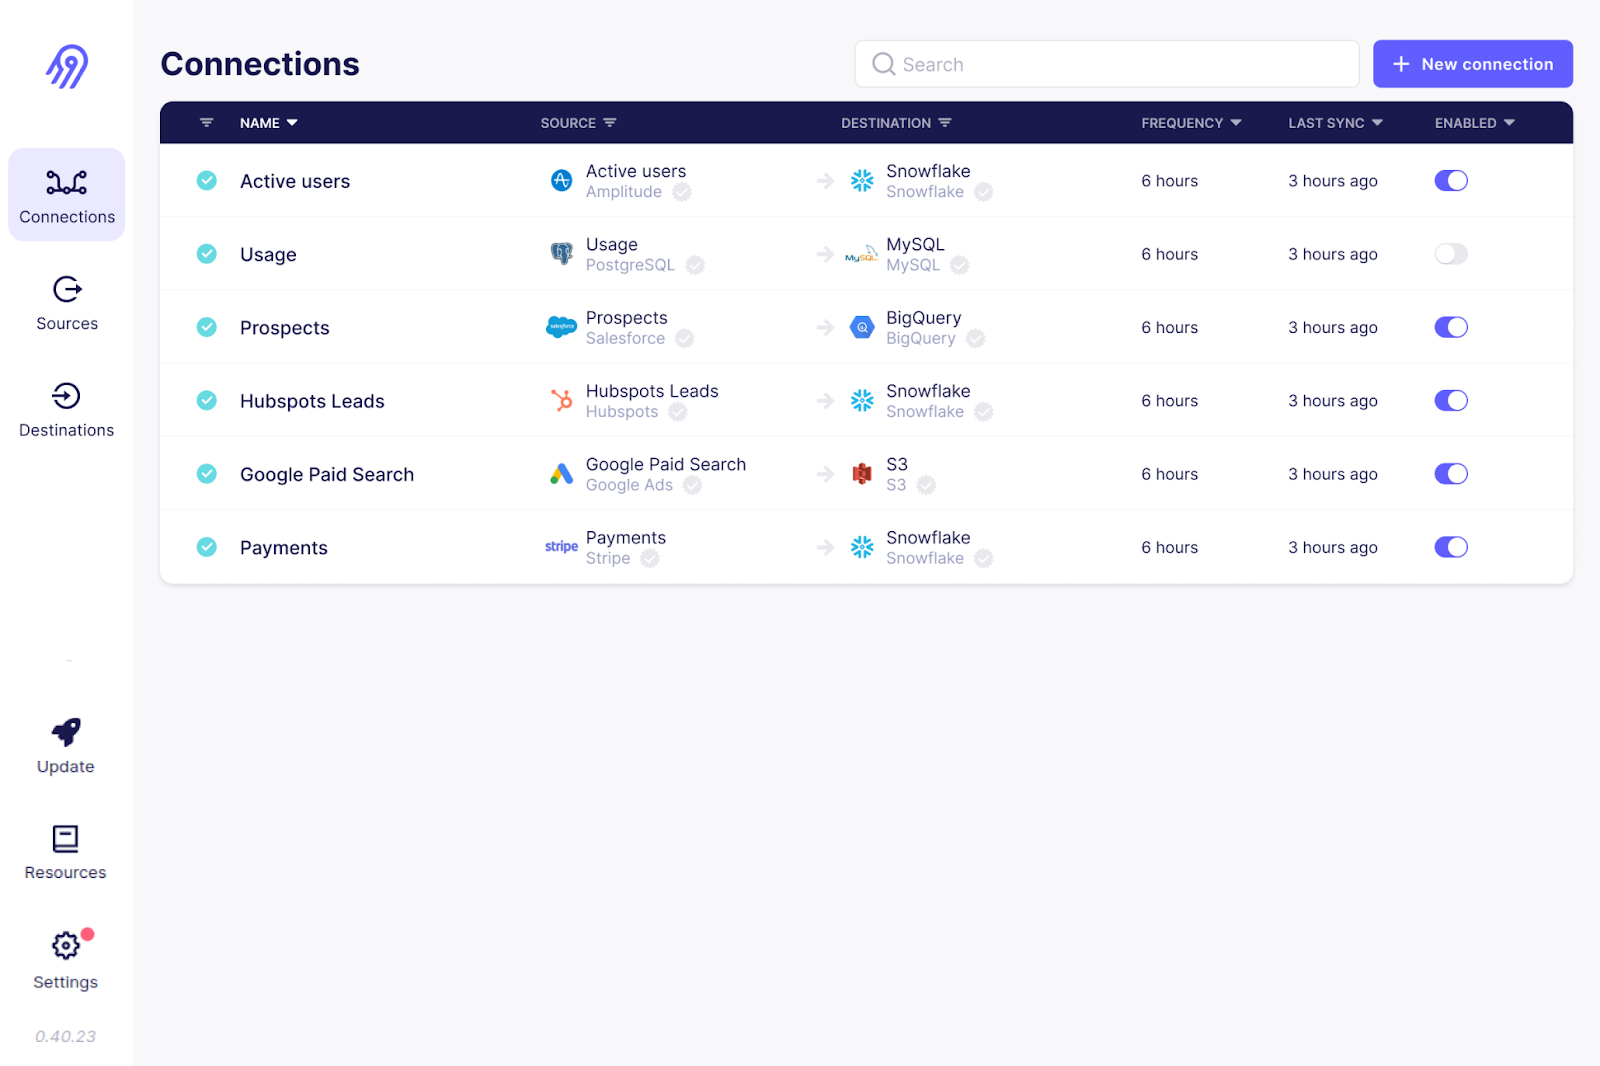
Antarmuka pengguna Airbyte. sumber: Airbyte GitHub
Informatica’s intelligent data management cloud berisi rangkaian alat untuk menyederhanakan data ingestion. Alat ‘Data Loader’ miliknya hanya membutuhkan beberapa menit untuk memuat data dari 30+ layanan cloud.
Informatica juga memiliki alat integrasi aplikasi yang menghubungkan sistem perangkat lunak yang berbeda, baik on-premise maupun di cloud. Platform integrasi data cloud-nya dirancang dengan baik untuk data ingestion berkinerja tinggi dengan ETL/ELT.
Dirancang untuk menangani data batch dan real-time, Informatica memungkinkan ingestion berbagai jenis data dari basis data relasional, aplikasi, dan sistem berkas. Selain itu, platform ini menyediakan kapabilitas AI seperti CLAIRE Engine, yang menganalisis informasi metadata dan menyarankan dataset relevan untuk kebutuhan data ingestion Anda.
Apache Flume adalah layanan terdistribusi dan andal untuk memuat data log ke tujuan. Arsitekturnya yang fleksibel dirancang khusus untuk aliran data streaming, seperti dari beberapa web server ke HDFS atau ElasticSearch hampir secara real-time.
Agen Flume adalah komponen utama yang bertanggung jawab atas pergerakan data. Agen ini terdiri dari channel, sink, dan source. Komponen source mengambil berkas data dari sumber data, dan sink memastikan sinkronisasi antara tujuan dan sumber. Beberapa agen Flume dapat dikonfigurasi untuk data ingestion paralel saat melakukan streaming volume data besar.
Apache Flume dikenal karena toleransi kesalahannya. Dengan beberapa mekanisme failover dan pemulihan, Flume memastikan data ingestion yang konsisten dan andal bahkan jika terjadi kegagalan.
Stitch adalah alat ETL cloud yang sederhana dan dapat diperluas. Meski tidak memiliki kapabilitas transformasi kustom yang kompleks, alat ini sangat cocok untuk tugas data ingestion.
Seperti alat ETL enterprise lainnya, Stitch menawarkan beragam konektor ke lebih dari 140 sumber data, umumnya dari aplikasi SaaS dan basis data ke data warehouse dan data lake. Untuk alur kerja data ingestion kustom, Stitch berintegrasi dengan Singer, memungkinkan Anda membangun konektor kustom.
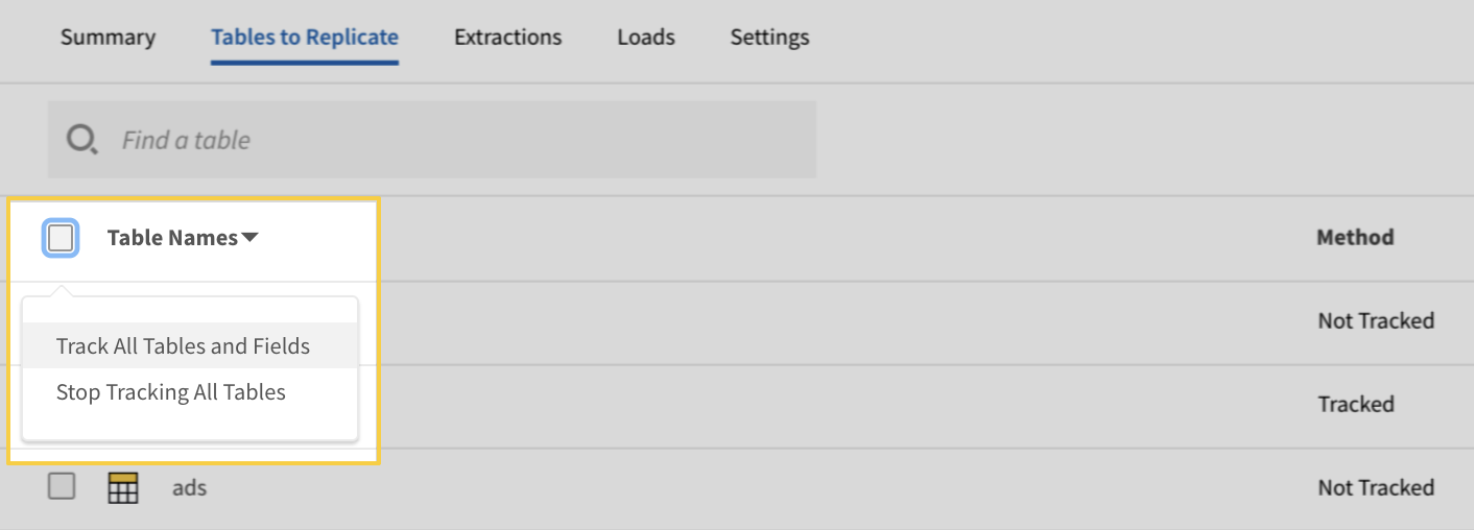
Antarmuka pengguna ekstraksi data Stitch. Sumber gambar: Dokumentasi Stitch
StreamSets, yang diakuisisi oleh IBM, adalah mesin integrasi data open-source untuk data stream, batch, dan CDC. Fitur ‘Data Collector’ menyediakan konektor sumber drag-and-drop untuk platform cloud seperti AWS, Microsoft Azure, dan Google Cloud, serta sistem on-premise.
Anda tidak memerlukan keahlian TI untuk membuat atau mengedit pipeline data ingestion — antarmuka drag-and-drop Data Collector sangat intuitif.
StreamSets adalah alat yang agnostik platform sehingga pengguna dapat membangun pipeline data collector yang sesuai dengan banyak lingkungan dengan konfigurasi ulang minimal. Selain data collector, platform ini memiliki data transformer yang beroperasi di atas Apache Spark untuk transformasi data yang kompleks.
Apache Beam adalah solusi terpadu yang menyediakan satu model pemrograman untuk kasus penggunaan batch dan streaming. Beam bekerja mulus dengan platform cloud seperti Google Cloud Dataflow, Apache Flink, dan Apache Spark.
Untuk data ingestion real-time, Anda dapat mendefinisikan window tetap, sliding, dan sesi untuk mengelompokkan dan memproses data dengan cepat.
Apache Beam menonjol karena fleksibilitasnya. Beam memungkinkan pipeline didefinisikan dalam bahasa pemrograman apa pun dan dijalankan pada beberapa mesin eksekusi.
Hevo Data adalah platform tanpa kode yang sepenuhnya dikelola untuk memindahkan data dari lebih dari 150 sumber ke tujuan pilihan Anda. Alat ini tidak hanya menangani data ingestion tetapi juga mentransformasi data agar siap untuk analitik.
Platform ini secara otomatis mendeteksi skema data yang masuk dan mencocokkannya dengan skema tujuan, memberikan fleksibilitas.
Hevo Data juga menawarkan arsitektur yang tangguh dan toleran kesalahan, memastikan tidak ada kehilangan data selama data ingestion. Secara keseluruhan, Hevo Data adalah pilihan utama untuk kasus penggunaan streaming dan analitik real-time.
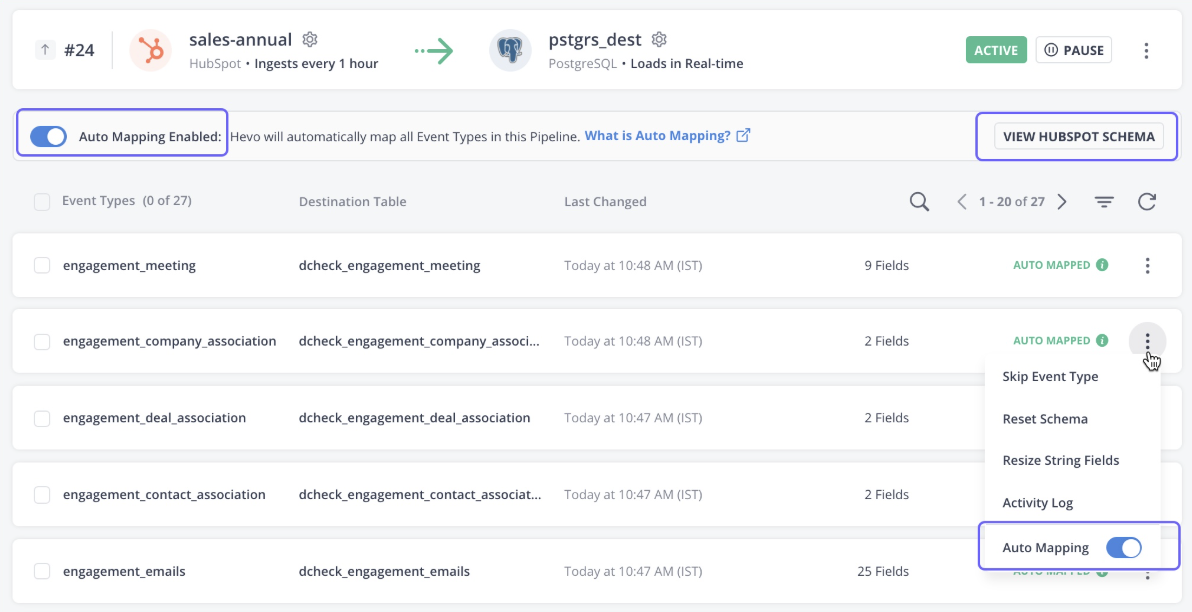
Antarmuka pengguna Hevo Data. Sumber gambar: Dokumentasi Hevo
Segment adalah platform data pelanggan, yang menyediakan data pelanggan yang bersih dan telah ditransformasi untuk analitik. Platform ini terspesialisasi dalam mengumpulkan berbagai jenis data pelanggan, seperti interaksi, impresi, klik, dan data perilaku lainnya.
Track API milik alat ini mengumpulkan data peristiwa dari berbagai sumber, termasuk mobile, web, dan server. Hanya dengan beberapa klik, data dapat diintegrasikan dengan lebih dari 450 aplikasi.
Data yang dikumpulkan melalui Segment tersedia bagi pengguna melalui kueri SQL, sementara programmer dapat mengakses data real-time menggunakan perintah curl.
Matillion adalah platform integrasi data cloud-native yang dirancang untuk memindahkan dan mentransformasi data di dalam cloud. Platform ini paling cocok untuk data warehouse cloud yang bertenaga seperti Snowflake, Amazon Redshift, dan Google BigQuery.
Platform ini menyediakan beragam konektor bawaan untuk sumber data cloud dan on-premise, termasuk basis data, aplikasi SaaS, platform media sosial, dan banyak lagi.
Dengan fokus pada kinerja, Matillion juga menawarkan kapabilitas transformasi yang kuat untuk membersihkan dan menyiapkan data untuk analisis lanjutan.
Keboola, yang dirancang khusus untuk melakukan transformasi kompleks, menyediakan fasilitas data ingestion kustom. Dengan lebih dari 250 integrasi bawaan antara sumber dan tujuan, Keboola mengotomatisasi data ingestion hanya dalam beberapa klik.
Keboola mendukung streaming data batch dan real-time untuk mengimpor data enterprise. Namun, untuk data ingestion real-time, Anda memerlukan keahlian pemrograman untuk menyiapkan webhook.
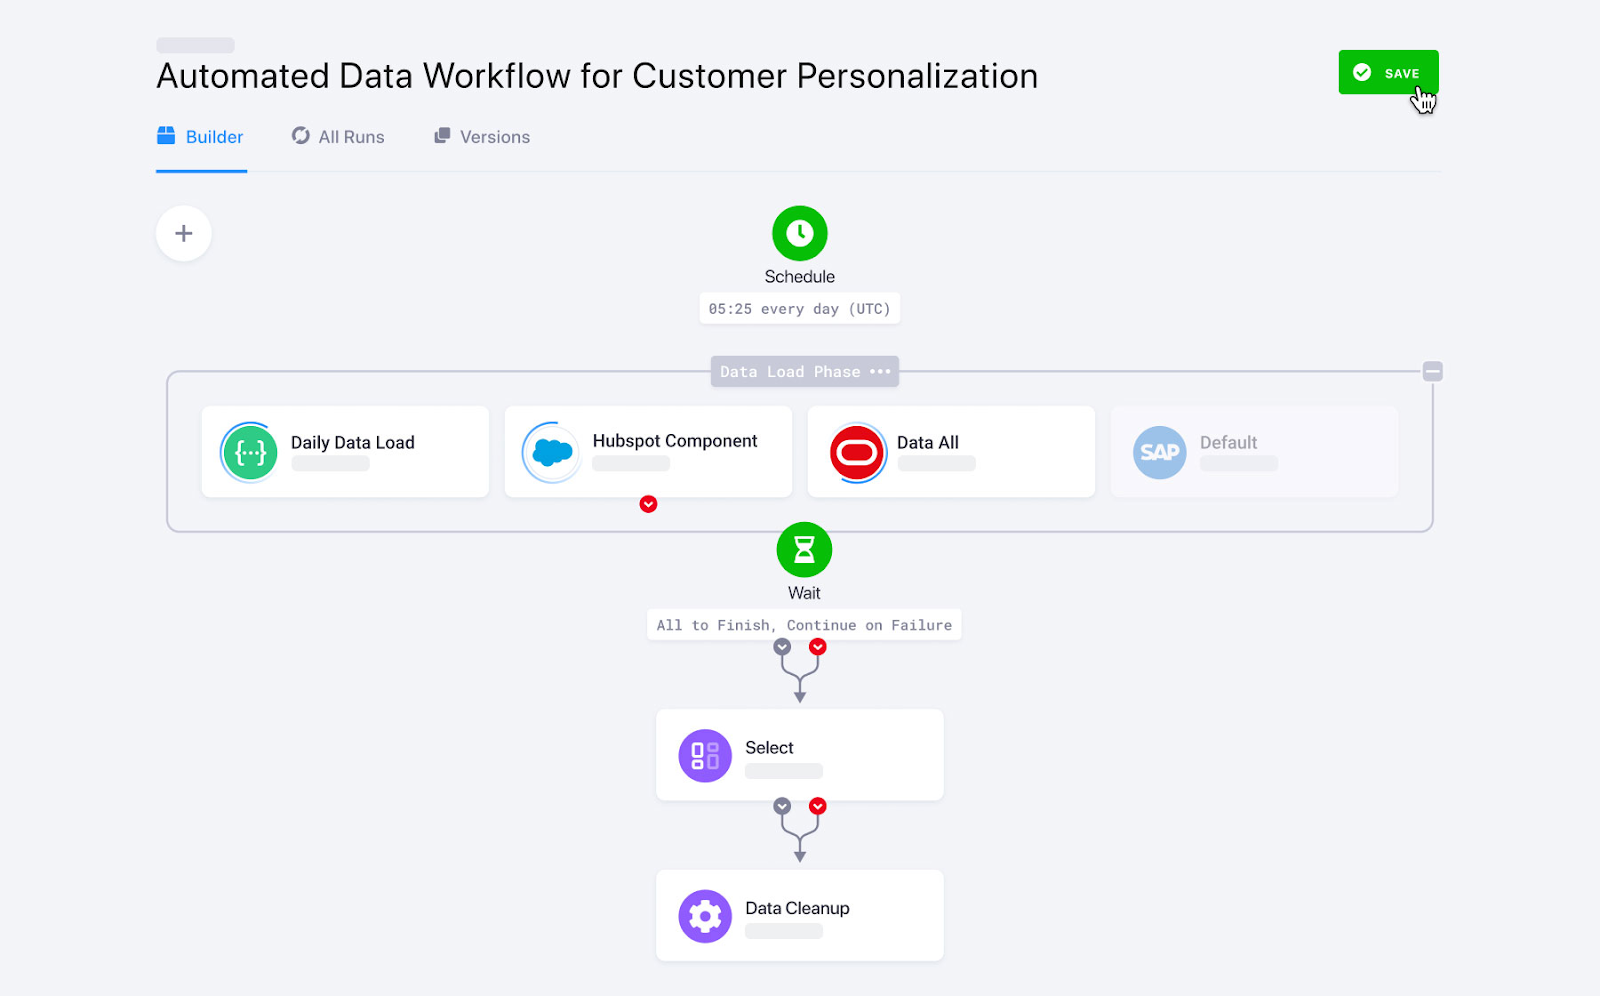
Alur kerja data Keboola. Sumber gambar: Keboola
Snowplow adalah platform pengumpulan data generasi berikutnya yang menangkap dan memproses data peristiwa dari berbagai sumber. Platform ini terspesialisasi dalam mengumpulkan data perilaku pelanggan dan menyiapkannya untuk analisis AI dan machine learning tingkat lanjut.
Snowplow secara internal menggunakan tracker dan webhook untuk mengumpulkan data peristiwa real-time.
Tracker adalah pustaka atau SDK yang dapat diintegrasikan ke aplikasi seluler, situs web, dan aplikasi sisi server. Tracker mengumpulkan informasi peristiwa seperti interaksi pengguna, klik, dan suka kemudian mengirimkannya ke collector. Collector kemudian meneruskan data melalui proses enrichment sebelum mengirimnya ke data warehouse tujuan.
IBM DataStage adalah platform integrasi data terkemuka di industri yang dibangun untuk operasi ETL dan ELT. Versi dasarnya tersedia on-premise, tetapi untuk merasakan skala dan otomatisasi melalui cloud, tingkatkan ke DataStage untuk IBM Cloud Pak®.
Kumpulan konektor dan stage bawaan yang ekstensif mengotomatisasi pergerakan data antara banyak sumber cloud dan data warehouse.
Bagi yang menyiapkan arsitektur data di ekosistem IBM, DataStage adalah alat andalan untuk data ingestion. DataStage terintegrasi dengan platform data IBM lainnya, seperti Cloud Object Storage dan Db2, untuk ingestion dan transformasi.
Alteryx dikenal dengan alat analitik dan visualisasinya. Dengan lebih dari 8000 pelanggan, ini adalah platform analitik populer yang mengotomatisasi tugas data dan analitik.
Alteryx memiliki alat bernama Designer Cloud yang menawarkan antarmuka intuitif untuk membangun pipeline data ingestion untuk kasus penggunaan analitik dan AI. Alat ini menawarkan konektivitas ke berbagai sumber data, termasuk data warehouse, penyimpanan cloud, dan sistem berkas.
Ingin menyederhanakan persiapan data dan analitik tanpa coding? Pelajari cara mengotomatisasi alur kerja dengan Introduction to Alteryx dan buka kapabilitas ETL drag-and-drop.
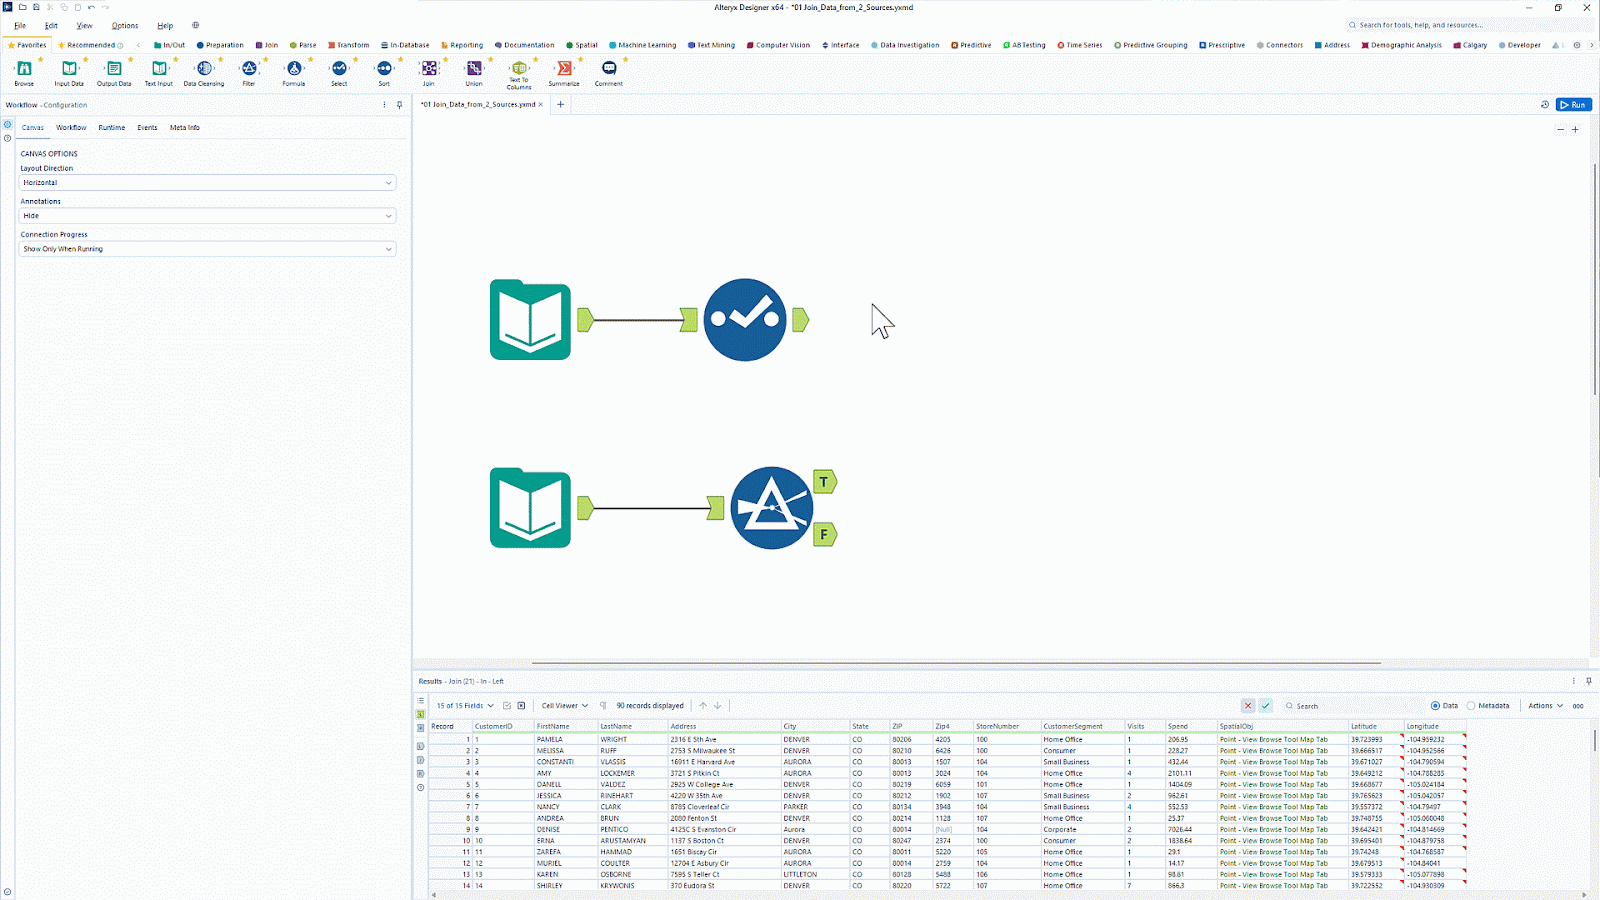
Antarmuka pengguna drag and drop Alteryx. Sumber gambar: Alteryx
|
Alat |
Terbaik untuk |
Fitur |
Harga |
|
Apache Kafka |
Streaming data real-time |
|
Open-source |
|
Apache Nifi |
Data ingestion real-time yang aman |
|
Open-source |
|
AWS Glue |
Ekosistem AWS |
|
Model harga pay-as-you-go. Biaya didasarkan pada jumlah pemrosesan data yang digunakan per jam. |
|
Google cloud dataflow |
Ekosistem Google Cloud |
|
Model harga pay-as-you-go. Biaya didasarkan pada sumber daya komputasi dan memori yang digunakan. |
|
Azure data factory |
Perusahaan yang menggunakan layanan Azure Microsoft lainnya |
|
Model harga pay-as-you-go |
|
Talend |
Perusahaan beranggaran rendah yang mencari solusi ETL intuitif |
|
Open-source |
|
Fivetran |
Kebutuhan ELT terkelola sepenuhnya |
|
Harga berbasis langganan |
|
Airbyte |
Organisasi yang mencari solusi kustomisasi open-source |
|
Tersedia layanan open-source maupun berbayar. |
|
Informatica |
Perusahaan yang mencari alat low-code dengan konektor sumber yang luas |
|
Uji coba gratis 30 hari, model harga pay-as-you-go |
|
Apache Flume |
Aliran data streaming |
|
Open-source |
|
Stitch |
Organisasi yang mencari alat sederhana untuk tugas data ingestion |
|
Anda dapat memilih harga berbasis tingkat atau model pay-as-you-use |
|
StreamSets |
Transformasi data yang kompleks |
|
Tersedia opsi open-source dan komersial |
|
Apache Beam |
Kerangka kerja berbasis kode yang dapat dikustomisasi untuk membangun pipeline data ingestion |
|
Kerangka kerja Apache Beam bersifat open-source, tetapi biaya timbul saat digunakan dengan layanan cloud. |
|
Hevo Data |
Bisnis menengah yang membutuhkan analitik real-time |
|
Harga berbasis langganan |
|
Segment |
Data peristiwa pelanggan |
|
Model harga berbasis langganan |
|
Matillion |
Alat ETL/ELT cloud-native |
|
Model harga berbasis langganan |
|
Keboola |
Pipeline transformasi data yang kompleks |
|
Model harga berbasis langganan |
|
Snowplow |
Mengumpulkan data peristiwa |
|
Tersedia opsi open-source dan komersial |
|
IBM DataStage |
Ekosistem cloud IBM |
|
Model harga berbasis langganan |
|
Alteryx |
Analitik dan visualisasi data |
|
Model harga berbasis langganan |
Dengan begitu banyak alat di industri, memilih platform integrasi data yang tepat untuk tujuan Anda bisa jadi sulit. Berikut adalah daftar beberapa faktor yang perlu Anda pertimbangkan sebelum memilih satu alat integrasi data tertentu.
Anda dapat dengan mudah melakukan ingestion lembar Excel atau berkas CSV ke tujuan. Namun, melakukan ingestion data streaming real-time secara manual dari banyak sumber ke berbagai tujuan bisa menantang. Misalnya, aplikasi modern seperti media sosial sering mengalami lonjakan permintaan pada waktu tertentu dan rendah di waktu lain. Di sinilah fitur skalabilitas alat data ingestion berperan penting.
Skalabilitas mengacu pada kemampuan untuk bertumbuh atau menyusut berdasarkan permintaan. Ini memungkinkan alat tersebut cepat beradaptasi dengan meningkatnya kebutuhan volume data tanpa mengorbankan kinerja.
Fleksibilitas merujuk pada kemampuan menangani data dari berbagai sumber dan format. Alat data ingestion yang mendukung berbagai sumber data dan menawarkan konektor kustom memastikan fleksibilitas dalam sistem data ingestion.
Misalnya, fitur pemetaan skema otomatis mendeteksi skema data yang masuk dan memetakannya ke tujuan tanpa membatasi pada struktur skema yang telah ditentukan. Ini memungkinkan alat tersebut melakukan ingestion data dengan skema apa pun.
Data ingestion batch mengumpulkan data sesuai jadwal dan memperbaruinya di tujuan. Di sisi lain, data ingestion real-time berarti mentransfer data secara terus-menerus tanpa penundaan.
Banyak alat data ingestion saat ini mendukung ingestion batch dan real-time. Namun, jika Anda sering menangani data real-time, seperti peristiwa pelanggan atau video streaming, pilih alat dengan kapabilitas throughput tinggi dan latensi rendah.
Berbagai alat data ingestion memiliki struktur harga yang berbeda. Beberapa menawarkan harga berbasis tingkat, sementara yang lain mengikuti model pay-as-you-go. Solusi ini seringkali lebih hemat biaya dibandingkan alat open-source karena alat gratis mengharuskan Anda merekrut ahli untuk mengaktifkan data ingestion. Namun, alat open-source menawarkan fleksibilitas dan kustomisasi tinggi untuk kasus penggunaan Anda.
Beberapa alat data ingestion berbayar juga menyediakan fitur tingkat enterprise dengan kapabilitas kustomisasi yang luas, meskipun hadir dengan biaya. Oleh karena itu, berdasarkan anggaran dan kebutuhan kustomisasi Anda, Anda harus memilih antara platform berbayar dan open-source.
Memilih alat data ingestion yang tepat bergantung pada kebutuhan spesifik Anda—apakah Anda memprioritaskan streaming real-time, pemrosesan batch, kompatibilitas cloud, atau kemudahan integrasi. Alat yang tercantum di atas menawarkan beragam opsi, membantu Anda merampingkan pengumpulan data dan pemuatan ke sistem tujuan secara efisien.
Jika Anda baru dalam rekayasa data dan ingin memperdalam pemahaman tentang bagaimana data mengalir melalui pipeline modern, lihat the Introduction to Data Engineering course. Bagi yang tertarik mempelajari lebih lanjut tentang proses ETL dan ELT di Python, ETL and ELT in Python adalah sumber yang bagus untuk mendapatkan pengalaman langsung dengan teknik data ingestion.
Pelajari lebih lanjut tentang data engineering dengan kursus-kursus ini!
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




