
Corso
Concetti di Data Warehousing
4 ore
53.2K
Pratica and corso your progress.
Continua Con GoogleLa data ingestion consiste nel raccogliere dati da varie fonti e caricarli nella destinazione. In commercio esistono molti strumenti di data ingestion che possono automatizzare e semplificare questo processo.
Dopo un’attenta ricerca e diversi test, ho messo insieme un elenco dei 20 migliori strumenti di data ingestion. Ognuno offre funzionalità specifiche, che tu abbia bisogno di elaborazione in tempo reale, ingestion a batch o supporto per fonti di dati eterogenee.
Vediamo gli strumenti nel dettaglio, esplorandone capacità e casi d’uso ideali!
Apache Kafka è un motore distribuito open source noto per l’elevato throughput e la bassa latenza. Include Kafka Connect, un framework per integrare Kafka con database esterni, file system e key-value store.
Apache Kafka segue un’architettura producer-consumer. I produttori inviano i dati ai topic Kafka, che fungono da intermediari organizzando logicamente i dati ricevuti nelle loro partizioni. Infine, i consumer accedono ai dati necessari da questi topic Kafka.
Perché Apache Kafka per la data ingestion?
Se ti interessa la data ingestion in tempo reale, dai un’occhiata a Introduction to Apache Kafka per imparare a elaborare flussi di dati in modo efficiente.
Apache NiFi è pensato per automatizzare i flussi di dati tra sistemi. Diversamente da Kafka, offre un’interfaccia intuitiva per progettare, distribuire e monitorare i flussi di dati.
Lo strumento usa i processor per la data ingestion. In NiFi i processor gestiscono funzioni come estrazione, pubblicazione, trasformazione o instradamento dei dati. Ad esempio, processor predefiniti come InvokeHTTP estraggono dati da API REST e GetKafka recupera messaggi dai topic Kafka.
Una volta che i processor iniziano a ingerire dati, vengono creati i FlowFile per ogni unità di dato. Questi FlowFile contengono metadati insieme ai dati effettivi e vengono instradati verso le rispettive destinazioni in base a regole definite.
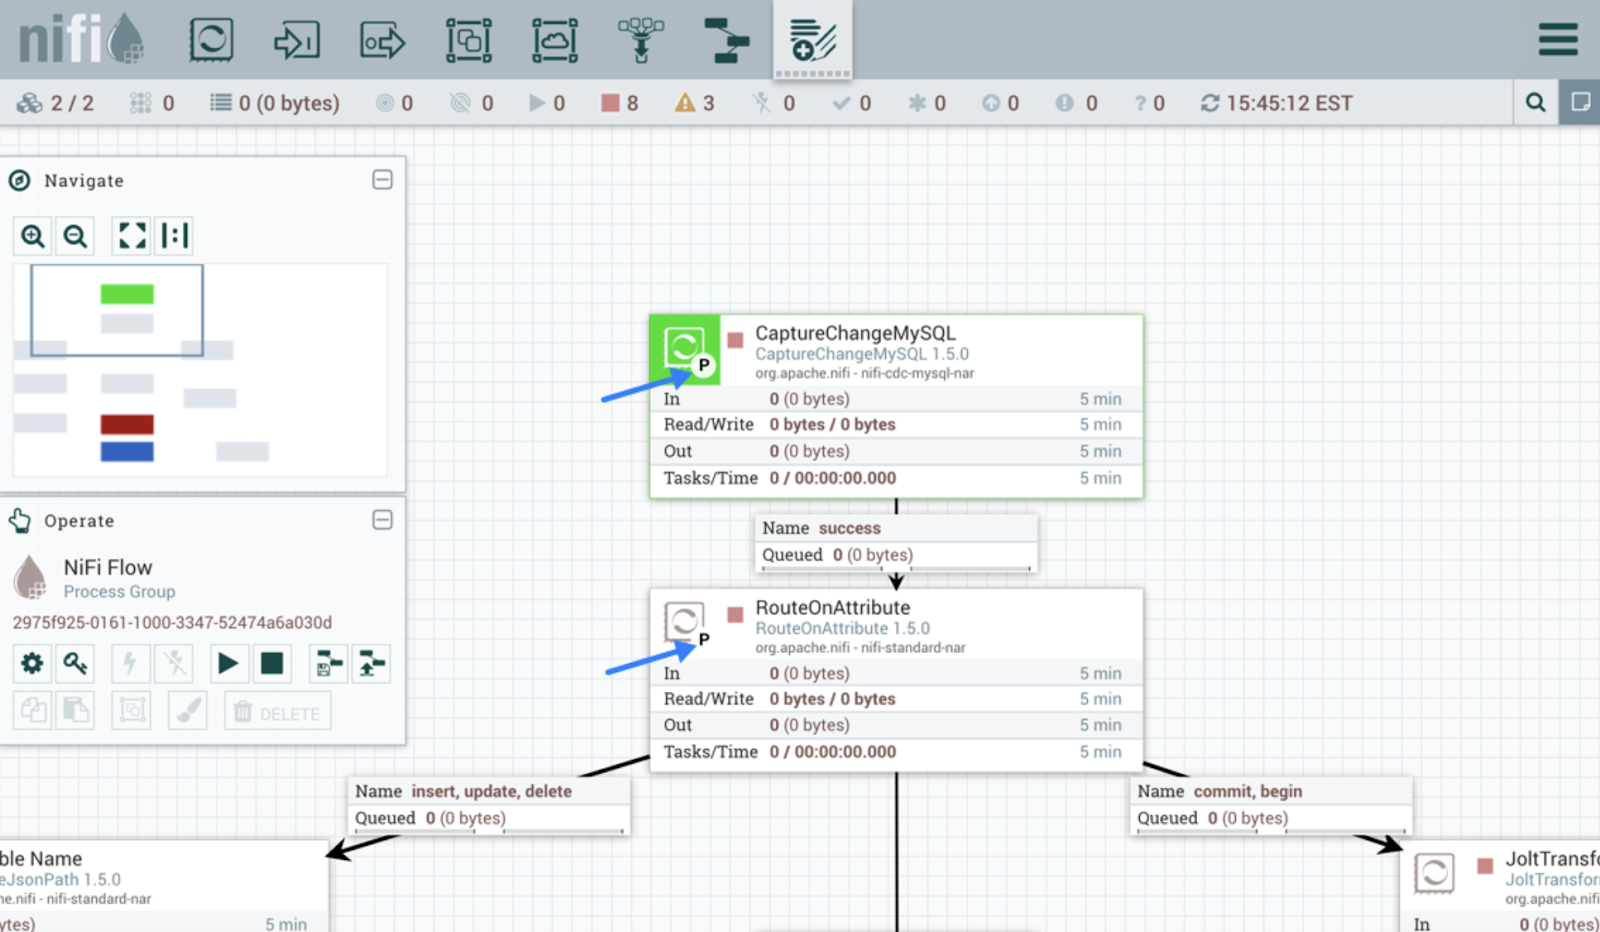
Interfaccia utente di Apache NiFi. Fonte: Guida utente di Apache NiFi.
AWS Glue è un servizio serverless di integrazione dati di Amazon. Scopre, trasforma e carica i dati nelle destinazioni per analisi o casi d’uso di ML. La piattaforma offre sia una GUI facile da usare sia ambienti di sviluppo come i notebook Jupyter.
In AWS Glue i due componenti principali sono i crawler e i job ETL. I crawler scansionano le sorgenti per rilevare lo schema e aggiungono i metadati ai cataloghi. I job ETL possono quindi individuare facilmente la sorgente e la sua struttura usando le informazioni del catalogo.
AWS Glue offre vari modi per creare ed eseguire pipeline. Ad esempio, i job ETL possono essere scritti in Python o Scala per trasformare e caricare i dati. Per chi non programma, Glue Studio offre un’interfaccia intuitiva per creare workflow senza scrivere codice.
Se stai valutando soluzioni ETL serverless, dai un’occhiata a questo tutorial su AWS Glue per una guida pratica alla creazione di pipeline dati scalabili.
Dataflow è un servizio Google Cloud completamente gestito per l’elaborazione in streaming e a batch. Gestisce sia pipeline semplici, come il trasferimento di dati tra sistemi a intervalli pianificati, sia pipeline avanzate in tempo reale.
Inoltre, lo strumento è altamente scalabile e supporta una transizione senza soluzione di continuità dal batch allo streaming quando necessario.
Google Dataflow è costruito sopra Apache Beam. Puoi quindi sviluppare pipeline di ingestion usando gli SDK Beam. Inoltre, lo strumento offre template di workflow predefiniti per creare pipeline all’istante. Gli sviluppatori possono anche creare template personalizzati e metterli a disposizione degli utenti non tecnici per la distribuzione on demand.
Azure Data Factory (ADF) è il servizio cloud di Microsoft per ingerire dati da più fonti. È progettato per creare, pianificare e orchestrare workflow per automatizzare il processo.
ADF di per sé non memorizza dati. Supporta il movimento dei dati tra sistemi e li elabora tramite risorse di calcolo su server remoti.
La piattaforma ha oltre 90 connettori integrati per collegare varie sorgenti, tra cui data store on-premise, API REST e server cloud. Quindi il componente “copy activity” copia i dati dalla sorgente alla destinazione (sink).
Se già utilizzi servizi Microsoft per altre operazioni sui dati, Azure Data Factory è una soluzione completa per le tue esigenze di data ingestion. Il nostro tutorial su Azure Data Factory ti guida nella configurazione di workflow di data ingestion su Azure.
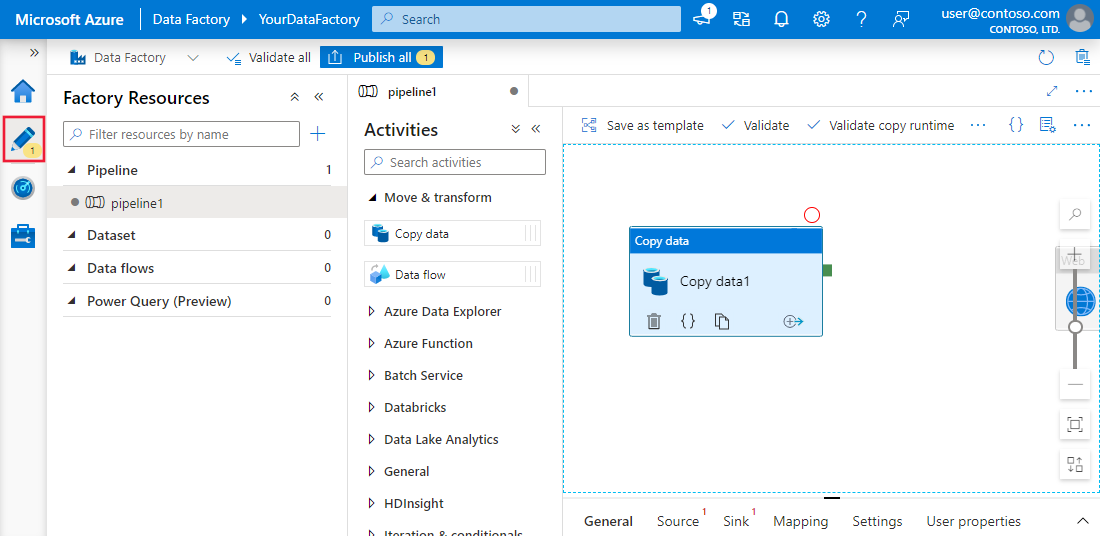
Esperienza dell’interfaccia utente di Azure Data Factory e Synapse Analytics. Immagine: Microsoft Learn
Talend è una piattaforma open source end-to-end per l’integrazione dei dati. Rende semplice costruire workflow di data ingestion, offrendo componenti drag-and-drop per collegare diverse sorgenti e destinazioni.
Talend è noto per spostare dati tra sistemi mantenendone la qualità. Il suo set di strumenti per la data quality assicura l’accuratezza dei dati durante l’ingestion. Inoltre, le funzionalità di monitoraggio integrate consentono di rispettare le normative di sicurezza e governance dei dati.
Fivetran è una popolare piattaforma di integrazione dati che automatizza i task ELT. Fornisce dati ininterrotti adattandosi automaticamente ai cambi di formato. Questa funzione aiuta anche a mantenere l’accuratezza attraverso il mapping dello schema durante l’ingestion.
Il principale vantaggio di strumenti come Fivetran è la manutenzione nulla. La gestione automatica degli schemi e il monitoraggio consentono pipeline auto-mantenute.
Inoltre, lo strumento include funzionalità di CDC (change data capture), garantendo che la destinazione sia aggiornata in tempo reale.
Per chi non lo conoscesse, il CDC è il processo di identificare le modifiche recenti apportate a un database e rifletterle nella destinazione in tempo reale.
Airbyte è un altro strumento open source di data ingestion in elenco. È la piattaforma di integrazione dati più popolare ed è usata da oltre 3000 aziende.
Con oltre 300 connettori predefiniti, Airbyte offre il supporto più ampio per varie connessioni di sorgenti e destinazioni. Inoltre, essendo open source, puoi esaminare il codice di questi connettori e personalizzarli. Se il tuo caso d’uso non è coperto, puoi scrivere un tuo connettore di sorgente.
Airbyte richiede competenze tecniche per configurare e mantenere le pipeline, soprattutto per i connettori personalizzati. Tuttavia, offre piani a pagamento con servizi completamente gestiti e supporto dedicato.
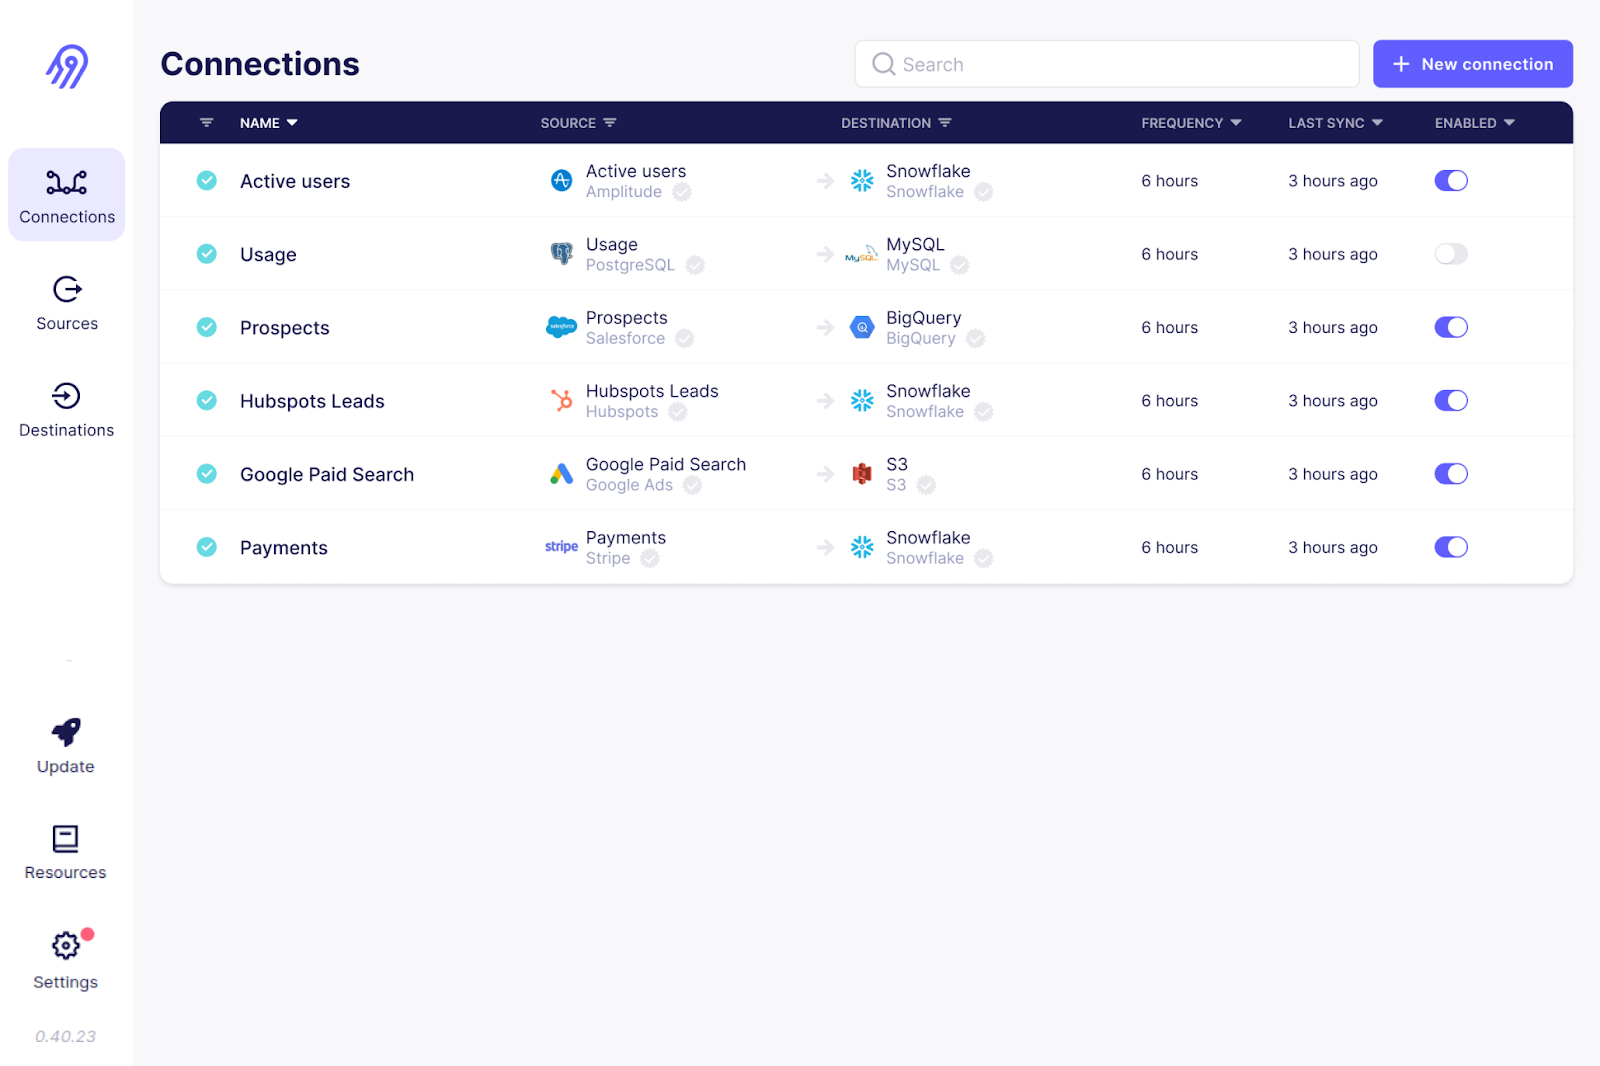
L’interfaccia utente di Airbyte. Immagine fonte: Airbyte GitHub
Informatica Intelligent Data Management Cloud include una suite di strumenti per semplificare la data ingestion. Il suo strumento “Data Loader” impiega solo pochi minuti per caricare dati da oltre 30 servizi cloud.
Informatica dispone anche di uno strumento di integrazione applicativa che collega software eterogenei, sia on-premise che nel cloud. La sua piattaforma di integrazione dati cloud è ben progettata per ingestion ad alte prestazioni con ETL/ELT.
Progettata per gestire dati batch e in tempo reale, Informatica consente di ingerire qualsiasi tipo di dato da database relazionali, applicazioni e file system. Inoltre, la piattaforma fornisce funzionalità di AI come il motore CLAIRE, che analizza i metadati e suggerisce dataset pertinenti per le tue esigenze di data ingestion.
Apache Flume è un servizio distribuito e affidabile per caricare dati di log nelle destinazioni. La sua architettura flessibile è progettata in particolare per flussi di dati in streaming, ad esempio da più web server a HDFS o ElasticSearch in quasi tempo reale.
Il Flume agent è il componente principale responsabile dei movimenti dei dati. È composto da channel, sink e source. Il componente source preleva i file dalla sorgente dati, mentre il sink garantisce la sincronizzazione tra destinazione e sorgente. È possibile configurare più Flume agent per un’ingestion parallela quando si eseguono streaming di grandi volumi di dati.
Apache Flume è noto per la sua tolleranza ai guasti. Con molteplici meccanismi di failover e ripristino, Flume garantisce un’ingestion coerente e affidabile anche in caso di errori.
Stitch è uno strumento ETL cloud semplice ed estensibile. Pur non avendo complesse funzionalità di trasformazione personalizzate, è perfetto per attività di data ingestion.
Come altri strumenti ETL enterprise, Stitch offre una gamma di connettori verso oltre 140 sorgenti, tipicamente da applicazioni SaaS e database verso data warehouse e data lake. Per workflow di ingestion personalizzati, Stitch si integra con Singer, permettendoti di creare connettori su misura.
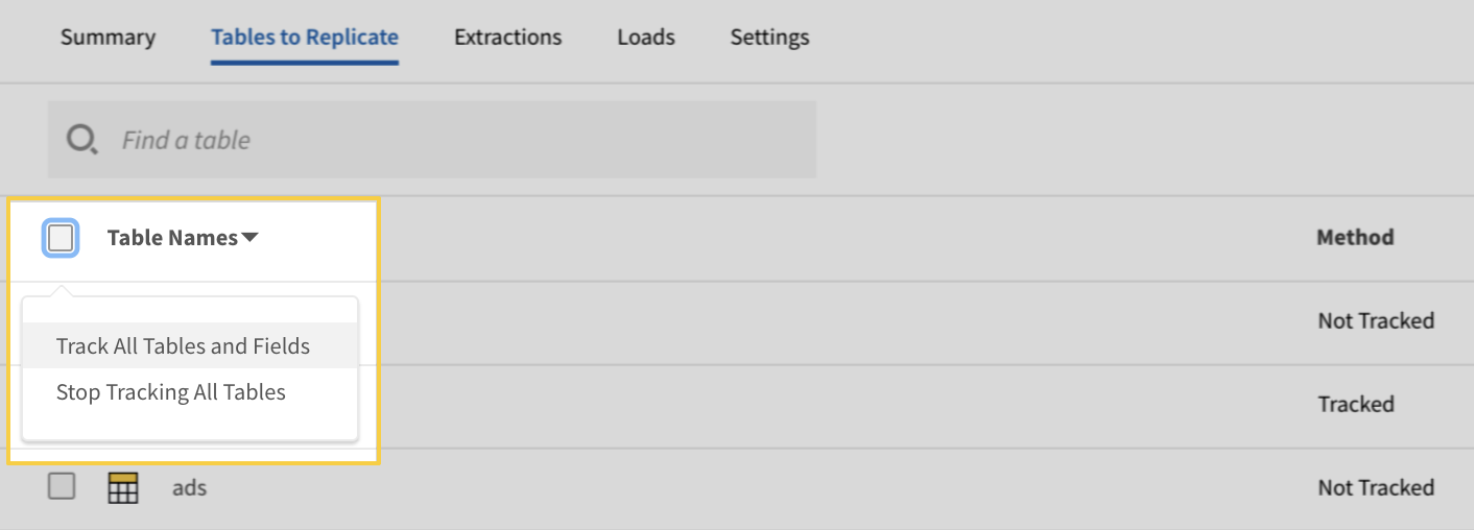
Interfaccia utente di estrazione dati di Stitch. Immagine: Documentazione Stitch
StreamSets, acquisita da IBM, è un motore open source di integrazione dati per stream, batch e CDC. La funzione “Data Collector” offre connettori drag-and-drop per piattaforme cloud come AWS, Microsoft Azure e Google Cloud, oltre a sistemi on-premise.
Non ti servono competenze IT per creare o modificare pipeline di data ingestion: l’interfaccia drag-and-drop del Data Collector è molto intuitiva.
StreamSets è uno strumento agnostico rispetto alla piattaforma, che permette di costruire pipeline del Data Collector adatte a più ambienti con minime riconfigurazioni. Oltre ai Data Collector, la piattaforma include data transformer che operano su Apache Spark per trasformazioni complesse.
Apache Beam è una soluzione unificata che fornisce un unico modello di programmazione per casi d’uso batch e streaming. Funziona senza problemi con piattaforme cloud come Google Cloud Dataflow, Apache Flink e Apache Spark.
Per la data ingestion in tempo reale, puoi definire finestre fisse, scorrevoli e di sessione per raggruppare ed elaborare rapidamente i dati.
Apache Beam si distingue per la flessibilità. Consente di definire pipeline in qualsiasi linguaggio di programmazione ed eseguirle su più motori di esecuzione.
Hevo Data è una piattaforma completamente gestita e no-code per spostare dati da oltre 150 sorgenti verso la destinazione che preferisci. Lo strumento non solo gestisce la data ingestion, ma trasforma anche i dati rendendoli pronti per l’analisi.
La piattaforma rileva automaticamente lo schema dei dati in ingresso e lo abbina a quello di destinazione, offrendo flessibilità.
Hevo Data offre inoltre un’architettura robusta e tollerante ai guasti, che assicura nessuna perdita di dati durante l’ingestion. Nel complesso, Hevo Data è la scelta ideale per streaming e analisi in tempo reale.
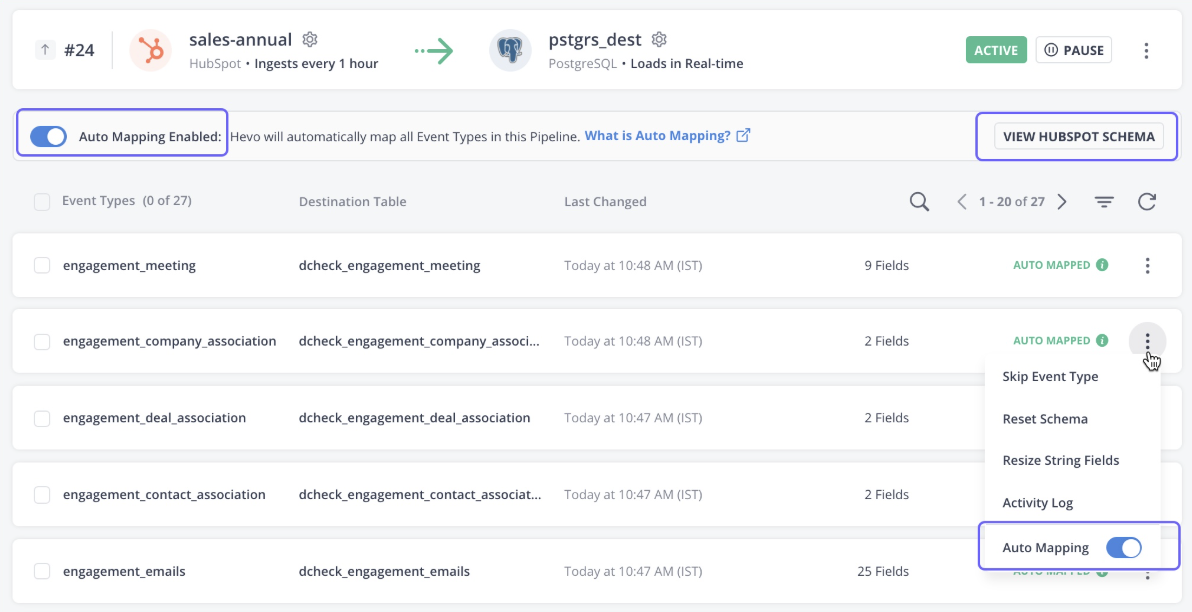
Interfaccia utente di Hevo Data. Immagine: Documentazione Hevo
Segment è una customer data platform che fornisce dati cliente puliti e trasformati per l’analisi. La piattaforma è specializzata nella raccolta di vari tipi di dati sui clienti, come interazioni, impression, clic e altri dati comportamentali.
La Track API dello strumento raccoglie eventi da più fonti, tra cui mobile, web e server. Con pochi clic, i dati possono essere integrati con oltre 450 app.
I dati raccolti tramite Segment sono disponibili agli utenti via query SQL, mentre gli sviluppatori possono accedere ai dati in tempo reale tramite comandi curl.
Matillion è una piattaforma cloud-native di integrazione dati pensata per spostare e trasformare dati nel cloud. È ottimizzata per potenti data warehouse cloud come Snowflake, Amazon Redshift e Google BigQuery.
La piattaforma offre un’ampia gamma di connettori predefiniti per sorgenti sia cloud che on-premise, inclusi database, applicazioni SaaS, piattaforme social e altro.
Con il suo focus sulle prestazioni, Matillion offre anche robuste capacità di trasformazione per ripulire e preparare i dati all’analisi.
Keboola, progettato specificamente per eseguire trasformazioni complesse, offre funzionalità di data ingestion personalizzate. Con oltre 250 integrazioni integrate tra sorgenti e destinazioni, automatizza la data ingestion in pochi clic.
Keboola supporta sia il batch sia lo streaming in tempo reale per importare dati enterprise. Tuttavia, per la data ingestion in tempo reale è necessaria competenza di coding per configurare i webhook.
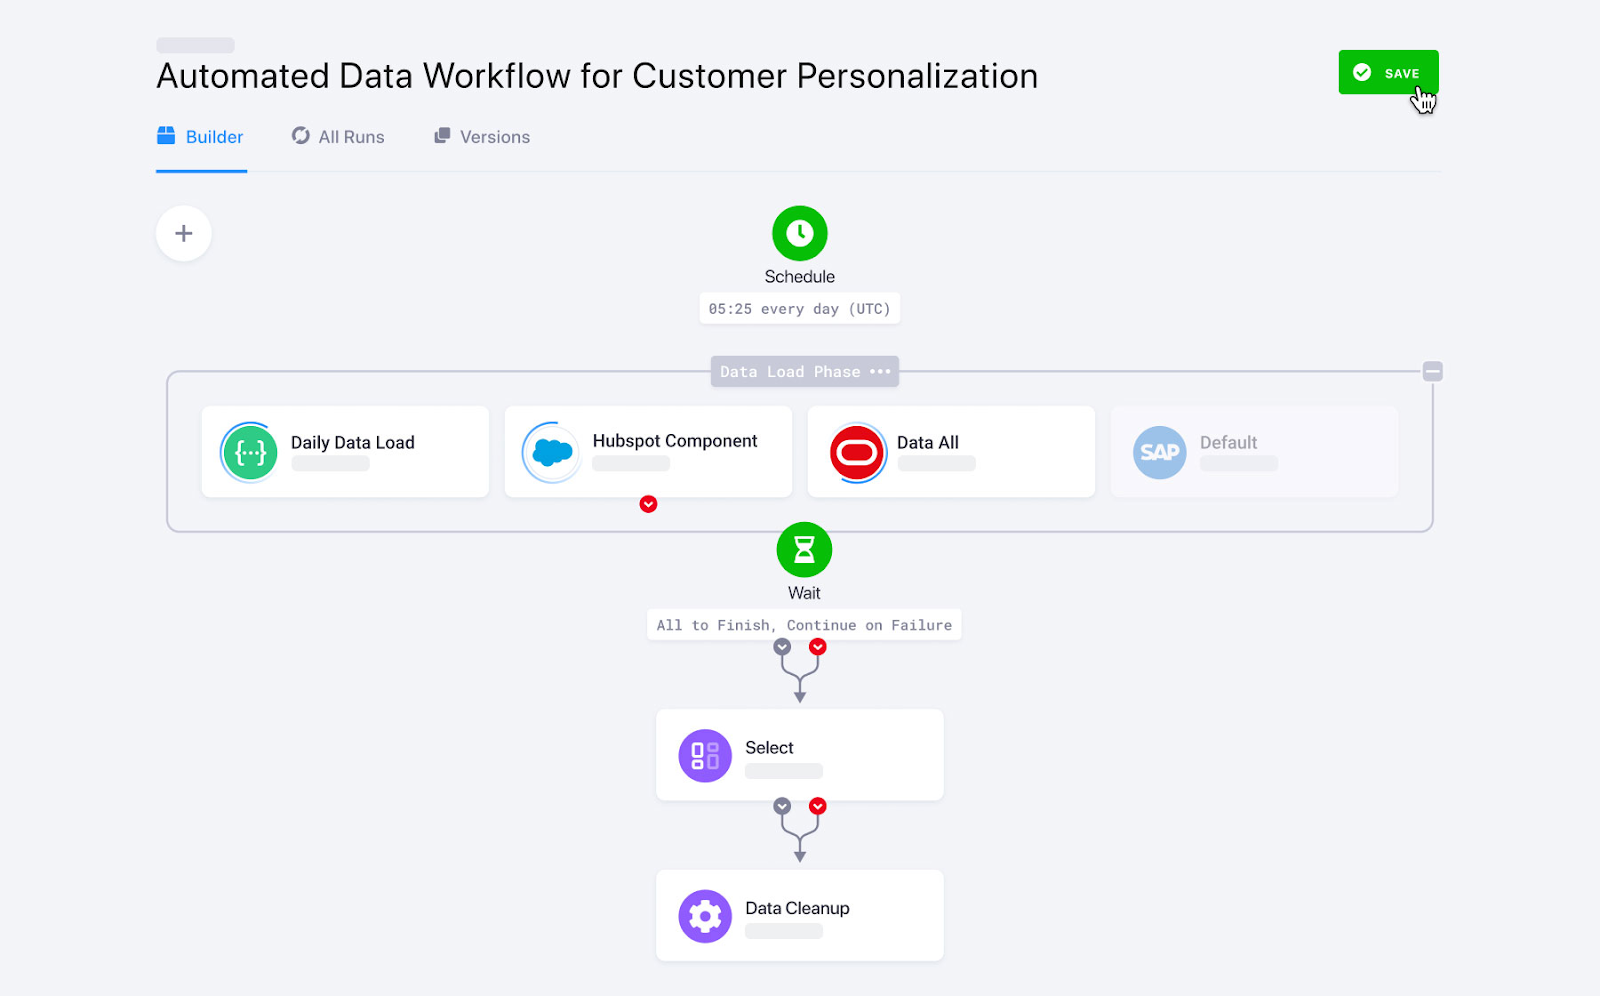
Workflow di dati in Keboola. Immagine: Keboola
Snowplow è una piattaforma di raccolta dati di nuova generazione che cattura ed elabora eventi da varie fonti. È specializzata nella raccolta di dati comportamentali dei clienti e nella loro preparazione per analisi avanzate di AI e machine learning.
Snowplow utilizza internamente tracker e webhook per raccogliere eventi in tempo reale.
I tracker sono librerie o SDK integrabili in app mobile, siti web e applicazioni lato server. Raccolgono informazioni sugli eventi, come interazioni, clic e like, e le inviano ai collector. I collector quindi fanno passare i dati attraverso un processo di arricchimento prima di inviarli al data warehouse di destinazione.
IBM DataStage è una piattaforma leader di integrazione dati progettata per operazioni ETL ed ELT. La versione base è disponibile on-premise, ma per sperimentare scala e automazione tramite cloud è possibile passare a DataStage for IBM Cloud Pak®.
Il suo ampio set di connettori e stage predefiniti automatizza il movimento dei dati tra molteplici sorgenti cloud e data warehouse.
Per chi ha impostato l’architettura dati nell’ecosistema IBM, DataStage è lo strumento di riferimento per la data ingestion. Si integra con altre piattaforme IBM, come Cloud Object Storage e Db2, per ingestion e trasformazione.
Alteryx è conosciuta per i suoi strumenti di analisi e visualizzazione dei dati. Con oltre 8000 clienti, è una piattaforma di analytics molto diffusa che automatizza attività su dati e analisi.
Alteryx dispone di uno strumento chiamato Designer Cloud che offre un’interfaccia intuitiva per costruire pipeline di data ingestion per casi d’uso di analytics e AI. Offre connettività a varie sorgenti dati, inclusi data warehouse, archiviazione cloud e file system.
Vuoi semplificare preparazione dei dati e analytics senza programmare? Scopri come automatizzare i workflow con Introduction to Alteryx e sblocca funzionalità ETL drag-and-drop.
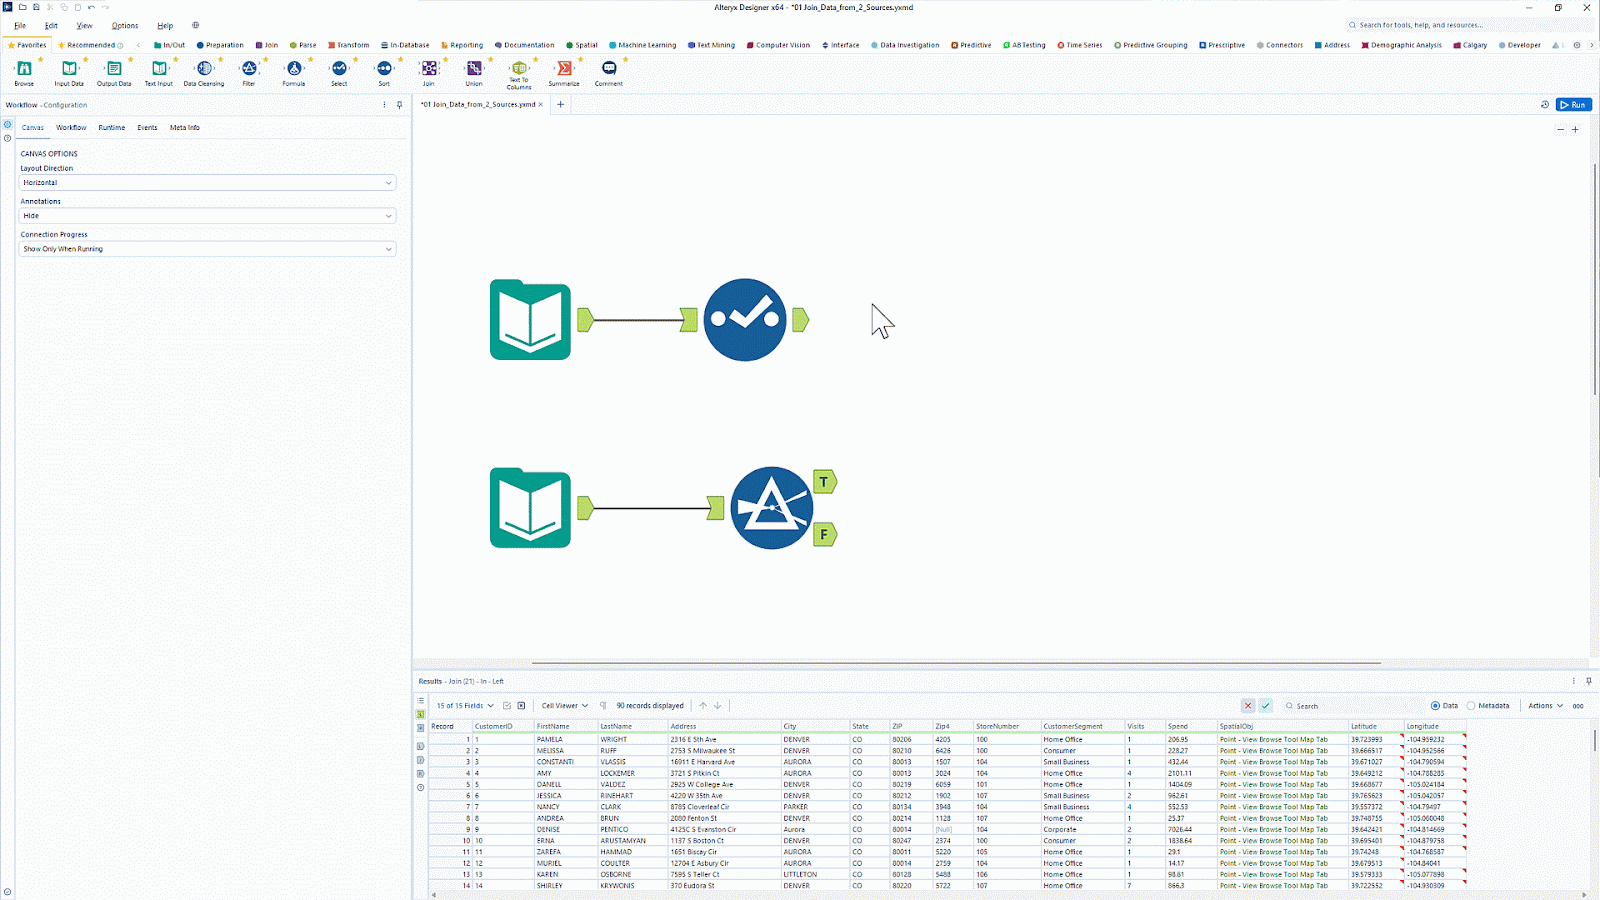
Interfaccia utente drag-and-drop di Alteryx. Immagine: Alteryx
|
Strumento |
Ideale per |
Funzionalità |
Prezzi |
|
Apache Kafka |
Streaming di dati in tempo reale |
|
Open source |
|
Apache Nifi |
Data ingestion sicura in tempo reale |
|
Open source |
|
AWS Glue |
Ecosistema AWS |
|
Modello di prezzo pay-as-you-go. I costi si basano sulla quantità di elaborazione dati utilizzata per ora. |
|
Google cloud dataflow |
Ecosistema Google Cloud |
|
Modello di prezzo pay-as-you-go. I costi si basano sulle risorse di calcolo e la memoria utilizzate. |
|
Azure data factory |
Aziende che usano altri servizi Azure di Microsoft |
|
Modello di prezzo pay-as-you-go |
|
Talend |
Aziende con budget ridotto in cerca di una soluzione ETL intuitiva |
|
Open source |
|
Fivetran |
Esigenze ELT completamente gestite |
|
Prezzo su abbonamento |
|
Airbyte |
Organizzazioni in cerca di una soluzione open source personalizzabile |
|
Disponibili sia servizi open source che a pagamento. |
|
Informatica |
Aziende che cercano strumenti low-code con connettori estesi alle sorgenti |
|
prova gratuita di 30 giorni, modello pay-as-you-go |
|
Apache Flume |
Flussi di dati in streaming |
|
Open source |
|
Stitch |
Organizzazioni in cerca di uno strumento semplice per attività di data ingestion |
|
Puoi scegliere modelli basati su livelli o pay-as-you-use |
|
StreamSets |
Trasformazioni dati complesse |
|
Disponibili opzioni sia open source che commerciali |
|
Apache Beam |
Framework personalizzabile e code-centric per costruire pipeline di data ingestion |
|
Il framework Apache Beam è open source, ma si sostengono costi quando usato con servizi cloud. |
|
Hevo Data |
Aziende di medie dimensioni che necessitano di analytics in tempo reale |
|
Prezzo su abbonamento |
|
Segment |
Dati di eventi dei clienti |
|
Modello di prezzo in abbonamento |
|
Matillion |
Strumento ETL/ELT cloud-native |
|
Modello di prezzo in abbonamento |
|
Keboola |
Pipeline di trasformazione dati complesse |
|
Modello di prezzo in abbonamento |
|
Snowplow |
Raccolta di dati di evento |
|
Disponibili opzioni sia open source che commerciali |
|
IBM DataStage |
Ecosistema IBM Cloud |
|
Modello di prezzo in abbonamento |
|
Alteryx |
Data analytics e visualizzazione |
|
Modello di prezzo in abbonamento |
Con così tanti strumenti sul mercato, scegliere la piattaforma di integrazione dati giusta per le tue esigenze può essere difficile. Ecco un elenco di fattori da considerare prima di optare per uno strumento specifico.
È facile ingerire un foglio Excel o un file CSV nelle destinazioni. Tuttavia, ingerire manualmente dati in streaming in tempo reale da più fonti verso varie destinazioni può essere impegnativo. Ad esempio, le applicazioni moderne, come i social, spesso hanno picchi di domanda in certi momenti e cali in altri. Qui entra in gioco la scalabilità degli strumenti di data ingestion.
Per scalabilità si intende la capacità di crescere o ridursi in base alla domanda. Questo permette allo strumento di adattarsi rapidamente all’aumento dei volumi di dati senza compromettere le prestazioni.
Per flessibilità si intende la capacità di gestire dati da varie sorgenti e in vari formati. Gli strumenti di data ingestion che supportano molte sorgenti e offrono connettori personalizzati garantiscono flessibilità nei sistemi di ingestion.
Ad esempio, la funzionalità di mapping automatico dello schema rileva lo schema dei dati in ingresso e lo mappa sulla destinazione senza vincolarlo a una struttura predefinita. Questo consente di ingerire dati con qualsiasi schema.
La data ingestion a batch raccoglie i dati secondo una pianificazione e li aggiorna nella destinazione. La data ingestion in tempo reale, invece, trasferisce continuamente i dati senza ritardi.
Molti strumenti di data ingestion oggi supportano sia batch che tempo reale. Tuttavia, se lavori spesso con dati in tempo reale, come eventi dei clienti o video streaming, scegli uno strumento con elevato throughput e bassa latenza.
I diversi strumenti di data ingestion hanno strutture di prezzo differenti. Alcuni offrono prezzi a livelli, altri seguono un modello pay-as-you-go. Queste soluzioni sono spesso più convenienti degli strumenti open source, perché quelli gratuiti richiedono di assumere esperti per abilitare la data ingestion. Tuttavia, gli strumenti open source offrono grande flessibilità e personalizzazione per il tuo caso d’uso.
Alcuni strumenti a pagamento offrono anche funzionalità di livello enterprise con ampie possibilità di personalizzazione, sebbene a un costo. In base al tuo budget e alle esigenze di personalizzazione, dovresti quindi scegliere tra piattaforme a pagamento e open source.
La scelta dello strumento di data ingestion giusto dipende dalle tue esigenze specifiche — che tu dia priorità allo streaming in tempo reale, all’elaborazione a batch, alla compatibilità con il cloud o alla facilità d’integrazione. Gli strumenti sopra elencati offrono un ventaglio di opzioni per semplificare la raccolta dei dati e il caricamento nei sistemi di destinazione in modo efficiente.
Se sei alle prime armi con la data engineering e vuoi approfondire come i dati scorrono nelle pipeline moderne, esplora il corso Introduction to Data Engineering. Se invece vuoi saperne di più su processi ETL ed ELT in Python, ETL and ELT in Python è un’ottima risorsa per fare pratica con le tecniche di data ingestion.
Approfondisci la data engineering con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min



