
4. Google Cloud Dataflow
Dataflow is een volledig beheerde Google Cloud-service voor stream- en batchverwerking. Het kan eenvoudige datapijplijnen aan, zoals het op geplande tijden verplaatsen van data tussen systemen, maar ook geavanceerde realtime pijplijnen.
Bovendien is de tool zeer schaalbaar en ondersteunt hij een naadloze overgang van batch- naar streamverwerking wanneer nodig.
Google Dataflow is gebouwd bovenop Apache Beam. Je kunt dus ingestiepijplijnen coderen met Beam SDK's. Daarnaast biedt de tool vooraf gedefinieerde workflowtemplates om pijplijnen direct te creëren. Ontwikkelaars kunnen ook eigen templates maken en deze beschikbaar stellen voor niet-technische gebruikers om on demand te deployen.
5. Azure Data Factory
Azure Data Factory (ADF) is Microsofts cloudservice voor het binnenhalen van data uit meerdere bronnen. Het is ontworpen om workflows te maken, te plannen en te orkestreren om het proces te automatiseren.
ADF slaat zelf geen data op. Het ondersteunt databeweging tussen systemen en verwerkt dit via compute-resources op externe servers.
Het platform heeft meer dan 90 ingebouwde connectors om verschillende databronnen te koppelen, waaronder on-premises datastores, REST API's en cloudservers. Vervolgens kopieert de component 'copy activity' de data van de bron naar de sink.
Als je al Microsoft-services gebruikt voor andere data-activiteiten, is Azure Data Factory een alles-in-éénoplossing voor je data-ingestiebehoeften. Onze Azure Data Factory-tutorial leidt je stap voor stap door het opzetten van data-ingestieworkflows op Azure.
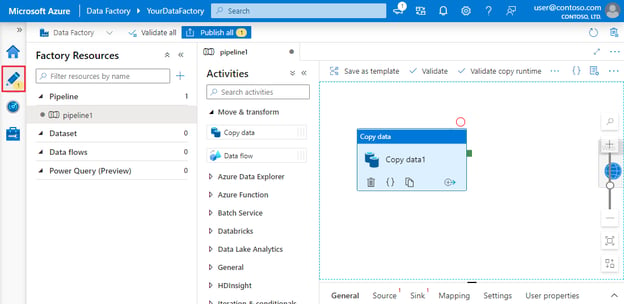
Gebruikersinterface-ervaring van Azure Data Factory en Synapse Analytics. Afbeeldingbron: Microsoft Learn
6. Talend
Talend is een open-source, end-to-end data-integratieplatform. Het maakt het bouwen van data-ingestieworkflows eenvoudig, met drag-and-dropcomponenten om verschillende bronnen en bestemmingen te verbinden.
Talend staat bekend om het verplaatsen van data tussen systemen met behoud van kwaliteit. De robuuste set datakwaliteitstools zorgt voor nauwkeurigheid tijdens ingestie. Bovendien maken de ingebouwde monitoringmogelijkheden naleving van databeveiligings- en governanceregels mogelijk.
7. Fivetran
Fivetran is een populair data-integratieplatform dat ELT-taken automatiseert. Het levert ononderbroken data door automatisch aanpassingen in dataformaten over te nemen. Deze functie helpt ook datanauwkeurigheid te behouden via schemamapping tijdens ingestie.
Het grootste voordeel van tools als Fivetran is dat ze geen onderhoud vergen. De automatische schemabeheer- en monitoringfuncties maken zelfonderhoudende pijplijnen mogelijk.
Daarnaast bevat de tool CDC (change data capture)-mogelijkheden, waardoor de bestemming realtime up-to-date blijft.
Voor wie het niet kent: CDC verwijst naar het proces waarbij recente updates in een database worden geïdentificeerd en realtime in de bestemming worden weerspiegeld.
8. Airbyte
Airbyte is een andere open-source tool voor data-ingestie in deze lijst. Het is het populairste data-integratieplatform en wordt door meer dan 3000 bedrijven gebruikt.
Met meer dan 300 kant-en-klare connectors biedt Airbyte de meest uitgebreide ondersteuning voor verschillende bron- en bestemmingsverbindingen. Bovendien kun je, omdat het open source is, in de code van deze connectors duiken en ze aanpassen. Als jouw use case niet wordt gedekt, kun je je eigen bronconnector schrijven.
Airbyte vereist technische expertise om pijplijnen op te zetten en te onderhouden, zeker bij aangepaste connectors. Er zijn echter betaalde plannen met volledig beheerde services en dedicated support.
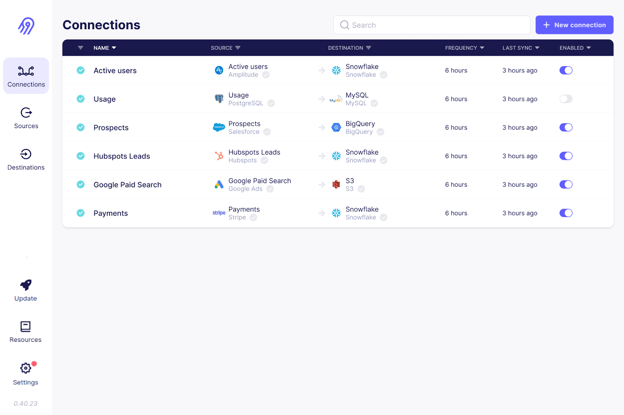
De Airbyte-gebruikersinterface. Afbeelding bron: Airbyte GitHub
9. Informatica
Informatica’s intelligente datamanagementcloud bevat een reeks tools om data-ingestie te vereenvoudigen. De tool ‘Data Loader’ laadt binnen enkele minuten data van meer dan 30 clouddiensten.
Informatica heeft ook een applicatie-integratietool die uiteenlopende softwaresystemen koppelt, zowel on-premises als in de cloud. Het cloud data-integratieplatform is goed ontworpen voor high-performance data-ingestie met ETL/ELT.
Informatica is ontworpen voor zowel batch- als realtime data en kan elk type data binnenhalen uit relationele databases, applicaties en bestandssystemen. Daarnaast biedt het platform AI-mogelijkheden zoals de CLAIRE Engine, die metadata analyseert en relevante datasets suggereert voor jouw data-ingestiebehoeften.
10. Apache Flume
Apache Flume is een gedistribueerde en betrouwbare service voor het laden van logdata naar bestemmingen. De flexibele architectuur is speciaal ontworpen voor streamingdatastromen, zoals van meerdere webservers naar HDFS of ElasticSearch in near-realtime.
De Flume-agent is de belangrijkste component die verantwoordelijk is voor databewegingen. Hij bestaat uit een channel, sink en source. De source-component pikt de databestanden op uit de bron, en de sink zorgt voor de synchronisatie tussen bestemming en bron. Meerdere Flume-agents kunnen worden geconfigureerd voor parallelle data-ingestie bij het streamen van grote volumes data.
Apache Flume staat bekend om zijn fouttolerantie. Met meerdere failover- en herstelmechanismen zorgt Flume voor consistente en betrouwbare data-ingestie, zelfs bij storingen.
11. Stitch
Stitch is een eenvoudige en uitbreidbare cloud-ETL-tool. Hoewel het geen complexe, aangepaste transformaties ondersteunt, is het perfect voor data-ingestietaken.
Net als andere enterprise ETL-tools biedt Stitch een reeks connectors naar meer dan 140 databronnen, doorgaans van SaaS-applicaties en databases naar datawarehouses en -lakes. Voor aangepaste data-ingestieworkflows integreert Stitch met Singer, waardoor je eigen connectors kunt bouwen.
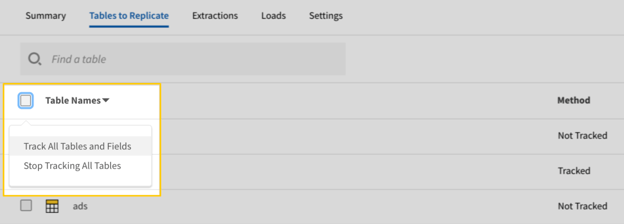
Gebruikersinterface voor data-extractie in Stitch. Afbeeldingsbron: Stitch-documentatie
12. StreamSets
StreamSets, overgenomen door IBM, is een open-source data-integratie-engine voor stream-, batch- en CDC-data. De ‘Data Collector’-functie biedt drag-and-dropsourceconnectors voor cloudplatforms zoals AWS, Microsoft Azure en Google Cloud, evenals on-premises systemen.
Je hebt geen IT-expertise nodig om pijplijnen voor data-ingestie te maken of te bewerken — de drag-and-drop-UI van de data collector is zeer intuïtief.
StreamSets is een platform-agnostische tool waarmee gebruikers data collector-pijplijnen kunnen bouwen die in meerdere omgevingen passen met minimale herconfiguraties. Naast data collectors heeft het platform datatransformers die draaien op Apache Spark voor complexe datatransformaties.
13. Apache Beam
Apache Beam is een uniforme oplossing die één programmeermodel biedt voor batch- en streaminguse cases. Het werkt naadloos met cloudplatforms zoals Google Cloud Dataflow, Apache Flink en Apache Spark.
Voor realtime data-ingestie kun je vaste, schuivende en sessievensters definiëren om data snel te groeperen en te verwerken.
Apache Beam valt op door zijn flexibiliteit. Het laat toe om pijplijnen in elke programmeertaal te definiëren en op meerdere execution engines te draaien.
14. Hevo Data
Hevo Data is een volledig beheerd, no-codeplatform voor het verplaatsen van data van meer dan 150 bronnen naar de bestemming van jouw keuze. De tool verzorgt niet alleen de data-ingestie, maar transformeert de data ook zodat deze klaar is voor analyse.
Het platform detecteert automatisch het schema van binnenkomende data en matcht dit met het doelschema, wat flexibiliteit biedt.
Hevo Data biedt ook een robuuste, fouttolerante architectuur, zodat er geen dataverlies optreedt tijdens data-ingestie. Al met al is Hevo Data de ideale keuze voor streaming- en realtime analytics-use cases.
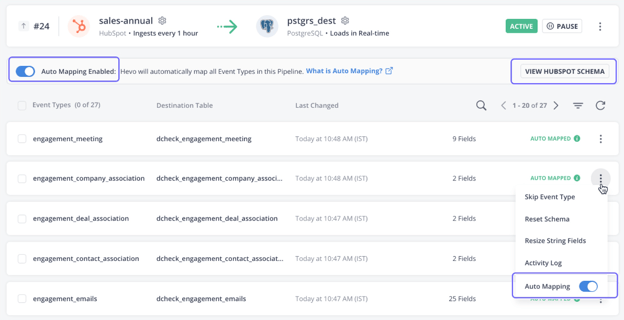
Hevo Data-gebruikersinterface. Afbeeldingsbron: Hevo-documentatie
15. Segment
Segment is een customer data-platform dat schone en getransformeerde klantdata levert voor analytics. Het platform is gespecialiseerd in het verzamelen van verschillende soorten klantdata, zoals interacties, impressies, kliks en ander gedragsdata.
De Track API van de tool verzamelt eventdata uit meerdere bronnen, waaronder mobiel, web en server. Met slechts een paar klikken kan de data worden geïntegreerd met meer dan 450 apps.
De via Segment verzamelde data is beschikbaar voor gebruikers via SQL-queries, terwijl programmeurs realtime data kunnen benaderen met curl-commando's.
16. Matillion
Matillion is een cloud-native data-integratieplatform dat is ontworpen om data in de cloud te verplaatsen en te transformeren. Het is vooral geschikt voor krachtige cloud datawarehouses zoals Snowflake, Amazon Redshift en Google BigQuery.
Het platform biedt een breed scala aan vooraf gebouwde connectors voor zowel cloud- als on-premises databronnen, waaronder databases, SaaS-applicaties, socialmediaplatforms en meer.
Met de focus op performance biedt Matillion ook sterke transformatiefuncties om data te schonen en voor te bereiden voor verdere analyse.
17. Keboola
Keboola, speciaal ontworpen voor het uitvoeren van complexe transformaties, biedt faciliteiten voor aangepaste data-ingestie. Met meer dan 250 ingebouwde integraties tussen bronnen en bestemmingen automatiseert het met een paar klikken data-ingestie.
Keboola ondersteunt zowel batch- als realtime datastreaming om enterprise-data te importeren. Maar voor realtime data-ingestie heb je wel codeerexpertise nodig om webhooks op te zetten.
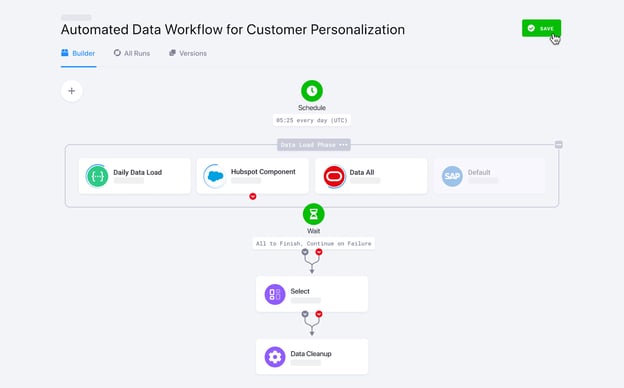
Keboola-dataworkflows. Afbeeldingsbron: Keboola
18. Snowplow
Snowplow is een next-gen dataverzamelplatform dat eventdata uit verschillende bronnen vastlegt en verwerkt. Het is gespecialiseerd in het verzamelen van klantgedragsdata en het voorbereiden daarvan voor geavanceerde AI- en machinelearninganalyse.
Snowplow gebruikt intern trackers en webhooks om realtime eventdata te verzamelen.
Trackers zijn de libraries of SDK's die kunnen worden geïntegreerd in mobiele apps, websites en server-side applicaties. Ze verzamelen eventinformatie zoals gebruikersinteracties, kliks en likes en sturen die naar collectors. De collectors sturen de data vervolgens door een verrijkingsproces voordat deze naar het datawarehouse wordt gestuurd.
19. IBM DataStage
IBM DataStage is een toonaangevend data-integratieplatform, gebouwd voor ETL- en ELT-operaties. De basisversie is on-premises beschikbaar, maar om schaal en automatisering via de cloud te ervaren, kun je upgraden naar DataStage voor IBM Cloud Pak®.
De uitgebreide set vooraf gebouwde connectors en stages automatiseert de databeweging tussen meerdere cloudbronnen en datawarehouses.
Voor wie zijn data-architectuur in het IBM-ecosysteem heeft ingericht, is DataStage de aangewezen tool voor data-ingestie. Het integreert met andere IBM-dataplatforms, zoals Cloud Object Storage en Db2, voor ingestie en transformatie.
20. Alteryx
Alteryx staat bekend om zijn data-analytics- en visualisatietools. Met meer dan 8000 klanten is het een populair analyticsplatform dat data- en analytische taken automatiseert.
Alteryx heeft een tool genaamd Designer Cloud met een intuïtieve interface voor het bouwen van data-ingestiepijplijnen voor analytics- en AI-use cases. Het biedt connectiviteit met verschillende databronnen, waaronder datawarehouses, cloudopslag en bestandssystemen.
Wil je datavoorbereiding en analytics vereenvoudigen zonder te coderen? Leer hoe je workflows automatiseert met Introduction to Alteryx en ontgrendel drag-and-drop-ETL-mogelijkheden.
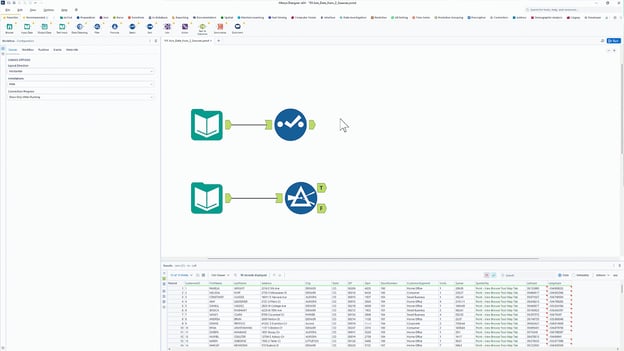
Alteryx drag-and-drop-gebruikersinterface. Afbeeldingsbron: Alteryx
Samenvattende tabel van tools voor data-ingestie
|
Tool |
Beste voor |
Functies |
Prijzen |
|
Apache Kafka |
Realtime datastreaming |
|
Open source |
|
Apache Nifi |
Beveiligde realtime data-ingestie |
|
Open source |
|
AWS Glue |
AWS-ecosysteem |
|
Pay-as-you-go-prijsmodel. Kosten zijn gebaseerd op het aantal gebruikte dataverwerkingsuren. |
|
Google cloud dataflow |
Google Cloud-ecosysteem |
|
Pay-as-you-go-prijsmodel. Kosten zijn gebaseerd op de gebruikte compute-resources en het geheugen. |
|
Azure data factory |
Bedrijven die andere Azure-services van Microsoft gebruiken |
|
Pay-as-you-go-prijsmodel |
|
Talend |
Bedrijven met beperkt budget die een intuïtieve ETL-oplossing zoeken |
|
Open source |
|
Fivetran |
Volledig beheerde ELT-behoeften |
|
Abonnementsprijs |
|
Airbyte |
Organisaties die een open-source maatwerkoplossing zoeken |
|
Zowel open source als betaalde services beschikbaar. |
|
Informatica |
Bedrijven die low-code tools met veel bronconnectors zoeken |
|
gratis proefperiode van 30 dagen, pay-as-you-go-prijsmodel |
|
Apache Flume |
Streamingdatastromen |
|
Open source |
|
Stitch |
Organisaties die een eenvoudige tool voor data-ingestietaken zoeken |
|
Je kunt kiezen uit getrapte tarieven of pay-as-you-use-prijsmodellen |
|
StreamSets |
Complexe datatransformaties |
|
Zowel open-source als commerciële opties beschikbaar |
|
Apache Beam |
Aanpasbaar, codegericht framework voor het bouwen van pijplijnen voor data-ingestie |
|
Het Apache Beam-framework is open source, maar er zijn kosten wanneer het met clouddiensten wordt gebruikt. |
|
Hevo Data |
Middelgrote bedrijven die realtime analytics nodig hebben |
|
Abonnementsprijs |
|
Segment |
Klant-eventdata |
|
Abonnementsprijsmodel |
|
Matillion |
Cloud-native ETL/ELT-tool |
|
Abonnementsprijsmodel |
|
Keboola |
Complexe datatransformatiepijplijnen |
|
Abonnementsprijsmodel |
|
Snowplow |
Verzamelen van eventdata |
|
Zowel open-source als commerciële opties beschikbaar |
|
IBM DataStage |
IBM Cloud-ecosysteem |
|
Abonnementsprijsmodel |
|
Alteryx |
Data-analytics en visualisatie |
|
Abonnementsprijsmodel |
Criteria voor het kiezen van tools voor data-ingestie
Met zoveel tools in de industrie kan het lastig zijn om het juiste data-integratieplatform voor jouw doelen te kiezen. Hier is een lijst met factoren die je zou moeten overwegen voordat je voor één specifieke data-integratietool kiest.
Schaalbaarheid
Een Excel- of CSV-bestand kun je gemakkelijk naar een bestemming laden. Maar realtime streamingdata handmatig binnenhalen uit meerdere bronnen en naar verschillende bestemmingen kan een uitdaging zijn. Moderne applicaties, zoals social media, kennen bijvoorbeeld piekbelasting op bepaalde tijden en dalen op andere. Hier blinkt de schaalbaarheid van tools voor data-ingestie uit.
Schaalbaarheid verwijst naar het vermogen om te groeien of te krimpen op basis van de vraag. Hierdoor kan de tool zich snel aanpassen aan toenemende datavolumes zonder in te leveren op performance.
Flexibiliteit
Flexibiliteit verwijst naar het vermogen om data uit verschillende bronnen en formaten te verwerken. Tools voor data-ingestie die diverse databronnen ondersteunen en aangepaste connectors bieden, waarborgen flexibiliteit in data-ingestiesystemen.
Een voorbeeld is automatische schemamapping: deze functie detecteert het schema van binnenkomende data en mappt dit naar de bestemming zonder vast te zitten aan een vooraf gedefinieerde schemastructuur. Zo kan de tool data met elk schema binnenhalen.
Realtime versus batchverwerking
Batch data-ingestie verzamelt data volgens een schema en werkt deze op de bestemming bij. Realtime data-ingestie daarentegen betekent het continu overdragen van data zonder vertraging.
Veel tools voor data-ingestie ondersteunen tegenwoordig zowel batch- als realtime data-ingestie. Maar als je vaak met realtime data werkt, zoals klantgebeurtenissen of videostreaming, kies dan een tool met hoge doorvoer en lage latentie.
Kosten en licenties
Verschillende tools voor data-ingestie hebben uiteenlopende prijsstructuren. Sommige bieden getrapte tarieven, andere volgen een pay-as-you-go-model. Deze oplossingen zijn vaak kostenefficiënter dan open-source tools omdat gratis tools vereisen dat je experts inhuurt om data-ingestie mogelijk te maken. Open-source tools bieden echter veel flexibiliteit en maatwerk voor jouw use case.
Sommige betaalde tools voor data-ingestie bieden ook enterprise-functies met uitgebreide maatwerkmogelijkheden, al brengen die kosten met zich mee. Kies daarom, op basis van je budget en maatwerkwensen, tussen betaalde en open-source platformen.
Conclusie
De juiste tool voor data-ingestie kiezen hangt af van jouw specifieke behoeften — of je nu realtime streaming, batchverwerking, cloudcompatibiliteit of eenvoudige integratie vooropstelt. De bovenstaande tools bieden uiteenlopende opties, zodat je het verzamelen en laden van data naar je doelsystemen efficiënt kunt stroomlijnen.
Ben je nieuw in data engineering en wil je beter begrijpen hoe data door moderne pijplijnen stroomt? Bekijk de Introduction to Data Engineering-cursus. Wie meer wil leren over ETL- en ELT-processen in Python, vindt in ETL and ELT in Python een uitstekende bron om hands-on ervaring op te doen met technieken voor data-ingestie.
Veelgestelde vragen
Wat is een tool voor data-ingestie?
Een tool voor data-ingestie helpt het proces te automatiseren van het verzamelen van data uit diverse bronnen — zoals databases, API's en streamingplatforms — en het laden ervan in een opslagsysteem, datawarehouse of datalake. Deze tools ondersteunen zowel batch- als realtime-ingestie om dataworkflows te stroomlijnen.
Hoe kies ik de juiste tool voor data-ingestie?
Overweeg factoren zoals datavolume, broncompatibiliteit, behoeften aan realtime versus batchverwerking, schaalbaarheid, gemak van integratie en prijs. Werk je met realtime data, dan zijn tools als Apache Kafka ideaal, terwijl batchgebruikers mogelijk de voorkeur geven aan tools als Apache NiFi of Fivetran.
Wat is het verschil tussen batch- en realtime-ingestie?
Batch-ingestie verwerkt data op geplande intervallen (bijv. elk uur of dagelijks) en is geschikt voor grote datasets die geen directe updates nodig hebben. Realtime-ingestie streamt data continu zodra deze binnenkomt, wat snellere besluitvorming mogelijk maakt voor toepassingen zoals fraudedetectie en monitoring.
Zijn open-source tools voor data-ingestie een goede keuze?
Ja! Open-source tools zoals Apache Kafka, Apache NiFi en Airbyte bieden flexibiliteit, kosteneffectiviteit en sterke community-ondersteuning. Ze vereisen echter vaak meer setup en onderhoud dan beheerde of enterprise-oplossingen zoals Fivetran of AWS Glue.
Wat is de rol van ETL en ELT bij data-ingestie?
ETL (Extract, Transform, Load) en ELT (Extract, Load, Transform) zijn datapijplijnaanpakken die worden gebruikt bij ingestie. ETL transformeert data vóór het laden naar de bestemming, terwijl ELT eerst ruwe data laadt en deze daarna transformeert, waarbij het de kracht van moderne cloud datawarehouses zoals Snowflake en BigQuery benut.

Srujana is een freelance techschrijver met een vierjarige opleiding in Computer Science. Schrijven over uiteenlopende onderwerpen, waaronder data science, cloud computing, development, programmeren, security en veel meer, gaat haar vanzelf af. Ze houdt van klassieke literatuur en het ontdekken van nieuwe bestemmingen.


Data-ingestie betekent data verzamelen uit verschillende bronnen en deze naar de bestemming laden. Er zijn veel tools voor data-ingestie op de markt die dit proces voor je kunnen automatiseren en vereenvoudigen.
Na zorgvuldig onderzoek en testen heb ik een lijst samengesteld met de 20 beste tools voor data-ingestie. Elk van deze tools biedt unieke functies, of je nu realtime verwerking, batch-ingestie of ondersteuning voor diverse databronnen nodig hebt.
Laten we in de tools duiken en hun mogelijkheden en ideale use cases verkennen!
1. Apache Kafka
Apache Kafka is een open-source gedistribueerde engine die bekendstaat om zijn hoge doorvoer en lage latentie. Het bevat Kafka Connect, een framework voor het integreren van Kafka met externe databases, bestandssystemen en key-value stores.
Apache Kafka volgt een producer-consumer-architectuur. Dataproducenten sturen data naar Kafka-topics, die als tussenpersoon fungeren en de ontvangen data logisch organiseren binnen hun partities. Tot slot halen consumenten de benodigde data op uit deze Kafka-topics.
Waarom Apache Kafka voor data-ingestie?
Voor lezers die geïnteresseerd zijn in realtime data-ingestie: bekijk Introduction to Apache Kafka om te leren hoe je streamingdata efficiënt verwerkt.
2. Apache NiFi
Apache NiFi is gebouwd om datastromen tussen systemen te automatiseren. In tegenstelling tot Kafka biedt het een intuïtieve interface voor het ontwerpen, uitrollen en monitoren van de datastroom.
De tool gebruikt processors voor data-ingestie. Processors in NiFi behandelen verschillende functies, zoals extractie, publicatie, transformatie of routering van data. Zo haalt een ingebouwde processor als
InvokeHTTPdata op uit een REST API en haaltGetKafkaberichten op uit Kafka-topics.Zodra de processors data beginnen binnen te halen, worden voor elke datapunt FlowFiles aangemaakt. Deze FlowFiles bevatten metadata samen met de daadwerkelijke data en worden op basis van gedefinieerde regels naar hun respectieve bestemmingen gerouteerd.
Apache NiFi-gebruikersinterface. Afbeeldingbron: Apache NiFi user guide.
3. AWS Glue
AWS Glue is een serverloze data-integratieservice van Amazon. Het ontdekt, transformeert en laadt data naar bestemmingen voor analytics- of ML-use cases. Het platform biedt zowel een gebruiksvriendelijke GUI als ontwikkelomgevingen zoals Jupyter-notebooks.
Crawlers en ETL-jobs zijn de twee belangrijkste componenten in AWS Glue. Crawlers scannen de databronnen om het schema te detecteren en voegen metadata toe aan catalogi. ETL-jobs kunnen vervolgens eenvoudig de databron en de structuur ervan ontdekken met behulp van de cataloginformatie.
AWS Glue biedt verschillende manieren om pijplijnen te maken en uit te voeren. Zo kunnen ETL-jobs in Python of Scala worden geschreven om data te transformeren en te laden. Voor niet-coders biedt Glue Studio een intuïtieve interface om workflows te maken zonder dat je hoeft te programmeren.
Als je serverloze ETL-oplossingen verkent, bekijk dan deze AWS Glue-tutorial voor een praktische gids voor het bouwen van schaalbare datapijplijnen.