
4. Google Cloud Dataflow
Dataflow 是 Google Cloud 提供的全托管流式与批处理服务。它既能处理在计划间隔内在系统间移动数据等简单数据管道,也能胜任高级实时管道。
此外,该工具具备极高的可扩展性,并支持在需要时无缝从批处理切换到流处理。
Google Dataflow 构建于 Apache Beam 之上。因此,您可以使用 Beam SDK 编写摄取管道。此外,该工具提供预定义的工作流模板,可快速创建管道。开发者也可创建自定义模板,供非技术用户按需部署。
5. Azure Data Factory
Azure Data Factory(ADF) 是微软的云端服务,用于从多个来源摄取数据。它旨在创建、调度和编排工作流,以自动化流程。
ADF 本身不存储任何数据。它支持系统间的数据移动,并通过远程服务器上的计算资源来处理数据。
该平台内置 90 多个连接器,可链接多种数据源,包括本地数据存储、REST API 和云服务器。随后,“复制活动”(copy activity)会将数据从源端复制到目标端(sink)。
如果您已在其他数据操作中使用微软服务,Azure Data Factory 是满足您数据摄取需求的一站式方案。我们的 Azure Data Factory 教程将带您在 Azure 上搭建数据摄取工作流。
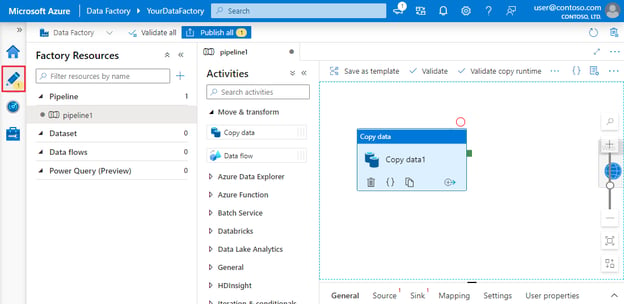
Azure Data Factory 和 Synapse Analytics 的用户界面体验。图片来源:Microsoft Learn
6. Talend
Talend 是一款开源的端到端数据集成平台。它通过拖放式组件连接不同来源与目标,使构建数据摄取工作流变得简单明了。
Talend 以在系统间移动数据同时保持质量而闻名。其强大的数据质量工具集可在摄取过程中确保数据准确性。此外,内置的监控能力有助于遵循数据安全与治理规范。
7. Fivetran
Fivetran 是广受欢迎的数据集成平台,能够自动化 ELT 任务。它可通过自动适配数据格式变更来提供不间断的数据流。该特性也有助于在摄取过程中通过模式映射保持数据准确性。
类似 Fivetran 这类工具的主要优势在于零维护。其自动化的模式管理与监控功能使管道能够自我维护。
此外,该工具包含 CDC(变更数据捕获)能力,确保目标端能够实时保持最新。
对于不熟悉者,CDC 指的是识别数据库的最新更新并将其实时反映到目标端的过程。
8. Airbyte
Airbyte 是清单中的另一款开源数据摄取工具。它是目前最受欢迎的数据集成平台之一,已有超过 3000 家公司在使用。
凭借 300 多个预制连接器,Airbyte 为各种来源与目标的连接提供最广泛的支持。此外,作为开源项目,您可以查看这些连接器的代码并进行自定义。若您的用例尚未覆盖,您也可以编写自己的来源连接器。
Airbyte 在搭建与维护管道(尤其是自定义连接器)方面需要技术专长。但它也提供付费方案,包含全托管服务与专属支持。
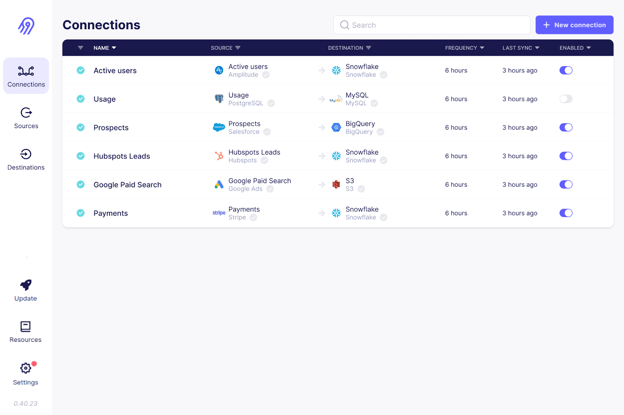
Airbyte 用户界面。图片来源:Airbyte GitHub
9. Informatica
Informatica 的智能数据管理云包含一系列简化数据摄取的工具。其中的 “Data Loader” 工具仅需数分钟即可从 30 多种云服务加载数据。
Informatica 还提供应用集成工具,可连接本地与云端的异构软件系统。其云数据集成平台针对带有 ETL/ELT 的高性能数据摄取而设计良好。
Informatica 能够处理批处理与实时数据,支持从关系型数据库、应用和文件系统中摄取任意类型的数据。此外,该平台提供如 CLAIRE Engine 等 AI 能力,可分析元数据信息并为您的数据摄取需求推荐相关数据集。
10. Apache Flume
Apache Flume 是一项分布式且可靠的服务,用于将日志数据加载至目标。其灵活的架构专为流式数据流设计,例如将多个 Web 服务器的数据以近实时方式发送至 HDFS 或 ElasticSearch。
Flume agent 是负责数据移动的核心组件,由 channel、sink 和 source 组成。source 组件从源数据中提取数据文件,sink 则确保源与目标之间的同步。在处理海量流数据时,可配置多个 Flume agent 并行摄取。
Apache Flume 以其容错性著称。借助多种故障切换与恢复机制,Flume 即使在发生故障时也能确保一致而可靠的数据摄取。
11. Stitch
Stitch 是一款简单且可扩展的云端 ETL 工具。尽管缺乏复杂的自定义转换能力,但非常适合数据摄取任务。
与其他企业级 ETL 工具类似,Stitch 提供 140 多个数据源连接器,通常将 SaaS 应用与数据库中的数据加载到数据仓库与数据湖。针对自定义数据摄取工作流,Stitch 可与 Singer 集成,支持构建自定义连接器。
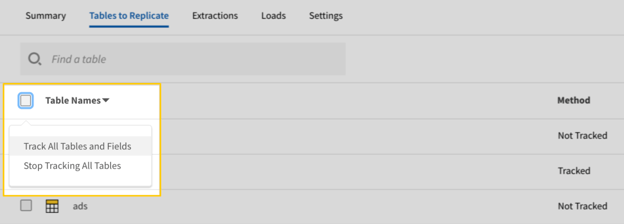
Stitch 数据抽取用户界面。图片来源:Stitch 文档
12. StreamSets
StreamSets(已被 IBM 收购)是一款用于流、批与 CDC 数据的开源数据集成引擎。其 “Data Collector” 功能提供可拖放的来源连接器,适配 AWS、Microsoft Azure、Google Cloud 等云平台以及本地系统。
您无需 IT 专业技能即可创建或编辑数据摄取管道——其 Data Collector 拖放式界面非常直观。
StreamSets 是平台无关的工具,允许用户构建适用于多种环境的数据采集管道,并将重新配置降至最少。除数据采集器外,该平台还提供基于 Apache Spark 的数据转换器,用于复杂数据转换。
13. Apache Beam
Apache Beam 是一体化方案,为批处理与流处理提供统一的编程模型。它可与 Google Cloud Dataflow、Apache Flink 和 Apache Spark 等云平台无缝协作。
针对实时数据摄取,您可以定义固定窗口、滑动窗口和会话窗口,以实现快速分组与处理数据。
Apache Beam 的突出之处在于其灵活性。它允许使用多种编程语言定义管道,并在多个执行引擎上运行。
14. Hevo Data
Hevo Data 是一款全托管、零代码的平台,可将来自 150 多种来源的数据移动到您选择的目标。该工具不仅负责数据摄取,还可对数据进行转换,使其具备分析就绪状态。
该平台会自动检测传入数据的模式并将其匹配到目标模式,提供极大灵活性。
Hevo Data 还提供稳健的容错架构,确保在数据摄取过程中零数据丢失。总体而言,Hevo Data 是流式与实时分析用例的理想选择。
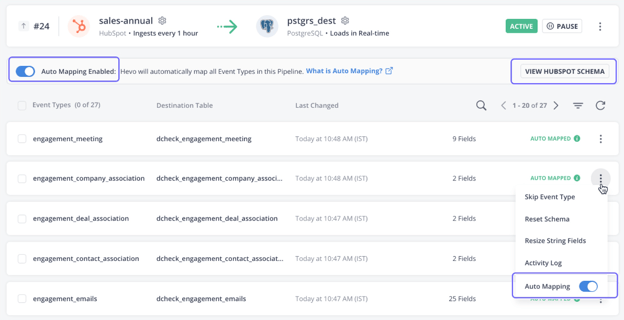
Hevo Data 用户界面。 图片来源:Hevo 文档
15. Segment
Segment 是客户数据平台,为分析提供干净且已转换的客户数据。该平台专注于采集多种类型的客户数据,如交互、曝光、点击与其他行为数据。
该工具的 Track API 可从移动端、网页与服务器等多个来源采集事件数据。只需几次点击,即可将数据集成至 450 多个应用。
通过 Segment 收集的数据,用户可使用 SQL 查询访问,程序员也可通过 curl 命令获取实时数据。
16. Matillion
Matillion 是云原生数据集成平台,旨在在云中移动并转换数据。它尤其适用于 Snowflake、Amazon Redshift、Google BigQuery 等强大的云数据仓库。
该平台为云端与本地数据源提供了广泛的预构建连接器,包括数据库、SaaS 应用、社交媒体平台等。
专注性能的同时,Matillion 还提供强大的转换能力,以清洗并准备数据供后续分析。
17. Keboola
Keboola,专为复杂转换而设计,提供自定义数据摄取能力。凭借 250 多个内置的源与目标集成,只需数次点击即可自动化数据摄取。
Keboola 支持批处理与实时数据流以导入企业数据。不过,在进行实时数据摄取时,您需要具备设置 webhook 的编码技能。
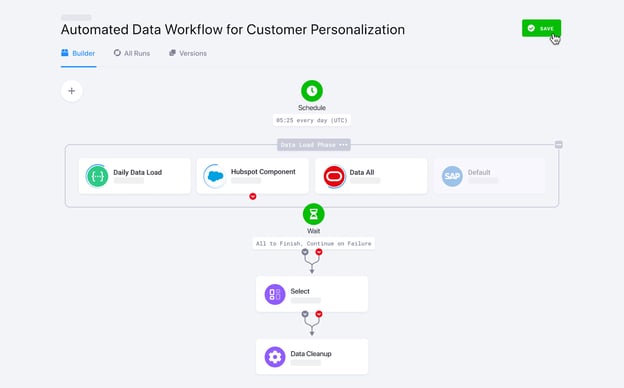
Keboola 数据工作流。 图片来源:Keboola
18. Snowplow
Snowplow 是新一代数据采集平台,可从多种来源捕获并处理事件数据。它专注于收集客户行为数据,并为高级 AI 与机器学习分析做好准备。
Snowplow 在内部使用 tracker 与 webhook 采集实时事件数据。
Tracker 是可集成至移动应用、网站与服务端应用的库或 SDK。它们收集用户交互、点击、点赞等事件信息并发送至 collector。collector 随后将数据进行富化处理,再发送到目标数据仓库。
19. IBM DataStage
IBM DataStage 是行业领先的数据集成平台,专为 ETL 与 ELT 操作而构建。其基础版本可在本地部署;若要通过云端体验规模与自动化能力,可升级至用于 IBM Cloud Pak® 的 DataStage。
其丰富的预构建连接器与阶段(stage)可在多个云端来源与数据仓库之间自动化数据移动。
对于在 IBM 生态中搭建数据架构的用户,DataStage 是进行数据摄取的首选工具。它还能与 IBM 的其他数据平台(如 Cloud Object Storage 和 Db2)集成,用于摄取与转换。
20. Alteryx
Alteryx 以其数据分析与可视化工具闻名。拥有超过 8000 名客户,它是一款广受欢迎的分析平台,可自动化数据与分析任务。
Alteryx 推出的 Designer Cloud 提供直观界面,用于为分析与 AI 场景构建数据摄取管道。它可连接多种数据源,包括数据仓库、云存储与文件系统。
想在无需编码的情况下简化数据准备与分析?学习如何使用Alteryx 入门课程,解锁拖放式 ETL 能力。
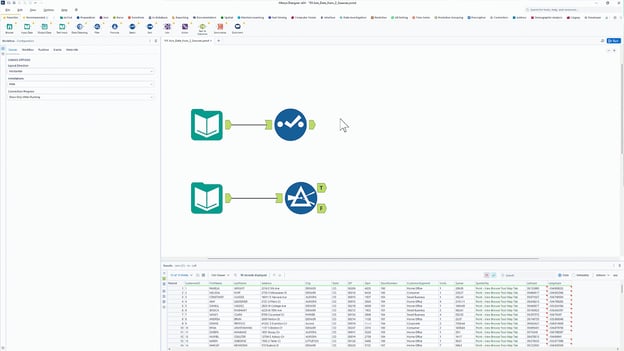
Alteryx 拖放式用户界面。 图片来源:Alteryx
数据摄取工具汇总表
|
工具 |
最适合 |
功能 |
定价 |
|
Apache Kafka |
实时数据流 |
|
开源 |
|
Apache Nifi |
安全的实时数据摄取 |
|
开源 |
|
AWS Glue |
AWS 生态 |
|
按需付费模式。按照每小时使用的数据处理量计费。 |
|
Google cloud dataflow |
Google Cloud 生态 |
|
按需付费模式。根据所用计算资源与内存计费。 |
|
Azure data factory |
使用微软 Azure 其他服务的企业 |
|
按需付费模式 |
|
Talend |
寻求直观 ETL 方案的低预算公司 |
|
开源 |
|
Fivetran |
全托管 ELT 需求 |
|
订阅制定价 |
|
Airbyte |
寻求开源自定义方案的组织 |
|
提供开源与付费服务。 |
|
Informatica |
寻求低代码且具备广泛源连接器的企业 |
|
30 天免费试用,按需付费模式 |
|
Apache Flume |
流式数据传输 |
|
开源 |
|
Stitch |
寻找用于数据摄取任务的简洁工具的组织 |
|
可选择分级或按使用量计费的定价模式 |
|
StreamSets |
复杂数据转换 |
|
提供开源与商业版本 |
|
Apache Beam |
可自定义、以代码为中心的数据摄取管道框架 |
|
Apache Beam 框架为开源,但与云服务配合使用时会产生费用。 |
|
Hevo Data |
需要实时分析的中型企业 |
|
订阅制定价 |
|
Segment |
客户事件数据 |
|
订阅制定价 |
|
Matillion |
云原生 ETL/ELT 工具 |
|
订阅制定价 |
|
Keboola |
复杂的数据转换管道 |
|
订阅制定价 |
|
Snowplow |
采集事件数据 |
|
提供开源与商业版本 |
|
IBM DataStage |
IBM 云生态 |
|
订阅制定价 |
|
Alteryx |
数据分析与可视化 |
|
订阅制定价 |
选择数据摄取工具的标准
行业内工具众多,要为您的目标选择合适的数据集成平台并不容易。以下列出在选定某款数据集成工具之前应考虑的一些因素。
可扩展性
将 Excel 表或 CSV 文件摄取到目标并不难。然而,手动将来自多个来源的实时流数据摄取到多个目标却颇具挑战。例如,现代应用(如社交媒体)常在某些时段出现访问高峰,而在其他时段较低。这正是数据摄取工具可扩展性大显身手之处。
可扩展性指的是根据需求进行扩张或收缩的能力。它使工具能够快速适应不断增长的数据量需求,而不牺牲性能。
灵活性
灵活性是指处理来自不同来源与不同格式数据的能力。支持多种数据源并提供自定义连接器的数据摄取工具,能够保证摄取系统的灵活性。
例如,自动模式映射功能会检测传入数据的模式并将其映射到目标,而不受限于预定义的模式结构。这样工具即可摄取任意模式的数据。
实时处理 vs 批处理
批量数据摄取会按计划收集数据并在目标端更新。相对地,实时数据摄取意味着以零延迟持续传输数据。
如今许多数据摄取工具同时支持批处理与实时数据摄取。但如果您经常处理实时数据(如客户事件或视频流),请选择具备高吞吐与低延迟能力的工具。
成本与许可
不同的数据摄取工具拥有不同的定价结构。有些提供分级定价,另一些采用按需付费模式。与开源工具相比,这些方案通常更具成本效益,因为免费工具往往需要您聘请专家来实现数据摄取。但开源工具在您的用例中提供了高灵活性与可定制性。
部分付费的数据摄取工具还提供企业级特性与广泛的自定义能力,但相应也会产生成本。因此,您应基于预算与定制需求,在付费与开源平台之间做出选择。
结论
选择合适的数据摄取工具取决于您的具体需求——您更看重实时流处理、批处理、云端兼容性,还是集成的便捷性。上述工具提供了多种选择,帮助您高效地将数据采集并加载到目标系统。
如果您刚接触数据工程并希望深入了解数据如何在现代管道中流动,请查看 数据工程入门课程。若您希望用 Python 进一步学习 ETL 与 ELT 流程, Python 中的 ETL 与 ELT是获取数据摄取技术实操经验的优质资源。
FAQs
什么是数据摄取工具?
数据摄取工具有助于自动化从各类来源(如数据库、API 与流平台)收集数据,并将其加载到存储系统、数据仓库或数据湖的过程。这些工具支持批处理与实时摄取,以简化数据工作流。
如何选择合适的数据摄取工具?
请考虑数据量、来源兼容性、实时与批处理需求、可扩展性、集成便捷性与定价等因素。若您处理的是实时数据,Apache Kafka 之类的工具或更理想;而偏向批处理的用户可能更青睐 Apache NiFi 或 Fivetran。
批处理与实时摄取有何区别?
批处理摄取会在计划的时间间隔(例如每小时或每日)处理数据,适用于不需要即时更新的大型数据集。实时摄取则在数据到达时持续流式传输,适合如欺诈检测与监控等需要更快决策的应用。
开源数据摄取工具是好选择吗?
当然可以!Apache Kafka、Apache NiFi 与 Airbyte 等开源工具具有灵活、成本更优与社区支持强等优势。但与 Fivetran 或 AWS Glue 等托管或企业级方案相比,它们可能需要更多的部署与维护工作。
ETL 与 ELT 在数据摄取中的作用是什么?
ETL(抽取、转换、加载)与 ELT(抽取、加载、转换)是摄取中使用的数据管道方法。ETL 在将数据加载到目标之前先进行转换;而 ELT 则先加载原始数据再进行转换,充分利用如 Snowflake 和 BigQuery 等现代云数据仓库的算力。

Srujana 是一名自由职业技术写作者,拥有计算机科学四年制学位。她擅长撰写各类主题的内容,包括数据科学、云计算、开发、编程、安全等众多领域。她热爱经典文学,也喜欢探索新的旅行目的地。
数据摄取是指从各种来源收集数据并将其加载到目标位置。市面上有许多数据摄取工具,可以为您自动化并简化这一过程。
经过细致的研究与测试,我整理出 20 款顶级数据摄取工具清单。无论您需要实时处理、批量摄取,还是对多样化数据源的支持,这些工具各具特色。
让我们深入了解这些工具,探究它们的能力与理想适用场景!
1. Apache Kafka
Apache Kafka 是一款以高吞吐、低延迟著称的开源分布式引擎。它包含 Kafka Connect,这是一个用于将 Kafka 与外部数据库、文件系统和键值存储集成的框架。
Apache Kafka 采用生产者-消费者架构。数据生产者将数据发送到 Kafka 主题(topic),主题如同中间层,通过分区对接收的数据进行逻辑组织。最终,消费者从这些 Kafka 主题中获取所需数据。
为何选择 Apache Kafka 进行数据摄取?
若您对实时数据摄取感兴趣,可查看 Introduction to Apache Kafka,学习如何高效处理流数据。
2. Apache NiFi
Apache NiFi 专为在系统之间自动化数据流而构建。不同于 Kafka,它提供直观的界面用于设计、部署和监控数据流。
该工具通过处理器(processor)进行数据摄取。NiFi 中的处理器负责提取、发布、转换或路由数据等多种功能。例如,预构建处理器
InvokeHTTP可从 REST API 拉取数据,GetKafka则从 Kafka 主题中获取消息。一旦处理器开始摄取数据,系统会为每个数据单元创建 FlowFile。FlowFile 包含实际数据及其元数据,并依据定义好的规则被路由至相应目标。
Apache NiFi 用户界面。图像来源:Apache NiFi 用户指南。
3. AWS Glue
AWS Glue 是 Amazon 推出的无服务器数据集成服务。它可发现、转换并将数据加载到目标,以用于分析或机器学习场景。该平台同时提供友好的可视化界面和诸如 Jupyter notebooks 等开发环境。
在 AWS Glue 中,Crawler 与 ETL 作业是两大核心组件。Crawler 会扫描数据源以检测模式(schema),并将元数据添加到目录。ETL 作业随后可利用目录信息轻松发现数据源及其结构。
AWS Glue 提供多种方式来创建与执行管道。例如,您可以使用 Python 或 Scala 编写 ETL 作业来转换和加载数据。对于不熟悉编码的用户,Glue Studio 提供直观界面,助您无需编写代码即可创建工作流。
如果您正在探索无服务器 ETL 方案,可查看 this AWS Glue tutorial,获取构建可扩展数据管道的实践指南。