
Khóa học
Các khái niệm về Kho dữ liệu (Data Warehouse)
4 giờ
53.2K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleData ingestion là việc thu thập dữ liệu từ nhiều nguồn khác nhau và nạp chúng vào điểm đích. Trên thị trường có nhiều công cụ data ingestion có thể tự động hóa và đơn giản hóa quy trình này cho bạn.
Sau khi nghiên cứu và thử nghiệm kỹ lưỡng, tôi đã tổng hợp danh sách 20 công cụ data ingestion hàng đầu. Mỗi công cụ đều có điểm mạnh riêng, dù bạn cần xử lý theo thời gian thực, ingest theo lô, hay hỗ trợ đa dạng nguồn dữ liệu.
Hãy cùng đi sâu vào từng công cụ để khám phá khả năng và tình huống sử dụng lý tưởng của chúng!
Apache Kafka là một engine phân tán mã nguồn mở nổi tiếng với thông lượng cao và độ trễ thấp. Nó bao gồm Kafka Connect, một khung tích hợp Kafka với các cơ sở dữ liệu bên ngoài, hệ thống tệp và kho khóa-giá trị.
Apache Kafka tuân theo kiến trúc producer-consumer. Các producer gửi dữ liệu vào các topic của Kafka, đóng vai trò như trung gian, tổ chức hợp lý dữ liệu nhận được trong các partition của chúng. Cuối cùng, consumer truy cập dữ liệu cần thiết từ các topic Kafka này.
Vì sao chọn Apache Kafka cho data ingestion?
Độc giả quan tâm đến data ingestion thời gian thực có thể xem Introduction to Apache Kafka để học cách xử lý dữ liệu streaming hiệu quả.
Apache NiFi được xây dựng để tự động hóa luồng dữ liệu giữa các hệ thống. Khác với Kafka, nó cung cấp giao diện trực quan để thiết kế, triển khai và giám sát luồng dữ liệu.
Công cụ sử dụng processor để ingest dữ liệu. Processor trong NiFi đảm nhận nhiều chức năng như trích xuất, xuất bản, biến đổi hoặc định tuyến dữ liệu. Ví dụ, các processor dựng sẵn như InvokeHTTP lấy dữ liệu từ REST API, và GetKafka truy xuất thông điệp từ các topic Kafka.
Khi các processor bắt đầu ingest dữ liệu, FlowFile sẽ được tạo cho mỗi đơn vị dữ liệu. Các FlowFile này chứa siêu dữ liệu cùng dữ liệu thực và được định tuyến tới điểm đến tương ứng dựa trên các quy tắc đã định.
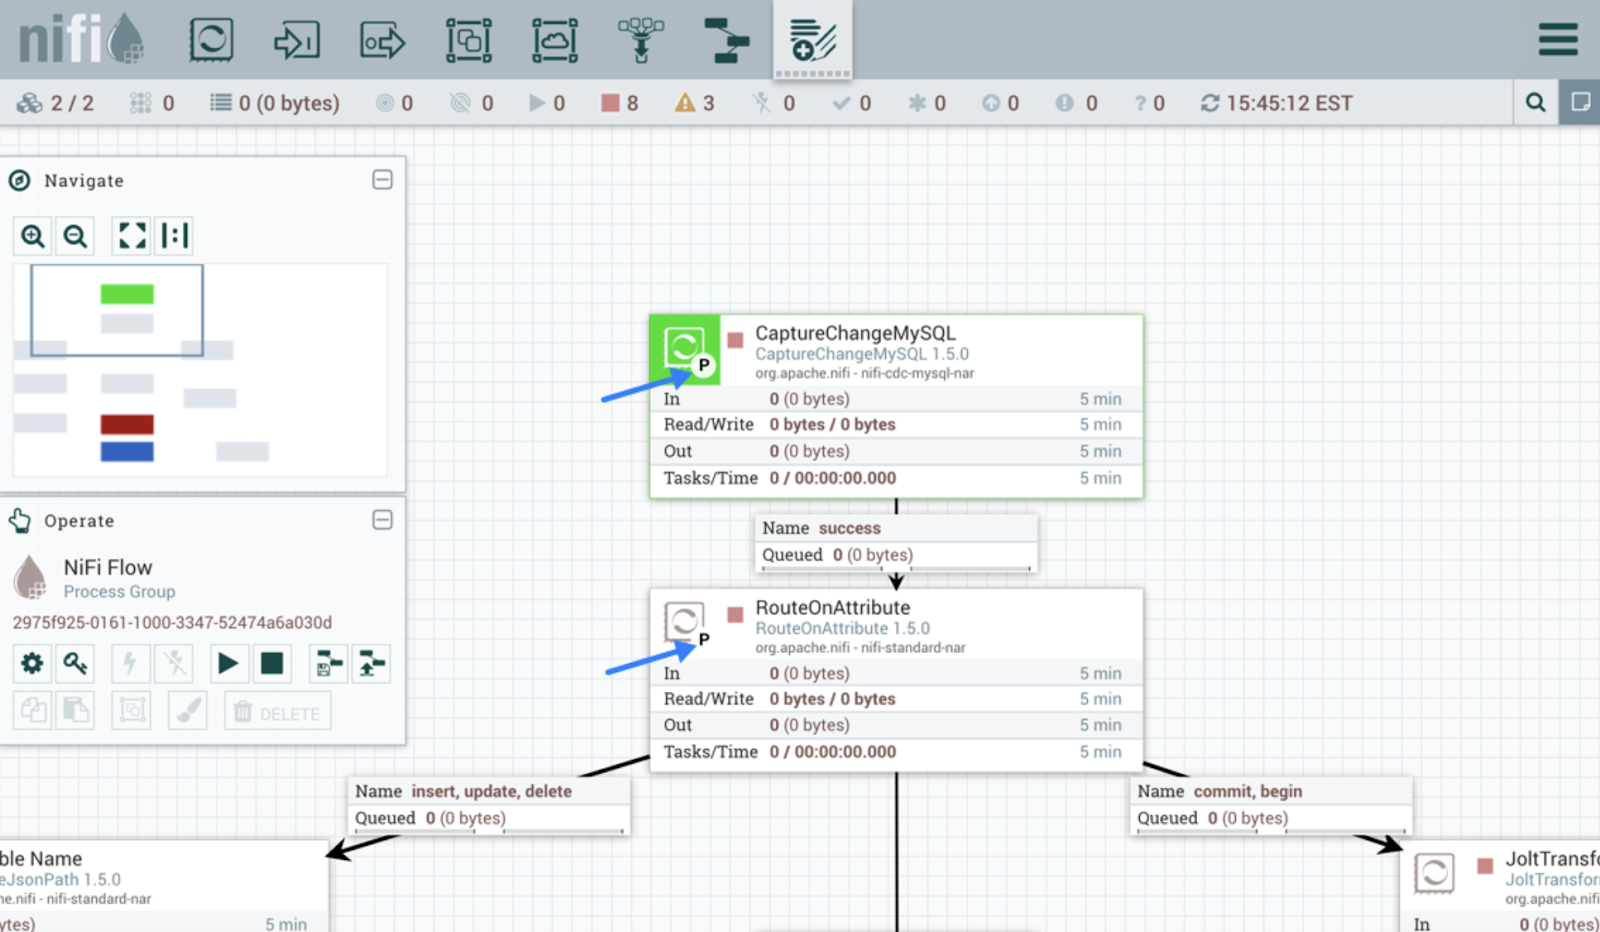
Giao diện người dùng Apache NiFi. Nguồn ảnh: Hướng dẫn sử dụng Apache NiFi.
AWS Glue là dịch vụ tích hợp dữ liệu serverless của Amazon. Nó khám phá, biến đổi và nạp dữ liệu tới điểm đích cho phân tích hoặc các bài toán ML. Nền tảng cung cấp cả giao diện GUI thân thiện và môi trường phát triển như Jupyter notebooks.
Crawler và ETL job là hai thành phần chính trong AWS Glue. Crawler quét các nguồn dữ liệu để phát hiện schema và thêm siêu dữ liệu vào catalog. ETL job sau đó có thể dễ dàng khám phá nguồn dữ liệu và cấu trúc của nó bằng thông tin từ catalog.
AWS Glue cung cấp nhiều cách để tạo và chạy pipeline. Ví dụ, ETL job có thể viết bằng Python hoặc Scala để biến đổi và nạp dữ liệu. Với người không lập trình, Glue Studio cung cấp giao diện trực quan để tạo workflow mà không cần viết mã.
Nếu bạn đang khám phá các giải pháp ETL serverless, hãy xem hướng dẫn AWS Glue này để thực hành xây dựng các pipeline dữ liệu có khả năng mở rộng.
Dataflow là dịch vụ được quản lý hoàn toàn của Google Cloud dành cho xử lý stream và batch. Nó có thể xử lý các pipeline dữ liệu đơn giản, như di chuyển dữ liệu giữa các hệ thống theo lịch, cũng như các pipeline thời gian thực nâng cao.
Hơn nữa, công cụ có khả năng mở rộng cao và hỗ trợ chuyển đổi liền mạch từ xử lý theo lô sang xử lý stream khi cần.
Google Dataflow được xây dựng trên Apache Beam. Vì vậy bạn có thể viết pipeline ingest bằng các SDK của Beam. Ngoài ra, công cụ cung cấp các mẫu workflow dựng sẵn để tạo pipeline tức thì. Nhà phát triển cũng có thể tạo template tùy chỉnh và cung cấp cho người dùng không chuyên kỹ thuật triển khai theo nhu cầu.
Azure Data Factory (ADF) là dịch vụ đám mây của Microsoft để ingest dữ liệu từ nhiều nguồn. Nó được thiết kế để tạo, lập lịch và điều phối workflow nhằm tự động hóa quy trình.
Bản thân ADF không lưu trữ bất kỳ dữ liệu nào. Nó hỗ trợ di chuyển dữ liệu giữa các hệ thống và xử lý thông qua tài nguyên tính toán trên máy chủ từ xa.
Nền tảng có hơn 90 connector tích hợp sẵn để kết nối nhiều nguồn dữ liệu, bao gồm kho dữ liệu on-premise, REST API và máy chủ đám mây. Sau đó, thành phần ‘copy activity’ sẽ sao chép dữ liệu từ nguồn tới đích.
Nếu bạn đã sử dụng các dịch vụ Microsoft cho các tác vụ dữ liệu khác, Azure Data Factory là giải pháp tổng thể cho nhu cầu data ingestion của bạn. Hướng dẫn Azure Data Factory của chúng tôi sẽ hướng dẫn bạn thiết lập workflow ingest dữ liệu trên Azure.
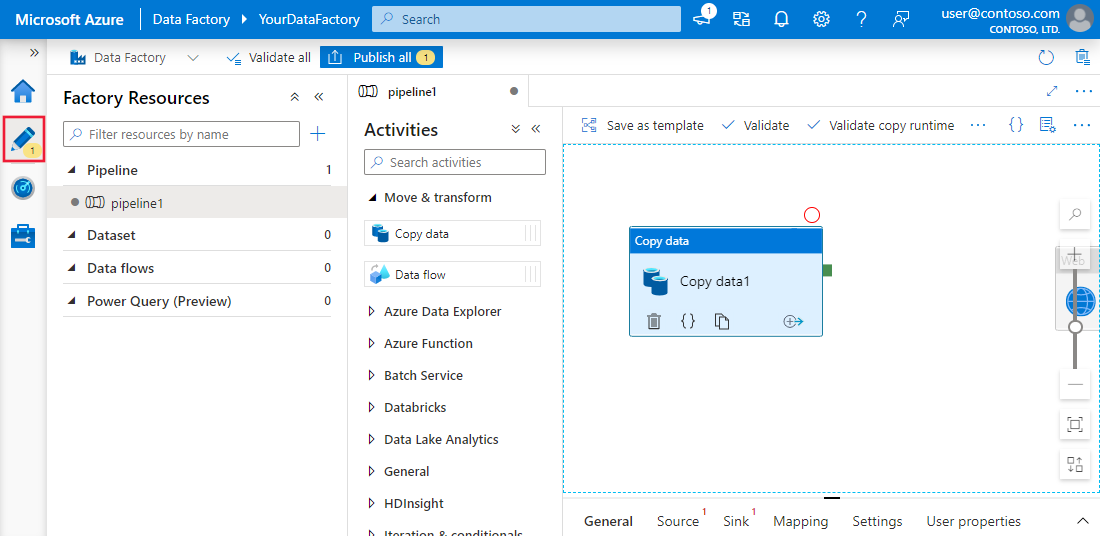
Trải nghiệm giao diện người dùng Azure Data Factory và Synapse Analytics. Nguồn ảnh: Microsoft Learn
Talend là nền tảng tích hợp dữ liệu end-to-end mã nguồn mở. Nó giúp xây dựng workflow data ingestion đơn giản với các thành phần kéo-thả để kết nối các nguồn và đích khác nhau.
Talend nổi tiếng với khả năng di chuyển dữ liệu giữa các hệ thống đồng thời duy trì chất lượng. Bộ công cụ chất lượng dữ liệu mạnh mẽ đảm bảo độ chính xác trong quá trình ingest. Ngoài ra, khả năng giám sát tích hợp sẵn giúp tuân thủ các quy tắc bảo mật và quản trị dữ liệu.
Fivetran là nền tảng tích hợp dữ liệu phổ biến tự động hóa các tác vụ ELT. Nó cung cấp dữ liệu liên tục bằng cách tự động thích ứng với thay đổi định dạng dữ liệu. Tính năng này cũng giúp duy trì độ chính xác thông qua ánh xạ schema trong quá trình ingest.
Ưu điểm lớn của các công cụ như Fivetran là hầu như không cần bảo trì. Quản lý schema và giám sát tự động cho phép pipeline tự vận hành.
Ngoài ra, công cụ bao gồm khả năng CDC (change data capture), đảm bảo điểm đích luôn được cập nhật theo thời gian thực.
Với những ai chưa quen, CDC là quá trình xác định các cập nhật gần đây được thực hiện trên một cơ sở dữ liệu và phản ánh chúng lên điểm đích theo thời gian thực.
Airbyte là một công cụ data ingestion mã nguồn mở khác trong danh sách. Đây là nền tảng tích hợp dữ liệu phổ biến nhất, được hơn 3000 công ty sử dụng.
Với hơn 300 connector dựng sẵn, Airbyte cung cấp hỗ trợ phong phú nhất cho nhiều kết nối nguồn và đích. Hơn nữa, vì là mã nguồn mở, bạn có thể xem mã của các connector này và tùy biến. Nếu bài toán của bạn chưa được hỗ trợ, bạn có thể viết connector nguồn riêng.
Airbyte đòi hỏi chuyên môn kỹ thuật để thiết lập và duy trì pipeline, đặc biệt với các connector tùy chỉnh. Tuy nhiên, họ có các gói trả phí với dịch vụ quản lý hoàn toàn và hỗ trợ chuyên biệt.
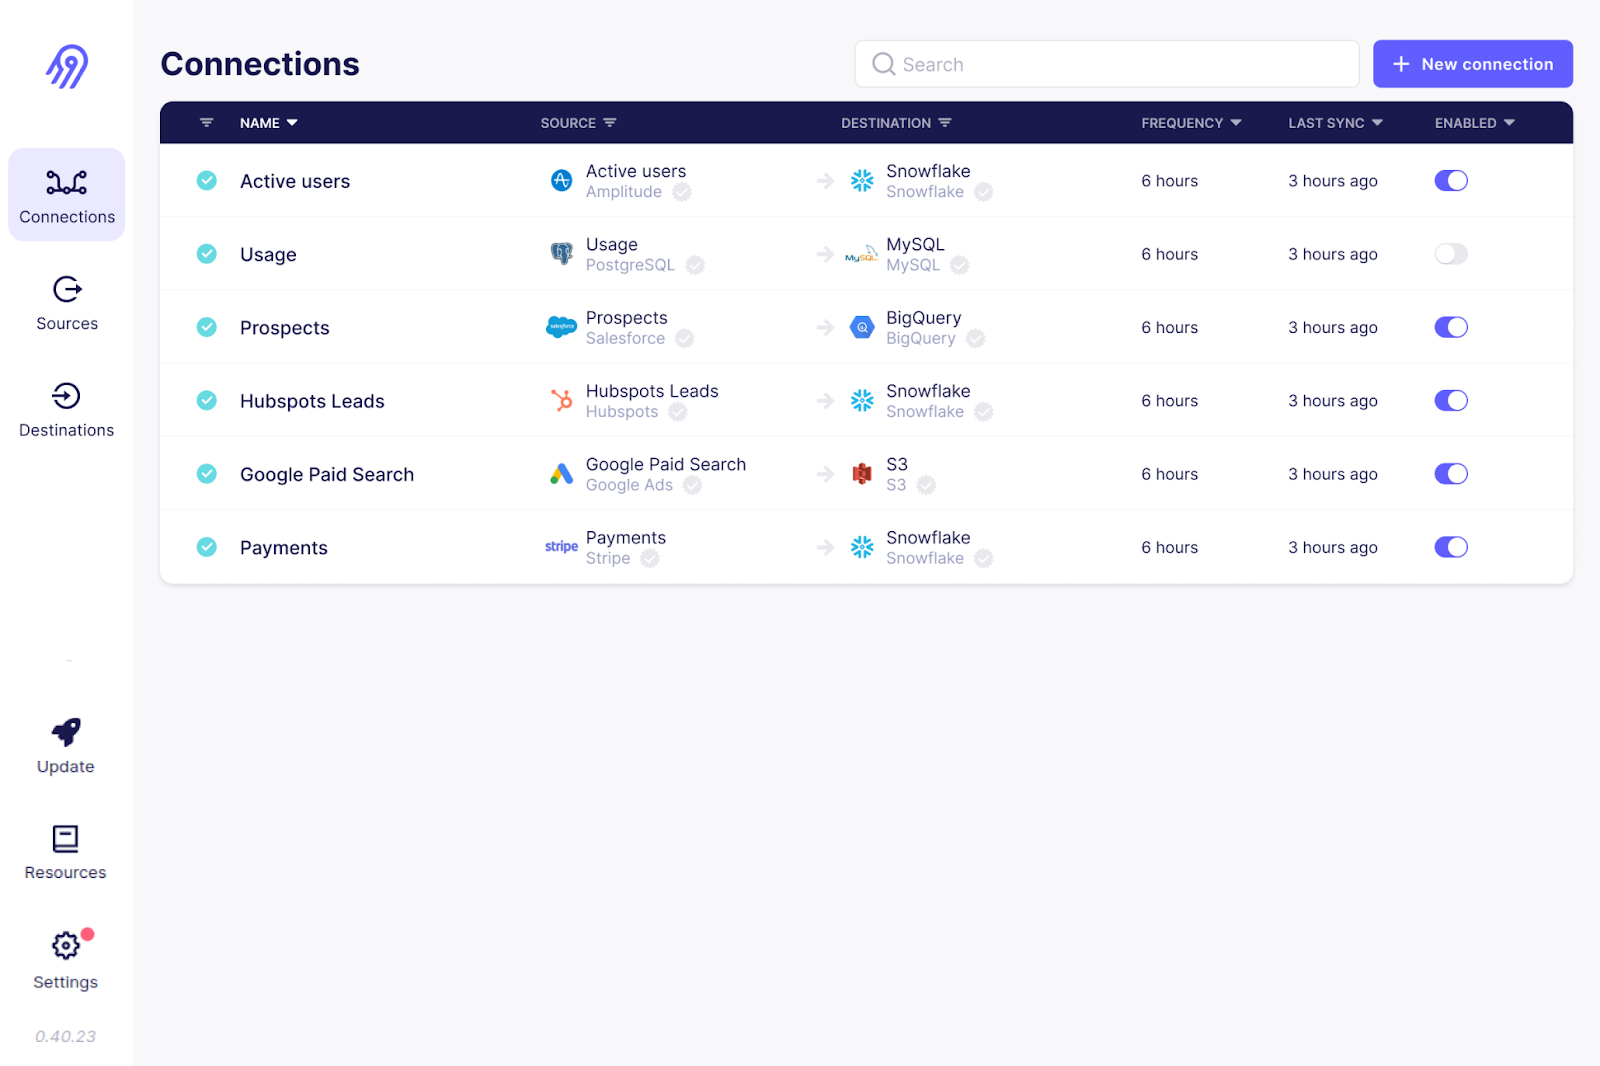
Giao diện người dùng Airbyte. Nguồn: Airbyte GitHub
Informatica’s intelligent data management cloud bao gồm một bộ công cụ để đơn giản hóa data ingestion. Công cụ ‘Data Loader’ của nó chỉ mất vài phút để nạp dữ liệu từ hơn 30 dịch vụ đám mây.
Informatica cũng có công cụ tích hợp ứng dụng kết nối các hệ thống phần mềm rời rạc, cả on-premises lẫn trên đám mây. Nền tảng tích hợp dữ liệu đám mây của nó được thiết kế tốt cho ingest dữ liệu hiệu năng cao với ETL/ELT.
Được thiết kế để xử lý dữ liệu theo lô và thời gian thực, Informatica cho phép ingest mọi loại dữ liệu từ cơ sở dữ liệu quan hệ, ứng dụng và hệ thống tệp. Ngoài ra, nền tảng cung cấp các khả năng AI như CLAIRE Engine, phân tích thông tin siêu dữ liệu và gợi ý các bộ dữ liệu phù hợp cho nhu cầu ingest của bạn.
Apache Flume là dịch vụ phân tán và đáng tin cậy để tải dữ liệu log tới điểm đích. Kiến trúc linh hoạt của nó được thiết kế đặc biệt cho các luồng dữ liệu streaming, chẳng hạn từ nhiều web server tới HDFS hoặc ElasticSearch gần như thời gian thực.
Flume agent là thành phần chính chịu trách nhiệm di chuyển dữ liệu. Nó bao gồm channel, sink và source. Thành phần source lấy các tệp dữ liệu từ nguồn, còn sink đảm bảo đồng bộ giữa đích và nguồn. Có thể cấu hình nhiều Flume agent để ingest song song khi streaming khối lượng dữ liệu lớn.
Apache Flume nổi tiếng với khả năng chịu lỗi. Với nhiều cơ chế dự phòng và khôi phục, Flume đảm bảo ingest dữ liệu nhất quán và đáng tin cậy ngay cả khi gặp sự cố.
Stitch là công cụ ETL đám mây đơn giản và dễ mở rộng. Dù thiếu các khả năng biến đổi tùy chỉnh phức tạp, nó hoàn hảo cho các tác vụ data ingestion.
Giống các công cụ ETL doanh nghiệp khác, Stitch cung cấp nhiều connector tới hơn 140 nguồn dữ liệu, thường từ ứng dụng SaaS và cơ sở dữ liệu vào data warehouse và data lake. Với workflow ingest dữ liệu tùy chỉnh, Stitch tích hợp với Singer, cho phép bạn xây dựng connector riêng.
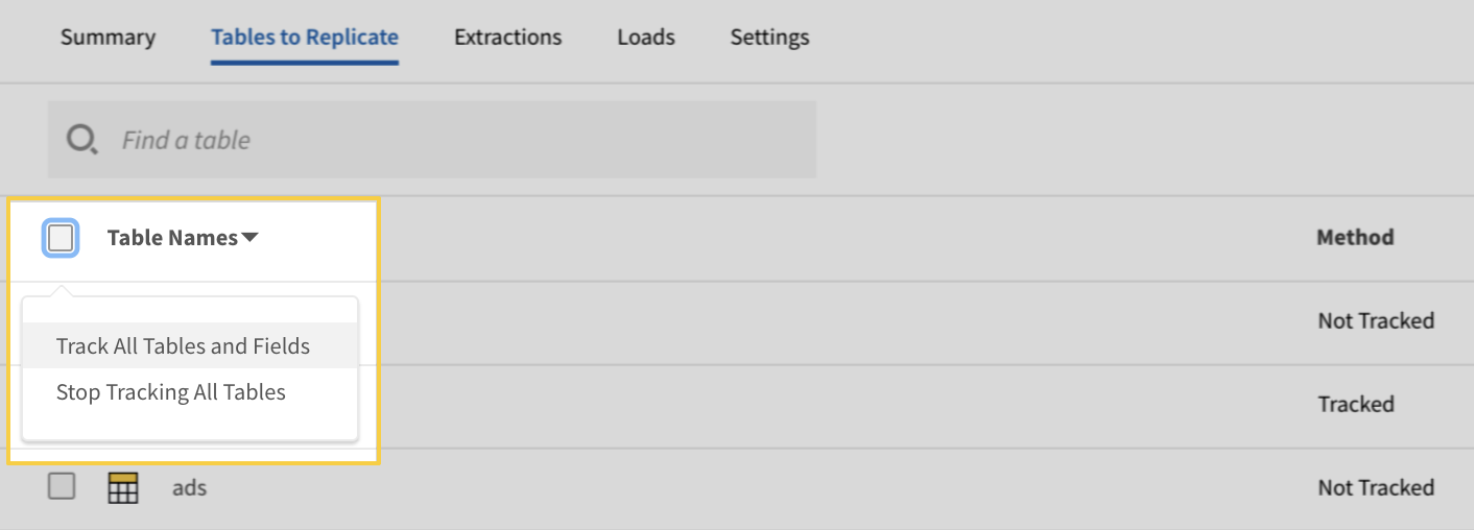
Giao diện trích xuất dữ liệu Stitch. Nguồn ảnh: Tài liệu Stitch
StreamSets, được IBM mua lại, là engine tích hợp dữ liệu mã nguồn mở cho dữ liệu stream, batch và CDC. Tính năng ‘Data Collector’ của nó cung cấp các connector nguồn dạng kéo-thả cho các nền tảng đám mây như AWS, Microsoft Azure và Google Cloud, cũng như hệ thống on-premises.
Bạn không cần chuyên môn IT để tạo hoặc chỉnh sửa pipeline ingest dữ liệu — giao diện kéo-thả của data collector rất trực quan.
StreamSets là công cụ độc lập nền tảng, cho phép người dùng xây dựng các pipeline data collector phù hợp với nhiều môi trường với ít cấu hình lại. Bên cạnh data collector, nền tảng còn có data transformer chạy trên Apache Spark cho các biến đổi dữ liệu phức tạp.
Apache Beam là giải pháp hợp nhất cung cấp một mô hình lập trình duy nhất cho các trường hợp batch và streaming. Nó hoạt động mượt mà với các nền tảng đám mây như Google Cloud Dataflow, Apache Flink và Apache Spark.
Với ingest dữ liệu thời gian thực, bạn có thể định nghĩa các cửa sổ thời gian cố định, trượt và phiên để nhóm và xử lý dữ liệu nhanh chóng.
Apache Beam nổi bật về tính linh hoạt. Nó cho phép định nghĩa pipeline bằng nhiều ngôn ngữ lập trình và chạy trên nhiều engine thực thi.
Hevo Data là nền tảng no-code được quản lý hoàn toàn để di chuyển dữ liệu từ hơn 150 nguồn đến điểm đích bạn chọn. Công cụ này không chỉ xử lý ingest dữ liệu mà còn biến đổi dữ liệu để sẵn sàng cho phân tích.
Nền tảng tự động phát hiện schema của dữ liệu đến và ánh xạ với schema đích, mang lại sự linh hoạt.
Hevo Data cũng cung cấp kiến trúc chịu lỗi mạnh mẽ, đảm bảo không mất dữ liệu trong quá trình ingest. Nhìn chung, Hevo Data là lựa chọn hàng đầu cho các bài toán streaming và phân tích thời gian thực.
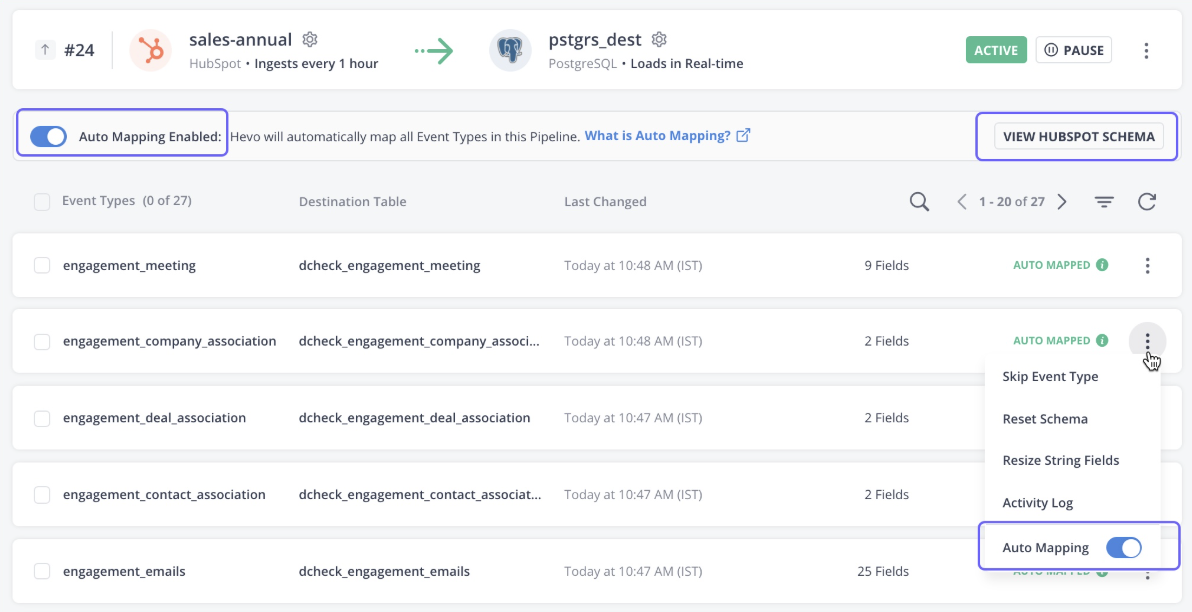
Giao diện người dùng Hevo Data. Nguồn ảnh: Tài liệu Hevo
Segment là nền tảng dữ liệu khách hàng, cung cấp dữ liệu khách hàng sạch và đã biến đổi cho phân tích. Nền tảng chuyên thu thập nhiều loại dữ liệu khách hàng như tương tác, hiển thị, nhấp chuột và các dữ liệu hành vi khác.
Track API của công cụ thu thập dữ liệu sự kiện từ nhiều nguồn, bao gồm di động, web và máy chủ. Chỉ với vài cú nhấp, dữ liệu có thể được tích hợp với hơn 450 ứng dụng.
Dữ liệu thu thập qua Segment có sẵn cho người dùng qua truy vấn SQL, trong khi lập trình viên có thể truy cập dữ liệu thời gian thực bằng lệnh curl.
Matillion là nền tảng tích hợp dữ liệu gốc đám mây, được thiết kế để di chuyển và biến đổi dữ liệu trong đám mây. Nó được tối ưu cho các kho dữ liệu đám mây mạnh mẽ như Snowflake, Amazon Redshift và Google BigQuery.
Nền tảng cung cấp nhiều connector dựng sẵn cho cả nguồn dữ liệu trên đám mây và on-premises, bao gồm cơ sở dữ liệu, ứng dụng SaaS, nền tảng mạng xã hội và hơn thế nữa.
Với trọng tâm về hiệu năng, Matillion cũng cung cấp khả năng biến đổi mạnh để làm sạch và chuẩn bị dữ liệu cho phân tích tiếp theo.
Keboola, được thiết kế đặc biệt cho các biến đổi phức tạp, cung cấp các tính năng ingest dữ liệu tùy chỉnh. Với hơn 250 tích hợp dựng sẵn giữa nguồn và đích, nó tự động hóa ingest dữ liệu chỉ với vài cú nhấp.
Keboola hỗ trợ cả ingest theo lô và streaming thời gian thực để nhập dữ liệu doanh nghiệp. Tuy nhiên, với ingest thời gian thực, bạn cần kỹ năng lập trình để thiết lập webhook.
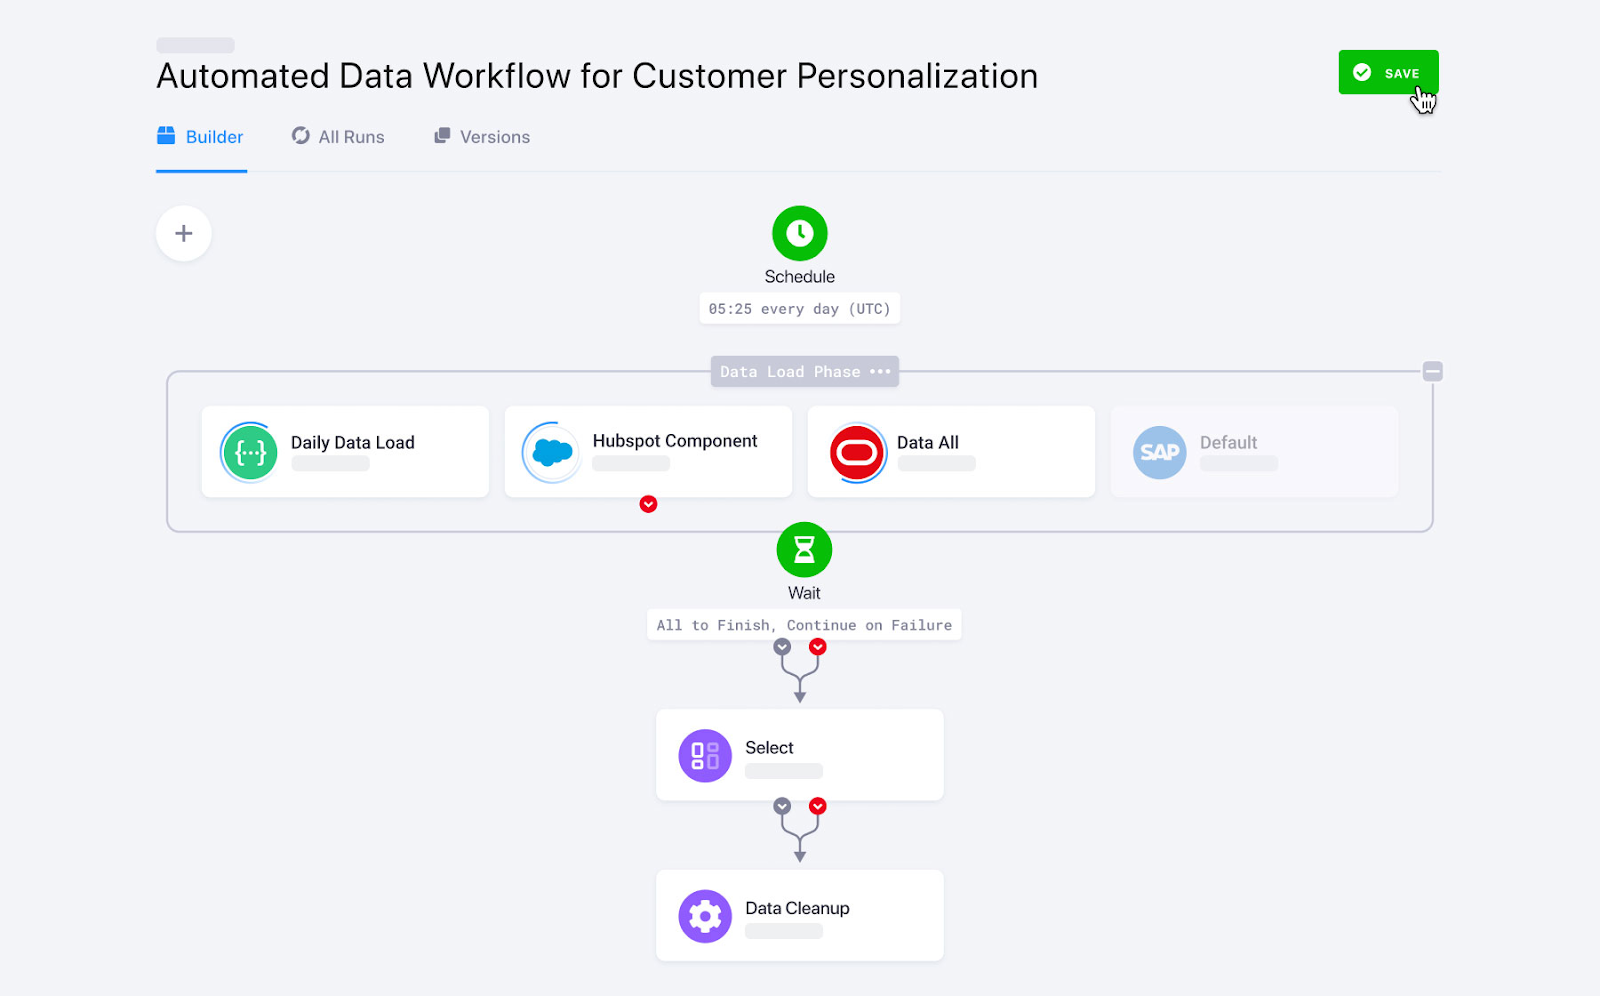
Workflow dữ liệu của Keboola. Nguồn ảnh: Keboola
Snowplow là nền tảng thu thập dữ liệu thế hệ mới, thu thập và xử lý dữ liệu sự kiện từ nhiều nguồn. Nó chuyên thu thập dữ liệu hành vi khách hàng và chuẩn bị cho phân tích AI và machine learning nâng cao.
Snowplow sử dụng tracker và webhook nội bộ để thu thập dữ liệu sự kiện thời gian thực.
Tracker là các thư viện hoặc SDK có thể tích hợp vào ứng dụng di động, website và ứng dụng phía server. Chúng thu thập thông tin sự kiện như tương tác người dùng, nhấp chuột, lượt thích và gửi đến collector. Các collector sau đó đưa dữ liệu qua quá trình làm giàu trước khi gửi đến kho dữ liệu đích.
IBM DataStage là nền tảng tích hợp dữ liệu hàng đầu trong ngành, được xây dựng cho các thao tác ETL và ELT. Phiên bản cơ bản có sẵn on-premises, nhưng để trải nghiệm khả năng mở rộng và tự động hóa trên đám mây, hãy nâng cấp lên DataStage for IBM Cloud Pak®.
Bộ connector và stage dựng sẵn phong phú của nó tự động hóa việc di chuyển dữ liệu giữa nhiều nguồn đám mây và data warehouse.
Với những ai xây dựng kiến trúc dữ liệu trong hệ sinh thái IBM, DataStage là công cụ lý tưởng cho data ingestion. Nó tích hợp với các nền tảng dữ liệu khác của IBM như Cloud Object Storage và Db2 để ingest và biến đổi.
Alteryx được biết đến với các công cụ phân tích dữ liệu và trực quan hóa. Với hơn 8000 khách hàng, đây là nền tảng phân tích phổ biến tự động hóa các tác vụ dữ liệu và phân tích.
Alteryx có công cụ tên Designer Cloud cung cấp giao diện trực quan để xây dựng pipeline ingest dữ liệu cho các bài toán phân tích và AI. Nó cung cấp kết nối tới nhiều nguồn dữ liệu, bao gồm data warehouse, lưu trữ đám mây và hệ thống tệp.
Muốn đơn giản hóa việc chuẩn bị dữ liệu và phân tích mà không cần viết mã? Tìm hiểu cách tự động hóa workflow với Introduction to Alteryx và mở khóa khả năng ETL kéo-thả.
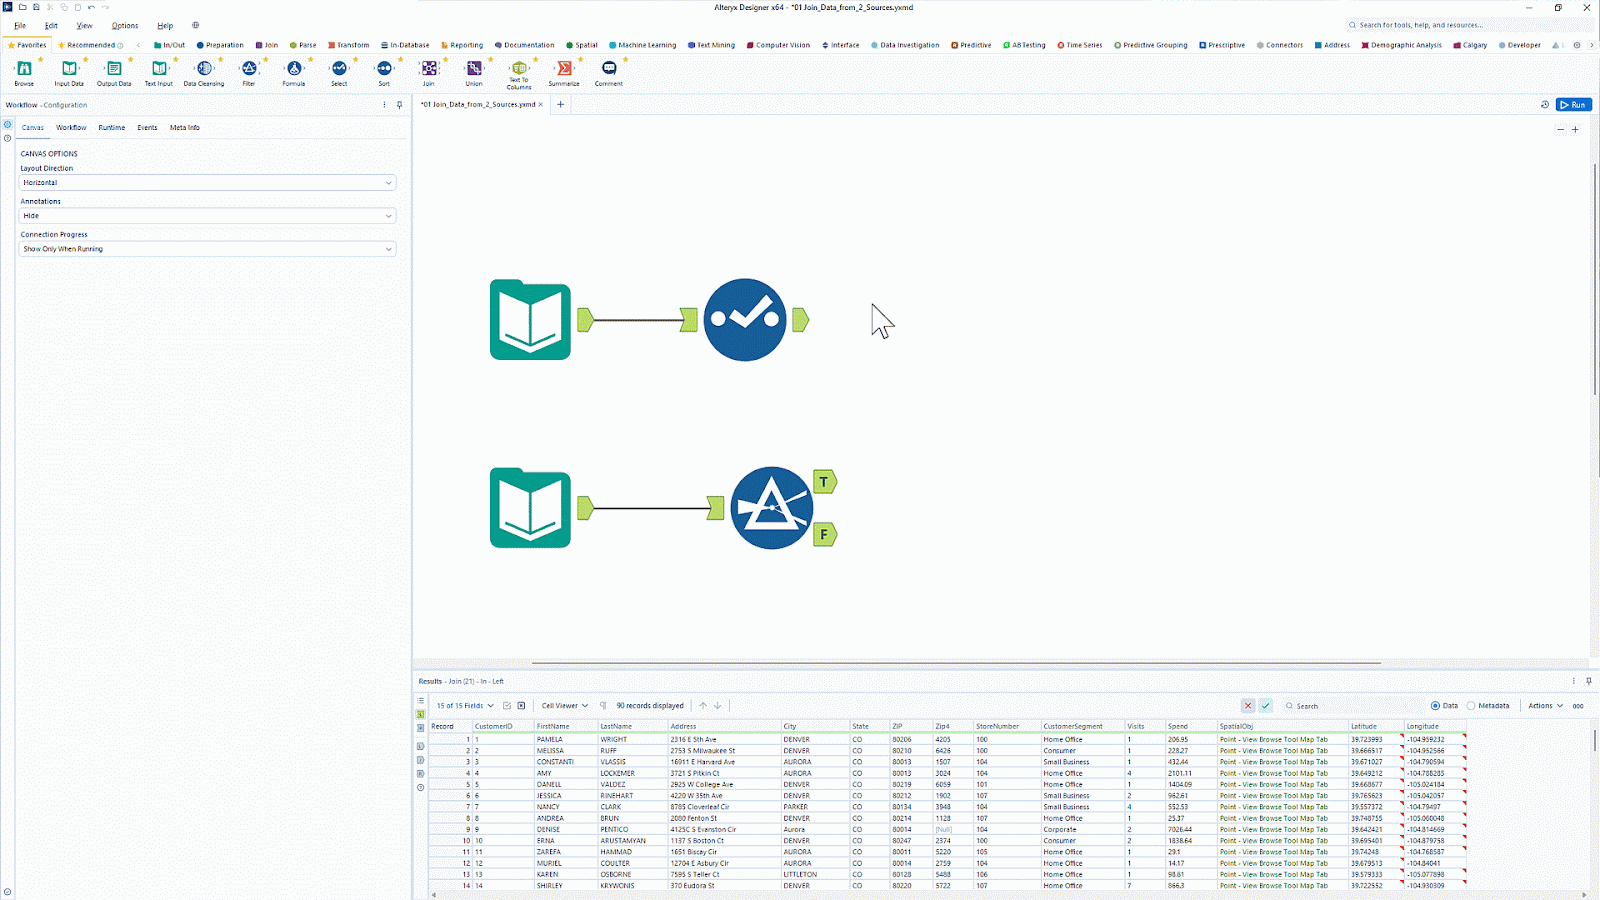
Giao diện kéo-thả của Alteryx. Nguồn ảnh: Alteryx
|
Công cụ |
Phù hợp nhất cho |
Tính năng |
Giá |
|
Apache Kafka |
Streaming dữ liệu thời gian thực |
|
Mã nguồn mở |
|
Apache Nifi |
Ingest dữ liệu thời gian thực có bảo mật |
|
Mã nguồn mở |
|
AWS Glue |
Hệ sinh thái AWS |
|
Mô hình tính phí theo mức sử dụng. Chi phí dựa trên số lượng xử lý dữ liệu theo giờ. |
|
Google cloud dataflow |
Hệ sinh thái Google Cloud |
|
Mô hình tính phí theo mức sử dụng. Chi phí dựa trên tài nguyên tính toán và bộ nhớ sử dụng. |
|
Azure data factory |
Doanh nghiệp sử dụng các dịch vụ Azure khác của Microsoft |
|
Mô hình tính phí theo mức sử dụng |
|
Talend |
Công ty ngân sách thấp tìm giải pháp ETL trực quan |
|
Mã nguồn mở |
|
Fivetran |
Nhu cầu ELT được quản lý hoàn toàn |
|
Giá theo gói đăng ký |
|
Airbyte |
Tổ chức tìm giải pháp mã nguồn mở có thể tùy biến |
|
Có cả mã nguồn mở và dịch vụ trả phí. |
|
Informatica |
Doanh nghiệp cần công cụ low-code với nhiều connector nguồn |
|
Dùng thử 30 ngày miễn phí, mô hình tính phí theo mức sử dụng |
|
Apache Flume |
Luồng dữ liệu streaming |
|
Mã nguồn mở |
|
Stitch |
Tổ chức cần công cụ đơn giản cho tác vụ ingest dữ liệu |
|
Bạn có thể chọn giá theo bậc hoặc trả theo mức sử dụng |
|
StreamSets |
Biến đổi dữ liệu phức tạp |
|
Có cả tùy chọn mã nguồn mở và thương mại |
|
Apache Beam |
Khung tùy chỉnh tập trung vào mã để xây dựng pipeline ingest dữ liệu |
|
Khung Apache Beam là mã nguồn mở, nhưng sẽ phát sinh chi phí khi dùng với dịch vụ đám mây. |
|
Hevo Data |
Doanh nghiệp vừa cần phân tích thời gian thực |
|
Giá theo gói đăng ký |
|
Segment |
Dữ liệu sự kiện khách hàng |
|
Mô hình giá đăng ký |
|
Matillion |
Công cụ ETL/ELT gốc đám mây |
|
Mô hình giá theo gói đăng ký |
|
Keboola |
Pipeline biến đổi dữ liệu phức tạp |
|
Mô hình giá theo gói đăng ký |
|
Snowplow |
Thu thập dữ liệu sự kiện |
|
Có cả tùy chọn mã nguồn mở và thương mại |
|
IBM DataStage |
Hệ sinh thái đám mây IBM |
|
Mô hình giá theo gói đăng ký |
|
Alteryx |
Phân tích và trực quan hóa dữ liệu |
|
Mô hình giá theo gói đăng ký |
Với rất nhiều công cụ trên thị trường, việc chọn nền tảng tích hợp dữ liệu phù hợp cho mục đích của bạn có thể khó khăn. Dưới đây là một số yếu tố bạn nên cân nhắc trước khi chọn một công cụ tích hợp dữ liệu cụ thể.
Bạn có thể dễ dàng ingest một bảng Excel hoặc tệp CSV vào đích. Tuy nhiên, ingest thủ công dữ liệu streaming thời gian thực từ nhiều nguồn tới nhiều đích có thể là thách thức. Ví dụ, các ứng dụng hiện đại như mạng xã hội thường có lúc nhu cầu đạt đỉnh và lúc thấp. Đây là nơi tính năng mở rộng của công cụ data ingestion phát huy hiệu quả.
Khả năng mở rộng là khả năng tăng hoặc giảm theo nhu cầu. Điều này cho phép công cụ nhanh chóng thích ứng với nhu cầu dữ liệu tăng mà không làm giảm hiệu năng.
Tính linh hoạt là khả năng xử lý dữ liệu từ nhiều nguồn và định dạng. Các công cụ data ingestion hỗ trợ đa dạng nguồn dữ liệu và cung cấp connector tùy chỉnh sẽ đảm bảo tính linh hoạt của hệ thống ingest.
Ví dụ, tính năng ánh xạ schema tự động phát hiện schema của dữ liệu đến và ánh xạ vào đích mà không bị ràng buộc bởi cấu trúc schema định sẵn. Điều này cho phép công cụ ingest dữ liệu với bất kỳ schema nào.
Ingest dữ liệu theo lô thu thập dữ liệu theo lịch và cập nhật tại điểm đích. Ngược lại, ingest thời gian thực là truyền dữ liệu liên tục với độ trễ bằng không.
Nhiều công cụ data ingestion hiện nay hỗ trợ cả ingest theo lô và thời gian thực. Tuy nhiên, nếu bạn thường xuyên làm với dữ liệu thời gian thực như sự kiện khách hàng hoặc video streaming, hãy chọn công cụ có khả năng thông lượng cao và độ trễ thấp.
Các công cụ data ingestion có cấu trúc giá khác nhau. Một số cung cấp giá theo bậc, số khác theo mô hình trả theo mức sử dụng. Các giải pháp này thường tiết kiệm chi phí hơn so với công cụ mã nguồn mở vì công cụ miễn phí yêu cầu bạn thuê chuyên gia để triển khai ingest. Tuy vậy, công cụ mã nguồn mở lại mang đến tính linh hoạt và khả năng tùy biến cao cho bài toán của bạn.
Một số công cụ ingest trả phí cũng cung cấp tính năng cấp doanh nghiệp với khả năng tùy biến sâu, dù đi kèm chi phí. Do đó, dựa trên ngân sách và nhu cầu tùy biến, bạn nên chọn giữa nền tảng trả phí và mã nguồn mở.
Việc chọn công cụ data ingestion phù hợp phụ thuộc vào nhu cầu cụ thể của bạn — liệu bạn ưu tiên streaming thời gian thực, xử lý theo lô, tương thích đám mây hay dễ tích hợp. Các công cụ liệt kê ở trên cung cấp nhiều lựa chọn, giúp bạn tinh gọn việc thu thập và nạp dữ liệu vào hệ thống đích một cách hiệu quả.
Nếu bạn mới làm quen với kỹ thuật dữ liệu và muốn hiểu sâu hơn về cách dữ liệu chảy qua các pipeline hiện đại, hãy xem khóa học Introduction to Data Engineering. Với những ai quan tâm tìm hiểu thêm về quy trình ETL và ELT trong Python, ETL and ELT in Python là nguồn tài liệu tuyệt vời để thực hành các kỹ thuật ingest dữ liệu.
Tìm hiểu thêm về kỹ thuật dữ liệu với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
