mHC (Manifold-Constrained Hyper-Connections) dari DeepSeek menanggapi masalah yang dihadapi sebagian besar tim saat menskalakan LLM: Anda bisa terus menambah GPU, tetapi pada titik tertentu pelatihan menjadi tidak stabil dan throughput berhenti meningkat.
Inti idenya sebagai berikut:
- Dalam skala besar, batasan nyata sering kali adalah bandwidth memori, komunikasi antargpu, dan overhead latensi.
- Hyper-Connections (HC) mencoba meningkatkan kapasitas model dengan membiarkan informasi mengalir melalui jalur residual yang lebih kaya tanpa terlalu meningkatkan FLOPs per lapisan. Namun pencampuran ekstra itu dapat merusak “identity shortcut” yang membuat jaringan residual stabil sejak awal, sehingga pelatihan menjadi gagal.
- mHC memperbaiki ini dengan membatasi cara jalur residual tersebut bercampur. Pencampuran residual dipaksa berperilaku seperti rata-rata tertimbang yang tertib (matriks doubly stochastic, ditegakkan menggunakan Sinkhorn–Knopp), yang mencegah sinyal dan gradien meledak atau menghilang.
Hyper-Connections meningkatkan konektivitas dan kapasitas, tetapi Manifold-Constrained Hyper-Connections (mHC) membuat peningkatan itu stabil dan dapat diskalakan, tanpa mengabaikan hambatan nyata seperti bandwidth memori dan komunikasi.
Jika Anda ingin mempelajari lebih lanjut tentang beberapa prinsip yang dibahas dalam tutorial ini, saya merekomendasikan menyimak kursus Transformer Models with PyTorch dan kursus Deep Learning with PyTorch.
Apa itu mHC? Dari Residual Connections ke Hyper-Connections
Di bagian ini, saya akan mengurai kebutuhan untuk melampaui residual connection biasa, bagaimana HC mencoba menyelesaikannya, dan mengapa mHC menjadi perbaikan yang membuat ide ini bekerja pada skala LLM.
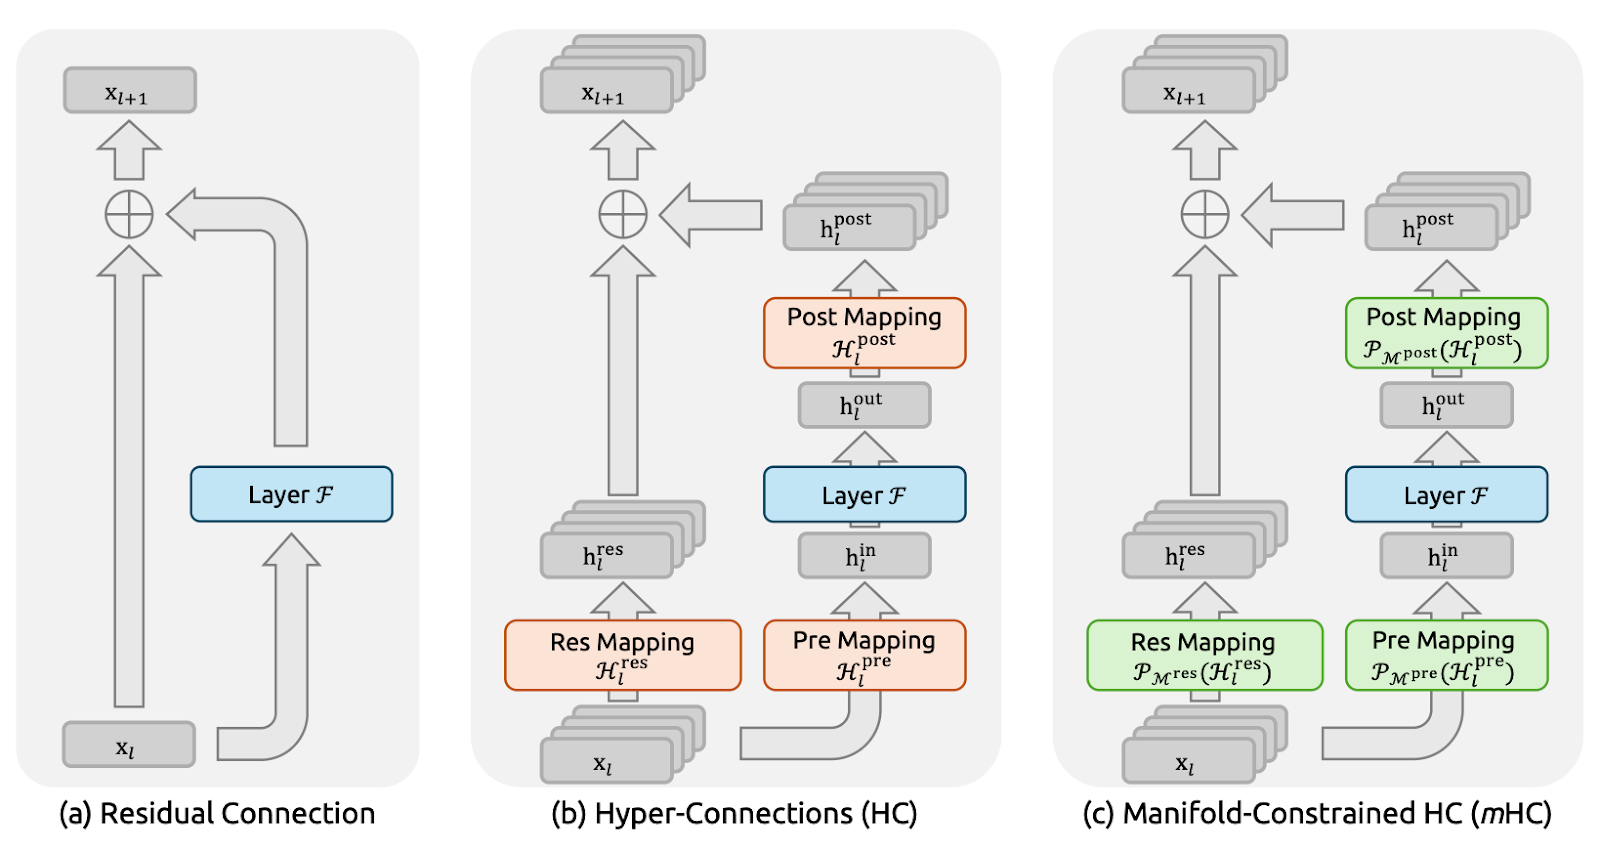
Gambar 1: Ilustrasi Paradigma Residual Connection (paper mHC)
Residual connection (Gambar a) memberi setiap lapisan jalur pintas identitas, memungkinkan sinyal dan gradien mengalir dengan bersih melalui jaringan yang sangat dalam.
DeepSeek secara eksplisit menggunakan prinsip pemetaan identitas ini sebagai titik awal untuk paper mHC. Kekurangannya adalah jalur residual biasa juga terlalu membatasi, sehingga tidak banyak memungkinkan pertukaran informasi di dalam aliran residual.
Sementara Hyper-Connections (HC) (Gambar b) merupakan langkah alami berikutnya, yang alih-alih satu aliran residual, diperluas menjadi n aliran paralel dan menambahkan pemetaan pre/post/residual yang dapat dipelajari sehingga aliran dapat bercampur dan berbagi informasi. Ini meningkatkan daya ekspresi tanpa harus melambungkan FLOPs per lapisan.
Namun dalam skala besar, HC menghadapi dua masalah besar. Pertama, karena aliran bercampur bebas di setiap lapisan, pencampuran kecil itu menumpuk seiring bertambahnya kedalaman. Melintasi banyak lapisan, jaringan dapat berhenti berperilaku seperti “skip connection” yang bersih, dan sinyal atau gradien dapat meledak atau memudar, membuat pelatihan tidak stabil. Kedua, sekalipun komputasi tambahannya sederhana, biaya perangkat keras naik cepat.
Manifold-Constrained Hyper-Connections (mHC) (Gambar c) mempertahankan konektivitas ekstra dari HC, tetapi membuatnya aman untuk dilatih seperti ResNet.
Gagasan utamanya adalah alih-alih membiarkan aliran residual bercampur sembarang, mHC memaksa pencampuran mengikuti aturan ketat. Dalam paper, hal ini dilakukan dengan mengubah matriks pencampuran menjadi “rata-rata tertimbang” yang tertib, menggunakan prosedur bernama Sinkhorn–Knopp. Hasilnya, bahkan setelah banyak lapisan, pencampuran tetap stabil, dan sinyal serta gradien tidak meledak atau lenyap.
Singkatnya, kita beralih dari residual connection ke mHC karena kita menginginkan aliran informasi yang lebih kaya alih-alih satu jalur pintas tunggal.
Konsep Kunci mHC
Secara garis besar, mHC mempertahankan pencampuran multi-stream ala Hyper-Connection, tetapi memasang pagar pembatas keras pada pencampuran tersebut agar berperilaku seperti jalur pintas stabil ala ResNet bahkan ketika kita menumpuk ratusan lapisan.
Para penulis membatasi matriks pencampuran residual Hlres agar tetap tertib di seluruh kedalaman, sambil tetap memungkinkan aliran bertukar informasi.
Secara konkret, mHC memaksa Hlres menjadi doubly stochastic, yaitu semua entri tidak negatif, dan setiap baris serta setiap kolom berjumlah 1. Itu membuat aliran residual bertindak seperti rata-rata tertimbang yang terkontrol.
Ini menonjolkan bahwa pemetaan tidak-ekspansif (norma spektral dibatasi 1), tetap stabil saat dikalikan lintas lapisan (tertutup di bawah perkalian), dan memiliki interpretasi pencampuran sebagai perata-rataan/pencampuran permutasi yang intuitif melalui Birkhoff polytope. Ini juga membatasi pemetaan pre/post agar tidak negatif untuk menghindari pembatalan sinyal.
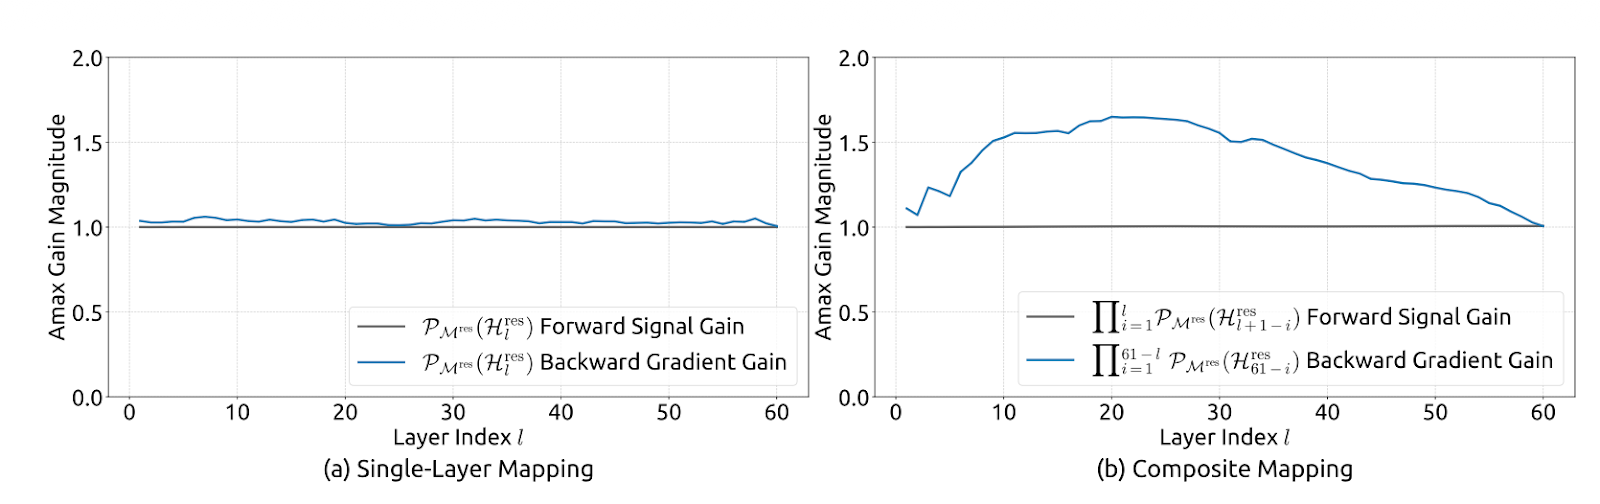
Gambar 2: Stabilitas Propagasi Manifold-Constrained Hyper-Connections (paper mHC)
Dari sisi implementasi, paper ini tetap praktis dengan menghitung pemetaan mentah tak-terbatas Hlpre, Hlpost, dan Hlres dari status multi-stream lapisan saat ini (mereka meratakan xl untuk mempertahankan konteks penuh), lalu memproyeksikannya ke bentuk terbatas. Hlpre dan Hlpost diperoleh dengan batasan berbasis sigmoid, sementara Hlres diproyeksikan menggunakan Sinkhorn–Knopp: mengeksponeksialkan untuk membuat entri positif, lalu normalisasi baris/kolom bergantian hingga jumlahnya 1.
Para penulis juga melaporkan mengimplementasikan mHC (dengan n=4) dalam skala besar dengan overhead waktu pelatihan hanya ~6,7%, terutama dengan agresif mengurangi lalu lintas memori. Mereka mengurutkan ulang bagian RMSNorm agar efisien, menggunakan kernel fusion (termasuk mengimplementasikan iterasi Sinkhorn dalam satu kernel dengan backward kustom), menggabungkan penerapan Hlpost dan Hlres dengan penggabungan residual untuk memangkas baca/tulis, menggunakan rekalkulasi selektif untuk menghindari penyimpanan aktivasi perantara besar, serta men tumpangtindihkan komunikasi dalam jadwal DualPipe yang diperluas untuk menyembunyikan latensi tahap pipeline.
Mengoptimalkan mHC: Teknik Sistem
Stabilitas saja tidak cukup. Jika mHC menambah terlalu banyak lalu lintas memori atau komunikasi antargpu, kita kalah pada throughput. Jadi para penulis memasangkan metode mHC dengan serangkaian optimasi infrastruktur yang dirancang agar tetap ramah terhadap tembok memori.
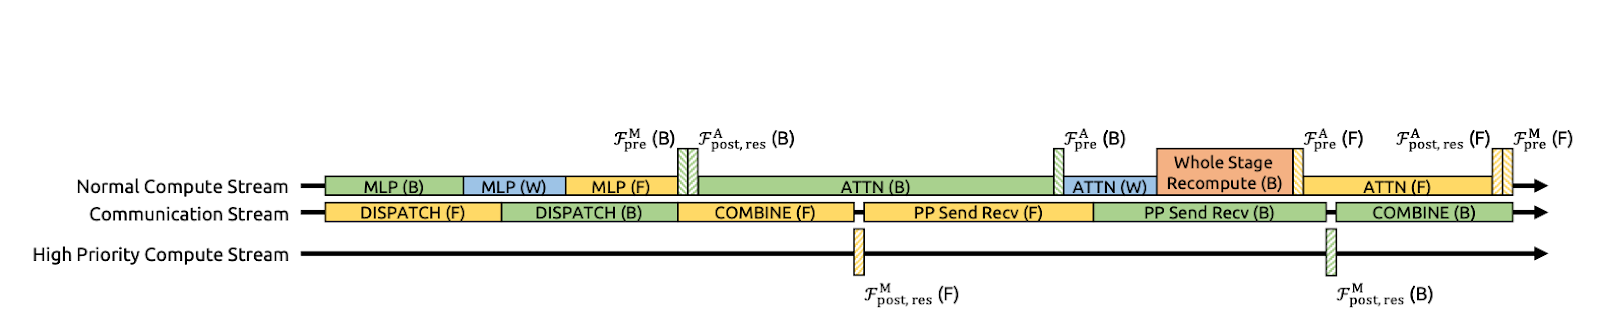
Gambar 3: Tumpang Tindih Komunikasi-Komputasi untuk mHC (paper mHC)
Kernel fusion untuk mengurangi baca/tulis memori
Para penulis mempercepat mHC dengan menggabungkan beberapa langkah menjadi satu kernel GPU. Alih-alih menerapkan Hlpost, Hlres, lalu menggabungkan kembali ke aliran residual sebagai lintasan terpisah (yang memaksa GPU menulis tensor perantara ke memori dan membacanya kembali), mereka melakukan operasi tersebut dalam satu lintasan.
Ini memangkas lalu lintas memori secara signifikan. Kernel kini membaca sekitar (n+1)C nilai alih-alih (3n+1)C dan menulis sekitar nC nilai alih-alih 3nC. Di sini, C adalah ukuran tersembunyi (fitur per aliran) dan n adalah jumlah aliran residual, sehingga nC adalah ukuran status residual yang diperlebar. Lebih sedikit baca/tulis berarti lebih sedikit data yang bergerak ke dan dari memori.
Paper ini juga menyarankan mengimplementasikan sebagian besar kernel menggunakan TileLang untuk memanfaatkan bandwidth memori dengan cara yang lebih baik.
Rekomputasi untuk mengendalikan memori aktivasi
Multi-stream mHC meningkatkan jumlah aktivasi perantara yang biasanya harus Anda simpan untuk backprop, yang dapat melambungkan memori GPU dan memaksa batch lebih kecil atau checkpointing yang lebih agresif.
Untuk menghindarinya, paper menyarankan trik sederhana: jangan simpan perantara mHC setelah forward pass. Sebagai gantinya, hitung ulang kernel mHC yang ringan saat backward pass, sambil melewati perhitungan ulang komponen Transformer F yang mahal.
Ini mengurangi tekanan memori dan membantu mempertahankan throughput efektif yang lebih tinggi. Batasan praktisnya adalah blok rekomputasi ini harus selaras dengan batas tahap pipeline; jika tidak, penjadwalan pipeline menjadi berantakan.
Penjadwalan sadar-komunikasi dengan tumpang tindih DualPipe
Dalam skala besar, paralelisme pipeline lazim digunakan, tetapi desain n-stream mHC meningkatkan jumlah data yang harus melintasi batas tahap, yang dapat menambah jeda komunikasi yang terasa.
DeepSeek mengoptimalkannya dengan memperluas DualPipe sehingga komunikasi dan komputasi saling tumpang tindih di batas pipeline. Artinya, GPU tetap melakukan pekerjaan berguna saat transfer berlangsung alih-alih menganggur menunggu proses kirim/terima selesai. Mereka juga menjalankan beberapa kernel pada compute stream prioritas tinggi, sehingga komputasi tidak menghambat kemajuan komunikasi. Hasilnya, biaya komunikasi ekstra dari mHC sebagian tersembunyi, meningkatkan efisiensi pelatihan end-to-end
Titik Panas
Bahkan jika kita tidak mengimplementasikan mHC, kerangka pikir DeepSeek adalah cara yang baik untuk melihat di mana sistem sebenarnya kehilangan waktu.
- Beban kerja konteks panjang: Prompt panjang membuat prefill mahal karena attention harus memindahkan banyak data melalui memori. Saat decode, KV cache terus bertambah, yang meningkatkan pembacaan memori per token. Bersama-sama, ini mendorong batas bandwidth memori dan sering menyebabkan fragmentasi atau batching yang tidak efisien.
- Routing MoE dan paralelisme expert: Dengan Mixture of Experts (MoE), biayanya bukan hanya tentang komputasi. Ada routing, pertukaran token, dan komunikasi lintas GPU yang diperlukan untuk mengirim token ke expert dan mengumpulkan keluaran. Tumpang tindih DualPipe dari DeepSeek berfokus pada menyembunyikan komunikasi pipeline di balik komputasi, yang dibutuhkan MoE dalam skala besar.
- Lalu lintas multi-penyewa dan batch kecil: Dalam penerapan nyata, permintaan tidak datang dalam batch besar yang rapi. Kita mendapat batch yang lebih kecil dan tidak konsisten, panjang sekuens campuran, serta reuse cache yang lebih lemah. Itu merusak efisiensi batching dan meningkatkan tail latency, sehingga bandwidth memori dan penjadwalan menjadi hambatan.
KV Cache dan Lalu Lintas Memori
Meskipun mHC terutama adalah gagasan untuk pelatihan, pelajaran inti paper ini berlaku langsung untuk inferensi. Paper ini berfokus pada optimalisasi tidak hanya untuk FLOPs, tetapi juga untuk lalu lintas memori, komunikasi, dan latensi. Bukti terbesarnya adalah decoding konteks panjang, di mana perkiraan kasar KV cache adalah:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batch
Untuk FP16/BF16, nilai bytes_per_elem adalah 2. Misalnya, dengan bentuk tipikal ( L=32, H=4096, batch=1), 8K token sekitar ~4 GB KV, sedangkan 128K token sekitar ~64 GB, jadi sekalipun komputasi tetap wajar, memori masih bisa meledak, dan Anda menjadi dibatasi oleh bandwidth.
Itulah mengapa optimalisasi inferensi praktis berfokus pada pengurangan perpindahan memori menggunakan teknik seperti kuantisasi KV cache, paged KV dan eviction, kernel attention yang efisien (keluarga FlashAttention), continuous batching dan shape bucketing, serta paralelisme yang sadar-komunikasi.
Tujuannya adalah mempertahankan peningkatan kinerja tanpa membayar pajak tersembunyi dalam baca/tulis memori dan sinkronisasi.
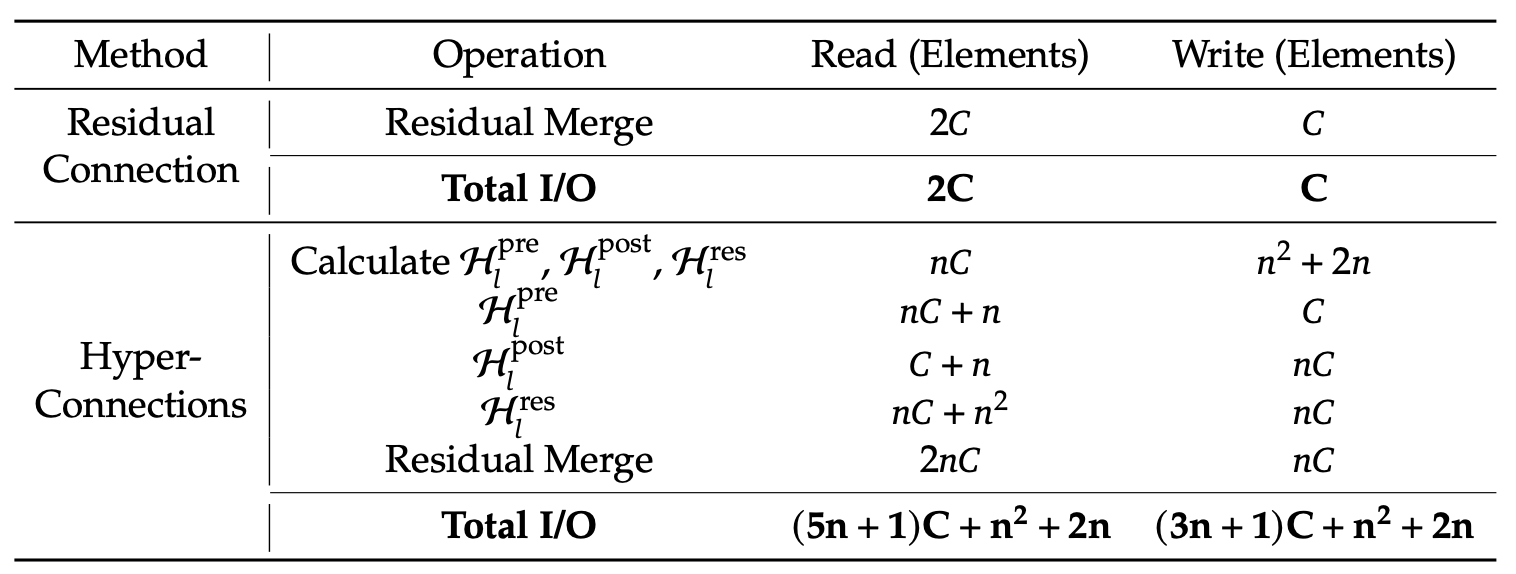
Tabel 1: Perbandingan Biaya Akses Memori Per Token (paper mHC)
DeepSeek melaporkan mHC secara konsisten mengungguli baseline dan melampaui HC pada sebagian besar tolok ukur untuk model 27B, termasuk +2,1% pada BBH dan +2,3% pada DROP dibandingkan HC. Ini menunjukkan bahwa mHC berujung pada hasil yang lebih baik dalam skala besar.
Kesimpulan
Inti yang dapat diambil dari paper ini adalah bahwa penskalaan LLM bukan hanya masalah FLOPs; ini juga masalah stabilitas dan sistem. Hyper-Connections (HC) meningkatkan kapasitas model dengan memperluas aliran residual dan memungkinkan beberapa aliran bercampur, tetapi pada kedalaman besar, pencampuran ini terakumulasi menjadi pemetaan komposit yang dapat menyimpang jauh dari jalur identitas, menyebabkan ledakan atau lenyapnya sinyal/gradien, dan kegagalan pelatihan.
mHC memperbaiki ini dengan memasang pagar pembatas pada pencampuran tersebut dengan membatasi matriks pencampuran residual agar doubly stochastic (tidak negatif, baris/kolom berjumlah 1), ditegakkan melalui Sinkhorn–Knopp, sehingga jalur residual berperilaku seperti rata-rata tertimbang yang terkontrol dan tetap stabil bahkan saat Anda menumpuk banyak lapisan.
DeepSeek juga memperlakukan efisiensi runtime sebagai bagian dari metodenya. Mereka menggunakan kernel fusion untuk mengurangi baca/tulis memori berbandwidth tinggi, dan rekomputasi selektif untuk meminimalkan memori aktivasi.
Selain itu, mereka memperluas DualPipe untuk men tumpangtindihkan komunikasi dengan komputasi, memastikan bahwa jeda pipeline tidak menghapus keuntungan. Hasilnya bukan hanya pelatihan yang lebih stabil, tetapi juga kinerja hilir yang lebih baik dalam skala besar.
Jika Anda ingin mempelajari lebih lanjut tentang pengembangan aplikasi LLM, saya merekomendasikan untuk menyimak kursus Developing LLM Applications with LangChain.




mHC (Manifold-Constrained Hyper-Connections) dari DeepSeek menanggapi masalah yang dihadapi sebagian besar tim saat menskalakan LLM: Anda bisa terus menambah GPU, tetapi pada titik tertentu pelatihan menjadi tidak stabil dan throughput berhenti meningkat.
Inti idenya sebagai berikut:
Hyper-Connections meningkatkan konektivitas dan kapasitas, tetapi Manifold-Constrained Hyper-Connections (mHC) membuat peningkatan itu stabil dan dapat diskalakan, tanpa mengabaikan hambatan nyata seperti bandwidth memori dan komunikasi.
Jika Anda ingin mempelajari lebih lanjut tentang beberapa prinsip yang dibahas dalam tutorial ini, saya merekomendasikan menyimak kursus Transformer Models with PyTorch dan kursus Deep Learning with PyTorch.
Apa itu mHC? Dari Residual Connections ke Hyper-Connections
Di bagian ini, saya akan mengurai kebutuhan untuk melampaui residual connection biasa, bagaimana HC mencoba menyelesaikannya, dan mengapa mHC menjadi perbaikan yang membuat ide ini bekerja pada skala LLM.
Gambar 1: Ilustrasi Paradigma Residual Connection (paper mHC)
Residual connection (Gambar a) memberi setiap lapisan jalur pintas identitas, memungkinkan sinyal dan gradien mengalir dengan bersih melalui jaringan yang sangat dalam.
DeepSeek secara eksplisit menggunakan prinsip pemetaan identitas ini sebagai titik awal untuk paper mHC. Kekurangannya adalah jalur residual biasa juga terlalu membatasi, sehingga tidak banyak memungkinkan pertukaran informasi di dalam aliran residual.
Sementara Hyper-Connections (HC) (Gambar b) merupakan langkah alami berikutnya, yang alih-alih satu aliran residual, diperluas menjadi n aliran paralel dan menambahkan pemetaan pre/post/residual yang dapat dipelajari sehingga aliran dapat bercampur dan berbagi informasi. Ini meningkatkan daya ekspresi tanpa harus melambungkan FLOPs per lapisan.
Namun dalam skala besar, HC menghadapi dua masalah besar. Pertama, karena aliran bercampur bebas di setiap lapisan, pencampuran kecil itu menumpuk seiring bertambahnya kedalaman. Melintasi banyak lapisan, jaringan dapat berhenti berperilaku seperti “skip connection” yang bersih, dan sinyal atau gradien dapat meledak atau memudar, membuat pelatihan tidak stabil. Kedua, sekalipun komputasi tambahannya sederhana, biaya perangkat keras naik cepat.
Manifold-Constrained Hyper-Connections (mHC) (Gambar c) mempertahankan konektivitas ekstra dari HC, tetapi membuatnya aman untuk dilatih seperti ResNet.
Gagasan utamanya adalah alih-alih membiarkan aliran residual bercampur sembarang, mHC memaksa pencampuran mengikuti aturan ketat. Dalam paper, hal ini dilakukan dengan mengubah matriks pencampuran menjadi “rata-rata tertimbang” yang tertib, menggunakan prosedur bernama Sinkhorn–Knopp. Hasilnya, bahkan setelah banyak lapisan, pencampuran tetap stabil, dan sinyal serta gradien tidak meledak atau lenyap.
Singkatnya, kita beralih dari residual connection ke mHC karena kita menginginkan aliran informasi yang lebih kaya alih-alih satu jalur pintas tunggal.
Konsep Kunci mHC
Secara garis besar, mHC mempertahankan pencampuran multi-stream ala Hyper-Connection, tetapi memasang pagar pembatas keras pada pencampuran tersebut agar berperilaku seperti jalur pintas stabil ala ResNet bahkan ketika kita menumpuk ratusan lapisan.
Para penulis membatasi matriks pencampuran residual
Hlresagar tetap tertib di seluruh kedalaman, sambil tetap memungkinkan aliran bertukar informasi.Secara konkret, mHC memaksa
Hlresmenjadi doubly stochastic, yaitu semua entri tidak negatif, dan setiap baris serta setiap kolom berjumlah 1. Itu membuat aliran residual bertindak seperti rata-rata tertimbang yang terkontrol.Ini menonjolkan bahwa pemetaan tidak-ekspansif (norma spektral dibatasi 1), tetap stabil saat dikalikan lintas lapisan (tertutup di bawah perkalian), dan memiliki interpretasi pencampuran sebagai perata-rataan/pencampuran permutasi yang intuitif melalui Birkhoff polytope. Ini juga membatasi pemetaan pre/post agar tidak negatif untuk menghindari pembatalan sinyal.
Gambar 2: Stabilitas Propagasi Manifold-Constrained Hyper-Connections (paper mHC)
Dari sisi implementasi, paper ini tetap praktis dengan menghitung pemetaan mentah tak-terbatas
Hlpre,Hlpost, danHlresdari status multi-stream lapisan saat ini (mereka meratakanxluntuk mempertahankan konteks penuh), lalu memproyeksikannya ke bentuk terbatas.HlpredanHlpostdiperoleh dengan batasan berbasis sigmoid, sementara Hlresdiproyeksikan menggunakan Sinkhorn–Knopp: mengeksponeksialkan untuk membuat entri positif, lalu normalisasi baris/kolom bergantian hingga jumlahnya 1.Para penulis juga melaporkan mengimplementasikan mHC (dengan n=4) dalam skala besar dengan overhead waktu pelatihan hanya ~6,7%, terutama dengan agresif mengurangi lalu lintas memori. Mereka mengurutkan ulang bagian RMSNorm agar efisien, menggunakan kernel fusion (termasuk mengimplementasikan iterasi Sinkhorn dalam satu kernel dengan backward kustom), menggabungkan penerapan
HlpostdanHlresdengan penggabungan residual untuk memangkas baca/tulis, menggunakan rekalkulasi selektif untuk menghindari penyimpanan aktivasi perantara besar, serta men tumpangtindihkan komunikasi dalam jadwal DualPipe yang diperluas untuk menyembunyikan latensi tahap pipeline.Mengoptimalkan mHC: Teknik Sistem
Stabilitas saja tidak cukup. Jika mHC menambah terlalu banyak lalu lintas memori atau komunikasi antargpu, kita kalah pada throughput. Jadi para penulis memasangkan metode mHC dengan serangkaian optimasi infrastruktur yang dirancang agar tetap ramah terhadap tembok memori.
Gambar 3: Tumpang Tindih Komunikasi-Komputasi untuk mHC (paper mHC)
Kernel fusion untuk mengurangi baca/tulis memori
Para penulis mempercepat mHC dengan menggabungkan beberapa langkah menjadi satu kernel GPU. Alih-alih menerapkan
Hlpost,Hlres, lalu menggabungkan kembali ke aliran residual sebagai lintasan terpisah (yang memaksa GPU menulis tensor perantara ke memori dan membacanya kembali), mereka melakukan operasi tersebut dalam satu lintasan.Ini memangkas lalu lintas memori secara signifikan. Kernel kini membaca sekitar
(n+1)Cnilai alih-alih(3n+1)Cdan menulis sekitarnCnilai alih-alih3nC. Di sini,Cadalah ukuran tersembunyi (fitur per aliran) dannadalah jumlah aliran residual, sehingganCadalah ukuran status residual yang diperlebar. Lebih sedikit baca/tulis berarti lebih sedikit data yang bergerak ke dan dari memori.Paper ini juga menyarankan mengimplementasikan sebagian besar kernel menggunakan TileLang untuk memanfaatkan bandwidth memori dengan cara yang lebih baik.
Rekomputasi untuk mengendalikan memori aktivasi
Multi-stream mHC meningkatkan jumlah aktivasi perantara yang biasanya harus Anda simpan untuk backprop, yang dapat melambungkan memori GPU dan memaksa batch lebih kecil atau checkpointing yang lebih agresif.
Untuk menghindarinya, paper menyarankan trik sederhana: jangan simpan perantara mHC setelah forward pass. Sebagai gantinya, hitung ulang kernel mHC yang ringan saat backward pass, sambil melewati perhitungan ulang komponen Transformer F yang mahal.
Ini mengurangi tekanan memori dan membantu mempertahankan throughput efektif yang lebih tinggi. Batasan praktisnya adalah blok rekomputasi ini harus selaras dengan batas tahap pipeline; jika tidak, penjadwalan pipeline menjadi berantakan.
Penjadwalan sadar-komunikasi dengan tumpang tindih DualPipe
Dalam skala besar, paralelisme pipeline lazim digunakan, tetapi desain n-stream mHC meningkatkan jumlah data yang harus melintasi batas tahap, yang dapat menambah jeda komunikasi yang terasa.
DeepSeek mengoptimalkannya dengan memperluas DualPipe sehingga komunikasi dan komputasi saling tumpang tindih di batas pipeline. Artinya, GPU tetap melakukan pekerjaan berguna saat transfer berlangsung alih-alih menganggur menunggu proses kirim/terima selesai. Mereka juga menjalankan beberapa kernel pada compute stream prioritas tinggi, sehingga komputasi tidak menghambat kemajuan komunikasi. Hasilnya, biaya komunikasi ekstra dari mHC sebagian tersembunyi, meningkatkan efisiensi pelatihan end-to-end
Titik Panas
Bahkan jika kita tidak mengimplementasikan mHC, kerangka pikir DeepSeek adalah cara yang baik untuk melihat di mana sistem sebenarnya kehilangan waktu.
KV Cache dan Lalu Lintas Memori
Meskipun mHC terutama adalah gagasan untuk pelatihan, pelajaran inti paper ini berlaku langsung untuk inferensi. Paper ini berfokus pada optimalisasi tidak hanya untuk FLOPs, tetapi juga untuk lalu lintas memori, komunikasi, dan latensi. Bukti terbesarnya adalah decoding konteks panjang, di mana perkiraan kasar KV cache adalah:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batchUntuk FP16/BF16, nilai
bytes_per_elemadalah 2. Misalnya, dengan bentuk tipikal ( L=32, H=4096, batch=1), 8K token sekitar ~4 GB KV, sedangkan 128K token sekitar ~64 GB, jadi sekalipun komputasi tetap wajar, memori masih bisa meledak, dan Anda menjadi dibatasi oleh bandwidth.Itulah mengapa optimalisasi inferensi praktis berfokus pada pengurangan perpindahan memori menggunakan teknik seperti kuantisasi KV cache, paged KV dan eviction, kernel attention yang efisien (keluarga FlashAttention), continuous batching dan shape bucketing, serta paralelisme yang sadar-komunikasi.
Tujuannya adalah mempertahankan peningkatan kinerja tanpa membayar pajak tersembunyi dalam baca/tulis memori dan sinkronisasi.
Tabel 1: Perbandingan Biaya Akses Memori Per Token (paper mHC)
DeepSeek melaporkan mHC secara konsisten mengungguli baseline dan melampaui HC pada sebagian besar tolok ukur untuk model 27B, termasuk +2,1% pada BBH dan +2,3% pada DROP dibandingkan HC. Ini menunjukkan bahwa mHC berujung pada hasil yang lebih baik dalam skala besar.
Kesimpulan
Inti yang dapat diambil dari paper ini adalah bahwa penskalaan LLM bukan hanya masalah FLOPs; ini juga masalah stabilitas dan sistem. Hyper-Connections (HC) meningkatkan kapasitas model dengan memperluas aliran residual dan memungkinkan beberapa aliran bercampur, tetapi pada kedalaman besar, pencampuran ini terakumulasi menjadi pemetaan komposit yang dapat menyimpang jauh dari jalur identitas, menyebabkan ledakan atau lenyapnya sinyal/gradien, dan kegagalan pelatihan.
mHC memperbaiki ini dengan memasang pagar pembatas pada pencampuran tersebut dengan membatasi matriks pencampuran residual agar doubly stochastic (tidak negatif, baris/kolom berjumlah 1), ditegakkan melalui Sinkhorn–Knopp, sehingga jalur residual berperilaku seperti rata-rata tertimbang yang terkontrol dan tetap stabil bahkan saat Anda menumpuk banyak lapisan.
DeepSeek juga memperlakukan efisiensi runtime sebagai bagian dari metodenya. Mereka menggunakan kernel fusion untuk mengurangi baca/tulis memori berbandwidth tinggi, dan rekomputasi selektif untuk meminimalkan memori aktivasi.
Selain itu, mereka memperluas DualPipe untuk men tumpangtindihkan komunikasi dengan komputasi, memastikan bahwa jeda pipeline tidak menghapus keuntungan. Hasilnya bukan hanya pelatihan yang lebih stabil, tetapi juga kinerja hilir yang lebih baik dalam skala besar.
Jika Anda ingin mempelajari lebih lanjut tentang pengembangan aplikasi LLM, saya merekomendasikan untuk menyimak kursus Developing LLM Applications with LangChain.