L’mHC di DeepSeek (Manifold-Constrained Hyper-Connections) affronta un problema che la maggior parte dei team incontra quando scala gli LLM: puoi continuare ad aggiungere GPU, ma a un certo punto l’addestramento diventa instabile e il throughput smette di migliorare.
Ecco l’idea centrale:
- Su larga scala, i veri limiti sono spesso la banda di memoria, la comunicazione GPU-to-GPU e la latenza.
- Le Hyper-Connections (HC) cercano di aumentare la capacità del modello consentendo al flusso d’informazione di passare attraverso percorsi residuali più ricchi senza aumentare troppo i FLOP per livello. Ma quel mixing aggiuntivo può rompere il “collegamento identità” che ha reso stabili le reti residuali in origine, causando il collasso dell’addestramento.
- mHC risolve questo problema vincolando il modo in cui quei percorsi residuali si mescolano. Il mixing residuo è forzato a comportarsi come una media pesata ben definita (una matrice doppiamente stocastica, imposta usando Sinkhorn–Knopp), che impedisce a segnali e gradienti di esplodere o estinguersi.
Le Hyper-Connections migliorano connettività e capacità, ma le Manifold-Constrained Hyper-Connections (mHC) rendono questo upgrade stabile e scalabile, senza ignorare i veri colli di bottiglia come banda di memoria e comunicazione.
Se vuoi approfondire alcuni dei principi trattati in questo tutorial, ti consiglio di dare un’occhiata al corso Transformer Models with PyTorch e al corso Deep Learning with PyTorch.
Cos’è mHC? Dalle connessioni residuali alle Hyper-Connections
In questa sezione, spiegherò perché serve andare oltre le semplici connessioni residuali, come le HC hanno provato a risolvere il problema e perché mHC è la soluzione che rende l’idea funzionale alla scala degli LLM.
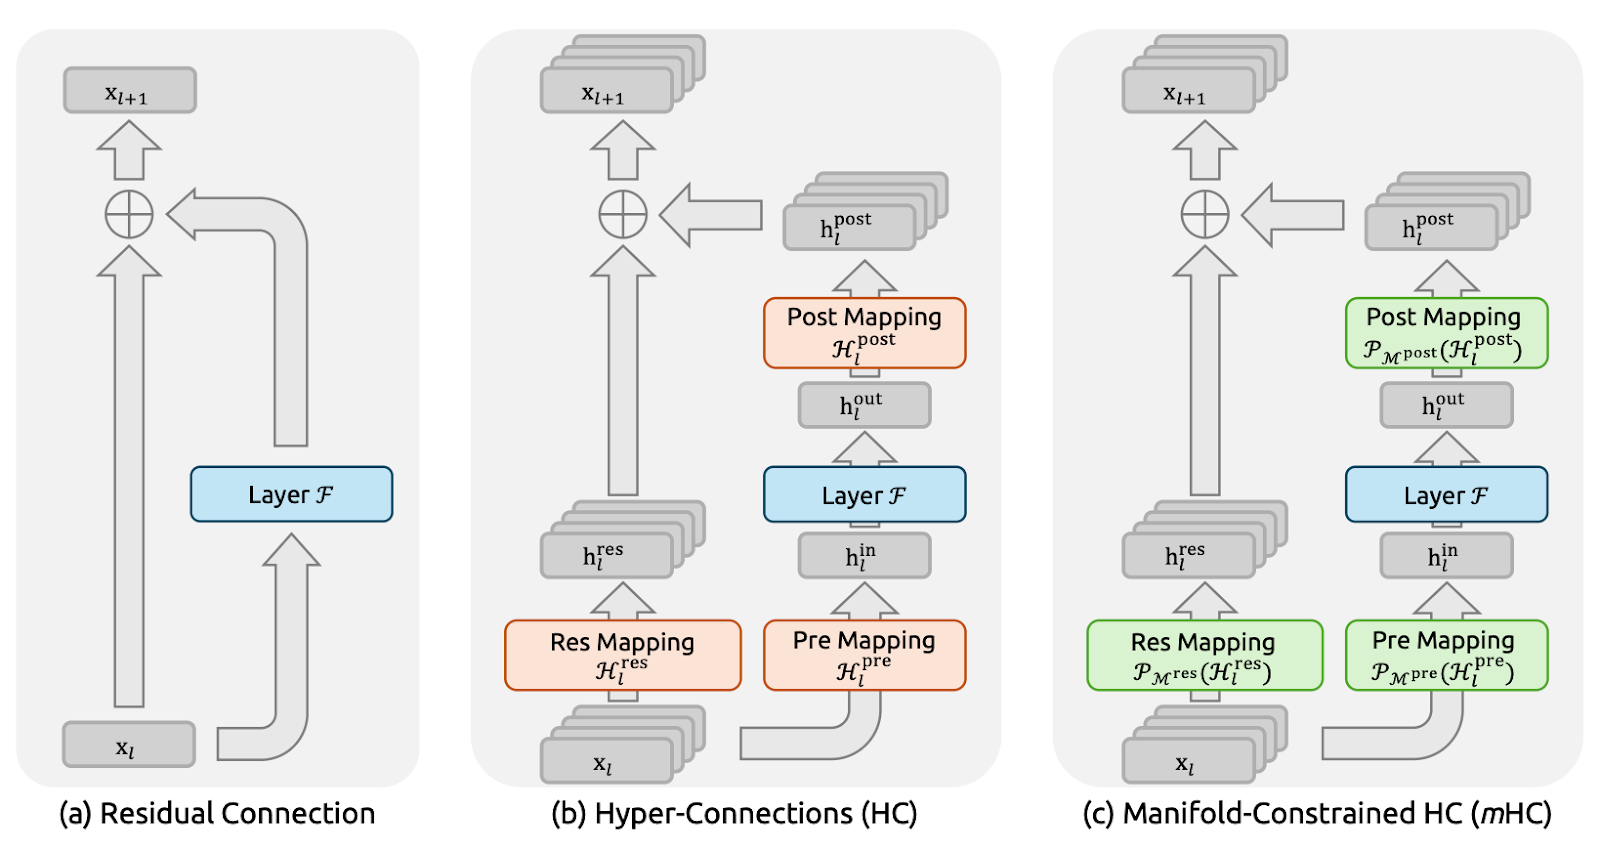
Figura 1: Illustrazioni dei paradigmi di connessioni residuali (paper mHC)
Le connessioni residuali (Figura a) forniscono a ogni livello un collegamento identità, consentendo a segnali e gradienti di fluire senza intoppi attraverso reti molto profonde.
DeepSeek ha usato esplicitamente questo principio di mappatura identità come punto di partenza per il paper mHC. Il rovescio della medaglia è che un semplice percorso residuo è anche troppo restrittivo e non consente molto scambio d’informazioni all’interno del flusso residuo.
Le Hyper-Connections (HC) (Figura b) sono state il passo successivo naturale: invece di un solo flusso residuo, si espandono in n flussi paralleli e aggiungono mappature pre/post/residuali apprendibili in modo che i flussi possano mescolarsi e condividere informazioni. Questo aumenta l’espressività senza necessariamente far esplodere i FLOP per livello.
Ma su larga scala, le HC incontrano due grossi problemi. Primo, poiché i flussi si mescolano liberamente a ogni livello, quei piccoli mixing si sommano man mano che si va più in profondità. Dopo molti livelli, la rete può smettere di comportarsi come una pulita “skip connection” e segnali o gradienti possono esplodere o attenuarsi, rendendo l’addestramento instabile. Secondo, anche se i calcoli extra sono semplici, il costo hardware cresce rapidamente.
Le Manifold-Constrained Hyper-Connections (mHC) (Figura c) mantengono la connettività aggiuntiva delle HC, ma rendono l’addestramento sicuro come in un ResNet.
L’idea principale è che, invece di lasciare che i flussi residuali si mescolino in qualunque modo, mHC impone regole rigide al mixing. Nel paper, ciò avviene trasformando la matrice di mixing in una “media pesata” ben comportata, usando una procedura chiamata Sinkhorn–Knopp. Il risultato è che, anche dopo molti livelli, il mixing rimane stabile e segnali e gradienti non esplodono né svaniscono.
In breve, siamo passati dalle connessioni residuali alle mHC perché volevamo un flusso d’informazione più ricco rispetto a un singolo percorso di skip.
Concetti chiave di mHC
A livello alto, mHC mantiene il mixing multi-stream delle Hyper-Connections, ma mette binari rigidi al mixing in modo che si comporti come un percorso di skip stabile in stile ResNet anche quando impiliamo centinaia di livelli.
Gli autori vincolano la matrice di mixing residuo Hlres così che resti ben comportata in profondità, pur consentendo lo scambio di informazioni tra i flussi.
In concreto, mHC forza Hlres a essere doppiamente stocastica, cioè tutte le voci sono non negative e ogni riga e ogni colonna somma a 1. Questo fa sì che il flusso residuo si comporti come una media pesata controllata.
Questo evidenzia che la mappatura è non espansiva (norma spettrale limitata a 1), resta stabile quando moltiplicata attraverso i livelli (chiusura per moltiplicazione) e ha un mixing intuitivo come media/permutazione, interpretabile via il poliedro di Birkhoff. Vincola anche le mappature pre/post a essere non negative per evitare la cancellazione del segnale.
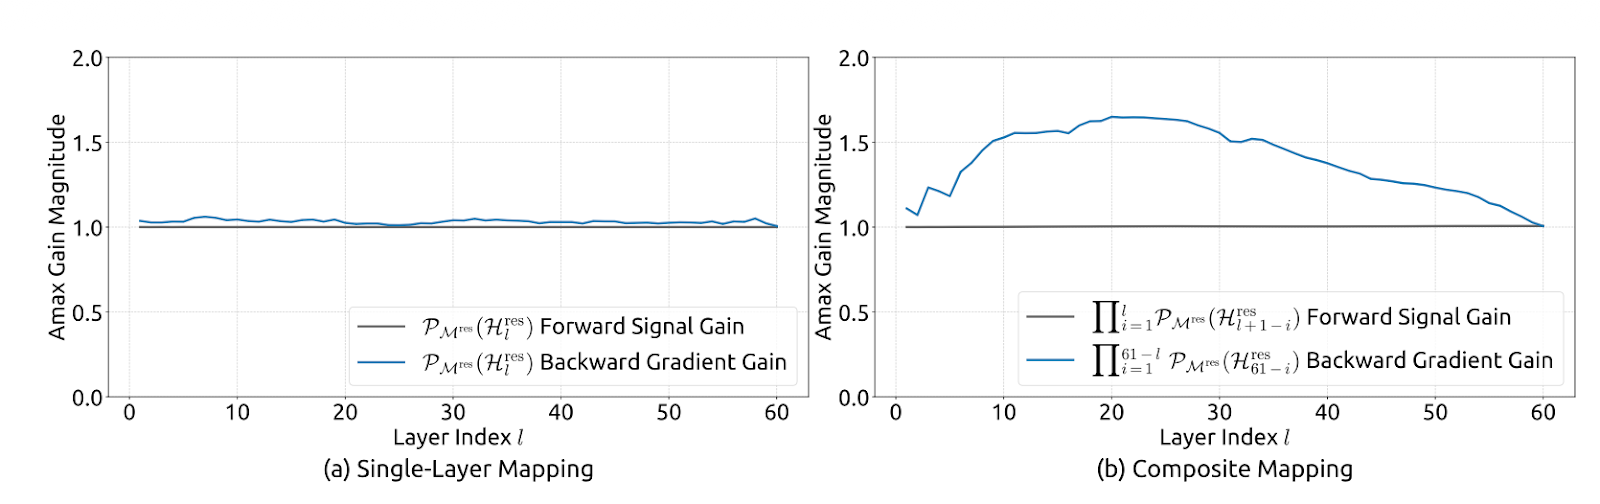
Figura 2: Stabilità della propagazione delle Manifold-Constrained Hyper-Connections (paper mHC)
A livello di implementazione, il paper resta pratico calcolando mappature grezze non vincolate Hlpre, Hlpost e Hlres dallo stato multi-stream del livello corrente (appiattiscono xl per preservare il contesto completo), quindi proiettandole nelle forme vincolate. Hlpre e Hlpost sono ottenute con un vincolo basato su sigmoid, mentre Hlres è proiettata usando Sinkhorn–Knopp: si esponenziano le voci per renderle positive, poi si alternano normalizzazioni per riga/colonna finché le somme non sono 1.
Gli autori riportano anche di aver implementato mHC (con n=4) su larga scala con solo ~6,7% di overhead in tempo di addestramento, principalmente riducendo aggressivamente il traffico di memoria. Hanno riordinato le parti di RMSNorm per efficienza, usato la fusione di kernel (inclusa l’implementazione delle iterazioni di Sinkhorn in un singolo kernel con backward personalizzato), fuso l’applicazione di Hlpost e Hlres con il merge residuo per ridurre letture/scritture, usato ricomputazioni selettive per evitare di memorizzare grandi attivazioni intermedie e sovrapposto la comunicazione in uno scheduling DualPipe esteso per nascondere la latenza tra stadi della pipeline.
Ottimizzare mHC: tecniche di sistema
La sola stabilità non basta. Se mHC aggiunge troppo traffico di memoria o comunicazione GPU-to-GPU, perdiamo in throughput. Perciò gli autori hanno affiancato al metodo mHC un set di ottimizzazioni infrastrutturali pensate per restare amiche della “memory wall”.
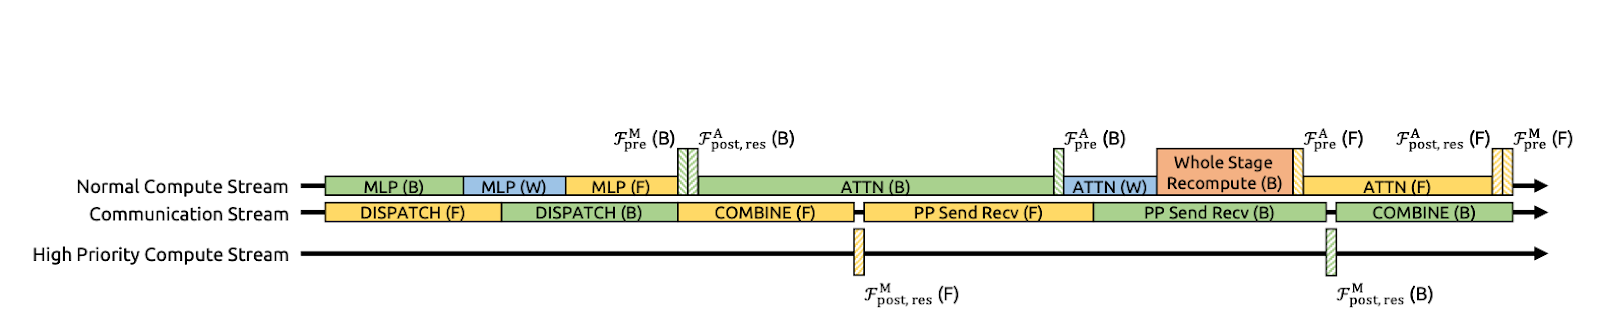
Figura 3: Sovrapposizione comunicazione-calcolo per mHC (paper mHC)
Fusione dei kernel per ridurre letture/scritture di memoria
Gli autori accelerano mHC fondendo diversi passaggi in un unico kernel GPU. Invece di applicare Hlpost, Hlres e poi fare il merge nel flusso residuo come passate separate (che costringono la GPU a scrivere tensori intermedi in memoria e rileggerli), eseguono queste operazioni in un’unica passata.
Questo riduce sensibilmente il traffico di memoria. Il kernel ora legge circa (n+1)C valori invece di (3n+1)C e scrive circa nC valori invece di 3nC. Qui, C è la dimensione nascosta (feature per flusso) e n è il numero di flussi residuali, quindi nC è la dimensione dello stato residuo ampliato. Meno letture/scritture significa meno dati che si spostano da e verso la memoria.
Il paper suggerisce anche di implementare la maggior parte dei kernel usando TileLang per sfruttare meglio la banda di memoria.
Ricomputazione per controllare la memoria delle attivazioni
Il multi-stream di mHC aumenta la quantità di attivazioni intermedie che normalmente dovresti memorizzare per il backprop, cosa che può saturare la memoria GPU e costringere a batch più piccoli o a checkpointing più aggressivo.
Per evitarlo, il paper suggerisce un trucco semplice: non archiviare gli intermedi di mHC dopo il forward pass. Invece, ricomputa i kernel leggeri di mHC durante il backward pass, evitando però la ricomputazione del costoso livello Transformer F.
Questo riduce la pressione sulla memoria e aiuta a mantenere un throughput effettivo più alto. Un vincolo pratico è che questi blocchi di ricomputazione dovrebbero allinearsi con i confini degli stadi di pipeline; altrimenti lo scheduling della pipeline diventa complicato.
Scheduling consapevole della comunicazione con overlap DualPipe
Su larga scala, il parallelismo a pipeline è comune, ma il design a n flussi di mHC aumenta la quantità di dati che devono attraversare i confini degli stadi, il che può aggiungere rallentamenti di comunicazione percepibili.
DeepSeek ottimizza estendendo DualPipe in modo che comunicazione e calcolo si sovrappongano ai confini della pipeline. Ciò significa che le GPU svolgono lavoro utile mentre avvengono i trasferimenti, invece di restare inattive in attesa del completamento di invii/ricezioni. Eseguono anche alcuni kernel su uno stream di calcolo ad alta priorità, così il calcolo non blocca i progressi della comunicazione. Il risultato è che il costo di comunicazione extra di mHC è in parte nascosto, migliorando l’efficienza dell’addestramento end-to-end
Hot spot
Anche se non implementiamo mHC, l’impostazione di DeepSeek è un buon modo per individuare dove il sistema perde davvero tempo.
- Carichi a contesto lungo: Prompt lunghi rendono costosa la prefill perché l’attenzione deve spostare molti dati in memoria. Durante il decode, la cache KV continua a crescere, aumentando le letture di memoria per token. Insieme, questi aspetti spingono ai limiti la banda di memoria e spesso causano frammentazione o batching inefficiente.
- Instradamento MoE e parallelismo degli esperti: Con Mixture of Experts (MoE), il costo non riguarda solo il calcolo. È l’instradamento, lo scambio di token e la comunicazione cross-GPU necessaria per inviare i token agli esperti e raccogliere gli output. L’overlap DualPipe di DeepSeek punta a nascondere la comunicazione della pipeline dietro il calcolo, cosa che il MoE richiede su larga scala.
- Traffico multi-tenant e batch piccoli: Nelle implementazioni reali, le richieste non arrivano in batch grandi e ordinati. Otteniamo batch più piccoli e irregolari, lunghezze di sequenza miste e minore riuso della cache. Questo peggiora l’efficienza del batching e aumenta la tail latency, quindi banda di memoria e scheduling diventano il collo di bottiglia.
KV cache e traffico di memoria
Anche se mHC è principalmente un’idea per l’addestramento, la lezione centrale del paper si applica direttamente all’inferenza. Il paper si concentra sull’ottimizzazione non solo dei FLOP, ma anche del traffico di memoria, della comunicazione e della latenza. La prova più evidente è il decoding a contesto lungo, dove la stima approssimativa della KV cache è:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batch
Per FP16/BF16, il valore di bytes_per_elem è 2. Ad esempio, con una forma tipica ( L=32, H=4096, batch=1), 8K token sono ~4 GB di KV, mentre 128K token sono ~64 GB, quindi anche se il compute resta ragionevole, la memoria potrebbe comunque esplodere e diventi limitato dalla banda.
Ecco perché le ottimizzazioni pratiche per l’inferenza puntano a ridurre lo spostamento di memoria usando tecniche come quantizzazione della KV cache, KV paginata ed eviction, kernel di attenzione efficienti (famiglia FlashAttention), batching continuo e shape bucketing, e parallelismo attento alla comunicazione.
L’obiettivo è mantenere i guadagni prestazionali senza pagare una tassa nascosta in letture/scritture di memoria e sincronizzazione.
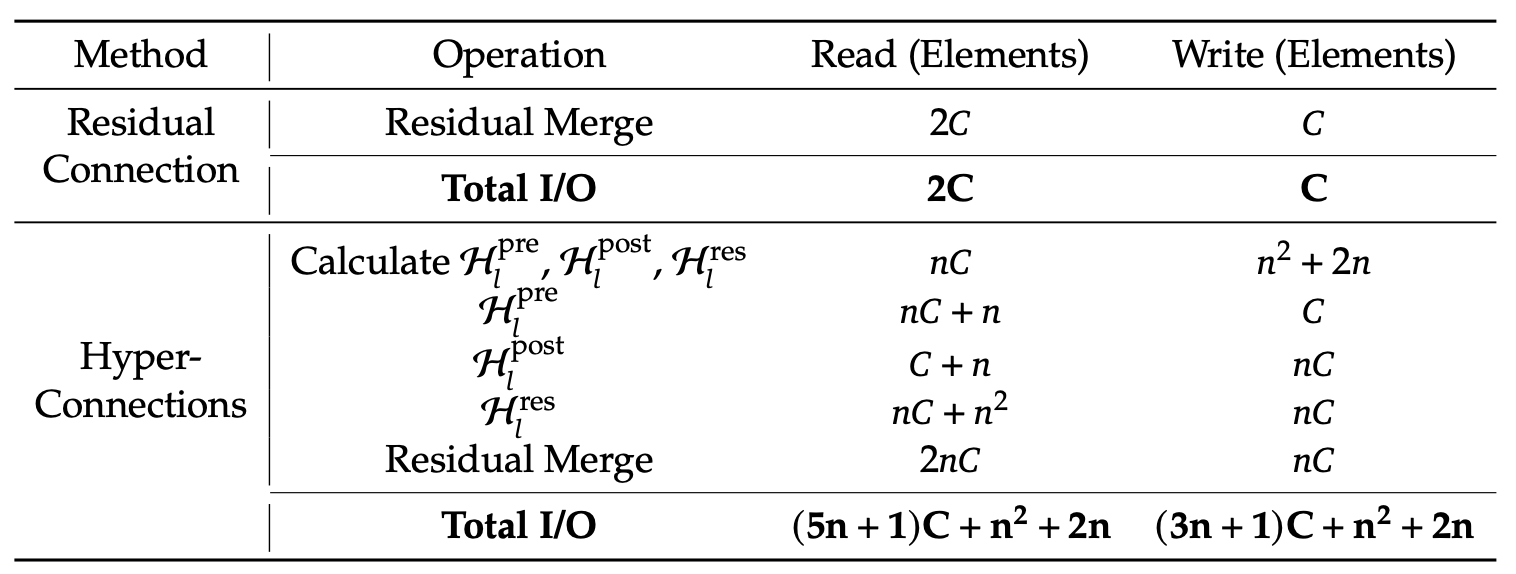
Tabella 1: Confronto dei costi di accesso alla memoria per token (paper mHC)
DeepSeek riporta che mHC supera costantemente il baseline e sorpassa HC nella maggior parte dei benchmark per modelli da 27B, inclusi +2,1% su BBH e +2,3% su DROP rispetto a HC. Questo mostra che mHC si traduce in risultati migliori su larga scala.
Conclusione
La lezione chiave di questo paper è che scalare gli LLM non è solo un problema di FLOP; è anche un problema di stabilità e di sistemi. Le Hyper-Connections (HC) aumentano la capacità del modello espandendo il flusso residuo e consentendo a più flussi di mescolarsi, ma a grandi profondità questo mixing si compone in una mappatura che può deviare significativamente da un percorso identità, portando a esplosione/estinzione di segnali/gradienti e crash dell’addestramento.
mHC risolve questo problema mettendo dei binari al mixing, vincolando la matrice di mixing residuo a essere doppiamente stocastica (non negativa, righe/colonne sommano a 1), imposta via Sinkhorn–Knopp, così che il percorso residuo si comporti come una media pesata controllata e rimanga stabile anche quando impili molti livelli.
DeepSeek tratta anche l’efficienza runtime come parte del metodo. Ha utilizzato la fusione dei kernel per ridurre le letture/scritture da memoria ad alta banda e la ricomputazione selettiva per minimizzare la memoria delle attivazioni.
Inoltre, ha esteso DualPipe per sovrapporre comunicazione e calcolo, assicurando che gli stalli della pipeline non annullino i guadagni. Il risultato è non solo un addestramento più stabile, ma anche prestazioni downstream migliori su larga scala.
Se vuoi approfondire lo sviluppo di applicazioni LLM, ti consiglio di dare un’occhiata al corso Developing LLM Applications with LangChain.







L’mHC di DeepSeek (Manifold-Constrained Hyper-Connections) affronta un problema che la maggior parte dei team incontra quando scala gli LLM: puoi continuare ad aggiungere GPU, ma a un certo punto l’addestramento diventa instabile e il throughput smette di migliorare.
Ecco l’idea centrale:
Le Hyper-Connections migliorano connettività e capacità, ma le Manifold-Constrained Hyper-Connections (mHC) rendono questo upgrade stabile e scalabile, senza ignorare i veri colli di bottiglia come banda di memoria e comunicazione.
Se vuoi approfondire alcuni dei principi trattati in questo tutorial, ti consiglio di dare un’occhiata al corso Transformer Models with PyTorch e al corso Deep Learning with PyTorch.
Cos’è mHC? Dalle connessioni residuali alle Hyper-Connections
In questa sezione, spiegherò perché serve andare oltre le semplici connessioni residuali, come le HC hanno provato a risolvere il problema e perché mHC è la soluzione che rende l’idea funzionale alla scala degli LLM.
Figura 1: Illustrazioni dei paradigmi di connessioni residuali (paper mHC)
Le connessioni residuali (Figura a) forniscono a ogni livello un collegamento identità, consentendo a segnali e gradienti di fluire senza intoppi attraverso reti molto profonde.
DeepSeek ha usato esplicitamente questo principio di mappatura identità come punto di partenza per il paper mHC. Il rovescio della medaglia è che un semplice percorso residuo è anche troppo restrittivo e non consente molto scambio d’informazioni all’interno del flusso residuo.
Le Hyper-Connections (HC) (Figura b) sono state il passo successivo naturale: invece di un solo flusso residuo, si espandono in n flussi paralleli e aggiungono mappature pre/post/residuali apprendibili in modo che i flussi possano mescolarsi e condividere informazioni. Questo aumenta l’espressività senza necessariamente far esplodere i FLOP per livello.
Ma su larga scala, le HC incontrano due grossi problemi. Primo, poiché i flussi si mescolano liberamente a ogni livello, quei piccoli mixing si sommano man mano che si va più in profondità. Dopo molti livelli, la rete può smettere di comportarsi come una pulita “skip connection” e segnali o gradienti possono esplodere o attenuarsi, rendendo l’addestramento instabile. Secondo, anche se i calcoli extra sono semplici, il costo hardware cresce rapidamente.
Le Manifold-Constrained Hyper-Connections (mHC) (Figura c) mantengono la connettività aggiuntiva delle HC, ma rendono l’addestramento sicuro come in un ResNet.
L’idea principale è che, invece di lasciare che i flussi residuali si mescolino in qualunque modo, mHC impone regole rigide al mixing. Nel paper, ciò avviene trasformando la matrice di mixing in una “media pesata” ben comportata, usando una procedura chiamata Sinkhorn–Knopp. Il risultato è che, anche dopo molti livelli, il mixing rimane stabile e segnali e gradienti non esplodono né svaniscono.
In breve, siamo passati dalle connessioni residuali alle mHC perché volevamo un flusso d’informazione più ricco rispetto a un singolo percorso di skip.
Concetti chiave di mHC
A livello alto, mHC mantiene il mixing multi-stream delle Hyper-Connections, ma mette binari rigidi al mixing in modo che si comporti come un percorso di skip stabile in stile ResNet anche quando impiliamo centinaia di livelli.
Gli autori vincolano la matrice di mixing residuo
Hlrescosì che resti ben comportata in profondità, pur consentendo lo scambio di informazioni tra i flussi.In concreto, mHC forza
Hlresa essere doppiamente stocastica, cioè tutte le voci sono non negative e ogni riga e ogni colonna somma a 1. Questo fa sì che il flusso residuo si comporti come una media pesata controllata.Questo evidenzia che la mappatura è non espansiva (norma spettrale limitata a 1), resta stabile quando moltiplicata attraverso i livelli (chiusura per moltiplicazione) e ha un mixing intuitivo come media/permutazione, interpretabile via il poliedro di Birkhoff. Vincola anche le mappature pre/post a essere non negative per evitare la cancellazione del segnale.
Figura 2: Stabilità della propagazione delle Manifold-Constrained Hyper-Connections (paper mHC)
A livello di implementazione, il paper resta pratico calcolando mappature grezze non vincolate
Hlpre,HlposteHlresdallo stato multi-stream del livello corrente (appiattisconoxlper preservare il contesto completo), quindi proiettandole nelle forme vincolate.HlpreeHlpostsono ottenute con un vincolo basato su sigmoid, mentre Hlresè proiettata usando Sinkhorn–Knopp: si esponenziano le voci per renderle positive, poi si alternano normalizzazioni per riga/colonna finché le somme non sono 1.Gli autori riportano anche di aver implementato mHC (con n=4) su larga scala con solo ~6,7% di overhead in tempo di addestramento, principalmente riducendo aggressivamente il traffico di memoria. Hanno riordinato le parti di RMSNorm per efficienza, usato la fusione di kernel (inclusa l’implementazione delle iterazioni di Sinkhorn in un singolo kernel con backward personalizzato), fuso l’applicazione di
HlposteHlrescon il merge residuo per ridurre letture/scritture, usato ricomputazioni selettive per evitare di memorizzare grandi attivazioni intermedie e sovrapposto la comunicazione in uno scheduling DualPipe esteso per nascondere la latenza tra stadi della pipeline.Ottimizzare mHC: tecniche di sistema
La sola stabilità non basta. Se mHC aggiunge troppo traffico di memoria o comunicazione GPU-to-GPU, perdiamo in throughput. Perciò gli autori hanno affiancato al metodo mHC un set di ottimizzazioni infrastrutturali pensate per restare amiche della “memory wall”.
Figura 3: Sovrapposizione comunicazione-calcolo per mHC (paper mHC)
Fusione dei kernel per ridurre letture/scritture di memoria
Gli autori accelerano mHC fondendo diversi passaggi in un unico kernel GPU. Invece di applicare
Hlpost,Hlrese poi fare il merge nel flusso residuo come passate separate (che costringono la GPU a scrivere tensori intermedi in memoria e rileggerli), eseguono queste operazioni in un’unica passata.Questo riduce sensibilmente il traffico di memoria. Il kernel ora legge circa
(n+1)Cvalori invece di(3n+1)Ce scrive circanCvalori invece di3nC. Qui,Cè la dimensione nascosta (feature per flusso) enè il numero di flussi residuali, quindinCè la dimensione dello stato residuo ampliato. Meno letture/scritture significa meno dati che si spostano da e verso la memoria.Il paper suggerisce anche di implementare la maggior parte dei kernel usando TileLang per sfruttare meglio la banda di memoria.
Ricomputazione per controllare la memoria delle attivazioni
Il multi-stream di mHC aumenta la quantità di attivazioni intermedie che normalmente dovresti memorizzare per il backprop, cosa che può saturare la memoria GPU e costringere a batch più piccoli o a checkpointing più aggressivo.
Per evitarlo, il paper suggerisce un trucco semplice: non archiviare gli intermedi di mHC dopo il forward pass. Invece, ricomputa i kernel leggeri di mHC durante il backward pass, evitando però la ricomputazione del costoso livello Transformer F.
Questo riduce la pressione sulla memoria e aiuta a mantenere un throughput effettivo più alto. Un vincolo pratico è che questi blocchi di ricomputazione dovrebbero allinearsi con i confini degli stadi di pipeline; altrimenti lo scheduling della pipeline diventa complicato.
Scheduling consapevole della comunicazione con overlap DualPipe
Su larga scala, il parallelismo a pipeline è comune, ma il design a n flussi di mHC aumenta la quantità di dati che devono attraversare i confini degli stadi, il che può aggiungere rallentamenti di comunicazione percepibili.
DeepSeek ottimizza estendendo DualPipe in modo che comunicazione e calcolo si sovrappongano ai confini della pipeline. Ciò significa che le GPU svolgono lavoro utile mentre avvengono i trasferimenti, invece di restare inattive in attesa del completamento di invii/ricezioni. Eseguono anche alcuni kernel su uno stream di calcolo ad alta priorità, così il calcolo non blocca i progressi della comunicazione. Il risultato è che il costo di comunicazione extra di mHC è in parte nascosto, migliorando l’efficienza dell’addestramento end-to-end
Hot spot
Anche se non implementiamo mHC, l’impostazione di DeepSeek è un buon modo per individuare dove il sistema perde davvero tempo.
KV cache e traffico di memoria
Anche se mHC è principalmente un’idea per l’addestramento, la lezione centrale del paper si applica direttamente all’inferenza. Il paper si concentra sull’ottimizzazione non solo dei FLOP, ma anche del traffico di memoria, della comunicazione e della latenza. La prova più evidente è il decoding a contesto lungo, dove la stima approssimativa della KV cache è:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batchPer FP16/BF16, il valore di
bytes_per_elemè 2. Ad esempio, con una forma tipica ( L=32, H=4096, batch=1), 8K token sono ~4 GB di KV, mentre 128K token sono ~64 GB, quindi anche se il compute resta ragionevole, la memoria potrebbe comunque esplodere e diventi limitato dalla banda.Ecco perché le ottimizzazioni pratiche per l’inferenza puntano a ridurre lo spostamento di memoria usando tecniche come quantizzazione della KV cache, KV paginata ed eviction, kernel di attenzione efficienti (famiglia FlashAttention), batching continuo e shape bucketing, e parallelismo attento alla comunicazione.
L’obiettivo è mantenere i guadagni prestazionali senza pagare una tassa nascosta in letture/scritture di memoria e sincronizzazione.
Tabella 1: Confronto dei costi di accesso alla memoria per token (paper mHC)
DeepSeek riporta che mHC supera costantemente il baseline e sorpassa HC nella maggior parte dei benchmark per modelli da 27B, inclusi +2,1% su BBH e +2,3% su DROP rispetto a HC. Questo mostra che mHC si traduce in risultati migliori su larga scala.
Conclusione
La lezione chiave di questo paper è che scalare gli LLM non è solo un problema di FLOP; è anche un problema di stabilità e di sistemi. Le Hyper-Connections (HC) aumentano la capacità del modello espandendo il flusso residuo e consentendo a più flussi di mescolarsi, ma a grandi profondità questo mixing si compone in una mappatura che può deviare significativamente da un percorso identità, portando a esplosione/estinzione di segnali/gradienti e crash dell’addestramento.
mHC risolve questo problema mettendo dei binari al mixing, vincolando la matrice di mixing residuo a essere doppiamente stocastica (non negativa, righe/colonne sommano a 1), imposta via Sinkhorn–Knopp, così che il percorso residuo si comporti come una media pesata controllata e rimanga stabile anche quando impili molti livelli.
DeepSeek tratta anche l’efficienza runtime come parte del metodo. Ha utilizzato la fusione dei kernel per ridurre le letture/scritture da memoria ad alta banda e la ricomputazione selettiva per minimizzare la memoria delle attivazioni.
Inoltre, ha esteso DualPipe per sovrapporre comunicazione e calcolo, assicurando che gli stalli della pipeline non annullino i guadagni. Il risultato è non solo un addestramento più stabile, ma anche prestazioni downstream migliori su larga scala.
Se vuoi approfondire lo sviluppo di applicazioni LLM, ti consiglio di dare un’occhiata al corso Developing LLM Applications with LangChain.