DeepSeek की mHC (Manifold-Constrained Hyper-Connections) उस समस्या को संबोधित करती है जिसका सामना अधिकतर टीमें LLMs को स्केल करते समय करती हैं: आप GPU जोड़ते रह सकते हैं, लेकिन एक बिंदु के बाद प्रशिक्षण अस्थिर हो जाता है और थ्रूपुट में सुधार रुक जाता है।
मुख्य विचार यह है:
- बड़े पैमाने पर वास्तविक सीमाएं अक्सर मेमोरी बैंडविड्थ, GPU-से-GPU संचार, और लेटेंसी ओवरहेड होती हैं।
- Hyper-Connections (HC) पर-लेयर FLOPs को बहुत अधिक बढ़ाए बिना समृद्ध रेजिडुअल पाथ्स के जरिए सूचना प्रवाह की अनुमति देकर मॉडल क्षमता बढ़ाने की कोशिश करती हैं। लेकिन यह अतिरिक्त मिक्सिंग उस “पहचान शॉर्टकट” को तोड़ सकती है जिसने शुरू में रेजिडुअल नेटवर्क्स को स्थिर बनाया था, जिससे प्रशिक्षण बिगड़ सकता है।
- mHC इसे इस तरह ठीक करती है कि उन रेजिडुअल पाथ्स की मिक्सिंग पर बाधाएं लगाई जाएं। रेजिडुअल मिक्सिंग को एक सुसंगत भारित औसत (डबल्ली स्टोकेस्टिक मैट्रिक्स, जिसे Sinkhorn–Knopp के जरिए लागू किया जाता है) जैसा व्यवहार करने के लिए बाध्य किया जाता है, जो सिग्नल और ग्रेडियंट्स को फटने या खत्म होने से रोकता है।
Hyper-Connections कनेक्टिविटी और क्षमता में सुधार करती हैं, लेकिन Manifold-Constrained Hyper-Connections (mHCs) उस अपग्रेड को स्थिर और स्केलेबल बनाती हैं, बिना मेमोरी बैंडविड्थ और संचार जैसी वास्तविक बाधाओं की अनदेखी किए।
यदि आप इस ट्यूटोरियल में शामिल कुछ सिद्धांतों के बारे में और जानने के इच्छुक हैं, तो मैं यह सुझाव देता/देती हूँ कि Transformer Models with PyTorch कोर्स और Deep Learning with PyTorch कोर्स देखें।
mHC क्या है? रेजिडुअल कनेक्शंस से हाइपर-कनेक्शंस तक
इस भाग में, मैं बताऊंगा/बताऊंगी कि साधारण रेजिडुअल कनेक्शंस से आगे बढ़ने की जरूरत क्यों है, HC ने इसे कैसे सुलझाने की कोशिश की, और mHC क्यों वह समाधान है जो LLM स्केल पर इस विचार को कारगर बनाता है।
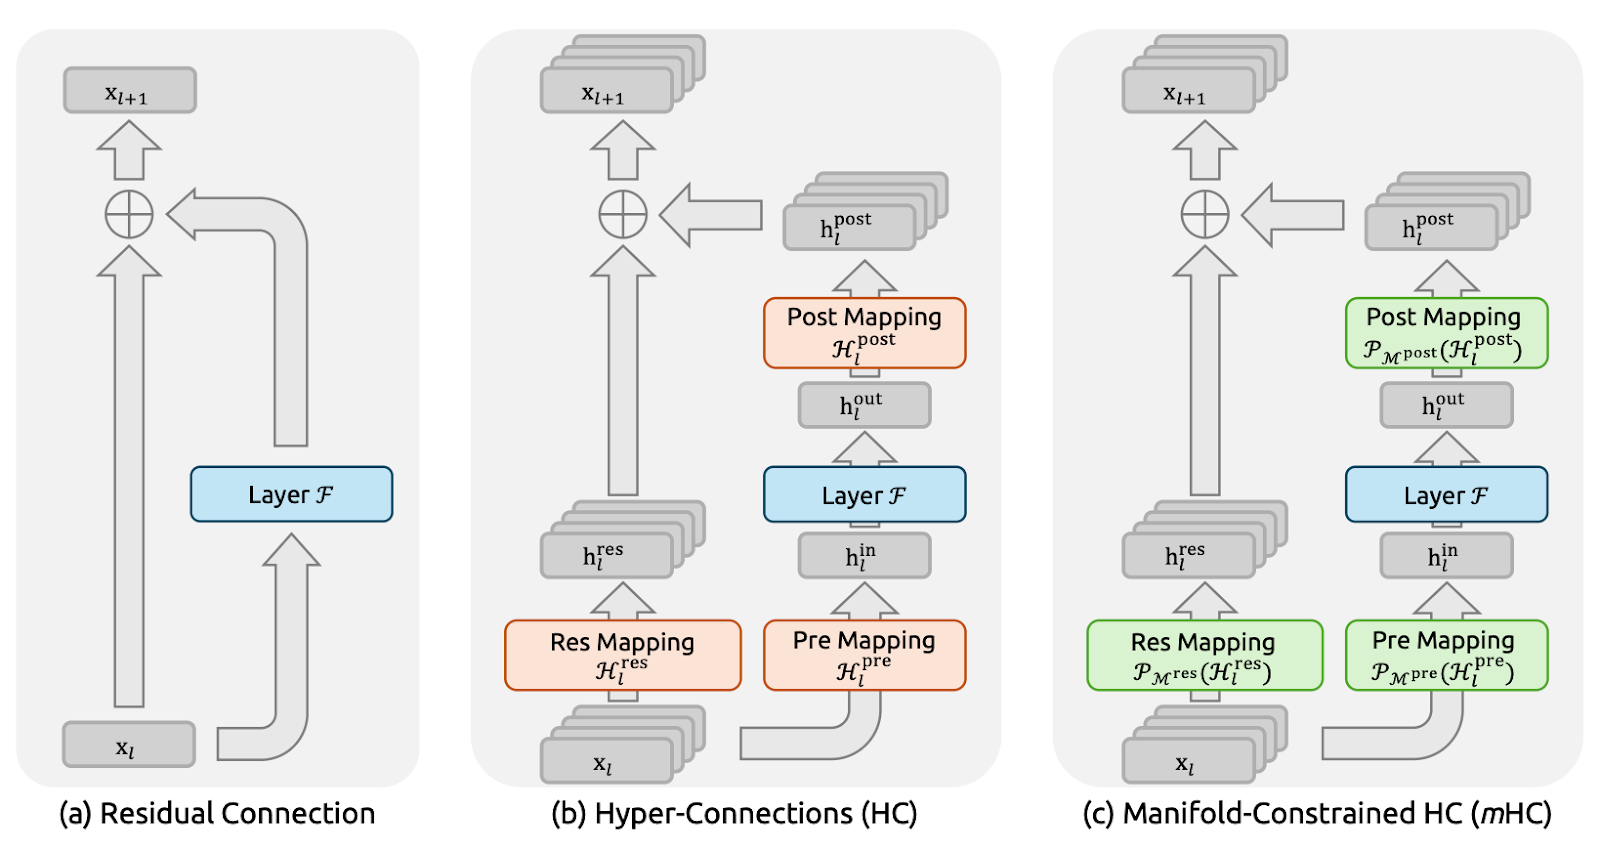
चित्र 1: रेजिडुअल कनेक्शन प्रतिमानों के आरेख (mHC पेपर)
रेजिडुअल कनेक्शंस (चित्र a) प्रत्येक लेयर को एक पहचान शॉर्टकट देते हैं, जिससे सिग्नल और ग्रेडियंट बहुत गहरे नेटवर्क्स के माध्यम से साफ-सुथरे ढंग से प्रवाहित हो पाते हैं।
DeepSeek ने mHC पेपर के लिए शुरुआती बिंदु के रूप में स्पष्ट रूप से इस आइडेंटिटी मैपिंग सिद्धांत का उपयोग किया। कमी यह है कि साधारण रेजिडुअल पाथ भी बहुत प्रतिबंधात्मक होता है, इसलिए यह रेजिडुअल स्ट्रीम के भीतर अधिक सूचना विनिमय की अनुमति नहीं देता।
हालांकि Hyper-Connections (HC) (चित्र b) स्वाभाविक अगला कदम थीं, जो एक रेजिडुअल स्ट्रीम के बजाय n समानांतर स्ट्रीम्स में विस्तार करती हैं और सीखने योग्य प्री/पोस्ट/रेजिडुअल मैपिंग जोड़ती हैं ताकि स्ट्रीम्स आपस में मिल सकें और जानकारी साझा कर सकें। इससे परत-दर-परत FLOPs को अनिवार्य रूप से बढ़ाए बिना अभिव्यक्ति-क्षमता बढ़ती है।
लेकिन बड़े पैमाने पर, HC दो बड़ी समस्याओं में फंसती है। पहली, क्योंकि स्ट्रीम्स हर लेयर पर स्वतंत्र रूप से मिलती हैं, वे छोटी-छोटी मिक्सिंग गहराई में जाने पर जमा होती जाती हैं। कई लेयर्स के बाद, नेटवर्क एक साफ “स्किप कनेक्शन” जैसा व्यवहार करना बंद कर सकता है, और सिग्नल या ग्रेडियंट फट सकते हैं या मंद पड़ सकते हैं, जिससे प्रशिक्षण अस्थिर हो जाता है। दूसरी, भले ही अतिरिक्त गणनाएं सरल हों, हार्डवेयर लागत तेजी से बढ़ती है।
Manifold-Constrained Hyper-Connections (mHC) (चित्र c) HC की अतिरिक्त कनेक्टिविटी को बनाए रखती है, लेकिन इसे ResNet की तरह सुरक्षित रूप से प्रशिक्षित करने योग्य बनाती है।
मुख्य विचार यह है कि रेजिडुअल स्ट्रीम्स को किसी भी तरह से मिलने देने के बजाय, mHC मिक्सिंग को कड़े नियमों का पालन करने के लिए बाध्य करती है। पेपर में, यह मिक्सिंग मैट्रिक्स को एक सुसंगत “भारित औसत” में बदलकर करती है, जिसे Sinkhorn–Knopp नामक प्रक्रिया से लागू किया जाता है। परिणाम यह है कि कई लेयर्स के बाद भी मिक्सिंग स्थिर रहती है, और सिग्नल व ग्रेडियंट न तो फटते हैं और न ही लुप्त होते हैं।
संक्षेप में, हम रेजिडुअल कनेक्शंस से mHC तक इसलिए आए क्योंकि हमें एक अकेले स्किप पाथ के बजाय और समृद्ध सूचना प्रवाह चाहिए था।
mHC के प्रमुख सिद्धांत
ऊंचे स्तर पर, mHC Hyper-Connection की मल्टी-स्ट्रीम मिक्सिंग को रखती है, लेकिन उस मिक्सिंग पर कड़े गार्डरेल लगाती है ताकि यह सैकड़ों लेयर्स पर भी एक स्थिर, ResNet-शैली स्किप पाथ जैसा व्यवहार करे।
लेखक रेजिडुअल मिक्सिंग मैट्रिक्स Hlres को इस तरह बाध्य करते हैं कि यह गहराई के साथ सुसंगत बना रहे, जबकि स्ट्रीम्स को जानकारी का आदान-प्रदान करने दे।
ठोस रूप से, mHC Hlres को डबल्ली स्टोकेस्टिक होने के लिए बाध्य करती है, यानी सभी प्रविष्टियां गैर-ऋणात्मक हों, और प्रत्येक पंक्ति तथा प्रत्येक स्तम्भ का योग 1 हो। इससे रेजिडुअल स्ट्रीम नियंत्रित भारित औसत की तरह कार्य करती है।
यह दर्शाता है कि मैपिंग नॉन-एक्सपैंसिव है (स्पेक्ट्रल नॉर्म 1 से बंधा हुआ), लेयर्स में गुणा होने पर स्थिर रहती है (मल्टिप्लिकेशन के तहत क्लोजर), और Birkhoff polytope के जरिए औसतीकरण/परम्यूटेशन-ब्लेंडिंग के सहज अर्थ में मिक्सिंग की व्याख्या देती है। यह सिग्नल कैंसलेशन से बचने के लिए प्री/पोस्ट मैपिंग्स को भी गैर-ऋणात्मक होने तक सीमित करता है।
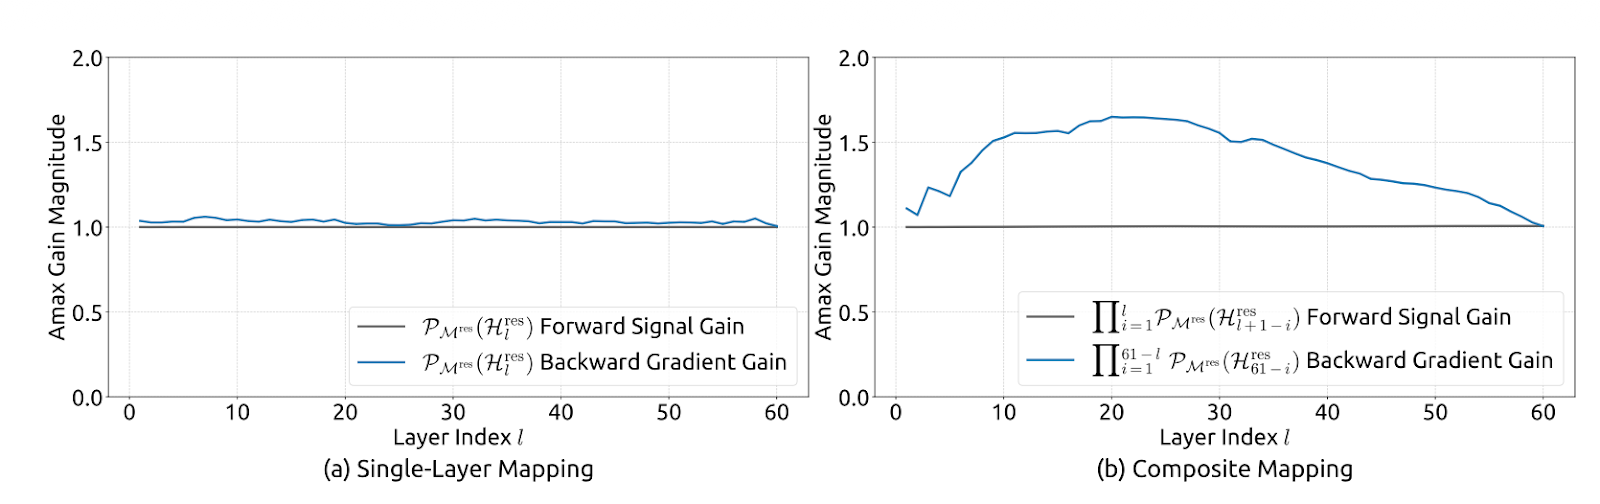
चित्र 2: Manifold-Constrained Hyper-Connections की प्रसार स्थिरता (mHC पेपर)
इम्प्लीमेंटेशन के लिहाज से, पेपर इसे व्यावहारिक रखता है: वर्तमान लेयर की मल्टी-स्ट्रीम स्टेट से बिना-बाधा वाली रॉ मैपिंग्स Hlpre, Hlpost, और Hlres की गणना करता है (वे पूर्ण संदर्भ बनाए रखने के लिए xl को फ्लैटन करते हैं), फिर उन्हें बाधित स्वरूपों में प्रोजेक्ट करता है। Hlpre और Hlpost सिग्मॉइड-आधारित बाधा से प्राप्त किए जाते हैं, जबकि Hlres को Sinkhorn–Knopp के जरिए प्रोजेक्ट किया जाता है—एंट्रियों को धनात्मक बनाने के लिए एक्सपोनेंशिएट, फिर पंक्ति/स्तम्भ सामान्यीकरण बारी-बारी से जब तक योग 1 न हो जाए।
लेखक यह भी रिपोर्ट करते हैं कि mHC (n=4 के साथ) को स्केल पर केवल ~6.7% प्रशिक्षण-समय ओवरहेड के साथ लागू किया गया, मुख्यतः मेमोरी ट्रैफ़िक को आक्रामक रूप से घटाकर। उन्होंने दक्षता के लिए RMSNorm के हिस्सों का क्रम बदला, कर्नेल फ्यूज़न किया (जिसमें कस्टम बैकवर्ड के साथ एक ही कर्नेल में Sinkhorn iterations लागू करना शामिल है), रेजिडुअल मर्ज के साथ Hlpost और Hlres के अनुप्रयोग को फ्यूज़ किया ताकि रीड/राइट कम हों, बड़े इंटरमीडिएट एक्टिवेशंस को स्टोर करने से बचने के लिए चयनात्मक रिकम्प्यूटिंग का उपयोग किया, और पाइपलाइन-स्टेज लेटेंसी छिपाने के लिए विस्तारित DualPipe शेड्यूल में संचार को ओवरलैप किया।
mHC का अनुकूलन: सिस्टम्स तकनीकें
सिर्फ स्थिरता पर्याप्त नहीं है। यदि mHC बहुत अधिक मेमोरी ट्रैफ़िक या GPU-से-GPU संचार जोड़ती है, तो हमारा थ्रूपुट घटेगा। इसलिए लेखकों ने mHC पद्धति को ऐसे इन्फ्रास्ट्रक्चर अनुकूलनों के साथ जोड़ा जो मेमोरी वॉल के प्रति अनुकूल रहें।
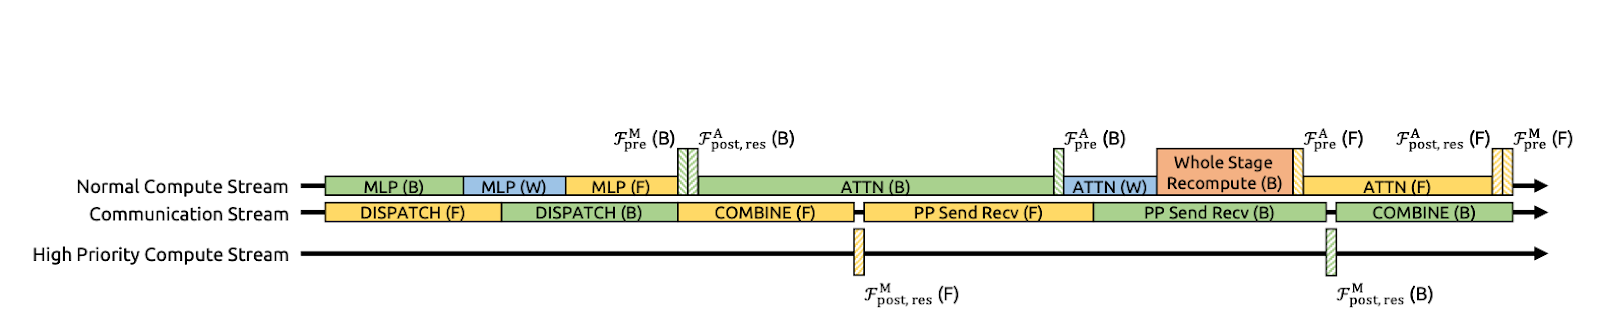
चित्र 3: mHC के लिए संचार-गणना ओवरलैपिंग (mHC पेपर)
मेमोरी रीड/राइट घटाने के लिए कर्नेल फ्यूज़न
लेखकों ने कई चरणों को एक GPU कर्नेल में फ्यूज़ करके mHC को तेज किया। Hlpost, Hlres लागू करने और फिर रेजिडुअल स्ट्रीम में मर्ज करने के बजाय (जो GPU को इंटरमीडिएट टेन्सर्स को मेमोरी में लिखने और फिर पढ़ने पर मजबूर करता), वे इन ऑपरेशंस को एक ही पास में करते हैं।
इससे मेमोरी ट्रैफ़िक में काफी कमी आती है। अब कर्नेल लगभग (n+1)C मान पढ़ता है, जबकि पहले (3n+1)C पढ़ता था, और लिखता लगभग nC मान है, पहले के 3nC की बजाय। यहां C हिडन साइज है (प्रति स्ट्रीम फीचर्स) और n रेजिडुअल स्ट्रीम्स की संख्या है, तो nC विस्तृत रेजिडुअल स्टेट का आकार है। कम रीड/राइट का मतलब मेमोरी तक कम डेटा आना-जाना है।
पेपर अधिकांश कर्नेल्स को TileLang का उपयोग करके लागू करने का भी सुझाव देता है ताकि मेमोरी बैंडविड्थ का बेहतर उपयोग हो सके।
एक्टिवेशन मेमोरी नियंत्रित करने के लिए रिकम्प्यूटेशन
मल्टी-स्ट्रीम mHC उन इंटरमीडिएट एक्टिवेशंस की मात्रा बढ़ा देता है जिन्हें सामान्यतः बैकप्रॉप के लिए स्टोर करना पड़ता है, जिससे GPU मेमोरी फूल सकती है और बैच छोटे करने पड़ सकते हैं या अधिक आक्रामक चेकपॉइंटिंग करनी पड़ सकती है।
इसे टालने के लिए, पेपर एक सरल तरकीब सुझाता है: फॉरवर्ड पास के बाद mHC इंटरमीडिएट्स स्टोर न करें। इसके बजाय, बैकवर्ड पास के दौरान हल्के mHC कर्नेल्स को फिर से गणना करें, जबकि महंगे Transformer लेयर F की रिकम्प्यूटेशन से बचें।
यह मेमोरी दबाव को घटाता है और उच्च प्रभावी थ्रूपुट बनाए रखने में मदद करता है। एक व्यावहारिक बाधा यह है कि ये रिकम्प्यूटेशन ब्लॉक्स पाइपलाइन स्टेज सीमाओं के साथ संरेखित होने चाहिए; अन्यथा, पाइपलाइन शेड्यूलिंग जटिल हो जाती है।
DualPipe ओवरलैप के साथ संचार-सचेत शेड्यूलिंग
बड़े पैमाने पर पाइपलाइन पैरेललिज़्म आम है, लेकिन mHC की n-स्ट्रीम डिज़ाइन स्टेज सीमाओं को पार करने वाले डेटा की मात्रा बढ़ा देती है, जो संचार में उल्लेखनीय रुकावटें जोड़ सकती है।
DeepSeek इसे DualPipe का विस्तार करके अनुकूलित करता है ताकि पाइपलाइन सीमाओं पर संचार और गणना ओवरलैप हों। इसका मतलब है कि GPU ट्रांसफर्स के दौरान भी उपयोगी कार्य करते हैं, send/receive के खत्म होने का इंतजार करते हुए निष्क्रिय नहीं बैठते। वे कुछ कर्नेल्स को हाई-प्रायोरिटी कंप्यूट स्ट्रीम पर भी चलाते हैं, ताकि कंप्यूट संचार की प्रगति को न रोके। परिणामस्वरूप mHC से हुई अतिरिक्त संचार लागत आंशिक रूप से छिप जाती है, और एंड-टू-एंड प्रशिक्षण दक्षता में सुधार होता है।
हॉट स्पॉट्स
भले ही हम mHC लागू न करें, DeepSeek का फ्रेमिंग यह पहचानने का अच्छा तरीका है कि सिस्टम वास्तव में कहां समय खो रहा है।
- लॉन्ग-कॉन्टेक्स्ट वर्कलोड्स: लंबे प्रॉम्प्ट्स प्रीफिल को महंगा बनाते हैं क्योंकि अटेंशन को मेमोरी के जरिए बहुत सारा डेटा स्थानांतरित करना पड़ता है। डिकोड के दौरान KV कैश बढ़ता रहता है, जिससे प्रति टोकन मेमोरी रीड्स बढ़ती हैं। साथ में, ये मेमोरी बैंडविड्थ सीमाओं को धकेलते हैं और अक्सर फ्रैगमेंटेशन या अक्षम बैचिंग का कारण बनते हैं।
- MoE रूटिंग और एक्सपर्ट पैरेललिज़्म: Mixture of Experts (MoE) में लागत सिर्फ कंप्यूट के बारे में नहीं है। यह रूटिंग, टोकन एक्सचेंज, और क्रॉस-GPU संचार के बारे में भी है, जो टोकन को एक्सपर्ट्स तक भेजने और आउटपुट इकट्ठा करने के लिए चाहिए। DeepSeek का DualPipe ओवरलैप, कंप्यूटेशन के पीछे पाइपलाइन संचार को छिपाने पर केंद्रित है, जिसकी MoE को स्केल पर जरूरत होती है।
- मल्टी-टेनेंट और छोटे बैच का ट्रैफ़िक: वास्तविक तैनाती में, अनुरोध साफ-सुथरे बड़े बैचों में नहीं आते। हमें छोटे, असंगत बैच, मिश्रित सीक्वेंस लंबाइयां, और कमजोर कैश पुन: उपयोग मिलता है। इससे बैचिंग दक्षता घटती है और टेल लेटेंसी बढ़ती है, इसलिए मेमोरी बैंडविड्थ और शेड्यूलिंग बाधा बन जाते हैं।
KV कैश और मेमोरी ट्रैफ़िक
यद्यपि mHC मुख्यतः एक प्रशिक्षण विचार है, पेपर का मूल सबक सीधे इंफेरेंस पर लागू होता है। पेपर केवल FLOPs के लिए नहीं, बल्कि मेमोरी ट्रैफ़िक, संचार, और लेटेंसी के लिए भी अनुकूलन पर केंद्रित है। सबसे बड़ा प्रमाण लॉन्ग-कॉन्टेक्स्ट डिकोडिंग है, जहां KV-कैश का मोटा अनुमान यह है:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batch
FP16/BF16 के लिए, bytes_per_elem का मान 2 होता है। उदाहरण के लिए, एक सामान्य आकार ( L=32, H=4096, batch=1) के साथ, 8K टोकन ~4 GB KV है, जबकि 128K टोकन ~64 GB है, तो भले ही कंप्यूट उचित रहे, मेमोरी फिर भी फूल सकती है, और आप बैंडविड्थ-बाउंड हो जाते हैं।
इसीलिए व्यवहारिक इंफेरेंस अनुकूलन KV कैश क्वांटाइज़ेशन, पेज्ड KV और इविक्शन, कुशल अटेंशन कर्नेल्स (FlashAttention-परिवार), कंटीन्यूअस बैचिंग और शेप बकेटिंग, तथा संचार-सचेत पैरेललिज़्म जैसी तकनीकों से मेमोरी मूवमेंट घटाने पर केंद्रित होते हैं।
उद्देश्य यह है कि प्रदर्शन लाभ बने रहें, बिना मेमोरी रीड्स/राइट्स और समन्वय में छुपा हुआ कर चुकाए।
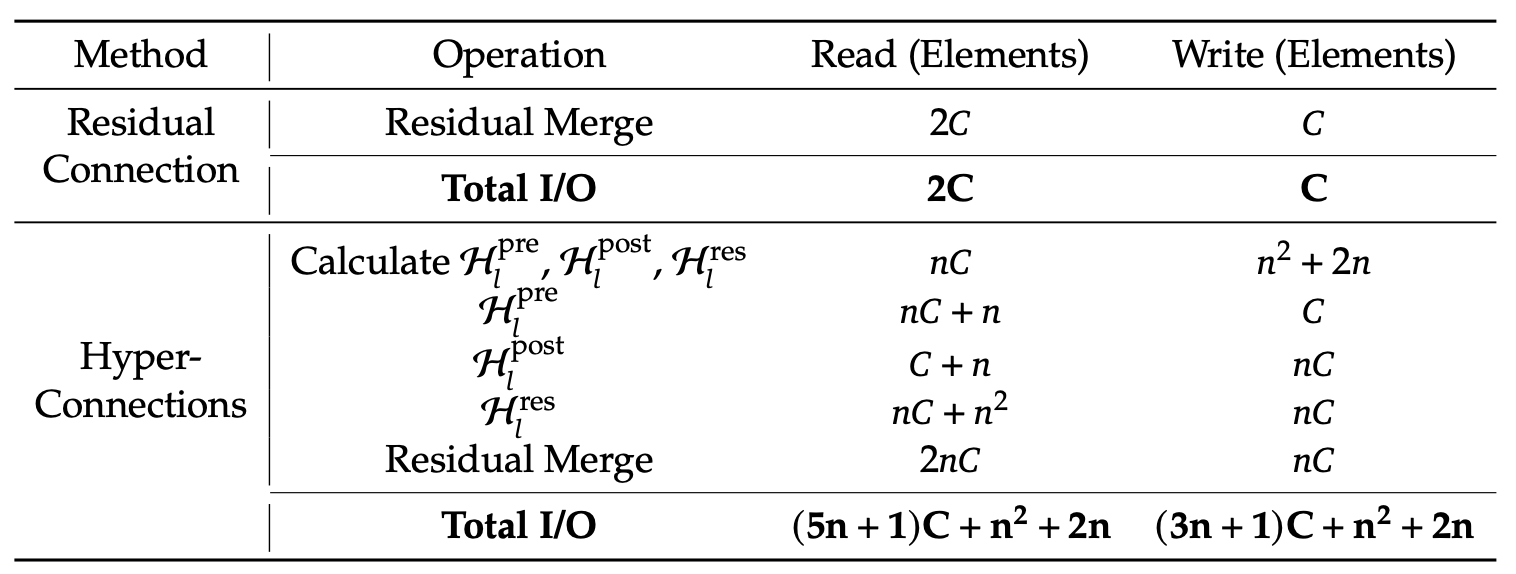
तालिका 1: प्रति टोकन मेमोरी एक्सेस लागत की तुलना (mHC पेपर)
DeepSeek रिपोर्ट करता है कि mHC लगातार बेसलाइन से बेहतर प्रदर्शन करता है और 27B मॉडलों के अधिकांश बेंचमार्क्स पर HC से आगे निकलता है, जिनमें HC की तुलना में BBH पर +2.1% और DROP पर +2.3% शामिल हैं। यह दिखाता है कि mHC स्केल पर बेहतर परिणामों में तब्दील होता है।
निष्कर्ष
इस पेपर से मुख्य सीख यह है कि LLMs का स्केलिंग केवल FLOPs की समस्या नहीं है; यह समान रूप से स्थिरता और सिस्टम्स की समस्या भी है। Hyper-Connections (HC) रेजिडुअल स्ट्रीम का विस्तार करके और कई स्ट्रीम्स को मिलाने देकर मॉडल क्षमता बढ़ाती हैं, लेकिन बड़ी गहराई पर यह मिक्सिंग एक समग्र मैपिंग में बदल जाती है जो आइडेंटिटी पाथ से काफी भटक सकती है, जिससे सिग्नल/ग्रेडियंट फटना या गायब होना और प्रशिक्षण का बिगड़ना हो सकता है।
mHC इसे रेजिडुअल मिक्सिंग मैट्रिक्स को डबल्ली स्टोकेस्टिक (गैर-ऋणात्मक, पंक्तियों/स्तम्भों का योग 1) तक सीमित करके—जो Sinkhorn–Knopp के जरिए लागू होता है—गार्डरेल्स लगा कर ठीक करती है, ताकि रेजिडुअल पाथ नियंत्रित भारित औसत जैसा व्यवहार करे और कई लेयर्स स्टैक करने पर भी स्थिर रहे।
DeepSeek रनटाइम दक्षता को भी पद्धति का हिस्सा मानता है। उन्होंने हाई-बैंडविड्थ मेमोरी रीड्स/राइट्स घटाने के लिए कर्नेल फ्यूज़न का उपयोग किया, और एक्टिवेशन मेमोरी को न्यूनतम करने के लिए चयनात्मक रिकम्प्यूटेशन का सहारा लिया।
इसके अलावा, उन्होंने DualPipe का विस्तार किया ताकि संचार और गणना ओवरलैप हों, सुनिश्चित करते हुए कि पाइपलाइन स्टॉल्स लाभ को समाप्त न करें। परिणामस्वरूप न केवल अधिक स्थिर प्रशिक्षण मिलता है, बल्कि स्केल पर बेहतर डाउनस्ट्रीम प्रदर्शन भी मिलता है।
यदि आप LLM एप्लिकेशन डेवलपमेंट के बारे में और जानना चाहते हैं, तो Developing LLM Applications with LangChain कोर्स अवश्य देखें।


DeepSeek की mHC (Manifold-Constrained Hyper-Connections) उस समस्या को संबोधित करती है जिसका सामना अधिकतर टीमें LLMs को स्केल करते समय करती हैं: आप GPU जोड़ते रह सकते हैं, लेकिन एक बिंदु के बाद प्रशिक्षण अस्थिर हो जाता है और थ्रूपुट में सुधार रुक जाता है।
मुख्य विचार यह है:
Hyper-Connections कनेक्टिविटी और क्षमता में सुधार करती हैं, लेकिन Manifold-Constrained Hyper-Connections (mHCs) उस अपग्रेड को स्थिर और स्केलेबल बनाती हैं, बिना मेमोरी बैंडविड्थ और संचार जैसी वास्तविक बाधाओं की अनदेखी किए।
यदि आप इस ट्यूटोरियल में शामिल कुछ सिद्धांतों के बारे में और जानने के इच्छुक हैं, तो मैं यह सुझाव देता/देती हूँ कि Transformer Models with PyTorch कोर्स और Deep Learning with PyTorch कोर्स देखें।
mHC क्या है? रेजिडुअल कनेक्शंस से हाइपर-कनेक्शंस तक
इस भाग में, मैं बताऊंगा/बताऊंगी कि साधारण रेजिडुअल कनेक्शंस से आगे बढ़ने की जरूरत क्यों है, HC ने इसे कैसे सुलझाने की कोशिश की, और mHC क्यों वह समाधान है जो LLM स्केल पर इस विचार को कारगर बनाता है।
चित्र 1: रेजिडुअल कनेक्शन प्रतिमानों के आरेख (mHC पेपर)
रेजिडुअल कनेक्शंस (चित्र a) प्रत्येक लेयर को एक पहचान शॉर्टकट देते हैं, जिससे सिग्नल और ग्रेडियंट बहुत गहरे नेटवर्क्स के माध्यम से साफ-सुथरे ढंग से प्रवाहित हो पाते हैं।
DeepSeek ने mHC पेपर के लिए शुरुआती बिंदु के रूप में स्पष्ट रूप से इस आइडेंटिटी मैपिंग सिद्धांत का उपयोग किया। कमी यह है कि साधारण रेजिडुअल पाथ भी बहुत प्रतिबंधात्मक होता है, इसलिए यह रेजिडुअल स्ट्रीम के भीतर अधिक सूचना विनिमय की अनुमति नहीं देता।
हालांकि Hyper-Connections (HC) (चित्र b) स्वाभाविक अगला कदम थीं, जो एक रेजिडुअल स्ट्रीम के बजाय n समानांतर स्ट्रीम्स में विस्तार करती हैं और सीखने योग्य प्री/पोस्ट/रेजिडुअल मैपिंग जोड़ती हैं ताकि स्ट्रीम्स आपस में मिल सकें और जानकारी साझा कर सकें। इससे परत-दर-परत FLOPs को अनिवार्य रूप से बढ़ाए बिना अभिव्यक्ति-क्षमता बढ़ती है।
लेकिन बड़े पैमाने पर, HC दो बड़ी समस्याओं में फंसती है। पहली, क्योंकि स्ट्रीम्स हर लेयर पर स्वतंत्र रूप से मिलती हैं, वे छोटी-छोटी मिक्सिंग गहराई में जाने पर जमा होती जाती हैं। कई लेयर्स के बाद, नेटवर्क एक साफ “स्किप कनेक्शन” जैसा व्यवहार करना बंद कर सकता है, और सिग्नल या ग्रेडियंट फट सकते हैं या मंद पड़ सकते हैं, जिससे प्रशिक्षण अस्थिर हो जाता है। दूसरी, भले ही अतिरिक्त गणनाएं सरल हों, हार्डवेयर लागत तेजी से बढ़ती है।
Manifold-Constrained Hyper-Connections (mHC) (चित्र c) HC की अतिरिक्त कनेक्टिविटी को बनाए रखती है, लेकिन इसे ResNet की तरह सुरक्षित रूप से प्रशिक्षित करने योग्य बनाती है।
मुख्य विचार यह है कि रेजिडुअल स्ट्रीम्स को किसी भी तरह से मिलने देने के बजाय, mHC मिक्सिंग को कड़े नियमों का पालन करने के लिए बाध्य करती है। पेपर में, यह मिक्सिंग मैट्रिक्स को एक सुसंगत “भारित औसत” में बदलकर करती है, जिसे Sinkhorn–Knopp नामक प्रक्रिया से लागू किया जाता है। परिणाम यह है कि कई लेयर्स के बाद भी मिक्सिंग स्थिर रहती है, और सिग्नल व ग्रेडियंट न तो फटते हैं और न ही लुप्त होते हैं।
संक्षेप में, हम रेजिडुअल कनेक्शंस से mHC तक इसलिए आए क्योंकि हमें एक अकेले स्किप पाथ के बजाय और समृद्ध सूचना प्रवाह चाहिए था।
mHC के प्रमुख सिद्धांत
ऊंचे स्तर पर, mHC Hyper-Connection की मल्टी-स्ट्रीम मिक्सिंग को रखती है, लेकिन उस मिक्सिंग पर कड़े गार्डरेल लगाती है ताकि यह सैकड़ों लेयर्स पर भी एक स्थिर, ResNet-शैली स्किप पाथ जैसा व्यवहार करे।
लेखक रेजिडुअल मिक्सिंग मैट्रिक्स
Hlresको इस तरह बाध्य करते हैं कि यह गहराई के साथ सुसंगत बना रहे, जबकि स्ट्रीम्स को जानकारी का आदान-प्रदान करने दे।ठोस रूप से, mHC
Hlresको डबल्ली स्टोकेस्टिक होने के लिए बाध्य करती है, यानी सभी प्रविष्टियां गैर-ऋणात्मक हों, और प्रत्येक पंक्ति तथा प्रत्येक स्तम्भ का योग 1 हो। इससे रेजिडुअल स्ट्रीम नियंत्रित भारित औसत की तरह कार्य करती है।यह दर्शाता है कि मैपिंग नॉन-एक्सपैंसिव है (स्पेक्ट्रल नॉर्म 1 से बंधा हुआ), लेयर्स में गुणा होने पर स्थिर रहती है (मल्टिप्लिकेशन के तहत क्लोजर), और Birkhoff polytope के जरिए औसतीकरण/परम्यूटेशन-ब्लेंडिंग के सहज अर्थ में मिक्सिंग की व्याख्या देती है। यह सिग्नल कैंसलेशन से बचने के लिए प्री/पोस्ट मैपिंग्स को भी गैर-ऋणात्मक होने तक सीमित करता है।
चित्र 2: Manifold-Constrained Hyper-Connections की प्रसार स्थिरता (mHC पेपर)
इम्प्लीमेंटेशन के लिहाज से, पेपर इसे व्यावहारिक रखता है: वर्तमान लेयर की मल्टी-स्ट्रीम स्टेट से बिना-बाधा वाली रॉ मैपिंग्स
Hlpre,Hlpost, औरHlresकी गणना करता है (वे पूर्ण संदर्भ बनाए रखने के लिएxlको फ्लैटन करते हैं), फिर उन्हें बाधित स्वरूपों में प्रोजेक्ट करता है।HlpreऔरHlpostसिग्मॉइड-आधारित बाधा से प्राप्त किए जाते हैं, जबकि Hlresको Sinkhorn–Knopp के जरिए प्रोजेक्ट किया जाता है—एंट्रियों को धनात्मक बनाने के लिए एक्सपोनेंशिएट, फिर पंक्ति/स्तम्भ सामान्यीकरण बारी-बारी से जब तक योग 1 न हो जाए।लेखक यह भी रिपोर्ट करते हैं कि mHC (n=4 के साथ) को स्केल पर केवल ~6.7% प्रशिक्षण-समय ओवरहेड के साथ लागू किया गया, मुख्यतः मेमोरी ट्रैफ़िक को आक्रामक रूप से घटाकर। उन्होंने दक्षता के लिए RMSNorm के हिस्सों का क्रम बदला, कर्नेल फ्यूज़न किया (जिसमें कस्टम बैकवर्ड के साथ एक ही कर्नेल में Sinkhorn iterations लागू करना शामिल है), रेजिडुअल मर्ज के साथ
HlpostऔरHlresके अनुप्रयोग को फ्यूज़ किया ताकि रीड/राइट कम हों, बड़े इंटरमीडिएट एक्टिवेशंस को स्टोर करने से बचने के लिए चयनात्मक रिकम्प्यूटिंग का उपयोग किया, और पाइपलाइन-स्टेज लेटेंसी छिपाने के लिए विस्तारित DualPipe शेड्यूल में संचार को ओवरलैप किया।mHC का अनुकूलन: सिस्टम्स तकनीकें
सिर्फ स्थिरता पर्याप्त नहीं है। यदि mHC बहुत अधिक मेमोरी ट्रैफ़िक या GPU-से-GPU संचार जोड़ती है, तो हमारा थ्रूपुट घटेगा। इसलिए लेखकों ने mHC पद्धति को ऐसे इन्फ्रास्ट्रक्चर अनुकूलनों के साथ जोड़ा जो मेमोरी वॉल के प्रति अनुकूल रहें।
चित्र 3: mHC के लिए संचार-गणना ओवरलैपिंग (mHC पेपर)
मेमोरी रीड/राइट घटाने के लिए कर्नेल फ्यूज़न
लेखकों ने कई चरणों को एक GPU कर्नेल में फ्यूज़ करके mHC को तेज किया।
Hlpost,Hlresलागू करने और फिर रेजिडुअल स्ट्रीम में मर्ज करने के बजाय (जो GPU को इंटरमीडिएट टेन्सर्स को मेमोरी में लिखने और फिर पढ़ने पर मजबूर करता), वे इन ऑपरेशंस को एक ही पास में करते हैं।इससे मेमोरी ट्रैफ़िक में काफी कमी आती है। अब कर्नेल लगभग
(n+1)Cमान पढ़ता है, जबकि पहले(3n+1)Cपढ़ता था, और लिखता लगभगnCमान है, पहले के3nCकी बजाय। यहांCहिडन साइज है (प्रति स्ट्रीम फीचर्स) औरnरेजिडुअल स्ट्रीम्स की संख्या है, तोnCविस्तृत रेजिडुअल स्टेट का आकार है। कम रीड/राइट का मतलब मेमोरी तक कम डेटा आना-जाना है।पेपर अधिकांश कर्नेल्स को TileLang का उपयोग करके लागू करने का भी सुझाव देता है ताकि मेमोरी बैंडविड्थ का बेहतर उपयोग हो सके।
एक्टिवेशन मेमोरी नियंत्रित करने के लिए रिकम्प्यूटेशन
मल्टी-स्ट्रीम mHC उन इंटरमीडिएट एक्टिवेशंस की मात्रा बढ़ा देता है जिन्हें सामान्यतः बैकप्रॉप के लिए स्टोर करना पड़ता है, जिससे GPU मेमोरी फूल सकती है और बैच छोटे करने पड़ सकते हैं या अधिक आक्रामक चेकपॉइंटिंग करनी पड़ सकती है।
इसे टालने के लिए, पेपर एक सरल तरकीब सुझाता है: फॉरवर्ड पास के बाद mHC इंटरमीडिएट्स स्टोर न करें। इसके बजाय, बैकवर्ड पास के दौरान हल्के mHC कर्नेल्स को फिर से गणना करें, जबकि महंगे Transformer लेयर F की रिकम्प्यूटेशन से बचें।
यह मेमोरी दबाव को घटाता है और उच्च प्रभावी थ्रूपुट बनाए रखने में मदद करता है। एक व्यावहारिक बाधा यह है कि ये रिकम्प्यूटेशन ब्लॉक्स पाइपलाइन स्टेज सीमाओं के साथ संरेखित होने चाहिए; अन्यथा, पाइपलाइन शेड्यूलिंग जटिल हो जाती है।
DualPipe ओवरलैप के साथ संचार-सचेत शेड्यूलिंग
बड़े पैमाने पर पाइपलाइन पैरेललिज़्म आम है, लेकिन mHC की n-स्ट्रीम डिज़ाइन स्टेज सीमाओं को पार करने वाले डेटा की मात्रा बढ़ा देती है, जो संचार में उल्लेखनीय रुकावटें जोड़ सकती है।
DeepSeek इसे DualPipe का विस्तार करके अनुकूलित करता है ताकि पाइपलाइन सीमाओं पर संचार और गणना ओवरलैप हों। इसका मतलब है कि GPU ट्रांसफर्स के दौरान भी उपयोगी कार्य करते हैं, send/receive के खत्म होने का इंतजार करते हुए निष्क्रिय नहीं बैठते। वे कुछ कर्नेल्स को हाई-प्रायोरिटी कंप्यूट स्ट्रीम पर भी चलाते हैं, ताकि कंप्यूट संचार की प्रगति को न रोके। परिणामस्वरूप mHC से हुई अतिरिक्त संचार लागत आंशिक रूप से छिप जाती है, और एंड-टू-एंड प्रशिक्षण दक्षता में सुधार होता है।
हॉट स्पॉट्स
भले ही हम mHC लागू न करें, DeepSeek का फ्रेमिंग यह पहचानने का अच्छा तरीका है कि सिस्टम वास्तव में कहां समय खो रहा है।
KV कैश और मेमोरी ट्रैफ़िक
यद्यपि mHC मुख्यतः एक प्रशिक्षण विचार है, पेपर का मूल सबक सीधे इंफेरेंस पर लागू होता है। पेपर केवल FLOPs के लिए नहीं, बल्कि मेमोरी ट्रैफ़िक, संचार, और लेटेंसी के लिए भी अनुकूलन पर केंद्रित है। सबसे बड़ा प्रमाण लॉन्ग-कॉन्टेक्स्ट डिकोडिंग है, जहां KV-कैश का मोटा अनुमान यह है:
KV_bytes ≈ 2 x L x T x H x bytes_per_elem x batchFP16/BF16 के लिए,
bytes_per_elemका मान 2 होता है। उदाहरण के लिए, एक सामान्य आकार ( L=32, H=4096, batch=1) के साथ, 8K टोकन ~4 GB KV है, जबकि 128K टोकन ~64 GB है, तो भले ही कंप्यूट उचित रहे, मेमोरी फिर भी फूल सकती है, और आप बैंडविड्थ-बाउंड हो जाते हैं।इसीलिए व्यवहारिक इंफेरेंस अनुकूलन KV कैश क्वांटाइज़ेशन, पेज्ड KV और इविक्शन, कुशल अटेंशन कर्नेल्स (FlashAttention-परिवार), कंटीन्यूअस बैचिंग और शेप बकेटिंग, तथा संचार-सचेत पैरेललिज़्म जैसी तकनीकों से मेमोरी मूवमेंट घटाने पर केंद्रित होते हैं।
उद्देश्य यह है कि प्रदर्शन लाभ बने रहें, बिना मेमोरी रीड्स/राइट्स और समन्वय में छुपा हुआ कर चुकाए।
तालिका 1: प्रति टोकन मेमोरी एक्सेस लागत की तुलना (mHC पेपर)
DeepSeek रिपोर्ट करता है कि mHC लगातार बेसलाइन से बेहतर प्रदर्शन करता है और 27B मॉडलों के अधिकांश बेंचमार्क्स पर HC से आगे निकलता है, जिनमें HC की तुलना में BBH पर +2.1% और DROP पर +2.3% शामिल हैं। यह दिखाता है कि mHC स्केल पर बेहतर परिणामों में तब्दील होता है।
निष्कर्ष
इस पेपर से मुख्य सीख यह है कि LLMs का स्केलिंग केवल FLOPs की समस्या नहीं है; यह समान रूप से स्थिरता और सिस्टम्स की समस्या भी है। Hyper-Connections (HC) रेजिडुअल स्ट्रीम का विस्तार करके और कई स्ट्रीम्स को मिलाने देकर मॉडल क्षमता बढ़ाती हैं, लेकिन बड़ी गहराई पर यह मिक्सिंग एक समग्र मैपिंग में बदल जाती है जो आइडेंटिटी पाथ से काफी भटक सकती है, जिससे सिग्नल/ग्रेडियंट फटना या गायब होना और प्रशिक्षण का बिगड़ना हो सकता है।
mHC इसे रेजिडुअल मिक्सिंग मैट्रिक्स को डबल्ली स्टोकेस्टिक (गैर-ऋणात्मक, पंक्तियों/स्तम्भों का योग 1) तक सीमित करके—जो Sinkhorn–Knopp के जरिए लागू होता है—गार्डरेल्स लगा कर ठीक करती है, ताकि रेजिडुअल पाथ नियंत्रित भारित औसत जैसा व्यवहार करे और कई लेयर्स स्टैक करने पर भी स्थिर रहे।
DeepSeek रनटाइम दक्षता को भी पद्धति का हिस्सा मानता है। उन्होंने हाई-बैंडविड्थ मेमोरी रीड्स/राइट्स घटाने के लिए कर्नेल फ्यूज़न का उपयोग किया, और एक्टिवेशन मेमोरी को न्यूनतम करने के लिए चयनात्मक रिकम्प्यूटेशन का सहारा लिया।
इसके अलावा, उन्होंने DualPipe का विस्तार किया ताकि संचार और गणना ओवरलैप हों, सुनिश्चित करते हुए कि पाइपलाइन स्टॉल्स लाभ को समाप्त न करें। परिणामस्वरूप न केवल अधिक स्थिर प्रशिक्षण मिलता है, बल्कि स्केल पर बेहतर डाउनस्ट्रीम प्रदर्शन भी मिलता है।
यदि आप LLM एप्लिकेशन डेवलपमेंट के बारे में और जानना चाहते हैं, तो Developing LLM Applications with LangChain कोर्स अवश्य देखें।